What gets filtered outCe qui est filtré
TRA6008 OptionalFacultatif
Four things filtering tries to do
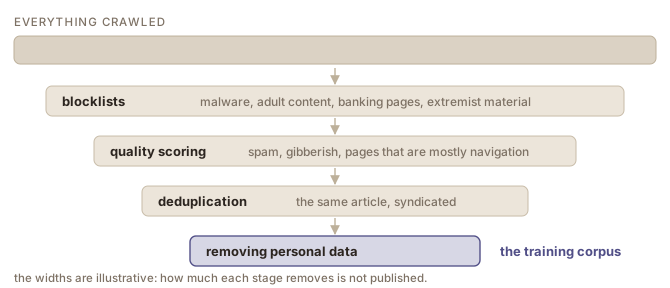
Whole sites are excluded first, through blocklists covering malware, adult content, banking pages and material judged extremist. Within what remains, automatic scoring drops pages that look like spam or gibberish, pages that repeat themselves, and pages that are mostly navigation and advertisement.
Near-duplicates are then removed. The same article is syndicated across dozens of sites, and a model trained on the same text hundreds of times gives it that much more weight, so deduplication is more important than it sounds. GPT-3’s builders describe both document-level fuzzy deduplication and the removal of documents overlapping with their evaluation sets (Brown et al., 2020).
Finally, there are attempts to remove personal information.
Why none of it works completely
These filters are automatic and approximate. Personal information appears in forms no pattern anticipates, a phone number written out in words or an address inside a scanned document, so some of it survives into the corpus and can resurface in what a model produces.
And “low quality” is not a property the text has. Somebody decides that this forum is worth keeping and that one is not, that this dialect reads as error-strewn, that this topic is unsuitable. Those decisions are usually made quickly, at scale, by people with a particular idea of what good writing looks like, and they end up shaping what a model treats as normal language (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
Quatre choses que le filtrage tente de faire
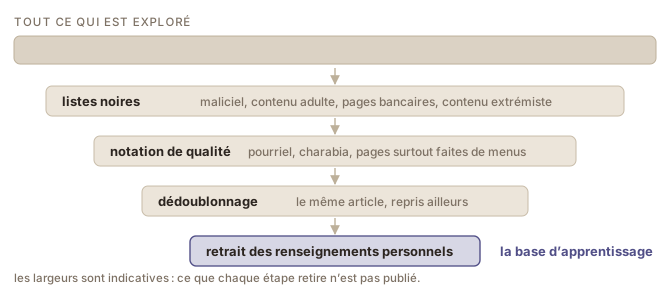
Des sites entiers sont d’abord exclus, au moyen de listes noires couvrant les maliciels, le contenu adulte, les pages bancaires et le contenu jugé extrémiste. Dans ce qui reste, une notation automatique écarte les pages qui ressemblent à du pourriel ou à du charabia, celles qui se répètent, et celles qui sont surtout faites de menus et de publicité.
Les quasi-doublons sont ensuite supprimés. Un même article est repris sur des dizaines de sites, et un modèle qui rencontre un texte des centaines de fois le pondère en conséquence : le dédoublonnage compte donc plus qu’il n’y paraît. Ceux qui ont construit GPT-3 décrivent à la fois un dédoublonnage approximatif au niveau du document et le retrait des documents recoupant leurs jeux d’évaluation (Brown et al., 2020).
Enfin, on tente de retirer les renseignements personnels.
Pourquoi rien de tout cela ne fonctionne complètement
Ces filtres sont automatiques et approximatifs. Les renseignements personnels apparaissent sous des formes qu’aucun motif n’anticipe, un numéro de téléphone écrit en toutes lettres ou une adresse à l’intérieur d’un document numérisé : une partie survit donc jusque dans le corpus et peut ressortir dans ce que produit un modèle.
Et la « faible qualité » n’est pas une propriété du texte. Quelqu’un décide que tel forum mérite d’être conservé et tel autre non, que tel dialecte se lit comme truffé de fautes, que tel sujet ne convient pas. Ces décisions se prennent en général vite, à grande échelle, par des gens qui ont une idée particulière de ce à quoi ressemble une bonne écriture, et elles finissent par façonner ce qu’un modèle traite comme une langue normale (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
Sources
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- OpenAI (2023). GPT-4 Technical Report. arXiv:2303.08774 (preprint). https://arxiv.org/abs/2303.08774