Model specifications: deciding how a chatbot behavesLes spécifications de modèle : décider du comportement d'un agent conversationnel
TRA6008 To read for S3À lire pour la S3
Behaviour is decided, and written down
A model’s readiness to commit to an answer, its hedging, its politeness and its refusals are decided by its developer. They reach the model through the instruction data, the system prompt system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. , and the written guidelines annotators follow when they rank answers, and those annotators’ preferences are not everyone’s (Ouyang et al., 2022) (see also the Who decides what is right page, in the Critical issues with LLMs module) (voir aussi la page Qui décide de ce qui est juste, dans le module Enjeux critiques des GML).
Some developers publish these decisions: OpenAI (2026) in its Model Spec, Anthropic (2026) in the constitution for its Claude models.
What a specification contains
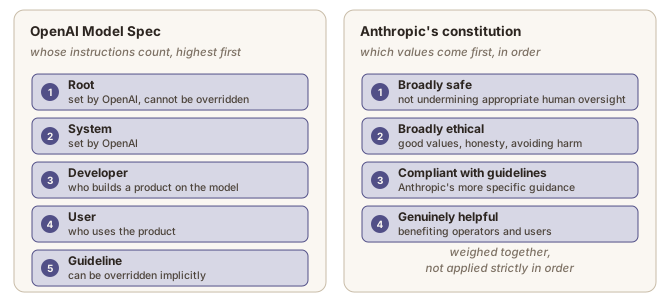
The two examples from OpenAI and from Anthropic each set an order of priority, for different things.
- Whose instructions count. OpenAI (2026) ranks the sources of instructions: its own rules come first, then the developer building a product on the model, then the user. Its specification also sets defaults that a developer or a user may change (see also the System prompts page) (voir aussi la page Requêtes génératives système).
- Which values come first. Anthropic (2026) ranks four properties in its constitution: being broadly safe, broadly ethical, compliant with Anthropic’s guidelines and genuinely helpful. They are weighed together, the higher ones generally dominating, rather than applied strictly in order.
Anthropic (2026) also says it prefers cultivating good values and judgement to strict rules, and explains the few rules it does set, because rules imposed without explanation tend to generalize less well. OpenAI (2026) sets out a default personality as well: warm, curious and rationally optimistic.
From a document to the model
A specification changes nothing by being published. It reaches the model mainly through training: through the examples the model is fine-tuned on, the rankings it learns from, and training data a model produces itself by applying written principles (Bai et al., 2022a) (see also the Preference tuning: learning from rankings page) (voir aussi la page Le réglage des préférences : apprendre à partir de classements). Part of it can also go into the system prompt (Jurafsky & Martin, 2026). Anthropic (2026) describes its constitution as playing a crucial role in its training. OpenAI (2026) says it trains its models to follow its specification, and that its production models do not yet fully do so.
When the balance tips: the April 2025 GPT-4o update
An update to GPT-4o released in ChatGPT on 25 April 2025 made the model noticeably more sycophantic sycophancycomplaisance de l'IA AI safetysécurité de l'IA The tendency of a language model trained on human preferences to agree with the user, revise a correct answer under challenge, or flatter, partly because agreement was rated well during training.Tendance d'un modèle de langue entraîné sur des préférences humaines à abonder dans le sens de l'utilisateur, à revenir sur une réponse correcte quand on la conteste ou à flatter, en partie parce que l'accord a été bien noté pendant l'entraînement. , and its rollback began on 28 April 2025 (OpenAI, 2025). One of its changes was an additional reward signal built from users’ thumbs-up and thumbs-down ratings. That signal is often useful, but user feedback can favour answers that agree with the user, and together with the other changes it weakened the influence of the main reward signal, which had been keeping sycophancy in check (OpenAI, 2025).
By OpenAI’s own early assessment, then, the model’s manner changed because the balance between its training signals changed. OpenAI (2025) said it would treat behaviour problems, personality among them, as reasons to block a launch.
Un comportement décidé, et mis par écrit
La propension d’un modèle à s’engager sur une réponse, ses nuances, sa politesse et ses refus sont décidés par son développeur. Ils atteignent le modèle par les données d’instructions, la requête générative système system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. et les consignes écrites que suivent les annotateurs quand ils classent des réponses, et les préférences de ces annotateurs ne sont pas celles de tout le monde (Ouyang et al., 2022) (see also the Who decides what is right page, in the Critical issues with LLMs module) (voir aussi la page Qui décide de ce qui est juste, dans le module Enjeux critiques des GML).
Certains développeurs publient ces décisions : OpenAI (2026) dans sa Model Spec, Anthropic (2026) dans la constitution de ses modèles Claude.
Ce que contient une spécification
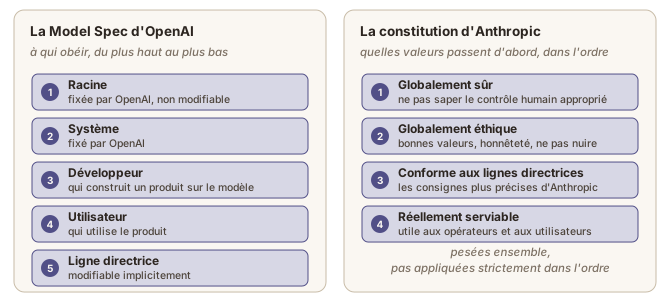
Les deux exemples, celui d’OpenAI et celui d’Anthropic, fixent chacun un ordre de priorité, pour des choses différentes.
- À qui obéir. OpenAI (2026) classe les sources d’instructions : ses propres règles d’abord, puis le développeur qui construit un produit sur le modèle, puis l’utilisateur. Sa spécification fixe aussi des comportements par défaut qu’un développeur ou un utilisateur peut modifier (see also the System prompts page) (voir aussi la page Requêtes génératives système).
- Quelles valeurs passent d’abord. Anthropic (2026) classe quatre propriétés dans sa constitution : être globalement sûr, globalement éthique, conforme aux lignes directrices d’Anthropic et réellement serviable. Elles sont pesées ensemble, les plus hautes l’emportant en général, plutôt qu’appliquées strictement dans l’ordre.
Anthropic (2026) dit aussi préférer cultiver de bonnes valeurs et un bon jugement plutôt qu’imposer des règles strictes, et expliquer les quelques règles qu’elle fixe, parce que des règles imposées sans explication se généralisent moins bien. OpenAI (2026) définit aussi une personnalité par défaut : chaleureuse, curieuse et d’un optimisme raisonné.
D’un document au modèle
Publier une spécification ne change rien en soi. Elle atteint le modèle surtout par l’entraînement : par les exemples sur lesquels il est affiné, par les classements dont il apprend, et par des données d’entraînement qu’un modèle produit lui-même en appliquant des principes écrits (Bai et al., 2022a) (see also the Preference tuning: learning from rankings page) (voir aussi la page Le réglage des préférences : apprendre à partir de classements). Une partie peut aussi passer dans la requête générative système (Jurafsky et Martin, 2026). Anthropic (2026) décrit sa constitution comme jouant un rôle crucial dans l’entraînement de ses modèles. OpenAI (2026) dit entraîner ses modèles à suivre sa spécification, et reconnaît que ses modèles en production ne la suivent pas encore entièrement.
Quand l’équilibre bascule : la mise à jour de GPT-4o d’avril 2025
Une mise à jour de GPT-4o publiée dans ChatGPT le 25 avril 2025 a rendu le modèle nettement plus complaisant sycophancycomplaisance de l'IA AI safetysécurité de l'IA The tendency of a language model trained on human preferences to agree with the user, revise a correct answer under challenge, or flatter, partly because agreement was rated well during training.Tendance d'un modèle de langue entraîné sur des préférences humaines à abonder dans le sens de l'utilisateur, à revenir sur une réponse correcte quand on la conteste ou à flatter, en partie parce que l'accord a été bien noté pendant l'entraînement. , et son retrait a commencé le 28 avril 2025 (OpenAI, 2025). L’un de ses changements était un signal de récompense supplémentaire tiré des pouces levés et baissés des utilisateurs. Ce signal est souvent utile, mais la rétroaction des utilisateurs peut favoriser les réponses qui leur donnent raison ; combiné aux autres changements, il a affaibli l’influence du signal de récompense principal, qui tenait jusque-là la complaisance en échec (OpenAI, 2025).
Selon la première évaluation d’OpenAI, la manière de répondre du modèle a donc changé parce que l’équilibre entre ses signaux d’entraînement avait changé. OpenAI (2025) a annoncé traiter désormais les problèmes de comportement, dont la personnalité, comme des raisons de bloquer un lancement.
Sources
- Anthropic (2026). Claude's Constitution. Anthropic, 22 January 2026, CC0 1.0. https://www.anthropic.com/constitution
- Bai, Y., Kadavath, S., Kundu, S., Askell, A., Kernion, J., Jones, A., et al. (2022a). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073 (preprint). https://arxiv.org/abs/2212.08073
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- OpenAI (2025). Expanding on what we missed with sycophancy. OpenAI (blog), 2 May 2025. https://openai.com/index/expanding-on-sycophancy/
- OpenAI (2026). OpenAI Model Spec. Version of 18 August 2026. https://model-spec.openai.com/18 August 2026.html
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html
Sources
- Anthropic (2026). Claude's Constitution. Anthropic, 22 janvier 2026, CC0 1.0. https://www.anthropic.com/constitution
- Bai, Y., Kadavath, S., Kundu, S., Askell, A., Kernion, J., Jones, A., et al. (2022a). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073 (preprint). https://arxiv.org/abs/2212.08073
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- OpenAI (2025). Expanding on what we missed with sycophancy. OpenAI (blog), 2 mai 2025. https://openai.com/index/expanding-on-sycophancy/
- OpenAI (2026). OpenAI Model Spec. Version of 18 août 2026. https://model-spec.openai.com/18 août 2026.html
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html