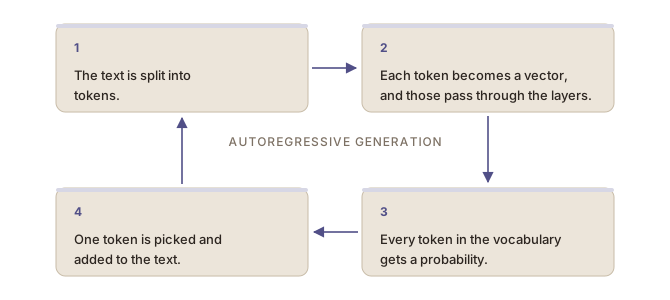
Each token becomes a vector, and those vectors pass through the network’s layers.
The model produces a score for every token in its vocabulary, turned into a probability.
One token is picked, appended to the text, and the process starts again from step 1.
Figure 5. Each turn of the loop produces one token, and the next turn reads it along with everything before it.
Every token gets a probability
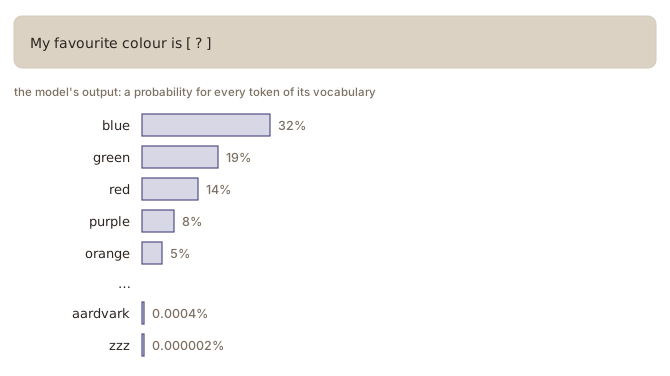
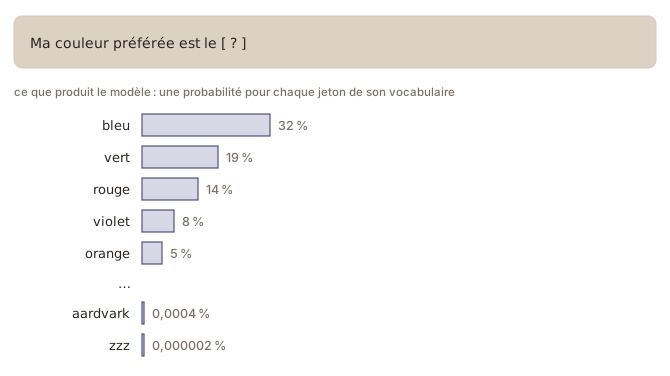
The third step is the one that gets misread. Asked to continue My favourite
colour is, the model does not decide on blue. It produces a number for every
single token it knows, tens of thousands of them, and those numbers add up to
one.
Figure 6. Every token in the vocabulary gets a probability, including the ones that make no sense here. The percentages are illustrative.
Most of them are absurd here and get probabilities near zero, but they are all
scored. Choosing one of them is a separate step, taken after the computation,
and the highest number does not always
win (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
Why the text arrives the way it does
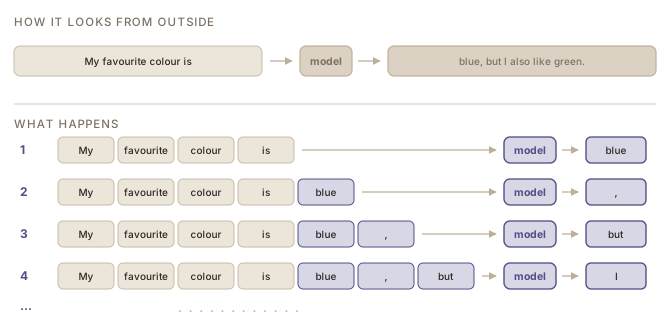
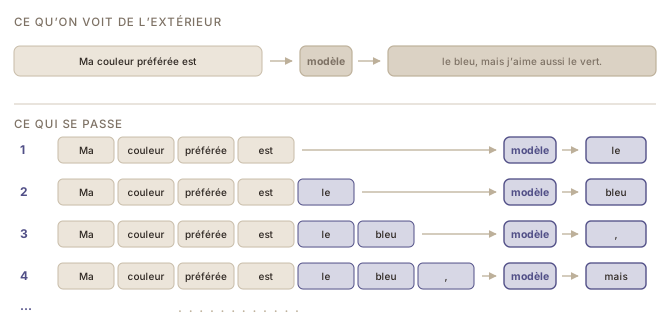
From the outside a model looks as though it reads your question once and writes
the answer. Each token in that answer is a separate pass, and every pass reads
the prompt together with everything the model has already added.
Figure 7. Above, generation as it looks from outside. Below, one pass of the model for every token produced.
An answer of five hundred tokens is five hundred of those passes. Two
consequences to consider:
The output appears steadily rather than all at once, because each token
has to wait for the one before it.
The model has no draft. It commits to each token before computing the
next, so it cannot plan a sentence, notice halfway that the ending will not
work, and revise the beginning.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Updated 14 September 2026
Ce qui se passe quand vous appuyez sur Entrée
Votre requête passe par les quatre mêmes étapes à chaque fois.
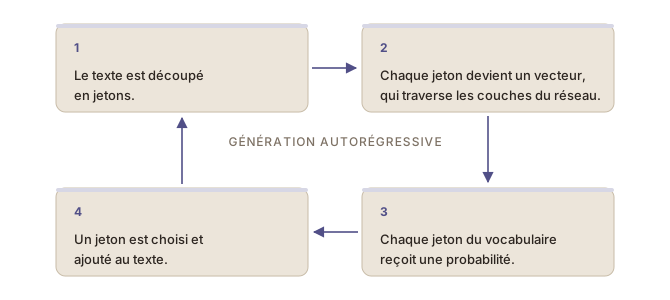
Chaque jeton devient un vecteur, et ces vecteurs traversent les couches du réseau.
Le modèle produit une note pour chaque jeton de son vocabulaire, convertie en probabilité.
Un jeton est choisi, ajouté au texte, et tout reprend à l’étape 1.
Figure 5. Chaque tour de la boucle produit un jeton, et le tour suivant le lit avec tout ce qui le précède.
Chaque jeton reçoit une probabilité
La troisième étape est celle que l’on interprète mal. Quand on lui demande de
continuer My favourite colour is, le modèle ne décide pas blue. Il produit
un nombre pour chacun des jetons qu’il connaît, des dizaines de milliers, et ces
nombres font 1 au total.
Figure 6. Chaque jeton du vocabulaire reçoit une probabilité, y compris ceux qui n'ont aucun sens ici. Les pourcentages sont donnés à titre indicatif.
La plupart sont absurdes ici et reçoivent des probabilités proches de zéro, mais
ils sont tous notés. En choisir un est une étape distincte, qui a lieu après le
calcul, et le nombre le plus élevé ne l’emporte pas
toujours (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
Pourquoi le texte arrive comme il arrive
Vu de l’extérieur, un modèle a l’air de lire votre question une fois et d’écrire
la réponse. Chaque jeton de cette réponse est un passage distinct, et chaque
passage lit la requête en même temps que tout ce que le modèle a déjà ajouté.
Figure 7. En haut, la génération telle qu'elle paraît de l'extérieur. En bas, un passage du modèle pour chaque jeton produit.
Une réponse de cinq cents jetons, ce sont cinq cents de ces passages. Deux
conséquences à retenir :
La sortie arrive progressivement plutôt que d’un seul coup, parce que
chaque jeton doit attendre celui qui le précède.
Le modèle n’a pas de brouillon. Il s’engage sur chaque jeton avant de
calculer le suivant, si bien qu’il ne peut pas prévoir une phrase, s’apercevoir
à mi-chemin que la fin ne fonctionnera pas, et revenir sur le début.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Mise à jour 14 septembre 2026
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/