Bases du TAL et extraction terminologiqueBases du TAL et extraction terminologique
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
The AI landscapeLe paysage de l'IA
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
This definition is deliberately broad, and broader than the science-fiction
picture of machines that think like humans. It includes any computational
approach to tasks associated with intelligence: recognizing patterns, making
decisions, using language, solving problems. It says nothing about how the
task is performed. A program following a few hundred hand-written rules and a
system trained on half the internet both qualify, and the difference between
those two ways of qualifying is the subject of the rest of this module.
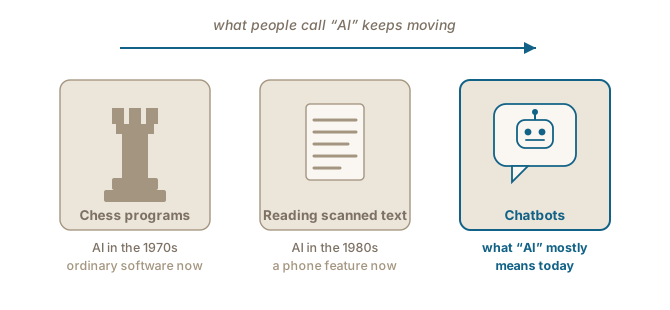
The boundary of the field also moves. Chess programs were once the showpiece
of AI research; today a chess engine on your phone beats any human and nobody
calls it AI. Converting a scanned page to editable text was cutting-edge AI in
the 1970s; it is now a routine feature of a phone camera. This pattern has a
name, the “AI effect” (McCorduck, 2004): once a capability is understood and
ordinary, it stops being seen as intelligence. Keep it in mind when you read
that a tool “uses AI”. The phrase mostly signals that the capability is
recent; it tells you almost nothing about what the tool actually does.
Figure 1. The boundary moves. Yesterday's showpieces became ordinary software, and the word followed the newest capability.
Grobelnik, M., Perset, K., & Russell, S. (2024). What is AI? Can you make a clear distinction between AI and non-AI systems?. OECD.AI Policy Observatory. https://oecd.ai/en/wonk/definition
International Organization for Standardization & International Electrotechnical Commission (2022). Information technology — Artificial intelligence — Artificial intelligence concepts and terminology (ISO/IEC 22989:2022). ISO/IEC. https://www.iso.org/standard/74296.html
Cette définition est volontairement large, plus large que l’image de
science-fiction de machines qui pensent comme des humains. Elle englobe toute
approche informatique de tâches associées à l’intelligence : reconnaître des
motifs, prendre des décisions, employer la langue, résoudre des problèmes.
Elle ne dit rien de la manière dont la tâche est accomplie. Un programme qui
suit quelques centaines de règles écrites à la main et un système entraîné sur
la moitié d’Internet répondent tous deux à la définition, et la différence
entre ces deux façons d’y répondre fait l’objet du reste de ce module.
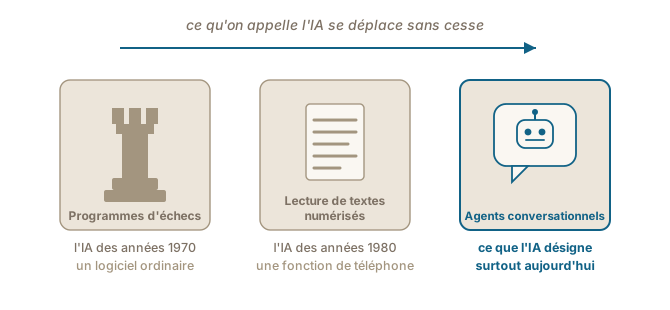
La frontière du domaine se déplace, elle aussi. Les programmes d’échecs ont
été la vitrine de la recherche en IA ; aujourd’hui, un logiciel d’échecs sur
votre téléphone bat n’importe quel humain et personne ne parle plus d’IA.
Convertir une page numérisée en texte modifiable était de l’IA de pointe dans
les années 1970 ; c’est devenu une fonction ordinaire d’un appareil photo de
téléphone. Ce phénomène porte un nom, l’« effet IA » (McCorduck, 2004) : dès
qu’une capacité est comprise et devenue courante, on cesse d’y voir de
l’intelligence. Gardez-le en tête quand vous lisez qu’un outil « utilise
l’IA ». L’expression signale surtout que la capacité est récente ; elle ne
vous dit à peu près rien de ce que l’outil fait.
Figure 1. La frontière se déplace. Les vitrines d'hier sont devenues des logiciels ordinaires, et le mot a suivi la capacité la plus récente.
Grobelnik, M., Perset, K., & Russell, S. (2024). What is AI? Can you make a clear distinction between AI and non-AI systems?. OECD.AI Policy Observatory. https://oecd.ai/en/wonk/definition
International Organization for Standardization & International Electrotechnical Commission (2022). Information technology — Artificial intelligence — Artificial intelligence concepts and terminology (ISO/IEC 22989:2022). ISO/IEC. https://www.iso.org/standard/74296.html
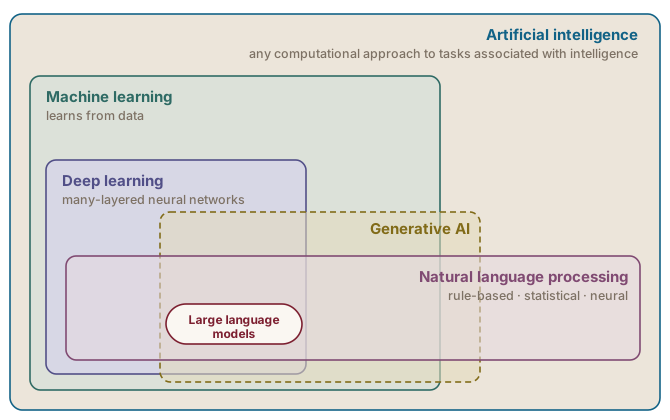
Not everything called AI learns. A chess program from the 1980s played by
rules its programmers wrote down; nothing in it changed with experience. The
spam filter in your mailbox, by contrast, was shown thousands of examples of
spam and ordinary mail and worked out the difference itself. Both are AI. Only
the second is machine learning.
Figure 2. How the fields nest. AI is the broadest category; machine learning learns from data; deep learning uses many-layered neural networks. Natural language processing crosses all three levels, and large language models sit where deep learning, generative AI and NLP meet.
International Organization for Standardization & International Electrotechnical Commission (2022). Information technology — Artificial intelligence — Artificial intelligence concepts and terminology (ISO/IEC 22989:2022). ISO/IEC. https://www.iso.org/standard/74296.html
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
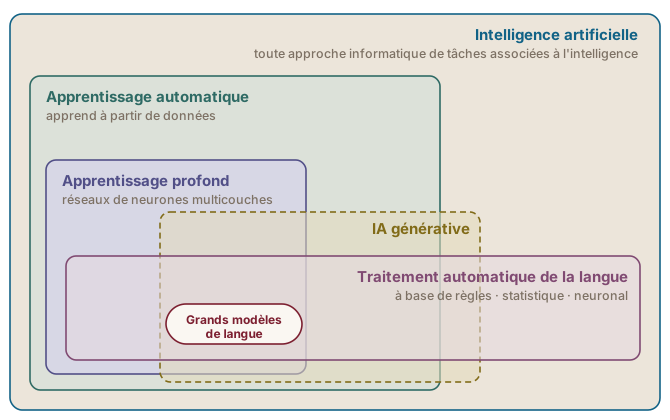
Tout ce qu’on appelle IA n’apprend pas. Un programme d’échecs des années 1980
jouait selon des règles écrites par ses programmeurs ; rien en lui ne changeait
avec l’expérience. Le filtre antipourriel de votre boîte de courriel, lui, a vu
des milliers d’exemples de pourriels et de courriels ordinaires et a dégagé la
différence tout seul. Les deux sont de l’IA. Seul le second est de
l’apprentissage automatique.
Figure 2. Comment les domaines s'emboîtent. L'IA est la catégorie la plus large ; l'apprentissage automatique apprend à partir de données ; l'apprentissage profond emploie des réseaux de neurones à plusieurs couches. Le traitement automatique de la langue traverse les trois niveaux, et les grands modèles de langue se trouvent au croisement de l'apprentissage profond, de l'IA générative et du TAL.
International Organization for Standardization & International Electrotechnical Commission (2022). Information technology — Artificial intelligence — Artificial intelligence concepts and terminology (ISO/IEC 22989:2022). ISO/IEC. https://www.iso.org/standard/74296.html
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Generative AI and large language modelsL'IA générative et les grands modèles de langue
Most of the systems mentioned so far analyze something that already exists: is
this email spam, what is the grammatical category of this word. The recent
wave of public attention went to systems that produce something instead:
text, images, music, code, video.
Grobelnik, M., Perset, K., & Russell, S. (2024). What is AI? Can you make a clear distinction between AI and non-AI systems?. OECD.AI Policy Observatory. https://oecd.ai/en/wonk/definition
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Weizenbaum, J. (1966). ELIZA—a computer program for the study of natural language communication between man and machine. Communications of the ACM, 9(1), 36–45. https://doi.org/10.1145/365153.365168
La plupart des systèmes évoqués jusqu’ici analysent quelque chose qui existe
déjà : ce courriel est-il un pourriel, quelle est la catégorie grammaticale de
ce mot. La vague récente d’attention du public est allée à des systèmes qui
produisent quelque chose : du texte, des images, de la musique, du code, de
la vidéo.
Grobelnik, M., Perset, K., & Russell, S. (2024). What is AI? Can you make a clear distinction between AI and non-AI systems?. OECD.AI Policy Observatory. https://oecd.ai/en/wonk/definition
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Weizenbaum, J. (1966). ELIZA—a computer program for the study of natural language communication between man and machine. Communications of the ACM, 9(1), 36–45. https://doi.org/10.1145/365153.365168
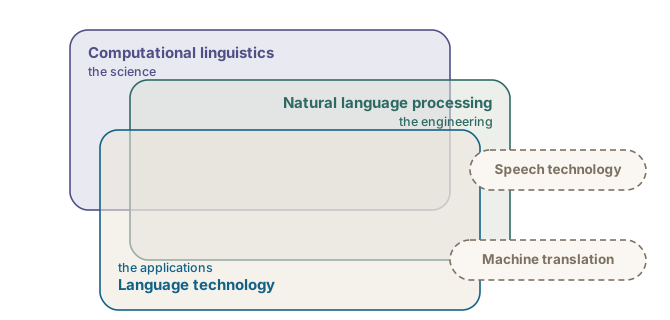
In this context, three terms are used to describe more or less the same thing
in different contexts.
Computational linguistics leans
toward the science, language studied by computational means; NLP leans toward
the engineering; language technology names the applied, product-facing side.
The emphasis differs more than the subject, and on this site I use the three
more or less interchangeably. Speech processing and machine translation sit on
the edge: sometimes counted inside these fields, sometimes as specialties
beside them.
Figure 4. Three names for largely the same territory; the emphasis differs more than the subject. Speech technology and machine translation are sometimes counted inside, sometimes beside.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
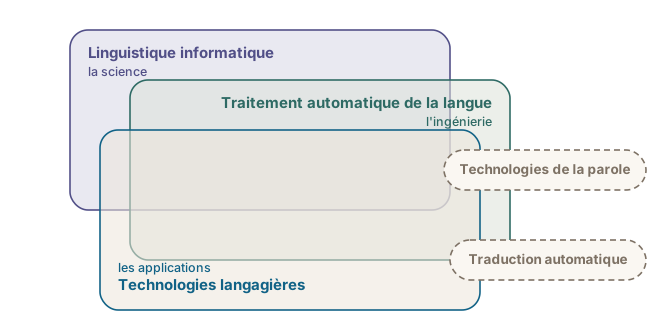
Dans ce contexte, trois termes servent à décrire plus ou moins la même chose
dans des contextes différents. La linguistique
informatique penche du côté de la science, la langue étudiée par des
moyens informatiques ; le TAL penche du côté de l’ingénierie ; les
technologies langagières désignent le versant appliqué, tourné vers le
produit. L’accent diffère plus que l’objet, et sur ce site j’emploie les trois
à peu près indifféremment. Le traitement de la parole et la traduction
automatique se tiennent à la limite : tantôt comptés dans ces domaines, tantôt
comme des spécialités à côté.
Figure 4. Trois noms pour à peu près le même territoire ; l'accent diffère plus que l'objet. Les technologies de la parole et la traduction automatique sont tantôt comptées dedans, tantôt à côté.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Four paradigmsQuatre paradigmes
Four ways of building a system
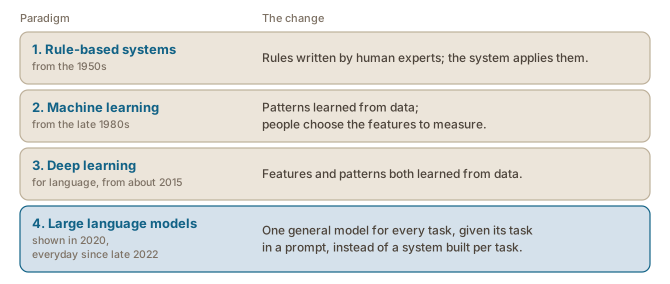
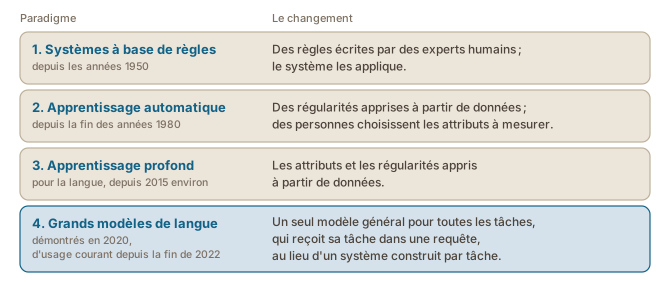
Natural language processing as a field has changed a great deal over the
past decades. The older approaches are still in use for some tasks, and some
of the newer ones existed for a long time before they became popular, but in
broad terms four big paradigms can be told apart, by the share of the work
that people do and the share the machine learns. Figure 5figure 5
sets them out in the order they arrived, with the change each one brought.
Figure 5. The four paradigms in the order they arrived, and the change each one brought.
Each paradigm is inside the one before it, the way the map of the fields nests
them: machine learning is a kind of AI, deep learning a kind of machine
learning, a large language model a kind of deep
learning (see also the nested fields page, in the Foundations of AI & NLP module) (voir aussi la page Les domaines emboîtés, dans le module Fondements de l'IA et du TAL). Each is
a paradigm of its own all the same, because the division of the work between
people and the machine changed each time: first the patterns were learned,
then the features, then the task itself no longer had to be built into the
system.
Interpreting the evolution
Some strategies were available long before they became successful.
Language models existed before ChatGPT made them popular (Brown et al.,
2020), and neural networks existed long before the data and the
computation they need to work well were
available (see also the How a network learns page, in the Foundations of AI & NLP module) (voir aussi la page Comment un réseau apprend, dans le module Fondements de l'IA et du TAL).
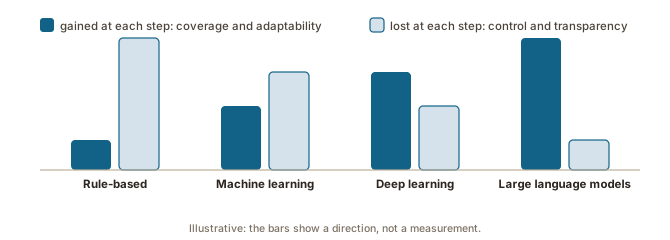
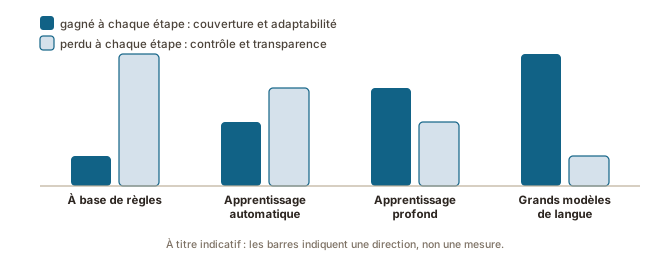
Each paradigm shift means that a different methodology becomes more
popular and more successful on some tasks, but all the previous
methodologies remain in use. To this day, there are plenty of tasks for
which rule-based methods remain the best solution. And though a new
strategy performs better on some tasks, the shift often comes at the cost
of control and transparency
(Figure 6figure 6) (see also the black box page, in the Foundations of AI & NLP module) (voir aussi la page La boîte noire, dans le module Fondements de l'IA et du TAL),
and with large requirements in data and computation.
Figure 6. The gain and the loss at each step. The bars show a direction, not a measurement.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Le traitement automatique de la langue a beaucoup changé au fil des
dernières décennies. Les approches les plus anciennes servent encore pour
certaines tâches, et certaines des plus récentes ont existé longtemps avant
de s’imposer, mais on distingue, à grands traits, quatre grands paradigmes,
selon la part du travail que font les personnes et la part qu’apprend la
machine. La Figure 5figure 5
les présente dans l’ordre de leur arrivée, avec le changement que chacun a
apporté.
Figure 5. Les quatre paradigmes dans l'ordre de leur arrivée, et le changement que chacun a apporté.
Chaque paradigme s’inscrit dans le précédent, comme s’emboîtent les domaines
sur la carte : l’apprentissage automatique est une forme d’IA, l’apprentissage
profond une forme d’apprentissage automatique, un grand modèle de langue une
forme d’apprentissage profond (see also the nested fields page, in the Foundations of AI & NLP module) (voir aussi la page Les domaines emboîtés, dans le module Fondements de l'IA et du TAL).
Chacun n’en est pas moins un paradigme à part entière, parce que le partage
du travail entre les personnes et la machine a changé à chaque fois : d’abord
les régularités ont été apprises, puis les attributs, puis la tâche elle-même
n’a plus eu à être construite dans le système.
Interpréter l’évolution
Certaines stratégies étaient disponibles bien avant de s’imposer. Les
modèles de langue existaient avant que ChatGPT ne les rende populaires
(Brown et al., 2020), et les réseaux de neurones ont existé longtemps avant
que les données et la puissance de calcul dont ils ont besoin pour bien
fonctionner ne soient disponibles (see also the How a network learns page, in the Foundations of AI & NLP module) (voir aussi la page Comment un réseau apprend, dans le module Fondements de l'IA et du TAL).
Chaque changement de paradigme signifie qu’une méthodologie différente
devient plus populaire et plus performante pour certaines tâches, mais
toutes les méthodologies précédentes restent en usage. Aujourd’hui encore,
pour bien des tâches, les méthodes à base de règles restent la meilleure
solution. Et même si une nouvelle stratégie fait mieux pour certaines
tâches, le changement se paie souvent en contrôle et en transparence
(Figure 6figure 6) (see also the black box page, in the Foundations of AI & NLP module) (voir aussi la page La boîte noire, dans le module Fondements de l'IA et du TAL),
et il exige beaucoup de données et de calcul.
Figure 6. Le gain et la perte à chaque étape. Les barres indiquent une direction, non une mesure.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
From rules to machine learningDes règles à l'apprentissage automatique
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Rule-based systemsLes systèmes à base de règles
Rules written by people
A rule-based system automates a task by applying rules that people wrote
down.
Two examples of simple rule-based systems are:
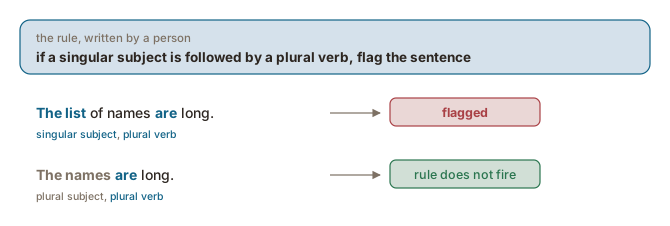
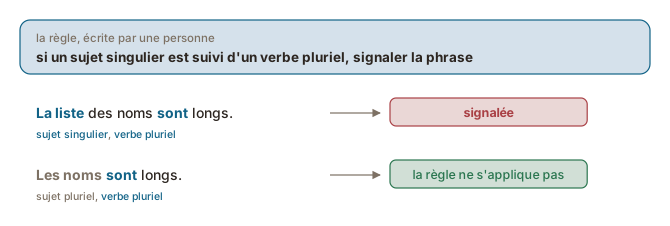
a grammar checker: a singular subject followed by a plural verb ⇒ flag the sentence
a date converter: four digits, a hyphen, two digits, a hyphen, two digits ⇒ a date; reorder the parts
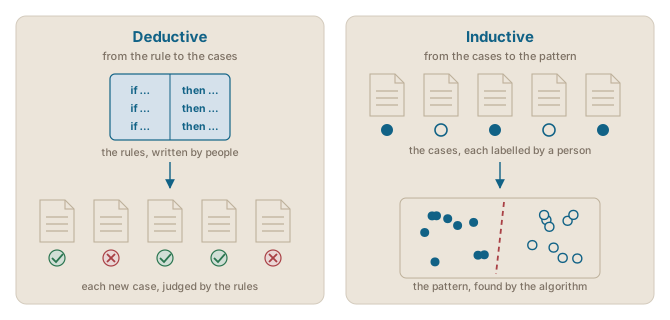
Every piece of the system’s behaviour was specified by a human, which is why
this is called the deductive approach: general rules first, applied to each
new case. Figure 1figure 1 shows one such rule applied to two sentences.
Figure 1. One hand-written rule of a grammar checker, applied to two sentences. It fires on the first and not on the second, and a wrong flag is fixed by fixing the rule.
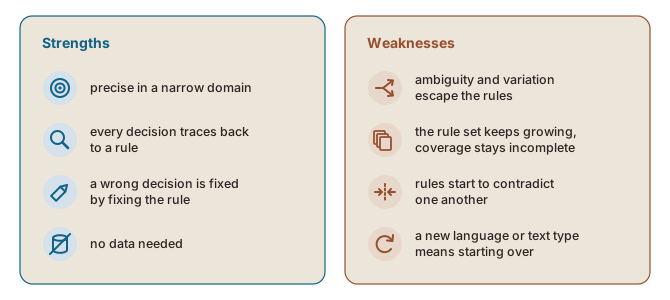
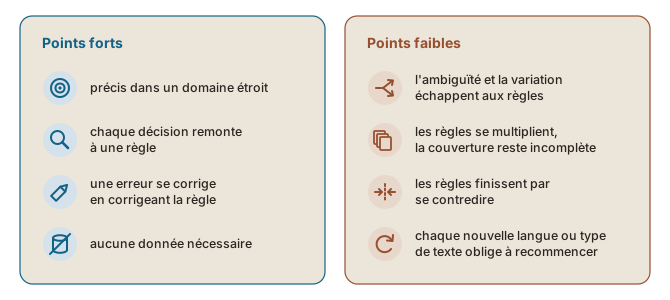
Figure 2. The strengths and weaknesses of rule-based systems.
By the late 1980s, the weaknesses had pushed the field toward another way of
building systems, in which the patterns are found in data instead of written
as rules.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Des règles écrites par des personnes
Un système à base de règles automatise une tâche en appliquant des règles que
des personnes ont écrites.
Voici deux exemples de systèmes simples à base de règles :
un correcteur grammatical : un sujet singulier suivi d’un verbe pluriel ⇒ signaler la phrase
un convertisseur de dates : quatre chiffres, un trait d’union, deux chiffres, un trait d’union, deux chiffres ⇒ une date ; réordonner les parties
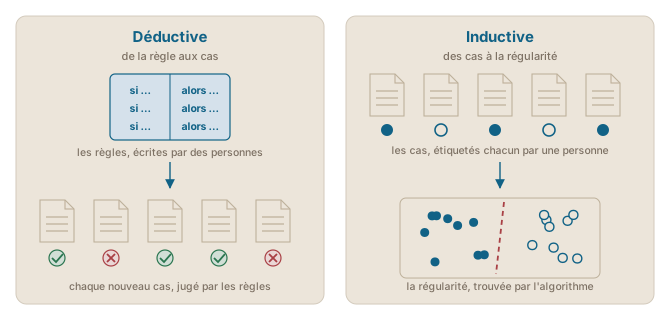
Chaque élément du comportement du système a été spécifié par une personne,
et c’est pourquoi on parle d’approche déductive : des règles générales
d’abord, appliquées à chaque nouveau cas. La Figure 1figure 1 montre une telle règle appliquée à deux phrases.
Figure 1. Une règle d'un correcteur grammatical, écrite à la main, appliquée à deux phrases. Elle se déclenche sur la première et pas sur la seconde, et un signalement erroné se corrige en corrigeant la règle.
Figure 2. Les points forts et les points faibles des systèmes à base de règles.
À la fin des années 1980, ces faiblesses avaient poussé le domaine vers une
autre façon de construire les systèmes, où les régularités sont trouvées
dans des données au lieu d’être écrites sous forme de règles.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
The turn to machine learningLe virage vers l'apprentissage automatique
Handled, provided enough cases like it are in the data and the features let the system find a systematic difference; an unusual case still gets an answer, as a degree of likelihood
Interpretability
Every decision traces back to a rule a person can read and change
Readable to a degree that depends on the algorithm; a decision is changed by changing the data
A new language or domain
Start again
Collect data, retrain
Where they fit
Narrow, well-defined tasks, and tasks with no data
Tasks with much variation and much data
Rule-based and machine learning systems compared.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Un cas que personne n’a prévu est un cas que personne n’a traité
Traitées, à condition que les données contiennent assez de cas semblables et que les attributs permettent au système de trouver une différence systématique ; un cas inhabituel obtient tout de même une réponse, sous forme de degré de probabilité
Interprétabilité
Chaque décision remonte à une règle qu’une personne peut lire et modifier
Lisible à un degré qui dépend de l’algorithme ; une décision se modifie en modifiant les données
Une nouvelle langue ou un nouveau domaine
Tout recommencer
Réunir des données, réentraîner
Où ils conviennent
Les tâches étroites et bien définies, et les tâches sans données
Les tâches très variables, avec beaucoup de données
Systèmes à base de règles et systèmes d'apprentissage automatique comparés.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Learning from labelled examplesApprendre à partir d'exemples étiquetés
Suppose you want a system that sorts email into spam and not spam. The
rule-based way is to describe spam: certain senders, certain words, too many
links. The supervised way is to show the system ten thousand emails that a
human already sorted, and let it work out the difference. Each email with its
human verdict attached is a labelled example, and a collection of many
labelled examples becomes training data.
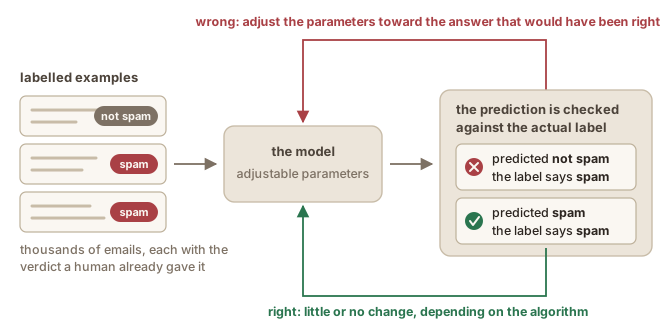
Figure 4. The training loop, and the two ways back from it: a wrong prediction adjusts the settings, a right one changes little or nothing.
Two consequences follow directly from this setup, and they will come back
again and again in this collection:
Everything is learned from the data, not from rules. The system
reproduces the judgements in its training data, mistakes and blind spots
included, and the data is the only way in: there is no rule to rewrite when
it gets something wrong.
The training data has to resemble the real job. A spam filter trained
on English corporate email will stumble on French phishing. What the
examples do not show, the model cannot learn.
Before anything can be learned, somebody has to decide what the algorithm
looks at when it compares two emails.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Supposons que vous vouliez un système qui trie les courriels entre pourriel
et non pourriel. La façon à base de règles consiste à décrire le pourriel :
certains expéditeurs, certains mots, trop de liens. La façon supervisée
consiste à montrer au système dix mille courriels qu’un humain a déjà triés,
et à le laisser dégager la différence. Chaque courriel accompagné du verdict
humain est un exemple étiqueté, et un ensemble de nombreux exemples étiquetés
devient des données d’entraînement.
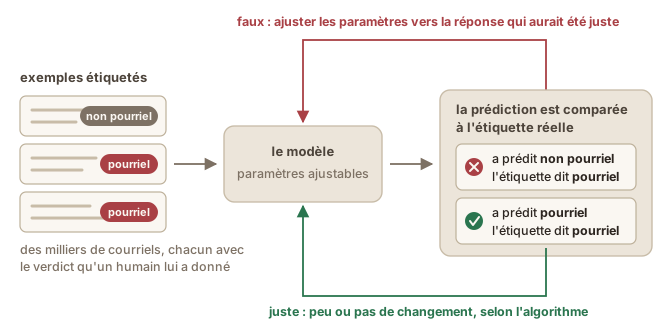
Figure 4. La boucle d'entraînement, et les deux façons d'en revenir : une prédiction fausse ajuste les paramètres, une prédiction juste ne change rien ou presque.
Deux conséquences découlent directement de ce fonctionnement, et elles
reviendront sans cesse dans ce matériel :
Tout s’apprend des données, pas de règles. Le système reproduit les
jugements de ses données d’entraînement, erreurs et angles morts compris, et
les données sont la seule porte d’entrée : il n’y a aucune règle à réécrire
quand il se trompe.
Les données d’entraînement doivent ressembler au travail réel. Un filtre
antipourriel entraîné sur des courriels d’entreprise en anglais trébuchera
sur de l’hameçonnage en français. Ce que les exemples ne montrent pas, le
modèle ne peut pas l’apprendre.
Avant que quoi que ce soit puisse s’apprendre, quelqu’un doit décider ce que
l’algorithme regarde quand il compare deux courriels.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
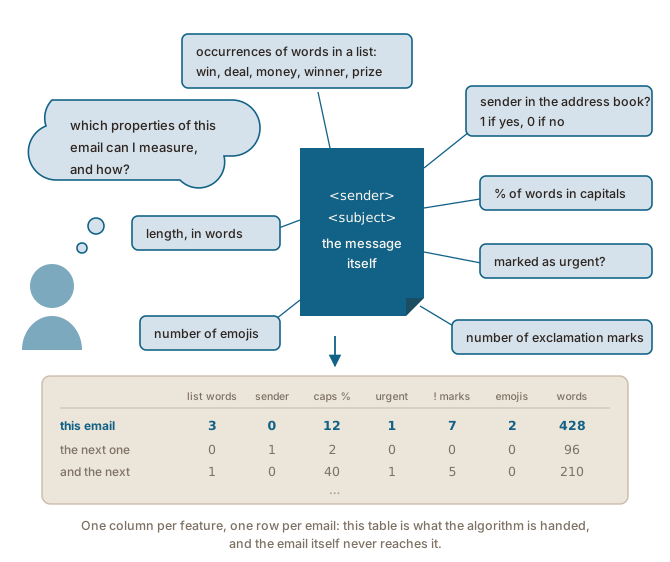
Algorithms cannot read emails the way humans do: they need numbers. So each
example has to be described as a set of measurable properties: how long the
message is, whether the sender is in your address book (typically encoded as
1 if yes, 0 if no), how many links it contains, whether the words win,
free or miracle appear. Each such property is a feature.
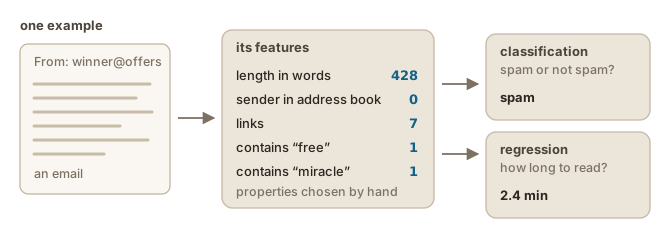
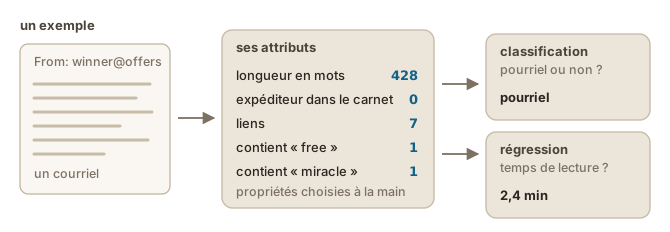
Figure 5. Feature engineering is this decision, made by a person: which properties of an email might separate spam from ordinary mail, how each one becomes a number, and therefore what the table looks like.
In traditional machine learning, choosing the features is human work, and it
is where most of the craft goes. Someone has to guess which properties
distinguish spam from ordinary mail, work out how to turn each one into a
number, test the result, and go back for better features when the model
disappoints. The guesses are hypotheses about the problem, and bad ones cap
what any algorithm can achieve.
The strength of this recipe, features plus labels plus the loop, is that it
can weigh hundreds of weak signals at once, which no hand-written rule set
manages. Its ceiling is the features themselves: the model can only be as
observant as the properties someone thought to measure. That ceiling is what
neural networks later removed, by learning the features
too (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Les algorithmes ne lisent pas les courriels comme les humains : il leur faut
des nombres. Chaque exemple doit donc être décrit par un ensemble de
propriétés mesurables : la longueur du message, la présence de l’expéditeur
dans votre carnet d’adresses (encodée en général par 1 si oui, 0 si non), le
nombre de liens, la présence des mots gagner, gratuit ou miracle. Chacune
de ces propriétés est un attribut.
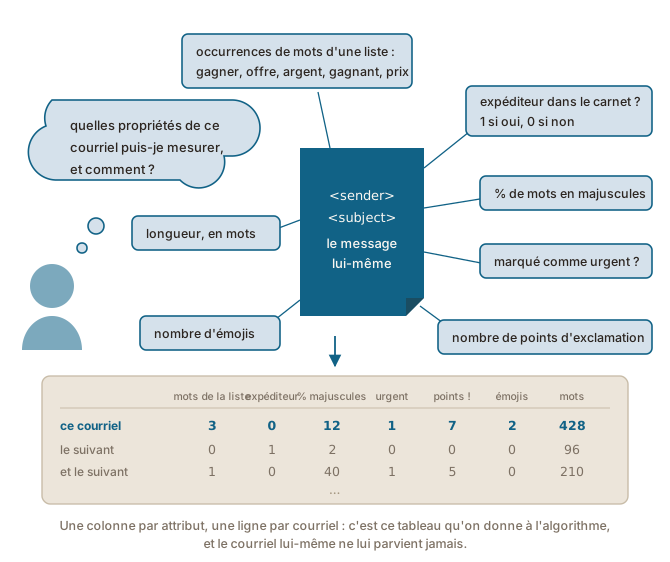
Figure 5. L'ingénierie des attributs, c'est cette décision, prise par une personne : quelles propriétés d'un courriel pourraient séparer le pourriel du courrier ordinaire, comment chacune devient un nombre, et donc à quoi ressemble le tableau.
En apprentissage automatique traditionnel, le choix des attributs est un
travail humain, et c’est là que passe l’essentiel du métier. Quelqu’un doit
deviner quelles propriétés distinguent le pourriel du courrier ordinaire,
trouver comment transformer chacune en nombre, tester le résultat et repartir
en chercher de meilleures quand le modèle déçoit. Ces suppositions sont des
hypothèses sur le problème, et les mauvaises plafonnent ce que n’importe quel
algorithme peut atteindre.
La force de cette recette, des attributs plus des étiquettes plus la boucle,
est de pouvoir peser des centaines de signaux faibles à la fois, ce qu’aucun
ensemble de règles écrites à la main ne réussit. Son plafond, ce sont les
attributs eux-mêmes : le modèle ne peut être plus observateur que les
propriétés que quelqu’un a pensé à mesurer. Ce plafond, ce sont les réseaux de
neurones qui l’ont levé plus tard, en apprenant aussi les
attributs (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Figure 6. One example, one set of features, two tasks: the answer is a category on one side and a number on the other.
The distinction is about the answer, not about the data. A customer review
supports both: a classifier decides whether it is positive or negative, and a
regression predicts the rating the reviewer gave, 1 to 5 stars, from the same
features. And the training loop does not change either way: predict, compare
with the label, adjust.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Figure 6. Un exemple, un jeu d'attributs, deux tâches : d'un côté la réponse est une catégorie, de l'autre un nombre.
La distinction porte sur la réponse, pas sur les données. Une critique de
client se prête aux deux : un classifieur décide si elle est positive ou
négative, et une régression prédit la note que la personne a donnée, de 1 à 5
étoiles, à partir des mêmes attributs. Et la boucle d’entraînement ne change
pas non plus : prédire, comparer à l’étiquette, ajuster.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Three kinds of learningTrois types d'apprentissage
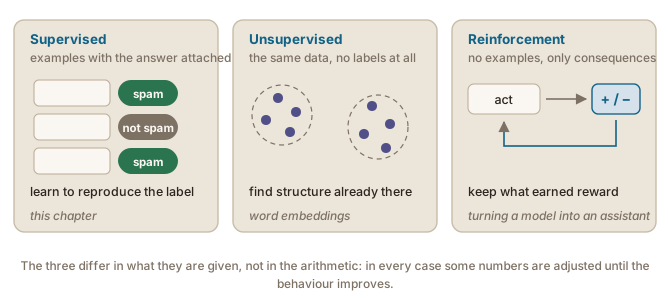
Labelled examples are one way to learn, and the one this chapter follows,
because it is the clearest and the most common. Two other families complete
the standard picture.
Figure 7. The three families differ in what they are given: examples with answers, data with no answers, or consequences of acting.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
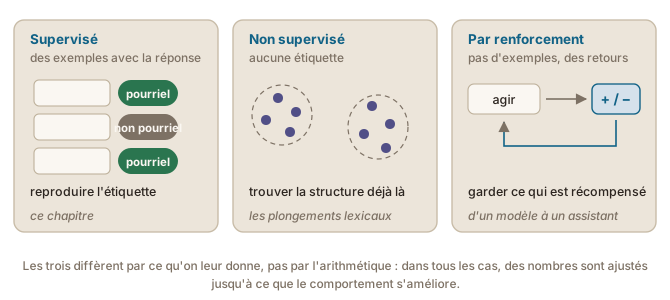
Les exemples étiquetés sont une façon d’apprendre, celle que suit ce
chapitre, parce qu’elle est la plus claire et la plus répandue. Deux autres
familles complètent le tableau habituel.
Figure 7. Les trois familles diffèrent par ce qu'on leur donne : des exemples avec les réponses, des données sans réponses, ou les conséquences de leurs actions.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Though you can do some impressive things with feature engineering, these
systems tend to all hit the same wall. Features like suffixes and
capitalization describe the form of a word. They say nothing about what it
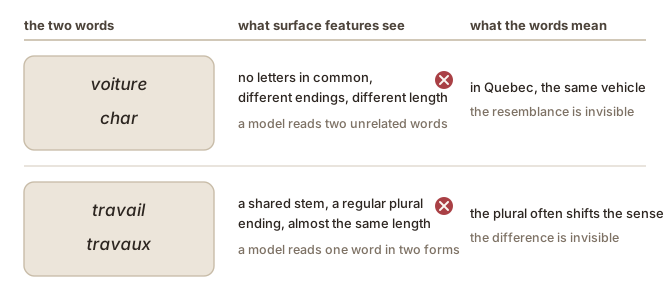
means. To a feature-based model, voiture and char are simply two different
sequences of letters, though in Quebec both can mean car; travail (work) and travaux
(roadworks) look like the singular and plural of one word, though the plural
often shifts the meaning. The way past the wall was to stop describing words
by hand-picked properties and let a system learn, from how words are used, a
numerical representation of the words
themselves (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
Figure 8. Form and meaning come apart in both directions. Words that look nothing alike can name the same thing, and words that look like one word can part company in meaning.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
On peut faire des choses impressionnantes avec l’ingénierie des attributs, et
pourtant ces systèmes butent tous sur le même mur. Des attributs comme les
suffixes et les majuscules décrivent la forme d’un mot. Ils ne disent rien
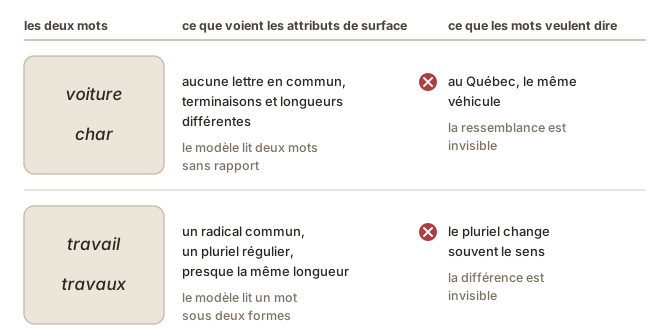
de ce qu’il veut dire. Pour un modèle fondé sur des attributs, voiture et
char sont simplement deux suites de lettres différentes, alors qu’au Québec les deux
peuvent désigner le même véhicule ; travail et travaux ont l’air du
singulier et du pluriel d’un même mot, alors que le pluriel en change souvent
le sens. Pour passer le mur, il a fallu cesser de décrire les mots par des
propriétés choisies à la main et laisser un système apprendre, à partir de la
façon dont les mots sont employés, une représentation numérique des mots
eux-mêmes (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
Figure 8. La forme et le sens se séparent dans les deux directions. Des mots qui ne se ressemblent pas peuvent nommer la même chose, et des mots qui ont l'air d'un seul mot peuvent diverger de sens.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
A tour of NLP tasksTour d'horizon des tâches du TAL
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
What natural language processing doesCe que fait le traitement automatique de la langue
The field behind the tools you use
Your word processor underlines a misspelled word. Your phone proposes the
rest of the word you are typing. A search engine returns pages that say what
you asked in other words. A video gets subtitles in a language its speakers
do not know. Behind each of these is a program that takes human language as
its input, as text or as speech, and does something with it. The field that
builds such programs is natural language processing.
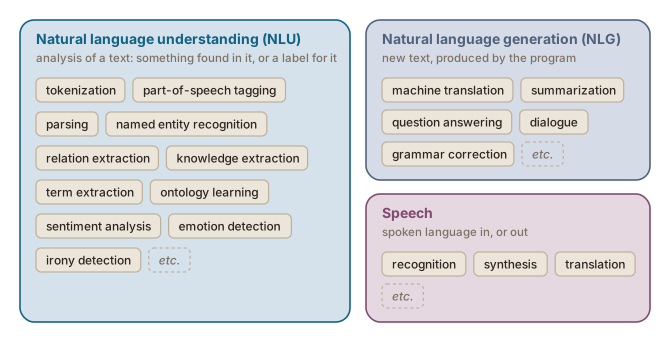
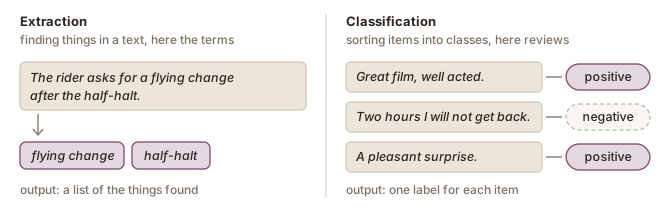
Tasks that read a text and return something found in it, or a label for it,
are grouped under natural language understanding (NLU; in French,
compréhension du langage naturel). Tasks that produce new text are grouped
under natural language generation (NLG; génération automatique de textes,
GAT). Tasks on speech take spoken language in or give it out
(Figure 1figure 1).
Figure 1. Common tasks of NLP: natural language understanding, natural language generation, and speech.
The two groups overlap: a translation system has to read before it writes,
and a chatbot does both at every turn.
Tasks inside everyday tools
Most of these tasks are already in the tools you use, where you do not see
them as tasks:
the spelling checker and the grammar checker in a word processor;
the lemmatized word lists and the searches by grammatical class of a
concordancer (see also the Corpus analysis module) (voir aussi le module L'analyse de corpus);
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Le domaine derrière les outils du quotidien
Votre traitement de texte souligne un mot mal orthographié. Votre téléphone
propose la fin du mot que vous tapez. Un moteur de recherche renvoie des
pages qui disent ce que vous avez demandé en d’autres mots. Une vidéo reçoit
des sous-titres dans une langue que ses locuteurs ne connaissent pas.
Derrière chacun de ces cas se trouve un programme qui prend la langue humaine
en entrée, à l’écrit ou à l’oral, et en fait quelque chose. Le domaine qui
conçoit ces programmes est le traitement automatique de la langue.
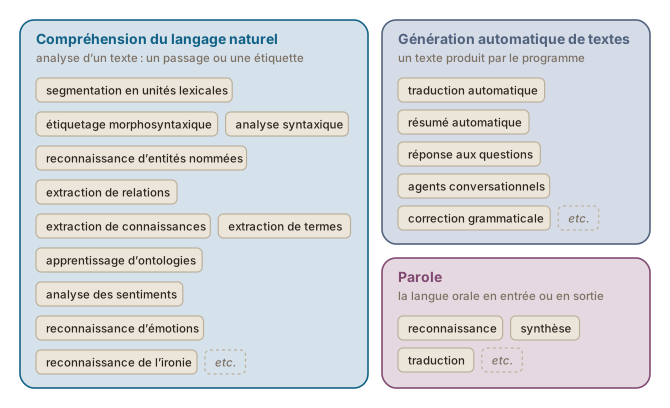
Les tâches qui lisent un texte et renvoient quelque chose qui s’y trouve, ou
une étiquette qui le décrit, sont regroupées sous la compréhension du langage
naturel (angl. natural language understanding, NLU). Les tâches qui
produisent un texte nouveau relèvent de la génération automatique de textes
(GAT, angl. natural language generation, NLG). Les tâches sur la parole
prennent la langue orale en entrée ou la produisent
(Figure 1figure 1).
Figure 1. Tâches courantes du TAL : compréhension du langage naturel, génération automatique de textes et parole.
Les deux groupes se recoupent : un système de traduction doit lire avant
d’écrire, et un agent conversationnel fait les deux à chaque échange.
Des tâches dans les outils du quotidien
La plupart de ces tâches se trouvent déjà dans les outils que vous utilisez,
où vous ne les voyez pas comme des tâches :
le correcteur orthographique et le correcteur grammatical d’un traitement
de texte ;
les listes de mots lemmatisés et les recherches par catégorie grammaticale
d’un concordancier (see also the Corpus analysis module) (voir aussi le module L'analyse de corpus) ;
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Named entity recognition: one task up closeLa reconnaissance d'entités nommées : une tâche vue de près
What the task does
In the sentence In March, Marie Tremblay left Hydro-Québec for a job
at McGill University in Montreal, a reader recognizes four names without
effort: a person, two organizations and a city. Named entity recognition is
the task of doing the same automatically: finding every stretch of a text
that is a proper name, and labelling its type
(Figure 2figure 2).
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. A sentence and the output of named entity recognition: four stretches, each with a type.
Four types are used most often, for persons, organizations, locations and
geopolitical entities such as countries. The task is often extended to
dates, times and amounts of money, which are not names in the strict sense
(Jurafsky & Martin, 2026).
Applications add their own types, for instance products, works of art or,
in medicine, genes and proteins.
Where it gets hard
The task sounds simple because reading a name is simple for you.
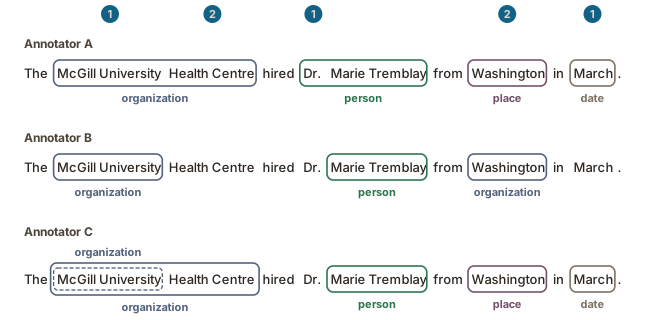
Figure 3figure 3 shows one sentence annotated by
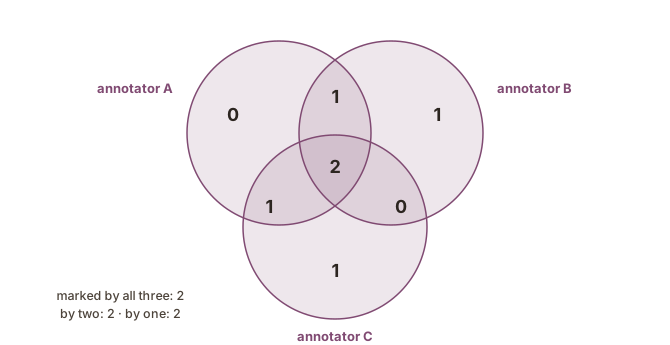
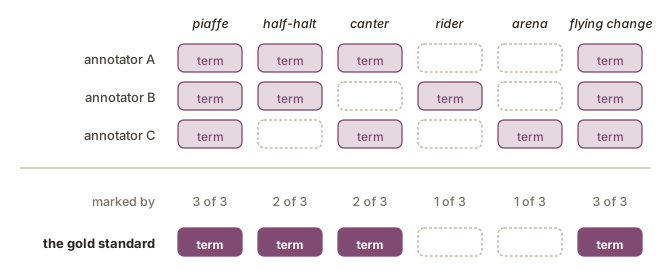
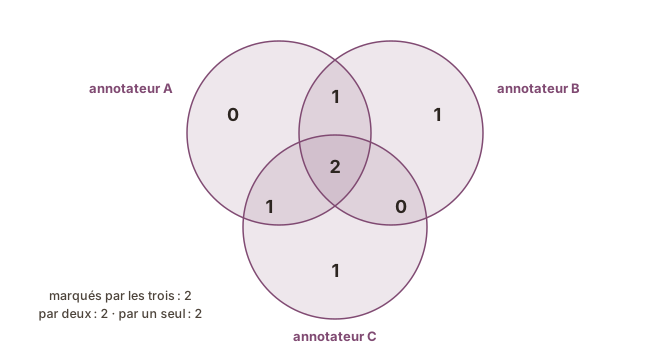
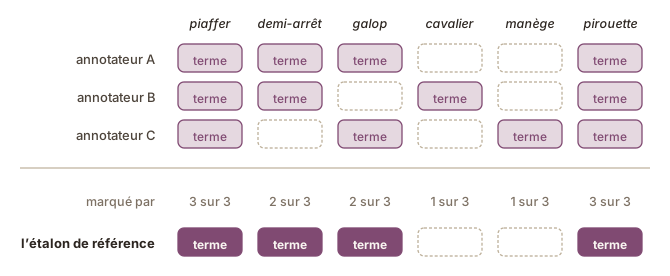
three people: they agree that Marie Tremblay is a person, and differ on
five points, numbered above the sentence.
Figure 3. One sentence, annotated by three people. The numbers refer to the rows of the table below.
The difficulties of the task are of three kinds. The table below sorts them,
with the cases from the figure and a few others.
Difficulty
Examples
For people
For a program
① Decided by the guidelines
Does Dr. belong to the person? Does March count? Is McGill University also marked inside the longer name? Elsewhere: the status of job titles, products or nicknames.
Most are easy when the guidelines are clear; where they say nothing, people disagree too.
Depends on whether its rules cover these cases, or whether its training examples contain enough of them, and on how easy they are to recognize in the text.
② Hard for people and programs
Where the name stops: the health centre or the university, two different organizations; finding where a name begins and ends is part of the task (Jurafsky & Martin, 2026). Washington: the city, the state or, as a shorthand, the American government.
People disagree even with guidelines, because the sentence can be read either way.
The same difficulty: nothing in the sentence decides.
③ Hard mainly for programs
Washington is a president, a city or a sports team depending on the sentence (Jurafsky & Martin, 2026). A name never seen before: a new company, a name from another language, a name written without a capital letter.
People rarely hesitate when the sentence settles the type.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Ce que fait la tâche
Dans la phrase En mars, Marie Tremblay a quitté Hydro-Québec pour
l’Université McGill, à Montréal, on reconnaît sans effort quatre noms :
une personne, deux organisations et une ville. La reconnaissance d’entités
nommées consiste à faire la même chose automatiquement : trouver chaque
passage d’un texte qui est un nom propre et en indiquer le type
(Figure 2figure 2).
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. Une phrase et la sortie de la reconnaissance d'entités nommées : quatre passages, chacun avec un type.
Quatre types sont les plus courants : les personnes, les organisations, les
lieux et les entités géopolitiques comme les pays. La tâche est souvent
élargie aux dates, aux heures et aux sommes d’argent, qui ne sont pas des
noms au sens strict (Jurafsky & Martin, 2026). Les applications ajoutent
leurs propres types, par exemple des produits, des œuvres d’art ou, en
médecine, des gènes et des protéines.
Là où la tâche se complique
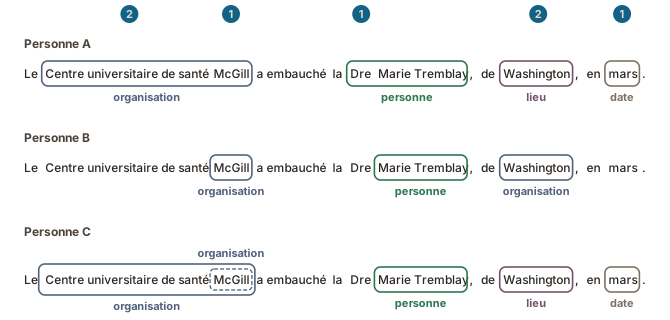
La tâche paraît simple parce que lire un nom est simple pour vous. La Figure 3figure 3 montre une
phrase annotée par trois personnes : elles s’accordent sur le fait que
Marie Tremblay est une personne, et divergent sur cinq points, numérotés
au-dessus de la phrase.
Figure 3. Une phrase, annotée par trois personnes. Les chiffres renvoient aux lignes du tableau ci-dessous.
Les difficultés de la tâche sont de trois sortes. Le tableau ci-dessous les
range avec les cas de la figure et d’autres exemples.
Difficulté
Exemples
Pour les personnes
Pour un programme
① Réglée par les consignes d’annotation
Dre fait-il partie du nom ? mars compte-t-il ? McGill s’annote-t-il aussi à l’intérieur du nom plus long ? Ailleurs : le statut des titres de fonction, des produits ou des surnoms.
La plupart sont faciles quand les consignes sont claires ; là où elles ne disent rien, les personnes divergent aussi.
Tout dépend de ce que couvrent ses règles, ou de la présence de ces cas en nombre suffisant dans ses exemples d’entraînement, et de la facilité à les reconnaître dans le texte.
② Difficile pour les personnes comme pour les programmes
L’endroit où le nom s’arrête : le centre universitaire de santé ou l’Université McGill dont il relève, deux organisations différentes ; trouver où un nom commence et où il finit fait partie de la tâche (Jurafsky & Martin, 2026). Washington : la ville, l’État ou, par raccourci, le gouvernement américain.
Divergent même avec des consignes, parce que la phrase se lit de deux façons.
Même difficulté : rien dans la phrase ne tranche.
③ Difficile surtout pour les programmes
Washington est un président, une ville ou une équipe sportive selon la phrase (Jurafsky & Martin, 2026). Un nom jamais vu : une nouvelle entreprise, un nom d’une autre langue, un nom écrit sans majuscule.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
From NLP pipelines to language modelsDes chaînes de traitement aux modèles de langue
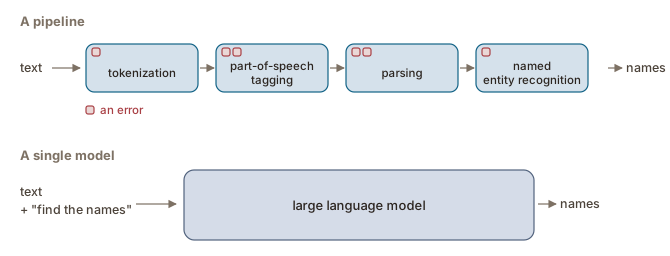
Often runs on your own computer, although many tools, machine translation among them, are online services
Usually a service run by a provider, which receives the text, although some models can run on your own computer
A pipeline of dedicated components and a single large language model, compared from the side of whoever builds the system and of whoever uses it.
The tasks have not disappeared. They are still the units in which systems
are judged: a model is evaluated on named entity recognition, on
translation or on summarization, one task at a time, against answers
produced by people, and that is how its strengths and its gaps are
found (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières). And
pipelines still run inside many of the tools you use: the spelling and
grammar checker of a word processor, the way a search engine matches a query
to pages, or the spam filter of an email inbox are built from components of
this kind.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
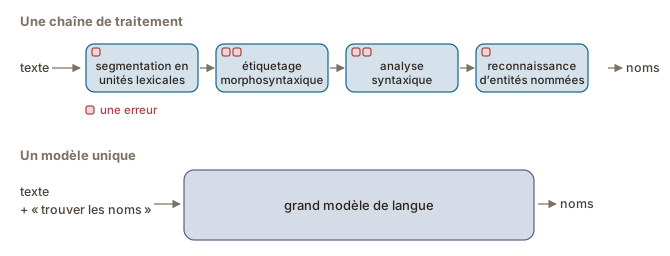
Figure 4. Une chaîne de traitement, où chaque tâche utilise la sortie de la précédente, et un modèle unique à qui l'on demande directement le résultat final.
Chaque composant se construit séparément, avec ses propres règles ou son propre corpus annoté et sa propre évaluation : un effort modeste chaque fois, pour de nombreux composants
Tourne souvent sur votre propre ordinateur, même si beaucoup d’outils, dont la traduction automatique, sont des services en ligne
Généralement un service exploité par un fournisseur, qui reçoit le texte, même si certains modèles peuvent tourner sur votre propre ordinateur
Une chaîne de traitement faite de composants spécialisés et un grand modèle de langue unique, comparés du point de vue de la personne qui construit le système et de celle qui l'utilise.
Les tâches n’ont pas disparu. Elles restent les unités dans lesquelles on
évalue les systèmes : un modèle est évalué sur la reconnaissance d’entités
nommées, la traduction ou le résumé automatique, une tâche à la fois, par
rapport à des réponses produites par des personnes, et c’est ainsi qu’on
découvre ses forces et ses lacunes (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
Et des chaînes de traitement fonctionnent encore dans bien des outils que
vous utilisez : le correcteur orthographique et grammatical d’un traitement
de texte, la façon dont un moteur de recherche associe une requête à des
pages ou le filtre antipourriel d’une messagerie sont construits à partir de
composants de ce type.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Tokenization (including an example of the rule-based approach)La segmentation en unités lexicales (y compris un exemple d'approche à base de règles)
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Counting words: types and tokensCompter les mots : types et occurrences
Two ways to count the words
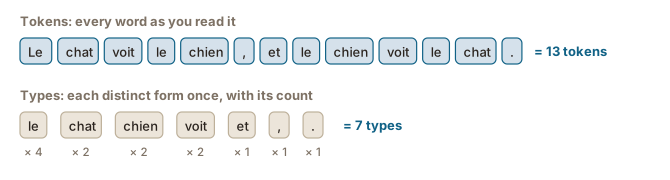
The sentence Le chat voit le chien, et le chien voit le chat. has eleven
words if you count every word as you read it, and five if you count each
distinct word once: le four times, chat, chien and voit twice each,
et once. Counting the comma and the full stop as well gives thirteen and
seven. The occurrences are called tokens, the distinct forms are called
types, as shown in Figure 1figure 1.
Figure 1. One sentence counted twice: thirteen tokens and seven types, with capitals ignored and punctuation marks counted as tokens.
The two counts answer different questions, and so does the ratio between
them, the number of types divided by the number of tokens, called the
type-token ratio. The table below gives examples of each in use.
What the number of tokens, the number of types and the type-token ratio each tell you, with examples of use.
Vanmassenhove et al. (2019, 2021) found machine translations less varied
than human translations of the same texts: frequent words became more
frequent and rare words rarer.Both studies used statistical and
neural systems the authors trained on European Parliament proceedings,
English with French and Spanish, in 2019 and 2021. Less varied is
not necessarily worse: in a technical text, naming the same thing the same
way throughout is what you want (Vanmassenhove et al., 2021). Chatbot output can go the other way: essays
written by ChatGPT were more varied than essays by human writers (Kendro et
al., 2026).Thirty essays each from ChatGPT-3.5, ChatGPT-4, o4-mini
and GPT-4.5 on one argumentative prompt of the TOEFL, against 240 writers of
English as a first or second language, from high school to doctoral
level.
The ratio depends on length
A short text has a high type-token ratio, a whole book a much lower one, and
a large corpus lower still, as the table below shows.The
Gettysburg Address was counted here on the
Bliss copy,
by word form as the corpora were, so cat and cats would be two types;
capitals were ignored and punctuation left out. Jurafsky and Martin do not
say how capitals and punctuation were treated in each corpus. Keeping
capitals would give the address 142 types instead of 138.
Text
Types
Tokens
Types per 1,000 tokens
The Gettysburg Address (Lincoln, 1863)
138
271
509
Shakespeare’s works
29 thousand
884 thousand
33
Brown corpus
38 thousand
1 million
38
Corpus of Contemporary American English (COCA)
2 million
440 million
4.5
Counts of types and tokens in one short speech and three English corpora, with the ratio calculated from them. The corpus counts are rough and come from Jurafsky and Martin (2026, p. 3).
This happens with any text. The more of it you count, the more types you
find, but ever more slowly, since the common words keep recurring and new
words become rarer; the relation is known as Herdan’s law or Heaps’ law
(Jurafsky & Martin, 2026, p. 4). A type-token ratio therefore only compares
texts of a similar length, and studies that compare texts of different
lengths use measures designed to depend less on it (Vanmassenhove et al.,
2019).
Word counts differ from tool to tool
A word count is the number of tokens a tool finds, so two tools can give
two different counts for the same document. The difference has two sources:
The rules of the tool. Whether l’opéra or doesn’t counts as one
word or two, whether peut-être and 1 000 000 stay whole, whether
punctuation counts at all: each tool makes these decisions in its own
way (see also the Hard cases for tokenization page, in the Classical NLP module) (voir aussi la page Les cas difficiles de la segmentation, dans le module TAL classique).
The text the tool counts. A document contains more than its running
text, for instance footnotes, text boxes, headers, the alternative text of
images or the hidden parts of a web page. One tool counts them, another
leaves them out, and a word processor may count them only when a setting
asks it to.
A translation is often quoted and paid by the word, so a count is worth
comparing with the one the other party’s tool gives before relying on it.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Kendro, K., Maloney, J., & Jarvis, S. (2026). Do Large Language Models Produce Texts With “Human-Like” Lexical Diversity? Evidence From Four ChatGPT Models. International Journal of Applied Linguistics, 36(3), 2822–2834. https://doi.org/10.1111/ijal.70115
Vanmassenhove, E., Shterionov, D., & Gwilliam, M. (2021). Machine Translationese: Effects of Algorithmic Bias on Linguistic Complexity in Machine Translation. Proceedings of the 16th Conference of the European Chapter of the Association for Computational Linguistics: Main Volume, 2203–2213. https://doi.org/10.18653/v1/2021.eacl-main.188
Vanmassenhove, E., Shterionov, D., & Way, A. (2019). Lost in Translation: Loss and Decay of Linguistic Richness in Machine Translation. Proceedings of Machine Translation Summit XVII: Research Track, 222–232. https://aclanthology.org/W19-6622/
Deux façons de compter les mots
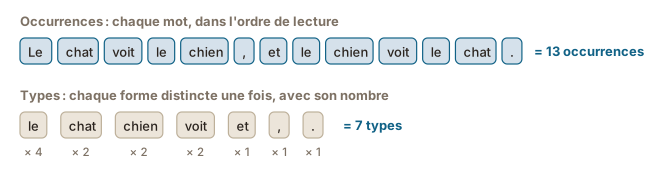
La phrase Le chat voit le chien, et le chien voit le chat. compte onze
mots si l’on compte chaque mot au fil de la lecture, et cinq si l’on ne
compte qu’une fois chaque mot distinct : le quatre fois, chat, chien et
voit deux fois chacun, et une fois. En comptant aussi la virgule et le
point, on obtient treize et sept. Les apparitions s’appellent des
occurrences, les formes distinctes des types, comme le montre la
Figure 1figure 1.
Figure 1. Une phrase comptée deux fois : treize occurrences et sept types, sans tenir compte des majuscules et en comptant les signes de ponctuation comme des occurrences.
Les deux comptes répondent à des questions différentes, tout comme le
rapport entre eux, le nombre de types divisé par le nombre d’occurrences,
appelé rapport types/occurrences (angl. type-token ratio). Le tableau
ci-dessous donne des exemples d’usage de chacun.
Ce qu'indiquent le nombre d'occurrences, le nombre de types et le rapport types/occurrences, avec des exemples d'usage.
Vanmassenhove et al. (2019, 2021) ont constaté que des traductions
automatiques étaient moins variées que des traductions humaines des mêmes
textes : les mots fréquents devenaient plus fréquents, et les mots rares,
plus rares.Les deux études portaient sur des systèmes statistiques
et neuronaux que les auteurs avaient entraînés sur les débats du Parlement
européen, entre l’anglais et le français ou l’espagnol, en 2019 et
2021. Moins varié ne veut pas forcément dire moins bon : dans un
texte technique, nommer la même chose de la même façon d’un bout à l’autre
est précisément ce qu’on cherche (Vanmassenhove et al., 2021). Les textes
produits par un agent conversationnel peuvent aller dans l’autre sens : des
dissertations écrites par ChatGPT étaient plus variées que celles de
rédacteurs humains (Kendro et al., 2026).Trente dissertations
par modèle, de ChatGPT-3.5, ChatGPT-4, o4-mini et GPT-4.5, sur un même sujet
argumentatif du TOEFL, comparées à celles de 240 personnes qui écrivent
l’anglais comme première ou seconde langue, du secondaire au
doctorat.
Le rapport dépend de la longueur
Un texte court a un rapport types/occurrences élevé, un livre entier un
rapport bien plus bas, et un grand corpus un rapport plus bas encore, comme
le montre le tableau ci-dessous.Le discours de Gettysburg a été
compté ici sur la
copie Bliss,
par forme de mot comme les corpus, si bien que cat et cats seraient deux
types ; les majuscules ont été ignorées et la ponctuation laissée de côté.
Jurafsky et Martin ne précisent pas comment les majuscules et la ponctuation
ont été traitées dans chaque corpus. En gardant les majuscules, le discours
compterait 142 types au lieu de 138.
Texte
Types
Occurrences
Types pour 1 000 occurrences
Le discours de Gettysburg (Lincoln, 1863)
138
271
509
Les œuvres de Shakespeare
29 000
884 000
33
Le corpus Brown
38 000
1 million
38
Corpus of Contemporary American English (COCA)
2 millions
440 millions
4,5
Types et occurrences d'un court discours et de trois corpus anglais, avec le rapport calculé à partir de ces chiffres. Les chiffres des corpus sont approximatifs et viennent de Jurafsky et Martin (2026, p. 3).
C’est le cas de tout texte. Plus on en compte, plus on y trouve de types,
mais de plus en plus lentement, puisque les mots courants reviennent sans
cesse et que les mots nouveaux se raréfient ; cette relation s’appelle la loi
de Herdan ou loi de Heaps (Jurafsky & Martin, 2026, p. 4). Un rapport
types/occurrences ne compare donc que des textes de longueur semblable, et
les études qui comparent des textes de longueurs différentes emploient des
mesures conçues pour en dépendre moins (Vanmassenhove et al., 2019).
Le nombre de mots varie d’un outil à l’autre
Un nombre de mots est le nombre d’occurrences qu’un outil trouve ; deux
outils peuvent donc donner deux nombres différents pour un même document. La
différence a deux sources :
Les règles de l’outil. Que l’opéra ou doesn’t compte pour un mot
ou pour deux, que peut-être et 1 000 000 restent entiers, que la
ponctuation compte ou non : chaque outil tranche ces questions à sa
façon (see also the Hard cases for tokenization page, in the Classical NLP module) (voir aussi la page Les cas difficiles de la segmentation, dans le module TAL classique).
Le texte que l’outil compte. Un document contient plus que son texte
courant, par exemple des notes de bas de page, des zones de texte, des
en-têtes, le texte de remplacement des images ou les parties cachées d’une
page Web. Un outil les compte, un autre les laisse de côté, et un
traitement de texte peut ne les compter que si un réglage le demande.
Une traduction est souvent chiffrée et payée au mot : avant de se fier à un
nombre de mots, mieux vaut le comparer à celui que donne l’outil de l’autre
partie.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Kendro, K., Maloney, J., & Jarvis, S. (2026). Do Large Language Models Produce Texts With “Human-Like” Lexical Diversity? Evidence From Four ChatGPT Models. International Journal of Applied Linguistics, 36(3), 2822–2834. https://doi.org/10.1111/ijal.70115
Vanmassenhove, E., Shterionov, D., & Gwilliam, M. (2021). Machine Translationese: Effects of Algorithmic Bias on Linguistic Complexity in Machine Translation. Proceedings of the 16th Conference of the European Chapter of the Association for Computational Linguistics: Main Volume, 2203–2213. https://doi.org/10.18653/v1/2021.eacl-main.188
Vanmassenhove, E., Shterionov, D., & Way, A. (2019). Lost in Translation: Loss and Decay of Linguistic Richness in Machine Translation. Proceedings of Machine Translation Summit XVII: Research Track, 222–232. https://aclanthology.org/W19-6622/
Tokenizing a text with rulesSegmenter un texte avec des règles
A task for rules
Cutting a text into words looks like a task made for rules: it is narrow,
and the rules seem easy to state
completely (see also the Rule-based systems page, in the Foundations of AI & NLP module) (voir aussi la page Les systèmes à base de règles, dans le module Fondements de l'IA et du TAL). You do it
without thinking, the first rule is obvious, and nothing about it seems to
need understanding.
Writing the rules, one text at a time
Writing the rules means testing them on one text after another. Each text
below breaks the rules written so far, and the fix is a new rule or a new
exception
(Figure 2figure 2).
Each text appears first as it is written and as the rules so far cut it:
before moving to the next stage, decide where the cut goes wrong and which
rule you would add.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. Seven French texts, each shown as written and as the rules so far cut it, then as the new rules cut it, with the list of rules it takes.
Two of these rules are unlike the others. The fixed expressions such as
aujourd’hui cannot be described by a pattern: someone has to write them
out, and the list is never complete. And unfusing au, du and des is
right for a tool that analyzes grammar, which needs à le, but a tool that
counts words would leave them whole: the right cut depends on what the
output is for.
Seven short texts already need three rules and seven exceptions, and the
list is far from complete. A task that looks simple becomes complex very
quickly.
The list is written for one language and one kind of text. French
numbers use a comma where English numbers use a full stop, and a rule set
for tweets is not a rule set for legal documents.
The list is never finished, because language keeps producing cases
nobody wrote a rule for.
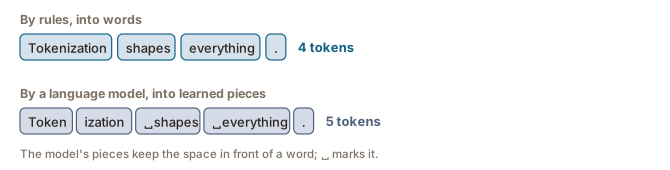
Figure 3. One sentence cut by a rule-based tokenizer, into four words, and by the tokenizer of a language model, into five pieces. The second cut was read off OpenAI's o200k_base vocabulary on 29 August 2026.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Une tâche pour des règles
Couper un texte en mots semble une tâche faite pour des règles : elle est
étroite, et les règles paraissent faciles à énoncer
entièrement (see also the Rule-based systems page, in the Foundations of AI & NLP module) (voir aussi la page Les systèmes à base de règles, dans le module Fondements de l'IA et du TAL). Vous la
faites sans y penser, la première règle est évidente, et rien ne semble
demander de comprendre quoi que ce soit.
Écrire les règles, un texte à la fois
Écrire les règles, c’est les tester sur un texte après l’autre. Chaque texte
ci-dessous met en défaut les règles écrites jusque-là, et la correction est
une nouvelle règle ou une nouvelle exception
(Figure 2figure 2).
Chaque texte apparaît d’abord tel qu’il est écrit et tel que les règles déjà
là le coupent : avant de passer à l’étape suivante, repérez où la coupe se
trompe et quelle règle vous ajouteriez.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. Sept textes français, chacun montré tel qu'écrit et tel que le coupent les règles déjà là, puis tel que le coupent les nouvelles règles, avec la liste des règles qu'il faut.
Deux de ces règles ne ressemblent pas aux autres. Les expressions figées
comme aujourd’hui ne se décrivent pas par un motif : quelqu’un doit en
rédiger la liste, et cette liste n’est jamais complète. Et décomposer au,
du et des convient à un outil qui analyse la grammaire, qui a besoin de
à le, mais un outil qui compte les mots les laisserait entiers : la bonne
coupe dépend de l’usage qu’on fera du résultat.
Sept textes courts demandent déjà trois règles et sept exceptions, et la
liste est loin d’être complète. Une tâche qui paraît simple devient
complexe très vite.
La liste est écrite pour une langue et un type de texte. Les nombres
français emploient une virgule là où les nombres anglais emploient un
point, et un ensemble de règles pour des messages de réseaux sociaux ne convient pas à des
documents juridiques.
La liste n’est jamais terminée, parce que la langue produit sans cesse
des cas pour lesquels personne n’a écrit de règle.
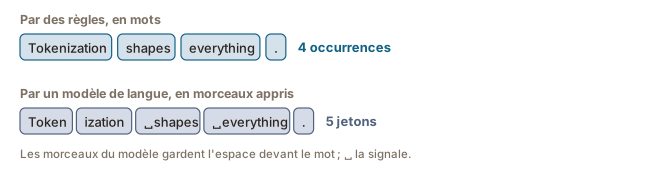
Figure 3. Une phrase anglaise coupée par un segmenteur à base de règles, en quatre mots, et par le segmenteur d'un modèle de langue, en cinq morceaux. La seconde coupe a été relevée dans le vocabulaire o200k_base d'OpenAI le 29 août 2026.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Hard cases for tokenizationLes cas difficiles de la segmentation
The cases a rule set has to cover
The table below lists common cases where splitting at spaces and punctuation
is not enough, with what makes each one hard.
Case
Examples
What breaks
Dates
01/01/25, 01-01-2025, 1er janvier 2025
Slashes and hyphens are punctuation elsewhere; the same date has many forms
Amounts and units
3 €, €3, 3€, 10 km, 10km
A space, or none, between number and symbol; the symbol before or after
Phone numbers
(514) 343-6111, 00.11.22.33.44
Brackets, hyphens, spaces and full stops inside one unit
Abbreviations
Dr., etc., p. ex., M.
The full stop belongs to the word and does not end the sentence
Compounds and multiword units
peut-être, chef-d’œuvre, pomme de terre, disque dur
One unit written with a hyphen, an apostrophe or spaces
Names
New York, Jean-Pierre, l’Université de Montréal
Several words, or a hyphen, or an elision, in one name
Clitics and contractions
l’opéra, doesn’t, du (de le)
A piece that cannot stand alone, attached to the next or previous word: one written word, two grammatical ones
Words cut at a line end
segmen- at the end of one line, tation at the start of the next
A hyphen that is not part of the word
Social media
#TAL, @umontreal, :), <3
Symbols that are part of a word or are a word
Mixed forms
C++, rock ‘n’ roll, f*ck
Punctuation inside a word
Bullets and numbering
1., a), •
A full stop or bracket that is not punctuation in the usual sense
Cases that break the simple rules of tokenization, with an example of each.
Every row needs its own rule, and the rules interact: a full stop may end a
sentence, mark an abbreviation, appear inside a number or inside an address,
and the tokenizer has to tell which from the characters around
it (see also the Segmenting a text into sentences page, in the Classical NLP module) (voir aussi la page Segmenter un texte en phrases, dans le module TAL classique).
Writing systems without spaces
Chinese, Japanese and Thai do not separate words with spaces, so there is no
first rule to start from. For Chinese, one option is to treat each
character as a unit, which works quite well because a character generally
stands for a meaningful unit of its own; for Japanese and Thai, where the individual
character is too small a unit, the words have to be found by other means
(Jurafsky & Martin, 2026). A rule set written for a language with spaces
has nothing to say about these languages at all.
Every tool has its own conventions
Since every one of these cases is a decision, two tokenizers seldom make all
of them the same way, and the same text comes out with different counts in
different tools. The difference shows wherever words are counted or matched:
in a word count, in a frequency list, in a search for an exact phrase, in the
comparison of two word lists. Knowing that the cuts differ lets you check a
count instead of trusting it. Some conventions are published as standards:
the Penn Treebank convention for English, for instance, splits doesn’t
into does and n’t and keeps hyphenated words together (Jurafsky &
Martin, 2026).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Les cas qu’un ensemble de règles doit couvrir
Le tableau ci-dessous présente des cas courants où couper aux espaces et à
la ponctuation ne suffit pas, avec ce qui rend chacun difficile.
Cas
Exemples
Ce qui pose problème
Dates
01/01/25, 01-01-2025, 1er janvier 2025
Barres obliques et traits d’union sont de la ponctuation ailleurs ; une même date s’écrit de plusieurs façons
Montants et unités
3 €, €3, 3€, 10 km, 10km
Une espace, ou aucune, entre le nombre et le symbole ; le symbole avant ou après
Numéros de téléphone
(514) 343-6111, 00.11.22.33.44
Parenthèses, traits d’union, espaces et points dans une même unité
Abréviations
M., etc., p. ex., Dr.
Le point appartient au mot et ne termine pas la phrase
Mots composés et unités de plusieurs mots
peut-être, chef-d’œuvre, pomme de terre, disque dur
Une seule unité écrite avec un trait d’union, une apostrophe ou des espaces
Noms propres
New York, Jean-Pierre, l’Université de Montréal
Plusieurs mots, un trait d’union ou une élision dans un seul nom
Clitiques et contractions
l’opéra, doesn’t, du (de le)
Un élément qui ne s’emploie pas seul, attaché au mot suivant ou précédent : un mot écrit, deux mots grammaticaux
Mots coupés en fin de ligne
segmen- en fin de ligne, tation au début de la suivante
Un trait d’union qui ne fait pas partie du mot
Réseaux sociaux
#TAL, @umontreal, :), <3
Des symboles qui font partie d’un mot ou qui sont un mot
Formes mixtes
C++, rock ‘n’ roll, f*ck
De la ponctuation à l’intérieur d’un mot
Puces et numérotation
1., a), •
Un point ou une parenthèse qui n’est pas de la ponctuation au sens habituel
Des cas qui mettent en défaut les règles simples de la segmentation, avec des exemples de chacun.
Chaque ligne demande sa propre règle, et les règles interagissent : un point
peut terminer une phrase, marquer une abréviation, apparaître dans un nombre
ou dans une adresse, et le segmenteur doit déterminer lequel d’après les
caractères qui l’entourent (see also the Segmenting a text into sentences page, in the Classical NLP module) (voir aussi la page Segmenter un texte en phrases, dans le module TAL classique).
Les écritures sans espaces
Le chinois, le japonais et le thaï ne séparent pas les mots par des espaces :
il n’y a donc pas de première règle par laquelle commencer. Pour le chinois,
une solution consiste à traiter chaque caractère comme une unité, ce qui
fonctionne assez bien parce qu’un caractère correspond en général à une
unité de sens ; pour le japonais et le thaï, où le caractère isolé est une
unité trop petite, il faut trouver les mots autrement (Jurafsky & Martin,
2026). Un ensemble de règles écrit pour une langue à espaces n’a rien à dire
sur ces langues.
Chaque outil a ses conventions
Puisque chacun de ces cas est une décision, deux segmenteurs les tranchent
rarement tous de la même façon, et un même texte donne des comptes
différents dans des outils différents. La différence apparaît partout où
l’on compte ou compare des mots : dans un nombre de mots, dans une liste de
fréquences, dans une recherche d’expression exacte, dans la comparaison de
deux listes de mots. Savoir que les coupes diffèrent permet de vérifier un
compte au lieu de s’y fier. Certaines conventions sont publiées comme des
normes : la convention du Penn Treebank pour l’anglais, par exemple, coupe
doesn’t en does et n’t et garde entiers les mots à trait d’union
(Jurafsky & Martin, 2026).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Segmenting a text into sentencesSegmenter un texte en phrases
A task of its own
Cutting a text into sentences is a task of its own, and the full stop is
the whole difficulty.
Question marks and exclamation marks almost always end a sentence. A full
stop ends a sentence, marks an abbreviation such as Dr. or etc., appears
inside a number such as 3.5 and inside an address, and sometimes does two
of these at once, as the last full stop of a sentence ending in etc. does
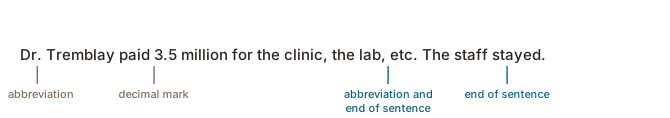
(Jurafsky & Martin, 2026). Figure 4figure 4
puts four of them in one sentence.
Figure 4. Four full stops in one sentence, doing three jobs.
Rules for sentences
Many sentence splitters first decide, for each full stop, whether it
belongs to a word or ends a sentence. The decision is often made by rules
and sometimes learned from examples, and a dictionary of abbreviations
helps, which can itself be written by hand or learned (Jurafsky & Martin,
2026).
Written as rules, the decision for the full stop alone already nests, each
exception settling a case that the line above got wrong:
Split at a full stop: it ends the sentence.
except when no space follows: a number or an address, as in 3.5
or umontreal.ca;
except when the next word starts with a lowercase letter: an
abbreviation inside a sentence, as in the lab, etc. and the staff;
except after a title from a list written out by hand, even when a
space and a capital follow: Dr. Tremblay, M. Dupont;
but after another abbreviation followed by a space and a capital,
the full stop does both jobs at once: in etc. The staff stayed., it
belongs to etc. and ends the sentence.
The four full stops of Figure 4figure 4
each fall under a different line. Every exception also opens a new gap: a
sentence that starts with a lowercase word, such as a brand name like
iPhone, is not split from the one before it, and an abbreviation missing
from the list is read as the end of a sentence.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Une tâche à part entière
Couper un texte en phrases est une tâche à part entière, et toute la
difficulté vient du point.
Les points d’interrogation et d’exclamation terminent presque toujours une
phrase. Un point termine une phrase, marque une abréviation comme M. ou
etc., apparaît dans un numéro de version comme 2.5 et dans une adresse,
et joue parfois deux de ces rôles à la fois, comme le dernier point d’une
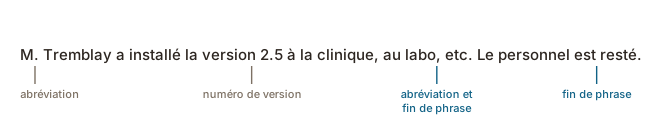
phrase qui se termine par etc. (Jurafsky & Martin, 2026). La Figure 4figure 4 en réunit quatre dans une même phrase.
Figure 4. Quatre points dans une même phrase, avec trois rôles.
Des règles pour les phrases
Beaucoup de segmenteurs de phrases décident d’abord, pour chaque point, s’il
appartient à un mot ou s’il termine une phrase. Cette décision est souvent
prise par des règles, parfois apprise à partir d’exemples, et un
dictionnaire d’abréviations aide, dictionnaire qui peut lui-même être
rédigé à la main ou appris (Jurafsky & Martin, 2026).
Écrite sous forme de règles, la décision pour le seul point s’emboîte déjà,
chaque exception réglant un cas que la ligne au-dessus traitait mal :
Couper à un point : il termine la phrase.
sauf quand aucune espace ne suit : un numéro ou une adresse, comme
2.5 ou umontreal.ca ;
sauf quand le mot suivant commence par une minuscule : une
abréviation au milieu d’une phrase, comme dans au labo, etc. et le
personnel ;
sauf après un titre d’une liste rédigée à la main, même quand une
espace et une majuscule suivent : M. Tremblay ;
mais après une autre abréviation suivie d’une espace et d’une
majuscule, le point joue les deux rôles à la fois : dans etc. Le
personnel est resté., il appartient à etc. et termine la phrase.
Les quatre points de la Figure 4figure 4 relèvent chacun d’une ligne différente. Chaque exception ouvre aussi une
nouvelle brèche : une phrase qui commence par une minuscule, par exemple un
nom de marque comme iPhone, n’est pas séparée de la précédente, et une
abréviation absente de la liste est lue comme une fin de phrase.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Part-of-speech tagging (including an example of machine learning)L'étiquetage morphosyntaxique (y compris un exemple d'apprentissage automatique)
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Word classes and part-of-speech tagsetsClasses de mots et jeux d'étiquettes morphosyntaxiques
A label for every word
In the sentence Mary loves reading books, you can say of every word
what kind of word it is: a proper noun, a verb, another verb, a noun. Part-of-speech tagging does this automatically for every word of a
text, and the result is written with a tag after each word:
Mary/PROPN loves/VERB reading/VERB books/NOUN.
The classes themselves are older than computers. Grammars have sorted words
into nouns, verbs, adjectives and the rest for two millennia, and the
classes are defined by how a word behaves with its neighbours and by the
endings it takes, not by what it means: a noun is a word that can follow a
determiner and take a plural, whatever it refers to (Jurafsky & Martin,
2026).
Figure 1. The 17 part-of-speech tags of Universal Dependencies (de Marneffe et al., 2021), with an English example for each.
Classes come in two kinds. Nouns, verbs, adjectives and
adverbs are open classes: new members appear all the time, as selfie
and to google did. Determiners, pronouns, prepositions and conjunctions
are closed classes: a few dozen words each, rarely added to, very frequent,
and doing the structural work of a sentence (Jurafsky & Martin, 2026).
Figure 1figure 1 shows
the seventeen classes of the tagset that Universal Dependencies, a large
collection of annotated corpora, uses for more than a hundred languages (de Marneffe et
al., 2021).
Tagsets differ
Those seventeen tags are one choice among many. A tagset is a decision about
how finely to cut the classes, and different projects have cut them very
differently.
The table below sets some of them side by side, from the seventeen
universal tags to sets that fold number, tense, case or gender into the
tag.The French and Dutch counts were checked on 6 October 2026 at
their sources: TreeTagger’s French tagset,
the label list of a CamemBERT tagger
trained on the French Treebank, and the documentation of the Spoken Dutch
Corpus.
Tagset
Language
Tags
What the extra tags record
Universal Dependencies
more than a hundred languages
17
n.a.; number, tense and gender are expressed as separate features per word
Penn Treebank
English
45
Singular against plural nouns, past tense against past participle, and so on
TreeTagger
French
33
Verb tenses and moods, pronoun types
French Treebank (used by a CamemBERT tagger)
French
29
Verb moods, pronoun types
MULTITAG
French
about 1 500
Gender and number, and for verbs mood and tense, folded into the tag (Allauzen & Bonneau-Maynard, 2008)
Spoken Dutch Corpus (CGN)
Dutch
316
Number, gender, case, tense and more, folded into the tag
Tagsets for Czech, Hungarian, Turkish
languages with rich morphology
4 to 10 times an English set
Case, number and gender (Jurafsky & Martin, 2026)
Tagsets of very different sizes, for the same task.
The information does not disappear when the tagset is small; it is encoded
elsewhere. Universal Dependencies keeps its seventeen tags and records
number, tense or gender as separate features attached to the word (de
Marneffe et al., 2021), where a larger tagset folds them into the tag
itself. Figure 2figure 2
shows the two conventions on two English words. When you read the output of a
tagger, the first thing to find out is which tagset it used, since ADJ in one and JJ in another may be the same class, and
NN in one may be two classes in another.
Figure 2. The same information in one tag (Penn Treebank) or in a short tag plus features (Universal Dependencies), as mapped by the Universal Dependencies conversion table for the Penn Treebank tags.
Sources
Allauzen, A., & Bonneau-Maynard, H. (2008). Training and Evaluation of POS Taggers on the French MULTITAG Corpus. Proceedings of the Sixth International Conference on Language Resources and Evaluation (LREC'08), Marrakech, 3373–3377. https://aclanthology.org/L08-1368/
de Marneffe, M.-C., Manning, C. D., Nivre, J., & Zeman, D. (2021). Universal Dependencies. Computational Linguistics, 47(2), 255–308. https://doi.org/10.1162/coli_a_00402
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Une étiquette pour chaque mot
Dans la phrase Marie adore lire des livres, vous pouvez dire de chaque mot
de quel type de mot il s’agit : un nom propre, un verbe, un autre verbe, un
déterminant, un nom. L’étiquetage morphosyntaxique fait la même chose
automatiquement pour chaque mot d’un texte, et le résultat s’écrit avec une
étiquette après chaque mot :
Marie/PROPN adore/VERB lire/VERB des/DET livres/NOUN.
La tâche prend un texte déjà découpé en
mots (see also the Tokenization (including an example of the rule-based approach) chapter, in the Classical NLP module) (voir aussi le chapitre La segmentation en unités lexicales (y compris un exemple d'approche à base de règles), dans le module TAL classique) et donne à
chacun exactement une étiquette (Jurafsky & Martin, 2026). Elle est rarement
le bout d’une chaîne de traitement et presque toujours une étape à
l’intérieur : un concordancier se sert des étiquettes pour vous laisser
chercher tous les noms qui suivent un verbe donné, et un correcteur
grammatical s’en sert, entre autres informations, pour vérifier qu’un verbe
s’accorde avec son sujet.
Classes ouvertes et classes fermées
Les classes elles-mêmes sont plus anciennes que les ordinateurs. Les
grammaires répartissent les mots en noms, verbes, adjectifs et ainsi de suite
depuis deux millénaires, et les classes se définissent par le comportement
d’un mot avec ses voisins et par les terminaisons qu’il prend, non par ce
qu’il veut dire : un nom est un mot qui peut suivre un déterminant et prendre
un pluriel, quoi qu’il désigne (Jurafsky & Martin, 2026).
Figure 1. Les 17 étiquettes morphosyntaxiques d'Universal Dependencies (de Marneffe et al., 2021), avec un exemple français pour chacune.
Il y a deux sortes de classes. Les noms, les verbes, les adjectifs et les
adverbes forment des classes ouvertes : de nouveaux membres y entrent sans
cesse, comme courriel et télécharger. Les déterminants, les pronoms, les
prépositions et les conjonctions forment des classes fermées : quelques
dizaines de mots chacune, rarement enrichies, très fréquentes, et qui font le
travail structurel de la phrase (Jurafsky & Martin, 2026).
La Figure 1figure 1 montre les
dix-sept classes du jeu d’étiquettes qu’utilise Universal Dependencies, une
vaste collection de corpus annotés, pour plus de cent langues (de Marneffe et
al., 2021).
Les jeux d’étiquettes diffèrent
Ces dix-sept étiquettes sont un choix parmi d’autres. Un jeu d’étiquettes est
une décision sur la finesse du découpage des classes, et les projets l’ont
tranchée de façons très différentes.
Le tableau ci-dessous en met quelques-uns côte à côte, des dix-sept
étiquettes universelles aux jeux qui intègrent le nombre, le temps, le cas ou
le genre dans l’étiquette.Les chiffres pour le français et le
néerlandais ont été vérifiés le 6 octobre 2026 à leur source : le jeu
d’étiquettes français de TreeTagger,
la liste d’étiquettes d’un étiqueteur CamemBERT
entraîné sur le French Treebank, et la documentation du Spoken Dutch
Corpus.
Jeu d’étiquettes
Langue
Étiquettes
Ce que consignent les étiquettes supplémentaires
Universal Dependencies
plus de cent langues
17
sans objet ; le nombre, le temps et le genre sont exprimés par des traits distincts, mot par mot
Penn Treebank
anglais
45
Nom singulier ou pluriel, passé ou participe passé, etc.
TreeTagger
français
33
Temps et modes du verbe, types de pronoms
French Treebank (utilisé par un étiqueteur CamemBERT)
français
29
Modes du verbe, types de pronoms
MULTITAG
français
environ 1 500
Genre et nombre, et pour les verbes mode et temps, intégrés à l’étiquette (Allauzen & Bonneau-Maynard, 2008)
Spoken Dutch Corpus (CGN)
néerlandais
316
Nombre, genre, cas, temps et plus, intégrés à l’étiquette
Jeux pour le tchèque, le hongrois, le turc
langues à morphologie riche
4 à 10 fois un jeu anglais
Cas, nombre et genre (Jurafsky & Martin, 2026)
Des jeux d'étiquettes de tailles très différentes, pour la même tâche.
L’information ne disparaît pas quand le jeu d’étiquettes est petit : elle est
codée ailleurs. Universal Dependencies garde ses dix-sept étiquettes et
consigne le nombre, le temps ou le genre sous forme de traits distincts
attachés au mot (de Marneffe et al., 2021), là où un jeu plus grand les
intègre à l’étiquette elle-même. La Figure 2figure 2 montre les deux conventions sur deux mots anglais, puisque le Penn Treebank
est un jeu d’étiquettes pour l’anglais. Quand vous lisez la sortie d’un
étiqueteur, la première chose à vérifier est le jeu d’étiquettes utilisé :
ADJ dans l’un et JJ dans un autre peuvent être la même classe, et NN
dans l’un peut correspondre à deux classes dans un autre.
Figure 2. La même information dans une seule étiquette (Penn Treebank) ou dans une étiquette courte et des traits (Universal Dependencies), selon la table de conversion d'Universal Dependencies pour les étiquettes du Penn Treebank.
Sources
Allauzen, A., & Bonneau-Maynard, H. (2008). Training and Evaluation of POS Taggers on the French MULTITAG Corpus. Proceedings of the Sixth International Conference on Language Resources and Evaluation (LREC'08), Marrakech, 3373–3377. https://aclanthology.org/L08-1368/
de Marneffe, M.-C., Manning, C. D., Nivre, J., & Zeman, D. (2021). Universal Dependencies. Computational Linguistics, 47(2), 255–308. https://doi.org/10.1162/coli_a_00402
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Ambiguous word classesL'ambiguïté des classes de mots
One form, several classes
The reason tagging is a task at all is that the form of a word does not
tell you its class. Book is a verb in book that flight and a noun in
hand me that book; fast is an adjective in a fast car and an adverb in
she runs fast. The table below gives four English words with two readings
each.
Word
One reading
The other
book
Hand me that book. (noun)
Book that flight. (verb)
back
She sat in the back. (noun)
Senators back the bill. (verb)
fast
A fast car. (adjective)
She runs fast. (adverb)
that
That book is mine. (determiner)
The book that I read. (relative pronoun)
Four English words that belong to two classes, with a sentence for each reading.
A tagger therefore cannot simply look a word up: it has to assign each
occurrence one of the word’s possible tags. Tagging is a
disambiguation task (Jurafsky & Martin, 2026).
How much of a text is ambiguous
Counted over the word types of a corpus, ambiguity looks like a minor
problem: in two large English corpora, the Wall Street Journal section of
the Penn Treebank (Marcus et al., 1993) and the Brown corpus (Francis &
Kučera, 1979), about 85 % of
the types have a single possible tag. Counted over the word tokens, it is the
normal case: the
ambiguous types are among the most frequent words of the language, and 55 to
67 % of the tokens in those corpora are ambiguous (Jurafsky & Martin, 2026). Figure 3figure 3
shows the two counts for the Wall Street Journal.
Figure 3. Ambiguity counted over word types and over tokens in the Wall Street Journal section of the Penn Treebank (Jurafsky & Martin, 2026). In the Brown corpus the figures are 15 % and 67 %.
The words with the most readings are short function words and common verbs:
in English that, back, down, put and set; back alone can take six
tags (Jurafsky & Martin, 2026). Word classes are one kind of ambiguity among
several, and frequency goes with the others too. Piantadosi et al. (2012)
found that in English, German and Dutch, more frequent word forms have more
homophones, and that in English more frequent words have more senses, even
with word length taken into account, a link Zipf had already observed. They
read it as efficiency: short, frequent forms are easy to produce and to
process, so a language reuses them for several meanings and leaves the
context to tell them apart.
Where annotators disagree
Ambiguity is not only a problem for programs. When people tag a corpus by
hand, following written guidelines, they agree on about 97 % of the tags,
and many of the remaining 3 % are cases where the grammar gives no clean
answer (Manning, 2011). English -ing forms before a noun are the
classic case, and the table below applies one test to three of them: an
adjective takes very, a verb form does not.
Phrase
With very
Reading
a boring lecture
a very boring lecture works
adjective
the falling leaves
the very falling leaves does not
verb form
sparkling lemonade
very sparkling lemonade: doubtful
between the two, for the guidelines to settle
Three -ing forms before a noun, and what the very test says about each.
Figure 4. A hundred errors of an English tagger on Wall Street Journal text, in the seven classes of Manning (2011), grouped as he discusses them; an error that fitted two classes counted half in each.
Figure 5. An illustration of what 97 % accuracy means.
Sources
Francis, W. N., & Kučera, H. (1979). Manual of information to accompany a standard corpus of present-day edited American English, for use with digital computers. Department of Linguistics, Brown University, Providence, RI (revised and amplified edition; first published 1964). https://listings.lib.msu.edu/public-corpora/cd421/manuals/brown/INDEX.HTM
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Manning, C. D. (2011). Part-of-speech tagging from 97% to 100%: Is it time for some linguistics?. In A. Gelbukh (Ed.), Computational Linguistics and Intelligent Text Processing, CICLing 2011 (Lecture Notes in Computer Science, Vol. 6608, pp. 171–189). Springer. https://doi.org/10.1007/978-3-642-19400-9_14
Marcus, M. P., Santorini, B., & Marcinkiewicz, M. A. (1993). Building a Large Annotated Corpus of English: The Penn Treebank. Computational Linguistics, 19(2), 313–330. https://aclanthology.org/J93-2004/
Si l’étiquetage est une tâche, c’est parce que la forme d’un mot ne dit pas
sa classe. Marche est un verbe dans je marche lentement et un nom dans
une marche en forêt ; fort est un adjectif dans un homme fort et un
adverbe dans il travaille fort. Le tableau ci-dessous donne quatre mots
français à deux lectures.
Mot
Une lecture
L’autre
marche
Je marche lentement. (verbe)
Une marche en forêt. (nom)
livre
Elle me donne un livre. (nom)
Il livre ses pensées. (verbe)
fort
Un homme fort. (adjectif)
Il travaille fort. (adverbe)
que
Le garçon que je vois. (pronom relatif)
Je crois que tu as raison. (conjonction de subordination)
Quatre mots français qui appartiennent à deux classes, avec une phrase pour chaque lecture.
Un étiqueteur ne peut donc pas simplement chercher un mot dans une liste : il
doit attribuer à chaque occurrence l’une des étiquettes possibles du mot.
L’étiquetage est une tâche de désambiguïsation (Jurafsky & Martin, 2026).
Quelle part d’un texte est ambiguë
Comptée sur les types de mots d’un corpus, l’ambiguïté semble un problème
mineur : dans deux grands corpus anglais, la section Wall Street Journal du
Penn Treebank (Marcus et al., 1993) et le corpus Brown (Francis & Kučera,
1979), environ 85 % des
types n’ont qu’une étiquette possible. Comptée sur les occurrences, elle est
la norme : les types ambigus sont parmi les mots les plus fréquents de la
langue, et 55 à 67 % des occurrences de ces corpus sont ambiguës (Jurafsky &
Martin, 2026). La Figure 3figure 3 montre les deux comptes pour le Wall Street Journal.
Figure 3. L'ambiguïté comptée sur les types et sur les occurrences dans la section Wall Street Journal du Penn Treebank (Jurafsky & Martin, 2026). Dans le corpus Brown, les chiffres sont de 15 % et 67 %.
Les mots qui ont le plus de lectures sont de petits mots grammaticaux et des
verbes courants : en anglais that, back, down, put et set ; back
peut à lui seul prendre six étiquettes (Jurafsky & Martin, 2026). Les classes
de mots sont une forme d’ambiguïté parmi d’autres, et la fréquence va de pair
avec les autres aussi. Piantadosi et al. (2012) ont constaté qu’en anglais, en
allemand et en néerlandais, les formes de mots les plus fréquentes ont plus
d’homophones, et qu’en anglais les mots les plus fréquents ont plus de sens,
même à longueur égale, un lien que Zipf avait déjà observé. Ils y voient une
question d’efficacité : les formes courtes et fréquentes sont faciles à
produire et à traiter, si bien qu’une langue les réutilise pour plusieurs sens
et laisse au contexte le soin de les distinguer.
Là où les annotateurs divergent
L’ambiguïté n’est pas un problème réservé aux programmes. Quand des personnes
étiquettent un corpus à la main en suivant des consignes écrites, elles
s’accordent sur environ 97 % des étiquettes, et bien des 3 % restants sont des
cas où la grammaire ne donne pas de réponse nette (Manning, 2011). En
anglais, les formes en -ing devant un nom sont le cas classique, et le
tableau ci-dessous applique un test à trois d’entre elles : un adjectif
accepte very (« très »), une forme verbale non.
Expression
Avec very
Lecture
a boring lecture
a very boring lecture fonctionne
adjectif
the falling leaves
the very falling leaves ne fonctionne pas
forme verbale
sparkling lemonade
very sparkling lemonade : douteux
entre les deux, aux consignes de trancher
Trois formes en -ing devant un nom, et ce qu'en dit le test de very.
Figure 4. Cent erreurs d'un étiqueteur anglais sur des textes du Wall Street Journal, dans les sept classes de Manning (2011), regroupées comme il les discute ; une erreur qui relevait de deux classes comptait pour moitié dans chacune.
Figure 5. Une illustration de ce que signifie une exactitude de 97 %.
Sources
Francis, W. N., & Kučera, H. (1979). Manual of information to accompany a standard corpus of present-day edited American English, for use with digital computers. Department of Linguistics, Brown University, Providence, RI (revised and amplified edition; first published 1964). https://listings.lib.msu.edu/public-corpora/cd421/manuals/brown/INDEX.HTM
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Manning, C. D. (2011). Part-of-speech tagging from 97% to 100%: Is it time for some linguistics?. In A. Gelbukh (Ed.), Computational Linguistics and Intelligent Text Processing, CICLing 2011 (Lecture Notes in Computer Science, Vol. 6608, pp. 171–189). Springer. https://doi.org/10.1007/978-3-642-19400-9_14
Marcus, M. P., Santorini, B., & Marcinkiewicz, M. A. (1993). Building a Large Annotated Corpus of English: The Penn Treebank. Computational Linguistics, 19(2), 313–330. https://aclanthology.org/J93-2004/
Figure 6. The most frequent tag on a phrase from the small corpus of the worked example. Figure 7. Part-of-speech tagging of English: the share of words tagged correctly by the baseline, and by the best systems and by people, with the top of the scale enlarged (Jurafsky & Martin, 2026).
Looking at the previous word
So the challenge is to get from 92 % as close as possible to 97 %. The errors
that remain with the naive approach, always using a word’s most frequent tag,
mostly come from ambiguous words with more than one possible tag, such as book,
which can be a verb or a noun
(Figure 6figure 6).
To disambiguate such a word, a tagger looks at its context, and a first step
is to look not only at the word that needs a tag, but also at the word before
it. A bigram is a
sequence of two consecutive words, or here of two consecutive tags, and a
bigram tagger adds a second count to the first: how often each tag follows the
tag of the previous word (Jurafsky & Martin, 2026). The bigram is one case of
a general notion, the n-gram, a sequence of n consecutive items: a trigram
tagger, for instance, looks at the tags of the two previous words.
Figure 8. The two questions a bigram tagger asks to tag book in travellers who book a room.
The tagger answers the two questions of
Figure 8figure 8 with
two probabilities, both counted in the tagged corpus, and gives the word the
tag for which the two together score highest.
Reading a probability such as P(book | VERB)
A probability is a share: a number between 0 and 1 that says how often
something happens out of a set of cases. 0 means never, 1 means always, and
0.25 means one time in four, or 25 %.
The notation P(A | B) is read “the probability of A, given B”. The bar means
given, and what comes after it says which cases you count in. Figure 9figure 9
reads P(book | VERB) piece by piece, and the table below reads both
probabilities a bigram tagger uses.
Figure 9. Reading P(book | VERB).
Written
Read as
Counted as
P(book | VERB)
the probability that a word is book, given that it is a verb
of all the verbs in the corpus, the share that are book
P(VERB | PRON)
the probability that a tag is VERB, given that the previous tag is PRON
of all the words that follow a pronoun, the share that are verbs
The two probabilities of a bigram tagger, read aloud and counted.
Both probabilities are plain shares, so you can work them out by hand.
A worked example, step by step
The phrase is travellers who book a room, and the counts come from a
small corpus of eight short English sentences, tagged by hand, in which
book occurs seven times in the singular (the plural books is another form), five times as a noun and twice as a verb. Figure 10figure 10
builds up with the four steps below.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 10. The worked example for book in travellers who book a room, one stage per step.
Step 1: the candidate tags
Figure 11. Stage 1 of the worked example.
A tagger does not invent a tag: it compares the tags a word can have. The
corpus shows two for book, NOUN and VERB, so the tagger computes one score
for each, and the higher score wins (Figure 11figure 11).
Step 2: the word, given each tag
Figure 12. Stage 2 of the worked example.
The first question counts, of the words that carry each tag, the share that
are book: among the nouns first, then among the verbs, and not among the
occurrences of book
(Figure 12figure 12).
5 of the 17 nouns are book: 0.294, written P(book | NOUN);
2 of the 16 verbs are book: 0.125, written P(book | VERB).
On this question alone, NOUN is ahead. That is the most frequent tag again,
and it is wrong here: the word on its own cannot tell this book from the
noun.
Step 3: each tag, given the previous tag
Figure 13. Stage 3 of the worked example.
The second question is what usually comes after the previous tag, which is
the information the most frequent tag never used. The word before book is
who, a pronoun, and the corpus has 9 words after a pronoun
(Figure 13figure 13).
none of them is a noun: 0, written P(NOUN | PRON);
4 of them are verbs: 0.444, written P(VERB | PRON).
Step 4: combining the two
Figure 14. Stage 4 of the worked example.
The tagger needs one score per tag that takes both answers into account, so
it multiplies them (Figure 14figure 14). A product is high only when
both numbers are, and a zero in either makes the whole product zero:
NOUN scores 0.294 × 0 = 0, and VERB scores 0.125 × 0.444 = 0.056.
VERB wins. The previous tag has overturned the lead NOUN had on the word
alone, and the tagger labels this book a verb, although book is a noun
more often than not.
A count of zero decided this case, and in a corpus of a hundred words that
happens all the time: a noun can follow a pronoun in English, as in her
book, where Universal Dependencies tags her as a pronoun, but the corpus
contains no example of it. Real taggers correct for this by giving every
count a small minimum, so that a sequence never seen in the corpus is
unlikely rather than impossible (Jurafsky & Martin, 2026).
The method as a rule
For every word of a text, a bigram tagger does the same three things with
counts from a tagged corpus:
it lists the tags the word can have;
for each tag, it multiplies the share of the word among the words that
carry this tag, P(word | tag), by the share of this tag
among the words that follow the previous tag,
P(tag | previous tag);
it keeps the tag with the larger product.
No rule anywhere says that book after who is a verb, and the method never
uses what book means: the counts alone decide.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Figure 6. L'étiquette la plus fréquente sur un segment du petit corpus de l'exemple détaillé. Figure 7. Étiquetage morphosyntaxique de l'anglais : la proportion de mots étiquetés correctement par l'étalon, par les meilleurs systèmes et par des personnes, avec le haut de l'échelle agrandi (Jurafsky & Martin, 2026).
Regarder le mot précédent
Le défi est donc de passer de 92 % au plus près de 97 %. Les erreurs qui
restent avec l’approche naïve, toujours prendre l’étiquette la plus fréquente
d’un mot, viennent surtout des mots ambigus qui ont plus d’une étiquette
possible, comme livre, qui peut être un verbe ou un nom
(Figure 6figure 6).
Pour lever l’ambiguïté d’un tel mot, un étiqueteur regarde son contexte, et
une première étape consiste à regarder non seulement le mot à étiqueter, mais
aussi le mot qui le précède. Un bigramme est une suite de deux mots
consécutifs, ou ici de deux étiquettes consécutives, et un étiqueteur
bigramme ajoute un second compte au premier : la fréquence de chaque étiquette
après l’étiquette du mot précédent (Jurafsky & Martin, 2026). Le bigramme est
un cas d’une notion générale, le n-gramme, une suite de n éléments
consécutifs : un étiqueteur trigramme, par exemple, regarde les étiquettes
des deux mots précédents.
Figure 8. Les deux questions que pose un étiqueteur bigramme pour étiqueter livre dans un auteur qui livre ses pensées.
L’étiqueteur répond aux deux questions de
Figure 8figure 8 par deux
probabilités, toutes deux comptées dans le corpus étiqueté, et donne au mot
l’étiquette pour laquelle les deux ensemble obtiennent le meilleur score.
Lire une probabilité comme P(livre | VERB)
Une probabilité est une proportion : un nombre entre 0 et 1 qui dit combien
de fois quelque chose se produit dans un ensemble de cas. 0 veut dire jamais,
1 toujours, et 0,25 une fois sur quatre, soit 25 %.
La notation P(A | B) se lit « la probabilité de A sachant
B ». La barre veut dire sachant, et ce qui la suit dit parmi quels cas on
compte. La Figure 9figure 9 lit
P(livre | VERB) morceau par morceau, et le tableau
ci-dessous lit les deux probabilités qu’utilise un étiqueteur bigramme.
Figure 9. Lire P(livre | VERB).
Notation
Se lit
Se compte
P(livre | VERB)
la probabilité qu’un mot soit livre, sachant que c’est un verbe
parmi tous les verbes du corpus, la proportion qui sont livre
P(VERB | PRON)
la probabilité qu’une étiquette soit VERB, sachant que l’étiquette précédente est PRON
parmi tous les mots qui suivent un pronom, la proportion de verbes
Les deux probabilités d'un étiqueteur bigramme, lues à voix haute et comptées.
Les deux probabilités sont de simples proportions, et vous pouvez les
calculer à la main.
Un exemple détaillé, étape par étape
Le segment est un auteur qui livre ses pensées, et les comptes viennent d’un
petit corpus de huit courtes phrases françaises, étiquetées à la main, où
livre apparaît sept fois au singulier (le pluriel livres est une autre forme), cinq fois comme nom et deux fois comme verbe. La Figure 10figure 10 se construit au fil des quatre étapes ci-dessous.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 10. L'exemple détaillé pour livre dans un auteur qui livre ses pensées, une phase par étape.
Étape 1 : les étiquettes candidates
Figure 11. Étape 1 de l'exemple détaillé.
Un étiqueteur n’invente pas d’étiquette : il compare les étiquettes qu’un mot
peut avoir. Le corpus en montre deux pour livre, NOUN et VERB, donc
l’étiqueteur calcule un score pour chacune, et le plus haut l’emporte
(Figure 11figure 11).
Étape 2 : le mot, sachant chaque étiquette
Figure 12. Étape 2 de l'exemple détaillé.
La première question compte, parmi les mots qui portent chaque étiquette, la
part qui sont livre : parmi les noms d’abord, puis parmi les verbes, et non
parmi les occurrences de livre
(Figure 12figure 12).
5 des 16 noms sont livre : 0,313, qui s’écrit P(livre | NOUN) ;
2 des 17 verbes sont livre : 0,118, qui s’écrit P(livre | VERB).
Sur cette seule question, NOUN est en tête. C’est encore l’étiquette la plus
fréquente, et elle est fausse ici : le mot seul ne permet pas de distinguer ce
livre du nom.
Étape 3 : chaque étiquette, sachant l’étiquette précédente
Figure 13. Étape 3 de l'exemple détaillé.
La seconde question porte sur ce qui vient d’habitude après l’étiquette
précédente, l’information que l’étiquette la plus fréquente n’utilisait
jamais. Le mot avant livre est qui, un pronom, et le corpus compte 13
mots après un pronom
(Figure 13figure 13).
aucun n’est un nom : 0, qui s’écrit P(NOUN | PRON) ;
7 sont des verbes : 0,538, qui s’écrit P(VERB | PRON).
Étape 4 : combiner les deux
Figure 14. Étape 4 de l'exemple détaillé.
L’étiqueteur a besoin d’un score par étiquette qui tienne compte des deux
réponses, et il les multiplie
(Figure 14figure 14). Un
produit n’est élevé que si les deux nombres le sont, et un zéro dans l’un des
deux annule le produit entier : NOUN obtient 0,313 × 0 = 0,
et VERB 0,118 × 0,538 = 0,063.
VERB l’emporte. L’étiquette précédente a renversé l’avance que NOUN avait sur
le mot seul, et l’étiqueteur étiquette ce livre comme un verbe, alors que
livre est le plus souvent un nom.
Un compte nul a décidé ce cas, et dans un corpus d’une centaine de mots, cela
arrive tout le temps : une séquence absente du corpus devient impossible,
alors qu’elle n’est que rare. Les vrais étiqueteurs corrigent ce problème en
donnant à chaque compte un petit minimum, de sorte qu’une séquence jamais vue
dans le corpus soit improbable plutôt qu’impossible (Jurafsky & Martin, 2026).
La méthode comme règle
Pour chaque mot d’un texte, un étiqueteur bigramme fait les trois mêmes
choses avec des comptes tirés d’un corpus étiqueté :
il fait la liste des étiquettes que le mot peut avoir ;
pour chaque étiquette, il multiplie la part du mot parmi les mots qui
portent cette étiquette, P(mot | étiquette), par la part
de cette étiquette parmi les mots qui suivent l’étiquette précédente,
P(étiquette | étiquette précédente) ;
il garde l’étiquette dont le produit est le plus grand.
Aucune règle ne dit nulle part que livre après qui est un verbe, et la
méthode n’utilise jamais ce que livre veut dire : seuls les comptes
décident.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Practice: tagging watch with probabilitiesExercices : étiqueter montre avec des probabilités
To answer, count in the corpus: all the nouns and all the verbs, those that
are the form watch, and what follows each pronoun and each punctuation
mark. Each line is one sentence, and you count what follows a word inside
its sentence: the final full stop is followed by nothing. The probabilities
are shares, so write them as decimals or as percentages, rounded to two
decimals.
Exercises
ExerciseExercice 1 · the word given the tag, for the nounle mot sachant l'étiquette, pour le nomnot startedà fairesolvedréussikeep tryingà retravailler
The tagger's first question: how typical watch is of nouns. Count all the words tagged NOUN in the corpus, then those that are the form watch. What is P(watch | NOUN)? Round to two decimals.
Première question de l'étiqueteur : à quel point « montre » est typique des noms. Comptez tous les mots étiquetés NOUN dans le corpus, puis ceux qui sont la forme « montre ». Quelle est P(montre | NOUN) ? Arrondissez à deux décimales.
Show the explanationVoir l'explication
The corpus has 21 nouns, of which 2 are watch (an old watch, a watch needs). P(watch | NOUN) = 2 / 21 = 0.10, or 9.52 %.
Le corpus compte 21 noms, dont 2 sont « montre » (« une montre en or », « qu'une montre demande »). P(montre | NOUN) = 2 / 21 = 0,10, soit 9,52 %.
ExerciseExercice 2 · the word given the tag, for the verble mot sachant l'étiquette, pour le verbenot startedà fairesolvedréussikeep tryingà retravailler
The same calculation for verbs: what is P(watch | VERB)? Count all the verbs, then those that are the form watch. Round to two decimals.
Le même calcul pour les verbes : quelle est P(montre | VERB) ? Comptez tous les verbes, puis ceux qui sont la forme « montre ». Arrondissez à deux décimales.
Show the explanationVoir l'explication
The corpus has 13 verbs, of which 3 are watch (the children watch, Visitors watch, Lea and Tom watch). P(watch | VERB) = 3 / 13 = 0.23, or 23.08 %. On the word alone, VERB is ahead: watch is a verb more often than a noun in the corpus.
Le corpus compte 12 verbes, dont 3 sont « montre » (« lui montre », « un guide montre », « Léa montre »). P(montre | VERB) = 3 / 12 = 0,25. « Montrant » est un verbe mais une autre forme : il compte parmi les 12 verbes, pas parmi les « montre ». Sur le mot seul, VERB est en tête : « montre » est plus souvent un verbe qu'un nom dans le corpus.
ExerciseExercice 3 · the tag given the previous tag, for the nounl'étiquette sachant l'étiquette précédente, pour le nomnot startedà fairesolvedréussikeep tryingà retravailler
The second question: what usually follows the previous tag. In she checks her watch, the word before watch is her, which Universal Dependencies tags as a pronoun (PRON), possessive or not. Count all the words that follow a pronoun in the corpus, then those that are nouns. What is P(NOUN | PRON)? Round to two decimals.
Seconde question : ce qui suit d'habitude l'étiquette précédente. Dans « un bracelet de montre », le mot avant « montre » est « de », une préposition (ADP). Comptez tous les mots qui suivent une préposition dans le corpus, puis ceux qui sont des noms. Quelle est P(NOUN | ADP) ? Arrondissez à deux décimales.
Show the explanationVoir l'explication
The corpus has 9 pronouns, and 4 are followed by a noun: her wrist, Her grandfather, their garden and his apprentices. P(NOUN | PRON) = 4 / 9 = 0.44, or 44.44 %. Of the other five, two are followed by punctuation, one by an adverb, one by an auxiliary and one by a verb.
Le corpus compte 10 prépositions, et 4 sont suivies d'un nom : « en or », « avec attention », « d'horlogerie » et « en silence ». P(NOUN | ADP) = 4 / 10 = 0,40. Cinq autres sont suivies d'un déterminant, comme « à le poignet », et la dernière d'un verbe.
ExerciseExercice 4 · the tag given the previous tag, for the verbl'étiquette sachant l'étiquette précédente, pour le verbenot startedà fairesolvedréussikeep tryingà retravailler
The same calculation for verbs: what is P(VERB | PRON)? Round to two decimals.
Le même calcul pour les verbes : quelle est P(VERB | ADP) ? Arrondissez à deux décimales.
Show the explanationVoir l'explication
Only one of the 9 pronouns is followed by a verb: He explains. P(VERB | PRON) = 1 / 9 = 0.11, or 11.11 %. This count covers every verb, whatever its form: here the tagger only looks at the tags.
Une seule des 10 prépositions est suivie d'un verbe : « à croire ». P(VERB | ADP) = 1 / 10 = 0,10. Ce compte porte sur tous les verbes, quelle que soit leur forme : l'étiqueteur ne regarde ici que les étiquettes.
Which tag does the bigram tagger give watch in She checks her watch, and why?
Quelle étiquette l'étiqueteur bigramme donne-t-il à « montre » dans « Elle cherche un bracelet de montre », et pourquoi ?
Show the solutionVoir la solution
The tagger compares two products: for the noun, 0.0952 × 0.444 = 0.042; for the verb, 0.231 × 0.111 = 0.026. The noun wins.
The first answer is the most frequent tag: on the word alone, VERB was ahead, and the tag would be wrong. The previous tag overturns the verb's lead, as in the worked example but the other way round. The third answer gives the right tag for the wrong reason: the tagger only knows that the previous tag is PRON, and nothing about possessives. The fourth forgets that the tagger never looks for the sentence in the corpus: it combines two counts, and both are there.
L'étiqueteur compare deux produits : pour le nom, 0,0952 × 0,40 = 0,038 ; pour le verbe, 0,25 × 0,10 = 0,025. Le nom l'emporte.
La première réponse est l'étiquette la plus fréquente : sur le mot seul, VERB était en tête, et l'étiquette serait fausse. C'est l'étiquette précédente qui renverse l'avance du verbe, comme dans l'exemple détaillé, mais dans l'autre sens. La troisième réponse donne la bonne étiquette pour une mauvaise raison : l'étiqueteur bigramme regarde l'étiquette du mot précédent, ADP pour « de », et non le mot « bracelet ». La quatrième oublie que l'étiqueteur ne cherche jamais la phrase dans le corpus : il combine deux comptes, et tous deux s'y trouvent.
Which tag does the bigram tagger give watch in He waits, watch in hand, and is the tag right?
Quelle étiquette l'étiqueteur bigramme donne-t-il à « montre » dans « Il attend, montre en main », et cette étiquette est-elle juste ?
Show the solutionVoir la solution
The previous word is the comma, tagged PUNCT. In the corpus, four words follow punctuation inside a sentence: one is a verb (, pointing) and none is a noun. The product for NOUN is therefore 0, and the product for VERB is small but positive: 0.231 × 1 / 4 = 0.058. VERB wins, and the tag is wrong: in watch in hand, watch is a noun.
The method works exactly as it should: the corpus has no noun after punctuation, so a zero decides the case. Real taggers give every count a small minimum for this reason. The first answer credits the tagger with a look at the next word, which is not part of its two counts, and the second describes the most frequent tag, which the bigram tagger does not use on its own.
Le mot précédent est la virgule, étiquetée PUNCT. Dans le corpus, six mots suivent une ponctuation à l'intérieur d'une phrase : un seul est un verbe (« , montrant ») et aucun n'est un nom. Le produit pour NOUN vaut donc 0, et celui pour VERB est petit mais positif : 0,25 × 1 / 6 = 0,042. VERB l'emporte, et l'étiquette est fausse : dans « montre en main », « montre » est un nom.
La méthode fonctionne exactement comme prévu : le corpus ne contient aucun nom après une ponctuation, si bien qu'un zéro tranche le cas. C'est pour cette raison que les vrais étiqueteurs donnent à chaque compte un petit minimum. La première réponse prête à l'étiqueteur un regard sur le mot suivant, qui ne fait pas partie de ses deux comptes, et la deuxième décrit l'étiquette la plus fréquente, que l'étiqueteur bigramme n'utilise pas seule.
Pour répondre, comptez dans le corpus : tous les noms et tous les verbes,
ceux qui sont la forme montre, et ce qui suit chaque préposition et chaque
ponctuation. Chaque ligne est une phrase, et on compte ce qui suit un mot à
l’intérieur de sa phrase : le point final n’est suivi de rien. Les
probabilités sont des proportions : écrivez-les en décimales ou en
pourcentages, arrondies à deux décimales.
Exercices
ExerciseExercice 1 · the word given the tag, for the nounle mot sachant l'étiquette, pour le nomnot startedà fairesolvedréussikeep tryingà retravailler
The tagger's first question: how typical watch is of nouns. Count all the words tagged NOUN in the corpus, then those that are the form watch. What is P(watch | NOUN)? Round to two decimals.
Première question de l'étiqueteur : à quel point « montre » est typique des noms. Comptez tous les mots étiquetés NOUN dans le corpus, puis ceux qui sont la forme « montre ». Quelle est P(montre | NOUN) ? Arrondissez à deux décimales.
Show the explanationVoir l'explication
The corpus has 21 nouns, of which 2 are watch (an old watch, a watch needs). P(watch | NOUN) = 2 / 21 = 0.10, or 9.52 %.
Le corpus compte 21 noms, dont 2 sont « montre » (« une montre en or », « qu'une montre demande »). P(montre | NOUN) = 2 / 21 = 0,10, soit 9,52 %.
ExerciseExercice 2 · the word given the tag, for the verble mot sachant l'étiquette, pour le verbenot startedà fairesolvedréussikeep tryingà retravailler
The same calculation for verbs: what is P(watch | VERB)? Count all the verbs, then those that are the form watch. Round to two decimals.
Le même calcul pour les verbes : quelle est P(montre | VERB) ? Comptez tous les verbes, puis ceux qui sont la forme « montre ». Arrondissez à deux décimales.
Show the explanationVoir l'explication
The corpus has 13 verbs, of which 3 are watch (the children watch, Visitors watch, Lea and Tom watch). P(watch | VERB) = 3 / 13 = 0.23, or 23.08 %. On the word alone, VERB is ahead: watch is a verb more often than a noun in the corpus.
Le corpus compte 12 verbes, dont 3 sont « montre » (« lui montre », « un guide montre », « Léa montre »). P(montre | VERB) = 3 / 12 = 0,25. « Montrant » est un verbe mais une autre forme : il compte parmi les 12 verbes, pas parmi les « montre ». Sur le mot seul, VERB est en tête : « montre » est plus souvent un verbe qu'un nom dans le corpus.
ExerciseExercice 3 · the tag given the previous tag, for the nounl'étiquette sachant l'étiquette précédente, pour le nomnot startedà fairesolvedréussikeep tryingà retravailler
The second question: what usually follows the previous tag. In she checks her watch, the word before watch is her, which Universal Dependencies tags as a pronoun (PRON), possessive or not. Count all the words that follow a pronoun in the corpus, then those that are nouns. What is P(NOUN | PRON)? Round to two decimals.
Seconde question : ce qui suit d'habitude l'étiquette précédente. Dans « un bracelet de montre », le mot avant « montre » est « de », une préposition (ADP). Comptez tous les mots qui suivent une préposition dans le corpus, puis ceux qui sont des noms. Quelle est P(NOUN | ADP) ? Arrondissez à deux décimales.
Show the explanationVoir l'explication
The corpus has 9 pronouns, and 4 are followed by a noun: her wrist, Her grandfather, their garden and his apprentices. P(NOUN | PRON) = 4 / 9 = 0.44, or 44.44 %. Of the other five, two are followed by punctuation, one by an adverb, one by an auxiliary and one by a verb.
Le corpus compte 10 prépositions, et 4 sont suivies d'un nom : « en or », « avec attention », « d'horlogerie » et « en silence ». P(NOUN | ADP) = 4 / 10 = 0,40. Cinq autres sont suivies d'un déterminant, comme « à le poignet », et la dernière d'un verbe.
ExerciseExercice 4 · the tag given the previous tag, for the verbl'étiquette sachant l'étiquette précédente, pour le verbenot startedà fairesolvedréussikeep tryingà retravailler
The same calculation for verbs: what is P(VERB | PRON)? Round to two decimals.
Le même calcul pour les verbes : quelle est P(VERB | ADP) ? Arrondissez à deux décimales.
Show the explanationVoir l'explication
Only one of the 9 pronouns is followed by a verb: He explains. P(VERB | PRON) = 1 / 9 = 0.11, or 11.11 %. This count covers every verb, whatever its form: here the tagger only looks at the tags.
Une seule des 10 prépositions est suivie d'un verbe : « à croire ». P(VERB | ADP) = 1 / 10 = 0,10. Ce compte porte sur tous les verbes, quelle que soit leur forme : l'étiqueteur ne regarde ici que les étiquettes.
Which tag does the bigram tagger give watch in She checks her watch, and why?
Quelle étiquette l'étiqueteur bigramme donne-t-il à « montre » dans « Elle cherche un bracelet de montre », et pourquoi ?
Show the solutionVoir la solution
The tagger compares two products: for the noun, 0.0952 × 0.444 = 0.042; for the verb, 0.231 × 0.111 = 0.026. The noun wins.
The first answer is the most frequent tag: on the word alone, VERB was ahead, and the tag would be wrong. The previous tag overturns the verb's lead, as in the worked example but the other way round. The third answer gives the right tag for the wrong reason: the tagger only knows that the previous tag is PRON, and nothing about possessives. The fourth forgets that the tagger never looks for the sentence in the corpus: it combines two counts, and both are there.
L'étiqueteur compare deux produits : pour le nom, 0,0952 × 0,40 = 0,038 ; pour le verbe, 0,25 × 0,10 = 0,025. Le nom l'emporte.
La première réponse est l'étiquette la plus fréquente : sur le mot seul, VERB était en tête, et l'étiquette serait fausse. C'est l'étiquette précédente qui renverse l'avance du verbe, comme dans l'exemple détaillé, mais dans l'autre sens. La troisième réponse donne la bonne étiquette pour une mauvaise raison : l'étiqueteur bigramme regarde l'étiquette du mot précédent, ADP pour « de », et non le mot « bracelet ». La quatrième oublie que l'étiqueteur ne cherche jamais la phrase dans le corpus : il combine deux comptes, et tous deux s'y trouvent.
Which tag does the bigram tagger give watch in He waits, watch in hand, and is the tag right?
Quelle étiquette l'étiqueteur bigramme donne-t-il à « montre » dans « Il attend, montre en main », et cette étiquette est-elle juste ?
Show the solutionVoir la solution
The previous word is the comma, tagged PUNCT. In the corpus, four words follow punctuation inside a sentence: one is a verb (, pointing) and none is a noun. The product for NOUN is therefore 0, and the product for VERB is small but positive: 0.231 × 1 / 4 = 0.058. VERB wins, and the tag is wrong: in watch in hand, watch is a noun.
The method works exactly as it should: the corpus has no noun after punctuation, so a zero decides the case. Real taggers give every count a small minimum for this reason. The first answer credits the tagger with a look at the next word, which is not part of its two counts, and the second describes the most frequent tag, which the bigram tagger does not use on its own.
Le mot précédent est la virgule, étiquetée PUNCT. Dans le corpus, six mots suivent une ponctuation à l'intérieur d'une phrase : un seul est un verbe (« , montrant ») et aucun n'est un nom. Le produit pour NOUN vaut donc 0, et celui pour VERB est petit mais positif : 0,25 × 1 / 6 = 0,042. VERB l'emporte, et l'étiquette est fausse : dans « montre en main », « montre » est un nom.
La méthode fonctionne exactement comme prévu : le corpus ne contient aucun nom après une ponctuation, si bien qu'un zéro tranche le cas. C'est pour cette raison que les vrais étiqueteurs donnent à chaque compte un petit minimum. La première réponse prête à l'étiqueteur un regard sur le mot suivant, qui ne fait pas partie de ses deux comptes, et la deuxième décrit l'étiquette la plus fréquente, que l'étiqueteur bigramme n'utilise pas seule.
Limits of a bigram taggerLes limites d'un étiqueteur bigramme
rely on the second half of the product alone, the tag that usually
follows the previous tag;
assume the unknown word belongs to an open class, since the closed
classes, determiners, pronouns and prepositions, are all already in the
corpus;
look at the shape of the word: a capital letter suggests a proper noun, a
word ending in -ly is usually an adverb, one ending in -ed a verb.
Figure 15. Three clues to the tag of a word the corpus never contained. Zorbled is an invented word.
The third strategy adds information of a new kind: not a count of the word, which does not exist, but a measurable
property of its form.
Errors that spread
The second weakness is built into the method as the worked example applies
it, from left to right. Each tag is chosen partly from the tag before it, so
a wrong tag changes the odds for the next word, and one error can produce a
run of them. Suppose a tagger takes time in time flies like an arrow for
a verb, as in time the runners. A noun is then a likely tag for flies,
and after a noun a verb is a likely tag for like: one wrong tag has become
three (Figure 16figure 16).
A tagger that chooses the tags for the whole sentence at once can still
revise time in the light of the words after it; one that works strictly
from left to right cannot.
Figure 16. An illustrative left-to-right tagger that starts with one wrong tag.
Figure 17. The context a bigram tagger uses, and the word that decides the tag.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Manning, C. D. (2011). Part-of-speech tagging from 97% to 100%: Is it time for some linguistics?. In A. Gelbukh (Ed.), Computational Linguistics and Intelligent Text Processing, CICLing 2011 (Lecture Notes in Computer Science, Vol. 6608, pp. 171–189). Springer. https://doi.org/10.1007/978-3-642-19400-9_14
se fier à la seconde moitié du produit seule, l’étiquette qui suit
d’habitude l’étiquette précédente ;
supposer que le mot inconnu appartient à une classe ouverte, puisque les
classes fermées, déterminants, pronoms et prépositions, sont toutes déjà
dans le corpus ;
regarder la forme du mot : une majuscule suggère un nom propre, un mot en
-ment est d’habitude un adverbe, un mot en -ait un verbe.
Figure 15. Trois indices pour l'étiquette d'un mot que le corpus ne contenait pas. Zorblait est un mot inventé.
La troisième stratégie apporte une information d’un nouveau genre : non pas
un compte du mot, qui n’existe pas, mais une propriété mesurable de sa forme.
Les erreurs qui se propagent
La deuxième faiblesse tient à la méthode telle que l’exemple détaillé
l’applique, de gauche à droite. Chaque étiquette est choisie en partie
d’après l’étiquette précédente, donc une étiquette fausse change les chances
du mot suivant, et une erreur peut en entraîner une série. Supposons qu’un
étiqueteur prenne le dans elle le livre demain pour un déterminant, comme
dans le livre est long. Après un déterminant, un nom est l’étiquette la plus
probable pour livre : une étiquette fausse en a entraîné une deuxième
(Figure 16figure 16).
Un étiqueteur qui choisit les étiquettes de toute la phrase à la fois peut
encore réviser le à la lumière des mots qui suivent ; un étiqueteur qui
travaille strictement de gauche à droite ne le peut pas.
Figure 16. Un étiqueteur illustratif, de gauche à droite, qui commence par une étiquette fausse.
Figure 17. Le contexte qu'utilise un étiqueteur bigramme, et le mot qui décide de l'étiquette.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Manning, C. D. (2011). Part-of-speech tagging from 97% to 100%: Is it time for some linguistics?. In A. Gelbukh (Ed.), Computational Linguistics and Intelligent Text Processing, CICLing 2011 (Lecture Notes in Computer Science, Vol. 6608, pp. 171–189). Springer. https://doi.org/10.1007/978-3-642-19400-9_14
Part-of-speech tagging todayL'étiquetage morphosyntaxique aujourd'hui
Figure 19. Four ways of tagging, from people deciding everything to the machine deciding everything. Hidden Markov model, feature-based and neural taggers all reach about 97 % on English (Jurafsky & Martin, 2026).
Where that leaves the task (Jurafsky & Martin, 2026):
What still costs: unknown words, rich morphology, and texts unlike the
training texts, such as tweets for a tagger trained on newspapers
(Manning, 2011).
Figure 20. Gemini 3 Pro tagging three sentences with Universal Dependencies tags, captured 6 October 2026.
Where you see tagging
You will rarely run a tagger yourself, but you will see its output wherever
a tool uses grammatical classes, for instance:
the word sketches and the searches by class of a concordancer (see also the Corpus analysis module) (voir aussi le module L'analyse de corpus);
Because every occurrence in its corpus is tagged, Sketch Engine treats book
as a noun and book as a verb as two different words, with sketches that
share almost nothing
(Figure 21figure 21).
The counts show the most frequent tag at work on a real corpus: the noun is
about fifteen times as frequent as the verb.
Figure 21. Word sketches of book as a noun and as a verb in the English Web 2021 corpus (enTenTen21), Sketch Engine, captured 6 October 2026.
When such a tool makes an odd mistake, a tag wrongly assigned to an ambiguous
word is often the reason.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Manning, C. D. (2011). Part-of-speech tagging from 97% to 100%: Is it time for some linguistics?. In A. Gelbukh (Ed.), Computational Linguistics and Intelligent Text Processing, CICLing 2011 (Lecture Notes in Computer Science, Vol. 6608, pp. 171–189). Springer. https://doi.org/10.1007/978-3-642-19400-9_14
Figure 19. Quatre façons d'étiqueter, des personnes qui décident de tout à la machine qui décide de tout. Les étiqueteurs à modèle de Markov caché, fondés sur des attributs et neuronaux atteignent tous environ 97 % en anglais (Jurafsky & Martin, 2026).
Ce qui fait encore baisser les scores : les mots inconnus, la morphologie riche, et les
textes différents des textes d’entraînement, comme des tweets pour un
étiqueteur entraîné sur des journaux (Manning, 2011).
Figure 20. Gemini 3 Pro étiquette trois phrases avec les étiquettes d'Universal Dependencies, capture du 6 octobre 2026.
Où vous voyez l’étiquetage
Vous lancerez rarement un étiqueteur vous-même, mais vous verrez ses
résultats partout où un outil se sert des classes grammaticales, par exemple :
les Word Sketches et les recherches par classe d’un
concordancier (see also the Corpus analysis module) (voir aussi le module L'analyse de corpus) ;
les vérifications grammaticales d’un traitement de texte.
Comme chaque occurrence de son corpus est étiquetée, Sketch Engine traite le
nom book et le verbe book comme deux mots différents, avec des Word Sketches qui
n’ont presque rien en commun, ici dans un corpus anglais
(Figure 21figure 21).
Les comptes montrent l’étiquette la plus fréquente à l’œuvre sur un vrai
corpus : le nom est environ quinze fois plus fréquent que le verbe.
Figure 21. Les Word Sketches de book comme nom et comme verbe dans le corpus English Web 2021 (enTenTen21), Sketch Engine, capture du 6 octobre 2026.
Quand un tel outil fait une erreur étrange, une étiquette mal attribuée à un
mot ambigu en est souvent la cause.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Manning, C. D. (2011). Part-of-speech tagging from 97% to 100%: Is it time for some linguistics?. In A. Gelbukh (Ed.), Computational Linguistics and Intelligent Text Processing, CICLing 2011 (Lecture Notes in Computer Science, Vol. 6608, pp. 171–189). Springer. https://doi.org/10.1007/978-3-642-19400-9_14
NormalizationNormalisation
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Normalizing text to reduce variationNormaliser un texte pour réduire la variation
Fewer types for the same text
Once a text is cut into tokens, many of its types are the same word in
different clothes: Le and le, colour and color, livre and
livres, ” and «. For many purposes these should count as one. Making
them one is normalization.
The point is to reduce the number of types while keeping what the task
needs. A frequency list that keeps Le and le apart splits the count of
one of the most frequent words in two. A search for chien that does not
find chiens misses every plural. A comparison of two lists of terms in which
one list is in lowercase and the other is not finds no matches at all.
Normalizing and filtering
Normalization is one of two ways to reduce the number of types, and the two
are easy to confuse because both leave a shorter list. The table below sets
out how they differ: in what happens to the occurrences.
What happens to a type
What happens to its tokens
Examples
Normalizing
It is merged with other types into one form
All of them are kept, counted under that one form
Lowercasing, removing accents, lemmatization
Filtering
It is removed
They are removed with it, so there are fewer tokens
Dropping stop words, punctuation, numbers or rare words
Two ways to reduce the number of types.
Information retrieval treats them as two separate steps (Manning et al.,
2008, §2.2.2–2.2.3). A count should say which of the two was applied:
after normalizing, the text is still all there; after filtering, part of
it is gone.
A filter many tools offer is a list of stop words, the words that occur
in every text and tell you little about its subject.
Dropping them is useful when the subject is what you are after and useless
when the grammar is.
Putting everything in lowercase normalizes. It removes almost four million
types and leaves the number of tokens exactly as it was: every occurrence
is still there, written in fewer ways.
Keeping only the types that start with a letter filters. It removes two
million more types and almost a billion tokens, because punctuation marks,
numbers and symbols are few types but occur everywhere.
Keeping only the types that occur at least five times filters too. It
removes 18.7 million types but only about 30 million tokens, under 1 % of
the corpus, since each of those types occurs at most four times.
Four million types remain of the original twenty-nine.The token and word counts are Sketch Engine’s own statistics for nlTenTen20, a crawl of the Dutch web from 2020 (6 836 979 371 tokens, 5 890 009 964 words); the type counts come from my word lists on that corpus, with each filter added in turn. The 5.89 billion tokens left after the second filter are the corpus’s word count, since Sketch Engine counts as a word every token that starts with a letter (Sketch Engine glossary, “word”, read 6 October 2026).
Figure 1. Types and tokens in a Dutch web corpus of 6.8 billion tokens, after each step.
The usual normalizations
The table below lists normalizations that tools commonly offer, with what
each one changes and what it can cost.
Operation
Example
What it loses
Case folding, everything in lowercase
Le, LE, le become le
The capital that tells Pierre from pierre, or a sentence start from a name
Removing accents
été, ete become ete
The difference between cote, côte, côté and coté
Unifying quotation marks and apostrophes
«, ”, „ become ”; ’ and ’ become ’
Nothing, in most tasks
Unifying numbers
10 000 and 10.000 become 10000; or every number becomes one placeholder, so 2026, 3,5 and 10 000 are all NUM
The thousands convention that told you the language; with a placeholder, the value itself
Expanding contractions
don’t becomes do not; du becomes de le
The written form, which a search then no longer finds
Unifying spelling variants
colour and color become color
The variety that told you where the text was written
Lemmatization
livre, livres become livre; allons, allait become aller
The number, tense and person of each occurrence
Common normalizations, with an example and what each one loses.
Expanding contractions
Expanding contractions is the one normalization in the table that adds
tokens, since one written word becomes two.
In English, don’t becomes do not, I’m becomes I am and won’t
becomes will not.
In French, du becomes de le, au becomes à le and aux becomes
à les; c’est, which a tokenizer usually cuts into c’ and est,
becomes ce est.
It is still a normalization, because nothing is removed: the number of
types falls while the number of tokens rises, as
Figure 2figure 2 shows.
After it, don’t and do not are the same form, and the
negation in don’t, won’t or isn’t is counted with every other not.
In French, the types du, au and aux disappear: the preposition in them
is counted under de or à, and the article under le or les. Some expansions need a decision first:
it’s is it is in it’s raining and it has in it’s been raining.
Figure 2. Expanding a contraction merges it into two types that already exist, so there are fewer types and more tokens.
The line between this and tokenization is not sharp. Cutting doesn’t
into does and n’t only cuts what is written, which is tokenization;
writing n’t as not, or du as de le, changes the letters, which is
normalization. Many tools do both in one step, and the list of tokenization
rules built for French in the tokenization chapter ends with one that turns au, du and des into
two words (see also the Tokenizing a text with rules page, in the Classical NLP module) (voir aussi la page Segmenter un texte avec des règles, dans le module TAL classique).
The forms an expansion produces are not always real words: ce est and de le are
not French. They are there so that a tagger can label the pronoun and the
verb, or the preposition and the article, separately. The annotated corpus
of the part-of-speech tagging chapter shows the tokenization side of the
same choice: it cuts can’t into ca and n’t, the form English tagsets
expect, and ca is not an English word
either (see also the Practice: tagging watch with probabilities page, in the Classical NLP module) (voir aussi la page Exercices : étiqueter montre avec des probabilités, dans le module TAL classique).
Choosing what to normalize and filter
Every normalization and every filter loses something, and the loss is only
acceptable if the task does not need what was lost. Lowercasing is right for a frequency
list and wrong for finding proper names. Removing accents is right for a
rough search and wrong for French, where a and à are two words. Dropping
stop words is right for finding the topic of a text and wrong for tagging
its grammar. So both are chosen per task, and the choice should be stated,
because a count or a score made after one set of normalizations and filters
is not comparable to a count made after another.
Sources
Jurafsky, D., & Martin, J. H. (2024). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft of 20 August 2024, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/ed3bookaug20_2024.pdf
Une fois un texte découpé en occurrences, beaucoup de ses types sont le même
mot sous des habits différents : Le et le, colour et color, livre
et livres, ” et «. Pour bien des usages, ils devraient compter pour
un. Les ramener à une seule forme, c’est la normalisation.
Le but est de réduire le nombre de types tout en gardant ce dont la tâche a
besoin. Une liste de fréquences qui sépare Le et le coupe en deux le
décompte de l’un des mots les plus fréquents. Une recherche de chien qui ne
trouve pas chiens manque tous les pluriels. Une comparaison de deux listes
de termes, l’une en minuscules et l’autre non, ne trouve aucune
correspondance.
Normaliser et filtrer
La normalisation est l’une des deux façons de réduire le nombre de types, et
on confond facilement les deux, puisque l’une comme l’autre donne une liste
plus courte. Le tableau ci-dessous montre en quoi elles diffèrent : dans ce
qu’il advient des occurrences.
Ce que devient un type
Ce que deviennent ses occurrences
Exemples
Normaliser
Il est fusionné avec d’autres types en une seule forme
Elles sont toutes gardées, comptées sous cette forme
Mise en minuscules, suppression des accents, lemmatisation
Filtrer
Il est supprimé
Elles disparaissent avec lui : il y a moins d’occurrences
Suppression des mots vides, de la ponctuation, des nombres ou des mots rares
Deux façons de réduire le nombre de types.
La recherche d’information en fait deux étapes distinctes (Manning et al.,
2008, §2.2.2–2.2.3). Un décompte devrait préciser laquelle des deux a été
appliquée : après une normalisation, le texte est encore là en entier ;
après un filtrage, une partie a disparu.
Un filtre que proposent beaucoup d’outils est une liste de mots vides, les
mots qui apparaissent dans tous les textes et en disent peu sur leur sujet.
Les supprimer est utile quand on s’intéresse au sujet d’un texte, et inutile
quand on s’intéresse à sa grammaire.
La mise en minuscules normalise. Elle supprime près de quatre millions de
types et laisse le nombre d’occurrences exactement tel quel : chaque
occurrence est toujours là, écrite de moins de façons.
Ne garder que les types qui commencent par une lettre est un filtre. Il
supprime deux millions de types de plus et près d’un milliard
d’occurrences, parce que les signes de ponctuation, les nombres et les
symboles sont peu nombreux comme types, mais apparaissent partout.
Ne garder que les types qui apparaissent au moins cinq fois est aussi un
filtre. Il supprime 18,7 millions de types, mais seulement 30 millions
d’occurrences environ, moins de 1 % du corpus, puisque chacun de ces types
apparaît au plus quatre fois.
Il reste quatre millions de types sur les vingt-neuf du départ.Les nombres d’occurrences et de mots sont les statistiques de Sketch Engine pour nlTenTen20, une collecte du Web néerlandais de 2020 (6 836 979 371 occurrences, 5 890 009 964 mots) ; les nombres de types viennent de mes listes de mots sur ce corpus, en ajoutant chaque filtre l’un après l’autre. Les 5,89 milliards d’occurrences qui restent après le deuxième filtre correspondent au nombre de mots du corpus, puisque Sketch Engine compte comme mot toute occurrence qui commence par une lettre (glossaire de Sketch Engine, « word », consulté le 6 octobre 2026).
Figure 1. Types et occurrences dans un corpus du Web néerlandais de 6,8 milliards d'occurrences, après chaque étape.
Les normalisations courantes
Le tableau ci-dessous présente des normalisations que les outils proposent
souvent, avec ce que chacune change et ce qu’elle peut coûter.
Opération
Exemple
Ce qu’elle fait perdre
Mise en minuscules
Le, LE, le deviennent le
La majuscule qui distingue Pierre de pierre, ou un début de phrase d’un nom
Suppression des accents
été, ete deviennent ete
La différence entre cote, côte, côté et coté
Uniformisation des guillemets et des apostrophes
«, ”, „ deviennent ” ; ’ et ’ deviennent ’
Rien, pour la plupart des tâches
Uniformisation des nombres
10 000 et 10.000 deviennent 10000 ; ou bien chaque nombre est remplacé par un même symbole, de sorte que 2026, 3,5 et 10 000 deviennent tous NUM
La convention des milliers, qui indiquait la langue ; avec un symbole, la valeur elle-même
Décomposition des contractions
don’t devient do not ; du devient de le
La forme écrite, qu’une recherche ne trouve plus
Uniformisation des variantes orthographiques
colour et color deviennent color
La variété, qui indiquait où le texte a été écrit
Lemmatisation
livre, livres deviennent livre ; allons, allait deviennent aller
Le nombre, le temps et la personne de chaque occurrence
Normalisations courantes, avec un exemple et ce que chacune fait perdre.
Décomposer les contractions
La décomposition des contractions est la seule normalisation du tableau qui
ajoute des occurrences, puisqu’un mot écrit en devient deux.
En anglais, don’t devient do not, I’m devient I am et won’t
devient will not.
En français, du devient de le, au devient à le et aux devient
à les ; c’est, qu’un segmenteur coupe d’ordinaire en c’ et est,
devient ce est.
C’est tout de même une normalisation, puisque rien n’est supprimé : le
nombre de types baisse pendant que le nombre d’occurrences augmente, comme le
montre la Figure 2figure 2. Après la
décomposition, don’t et do not sont la même forme, et la négation de
don’t, won’t ou isn’t est comptée avec tous les autres not. En
français, les types du, au et aux disparaissent : leur préposition est
comptée sous de ou à, et leur article sous le ou les. Certaines
décompositions demandent d’abord de trancher : it’s vaut it is dans
it’s raining et it has dans it’s been raining.
Figure 2. Décomposer une contraction la fusionne dans deux types qui existent déjà : il y a moins de types et plus d'occurrences.
La frontière avec la segmentation en unités lexicales n’est pas nette.
Couper doesn’t en does et n’t ne fait que couper ce qui est écrit,
c’est de la segmentation ; écrire n’t sous la forme not, ou du sous la
forme de le, change les lettres, c’est de la normalisation. Beaucoup
d’outils font les deux en une seule étape, et la liste de règles de
segmentation construite pour le français dans le chapitre sur la
segmentation se termine par une règle qui transforme au, du et des en
deux mots (see also the Tokenizing a text with rules page, in the Classical NLP module) (voir aussi la page Segmenter un texte avec des règles, dans le module TAL classique).
Les formes qu’une décomposition produit ne sont pas toujours de vrais mots :
ce est et de le ne sont pas du français. Elles servent à ce qu’un
étiqueteur puisse étiqueter séparément le pronom et le verbe, ou la
préposition et l’article. Le corpus annoté du chapitre sur l’étiquetage
morphosyntaxique a été normalisé de cette façon, c’est pourquoi il contient
la phrase mais ce est
vrai (see also the Practice: tagging watch with probabilities page, in the Classical NLP module) (voir aussi la page Exercices : étiqueter montre avec des probabilités, dans le module TAL classique).
Choisir ce qu’on normalise et ce qu’on filtre
Toute normalisation et tout filtrage font perdre quelque chose, et la perte
n’est acceptable que si la tâche n’a pas besoin de ce qui a été perdu. La
mise en minuscules convient à une liste de fréquences, mais pas à la
recherche de noms propres. La suppression des accents convient à une
recherche approximative, mais pas au français, où a et à sont deux mots.
La suppression des mots vides convient pour trouver le sujet d’un texte,
mais pas pour en étiqueter la grammaire. On les choisit donc selon la tâche,
et ce choix devrait être indiqué, parce qu’un décompte ou un score obtenu
après un ensemble de normalisations et de filtres n’est pas comparable à un
décompte obtenu après un autre.
Sources
Jurafsky, D., & Martin, J. H. (2024). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft of 20 août 2024, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/ed3bookaug20_2024.pdf
A dictionary form: va, allons, allait become aller
What is left once the ending is cut, often not a word: chercher, cherches become cherch
What it needs
A dictionary or a model of the language, often the word’s tag
A list of endings to cut, for one language
Errors
Mostly on forms with two possible lemmas
Many, in both directions (Jurafsky & Martin, 2024)
Lemmatization and stemming compared.
Figure 3figure 3 shows
both on nine French forms, with the stems the Snowball stemmer for French
produces.The stems are the output of the Snowball stemmer for French (snowballstem.org), run on 6 October 2026.
Figure 3. Lemmas and stems for the same forms. The lemmatizer groups each word's forms; the stemmer merges two words and splits two others.
Stemming errors
A stemmer works on letters alone. It has no dictionary and no information
about grammatical class, so nothing in its rules can tell that livre and
livrer are two words, or that cherchent belongs with chercher. Writing
its rules is a balance between two errors (Jurafsky & Martin, 2024):
Over-stemming: a rule applied too widely merges words that should stay
apart, as livre and livrer under livr.
Under-stemming: a rule applied too narrowly, or left out, splits forms that
belong together, as cherchent and chercher.
Applying a rule more widely removes some under-stemming and adds
over-stemming, so every rule is a judgement about which does more harm.
Two endings, two decisions
In French, -ent ends the third person plural of the present and -ant
the present participle, so removing them would bring more of a verb’s forms
together. Both endings also end many other words, and the Snowball stemmer
treats the two differently.
Ending
Rule
What it gains
What it costs
-ent
Never removed on its own
accident, moment, parent, souvent stay whole
cherchent stays apart from chercher: under-stemming
-ant
Removed
cherchant joins chercher under cherch
restaurant joins restaurer under restaur, important joins importer under import: over-stemming
Two verb endings in the Snowball stemmer for French.
The stemmer’s documentation explains the first decision: removing -ent
or -ons would cause “unacceptable overstemming”, as in accident and
garçons.Snowball, French stemming algorithm (snowballstem.org), read 6 October 2026; the stems in the table were produced with it the same day.
That is also why allons only becomes allon: a later rule deletes the
final s, and the -on stays.
Lemmatization and tagging
A form can belong to two lemmas: livre is its own lemma as a noun (un
livre) and a form of livrer as a verb (il livre), as saw is a form of
see as a verb and its own lemma as a noun (Manning et al., 2008).
Figure 4figure 4 shows
two such forms.
Figure 4. The same written form with two lemmas. For livre the tag is enough to choose the lemma; for fils only the rest of the sentence can.
The lemma can help choose the tag, for instance in German, where a plural
noun phrase does not show its gender and only the lemma does. Systems that
do both tasks together improve on both (Müller et al., 2015; Kondratyuk et
al., 2018).
Bergmanis, T., & Goldwater, S. (2018). Context Sensitive Neural Lemmatization with Lematus. Proceedings of the 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long Papers), 1391–1400. https://aclanthology.org/N18-1126/
Jurafsky, D., & Martin, J. H. (2024). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft of 20 August 2024, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/ed3bookaug20_2024.pdf
Kondratyuk, D., Gavenčiak, T., Straka, M., & Hajič, J. (2018). LemmaTag: Jointly Tagging and Lemmatizing for Morphologically Rich Languages with BRNNs. Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, 4921–4928. https://aclanthology.org/D18-1532/
Müller, T., Cotterell, R., Fraser, A., & Schütze, H. (2015). Joint Lemmatization and Morphological Tagging with Lemming. Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing, 2268–2274. https://aclanthology.org/D15-1272/
Une forme de dictionnaire : va, allons, allait deviennent aller
Ce qui reste une fois la terminaison coupée, souvent pas un mot : chercher, cherches deviennent cherch
Ce dont elle a besoin
Un dictionnaire ou un modèle de la langue, souvent l’étiquette du mot
Une liste de terminaisons à couper, pour une langue donnée
Erreurs
Surtout sur les formes qui ont deux lemmes possibles
Nombreuses, dans les deux sens (Jurafsky & Martin, 2024)
La lemmatisation et la racinisation comparées.
La Figure 3figure 3 montre les deux sur neuf formes
françaises, avec les racines que produit le raciniseur Snowball pour le
français.Les racines sont celles que produit le raciniseur Snowball pour le français (snowballstem.org), exécuté le 6 octobre 2026.
Figure 3. Lemmes et racines pour les mêmes formes. Le lemmatiseur regroupe les formes de chaque mot ; le raciniseur fusionne deux mots et en scinde deux autres.
Les erreurs de racinisation
Un raciniseur ne travaille que sur les lettres. Il n’a ni dictionnaire ni
information sur la classe grammaticale, si bien que rien dans ses règles ne
permet de savoir que livre et livrer sont deux mots, ou que cherchent
va avec chercher. Écrire ses règles revient à trouver un équilibre entre
deux erreurs (Jurafsky & Martin, 2024) :
La racinisation excessive : une règle appliquée trop largement fusionne
des mots qui devraient rester distincts, comme livre et livrer sous
livr.
La racinisation insuffisante : une règle appliquée trop étroitement, ou
absente, sépare des formes qui vont ensemble, comme cherchent et
chercher.
Appliquer une règle plus largement réduit la racinisation insuffisante et
augmente la racinisation excessive : chaque règle repose donc sur un
jugement, celui de l’erreur qui fait le plus de tort.
Deux terminaisons, deux décisions
En français, -ent termine la troisième personne du pluriel du présent et
-ant le participe présent : les supprimer rapprocherait davantage de
formes d’un même verbe. Mais ces deux terminaisons terminent aussi beaucoup
d’autres mots, et le raciniseur Snowball les traite différemment.
Terminaison
Règle
Ce qu’on y gagne
Ce qu’on y perd
-ent
Jamais supprimée seule
accident, moment, parent, souvent restent entiers
cherchent reste séparé de chercher : racinisation insuffisante
-ant
Supprimée
cherchant rejoint chercher sous cherch
restaurant rejoint restaurer sous restaur, important rejoint importer sous import : racinisation excessive
Deux terminaisons verbales dans le raciniseur Snowball pour le français.
La documentation du raciniseur explique la première décision : supprimer
-ent ou -ons entraînerait « unacceptable overstemming » [ma traduction :
« une racinisation excessive inacceptable »], comme dans accident et
garçons.Snowball, algorithme de racinisation pour le français (snowballstem.org), consulté le 6 octobre 2026 ; les racines du tableau ont été produites avec lui le même jour.
C’est aussi pourquoi allons ne devient que allon : une règle appliquée
plus tard supprime le s final, et le -on reste.
Lemmatisation et étiquetage
Une forme peut appartenir à deux lemmes : livre est son propre lemme comme
nom (un livre) et une forme de livrer comme verbe (il livre), de même
que saw est une forme de see comme verbe et son propre lemme comme nom
(Manning et al., 2008). La Figure 4figure 4 montre deux
formes de ce genre.
Figure 4. La même forme écrite avec deux lemmes. Pour livre, l'étiquette suffit à choisir le lemme ; pour fils, seul le reste de la phrase le peut.
L’étiquette et le lemme sont liés de trois façons :
Le lemme peut aider à choisir l’étiquette, par exemple en allemand, où un
groupe nominal au pluriel ne montre pas son genre, que seul le lemme
indique. Les systèmes qui font les deux tâches ensemble améliorent les deux
(Müller et al., 2015 ; Kondratyuk et al., 2018).
Bergmanis, T., & Goldwater, S. (2018). Context Sensitive Neural Lemmatization with Lematus. Proceedings of the 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long Papers), 1391–1400. https://aclanthology.org/N18-1126/
Jurafsky, D., & Martin, J. H. (2024). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft of 20 août 2024, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/ed3bookaug20_2024.pdf
Kondratyuk, D., Gavenčiak, T., Straka, M., & Hajič, J. (2018). LemmaTag: Jointly Tagging and Lemmatizing for Morphologically Rich Languages with BRNNs. Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, 4921–4928. https://aclanthology.org/D18-1532/
Müller, T., Cotterell, R., Fraser, A., & Schütze, H. (2015). Joint Lemmatization and Morphological Tagging with Lemming. Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing, 2268–2274. https://aclanthology.org/D15-1272/
Automatic term extraction (from rules to large language models)Extraction automatique de termes (des règles aux grands modèles de langue)
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
A term is a single unit. The word terminology is used in two
senses: the set of all the terms of a domain (the terminology of dressage),
and the discipline that studies terms and how to record them.
Terms take up a real share of a translator’s time. In studies from the
2000s, translators estimated that they spent roughly 15 to 30% of their
working time on terminology, most of it on looking terms up (Champagne,
2004; Gornostay, 2010).Both studies date from before neural
machine translation and large language models, and no comparable figures
for today’s tools are cited here. The share depends on the
translator and on the field: in Champagne’s study it was highest in
financial institutions and lowest in language firms, and the participants
put it at 40 to 60% for a translator new to the job. Translating a term
often takes knowledge of the domain as well as of the two languages.
Translators are therefore among the main users of terminological resources
such as termbases and glossaries.
Figure 1figure 1 shows four of the movements that dressage terms name.The photographs are from
Wikimedia Commons, cropped and resized: the piaffe,
the passage
and the extended trot
by Eponimm, under CC BY 4.0;
the canter pirouette
by World Dressage Masters, under CC BY 2.0.
Figure 1. Four movements of dressage, each with a term of its own: piaffe and passage (top), canter pirouette and extended trot (bottom). Photographs by Eponimm (CC BY 4.0) and World Dressage Masters (CC BY 2.0), Wikimedia Commons.
Terms are often recorded in termbases, which tend to organize them by
concept. In a multilingual termbase, you can then see the terms used for one
concept in several languages. The example in Figure 2figure 2, taken from TERMIUM Plus, also shows that the ideal of one term per concept
in each language is often not reached in practice: the record suggests three
English terms for a single French one.
Figure 2. A term bank record, here TERMIUM Plus (read 30 September 2026): one concept, the terms that name it in each language, its subject field, and contexts.
Terms of several words
In the texts a translator works on, many terms are longer than one word.
Flying change names one movement, in which the horse changes its leading
leg in the air between two strides of canter, and its meaning does not follow
from flying and change looked up separately. Recognizing a term therefore
includes deciding where it starts and where it ends: in “the collected canter
pirouette”, you might record canter pirouette, collected canter,
canter, pirouette, or all four.
Sources
Champagne, G. (2004). The Economic Value of Terminology: an Exploratory Study. Report submitted to the Translation Bureau of Canada, 30 April 2004. Guy Champagne Inc., Montreal.
Gornostay, T. (2010). Terminology Management in Real Use. Proceedings of the 5th International Biannual Conference “Applied Linguistics in Research and Education” in Memoriam Rajmund Piotrowski (1922-2009), Saint Petersburg.
ISO (2019). ISO 1087:2019 Terminology work and terminology science — Vocabulary. International Organization for Standardization, 2nd ed.. https://www.iso.org/standard/62330.html
Un terme est une unité. Le mot terminologie s’emploie en deux sens :
l’ensemble des termes d’un domaine (la terminologie du dressage), et la
discipline qui étudie les termes et la façon de les consigner.
Les termes occupent une part réelle du temps de traduction. Dans des études
des années 2000, des traducteurs estimaient consacrer de 15 à 30 % environ
de leur temps de travail à la terminologie, surtout à la recherche de termes
(Champagne, 2004 ; Gornostay, 2010).Les deux études datent
d’avant la traduction automatique neuronale et les grands modèles de langue,
et aucun chiffre comparable pour les outils d’aujourd’hui n’est cité
ici. Cette part dépend de la personne et du secteur : dans l’étude
de Champagne, elle était la plus élevée dans les institutions financières et
la plus faible dans les cabinets de traduction, et les participants
l’estimaient à 40 à 60 % pour une personne qui débute dans le métier.
Traduire un terme demande souvent de connaître le domaine, en plus des deux
langues. Les traducteurs comptent donc parmi les principaux utilisateurs de
ressources terminologiques comme les bases terminologiques et les
glossaires.
La Figure 1figure 1 montre quatre des mouvements que désignent les termes du dressage.Les photographies viennent
de Wikimedia Commons, recadrées et redimensionnées : le piaffer,
le passage
et le trot allongé
par Eponimm, sous licence CC BY 4.0 ;
la pirouette au galop
par World Dressage Masters, sous licence CC BY 2.0.
Figure 1. Quatre mouvements du dressage, chacun avec son terme : piaffer et passage (en haut), pirouette au galop et trot allongé (en bas). Photographies d'Eponimm (CC BY 4.0) et de World Dressage Masters (CC BY 2.0), Wikimedia Commons.
Les termes sont souvent consignés dans des bases terminologiques, qui tendent
à les organiser par concept. Dans une base multilingue, vous voyez alors les
termes employés pour un même concept dans plusieurs langues. L’exemple de la
Figure 2figure 2, tiré de TERMIUM Plus, montre aussi que l’idéal d’un seul terme par
concept dans chaque langue ne se vérifie souvent pas en pratique : la fiche
propose trois termes anglais pour un seul terme français.
Figure 2. Une fiche de banque terminologique, ici TERMIUM Plus (consultée le 30 septembre 2026) : un concept, les termes qui le désignent dans chaque langue, son domaine et des contextes.
Les termes de plusieurs mots
Dans les textes sur lesquels travaille une traductrice ou un traducteur,
beaucoup de termes dépassent un mot. Changement de pied désigne un seul
mouvement, dans lequel le cheval change de pied en l’air entre deux foulées
de galop, et son sens ne se déduit pas de changement et de pied cherchés
séparément. Reconnaître un terme suppose donc de décider où il commence et où
il finit : dans « la pirouette au galop rassemblé », vous pourriez consigner
pirouette au galop, galop rassemblé, galop, pirouette, ou les quatre.
Sources
Champagne, G. (2004). The Economic Value of Terminology: an Exploratory Study. Report submitted to the Translation Bureau of Canada, 30 avril 2004. Guy Champagne Inc., Montreal.
Gornostay, T. (2010). Terminology Management in Real Use. Proceedings of the 5th International Biannual Conference “Applied Linguistics in Research and Education” in Memoriam Rajmund Piotrowski (1922-2009), Saint Petersburg.
ISO (2019). ISO 1087:2019 Terminology work and terminology science — Vocabulary. International Organization for Standardization, 2nd ed.. https://www.iso.org/standard/62330.html
Where people disagree about termsLes points de désaccord sur les termes
Figure 3. Three annotators on the same texts: the share of terms marked by all three, by two and by one, and the average agreement between two annotators depending on what they were given (Rigouts Terryn et al., 2020a).
Term boundaries
In “the horse moves on in posting trot”, is the term posting trot, trot,
posting, or all three? There is no universally correct answer to that
question, so this is where annotation guidelines can reduce some of the
variation. The guidelines of the ACTER dataset, for instance, answer “all three”: when
part of a longer term is a term in its own right, the longer term and the
shorter one are both marked. In the dressage texts, posting
trot was marked as a whole, and posting and trot were marked as well
(Rigouts Terryn, 2021a).
Other annotation schemes keep only the longest unit (Liu et al., 2025). Terms interrupted by other words
are another case to settle: in “collected and extended trot”, collected trot
is there in meaning but never appears as such in the text.
Figure 4figure 4 shows both cases as an annotation tool records them.
Figure 4. Nested and split terms in the BRAT annotation tool, from the annotation of a term extraction dataset: ventricle inside right ventricle, and left ventricle, which the text never writes in full, recorded as a part linked to the term it belongs to (Rigouts Terryn et al., 2020a).
Everyday words with a specialized sense
Some terms look like ordinary words; the table below gives three from
dressage. A reader who does not know the domain reads straight past them;
for a translator, they are exactly the words that need checking.
Word
Everyday sense
In dressage
collection
a set of objects
the way a horse shifts its weight towards its hindquarters and shortens its strides; collected and collect follow it
contact
touching, or being in touch
the connection between the rider’s hands and the horse’s mouth through the reins
passage
a way through, or an extract from a text
a movement: a very collected, elevated trot
Three dressage terms that look like everyday words.
Annotators also disagree about how specialized a unit has to be to count as
a term. One way to make that decision explicit is to ask two separate
questions, as the ACTER guidelines do (Rigouts Terryn, 2021a):
Is it specific to the domain? Does the unit relate to the subject of the
texts? This dimension is called domain specificity.
Is it specific in the lexicon? Is it known only to specialists, or is it
part of everyday vocabulary? This dimension is called lexicon specificity.
Different term labels can be defined from these two dimensions.
Figure 5figure 5 shows the three labels of the ACTER scheme: a unit that is specific on
both dimensions is a Specific Term, one that is specific to the domain only
is a Common Term, and one that is specific in the lexicon only is an
Out-of-Domain Term.
Figure 5. The two questions of the ACTER annotation scheme and the three labels they give, with examples chosen for dressage (after Rigouts Terryn, 2021a).
Both answers depend on who is asking, and the edge of the domain is a
decision too. When the dressage texts were annotated, terms from other
equestrian sports, such as gymkhana or voltige (vaulting), were labelled
as out of the domain, because the domain was taken to be dressage rather than
riding as a whole (Rigouts Terryn et al., 2019).
Knowing a domain well does not settle it either. I annotated the dressage
texts myself, and I know the sport well: I understood the terminology without
effort, but found it harder to tell terms from general vocabulary, because
the terms had become part of my own everyday vocabulary (Rigouts Terryn et
al., 2020a).
Two ways of settling the cases
A project that needs a list of terms has to settle the cases annotators
disagree about, such as term boundaries and everyday words with a
specialized sense. It can do so in two broad ways.
Categories. A scheme such as ACTER’s keeps the disagreement visible by
giving each unit a label: one of the three term labels above, or Named
Entity. A list can then be made strict or broad afterwards, by choosing
which labels count.
Neither way removes the disagreement. Every list of terms depends on such
choices, whether a person or a tool made it, and two lists made with
different choices cannot simply be compared as right and wrong.
Sources
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Liu, S., Lefever, E., & Hoste, V. (2025). MariATE: Automatic Term Extraction Using Large Language Models in the Maritime Domain. Proceedings of the 15th International Conference on Recent Advances in Natural Language Processing (RANLP 2025), 663–673. https://aclanthology.org/2025.ranlp-1.77/
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Figure 3. Trois annotateurs sur les mêmes textes : la part des termes retenus par les trois, par deux et par un seul, et l'accord moyen entre deux annotateurs selon ce qui leur était fourni (Rigouts Terryn et al., 2020a).
Les frontières d’un terme
Dans « le cheval repart au trot enlevé », le terme est-il trot enlevé,
trot, enlevé, ou les trois ? Cette question n’a pas de réponse
universellement correcte, et c’est donc là que des consignes d’annotation
peuvent réduire une partie de la variation. Les consignes du jeu de données ACTER, par exemple, répondent « les trois » : quand
une partie d’un terme plus long est elle-même un terme, le terme long et le
terme court sont tous deux annotés. Dans les textes anglais sur le dressage, posting
trot (trot enlevé) a été annoté en entier, et posting et trot l’ont été aussi
(Rigouts Terryn, 2021a).
D’autres schémas d’annotation ne gardent que l’unité la plus longue (Liu et al., 2025). Les termes interrompus par d’autres mots
sont un autre cas à trancher : dans « trot rassemblé et allongé », trot allongé
est là par le sens, mais n’apparaît jamais tel quel dans le texte.
La Figure 4figure 4 montre les deux cas tels qu’un outil d’annotation les enregistre.
Figure 4. Termes imbriqués et termes scindés dans l'outil d'annotation BRAT, lors de l'annotation d'un jeu de données d'extraction de termes : ventricle à l'intérieur de right ventricle, et left ventricle, que le texte n'écrit jamais en entier, enregistré comme une partie reliée au terme auquel elle appartient (Rigouts Terryn et al., 2020a).
Les mots courants qui ont un sens spécialisé
Certains termes ressemblent à des mots ordinaires ; le tableau ci-dessous en
donne trois, tirés du dressage. Une personne qui ne connaît pas le domaine ne
s’y arrête pas ; pour un traducteur, ce sont justement les mots à vérifier.
Mot
Sens courant
En dressage
rassembler
réunir des personnes ou des choses
l’attitude d’un cheval qui reporte son poids vers l’arrière-main et raccourcit ses foulées ; rassemblé en vient
contact
le fait de toucher, ou d’être en relation
la liaison entre les mains du cavalier et la bouche du cheval, par les rênes
passage
un endroit où l’on passe, ou un extrait de texte
un mouvement : un trot très rassemblé et relevé
Trois termes du dressage qui ressemblent à des mots courants.
Les annotateurs ne s’accordent pas non plus sur le degré de spécialisation
qu’une unité doit avoir pour compter comme terme. Une façon de rendre cette
décision explicite consiste à poser deux questions distinctes, comme le font
les consignes d’ACTER (Rigouts Terryn, 2021a) :
Est-elle spécifique au domaine ? L’unité se rapporte-t-elle au sujet des
textes ? Cette dimension s’appelle la spécificité au domaine.
Est-elle spécifique dans le lexique ? Est-elle connue des seuls spécialistes, ou
fait-elle partie du vocabulaire courant ? Cette dimension s’appelle la spécificité lexicale.
Ces deux dimensions permettent de définir différentes étiquettes de termes.
La Figure 5figure 5 montre les trois étiquettes du schéma d’ACTER : une unité spécifique sur
les deux dimensions est un terme spécifique (Specific Term), une unité spécifique au domaine seulement
est un terme commun (Common Term), et une unité spécifique dans le lexique seulement est un
terme hors domaine (Out-of-Domain Term).
Figure 5. Les deux questions du schéma d'annotation d'ACTER et les trois étiquettes qui en découlent, avec des exemples choisis pour le dressage (d'après Rigouts Terryn, 2021a).
Les deux réponses dépendent de la personne qui les donne, et la limite du domaine est
elle aussi une décision. Quand les textes sur le dressage ont été annotés, les termes d’autres
sports équestres, comme gymkhana ou voltige, ont été étiquetés
hors domaine, parce que le domaine retenu était le dressage et non
l’équitation dans son ensemble (Rigouts Terryn et al., 2019).
Bien connaître un domaine ne règle pas la question non plus. J’ai annoté moi-même les
textes sur le dressage, et je connais bien ce sport : je comprenais la terminologie sans
effort, mais j’avais plus de mal à distinguer les termes du vocabulaire général, parce que
ces termes faisaient désormais partie de mon vocabulaire courant (Rigouts Terryn et
al., 2020a).
Deux façons de trancher les cas
Un projet qui a besoin d’une liste de termes doit trancher les cas sur lesquels les annotateurs
ne s’accordent pas, comme les frontières d’un terme et les mots courants qui ont un
sens spécialisé. Il peut le faire de deux grandes façons.
Des catégories. Un schéma comme celui d’ACTER garde le désaccord visible en
donnant à chaque unité une étiquette : l’une des trois étiquettes de termes
ci-dessus, ou celle d’entité nommée. La liste peut ensuite être rendue stricte ou large,
selon les étiquettes retenues.
Aucune des deux façons ne supprime le désaccord. Toute liste de termes repose sur de tels
choix, qu’elle vienne d’une personne ou d’un outil, et deux listes établies avec
des choix différents ne peuvent pas simplement être comparées comme une bonne et une mauvaise.
Sources
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Liu, S., Lefever, E., & Hoste, V. (2025). MariATE: Automatic Term Extraction Using Large Language Models in the Maritime Domain. Proceedings of the 15th International Conference on Recent Advances in Natural Language Processing (RANLP 2025), 663–673. https://aclanthology.org/2025.ranlp-1.77/
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Term extraction as a taskL'extraction de termes comme tâche
Why extract terms
A list of the terms in a set of texts is useful in several kinds of work,
for instance:
for a translator, the terms in a client’s earlier documents show the
terminology that client uses;
the terms in a text you are about to translate can be looked up and settled
in one go before you start, where you would otherwise stop to research each
term as you come to it;
outside translation, the terms in a company’s manuals are the starting
point for a glossary for new staff, and the terms in a book for its index.
A term extractor can return its candidate terms in two forms (Figure 6figure 6):
A list. Each candidate appears once, however often it occurs, usually
ranked by a score that estimates how likely it is to be a term. The person
who validates the list decides where to stop reading it (Rigouts Terryn et
al., 2019).
The terms in the text. Every occurrence is marked where it appears, the
way a person highlights terms in a document (Lefever & Rigouts Terryn, 2024).
The same word can then be marked in one sentence and left unmarked in
another, where it has its everyday sense (Rigouts Terryn, 2021a).
Figure 6. The same text as a ranked list of candidates and as terms marked in the text. The scores are illustrative.
The challenge was therefore to translate the human notion of a term into
characteristics that a program can measure. Each method in this chapter is
one answer to that challenge, and each answer is imperfect in its own way.
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Pourquoi extraire des termes
La liste des termes d’un ensemble de textes est utile dans plusieurs types de
travail, par exemple :
pour un traducteur, les termes des documents antérieurs d’un client montrent
la terminologie que ce client emploie ;
les termes d’un texte que vous allez traduire peuvent être cherchés et fixés
en une fois avant de commencer, au lieu de vous arrêter pour chercher chaque
terme au moment où vous le rencontrez ;
en dehors de la traduction, les termes des manuels d’une entreprise sont le
point de départ d’un glossaire pour le nouveau personnel, et les termes d’un
livre, celui de son index.
Un extracteur de termes peut renvoyer ses candidats terminologiques sous deux formes (Figure 6figure 6) :
Une liste. Chaque candidat y figure une fois, quel que soit son nombre d’occurrences, le plus souvent
classé selon un score qui estime la probabilité qu’il soit un terme. La personne
qui valide la liste décide où arrêter sa lecture (Rigouts Terryn et
al., 2019).
Les termes dans le texte. Chaque occurrence est marquée là où elle apparaît, comme
lorsqu’on surligne les termes d’un document (Lefever et Rigouts Terryn, 2024).
Le même mot peut alors être marqué dans une phrase et ne pas l’être dans
une autre, où il a son sens courant (Rigouts Terryn, 2021a).
Figure 6. Le même texte sous forme de liste classée de candidats et sous forme de termes marqués dans le texte. Les scores sont donnés à titre d'illustration.
Le défi consistait donc à traduire la notion humaine de terme en
caractéristiques qu’un programme peut mesurer. Chaque méthode de ce chapitre est
une réponse à ce défi, et chaque réponse est imparfaite à sa manière.
Un agent conversationnel à qui l’on demande les termes d’un texte
Trois familles de méthodes d'extraction de termes.
Sources
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Linguistic methods: part-of-speech patternsMéthodes linguistiques : les patrons morphosyntaxiques
Most terms are nouns or groups built around a noun, such as piaffe,
collected canter or canter pirouette, although adjectives, verbs and
adverbs can be terms too (Rigouts Terryn, 2021a).
If a program can get the parts of speech, and terms tend to have certain
sequences of them, then it can extract every sequence of that form. One of
the earliest algorithms for finding terms in text already worked this way
(Justeson & Katz, 1995).
The reasoning has a flaw: a noun or a group built around a noun can be a
term, but that does not mean that it is one.
Part-of-speech patterns
The linguistic method works in three steps (Lefever & Rigouts Terryn, 2024):
Typical patterns of terms, with a dressage example in each language where the pattern is common.
Figure 7figure 7 shows the three steps on one sentence, and what they return: five
candidates, of which two are terms, and one term that no pattern matches.
Figure 7. Tagging and pattern matching on one sentence, with the candidates the two patterns return and the term they miss. The tags are simplified.
Noise. In the sentence of Figure 7figure 7,
little girl has the same shape as flying change, and a pattern for
single nouns catches every noun in the text: girl, and change on its
own, which is only a fragment of a term.
It is nearly impossible to write every pattern a term can take, especially
since the tagger makes mistakes of its own (Rigouts Terryn et al., 2019).
The more patterns you have, the less likely you are to miss terms (less
silence), but the more likely you are to extract non-terms as well (more
noise).
Figure 8. The grammatical patterns of the candidates TermoStat extracted from a French corpus about dressage (TermoStat 4.0 beta, 30 September 2026). The interface changes.
Patterns depend on the domain as well. A term that starts with a
preposition, such as on the bit, is common in dressage and uncommon in many
other domains, so a list of patterns that suits one domain can miss terms in
another.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Justeson, J. S., & Katz, S. M. (1995). Technical terminology: some linguistic properties and an algorithm for identification in text. Natural Language Engineering, 1(1), 9–27. https://doi.org/10.1017/S1351324900000048
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
La plupart des termes sont des noms ou des groupes construits autour d’un nom, comme piaffer,
galop rassemblé ou pirouette au galop, même si des adjectifs, des verbes et des
adverbes peuvent aussi être des termes (Rigouts Terryn, 2021a).
Si un programme peut obtenir les parties du discours, et si les termes tendent à suivre certaines
suites de parties du discours, il peut alors extraire toutes les suites de cette forme. L’un des
premiers algorithmes de repérage de termes dans un texte fonctionnait déjà ainsi
(Justeson et Katz, 1995).
Ce raisonnement a un défaut : un nom ou un groupe construit autour d’un nom peut être un
terme, mais cela ne veut pas dire qu’il en est un.
Les patrons morphosyntaxiques
La méthode linguistique procède en trois étapes (Lefever et Rigouts Terryn, 2024) :
Patrons typiques des termes, avec un exemple du dressage dans chaque langue où le patron est courant.
La Figure 7figure 7 montre les trois étapes sur une phrase, et ce qu’elles renvoient : cinq
candidats, dont trois sont des termes, et un terme qu’aucun patron ne retient.
Figure 7. L'étiquetage et le repérage des patrons sur une phrase, avec les candidats que renvoient les deux patrons et le terme qu'ils manquent. Les étiquettes sont simplifiées.
Le bruit. Dans la phrase de la Figure 7figure 7,
fillette joyeuse a la même forme que galop rassemblé, et un patron pour les
noms seuls retient tous les noms du texte, dont fillette.
Il est à peu près impossible d’écrire tous les patrons qu’un terme peut suivre, d’autant
que l’étiqueteur commet ses propres erreurs (Rigouts Terryn et al., 2019).
Plus vous avez de patrons, moins vous risquez de manquer des termes (moins de
silence), mais plus vous risquez d’extraire aussi des unités qui ne sont pas des termes (plus de
bruit).
Figure 8. Les patrons grammaticaux des candidats que TermoStat a extraits d'un corpus français sur le dressage (TermoStat 4.0 bêta, 30 septembre 2026). L'interface change.
Les patrons dépendent aussi du domaine. Un terme qui commence par une
préposition, comme sur la main, est courant en dressage et peu courant dans beaucoup
d’autres domaines, si bien qu’une liste de patrons adaptée à un domaine peut manquer des termes dans
un autre.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Justeson, J. S., & Katz, S. M. (1995). Technical terminology: some linguistic properties and an algorithm for identification in text. Natural Language Engineering, 1(1), 9–27. https://doi.org/10.1017/S1351324900000048
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Statistical methods: termhood and unithoodMéthodes statistiques : degré de termitude et degré de figement
A term occurs relatively more often in the texts of its domain than in general text
Unithood
Do the words of a unit of several words form one unit? Flying change does; the horse changes does not, although its words often appear together.
How often the words of a candidate occur together, and how often each occurs on its own
The words of a term occur together more often than unrelated words do
Termhood and unithood: the question, the count and the assumption.
Termhood: comparing two corpora
A specialized corpus and a general one, such as a large collection of
newspaper articles (Drouin, 2003), are never the same size, so the counts
themselves cannot be compared. The comparison
uses relative frequencies: the number of occurrences divided by the size
of the corpus, often given per million words (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus).
The table below gives six words, with illustrative figures.
Word
Dressage corpus (200,000 words)
Per million
General corpus (100 million words)
Per million
How many times more frequent in dressage
the
12,105
60,525
6,031,000
60,310
1.0
next
153
765
70,400
704
1.1
horse
1,874
9,370
25,300
253
37
canter
468
2,340
1,240
12.4
189
piaffe
31
155
12
0.12
1,292
collection
63
315
19,800
198
1.6
Absolute and relative frequencies in a specialized and a general corpus. The figures are illustrative.
Figure 9figure 9 draws four of those words. Counted in occurrences, every word is
more frequent in the general corpus, because that corpus is 500 times larger.
Counted per million words, the six words of the table fall into four cases:
the and next are about as frequent in both corpora, so nothing ties
them to dressage;
horse is far more frequent in the dressage corpus, but it is also a
common word elsewhere;
canter and piaffe hardly occur outside texts about riding;
collection is a dressage term, but it is only 1.6 times more frequent in
the dressage corpus, because it is also an everyday word.
Figure 9. The same four words counted in occurrences and per million words. The figures are illustrative; the bars are to scale within each pair.
Corpus tools offer the same comparison under another name: Sketch Engine’s
Keywords function lists the words that are far more frequent in your corpus
than in a reference corpus of general language (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
A worked example: the log-likelihood ratio
Relative frequencies leave one question open: a word can be more frequent in
a small corpus by chance, especially when it occurs only a few times.
Statistical measures of termhood therefore take into account how much
evidence there is, as well as how large the difference is.
The log-likelihood ratio serves here as a worked example. It is a common
measure (Lefever & Rigouts Terryn, 2024), but one among many. The goal is to
understand the principle; the exact formula and the mathematical details are
not needed for that.
For each word, e.g., canter, the calculation goes through four steps, with
the figures of the frequency table above:
Counts.Canter occurs 468 times in the dressage corpus of 200,000
words, and 1,240 times in the general corpus of 100 million words.
Relative frequencies. 468 divided by 200,000 is 2,340 occurrences per
million words in the dressage corpus; 1,240 divided by 100 million is 12.4
per million in the general corpus. Canter is about 190 times more
frequent in the dressage corpus.
Expected counts. The two corpora together contain 1,708 occurrences of
canter, and the dressage corpus is about 0.2% of all the text. If
canter were equally frequent everywhere, about 3 of the 1,708
occurrences would be in the dressage corpus (0.2% of 1,708). There are
468.
Score. The log-likelihood ratio compares the counts that were observed
with the counts that were expected, 468 against about 3, and gives
canter a score of 3,818. A word whose counts are exactly as expected
scores zero. The further the counts are from the expected ones, and the
more occurrences there are to support the difference, the higher the
score.
Figure 10figure 10 gives, for the six words of the frequency table, how many times more
frequent each word is in the dressage corpus, how often it occurs there, and
its log-likelihood ratio.
Figure 10. Three numbers for six words: the size of the difference, the number of occurrences, and the log-likelihood ratio that results. The figures are illustrative; the bars are to scale within each column.
Three things can be read from the figure:
The has by far the most occurrences and a score close to zero.
Frequency alone says nothing about how specific a word is.
Piaffe is about 1,300 times more frequent in the dressage corpus, the
largest difference of the six, but it scores far below horse, which is
only 37 times more frequent. Thirty-one occurrences are less evidence than
1,874.
A high score needs both: a clear difference and enough occurrences to
support it.
Collection scores 11.7, far below piaffe, which has half as many
occurrences. It is a dressage term, the way a horse shifts its weight
towards its hindquarters, and also an everyday word, as in an art
collection (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique).
A program counts written forms and cannot tell the two senses apart, so
the everyday uses in the general corpus pull the score down.
When a difference counts
A less clear case shows why the score is needed. The table below gives two
words that are both one and a half times more frequent in the dressage
corpus than in the general one, with illustrative figures.
Word
Occurrences in the dressage corpus
Per million
Per million in the general corpus
How many times more frequent in dressage
Log-likelihood ratio
weather
7
35
23
1.5
1.1
leg
312
1,560
1,026
1.5
47.8
Two words with the same difference in relative frequency and different scores. The figures are illustrative.
The difference in relative frequency is the same for both words, but seven
occurrences are too few to rely on: one or two more or fewer would change
the picture. Three hundred and twelve occurrences are enough.
By the usual convention, a score above 3.84 means that a difference of that
size would come about by chance less than 5 times in 100, and the difference
is then called statistically significant.The thresholds are given with the log-likelihood calculator
of the UCREL centre at Lancaster University: 3.84 for 5 chances in 100 and
6.63 for 1 in 100 (read 1 October 2026).Figure 11figure 11 places the eight words of the two tables on either side of that threshold.
Figure 11. The scores of the eight example words and the threshold of 3.84, on a logarithmic scale. Filled dots are dressage terms. The figures are illustrative.
The scores in a term extractor
A term extractor reports these numbers for each candidate. In TermoStat’s
list of results (Figure 12figure 12), each row gives the frequency of the candidate in the corpus (Freq) and
several scores computed against a reference corpus, the log-likelihood ratio
(LL) among them (see also the TermoStat: a hybrid extractor page, in the Classical NLP module) (voir aussi la page TermoStat : un extracteur hybride, dans le module TAL classique).
Figure 12. The frequency and the scores of the first five candidates TermoStat extracted from a French corpus about dressage (TermoStat 4.0 beta, 1 October 2026). The interface changes.
Unithood: words that occur together
Flying and change are both ordinary words, but in dressage texts they
occur side by side far more often than chance would put them together. Good
and horse also occur together often, but mostly because both are frequent.
Measures of unithood compare how often the words of a candidate occur
together with how often each occurs on its own (Lefever & Rigouts Terryn,
2024).
Unithood alone does not identify terms. It measures how firmly words stick
together, which is also true of fixed expressions that are not terms, such as
in the end or on the other hand (Kageura & Umino, 1996). Measures designed
for terms of several words, such as the C-value (Frantzi et al., 2000),
exist for that reason, and it is also why the statistical measures are
usually combined with the linguistic
patterns (see also the Hybrid term extraction page, in the Classical NLP module) (voir aussi la page L'extraction hybride de termes, dans le module TAL classique).
They need no knowledge of the language: the same counts work for English, French or Dutch, provided a general corpus exists in that language.
Requirement
They need enough text: a few pages give too few occurrences for the measure to separate the terms from the rest.
Silence
A word that occurs once or twice scores low, however specialized it is, so rare terms are easily missed (Rigouts Terryn et al., 2019). A term that is also an everyday word, such as collection, scores low too, because it is frequent in general text as well.
Noise
A high score does not make a term: a word can be frequent in these texts for another reason, such as the name of a rider, and a fragment of a longer term scores as readily as the whole term.
Strengths and limits of statistical methods.
Sources
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Frantzi, K., Ananiadou, S., & Mima, H. (2000). Automatic recognition of multi-word terms: the C-value/NC-value method. International Journal on Digital Libraries, 3(2), 115–130. https://doi.org/10.1007/s007999900023
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rayson, P., & Garside, R. (2000). Comparing Corpora using Frequency Profiling. Proceedings of the Workshop on Comparing Corpora, 38th Annual Meeting of the Association for Computational Linguistics, 1–6. https://aclanthology.org/W00-0901/
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Un terme apparaît relativement plus souvent dans les textes de son domaine que dans les textes généraux
Degré de figement
Les mots d’une unité de plusieurs mots forment-ils une seule unité ? Oui pour changement de pied ; non pour le cheval change, même si ces mots apparaissent souvent ensemble.
Le nombre de fois où les mots d’un candidat apparaissent ensemble, et le nombre de fois où chacun apparaît seul
Les mots d’un terme apparaissent ensemble plus souvent que des mots sans lien
Le degré de termitude et le degré de figement : la question, le compte et l'hypothèse.
Le degré de termitude : comparer deux corpus
Un corpus spécialisé et un corpus général, par exemple un grand ensemble
d’articles de journaux (Drouin, 2003), n’ont jamais la même taille, si bien que les
nombres d’occurrences ne peuvent pas être comparés tels quels. La comparaison
se fait avec des fréquences relatives : le nombre d’occurrences divisé par la taille
du corpus, souvent exprimé par million de mots (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus).
Le tableau ci-dessous donne six mots, avec des chiffres fournis à titre d’illustration.
Mot
Corpus de dressage (200 000 mots)
Par million
Corpus général (100 millions de mots)
Par million
Combien de fois plus fréquent en dressage
le
12 105
60 525
6 031 000
60 310
1,0
prochain
153
765
70 400
704
1,1
cheval
1 874
9 370
25 300
253
37
galop
468
2 340
1 240
12,4
189
piaffer
31
155
12
0,12
1 292
passage
63
315
19 800
198
1,6
Fréquences absolues et relatives dans un corpus spécialisé et dans un corpus général. Les chiffres sont donnés à titre d'illustration.
La Figure 9figure 9 représente quatre de ces mots. En nombre d’occurrences, chaque mot est
plus fréquent dans le corpus général, parce que ce corpus est 500 fois plus grand.
Par million de mots, les six mots du tableau se répartissent en quatre cas :
le et prochain sont à peu près aussi fréquents dans les deux corpus, si bien que rien ne les
rattache au dressage ;
cheval est beaucoup plus fréquent dans le corpus de dressage, mais c’est aussi un
mot courant ailleurs ;
galop et piaffer n’apparaissent presque pas en dehors des textes sur l’équitation ;
passage est un terme du dressage, mais il n’est que 1,6 fois plus fréquent dans
le corpus de dressage, parce que c’est aussi un mot courant.
Figure 9. Les quatre mêmes mots comptés en occurrences et par million de mots. Les chiffres sont donnés à titre d'illustration ; les barres sont à l'échelle à l'intérieur de chaque paire.
Les outils d’analyse de corpus proposent la même comparaison sous un autre nom : la fonction
Keywords de Sketch Engine dresse la liste des mots beaucoup plus fréquents dans votre corpus
que dans un corpus de référence de langue générale (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Un exemple détaillé : le rapport de vraisemblance
Les fréquences relatives laissent une question ouverte : un mot peut être plus fréquent dans
un petit corpus par hasard, surtout s’il n’y apparaît que quelques fois.
Les mesures statistiques du degré de termitude tiennent donc compte de la quantité
d’indices disponibles, en plus de l’ampleur de la différence.
Le rapport de vraisemblance (angl. log-likelihood ratio) sert ici d’exemple détaillé. C’est une mesure
courante (Lefever et Rigouts Terryn, 2024), mais une parmi beaucoup d’autres. Le but est
d’en comprendre le principe ; la formule exacte et les détails mathématiques ne sont
pas nécessaires pour cela.
Pour chaque mot, par exemple galop, le calcul passe par quatre étapes, avec
les chiffres du tableau de fréquences ci-dessus :
Les occurrences.Galop apparaît 468 fois dans le corpus de dressage de 200 000
mots, et 1 240 fois dans le corpus général de 100 millions de mots.
Les fréquences relatives. 468 divisé par 200 000 donne 2 340 occurrences par
million de mots dans le corpus de dressage ; 1 240 divisé par 100 millions donne 12,4
par million dans le corpus général. Galop est environ 190 fois plus
fréquent dans le corpus de dressage.
Les occurrences attendues. Les deux corpus contiennent ensemble 1 708 occurrences de
galop, et le corpus de dressage représente environ 0,2 % de tout le texte. Si
galop était aussi fréquent partout, environ 3 des 1 708
occurrences se trouveraient dans le corpus de dressage (0,2 % de 1 708). Il y en a
468.
Le score. Le rapport de vraisemblance compare les occurrences observées
aux occurrences attendues, 468 contre 3 environ, et donne à
galop un score de 3 818. Un mot dont les occurrences correspondent exactement à ce qui est attendu
obtient zéro. Plus les occurrences s’éloignent de ce qui est attendu, et plus
elles sont nombreuses à appuyer cette différence, plus le score est
élevé.
La Figure 10figure 10 donne, pour les six mots du tableau de fréquences, combien de fois
chaque mot est plus fréquent dans le corpus de dressage, combien de fois il y apparaît, et
son rapport de vraisemblance.
Figure 10. Trois chiffres pour six mots : l'ampleur de la différence, le nombre d'occurrences, et le rapport de vraisemblance qui en résulte. Les chiffres sont donnés à titre d'illustration ; les barres sont à l'échelle à l'intérieur de chaque colonne.
La figure permet de lire trois choses :
Le a de loin le plus d’occurrences et un score proche de zéro.
La fréquence seule ne dit rien de la spécificité d’un mot.
Piaffer est environ 1 300 fois plus fréquent dans le corpus de dressage, la
plus grande différence des six, mais son score est bien inférieur à celui de cheval, qui n’est
que 37 fois plus fréquent. Trente et une occurrences sont un indice plus faible que
1 874.
Un score élevé demande les deux : une différence nette et assez d’occurrences pour
l’appuyer.
Passage obtient 11,7, bien en dessous de piaffer, qui a deux fois moins
d’occurrences. C’est un terme du dressage, un trot très rassemblé et relevé,
et aussi un mot courant, comme dans un passage pour
piétons (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique).
Un programme compte des formes écrites et ne peut pas distinguer les deux sens, si bien que
les emplois courants du corpus général font baisser le score.
À partir de quand une différence compte
Un cas moins net montre pourquoi le score est nécessaire. Le tableau ci-dessous donne deux
mots qui sont tous deux une fois et demie plus fréquents dans le corpus de dressage
que dans le corpus général, avec des chiffres fournis à titre d’illustration.
Mot
Occurrences dans le corpus de dressage
Par million
Par million dans le corpus général
Combien de fois plus fréquent en dressage
Rapport de vraisemblance
météo
7
35
23
1,5
1,1
jambe
312
1 560
1 026
1,5
47,8
Deux mots qui présentent la même différence de fréquence relative et des scores différents. Les chiffres sont donnés à titre d'illustration.
La différence de fréquence relative est la même pour les deux mots, mais sept
occurrences sont trop peu pour s’y fier : une ou deux de plus ou de moins changeraient
le tableau. Trois cent douze occurrences suffisent.
Par convention, un score supérieur à 3,84 signifie qu’une différence de cette
ampleur apparaîtrait par hasard moins de 5 fois sur 100, et la différence
est alors dite statistiquement significative.Les seuils sont donnés avec le calculateur du rapport de vraisemblance
du centre UCREL de l’Université de Lancaster : 3,84 pour 5 chances sur 100 et
6,63 pour 1 sur 100 (consulté le 1er octobre 2026). La Figure 11figure 11 place les huit mots des deux tableaux de part et d’autre de ce seuil.
Figure 11. Les scores des huit mots donnés en exemple et le seuil de 3,84, sur une échelle logarithmique. Les points pleins sont des termes du dressage. Les chiffres sont donnés à titre d'illustration.
Les scores dans un extracteur de termes
Un extracteur de termes donne ces chiffres pour chaque candidat. Dans la
liste de résultats de TermoStat (Figure 12figure 12), chaque ligne indique la fréquence du candidat dans le corpus (Freq) et
plusieurs scores calculés par rapport à un corpus de référence, dont le rapport de vraisemblance
(LL) (see also the TermoStat: a hybrid extractor page, in the Classical NLP module) (voir aussi la page TermoStat : un extracteur hybride, dans le module TAL classique).
Figure 12. La fréquence et les scores des cinq premiers candidats que TermoStat a extraits d'un corpus français sur le dressage (TermoStat 4.0 bêta, 1er octobre 2026). L'interface change.
Le degré de figement : des mots qui apparaissent ensemble
Changement et pied sont deux mots ordinaires, mais dans les textes sur le dressage ils
apparaissent côte à côte bien plus souvent que le hasard ne les ferait se rencontrer. Bon
et cheval apparaissent souvent ensemble eux aussi, mais surtout parce que les deux sont fréquents.
Les mesures du degré de figement comparent le nombre de fois où les mots d’un candidat apparaissent
ensemble au nombre de fois où chacun apparaît seul (Lefever et Rigouts Terryn,
2024).
Le degré de figement ne suffit pas à identifier les termes. Il mesure la solidité du lien entre des mots,
et ce lien est tout aussi solide dans des expressions figées qui ne sont pas des termes, comme
à la fin ou d’autre part (Kageura et Umino, 1996). Des mesures conçues
pour les termes de plusieurs mots, comme la C-value (Frantzi et al., 2000),
existent pour cette raison, et c’est aussi pourquoi les mesures statistiques sont
le plus souvent combinées aux patrons
morphosyntaxiques (see also the Hybrid term extraction page, in the Classical NLP module) (voir aussi la page L'extraction hybride de termes, dans le module TAL classique).
Les forces et les limites des méthodes statistiques
Elles n’ont besoin d’aucune connaissance de la langue : les mêmes comptes valent pour l’anglais, le français ou le néerlandais, à condition qu’un corpus général existe dans cette langue.
Condition
Il leur faut assez de texte : quelques pages donnent trop peu d’occurrences pour que la mesure sépare les termes du reste.
Silence
Un mot qui apparaît une ou deux fois obtient un score faible, aussi spécialisé soit-il, si bien que les termes rares sont facilement manqués (Rigouts Terryn et al., 2019). Un terme qui est aussi un mot courant, comme passage, obtient lui aussi un score faible, parce qu’il est également fréquent dans les textes généraux.
Bruit
Un score élevé ne fait pas un terme : un mot peut être fréquent dans ces textes pour une autre raison, comme le nom d’un cavalier, et un fragment d’un terme plus long obtient un score aussi facilement que le terme entier.
Les forces et les limites des méthodes statistiques.
Sources
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Frantzi, K., Ananiadou, S., & Mima, H. (2000). Automatic recognition of multi-word terms: the C-value/NC-value method. International Journal on Digital Libraries, 3(2), 115–130. https://doi.org/10.1007/s007999900023
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rayson, P., & Garside, R. (2000). Comparing Corpora using Frequency Profiling. Proceedings of the Workshop on Comparing Corpora, 38th Annual Meeting of the Association for Computational Linguistics, 1–6. https://aclanthology.org/W00-0901/
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Hybrid term extractionL'extraction hybride de termes
Two methods with opposite weaknesses
Linguistic and statistical methods fail in different ways, as the table
below sets out, and each does well where the other fails.
Method
What it gives
What it lacks
Linguistic
candidates with the grammatical form of a term
any way of telling a term from another sequence of the same form
Statistical
a ranking of words by how specific they are to the domain
any account of grammar: it scores single words and fragments as readily as whole terms
What linguistic and statistical methods each give and lack.
A hybrid extractor combines the two.
The two steps
A hybrid extractor works in two steps (Figure 13figure 13).
Figure 13. The two steps of a hybrid term extractor, with examples from dressage.
The result is a list of candidates ordered from most to least likely to be a
term. Nothing in it says where the terms stop: the person who uses the list
chooses a cut-off, reads the top of it, or sets a threshold on the score
(Rigouts Terryn et al., 2019). TermoStat is a tool of this
kind (see also the TermoStat: a hybrid extractor page, in the Classical NLP module) (voir aussi la page TermoStat : un extracteur hybride, dans le module TAL classique).
Strengths and limits
The table below sets the strengths of a hybrid extractor beside its limits.
Strengths
Limits
Transparent. Each candidate is on the list because it matched a pattern and scored high, so you can see why it is there.
Repeatable. The same text gives the same list every time.
Rare terms are easily missed. A term that occurs once or twice scores low, however specialized it is (Rigouts Terryn et al., 2019).
The cut-off is yours. On a collection of Dutch texts about dressage, TermoStat’s full list contained almost two thirds of the terms people had marked, but fewer than one candidate in five was a term (Rigouts Terryn et al., 2019).
The patterns depend on the language. They are written for one language, and a term with an unusual structure falls outside them.
Strengths and limits of a hybrid term extractor.
On the size of the corpus, TermoStat’s guide recommends at least 50,000 words
and warns that under 10,000 few candidates come out as statistically
significant.TermoStat, Guide de l’utilisateur, version 4.0 beta,
read 30 September 2026. The Keywords function of Sketch Engine ranks
words by the same kind of comparison and has the same
limit (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Deux méthodes aux faiblesses opposées
Les méthodes linguistiques et statistiques échouent de façons différentes, comme le montre le
tableau ci-dessous, et chacune réussit là où l’autre échoue.
Méthode
Ce qu’elle apporte
Ce qui lui manque
Linguistique
des candidats qui ont la forme grammaticale d’un terme
un moyen de distinguer un terme d’une autre suite de même forme
Statistique
un classement des mots selon leur spécificité au domaine
toute prise en compte de la grammaire : elle donne un score aux mots isolés et aux fragments aussi facilement qu’aux termes entiers
Ce que les méthodes linguistiques et statistiques apportent, et ce qui leur manque.
Un extracteur hybride combine les deux.
Les deux étapes
Un extracteur hybride procède en deux étapes (Figure 13figure 13).
Figure 13. Les deux étapes d'un extracteur de termes hybride, avec des exemples du dressage.
Le résultat est une liste de candidats classés du plus probable au moins probable comme
terme. Rien n’y indique où les termes s’arrêtent : la personne qui utilise la liste
choisit un seuil, en lit le début, ou fixe un score minimal
(Rigouts Terryn et al., 2019). TermoStat est un outil de ce
type (see also the TermoStat: a hybrid extractor page, in the Classical NLP module) (voir aussi la page TermoStat : un extracteur hybride, dans le module TAL classique).
Les forces et les limites
Le tableau ci-dessous met les forces d’un extracteur hybride en regard de ses limites.
Forces
Limites
Transparent. Chaque candidat figure dans la liste parce qu’il correspondait à un patron et a obtenu un score élevé : vous pouvez donc voir pourquoi il s’y trouve.
Reproductible. Le même texte donne chaque fois la même liste.
Les termes rares sont facilement manqués. Un terme qui apparaît une ou deux fois obtient un score faible, aussi spécialisé soit-il (Rigouts Terryn et al., 2019).
Le seuil vous revient. Sur un ensemble de textes néerlandais sur le dressage, la liste complète de TermoStat contenait près des deux tiers des termes annotés par des personnes, mais moins d’un candidat sur cinq était un terme (Rigouts Terryn et al., 2019).
Les patrons dépendent de la langue. Ils sont écrits pour une langue, et un terme de structure inhabituelle leur échappe.
Les forces et les limites d'un extracteur de termes hybride.
Sur la taille du corpus, le guide de TermoStat recommande au moins 50 000 mots
et prévient qu’en dessous de 10 000, peu de candidats ressortent comme statistiquement
significatifs.TermoStat, Guide de l’utilisateur, version 4.0 bêta,
consulté le 30 septembre 2026. La fonction Keywords de Sketch Engine classe
les mots selon le même type de comparaison et a la même
limite (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
TermoStat: a hybrid extractorTermoStat : un extracteur hybride
Running TermoStat takes three settingsTermoStat, Guide de l’utilisateur, version 4.0 beta, read
30 September 2026; the guide is in the tool’s Help menu, behind the login. (Figure 14figure 14):
the parts of speech to extract, among nouns, noun phrases, adjectives,
verbs and adverbs.
Figure 14. TermoStat's settings for one corpus: the language and the parts of speech to extract.
The ranked list and its scores
TermoStat returns a list of candidates ranked by specificity (Figure 15figure 15).
Each row gives the candidate, the forms it takes in the corpus, its
grammatical pattern, its frequency and its scores.
Figure 15. The top of TermoStat's ranked list for a French corpus about dressage: the candidates sorted by specificity, with their forms, pattern, frequency and scores, and the validation column on the left.
The first score, Spec, ranks the list (Drouin et al., 2020). The other
columns measure the same comparison in other ways, as the table below sets
out.
Column
What it measures
Spec
specificity: how far the candidate’s frequency in the corpus departs from the frequency the reference corpus predicts
Chi² and LL
two statistical tests of that difference, the chi-square and the log-likelihood; the guide calls the second more reliable for infrequent candidates
LogOdd
how many times more likely the candidate is in the corpus than in the reference corpus, on a logarithmic scale
Weird.
the candidate’s relative frequency in the corpus divided by its relative frequency in the reference corpus
Disp.
how evenly the candidate is spread over the corpus
Spec β
Spec multiplied by Disp., so that a candidate frequent in one document only moves down the list
The score columns of TermoStat's list, after its user guide (version 4.0 beta).
Term bank badges
In TermoStat’s list of results, a badge beside a candidate names a term bank that publishes a definition for
it, and opening it shows the bank’s definitions with their subject fields
(Figure 16figure 16).
When a bank has several records, the tool orders them by how well they fit
the corpus. Its own guide calls that order a hint and not a verdict, right
about two times in three: for cheval, the records shown are a
racquet-sports move and a gymnastics apparatus.
Figure 16. The term bank records TermoStat found for one candidate: neither of them is the dressage sense.
Validating and exporting
In the first column of TermoStat’s list of results, every candidate can be
accepted or rejected, which is the validation step done inside the tool. The sentences a
candidate occurs in are the quickest check on a doubtful one (Figure 17figure 17):
they show whether the word always names a concept of the domain, or also
turns up in its everyday sense. Other tabs give its collocates, the
grammatical patterns of all the candidates, and a word cloud.
Figure 17. The occurrences of one candidate in context, the view a concordancer gives.
The list can be downloaded in two formats, which keep different parts of the
result. The spreadsheet (TSV) has every column of the list, one candidate per
row, and is the file to work from when you want to sort, filter or count; the
first twenty rows are below.
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Drouin, P., Morel, J.-B., & L'Homme, M.-C. (2020). Automatic Term Extraction from Newspaper Corpora: Making the Most of Specificity and Common Features. In B. Daille, K. Kageura & A. Rigouts Terryn (Eds.), Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020) (pp. 1–7). European Language Resources Association. https://aclanthology.org/2020.computerm-1.1/
Lancer TermoStat demande trois réglagesTermoStat, Guide de l’utilisateur, version 4.0 bêta, consulté le
30 septembre 2026 ; le guide se trouve dans le menu Aide de l’outil, après connexion. (Figure 14figure 14) :
les parties du discours à extraire, parmi les noms, les syntagmes nominaux, les adjectifs,
les verbes et les adverbes.
Figure 14. Les réglages de TermoStat pour un corpus : la langue et les parties du discours à extraire.
La liste classée et ses scores
TermoStat renvoie une liste de candidats classés par spécificité (Figure 15figure 15).
Chaque ligne donne le candidat, les formes qu’il prend dans le corpus, son
patron grammatical, sa fréquence et ses scores.
Figure 15. Le début de la liste classée de TermoStat pour un corpus français sur le dressage : les candidats triés par spécificité, avec leurs formes, leur patron, leur fréquence et leurs scores, et la colonne de validation à gauche.
Le premier score, Spec, classe la liste (Drouin et al., 2020). Les autres
colonnes mesurent la même comparaison d’autres façons, comme le présente le tableau
ci-dessous.
Colonne
Ce qu’elle mesure
Spec
la spécificité : l’écart entre la fréquence du candidat dans le corpus et la fréquence que prédit le corpus de référence
Chi² et LL
deux tests statistiques de cette différence, le chi-deux et le rapport de vraisemblance ; le guide juge le second plus fiable pour les candidats peu fréquents
LogOdd
combien de fois le candidat est plus probable dans le corpus que dans le corpus de référence, sur une échelle logarithmique
Weird.
la fréquence relative du candidat dans le corpus divisée par sa fréquence relative dans le corpus de référence
Disp.
la régularité de la répartition du candidat dans le corpus
Spec β
Spec multiplié par Disp., de sorte qu’un candidat fréquent dans un seul document descend dans la liste
Les colonnes de scores de la liste de TermoStat, d'après son guide de l'utilisateur (version 4.0 bêta).
Les badges de banques terminologiques
Dans la liste de résultats de TermoStat, un badge à côté d’un candidat nomme une banque terminologique qui en publie une
définition, et l’ouvrir affiche les définitions de la banque avec leurs domaines
(Figure 16figure 16).
Quand une banque a plusieurs fiches, l’outil les ordonne selon leur proximité avec
le corpus. Son propre guide présente cet ordre comme un indice et non comme un verdict, juste
environ deux fois sur trois : pour cheval, les fiches affichées concernent un
déplacement des sports de raquette et un agrès de gymnastique.
Figure 16. Les fiches de banques terminologiques que TermoStat a trouvées pour un candidat : aucune des deux ne correspond au sens du dressage.
La validation et l’exportation
Dans la première colonne de la liste de résultats de TermoStat, chaque candidat peut être
accepté ou rejeté : c’est l’étape de validation, faite dans l’outil même. Les phrases où un
candidat apparaît sont le moyen le plus rapide de vérifier un cas douteux (Figure 17figure 17) :
elles montrent si le mot désigne toujours un concept du domaine, ou s’il
apparaît aussi dans son sens courant. D’autres onglets donnent ses cooccurrents, les
patrons grammaticaux de tous les candidats et un nuage de mots.
Figure 17. Les occurrences d'un candidat en contexte, la vue que donne un concordancier.
La liste se télécharge dans deux formats, qui ne conservent pas les mêmes parties du
résultat. Le tableur (TSV) contient toutes les colonnes de la liste, un candidat par
ligne, et c’est le fichier à utiliser pour trier, filtrer ou compter ; les
vingt premières lignes figurent ci-dessous.
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Drouin, P., Morel, J.-B., & L'Homme, M.-C. (2020). Automatic Term Extraction from Newspaper Corpora: Making the Most of Specificity and Common Features. In B. Daille, K. Kageura & A. Rigouts Terryn (Eds.), Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020) (pp. 1–7). European Language Resources Association. https://aclanthology.org/2020.computerm-1.1/
Machine-learning methods for term extractionMéthodes d'extraction de termes par apprentissage automatique
Four candidates as rows of features, with the label from the annotation. The values are illustrative.
Classifying candidates: HAMLET
HAMLET, a tool I developed with Véronique Hoste and Els Lefever, follows the
steps of the hybrid method but learns them from examples. The grammatical
patterns come from the annotated texts instead of a hand-written list, and a
classifier labels each candidate as a term or not, from many features
(Rigouts Terryn et al., 2021).
On the same Dutch texts about dressage, HAMLET proposed far fewer candidates
than TermoStat, and a much larger share of them were terms, while
TermoStat’s longer list contained somewhat more of the terms people had
marked. HAMLET also found more of the terms that occurred only once, which a
single frequency-based measure tends to miss (Rigouts Terryn et al., 2019).
Sequence labelling is a second kind of supervised model for term extraction,
and it does not start from a list of candidates. It reads the text word by
word and gives each word a label, as Figure 18figure 18
shows: B for the first word of a term, I for a word inside a term, and
O for a word outside any term (Rigouts Terryn et al., 2022b). This is
called sequence labelling, and the same technique is used to find names in
texts (see also the A tour of NLP tasks chapter, in the Classical NLP module) (voir aussi le chapitre Tour d'horizon des tâches du TAL, dans le module TAL classique).
Figure 18. Sequence labelling: each word is labelled as the beginning of a term (B), inside a term (I) or outside (O).
Figure 19. The settings of the D-Terminer demo: the labelling scheme, the training domains and the term labels (1 October 2026). The interface changes.
Its two views of a result are the two forms of output: a list, and the terms
marked in the text. In the list (Figure 20figure 20), one column counts how often a candidate occurs in the corpus and another
how often it was marked as a term. The two differ, because the model labels
each occurrence separately: pas occurs 278 times in these French texts and is
marked 46 times, since pas is the walk, a gait of the horse, and also the
French word for “not”. The context view
(Figure 21figure 21) shows the same candidates where they occur in one text.
Figure 20. The list view of the D-Terminer demo on French texts about dressage: each candidate once, with its occurrences in the corpus and the number of times it was marked as a term (1 October 2026). Figure 21. The context view of the D-Terminer demo: the candidates marked where they occur in one text, with the list for that text beside it (1 October 2026).
Comparing the two approaches
A model that classifies candidates and a model that labels sequences differ
in what they decide on and in what they can return, as the table below sets out (Rigouts Terryn et al., 2021, 2022a,
2022b).
Classifying candidates
Sequence labelling
What it labels
each candidate of a list, once
each word, in the sentence where it occurs
Output
a list of terms
terms marked in the text
The same word in two sentences
one decision for both
can be a term in one and not in the other
A shorter term inside a longer one
both can be kept
only the longest: one line of B, I and O labels cannot mark both
Amount of text
a corpus, since several features are frequencies
a single sentence is enough
A classifier of candidates and a sequence labeller, compared.
The language. Scores were lower in French than in Dutch. A likely
reason is compounding: a Dutch term is often one compound word where French
and English need several words, and terms of several words are harder to
extract (Rigouts Terryn, 2026; Rigouts Terryn et al., 2022b).
The amount of data. More annotated examples help (Rigouts Terryn et
al., 2021), and a model that sorts a list also needs enough text to
extract from, since several of its features are frequencies.
The kind of term. Terms of several words, and terms that are also
everyday words, are found less often than the others (Rigouts Terryn et
al., 2022b).
The method. The behaviour of a model that learned from examples is
less predictable than a set of rules (Rigouts Terryn et al., 2021).
Sources
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2021). HAMLET: Hybrid Adaptable Machine Learning approach to Extract Terminology. Terminology, 27(2), 254–293. https://doi.org/10.1075/term.20017.rig
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Rigouts Terryn, A., Hoste, V., Drouin, P., & Lefever, E. (2020b). TermEval 2020: Shared Task on Automatic Term Extraction Using the Annotated Corpora for Term Extraction Research (ACTER) Dataset. Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020), 85–94. https://aclanthology.org/2020.computerm-1.12/
Combien de fois plus fréquent que dans les textes généraux
Partie d’un candidat plus long
Terme ?
galop rassemblé
2
nom + adjectif
12
180
oui
oui
piaffer
1
nom
9
1 500
non
oui
dernier coin
2
adjectif + nom
1
2
non
non
bon cheval
2
adjectif + nom
3
4
non
non
Quatre candidats sous forme de lignes d'attributs, avec l'étiquette issue de l'annotation. Les valeurs sont données à titre d'illustration.
Classer des candidats : HAMLET
HAMLET, un outil que j’ai conçu avec Véronique Hoste et Els Lefever, suit les
étapes de la méthode hybride, mais les apprend à partir d’exemples. Les patrons
grammaticaux viennent des textes annotés, et non d’une liste écrite à la main, et un
classifieur étiquette chaque candidat comme terme ou non, à partir de nombreux attributs
(Rigouts Terryn et al., 2021).
Sur les mêmes textes néerlandais sur le dressage, HAMLET a proposé beaucoup moins de candidats
que TermoStat, et une part bien plus grande de ces candidats étaient des termes, alors que
la liste plus longue de TermoStat contenait un peu plus des termes que des personnes avaient
annotés. HAMLET a aussi trouvé davantage de termes qui n’apparaissaient qu’une fois, qu’une
seule mesure fondée sur la fréquence tend à manquer (Rigouts Terryn et al., 2019).
L’étiquetage de séquences est un second type de modèle supervisé pour l’extraction de termes,
et il ne part pas d’une liste de candidats. Il lit le texte mot par
mot et donne une étiquette à chaque mot, comme le montre la Figure 18figure 18 :
B pour le premier mot d’un terme, I pour un mot à l’intérieur d’un terme, et
O pour un mot en dehors de tout terme (Rigouts Terryn et al., 2022b). Cette méthode
s’appelle l’étiquetage de séquences, et la même technique sert à repérer les noms propres dans
les textes (see also the A tour of NLP tasks chapter, in the Classical NLP module) (voir aussi le chapitre Tour d'horizon des tâches du TAL, dans le module TAL classique).
Figure 18. L'étiquetage de séquences : chaque mot est étiqueté comme le début d'un terme (B), l'intérieur d'un terme (I) ou l'extérieur (O).
Les réglages de la démonstration nomment les notions de ce chapitre (Figure 19figure 19) : le schéma d’étiquetage, les domaines des textes annotés
sur lesquels le modèle a été entraîné, et les types de termes à
renvoyer (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique).
Figure 19. Les réglages de la démonstration D-Terminer : le schéma d'étiquetage, les domaines d'entraînement et les étiquettes de termes (1er octobre 2026). L'interface change.
Ses deux vues d’un résultat sont les deux formes de résultat : une liste, et les termes
marqués dans le texte. Dans la liste (Figure 20figure 20), une colonne compte les occurrences d’un candidat dans le corpus et une autre
le nombre de fois où il a été marqué comme terme. Les deux diffèrent, parce que le modèle étiquette
chaque occurrence séparément : pas apparaît 278 fois dans ces textes français et n’est
marqué que 46 fois, puisque pas est à la fois une allure du cheval et
l’adverbe de négation. La vue en contexte
(Figure 21figure 21) montre les mêmes candidats là où ils apparaissent dans un texte.
Figure 20. La vue en liste de la démonstration D-Terminer sur des textes français sur le dressage : chaque candidat une fois, avec ses occurrences dans le corpus et le nombre de fois où il a été marqué comme terme (1er octobre 2026). Figure 21. La vue en contexte de la démonstration D-Terminer : les candidats marqués là où ils apparaissent dans un texte, avec la liste pour ce texte à côté (1er octobre 2026).
Comparaison des deux approches
Un modèle qui classe des candidats et un modèle qui étiquette des séquences diffèrent
par ce qu’ils étiquettent et par ce qu’ils peuvent renvoyer, comme le présente le tableau ci-dessous (Rigouts Terryn et al., 2021, 2022a,
2022b).
Classement de candidats
Étiquetage de séquences
Ce qu’il étiquette
chaque candidat d’une liste, une fois
chaque mot, dans la phrase où il apparaît
Résultat
une liste de termes
des termes marqués dans le texte
Le même mot dans deux phrases
une seule décision pour les deux
peut être un terme dans l’une et pas dans l’autre
Un terme court à l’intérieur d’un terme long
les deux peuvent être gardés
seulement le plus long : une seule ligne d’étiquettes B, I et O ne peut pas marquer les deux
Quantité de texte
un corpus, puisque plusieurs attributs sont des fréquences
une seule phrase suffit
Un classifieur de candidats et un étiqueteur de séquences, comparés.
La langue. Les scores étaient plus faibles en français qu’en néerlandais. La composition
en est une raison probable : un terme néerlandais est souvent un seul mot composé là où le français
et l’anglais demandent plusieurs mots, et les termes de plusieurs mots sont plus difficiles à
extraire (Rigouts Terryn, 2026 ; Rigouts Terryn et al., 2022b).
La quantité de données. Plus d’exemples annotés aident (Rigouts Terryn et
al., 2021), et un modèle qui trie une liste a aussi besoin d’assez de texte
d’où extraire, puisque plusieurs de ses attributs sont des fréquences.
Le type de terme. Les termes de plusieurs mots, et les termes qui sont aussi
des mots courants, sont moins souvent trouvés que les autres (Rigouts Terryn et
al., 2022b).
La méthode. Le comportement d’un modèle qui a appris à partir d’exemples est
moins prévisible qu’un ensemble de règles (Rigouts Terryn et al., 2021).
Sources
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2021). HAMLET: Hybrid Adaptable Machine Learning approach to Extract Terminology. Terminology, 27(2), 254–293. https://doi.org/10.1075/term.20017.rig
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Rigouts Terryn, A., Hoste, V., Drouin, P., & Lefever, E. (2020b). TermEval 2020: Shared Task on Automatic Term Extraction Using the Annotated Corpora for Term Extraction Research (ACTER) Dataset. Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020), 85–94. https://aclanthology.org/2020.computerm-1.12/
Terms in two languagesLes termes dans deux langues
Bilingual extraction from parallel texts has long worked through the
alignment of the two sides: candidates are taken from words and phrases that
the alignment links, then filtered on their frequencies (Lefever et al.,
2009; Macken et al., 2013). D-Terminer’s bilingual mode works in two steps
(Rigouts Terryn et al., 2022a):
Monolingual extraction in each language. The terms are extracted
separately from the source sentences and from the target sentences.
Alignment. The words of each pair of aligned sentences are linked, and
each source candidate gets a ranked list of target candidates that appear
in the same sentences, with a score for how reliably they correspond
(Figure 22figure 22).
Figure 22. Terms extracted in each language, then linked through the aligned sentence pair.
The demo shows the result in two views, on its own sample of French and
English texts about corruption. In the list (Figure 23figure 23), each French candidate has one or more English candidates with their
scores: entreprise has company first and business second. Some pairs
need checking, such as législation with licensing. In the context view
(Figure 24figure 24), the candidates are marked in the aligned sentences of both languages.
Figure 23. D-Terminer's bilingual results on its French and English sample: for each French candidate, the English candidates found in the same sentences, with their scores (1 October 2026). The interface changes. Figure 24. The same result in context: the candidate terms marked in each pair of aligned sentences (1 October 2026).
In an evaluation of this bilingual mode on English and Dutch texts about
corruption, the first target candidate was a correct equivalent for about
three source candidates in four (Rigouts Terryn et al., 2022a).
Causes of missing equivalents
The most common cause of a missing equivalent was the first step: the
equivalent had never been extracted in the target language (Rigouts Terryn et
al., 2022a). Languages build terms differently:
Compounds. Dutch writes many terms as one word where English writes
several, as in standaardclausules for standard clauses, so a unit
extracted in one language may not be extracted in the other.
Word order. The words of a term do not come in the same order in both
languages, as in galop rassemblé for collected canter.
Different formulations. A translator may use a noun in one language and
a verb in the other, or a paraphrase instead of a term, and then the text
offers no equivalent to extract.
Lefever, E., Macken, L., & Hoste, V. (2009). Language-independent bilingual terminology extraction from a multilingual parallel corpus. Proceedings of the 12th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2009), 496–504. https://aclanthology.org/E09-1057/
Macken, L., Lefever, E., & Hoste, V. (2013). TExSIS: Bilingual terminology extraction from parallel corpora using chunk-based alignment. Terminology, 19(1), 1–30. https://doi.org/10.1075/term.19.1.01mac
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
L’extraction bilingue à partir de textes parallèles passe depuis longtemps par
l’alignement des deux côtés : les candidats sont tirés des mots et des groupes de mots que
l’alignement relie, puis filtrés selon leurs fréquences (Lefever et al.,
2009 ; Macken et al., 2013). Le mode bilingue de D-Terminer procède en deux étapes
(Rigouts Terryn et al., 2022a) :
L’extraction monolingue dans chaque langue. Les termes sont extraits
séparément des phrases sources et des phrases cibles.
L’alignement. Les mots de chaque paire de phrases alignées sont reliés, et
chaque candidat source reçoit une liste classée de candidats cibles qui apparaissent
dans les mêmes phrases, avec un score qui indique la fiabilité de la correspondance
(Figure 22figure 22).
Figure 22. Les termes extraits dans chaque langue, puis reliés au moyen de la paire de phrases alignées.
La démonstration présente le résultat dans deux vues, sur son propre échantillon de textes français et
anglais sur la corruption. Dans la liste (Figure 23figure 23), chaque candidat français a un ou plusieurs candidats anglais avec leurs
scores : entreprise a d’abord company, puis business. Certaines paires
sont à vérifier, comme législation avec licensing. Dans la vue en contexte
(Figure 24figure 24), les candidats sont marqués dans les phrases alignées des deux langues.
Figure 23. Les résultats bilingues de D-Terminer sur son échantillon français et anglais : pour chaque candidat français, les candidats anglais trouvés dans les mêmes phrases, avec leurs scores (1er octobre 2026). L'interface change. Figure 24. Le même résultat en contexte : les candidats terminologiques marqués dans chaque paire de phrases alignées (1er octobre 2026).
Dans une évaluation de ce mode bilingue sur des textes anglais et néerlandais sur la
corruption, le premier candidat cible était un équivalent correct pour environ
trois candidats sources sur quatre (Rigouts Terryn et al., 2022a).
Les causes des équivalents manquants
La cause la plus fréquente d’un équivalent manquant était la première étape : l’équivalent
n’avait jamais été extrait dans la langue cible (Rigouts Terryn et
al., 2022a). Les langues ne construisent pas leurs termes de la même façon :
Les mots composés. Le néerlandais écrit en un seul mot beaucoup de termes que l’anglais écrit en
plusieurs, comme standaardclausules pour standard clauses, si bien qu’une unité
extraite dans une langue ne l’est pas forcément dans l’autre.
L’ordre des mots. Les mots d’un terme ne viennent pas dans le même ordre dans les deux
langues, comme dans collected canter pour galop rassemblé.
Les formulations différentes. Une traduction peut employer un nom dans une langue et
un verbe dans l’autre, ou une paraphrase à la place d’un terme, et le texte
n’offre alors aucun équivalent à extraire.
Lefever, E., Macken, L., & Hoste, V. (2009). Language-independent bilingual terminology extraction from a multilingual parallel corpus. Proceedings of the 12th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2009), 496–504. https://aclanthology.org/E09-1057/
Macken, L., Lefever, E., & Hoste, V. (2013). TExSIS: Bilingual terminology extraction from parallel corpora using chunk-based alignment. Terminology, 19(1), 1–30. https://doi.org/10.1075/term.19.1.01mac
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Term extraction with LLMsL'extraction de termes avec les GML
whether a shorter term inside a longer one counts;
in what form to return each candidate.
Every decision on which people disagree becomes a decision written into the
prompt, so two people who prompt differently can get different lists from
the same model.
The two screenshots below show the difference on one text about dressage.
With a bare request (Figure 25figure 25), the chatbot returns the terms that the text defines, each with a
definition. With a prompt written like guidelines (Figure 26figure 26), the answer is a plain list in the form the prompt asked for.
Figure 25. A bare request: a text about dressage and the answer of one chatbot when nothing says what a term is (Gemini 3.1 Pro, 1 October 2026). The interface changes. Figure 26. The same text with a prompt written from annotation guidelines: the list follows the definition and the form it was given (Gemini 3.6 Flash with extended thinking, 1 October 2026).
Results of LLMs
Early studies, with GPT-3.5 and Llama 2, found that prompting an LLM came
close to tools trained on annotated examples (Banerjee et al., 2024; Tran et
al., 2024). With models available in 2025, the gap closed: on the twelve
corpora of the ACTER dataset, four LLMs were competitive with tools trained
for the task, and in the range of the agreement between annotators (Rigouts
Terryn, 2026) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).GPT-5 and GPT-5-mini (snapshots of 7 August 2025),
Mistral Large (2411) and Magistral Medium (2507). Three findings
of that study:
The texts changed the results more than the model did. The domain and
the language of a text counted for more than the choice among the four
models.
A detailed prompt helped more than examples in the prompt.
The models proposed too much rather than too little, for instance
general words, several terms joined by and, and descriptive phrases.
Banerjee, S., Chakravarthi, B. R., & McCrae, J. P. (2024). Large Language Models for Few-Shot Automatic Term Extraction. In Natural Language Processing and Information Systems (NLDB 2024), Lecture Notes in Computer Science (pp. 137–150). Springer. https://doi.org/10.1007/978-3-031-70239-6_10
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Tran, H. T. H., González-Gallardo, C.-E., Delaunay, J., Doucet, A., & Pollak, S. (2024). Is Prompting What Term Extraction Needs?. In Text, Speech, and Dialogue (TSD 2024), Lecture Notes in Computer Science (pp. 17–29). Springer. https://doi.org/10.1007/978-3-031-70563-2_2
si un terme court à l’intérieur d’un terme plus long compte ;
sous quelle forme renvoyer chaque candidat.
Chaque décision sur laquelle les personnes ne s’accordent pas devient une décision écrite dans la
requête, si bien que deux personnes qui formulent leur requête différemment peuvent obtenir des listes différentes
du même modèle.
Les deux captures d’écran ci-dessous montrent la différence sur un texte anglais sur le dressage.
Avec une demande nue (Figure 25figure 25), l’agent conversationnel renvoie les termes que le texte définit, chacun avec une
définition. Avec une requête rédigée comme des consignes (Figure 26figure 26), la réponse est une simple liste, sous la forme demandée par la requête.
Figure 25. Une demande nue : un texte sur le dressage et la réponse d'un agent conversationnel quand rien ne dit ce qu'est un terme (Gemini 3.1 Pro, 1er octobre 2026). L'interface change. Figure 26. Le même texte avec une requête rédigée à partir de consignes d'annotation : la liste suit la définition et la forme qui lui ont été données (Gemini 3.6 Flash avec réflexion étendue, 1er octobre 2026).
Banerjee, S., Chakravarthi, B. R., & McCrae, J. P. (2024). Large Language Models for Few-Shot Automatic Term Extraction. In Natural Language Processing and Information Systems (NLDB 2024), Lecture Notes in Computer Science (pp. 137–150). Springer. https://doi.org/10.1007/978-3-031-70239-6_10
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Tran, H. T. H., González-Gallardo, C.-E., Delaunay, J., Doucet, A., & Pollak, S. (2024). Is Prompting What Term Extraction Needs?. In Text, Speech, and Dialogue (TSD 2024), Lecture Notes in Computer Science (pp. 17–29). Springer. https://doi.org/10.1007/978-3-031-70563-2_2
Comparing term extraction methodsComparer les méthodes d'extraction de termes
No single difference settles the choice between a dedicated tool and an LLM,
but some situations point one way:
A large corpus in one domain, to go through the same way every time,
suits a dedicated tool: its ranked list can be read from the top, and
running it again gives the same list.
A single document, a language or domain no tool was trained for, or a
list you want with labels and remarks, suits an LLM.
A language with little text on the web is a reason for caution with
either: the results of LLMs on this task were obtained on languages with many
resources
(Rigouts Terryn, 2026).
The two can also be combined: a large LLM marks the terms in many texts, and
a much smaller, openly available model is trained on those marks, which
avoids sending every new text to a provider (Senger et al., 2025).
Typical errors of each method
Each method of this chapter tends to go wrong in its own way, as the table
below sums up.
Method
Typical errors
Linguistic
Proposes every sequence with the form of a term, such as little girl, and misses terms of an unusual form, such as on the bit
Statistical
Misses rare terms and terms that are also everyday words, such as collection, and proposes words that are frequent in the texts for another reason
Hybrid
Has the limits of both, and the result depends on where the ranked list is cut off
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Senger, E., Campbell, Y., van der Goot, R., & Plank, B. (2025). Crossing Domains without Labels: Distant Supervision for Term Extraction. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1366–1378. https://aclanthology.org/2025.emnlp-industry.95/
Ce qui distingue un extracteur de termes spécialisé d'un GML.
Aucune de ces différences ne tranche à elle seule entre un outil spécialisé et un GML,
mais certaines situations orientent le choix :
Un grand corpus dans un seul domaine, à traiter chaque fois de la même façon,
convient à un outil spécialisé : sa liste classée se lit à partir du début, et
le relancer donne la même liste.
Un seul document, une langue ou un domaine pour lesquels aucun outil n’a été entraîné, ou une
liste que vous voulez avec des étiquettes et des remarques, conviennent à un GML.
Une langue peu présente sur le web est une raison d’être prudent avec
l’un comme avec l’autre : les résultats des GML pour cette tâche ont été obtenus pour des langues bien dotées en ressources
(Rigouts Terryn, 2026).
Les deux peuvent aussi se combiner : un grand GML marque les termes dans de nombreux textes, et
un modèle beaucoup plus petit, librement accessible, est entraîné sur ces marques, ce qui
évite d’envoyer chaque nouveau texte à un fournisseur (Senger et al., 2025).
Les erreurs typiques de chaque méthode
Chaque méthode de ce chapitre tend à échouer à sa manière, comme le résume le tableau
ci-dessous.
Méthode
Erreurs typiques
Linguistique
Propose toute suite qui a la forme d’un terme, comme fillette joyeuse, et manque les termes de forme inhabituelle, comme sur la main
Statistique
Manque les termes rares et les termes qui sont aussi des mots courants, comme passage, et propose des mots fréquents dans les textes pour une autre raison
Hybride
A les limites des deux, et le résultat dépend de l’endroit où la liste classée est coupée
Réussit moins bien sur des textes différents de ceux de son entraînement, sur les termes de plusieurs mots et sur les termes qui sont aussi des mots courants
GML
En proposent trop, par exemple des mots généraux et plusieurs termes joints en un seul, et renvoient parfois une forme qui ne figure pas telle quelle dans le texte
Là où chaque méthode d'extraction de termes tend à échouer.
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Senger, E., Campbell, Y., van der Goot, R., & Plank, B. (2025). Crossing Domains without Labels: Distant Supervision for Term Extraction. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1366–1378. https://aclanthology.org/2025.emnlp-industry.95/
Evaluation foundationsFondements de l'évaluation
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Systematic evaluationL'évaluation systématique
Limits of a first impression
When you try out a language tool, for example a machine translation system, a
spelling checker or a chatbot, the obvious way to judge it is to look at some
of its results and decide whether they seem good. That first impression is
useful, but it is a weak basis for a conclusion:
it relies on the few examples you happened to try;
it depends on your own expertise, so another person can judge the same
results differently, and it does not work for a subject or a language in
which your own expertise is limited;
it cannot be compared with another person’s impression of another tool, or
with your own impression of the same tool a year later.
An evaluation is a more systematic way of judging a tool. The tool is run on
evaluation data chosen in advance and its output is judged by a method that
is stated, so that the result can be checked, repeated and compared.
Figure 1. One of the main difficulties in evaluating NLP tasks is that there are often multiple correct answers. Compare, for instance, simple mathematics (1 correct answer, everything else wrong) with translation (multiple correct answers, maybe a few OK answers, some wrong answers).
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Les limites d’une première impression
Quand vous essayez un outil langagier, par exemple un système de traduction
automatique, un correcteur orthographique ou un agent conversationnel, la
façon la plus évidente de le juger consiste à regarder quelques-uns de ses
résultats et à décider s’ils semblent bons. Cette première impression est
utile, mais c’est une base fragile pour une conclusion :
elle dépend des quelques exemples que vous avez essayés ;
elle dépend de votre propre expertise, de sorte qu’une autre personne peut
juger les mêmes résultats autrement, et elle ne fonctionne pas pour un
sujet ou une langue où votre expertise est limitée ;
elle ne peut pas être comparée à l’impression d’une autre personne sur un
autre outil, ni à votre propre impression du même outil un an plus tard.
Une évaluation est une façon plus systématique de juger un outil. L’outil
fonctionne sur des données d’évaluation choisies à l’avance et sa sortie est
jugée selon une méthode déclarée, de sorte que le résultat peut être
vérifié, répété et comparé.
Figure 1. L'une des principales difficultés de l'évaluation des tâches du TAL est qu'il existe souvent plusieurs réponses correctes. Comparez, par exemple, un calcul simple (une seule réponse correcte, toutes les autres fausses) et la traduction (plusieurs réponses correctes, peut-être quelques réponses acceptables, quelques réponses fausses).
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. An evaluation of named entity recognition, the task of finding the names in a text: people mark the names first, and the output of the system is then compared with their answers. The marks are invented.
The general word for the answers that an output is compared with is the
reference. A gold standard is a reference that people produced. For a
translation system, it is a translation made by a person, called a reference
translation.
Ground truth is often used as a synonym of gold standard, but the two answer
different questions about a reference
(Figure 4figure 4): a gold standard is produced by people, and a ground truth
consists of verifiable facts. Where the answers depend on judgement, people can
disagree and more than one answer can be correct (Basile et al., 2021), so a
gold standard is then not a ground truth.
Figure 4. Gold standard and ground truth answer two different questions about a reference. The examples are mine.
Limits of a gold standard
Every score computed against a gold standard is a comparison with one
particular set of answers, and that set has limits of its own:
It depends on the guidelines. The people who made it followed written
guidelines and decided the unclear cases, for instance whether names count
as terms or how long a term may be. Had they decided differently, the same
system would score differently on the same
text (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique).
For many language tasks, some of these decisions are a matter of judgement
(Basile et al., 2021).
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rebholz-Schuhmann, D., Jimeno Yepes, A. J., van Mulligen, E. M., Kang, N., Kors, J., Milward, D., et al. (2010). The CALBC Silver Standard Corpus for Biomedical Named Entities — A Study in Harmonizing the Contributions from Four Independent Named Entity Taggers. Proceedings of the Seventh International Conference on Language Resources and Evaluation (LREC'10). https://aclanthology.org/L10-1609/
Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722
Tan, Z., Li, D., Wang, S., Beigi, A., Jiang, B., Bhattacharjee, A., et al. (2024). Large Language Models for Data Annotation and Synthesis: A Survey. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 930–957. https://aclanthology.org/2024.emnlp-main.54/
La sortie et l’étalon de référence
La façon la plus courante d’évaluer un système de TAL est de comparer sa
sortie avec un étalon de référence (angl. gold
standard) (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières). L’étalon de
référence indique quelle aurait dû être la sortie, et il est le plus souvent
constitué des réponses que des personnes ont données pour la même entrée
(Jurafsky & Martin, 2026).
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. Une évaluation de la reconnaissance d'entités nommées, la tâche qui consiste à trouver les noms dans un texte : des personnes marquent d'abord les noms, puis la sortie du système est comparée à leurs réponses. Les annotations sont inventées.
Étalon de référence, référence et réalité de terrain
Le mot général pour les réponses auxquelles une sortie est comparée est la
référence. Un étalon de référence est une référence que des personnes ont
produite. Pour un système de traduction, c’est une traduction faite par une
personne, appelée traduction de référence.
Le terme réalité de terrain (angl. ground truth) est souvent employé comme
synonyme d’étalon de référence, mais les deux répondent à des questions
différentes sur une référence
(Figure 4figure 4) : un étalon de référence est produit par des personnes, et une
réalité de terrain est constituée de faits vérifiables. Lorsque les réponses
dépendent d’un jugement, les personnes peuvent être en désaccord et
plusieurs réponses peuvent être correctes (Basile et al., 2021) : un étalon
de référence n’est alors pas une réalité de terrain.
Figure 4. L'étalon de référence et la réalité de terrain répondent à deux questions différentes sur une référence. Les exemples sont les miens.
Les limites d’un étalon de référence
Chaque score calculé par rapport à un étalon de référence est une comparaison
avec un ensemble de réponses particulier, et cet ensemble a ses propres
limites :
Il dépend des consignes. Les personnes qui l’ont établi ont suivi des
consignes écrites et ont tranché les cas flous, par exemple si les noms
propres comptent comme des termes, ou quelle longueur un terme peut avoir.
Si elles avaient décidé autrement, le même système obtiendrait un autre
score sur le même
texte (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique).
Pour beaucoup de tâches langagières, une partie de ces décisions relève du
jugement (Basile et al., 2021).
Il énumère un nombre limité de réponses. Pour un système qui produit du
texte, comme un système de traduction ou un agent conversationnel, une
sortie peut être bonne sans ressembler à aucune d’elles, et c’est l’une des
raisons pour lesquelles des personnes jugent aussi de telles sorties
directement (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
Sources
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rebholz-Schuhmann, D., Jimeno Yepes, A. J., van Mulligen, E. M., Kang, N., Kors, J., Milward, D., et al. (2010). The CALBC Silver Standard Corpus for Biomedical Named Entities — A Study in Harmonizing the Contributions from Four Independent Named Entity Taggers. Proceedings of the Seventh International Conference on Language Resources and Evaluation (LREC'10). https://aclanthology.org/L10-1609/
Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722
Tan, Z., Li, D., Wang, S., Beigi, A., Jiang, B., Bhattacharjee, A., et al. (2024). Large Language Models for Data Annotation and Synthesis: A Survey. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 930–957. https://aclanthology.org/2024.emnlp-main.54/
Agreement between annotatorsL'accord entre annotateurs
Inter-annotator agreement is a measure of the reliability of a gold standard:
high agreement suggests that the annotators understood the guidelines in the
same way (Artstein & Poesio, 2008). In
Figure 5figure 5, three annotators have marked six units between them, and only two
of the six were marked by all three.
Figure 5. Three annotators marking the terms of one short text: the number of units marked by each combination of them. The example is invented.
The simplest measure is the share of items on which the annotators gave the
same answer. Part of any agreement arises by chance, and some measures
correct for it (Artstein & Poesio, 2008). When annotators mark things in
running text, such as terms, their agreement can be measured with the same
scores as a system (Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
Low and high agreement
Low agreement is a finding about the task. Either some annotators are
wrong, or the guidelines do not fit the data (Artstein & Poesio, 2008). For
many language tasks there is a third possibility, that more than one answer
is right (Basile et al., 2021).
A task with low agreement is harder to evaluate, and often harder to
automate. The gold standard that a system is scored against is itself
uncertain, and where people do not agree on the answer, a system has no
consistent answer to learn or to reproduce. In a review of published results
in biomedical NLP, Boguslav and Cohen (2017) found that tasks with higher
agreement between annotators also had higher system scores.
High agreement is not proof. Reliability is a precondition for a
gold standard being right, but two people can share the same mistaken idea and
agree completely (Artstein & Poesio, 2008).
Combining several annotators
Most evaluations compare a system with a single gold standard, so the
differences between annotators have to be settled. This step is called
adjudication, and it can be done in several ways, for instance:
Discussion: the annotators compare their results and settle each
difference together.
Majority vote: a unit goes into the gold standard when most of the
annotators marked it. Figure 6figure 6 applies it to the three annotators of
Figure 5figure 5.
One person checks: a single experienced annotator makes or reviews
every decision, which keeps the gold standard consistent but makes it one
person’s view.
Figure 6. A majority vote: three annotators mark the terms, and the gold standard keeps the units that at least two of them marked. The example is invented.
Combining the annotations is not the only option. An evaluation can also keep
the annotations of each person and compare a system with all of them, so that
the items on which people disagree are counted as well (Basile et al., 2021).
The agreement is often assumed to be the upper limit of what a system can
reach, but systems do score above it (Boguslav & Cohen, 2017). A higher score
is not always feasible, and it is not always desirable: a much higher score
can mean that the system reproduces the choices of the particular people who
made the gold standard.
Sources
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Boguslav, M., & Cohen, K. B. (2017). Inter-Annotator Agreement and the Upper Limit on Machine Performance: Evidence from Biomedical Natural Language Processing. Studies in Health Technology and Informatics, 245, 298–302. https://doi.org/10.3233/978-1-61499-830-3-298
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131
L’accord inter-annotateurs est une mesure de la fiabilité d’un étalon de
référence : un accord élevé suggère que les annotateurs ont compris les
consignes de la même façon (Artstein & Poesio, 2008). Dans
Figure 5figure 5, trois annotateurs ont marqué six unités à eux trois, et seules deux
des six ont été marquées par les trois.
Figure 5. Trois annotateurs marquent les termes d'un court texte : le nombre d'unités marquées par chaque combinaison d'annotateurs. L'exemple est inventé.
La mesure la plus simple est la proportion d’éléments pour lesquels les
annotateurs ont donné la même réponse. Une partie de tout accord est due au
hasard, et certaines mesures en tiennent compte (Artstein & Poesio, 2008).
Lorsque les annotateurs marquent des éléments dans un texte suivi, comme des
termes, leur accord peut être mesuré avec les mêmes scores qu’un système
(Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
Accord faible et accord élevé
Un accord faible est un constat sur la tâche. Soit certains
annotateurs se trompent, soit les consignes ne conviennent pas aux données
(Artstein & Poesio, 2008). Pour beaucoup de tâches langagières, il existe
une troisième possibilité : plusieurs réponses sont correctes (Basile et
al., 2021).
Une tâche où l’accord est faible est plus difficile à évaluer, et
souvent plus difficile à automatiser. L’étalon de référence auquel un
système est comparé est lui-même incertain, et lorsque les personnes ne
s’entendent pas sur la réponse, un système n’a pas de réponse constante à
apprendre ou à reproduire. Dans une analyse de résultats publiés en TAL
biomédical, Boguslav et Cohen (2017) ont constaté que les tâches où
l’accord entre annotateurs était plus élevé obtenaient aussi des scores de
systèmes plus élevés.
Un accord élevé n’est pas une preuve. La fiabilité est une condition
préalable pour qu’un étalon de référence soit juste, mais deux personnes
peuvent partager la même idée fausse et être entièrement d’accord (Artstein
& Poesio, 2008).
Combiner plusieurs annotateurs
La plupart des évaluations comparent un système à un seul étalon de
référence : les différences entre annotateurs doivent donc être tranchées.
Cette étape s’appelle l’arbitrage, et elle peut se faire de plusieurs
façons, par exemple :
La discussion : les annotateurs comparent leurs résultats et tranchent
chaque différence ensemble.
Le vote majoritaire : une unité entre dans l’étalon de référence
lorsque la majorité des annotateurs l’ont marquée. La Figure 6figure 6 l’applique aux trois annotateurs de
Figure 5figure 5.
La vérification par une seule personne : un seul annotateur
expérimenté prend ou révise chaque décision, ce qui garde l’étalon de
référence cohérent, mais en fait le point de vue d’une seule personne.
Figure 6. Un vote majoritaire : trois annotateurs marquent les termes, et l'étalon de référence garde les unités qu'au moins deux d'entre eux ont marquées. L'exemple est inventé.
Combiner les annotations n’est pas la seule possibilité. Une évaluation peut
aussi conserver les annotations de chaque personne et comparer un système à
toutes, de sorte que les éléments sur lesquels les personnes sont en
désaccord sont comptés eux aussi (Basile et al., 2021).
L’accord et le score d’un système
Un score par rapport à un étalon de référence ne peut pas être interprété
sans l’accord entre les personnes qui l’ont établi. Lorsque deux personnes
soigneuses atteignent 0,6 l’une par rapport à l’autre, un système qui
atteint 0,6 par rapport à l’une d’elles fait à peu près aussi bien que le
ferait une deuxième
personne (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
L’accord est souvent considéré comme la limite supérieure de ce qu’un
système peut atteindre, mais des systèmes obtiennent bel et bien des scores
supérieurs (Boguslav & Cohen, 2017). Un score plus élevé n’est pas toujours
réalisable, et il n’est pas toujours souhaitable : un score beaucoup plus
élevé peut signifier que le système reproduit les choix des personnes qui
ont établi l’étalon de référence.
Sources
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Boguslav, M., & Cohen, K. B. (2017). Inter-Annotator Agreement and the Upper Limit on Machine Performance: Evidence from Biomedical Natural Language Processing. Studies in Health Technology and Informatics, 245, 298–302. https://doi.org/10.3233/978-1-61499-830-3-298
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131
BaselinesLes étalons
A score compared with a simple method
A score does not say, on its own, whether a system is good. If you are told
that a spam filter is right for 90 messages out of 100, you still need to know
what a very simple method would score on the same messages. If 90 of the 100
messages are not spam, a filter that lets every message through is also right
90 times out of 100, and it has not stopped any spam
(Figure 8figure 8).
Figure 8. The same 100 messages judged twice: by letting every message through, and by a spam filter. Both are right for 90 messages. The example is invented.
The score of such a simple method is called a baseline.
right as often as that class occurs: 90 % when nine items in ten belong to it
Most frequent answer for each item
gives each item the answer it had most often in a set of labelled examples; only possible where the same items come back, as words do
depends on the task, and can be high: about 92 % of the words for part-of-speech tagging of English, the example below
Three simple baselines for a classification task.
A baseline can also be an existing tool: a new system is then expected to do
better than the one it replaces.The third baseline is not always
possible: it needs labelled examples, and the items of the test have to come
back from those examples, as words do in running text. Jurafsky and Martin
(2026) give it for part-of-speech tagging. No two emails are identical, so a
spam filter has no such baseline.
Figure 9. Part-of-speech tagging of English: the share of words labelled correctly by the baseline, and by the best systems and by people, with the top of the scale enlarged (Jurafsky & Martin, 2026).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Un score comparé à une méthode simple
Un score ne dit pas, à lui seul, si un système est bon. Si l’on vous dit
qu’un filtre antipourriel a raison pour 90 messages sur 100, il vous reste à
savoir quel score une méthode très simple obtiendrait sur les mêmes
messages. Si 90 des 100 messages ne sont pas des pourriels, un filtre qui
laisse passer tous les messages a lui aussi raison 90 fois sur 100, et il
n’a arrêté aucun pourriel
(Figure 8figure 8).
Figure 8. Les mêmes 100 messages jugés deux fois : en laissant passer tous les messages, et par un filtre antipourriel. Les deux ont raison pour 90 messages. L'exemple est inventé.
Le score d’une telle méthode simple s’appelle un étalon.
avec deux classes, a raison environ une fois sur deux
Classe majoritaire
répond toujours la classe la plus fréquente
a raison aussi souvent que cette classe apparaît : 90 % lorsque neuf éléments sur dix lui appartiennent
Réponse la plus fréquente pour chaque élément
donne à chaque élément la réponse qu’il a reçue le plus souvent dans un ensemble d’exemples étiquetés ; possible seulement lorsque les mêmes éléments reviennent, comme le font les mots
dépend de la tâche, et peut être élevé : environ 92 % des mots pour l’étiquetage morphosyntaxique de l’anglais, l’exemple ci-dessous
Trois étalons simples pour une tâche de classification.
Un étalon peut aussi être un outil existant : on attend alors d’un nouveau
système qu’il fasse mieux que celui qu’il remplace.Le troisième
étalon n’est pas toujours possible : il lui faut des exemples étiquetés, et
les éléments du test doivent revenir dans ces exemples, comme le font les
mots dans un texte suivi. Jurafsky et Martin (2026) le donnent pour
l’étiquetage morphosyntaxique. Il n’y a pas deux courriels identiques, de
sorte qu’un filtre antipourriel n’a pas d’étalon de ce type.
Figure 9. Étiquetage morphosyntaxique de l'anglais : la proportion de mots étiquetés correctement par l'étalon, par les meilleurs systèmes et par des personnes, avec le haut de l'échelle agrandi (Jurafsky & Martin, 2026).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Evaluating extraction and classificationÉvaluation de l'extraction et de la classification
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
False positives and false negativesFaux positifs et faux négatifs
Extraction and classification
This chapter is about two kinds of system
(Figure 1figure 1):
For example, a term extractor, a tool that lists the specialized terms of a
text, is run on a sentence about dressage, an equestrian sport
(Figure 2figure 2):
the tool returns a list of three candidates: flying change, last corner
and collected canter;
the gold standard is a list of three terms: flying change, half-halt
and collected canter.
Two candidates are on both lists, so they are correct. The tool has also
made two errors, of different kinds:
last corner was returned, but it is not a term;
half-halt is a term, but it was not returned.
Figure 2. A text, the list of the gold standard and the list a tool returned: two correct candidates, one term that was missed and one candidate that is not a term.
The four outcomes
When the output of a system is compared with a gold standard, every decision
is one of four cases, defined in the boxes below and often abbreviated TP, FP,
FN and TN.
In the example above, flying change and collected canter are true
positives, last corner is a false positive and half-halt is a false
negative. The true negatives are everything else in the text.
Figure 3figure 3 builds up the four cases for a term
extractor.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. The four outcomes as regions: what is in the gold standard, what the system returned, and where the two overlap.
Jurafsky and Martin (2026) present the same four cases as a table, called a
confusion matrix, for a system that sorts items into two classes, such as a
spam filter: a message stopped by mistake is a false positive, and spam that
reaches the inbox is a false negative.
In the gold standard
Not in the gold standard
Returned by the system
true positive
false positive
Not returned by the system
false negative
true negative
The four outcomes as a confusion matrix.
Noise and silence
The false positives are also called noise, and the false negatives silence.
You can interpret the two words quite literally: noise is output that should
not be there, and silence is output that is missing.
True negatives
The fourth case differs between the two kinds of system
(Figure 4figure 4):
For a spam filter, each message is one item, so the true negatives, the
messages that are not spam and were let through, can be counted.
For a system that finds things in a text, such as a term extractor, the
true negatives would be every word and every sequence of words that is not
a term and was not returned. Such units vary in length and overlap, so
their number is not well defined (Hripcsak & Rothschild, 2005).
Figure 4. True negatives in the two kinds of system: messages can be counted, but the units of a text that are not terms vary in length and overlap.
The two errors work against each other. A tool set to return more candidates
misses fewer terms, but it also returns more units that are not terms. A tool
set to return fewer candidates does the reverse.
In Figure 5figure 5, a tool has ranked twelve candidates, and the
list is cut at three points. The further down the list the cut is made, the
fewer terms are missed and the more noise comes with them. An evaluation
therefore reports each of the two errors as well as a score that combines
them.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 5. One ranked list of candidates cut at three points, against a gold standard of eight terms.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Extraction et classification
Ce chapitre porte sur deux types de système
(Figure 1figure 1) :
Figure 1. Les deux types de système de ce chapitre : l'un donne la liste des éléments qu'il a repérés dans un texte, l'autre donne une étiquette à chaque élément.
Par exemple, un extracteur de termes, un outil qui dresse la liste des termes
spécialisés d’un texte, traite une phrase sur le dressage, un sport équestre
(Figure 2figure 2) :
l’outil propose une liste de trois candidats : changement de pied,
dernier coin et galop rassemblé ;
l’étalon de référence est une liste de trois termes : changement de pied,
demi-arrêt et galop rassemblé.
Deux candidats figurent sur les deux listes : ils sont donc corrects. L’outil
a aussi fait deux erreurs, de types différents :
dernier coin a été proposé, mais ce n’est pas un terme ;
demi-arrêt est un terme, mais il n’a pas été trouvé.
Figure 2. Un texte, la liste de l'étalon de référence et la liste proposée par un outil : deux candidats corrects, un terme manqué et un candidat qui n'est pas un terme.
Les quatre cas
Quand la sortie d’un système est comparée à un étalon de référence, chaque
décision correspond à l’un de quatre cas, définis dans les encadrés
ci-dessous et souvent abrégés VP, FP, FN et VN.
Dans l’exemple ci-dessus, changement de pied et galop rassemblé sont des
vrais positifs, dernier coin est un faux positif et demi-arrêt est un
faux négatif. Les vrais négatifs sont tout le reste du texte.
La Figure 3figure 3 construit les quatre cas pour un extracteur
de termes.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. Les quatre cas sous forme de zones : ce qui est dans l'étalon de référence, ce que le système a trouvé, et là où les deux se chevauchent.
Jurafsky et Martin (2026) présentent les mêmes quatre cas sous forme de
tableau, appelé matrice de confusion, pour un système qui classe des éléments
en deux classes, comme un filtre antipourriel : un message arrêté par erreur
est un faux positif, et un pourriel qui arrive dans la boîte de réception est
un faux négatif.
Dans l’étalon de référence
Absent de l’étalon de référence
Trouvé par le système
vrai positif
faux positif
Non trouvé par le système
faux négatif
vrai négatif
Les quatre cas sous forme de matrice de confusion.
Le bruit et le silence
L’ensemble des faux positifs s’appelle aussi le bruit, et l’ensemble des faux
négatifs, le silence. Les deux mots peuvent se comprendre littéralement : le
bruit est ce qui ne devrait pas se trouver dans la sortie, et le silence, ce
qui y manque.
Les vrais négatifs
Le quatrième cas n’est pas le même pour les deux types de système
(Figure 4figure 4) :
Pour un filtre antipourriel, chaque message est un élément : les vrais
négatifs, les messages qui ne sont pas des pourriels et que le filtre a
laissés passer, peuvent donc être comptés.
Pour un système qui repère des éléments dans un texte, comme un extracteur
de termes, les vrais négatifs seraient chaque mot et chaque suite de mots
qui n’est pas un terme et n’a pas été trouvée. Ces unités varient en
longueur et se chevauchent : leur nombre n’est donc pas bien défini
(Hripcsak & Rothschild, 2005).
Figure 4. Les vrais négatifs dans les deux types de système : les messages peuvent être comptés, mais les unités d'un texte qui ne sont pas des termes varient en longueur et se chevauchent.
Les deux erreurs s’opposent. Un outil réglé pour proposer plus de candidats
manque moins de termes, mais il propose aussi plus d’unités qui ne sont pas
des termes. Un outil réglé pour proposer moins de candidats fait l’inverse.
Dans Figure 5figure 5, un outil a classé douze candidats, et la
liste est coupée à trois endroits. Plus la coupure se fait bas dans la liste,
moins il manque de termes, et plus il y a de bruit. Une évaluation indique
donc chacune des deux erreurs, en plus d’un score qui les combine.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 5. Une liste classée de candidats coupée à trois endroits, comparée à un étalon de référence de huit termes.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Precision, recall and F1Précision, rappel et score F1
Figure 6. The parts that precision and recall are calculated from: the terms in the gold standard, the candidates the system returned, and their overlap.
Each score can be explained in several ways, and one may be clearer to you
than the others:
In this example, a term extractor returns ten candidates for a short text
about dressage, and the gold standard for that text has nine terms
(Figure 7figure 7).
Figure 7. A gold standard of nine terms and the ten candidates of a tool, coloured by outcome.
Five candidates are on both lists, so there are 5 true positives, 5 false
positives and 4 false negatives
(Figure 8figure 8):
precision = 5 / (5 + 5) = 0.50;
recall = 5 / (5 + 4) = 0.56.
Figure 8. Precision and recall measure the same overlap against two different totals: what the system returned, and what the gold standard contains.
The F1 score
The F1 score combines precision and recall into one number.
It is twice their product divided by their sum:
F1 = 2 × precision × recall / (precision + recall), here
2 × 0.50 × 0.56 / (0.50 + 0.56) = 0.53. As a harmonic mean, it is closer to
the lower of the two values than an ordinary average would be (Jurafsky &
Martin, 2026), so a tool cannot score well by doing one thing only. For
example, if a tool returned every word and every sequence of words of a text,
it would have perfect recall, a precision close to zero, and an F1 score
close to zero (Figure 9figure 9).
Figure 9. The F1 score and the ordinary average of precision and recall, for the tool of the worked example and for a tool that returns everything.
The scores change with the number of candidates a tool returns.
Figure 10figure 10 gives the three scores after each candidate of the ranked list of
Figure 5figure 5: as more candidates are kept, precision falls and recall
rises, and the F1 score is highest after seven candidates.
Figure 10. Precision, recall and F1 after each candidate of one ranked list, against a gold standard of eight terms.
More than two classes
When a system sorts items into more than two classes, for example emails into
urgent, normal and spam, precision and recall are calculated for each class.
The scores of the classes are then averaged (macroaveraging), or the
decisions for all classes are pooled before the calculation (microaveraging),
in which case the most frequent class has the most influence on the result
(Jurafsky & Martin, 2026).
Figure 11figure 11 calculates it for a spam filter and 100 messages: 10 of the
messages are spam, and the filter stops 6 of them and 6 messages that are not
spam.
Figure 11. The same 100 messages judged by a spam filter and by letting every message through: the same accuracy, very different recall.
Accuracy is misleading when the class to find is rare, as the second matrix
shows. Jurafsky and Martin (2026) give a more extreme example: a million social media
posts, of which a hundred are about the product a company wants to follow: a system that labels every
post as not about the product is right for 99.99 % of the posts, but it has
found none of the hundred. Precision and recall do not count the true
negatives, so the same system has a recall of
zero (see also the Baselines page, in the Evaluating language technology module) (voir aussi la page Les étalons, dans le module L'évaluation des technologies langagières).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Figure 6. Les parties à partir desquelles se calculent la précision et le rappel : les termes de l'étalon de référence, les candidats proposés par le système, et leur chevauchement.
Chaque score peut s’expliquer de plusieurs façons, et l’une d’elles vous
paraîtra peut-être plus claire que les autres :
Précision
sous forme de formule : précision = VP / (VP + FP) ;
Dans cet exemple, un extracteur de termes propose dix candidats pour un
court texte sur le dressage, et l’étalon de référence de ce texte compte neuf
termes
(Figure 7figure 7).
Figure 7. Un étalon de référence de neuf termes et les dix candidats d'un outil, en couleur selon le cas.
Cinq candidats figurent sur les deux listes : il y a donc 5 vrais positifs,
5 faux positifs et 4 faux négatifs
(Figure 8figure 8) :
précision = 5 / (5 + 5) = 0,50 ;
rappel = 5 / (5 + 4) = 0,56.
Figure 8. La précision et le rappel mesurent le même chevauchement par rapport à deux totaux différents : ce que le système a trouvé, et ce que contient l'étalon de référence.
Le score F1
Le score F1 combine la précision et le rappel en un seul nombre.
Il vaut deux fois leur produit, divisé par leur somme :
F1 = 2 × précision × rappel / (précision + rappel), ici
2 × 0,50 × 0,56 / (0,50 + 0,56) = 0,53. Comme moyenne harmonique, il est plus
proche de la plus basse des deux valeurs que ne le serait une moyenne
ordinaire (Jurafsky & Martin, 2026) : un outil ne peut donc pas obtenir un bon
score en ne faisant qu’une seule chose. Par exemple, si un outil proposait
chaque mot et chaque suite de mots d’un texte, il aurait un rappel parfait,
une précision proche de zéro et un score F1 proche de zéro
(Figure 9figure 9).
Figure 9. Le score F1 et la moyenne ordinaire de la précision et du rappel, pour l'outil de l'exemple détaillé et pour un outil qui propose tout.
Les scores changent avec le nombre de candidats qu’un outil propose.
La Figure 10figure 10 donne les trois scores après chaque candidat de la liste classée de
Figure 5figure 5 : à mesure qu’on garde plus de candidats, la précision baisse et
le rappel augmente, et le score F1 est le plus élevé après sept candidats.
Figure 10. La précision, le rappel et le score F1 après chaque candidat d'une liste classée, comparée à un étalon de référence de huit termes.
Plus de deux classes
Quand un système classe des éléments en plus de deux classes, par exemple des
courriels en urgents, normaux et pourriels, la précision et le rappel se
calculent pour chaque classe. On fait ensuite la moyenne des scores des
classes (macromoyenne), ou on regroupe les décisions de toutes les classes
avant le calcul (micromoyenne) ; dans ce cas, la classe la plus fréquente
pèse le plus sur le résultat (Jurafsky & Martin, 2026).
La Figure 11figure 11 la calcule pour un filtre antipourriel et 100 messages : 10
de ces messages sont des pourriels, et le filtre en arrête 6, ainsi que 6
messages qui ne sont pas des pourriels.
Figure 11. Les mêmes 100 messages jugés par un filtre antipourriel et en laissant passer tous les messages : la même exactitude, un rappel très différent.
L’exactitude est trompeuse quand la classe à trouver est rare, comme le
montre la deuxième matrice. Jurafsky et Martin (2026) donnent un exemple plus
extrême : un million de publications sur les réseaux sociaux, dont une
centaine portent sur le produit qu’une entreprise veut suivre. Un système qui
étiquette chaque publication comme ne portant pas sur le produit a raison
pour 99,99 % des publications, mais il n’a trouvé aucune des cent. La
précision et le rappel ne comptent pas les vrais négatifs : le même système a
donc un rappel de
zéro (see also the Baselines page, in the Evaluating language technology module) (voir aussi la page Les étalons, dans le module L'évaluation des technologies langagières).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Practice: precision, recall and F1Pratique : précision, rappel et score F1
The gold standard has eight terms and the tool found four of them. Recall is the share of the terms of the gold standard that the tool found: 4 / 8 = 0.50.
La référence compte huit termes et l'outil en a trouvé quatre. Le rappel est la part des termes de la référence que l'outil a trouvés : 4 / 8 = 0,50.
ExerciseExercice 3 · the F1 scorele score F1not startedà fairesolvedréussikeep tryingà retravailler
What is the F1 score of the tool? Round the answer to two decimals.
Quel est le score F1 de l'outil ? Arrondissez la réponse à deux décimales.
Show the explanationVoir l'explication
The F1 score is twice the product of precision and recall, divided by their sum: 2 × 0.67 × 0.50 / (0.67 + 0.50) = 0.57. It lies between the two values, closer to the lower one.
Le score F1 vaut deux fois le produit de la précision et du rappel, divisé par leur somme : 2 × 0,67 × 0,50 / (0,67 + 0,50) = 0,57. Il se situe entre les deux valeurs, plus près de la plus basse.
A second tool returns twenty candidates for the same text, and all eight terms of the gold standard are among them. Which of the following statements is true?
Un deuxième outil propose vingt candidats pour le même texte, et les huit termes de la référence en font partie. Lequel des énoncés suivants est exact ?
Show the solutionVoir la solution
The second tool has a recall of 8 / 8 = 1.00 and a precision of 8 / 20 = 0.40. Its F1 score is therefore 2 × 0.40 × 1.00 / (0.40 + 1.00) = 0.57, the same as the first tool's.
Two tools can reach the same F1 score with opposite errors: the first misses half of the terms, and most of the second tool's candidates are not terms. That is why an evaluation reports precision and recall as well as the F1 score.
Le deuxième outil a un rappel de 8 / 8 = 1,00 et une précision de 8 / 20 = 0,40. Son score F1 est donc de 2 × 0,40 × 1,00 / (0,40 + 1,00) = 0,57, comme celui du premier outil.
Deux outils peuvent obtenir le même score F1 avec des erreurs opposées : le premier manque la moitié des termes, et la plupart des candidats du second ne sont pas des termes. C'est pourquoi une évaluation indique la précision et le rappel en plus du score F1.
Partial matches and cut-off in term extraction. Reported scores differ greatly depending
on how strict the evaluation is, for example on whether partial matches are
accepted, and they change with the point at which a ranked list is cut off
(Rigouts Terryn et al., 2019).
Unique terms or occurrences. Scores for every occurrence in the running text
and scores for a list of unique terms can lead to different conclusions,
for example about the language or the domain in which a system does best
(Rigouts Terryn et al., 2022b).
A strict comparison has two outcomes, correct or not, but many candidates of
a term extractor are between the two
(Figure 13figure 13):
the candidate is part of a term in the gold standard;
the candidate is a term of the gold standard with another word attached;
the candidate would be a term for some purposes and not for others.
Figure 13. Between a candidate that is wrong and one that is right: three cases a strict comparison counts as errors.
The same cases come up in named entity recognition, for instance Curie for
Marie Curie, or the University of Paris with one word too many. A strict
evaluation counts all of them as errors. A more lenient evaluation
accepts some of them and gives higher scores, so scores obtained with
different rules cannot be compared.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Correspondances partielles et seuil en extraction de termes. Les scores
publiés varient beaucoup selon la rigueur de l’évaluation, par exemple selon
que les correspondances partielles sont acceptées ou non, et ils changent
avec l’endroit où une liste classée est coupée (Rigouts Terryn et al.,
2019).
Termes uniques ou occurrences. Les scores calculés sur chaque
occurrence dans le texte et les scores calculés sur une liste de termes
uniques peuvent mener à des conclusions différentes, par exemple sur la
langue ou le domaine où un système réussit le mieux (Rigouts Terryn et al.,
2022b).
Une comparaison stricte n’a que deux issues, correct ou non, mais beaucoup de
candidats d’un extracteur de termes se situent entre les deux
(Figure 13figure 13) :
le candidat est une partie d’un terme de l’étalon de référence ;
le candidat est un terme de l’étalon de référence auquel s’ajoute un autre
mot ;
le candidat serait un terme pour certains usages, mais pas pour d’autres.
Figure 13. Entre un candidat faux et un candidat juste : trois cas qu'une comparaison stricte compte comme des erreurs.
Les mêmes cas se présentent en reconnaissance d’entités nommées, par exemple
Curie pour Marie Curie, ou l’Université de Paris avec un mot de trop.
Une évaluation stricte les compte tous comme des erreurs. Une évaluation plus
souple en accepte certains et donne des scores plus élevés : des scores
obtenus avec des règles différentes ne peuvent donc pas être comparés.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Agreement as an F1 scoreL'accord mesuré par le score F1
Measured this way, the IAA between people is on the same scale as the score
of a system, and the two can be set side by side.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Figure 14. Deux annotateurs évalués l'un par rapport à l'autre : la précision et le rappel s'inversent selon l'étalon de référence, et le score F1 ne change pas.
Mesuré ainsi, l’accord inter-annotateurs est sur la même échelle que le score
d’un système, et les deux peuvent être comparés directement.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733