Why not simply use words or characters?Pourquoi ne pas simplement prendre les mots ou les caractères ?
TRA6008 S2 · in classS2 · en classe
Vocabulary
Every model has a fixed list of tokens, chosen before training starts and never added to afterwards. Every text it will ever read or write has to be expressed using the tokens in that list, and whatever is not in the list cannot be represented at all.
How long that list should be is the question this page turns on, and the two obvious answers sit at either end.
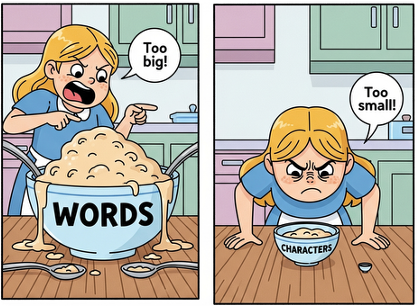
One number per word?
Each token would then be a unit that means something. But a list of words runs into three walls at once.
- It can never be complete. An average twenty-year-old native speaker of American English knows about 42,000 lemmas lemmalemme linguisticslinguistique The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller. (Brysbaert et al., 2016), and real text piles names, technical terms, foreign words, typos and yesterday’s coinages on top of that. No list contains every word of one language, let alone of all of them, and new words appear faster than any list can be revised.
- Rare entries stay poorly learned. A word seen a handful of times in training gets a vector built from those few occurrences, which is not enough to place it usefully. Enlarging the list adds entries of exactly that kind.
- Every entry costs. The model keeps one row of numbers per entry, and at every step it scores every entry in the list to decide what comes next. A longer list means more memory and more computing, for entries that are mostly rare.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
One number per character?
The list would be tiny, a few hundred entries at most, and nothing would ever be missing: any text at all can be spelled out, in any language, typos included. The cost is at the other end. A single character tells you almost nothing, t on its own means nothing, and a page of text becomes a very long run of them, as the character row of Figure 1figure 1 shows. The model would have to rebuild every word from scratch, every time one occurred.
Pieces in between
New words are mostly made of familiar pieces, and that is the way out. You can read antibacterial without having seen it before, because anti-, bacteri and -al are old acquaintances. A vocabulary of pieces, some of them whole words and some fragments, keeps the common words whole and can still spell out anything at all, down to single characters in the worst case.
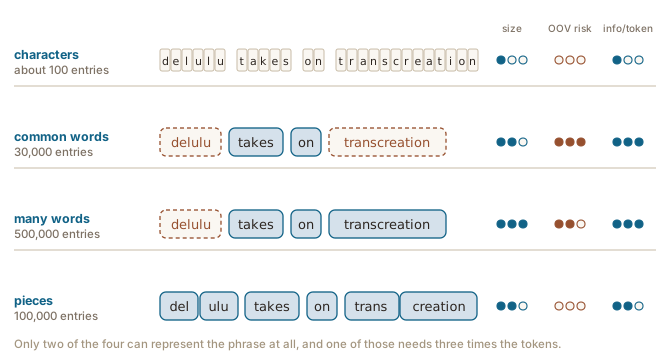
With the subword strategy, single characters are still part of the vocabulary as well. So when no larger piece matches, any sequence at all can still be covered by the individual characters, and there are no out-of-vocabulary problems left: not for a typo, a surname, a word in a language the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. barely saw, or a line of pure gibberish. What varies is the number of tokens. A familiar word is one token, and an unfamiliar one takes as many as it takes to spell it (see also the Consequences of tokenization chapter) (voir aussi le chapitre Conséquences de la jetonisation).
Le vocabulaire
Chaque modèle a une liste fixe de jetons, choisie avant le début de l’entraînement et jamais complétée ensuite. Tout texte qu’il lira ou écrira doit s’exprimer avec les jetons de cette liste, et ce qui n’y figure pas ne peut pas être représenté du tout.
Quelle doit être la longueur de cette liste ? C’est la question qui occupe cette page, et les deux réponses évidentes se trouvent aux deux extrémités.
Un numéro par mot ?
Chaque jeton serait alors une unité qui veut dire quelque chose. Mais une liste de mots se heurte à trois murs à la fois.
- Elle ne peut jamais être complète. Une personne moyenne de vingt ans dont l’anglais américain est la langue maternelle connaît environ 42 000 lemmes lemmalemme linguisticslinguistique The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller. (Brysbaert et al., 2016), et les textes réels y ajoutent des noms propres, des termes techniques, des mots étrangers, des coquilles et les néologismes d’hier. Aucune liste ne contient tous les mots d’une seule langue, encore moins de toutes, et les mots nouveaux apparaissent plus vite qu’aucune liste ne peut être révisée.
- Les entrées rares restent mal apprises. Un mot vu une poignée de fois à l’entraînement reçoit un vecteur construit sur ces quelques occurrences, ce qui ne suffit pas à le placer utilement. Agrandir la liste ajoute des entrées exactement de ce genre.
- Chaque entrée coûte. Le modèle garde une rangée de nombres par entrée, et à chaque étape il attribue un score à chaque entrée de la liste pour décider de la suite. Une liste plus longue veut dire plus de mémoire et plus de calcul, pour des entrées le plus souvent rares.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Un numéro par caractère ?
La liste serait minuscule, quelques centaines d’entrées au plus, et rien ne manquerait jamais : n’importe quel texte peut s’épeler, dans n’importe quelle langue, coquilles comprises. Le coût est à l’autre bout. Un caractère isolé ne dit presque rien, t tout seul ne veut rien dire, et une page de texte devient une très longue suite de caractères, comme le montre la rangée des caractères de la Figure 1figure 1. Le modèle devrait reconstruire chaque mot depuis le début, chaque fois qu’il en rencontre un.
Des morceaux entre les deux
Les mots nouveaux sont surtout faits de morceaux familiers, et c’est là que se trouve l’issue. Vous pouvez lire antibactérien sans l’avoir jamais vu, parce que anti-, bactér et -ien sont de vieilles connaissances. Un vocabulaire de morceaux, dont certains sont des mots entiers et d’autres des fragments, garde les mots courants entiers et peut malgré tout épeler n’importe quoi, jusqu’aux caractères isolés dans le pire des cas.
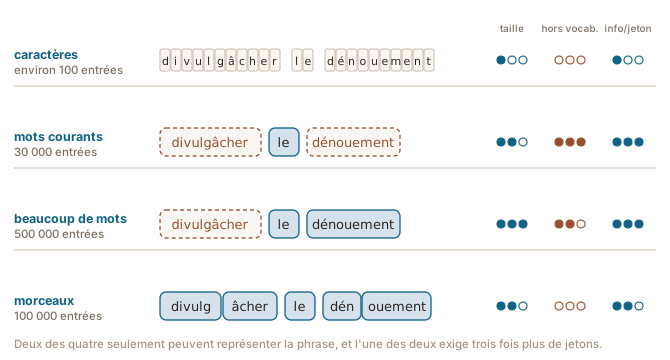
Avec la stratégie sous-lexicale, les caractères isolés font toujours partie du vocabulaire. Donc, quand aucun morceau plus grand ne correspond, n’importe quelle suite peut encore être couverte par les caractères individuels, et il ne reste aucun problème de mot hors vocabulaire : ni pour une coquille, ni pour un patronyme, ni pour un mot dans une langue que le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. a à peine vue, ni pour une ligne de pur charabia. Ce qui varie, c’est le prix. Un mot familier coûte un jeton, et un mot inconnu en coûte autant qu’il en faut pour l’épeler (see also the Consequences of tokenization chapter) (voir aussi le chapitre Conséquences de la jetonisation).
Sources
- Brysbaert, M., Stevens, M., Mandera, P., & Keuleers, E. (2016). How Many Words Do We Know? Practical Estimates of Vocabulary Size Dependent on Word Definition, the Degree of Language Input and the Participant's Age. Frontiers in Psychology, 7, 1116. https://doi.org/10.3389/fpsyg.2016.01116
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/