Absolute and relative frequenciesFréquences absolues et relatives
The same function on another corpus
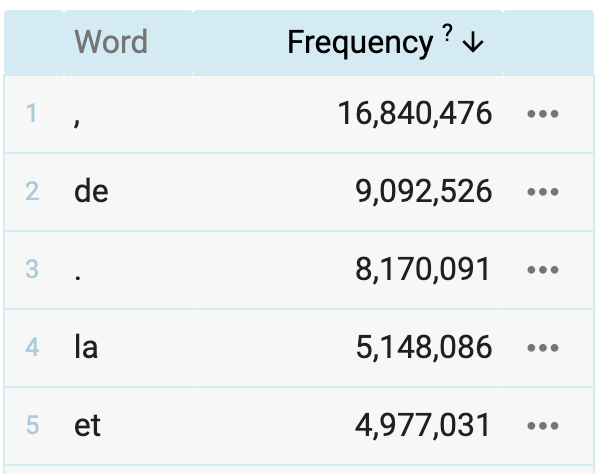
In the Gutenberg corpus, made of literary texts, the five most frequent words are these:
Now change corpus: select United Nations Parallel Corpus (UNPC) - French, the French side of the United Nations parallel corpus parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. (Ziemski et al., 2016), made of official UN texts. Run Wordlist again and look at the top of the list.
What is the frequency of the word "de" in the French UNPC corpus?
Quelle est la fréquence du mot « de » dans le corpus UNPC français ?
Show the explanationVoir l'explication
"De" occurs 50,020,990 times. It is the most frequent word of the UNPC corpus, as it is of the Gutenberg corpus: typical of French.
This corpus carries metadata about when each text was published. The results therefore give more than one overall frequency: they also show how that frequency moves over time.
« de » apparaît 50 020 990 fois. C'est le mot le plus fréquent du corpus UNPC, comme du corpus Gutenberg : typique du français.
Ce corpus porte des métadonnées sur la date de publication de chaque texte. Les résultats ne donnent donc pas qu'une fréquence globale : ils montrent aussi son évolution dans le temps.
What is the frequency of the apostrophe (') in the UNPC corpus?
Quelle est la fréquence de l'apostrophe (« ' ») dans le corpus UNPC ?
Show the explanationVoir l'explication
The apostrophe occurs 41,107,133 times. It is very frequent in French because of elision: "l'", "d'", "qu'", and so on. And since it is a token in its own right, it appears in the list alongside the words.
L'apostrophe apparaît 41 107 133 fois. Elle est très fréquente en français à cause des élisions : « l' », « d' », « qu' », etc. Et comme il s'agit d'un token à part entière, elle figure dans la liste au même titre que les mots.
The word at the top is the same in both corpora, “de”, which is the ordinary profile of French. Every frequency in the UNPC is nonetheless several times higher, because that corpus is much bigger. Raw counts therefore measure the size of the corpus in part, and two corpora of different sizes do not compare directly.
Normalizing in order to compare
Absolute frequency is the raw number of occurrences token¹occurrence de mot linguisticslinguistique An individual occurrence of a word or another countable element in a text.Apparition individuelle d'un mot ou d'un autre élément dénombrable dans un texte. of a word in a corpus. Relative frequency divides that number by the size of the corpus (Jurafsky & Martin, 2026, p. 72): if Chinese occurs 400 times in a corpus of a million words, dividing gives 0.0004.
Proportions like that are hard to read and hard to compare at a glance, so corpus tools scale them to a common base, usually one million words (Brezina, 2018, chap. 2):
relative frequency = (absolute frequency ÷ corpus size) × 1,000,000
A worked example. A word appears 300 times in a corpus of one million words: 300 occurrences per million. The same word appears 1,200 times in a corpus of ten million words: 120 occurrences per million. Despite four times as many occurrences, it is proportionally rarer there.
For the exercises that follow, go back to the Gutenberg French 2020 corpus.
La même fonction sur un autre corpus
Dans le corpus Gutenberg, fait de textes littéraires, les cinq mots les plus fréquents sont ceux-ci :
Changez maintenant de corpus : sélectionnez United Nations Parallel Corpus (UNPC) - French, la partie française du corpus parallèle parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. des Nations Unies (Ziemski et al., 2016), composé de textes officiels de l’ONU. Relancez Wordlist et regardez le haut de la liste.
What is the frequency of the word "de" in the French UNPC corpus?
Quelle est la fréquence du mot « de » dans le corpus UNPC français ?
Show the explanationVoir l'explication
"De" occurs 50,020,990 times. It is the most frequent word of the UNPC corpus, as it is of the Gutenberg corpus: typical of French.
This corpus carries metadata about when each text was published. The results therefore give more than one overall frequency: they also show how that frequency moves over time.
« de » apparaît 50 020 990 fois. C'est le mot le plus fréquent du corpus UNPC, comme du corpus Gutenberg : typique du français.
Ce corpus porte des métadonnées sur la date de publication de chaque texte. Les résultats ne donnent donc pas qu'une fréquence globale : ils montrent aussi son évolution dans le temps.
What is the frequency of the apostrophe (') in the UNPC corpus?
Quelle est la fréquence de l'apostrophe (« ' ») dans le corpus UNPC ?
Show the explanationVoir l'explication
The apostrophe occurs 41,107,133 times. It is very frequent in French because of elision: "l'", "d'", "qu'", and so on. And since it is a token in its own right, it appears in the list alongside the words.
L'apostrophe apparaît 41 107 133 fois. Elle est très fréquente en français à cause des élisions : « l' », « d' », « qu' », etc. Et comme il s'agit d'un token à part entière, elle figure dans la liste au même titre que les mots.
Le mot en tête est le même dans les deux corpus, « de », ce qui est le profil ordinaire du français. Toutes les fréquences de l’UNPC sont pourtant plusieurs fois plus élevées, parce que ce corpus est beaucoup plus gros. Les comptes bruts mesurent donc en partie la taille du corpus, et deux corpus de tailles différentes ne se comparent pas directement.
Normaliser pour comparer
La fréquence absolue est le nombre brut d’occurrences token¹occurrence de mot linguisticslinguistique An individual occurrence of a word or another countable element in a text.Apparition individuelle d'un mot ou d'un autre élément dénombrable dans un texte. d’un mot dans un corpus. La fréquence relative divise ce nombre par la taille du corpus (Jurafsky et Martin, 2026, p. 72) : si Chinese apparaît 400 fois dans un corpus d’un million de mots, la division donne 0,0004.
De telles proportions se lisent et se comparent mal d’un coup d’œil ; les outils de corpus les ramènent donc à une base commune, d’habitude un million de mots (Brezina, 2018, chap. 2) :
fréquence relative = (fréquence absolue ÷ taille du corpus) × 1 000 000
Un exemple chiffré. Un mot apparaît 300 fois dans un corpus d’un million de mots : 300 occurrences par million. Le même mot apparaît 1 200 fois dans un corpus de dix millions de mots : 120 occurrences par million. Malgré quatre fois plus d’occurrences, il y est proportionnellement plus rare.
Pour la suite des exercices, revenez au corpus Gutenberg French 2020.
Sources
- Brezina, V. (2018). Statistics in Corpus Linguistics: A Practical Guide. Cambridge University Press. https://doi.org/10.1017/9781316410899
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Sketch Engine (2020). Gutenberg Corpora 2020. sketchengine.eu. https://www.sketchengine.eu/gutenberg-corpora-2020/
- Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/