Large language modelsLes grands modèles de langue
TRA6008 OptionalFacultatif
One model, many tasks
Every system of the first three paradigms was built for one task: a spam filter sorts email, a tagger labels words with their grammatical class, and the next system means starting again, with new rules, new features or new labelled data. A large language model is a neural network neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. of the kind this chapter describes, trained from examples like the second and third paradigms, except that the examples are plain text and the task is to predict the next word (Jurafsky & Martin, 2026). Nothing in that training names a task, and once trained, the same model translates, summarizes, lists the terms in a text or labels its words, when the request is written to it in a prompt (Brown et al., 2020). Figure 6figure 6 sets the two arrangements side by side.
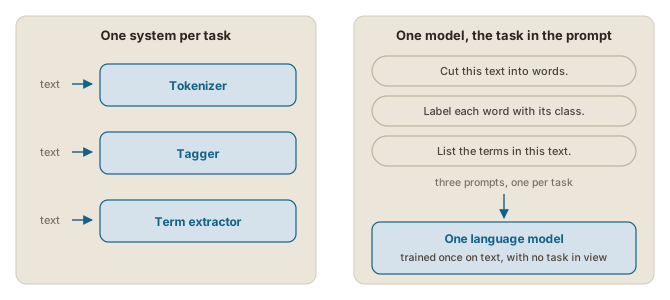
Decreasing human influence
Each shift took one thing out of the developer’s hands, as the table below sets out, and the last took the largest: the task itself, which passes to the person using the model.
| Shift | No longer specified by the developer | Still specified by people |
|---|---|---|
| Rules to machine learning | the patterns | the task and the features, by the developer, before training |
| Machine learning to deep learning | the features featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. | the task and its data, by the developer, before training |
| Deep learning to large language models | the task | the task, by the person using the model, in a prompt |
A large language model is, technically, deep learning. Four things make it a paradigm of its own all the same, rather than a step inside the third:
- One general system instead of a system per task. The line is not absolute, since a model can be fine-tuned fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. for one task or one context (see also the Fine-tuning chapter, in the LLM lifecycle module) (voir aussi le chapitre Affinage, dans le module Cycle de vie des GML) and dedicated systems are built on top of models, but its capabilities are far broader than those of any earlier system, and a prompt alone reaches most of them.
- A far simpler interface, so far less specialized users. A prompt is ordinary text rather than a program, so the person who describes the job is often the person who used to be a user of someone else’s system. The line between building a system and using one has moved.
- An even larger appetite for data and computation, in place of explicit knowledge. Each earlier shift already traded knowledge written by people for data; this one trades the task description itself for more text and more computation.
- A blurrier line between natural language processing natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. and the rest of AI. The model that labels words or extracts terms is the same one that writes code, describes images and acts on your behalf, and language has become the interface to all of it.
A prompt steers a model without changing it, and within limits (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
Still deep learning
Everything that was true of the third paradigm is still true of the fourth:
- the patterns it learned are spread over billions of numbers nobody can read (see also the black box page) (voir aussi la page La boîte noire);
- everything it does comes from its training text, with that text’s gaps and leanings (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML);
- the tasks it does well and badly do not follow what a person finds hard, so its abilities have to be tested;
- the dedicated systems have not disappeared: for a task run on whole corpora, fast and the same way every time, a trained tagger or a term extractor is still the usual tool (see also the Comparing term extraction methods page, in the Classical NLP module) (voir aussi la page Comparer les méthodes d'extraction de termes, dans le module TAL classique).
Un seul modèle, de nombreuses tâches
Chaque système des trois premiers paradigmes était construit pour une tâche : un filtre antipourriel trie les courriels, un étiqueteur attribue à chaque mot sa classe grammaticale, et le système suivant oblige à repartir de zéro, avec de nouvelles règles, de nouveaux attributs ou de nouvelles données étiquetées. Un grand modèle de langue est un réseau de neurones neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. du type que décrit ce chapitre, entraîné à partir d’exemples comme dans les deuxième et troisième paradigmes, à ceci près que les exemples sont du texte brut et que la tâche consiste à prédire le mot suivant (Jurafsky & Martin, 2026). Rien dans cet entraînement ne nomme une tâche, et une fois entraîné, le même modèle traduit, résume, dresse la liste des termes d’un texte ou en étiquette les mots, quand la demande lui est rédigée dans une requête (Brown et al., 2020). La Figure 6figure 6 compare les deux façons de faire.
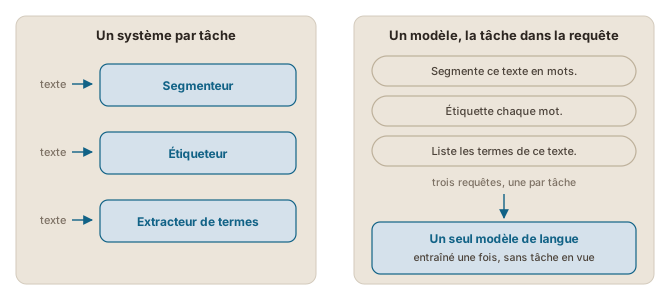
Une influence humaine qui diminue
Chaque changement a retiré une chose des mains du développeur, comme le montre le tableau ci-dessous, et le dernier a retiré la plus importante : la tâche elle-même, qui passe à la personne qui se sert du modèle.
| Changement | N’est plus spécifié par le développeur | Reste spécifié par des personnes |
|---|---|---|
| Des règles à l’apprentissage automatique | les régularités | la tâche et les attributs, par le développeur, avant l’entraînement |
| De l’apprentissage automatique à l’apprentissage profond | les attributs featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. | la tâche et ses données, par le développeur, avant l’entraînement |
| De l’apprentissage profond aux grands modèles de langue | la tâche | la tâche, par la personne qui se sert du modèle, dans une requête |
Un grand modèle de langue relève, techniquement, de l’apprentissage profond. Quatre choses en font pourtant un paradigme à part entière, plutôt qu’une étape à l’intérieur du troisième :
- Un seul système général au lieu d’un système par tâche. La frontière n’est pas absolue, puisqu’un modèle peut être affiné fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. pour une tâche ou un contexte (see also the Fine-tuning chapter, in the LLM lifecycle module) (voir aussi le chapitre Affinage, dans le module Cycle de vie des GML) et que des systèmes dédiés sont construits à partir de modèles, mais ses capacités sont bien plus larges que celles de tout système antérieur, et une requête suffit à en atteindre la plupart.
- Une interface bien plus simple, donc des utilisateurs bien moins spécialisés. Une requête est du texte ordinaire et non un programme, si bien que la personne qui décrit la tâche est souvent celle qui, auparavant, se servait du système de quelqu’un d’autre. La frontière entre construire un système et s’en servir s’est déplacée.
- Un appétit encore plus grand pour les données et le calcul, au lieu de connaissances explicites. Chaque changement précédent troquait déjà des connaissances écrites par des personnes contre des données ; celui-ci troque la description même de la tâche contre davantage de texte et de calcul.
- Une frontière plus floue entre le traitement automatique de la langue natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. et le reste de l’IA. Le modèle qui étiquette des mots ou extrait des termes est le même qui écrit du code, décrit des images et agit en votre nom, et la langue est devenue l’interface de tout cela.
Une requête oriente un modèle sans le modifier, et dans certaines limites (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
Toujours de l’apprentissage profond
Tout ce qui valait pour le troisième paradigme vaut encore pour le quatrième :
- les régularités qu’il a apprises sont réparties sur des milliards de nombres que personne ne sait lire (see also the black box page) (voir aussi la page La boîte noire) ;
- tout ce qu’il fait vient de son texte d’entraînement, avec les lacunes et les penchants de ce texte (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML) ;
- les tâches qu’il réussit ou rate ne suivent pas ce qu’une personne trouve difficile, si bien que ses capacités doivent être testées ;
- les systèmes dédiés n’ont pas disparu : pour une tâche appliquée à des corpus entiers, rapidement et toujours de la même façon, un étiqueteur entraîné ou un extracteur de termes reste l’outil habituel (see also the Comparing term extraction methods page, in the Classical NLP module) (voir aussi la page Comparer les méthodes d'extraction de termes, dans le module TAL classique).
Sources
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/