Agreement between annotatorsL'accord entre annotateurs
TRA2600 To read for S9À lire pour la S9
TRA6008 S5 · in classS5 · en classe
What agreement measures
For many language tasks, there is no single answer that is objectively true (see also the Systematic evaluation page) (voir aussi la page L'évaluation systématique), so people who annotate the same data separately do not produce the same gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. . The extent to which they agree is called inter-annotator agreement (IAA).
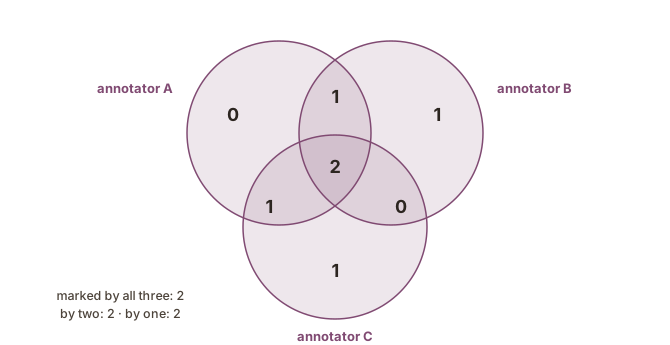
Inter-annotator agreement is a measure of the reliability of a gold standard: high agreement suggests that the annotators understood the guidelines in the same way (Artstein & Poesio, 2008). In Figure 5figure 5, three annotators have marked six units between them, and only two of the six were marked by all three.
Agreement is also measured when people judge the output of a system directly (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer). For translations, for example, both ratings on a scale and error annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. generally show low agreement between the people who judge (Kocmi et al., 2024a).
Measures of agreement
The simplest measure is the share of items on which the annotators gave the same answer. Part of any agreement arises by chance, and some measures correct for it (Artstein & Poesio, 2008). When annotators mark things in running text, such as terms, their agreement can be measured with the same scores as a system (Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page) (voir aussi la page L'accord mesuré par le score F1).
Low and high agreement
- Low agreement is a finding about the task. Either some annotators are wrong, or the guidelines do not fit the data (Artstein & Poesio, 2008). For many language tasks there is a third possibility, that more than one answer is right (Basile et al., 2021).
- A task with low agreement is harder to evaluate, and often harder to automate. The gold standard that a system is scored against is itself uncertain, and where people do not agree on the answer, a system has no consistent answer to learn or to reproduce. In a review of published results in biomedical NLP, Boguslav and Cohen (2017) found that tasks with higher agreement between annotators also had higher system scores.
- High agreement is not proof. Reliability is a precondition for a gold standard being right, but two people can share the same mistaken idea and agree completely (Artstein & Poesio, 2008).
Combining several annotators
Most evaluations compare a system with a single gold standard, so the differences between annotators have to be settled. This step is called adjudication, and it can be done in several ways, for instance:
- Discussion: the annotators compare their results and settle each difference together.
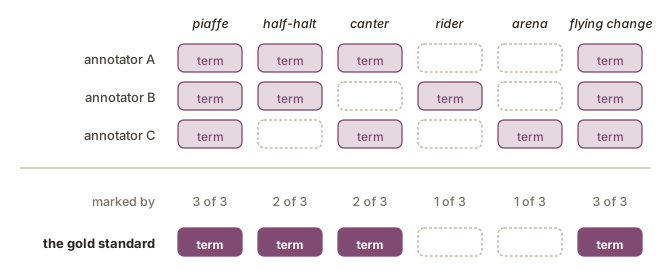
- Majority vote: a unit goes into the gold standard when most of the annotators marked it. Figure 6figure 6 applies it to the three annotators of Figure 5figure 5.
- One person checks: a single experienced annotator makes or reviews every decision, which keeps the gold standard consistent but makes it one person’s view.
Combining the annotations is not the only option. An evaluation can also keep the annotations of each person and compare a system with all of them, so that the items on which people disagree are counted as well (Basile et al., 2021).
Agreement and the score of a system
A score against a gold standard cannot be interpreted without the agreement between the people who made it. When two careful people reach 0.6 against each other, a system that reaches 0.6 against one of them does about as well as a second person would (see also the Agreement as an F1 score page) (voir aussi la page L'accord mesuré par le score F1).
The agreement is often assumed to be the upper limit of what a system can reach, but systems do score above it (Boguslav & Cohen, 2017). A higher score is not always feasible, and it is not always desirable: a much higher score can mean that the system reproduces the choices of the particular people who made the gold standard.
Ce que mesure l’accord
Pour beaucoup de tâches langagières, il n’existe pas de réponse unique qui soit objectivement vraie (see also the Systematic evaluation page) (voir aussi la page L'évaluation systématique) : des personnes qui annotent les mêmes données séparément ne produisent donc pas le même étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. . La mesure dans laquelle elles sont d’accord s’appelle l’accord inter-annotateurs.
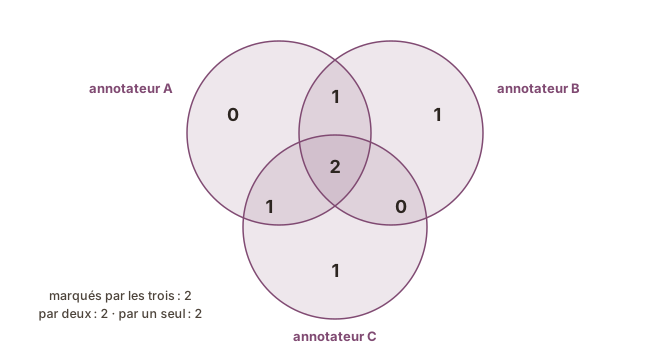
L’accord inter-annotateurs est une mesure de la fiabilité d’un étalon de référence : un accord élevé suggère que les annotateurs ont compris les consignes de la même façon (Artstein & Poesio, 2008). Dans Figure 5figure 5, trois annotateurs ont marqué six unités à eux trois, et seules deux des six ont été marquées par les trois.
L’accord se mesure aussi lorsque des personnes jugent directement la sortie d’un système (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer). Pour les traductions, par exemple, la notation sur une échelle et l’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. des erreurs donnent toutes deux, en général, un accord faible entre les personnes qui jugent (Kocmi et al., 2024a).
Les mesures de l’accord
La mesure la plus simple est la proportion d’éléments pour lesquels les annotateurs ont donné la même réponse. Une partie de tout accord est due au hasard, et certaines mesures en tiennent compte (Artstein & Poesio, 2008). Lorsque les annotateurs marquent des éléments dans un texte suivi, comme des termes, leur accord peut être mesuré avec les mêmes scores qu’un système (Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page) (voir aussi la page L'accord mesuré par le score F1).
Accord faible et accord élevé
- Un accord faible est un constat sur la tâche. Soit certains annotateurs se trompent, soit les consignes ne conviennent pas aux données (Artstein & Poesio, 2008). Pour beaucoup de tâches langagières, il existe une troisième possibilité : plusieurs réponses sont correctes (Basile et al., 2021).
- Une tâche où l’accord est faible est plus difficile à évaluer, et souvent plus difficile à automatiser. L’étalon de référence auquel un système est comparé est lui-même incertain, et lorsque les personnes ne s’entendent pas sur la réponse, un système n’a pas de réponse constante à apprendre ou à reproduire. Dans une analyse de résultats publiés en TAL biomédical, Boguslav et Cohen (2017) ont constaté que les tâches où l’accord entre annotateurs était plus élevé obtenaient aussi des scores de systèmes plus élevés.
- Un accord élevé n’est pas une preuve. La fiabilité est une condition préalable pour qu’un étalon de référence soit juste, mais deux personnes peuvent partager la même idée fausse et être entièrement d’accord (Artstein & Poesio, 2008).
Combiner plusieurs annotateurs
La plupart des évaluations comparent un système à un seul étalon de référence : les différences entre annotateurs doivent donc être tranchées. Cette étape s’appelle l’arbitrage, et elle peut se faire de plusieurs façons, par exemple :
- La discussion : les annotateurs comparent leurs résultats et tranchent chaque différence ensemble.
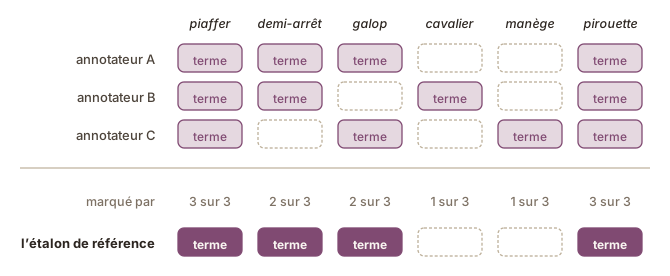
- Le vote majoritaire : une unité entre dans l’étalon de référence lorsque la majorité des annotateurs l’ont marquée. La Figure 6figure 6 l’applique aux trois annotateurs de Figure 5figure 5.
- La vérification par une seule personne : un seul annotateur expérimenté prend ou révise chaque décision, ce qui garde l’étalon de référence cohérent, mais en fait le point de vue d’une seule personne.
Combiner les annotations n’est pas la seule possibilité. Une évaluation peut aussi conserver les annotations de chaque personne et comparer un système à toutes, de sorte que les éléments sur lesquels les personnes sont en désaccord sont comptés eux aussi (Basile et al., 2021).
L’accord et le score d’un système
Un score par rapport à un étalon de référence ne peut pas être interprété sans l’accord entre les personnes qui l’ont établi. Lorsque deux personnes soigneuses atteignent 0,6 l’une par rapport à l’autre, un système qui atteint 0,6 par rapport à l’une d’elles fait à peu près aussi bien que le ferait une deuxième personne (see also the Agreement as an F1 score page) (voir aussi la page L'accord mesuré par le score F1).
L’accord est souvent considéré comme la limite supérieure de ce qu’un système peut atteindre, mais des systèmes obtiennent bel et bien des scores supérieurs (Boguslav & Cohen, 2017). Un score plus élevé n’est pas toujours réalisable, et il n’est pas toujours souhaitable : un score beaucoup plus élevé peut signifier que le système reproduit les choix des personnes qui ont établi l’étalon de référence.
Sources
- Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
- Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
- Boguslav, M., & Cohen, K. B. (2017). Inter-Annotator Agreement and the Upper Limit on Machine Performance: Evidence from Biomedical Natural Language Processing. Studies in Health Technology and Informatics, 245, 298–302. https://doi.org/10.3233/978-1-61499-830-3-298
- Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
- Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131