Matching rulesLes règles de correspondance
TRA2600 S9 · in classS9 · en classe
TRA6008 S5 · in classS5 · en classe
Matching decisions
The scores of a system that finds things in a text depend on how strictly an answer has to match the gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. to count as correct (see also the Interpreting a score page) (voir aussi la page Interpréter un score). The same decisions come up for any such task. The table below gives them for term extraction (see also the Automatic term extraction (from rules to large language models) chapter, in the Classical NLP module) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue), dans le module TAL classique) and for named entity recognition named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , which finds the names of people, places and organizations in a text.
| Decision | Term extraction | Named entity recognition |
|---|---|---|
| Unique items or occurrences | each term once, or every occurrence in the text | each name once, or every mention of it in the text |
| Partial matches | whether canter is wrong, half right or right when the gold standard has collected canter | whether Curie is wrong, half right or right when the gold standard has Marie Curie |
| Nested units | only the longest terms, or also the shorter terms inside them, such as canter in collected canter | only the longest names, or also the names inside them, such as Paris in University of Paris |
| Form | whether capital letters, plurals and spelling variants are the same answer | whether capital letters and spelling variants, such as Tchaikovsky and Tchaikovski, are the same answer |
| Labels | whether a term must also have the right label, when the gold standard labels its terms | whether a name must also have the right type, such as person or place |
| Cut-off | the whole ranked list, or its top | a threshold on the confidence of the system, when it reports one |
For classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. , most of these decisions do not come up: each item, such as a message, is a unit with fixed boundaries, and the system gives it a class. Jurafsky and Martin (2026) point out that named entity recognition has a step of segmentation, deciding where each name starts and ends, which text classification does not have, and that this step complicates its evaluation.
In Figure 12figure 12, for example, the same four candidates get an F1 score F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. of 0.25, 0.50 or 0.75, depending on the decision about form.
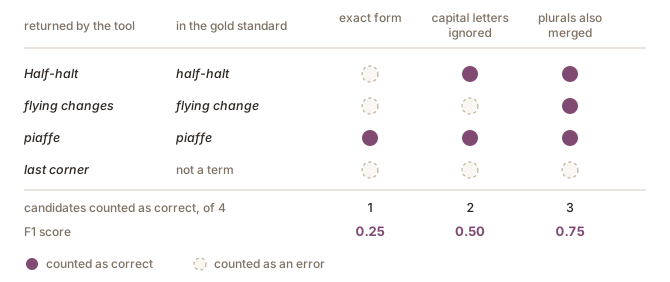
Four findings show how much these decisions can change the scores:
- Partial matches in named entity recognition. When the name is the unit that is counted, a system that returns Jane where the gold standard has Jane Villanueva makes two errors at once: a false positive false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. for Jane and a false negative false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. for Jane Villanueva (Jurafsky & Martin, 2026).
- Partial matches and cut-off in term extraction. Reported scores differ greatly depending on how strict the evaluation is, for example on whether partial matches are accepted, and they change with the point at which a ranked list is cut off (Rigouts Terryn et al., 2019).
- Unique terms or occurrences. Scores for every occurrence in the running text and scores for a list of unique terms can lead to different conclusions, for example about the language or the domain in which a system does best (Rigouts Terryn et al., 2022b).
- Form. A large language model large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. sometimes returns a form that is not in the text word for word, such as follow-up where the text has follow up (Rigouts Terryn, 2026).
Candidates between right and wrong
A strict comparison has two outcomes, correct or not, but many candidates of a term extractor are between the two (Figure 13figure 13):
- the candidate is part of a term in the gold standard;
- the candidate is a term of the gold standard with another word attached;
- the candidate would be a term for some purposes and not for others.
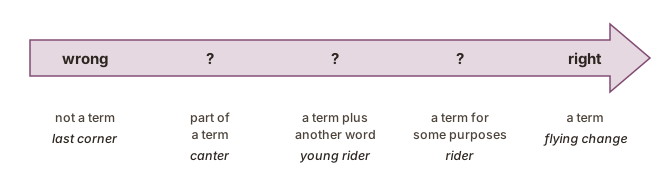
The same cases come up in named entity recognition, for instance Curie for Marie Curie, or the University of Paris with one word too many. A strict evaluation counts all of them as errors. A more lenient evaluation accepts some of them and gives higher scores, so scores obtained with different rules cannot be compared.
Les décisions de correspondance
Les scores d’un système qui repère des éléments dans un texte dépendent de la rigueur avec laquelle une réponse doit correspondre à l’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. pour compter comme correcte (see also the Interpreting a score page) (voir aussi la page Interpréter un score). Les mêmes décisions se posent pour toute tâche de ce genre. Le tableau ci-dessous les donne pour l’extraction de termes (see also the Automatic term extraction (from rules to large language models) chapter, in the Classical NLP module) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue), dans le module TAL classique) et pour la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , qui repère les noms de personnes, de lieux et d’organisations dans un texte.
| Décision | Extraction de termes | Reconnaissance d’entités nommées |
|---|---|---|
| Éléments uniques ou occurrences | chaque terme une seule fois, ou chacune de ses occurrences dans le texte | chaque nom une seule fois, ou chacune de ses mentions dans le texte |
| Correspondances partielles | si galop est faux, à moitié juste ou juste quand l’étalon de référence contient galop rassemblé | si Curie est faux, à moitié juste ou juste quand l’étalon de référence contient Marie Curie |
| Unités imbriquées | seulement les termes les plus longs, ou aussi les termes plus courts qu’ils contiennent, comme galop dans galop rassemblé | seulement les noms les plus longs, ou aussi les noms qu’ils contiennent, comme Paris dans Université de Paris |
| Forme | si les majuscules, les pluriels et les variantes orthographiques donnent la même réponse | si les majuscules et les variantes orthographiques, comme Tchaïkovski et Tchaïkovsky, donnent la même réponse |
| Étiquettes | si un terme doit aussi avoir la bonne étiquette, quand l’étalon de référence étiquette ses termes | si un nom doit aussi avoir le bon type, comme personne ou lieu |
| Seuil | toute la liste classée, ou son haut | un seuil sur la confiance du système, quand il en indique une |
Pour la classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. , la plupart de ces décisions ne se posent pas : chaque élément, comme un message, est une unité aux limites fixes, et le système lui attribue une classe. Jurafsky et Martin (2026) font remarquer que la reconnaissance d’entités nommées comporte une étape de segmentation, qui décide où chaque nom commence et finit, que la classification de textes n’a pas, et que cette étape complique son évaluation.
Dans Figure 12figure 12, par exemple, les mêmes quatre candidats obtiennent un score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. de 0,25, de 0,50 ou de 0,75, selon la décision sur la forme.
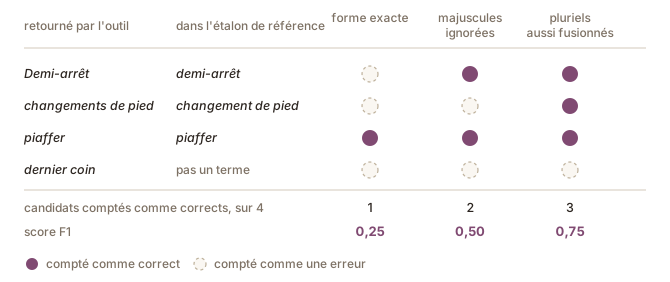
Quatre constats montrent à quel point ces décisions peuvent changer les scores :
- Correspondances partielles en reconnaissance d’entités nommées. Quand l’unité comptée est le nom, un système qui propose Jane là où l’étalon de référence contient Jane Villanueva fait deux erreurs à la fois : un faux positif false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. pour Jane et un faux négatif false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. pour Jane Villanueva (Jurafsky & Martin, 2026).
- Correspondances partielles et seuil en extraction de termes. Les scores publiés varient beaucoup selon la rigueur de l’évaluation, par exemple selon que les correspondances partielles sont acceptées ou non, et ils changent avec l’endroit où une liste classée est coupée (Rigouts Terryn et al., 2019).
- Termes uniques ou occurrences. Les scores calculés sur chaque occurrence dans le texte et les scores calculés sur une liste de termes uniques peuvent mener à des conclusions différentes, par exemple sur la langue ou le domaine où un système réussit le mieux (Rigouts Terryn et al., 2022b).
- Forme. Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. donne parfois une forme qui ne figure pas telle quelle dans le texte, comme follow-up là où le texte a follow up (Rigouts Terryn, 2026).
Les candidats entre le juste et le faux
Une comparaison stricte n’a que deux issues, correct ou non, mais beaucoup de candidats d’un extracteur de termes se situent entre les deux (Figure 13figure 13) :
- le candidat est une partie d’un terme de l’étalon de référence ;
- le candidat est un terme de l’étalon de référence auquel s’ajoute un autre mot ;
- le candidat serait un terme pour certains usages, mais pas pour d’autres.
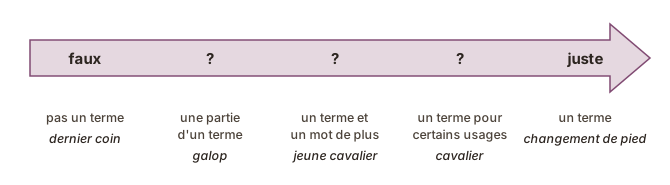
Les mêmes cas se présentent en reconnaissance d’entités nommées, par exemple Curie pour Marie Curie, ou l’Université de Paris avec un mot de trop. Une évaluation stricte les compte tous comme des erreurs. Une évaluation plus souple en accepte certains et donne des scores plus élevés : des scores obtenus avec des règles différentes ne peuvent donc pas être comparés.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
- Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig