Benchmarks and test setsTests de performances et jeux de test
TRA2600 OptionalFacultatif
TRA6008 OptionalFacultatif
Gold standard, test set and benchmark
A gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. is one part of an evaluation: the answers that an output is compared with. A benchmark is a whole evaluation, prepared once and shared, so that everyone who tests a system for the same task uses the same one (Raji et al., 2021).
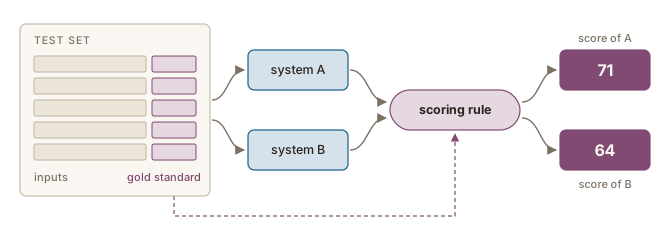
A benchmark fixes all three parts of an evaluation (see also the Systematic evaluation page) (voir aussi la page L'évaluation systématique), as the table below and Figure 7figure 7 show.
| Part of an evaluation | In a benchmark |
|---|---|
| Evaluation data | a fixed set of inputs that the systems were not trained on |
| Judgement | an answer for each input: most often a gold standard for answers that are not verifiable; a ground truth ground truthréalité de terrain evaluationévaluation The values, labels or observations treated as the correct description of the cases in a dataset.Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. when they are |
| Measure | a scoring rule, the same for every system |
The inputs of a benchmark, together with their answers, are its test set.
A gold standard that you make for your own project is therefore not a benchmark. It becomes part of one when it is published with its inputs and a scoring rule, and other people use it to compare their systems.
A test that can be reused
A benchmark can be reused: once it exists, any number of systems, including systems released later, can be scored on it in exactly the same way. Pairwise comparisons and ratings by people take new effort for every system, and they cannot be repeated identically (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer).
Using the same test for every system does not by itself make the comparison fair: a system may have been trained on the test set, or the test set may suit one system better than another.
Data contamination
A system that learned from its test set has not been tested, any more than a student who saw the exam paper the night before. For a model trained on text collected from the web, such learning is difficult to rule out. A public benchmark is text on the web, and so are the papers that discuss it, answer keys and forum threads.
Contamination makes a score too high without making the system better. With the training data undisclosed, it is hard to measure from outside, and Sainz et al. (2023) argue that it has to be measured for each benchmark and cannot be assumed absent (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML).
Contamination can also happen by hand: pasting a benchmark’s questions into a chat product that uses its conversations for training sends the test set to the provider. Balloccu et al. (2024) reviewed studies that evaluated such products and found that, between them, they had exposed the test items of hundreds of benchmarks in this way.
Two other things can distort a comparison on the same test set:
- Tuning on the test set. A system that was adjusted again and again until its score on the test set went up has also learned from it, which is why a separate development set validation setjeu de données de validation machine learningapprentissage automatique A portion of a dataset kept separate from the data used to fit a model's parameters and used during development to guide choices about the model.Portion d'un jeu de données tenue à l'écart des données servant à ajuster les paramètres d'un modèle et utilisée pendant le développement pour guider les choix concernant le modèle. is used for tuning (see also the From rules to machine learning chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des règles à l'apprentissage automatique, dans le module Fondements de l'IA et du TAL).
- A test set closer to one system. A test set whose texts resemble the training data of one system more than that of another favours that system.
Limits of a benchmark score
Each of the three parts of a benchmark can be flawed, so a score can only be interpreted by looking at all three. Two parts can be excellent, but a flaw in the third still affects every score.
- The test set: how relevant is it to your task and your texts? A benchmark measures the particular tasks it contains, not a “general” ability (Raji et al., 2021). A high score on general knowledge or on coding says little about how a system will do on a legal text in French (see also the LLM leaderboards chapter, in the Using LLMs module) (voir aussi le chapitre Les classements de GML, dans le module Utiliser les GML).
- The gold standard: how reliable is it? The answers are only as reliable as the agreement between the people who produced them (see also the Agreement between annotators page) (voir aussi la page L'accord entre annotateurs).
- The scoring rule: what is it able to measure? An automatic score can go up without the outputs getting better: for translation, relying on BLEU alone led to bad decisions about which system to deploy (Kocmi et al., 2021) (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer).
Étalon de référence, jeu de test et test de performances
Un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. est une partie d’une évaluation : les réponses auxquelles une sortie est comparée. Un test de performances est une évaluation complète, préparée une fois et partagée, de sorte que toutes les personnes qui testent un système pour la même tâche utilisent la même (Raji et al., 2021).
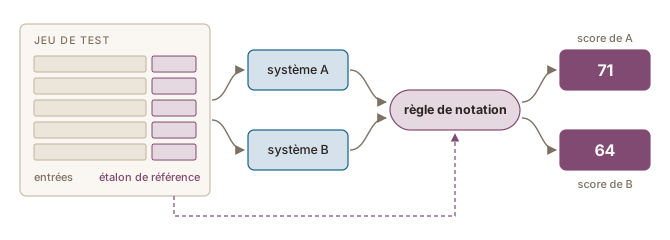
Un test de performances fixe les trois parties d’une évaluation (see also the Systematic evaluation page) (voir aussi la page L'évaluation systématique), comme le montrent le tableau ci-dessous et Figure 7figure 7.
| Partie d’une évaluation | Dans un test de performances |
|---|---|
| Données d’évaluation | un ensemble fixe d’entrées qui n’ont pas servi à entraîner les systèmes |
| Jugement | une réponse pour chaque entrée : le plus souvent un étalon de référence pour les réponses qui ne sont pas vérifiables ; une réalité de terrain ground truthréalité de terrain evaluationévaluation The values, labels or observations treated as the correct description of the cases in a dataset.Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. lorsqu’elles le sont |
| Mesure | une règle de notation, la même pour tous les systèmes |
Les entrées d’un test de performances, avec leurs réponses, constituent son jeu de test.
Un étalon de référence que vous créez pour votre propre projet n’est donc pas un test de performances. Il en devient une partie lorsqu’il est publié avec ses entrées et une règle de notation, et que d’autres personnes l’utilisent pour comparer leurs systèmes.
Un test réutilisable
Un test de performances peut être réutilisé : une fois qu’il existe, autant de systèmes qu’on le souhaite, y compris des systèmes publiés plus tard, peuvent y obtenir un score exactement de la même façon. Les comparaisons par paires et les notations par des personnes demandent un nouvel effort pour chaque système, et elles ne peuvent pas être répétées à l’identique (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer).
Utiliser le même test pour tous les systèmes ne suffit pas à rendre la comparaison équitable : un système peut avoir été entraîné sur le jeu de test, ou le jeu de test peut convenir mieux à un système qu’à un autre.
La contamination des données
Un système qui a appris à partir de son jeu de test n’a pas été testé, pas plus qu’un étudiant qui a vu le questionnaire de l’examen la veille. Pour un modèle entraîné sur du texte recueilli sur le web, un tel apprentissage est difficile à exclure. Un test de performances public est du texte sur le web, tout comme les articles qui en discutent, les corrigés et les fils de discussion.
La contamination rend un score trop élevé sans rendre le système meilleur. Comme les données d’entraînement ne sont pas divulguées, elle est difficile à mesurer de l’extérieur, et Sainz et al. (2023) soutiennent qu’elle doit être mesurée pour chaque test de performances et qu’on ne peut pas la supposer absente (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML).
La contamination peut aussi se produire à la main : coller les questions d’un test de performances dans un agent conversationnel dont les conversations servent à l’entraînement transmet le jeu de test au fournisseur. Balloccu et al. (2024) ont passé en revue des études qui évaluaient de tels produits et ont constaté qu’à elles toutes, elles avaient ainsi exposé les éléments de test de centaines de tests de performances.
Deux autres facteurs peuvent fausser une comparaison sur le même jeu de test :
- L’ajustement sur le jeu de test. Un système qui a été ajusté encore et encore jusqu’à ce que son score au jeu de test augmente a lui aussi appris à partir de ce jeu, et c’est pourquoi un jeu de développement validation setjeu de données de validation machine learningapprentissage automatique A portion of a dataset kept separate from the data used to fit a model's parameters and used during development to guide choices about the model.Portion d'un jeu de données tenue à l'écart des données servant à ajuster les paramètres d'un modèle et utilisée pendant le développement pour guider les choix concernant le modèle. distinct sert à l’ajustement (see also the From rules to machine learning chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des règles à l'apprentissage automatique, dans le module Fondements de l'IA et du TAL).
- Un jeu de test plus proche d’un système. Un jeu de test dont les textes ressemblent davantage aux données d’entraînement d’un système qu’à celles d’un autre favorise ce système.
Les limites d’un score à un test de performances
Chacune des trois parties d’un test de performances peut avoir des défauts : un score ne peut donc être interprété qu’en examinant les trois. Deux parties peuvent être excellentes, mais un défaut dans la troisième affecte tout de même tous les scores.
- Le jeu de test : est-il pertinent pour votre tâche et vos textes ? Un test de performances mesure les tâches particulières qu’il contient, et non une capacité « générale » (Raji et al., 2021). Un score élevé en culture générale ou en programmation en dit peu sur ce qu’un système fera d’un texte juridique en français (see also the LLM leaderboards chapter, in the Using LLMs module) (voir aussi le chapitre Les classements de GML, dans le module Utiliser les GML).
- L’étalon de référence : est-il fiable ? Les réponses ne sont pas plus fiables que l’accord entre les personnes qui les ont produites (see also the Agreement between annotators page) (voir aussi la page L'accord entre annotateurs).
- La règle de notation : que peut-elle mesurer ? Un score automatique peut augmenter sans que les sorties s’améliorent : en traduction, se fier uniquement à BLEU a mené à de mauvaises décisions sur le système à déployer (Kocmi et al., 2021) (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer).
Sources
- Balloccu, S., Schmidtová, P., Lango, M., & Dušek, O. (2024). Leak, Cheat, Repeat: Data Contamination and Evaluation Malpractices in Closed-Source LLMs. Proceedings of the 18th Conference of the European Chapter of the Association for Computational Linguistics (Volume 1: Long Papers), 67–93. https://doi.org/10.18653/v1/2024.eacl-long.5
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., Federmann, C., Grundkiewicz, R., Junczys-Dowmunt, M., Matsushita, H., & Menezes, A. (2021). To Ship or Not to Ship: An Extensive Evaluation of Automatic Metrics for Machine Translation. Proceedings of the Sixth Conference on Machine Translation (WMT 2021), 478–494. https://aclanthology.org/2021.wmt-1.57/
- Raji, D., Denton, E., Bender, E. M., Hanna, A., & Paullada, A. (2021). AI and the Everything in the Whole Wide World Benchmark. Proceedings of the Neural Information Processing Systems Track on Datasets and Benchmarks, 1 (NeurIPS 2021). https://datasets-benchmarks-proceedings.neurips.cc/paper/2021/hash/084b6fbb10729ed4da8c3d3f5a3ae7c9-Abstract-round2.html
- Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722