Term extraction with LLMsL'extraction de termes avec les GML
TRA2600 S8 · in classS8 · en classe
TRA6008 To read for S5À lire pour la S5
Prompting for terms
The simplest way to extract terms with an LLM is to paste a text into a chatbot and ask for the terms in it. Nothing but the model’s training then settles what counts as a term. A more careful prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. gives the model the information a person would need to decide which units are terms:
- what a term is;
- whether names and single words count;
- whether a shorter term inside a longer one counts;
- in what form to return each candidate.
Every decision on which people disagree becomes a decision written into the prompt, so two people who prompt differently can get different lists from the same model.
In a research study, the prompt should resemble the annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. guidelines that the people who made the gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. followed, so that the model and the annotators work from the same instructions.
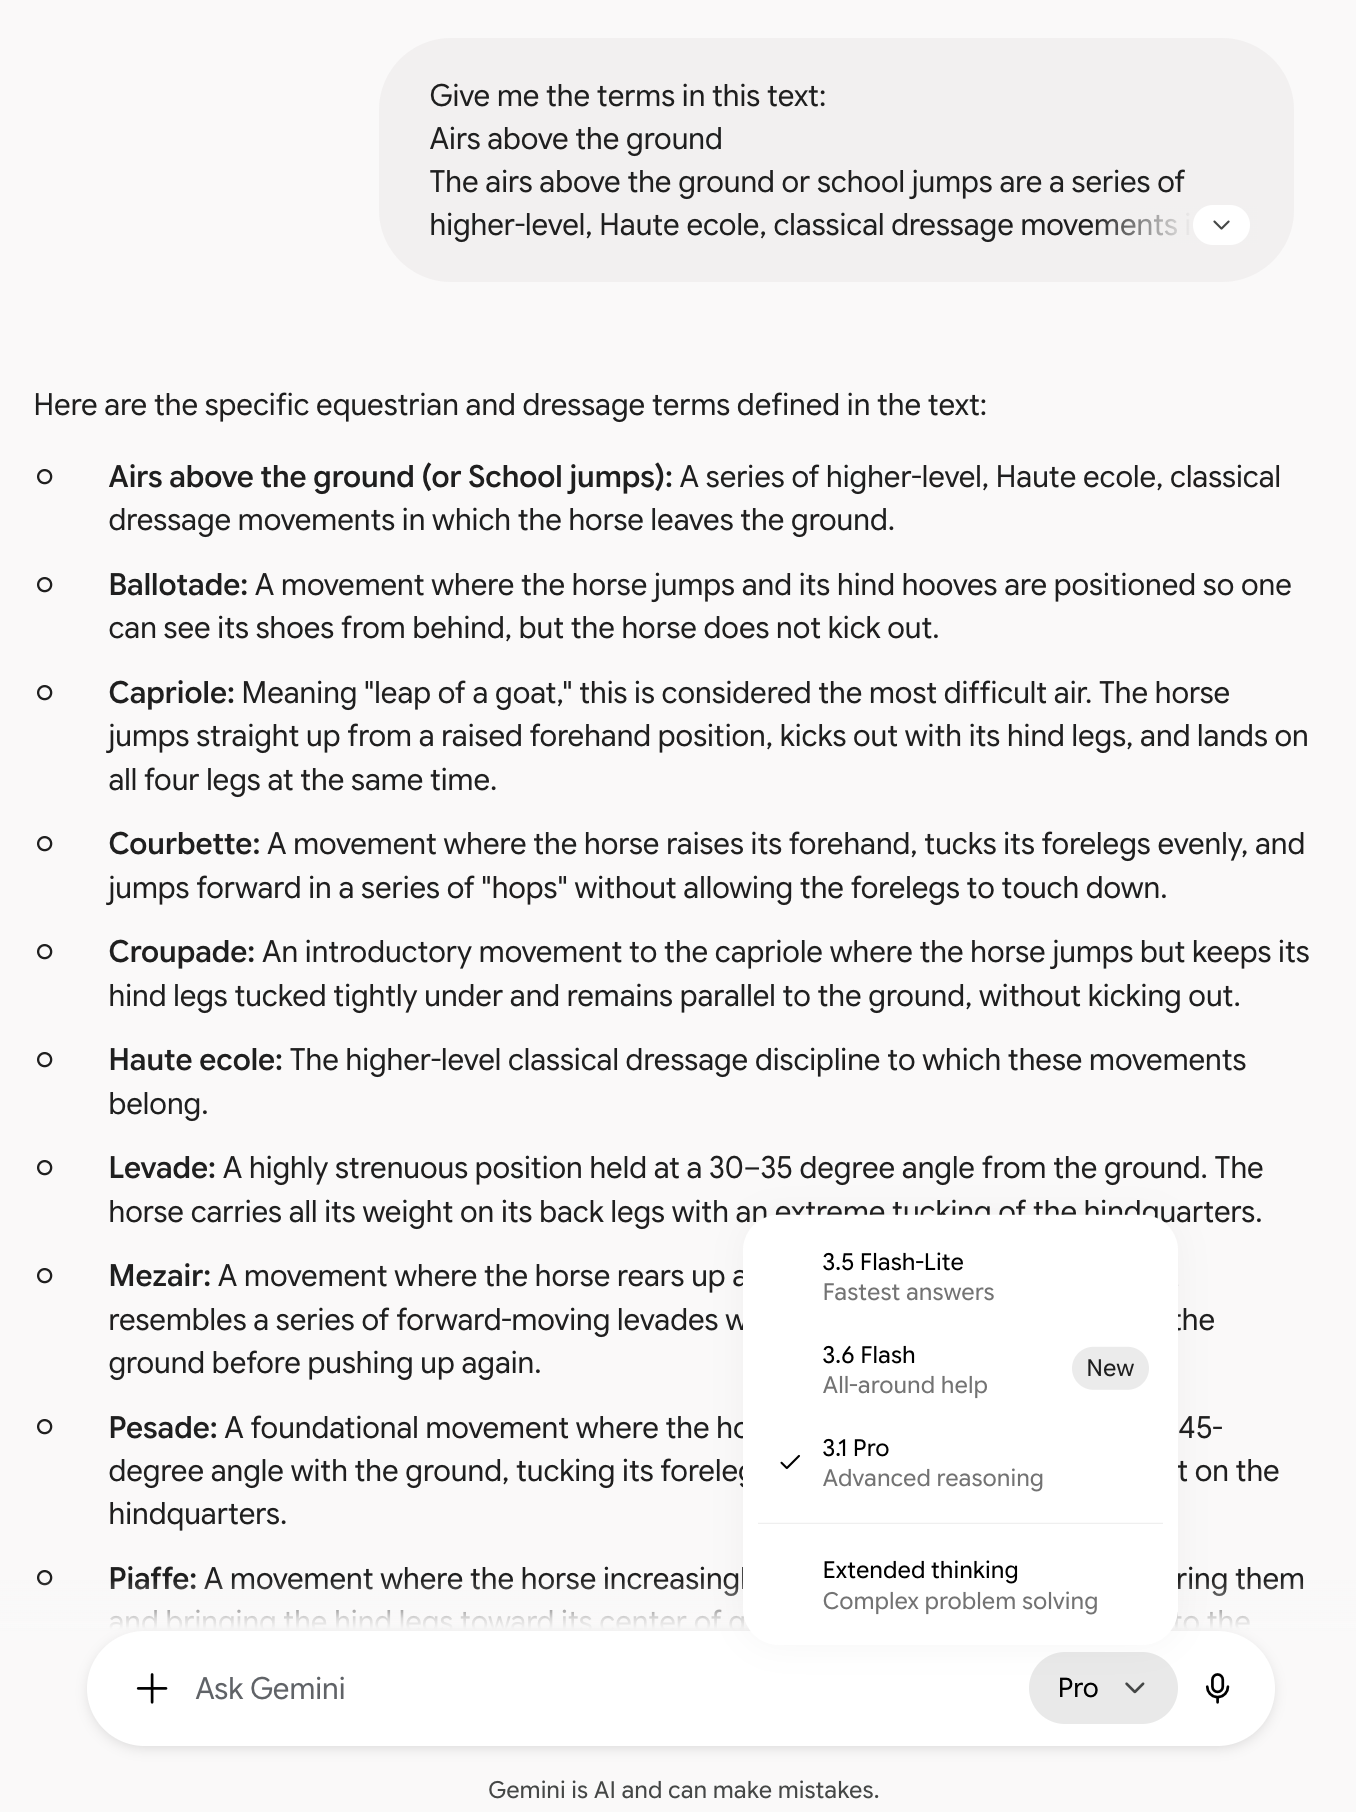
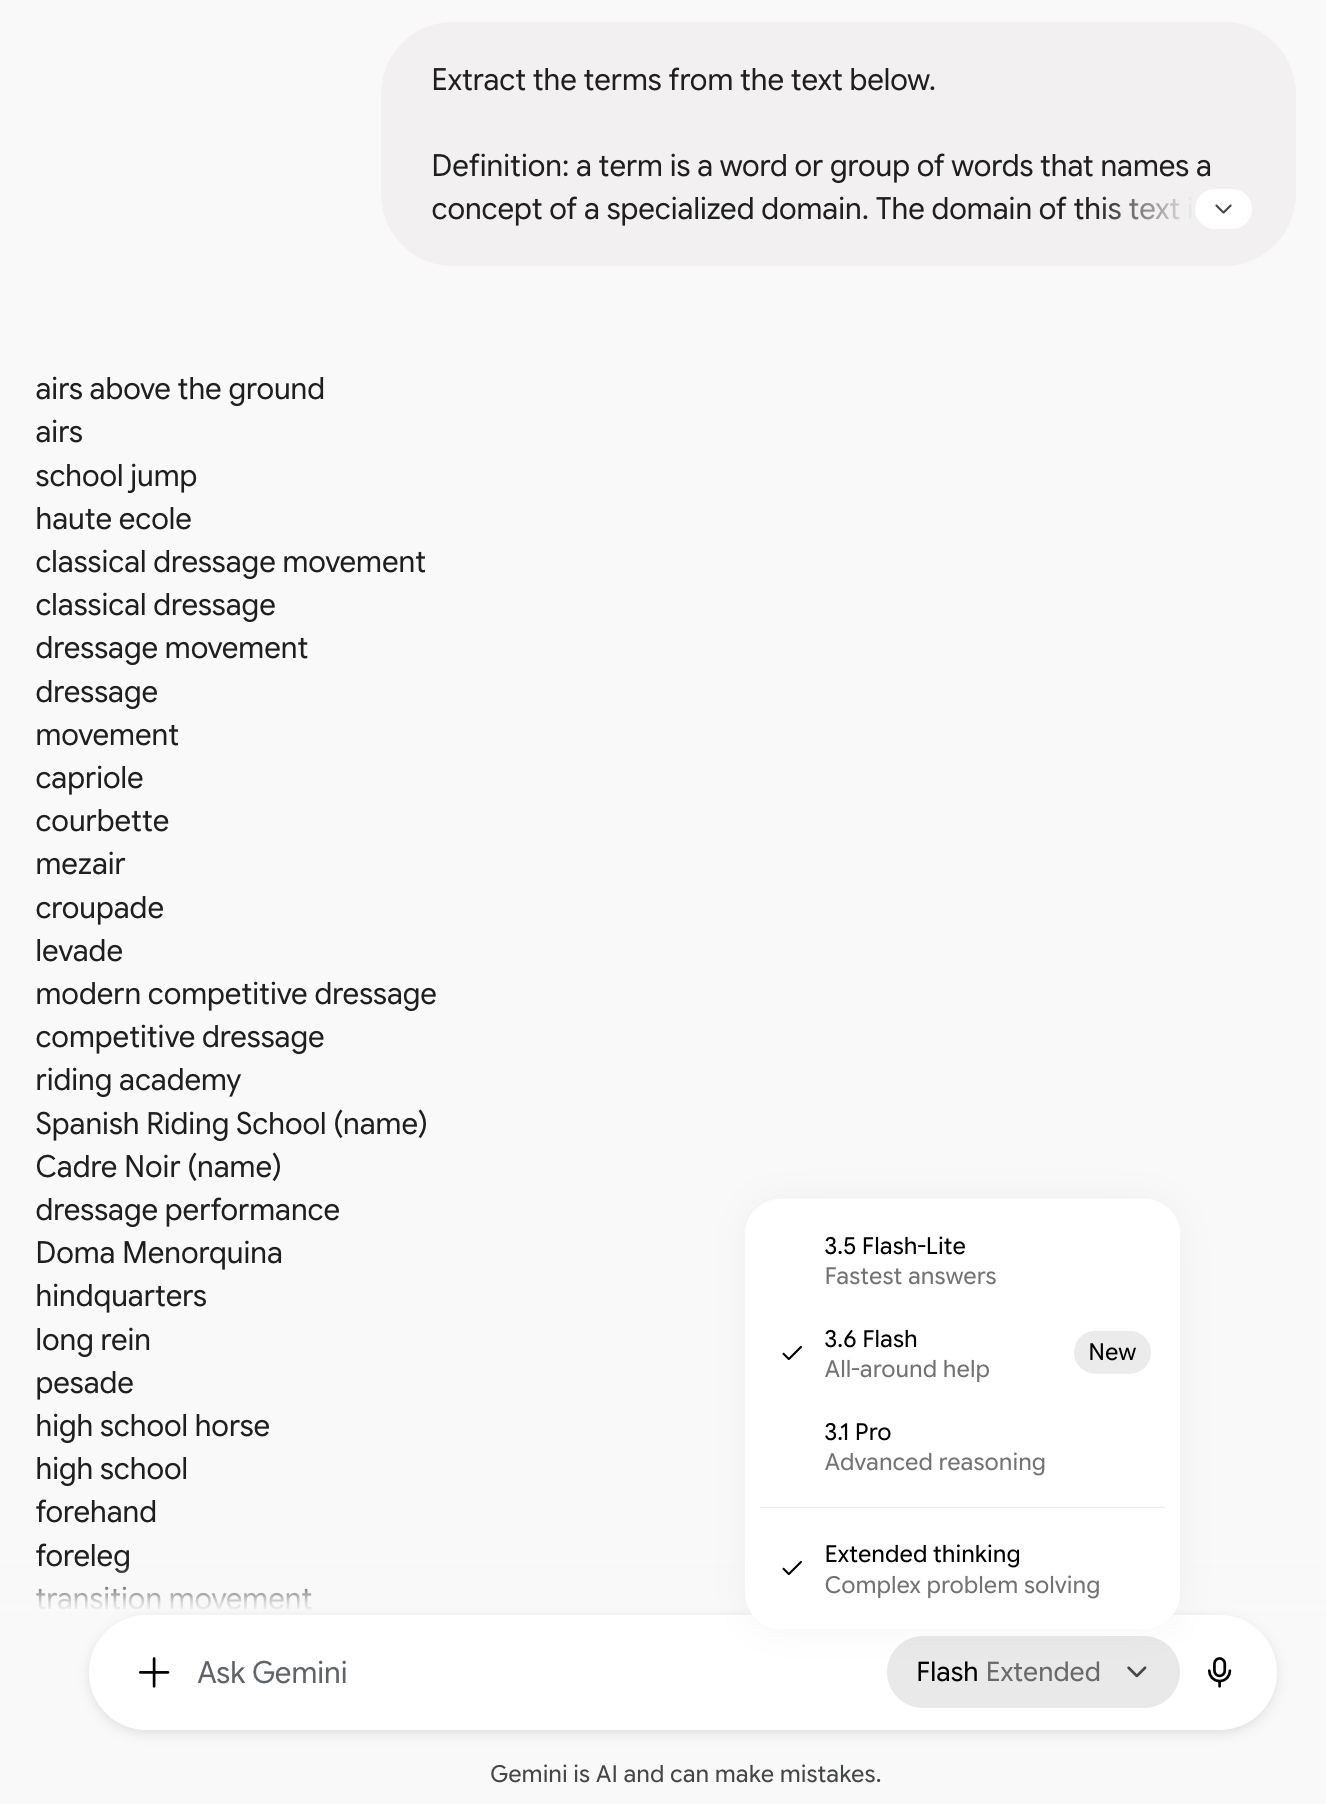
The two screenshots below show the difference on one text about dressage. With a bare request (Figure 25figure 25), the chatbot returns the terms that the text defines, each with a definition. With a prompt written like guidelines (Figure 26figure 26), the answer is a plain list in the form the prompt asked for.
Results of LLMs
Early studies, with GPT-3.5 and Llama 2, found that prompting an LLM came close to tools trained on annotated examples (Banerjee et al., 2024; Tran et al., 2024). With models available in 2025, the gap closed: on the twelve corpora of the ACTER dataset, four LLMs were competitive with tools trained for the task, and in the range of the agreement between annotators (Rigouts Terryn, 2026) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).GPT-5 and GPT-5-mini (snapshots of 7 August 2025), Mistral Large (2411) and Magistral Medium (2507). Three findings of that study:
- The texts changed the results more than the model did. The domain and the language of a text counted for more than the choice among the four models.
- A detailed prompt helped more than examples in the prompt.
- The models proposed too much rather than too little, for instance general words, several terms joined by and, and descriptive phrases.
Candidates that are not in the text
A tool built on rules or trained to mark words can only return words that are in the text. An LLM writes its answer, so a candidate can differ from the text. In the same study, about 2% of the candidates did not appear in the text word for word, which is often counted as a hallucination hallucinationfabulation de l'IA language modelsmodèles de langue Content generated by an AI model that is factually incorrect or fabricated, even though it may sound plausible.Contenu généré par un modèle d'IA qui est factuellement inexact ou fabriqué, même s'il peut sembler plausible. . Most of them were tidied forms of terms that are in the text, such as a shortened term given in full or punctuation dropped, and real inventions were rare (Rigouts Terryn, 2026). Each candidate still has to be checked against the text.
Formuler une requête pour obtenir des termes
La façon la plus simple d’extraire des termes avec un GML est de coller un texte dans un agent conversationnel et de lui demander les termes qu’il contient. Seul l’entraînement du modèle détermine alors ce qui compte comme terme. Une requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. plus soignée donne au modèle les informations dont une personne aurait besoin pour décider quelles unités sont des termes :
- ce qu’est un terme ;
- si les noms propres et les mots isolés comptent ;
- si un terme court à l’intérieur d’un terme plus long compte ;
- sous quelle forme renvoyer chaque candidat.
Chaque décision sur laquelle les personnes ne s’accordent pas devient une décision écrite dans la requête, si bien que deux personnes qui formulent leur requête différemment peuvent obtenir des listes différentes du même modèle.
Dans une étude de recherche, la requête devrait ressembler aux consignes d’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. qu’ont suivies les personnes qui ont établi l’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , de sorte que le modèle et les annotateurs travaillent à partir des mêmes instructions.
Les deux captures d’écran ci-dessous montrent la différence sur un texte anglais sur le dressage. Avec une demande nue (Figure 25figure 25), l’agent conversationnel renvoie les termes que le texte définit, chacun avec une définition. Avec une requête rédigée comme des consignes (Figure 26figure 26), la réponse est une simple liste, sous la forme demandée par la requête.
Les résultats des GML
Les premières études, avec GPT-3.5 et Llama 2, ont constaté qu’une requête adressée à un GML approchait les outils entraînés sur des exemples annotés (Banerjee et al., 2024 ; Tran et al., 2024). Avec les modèles disponibles en 2025, l’écart s’est comblé : sur les douze corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. du jeu de données ACTER, quatre GML étaient compétitifs face aux outils entraînés pour la tâche, et dans la zone de l’accord entre annotateurs (Rigouts Terryn, 2026) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).GPT-5 et GPT-5-mini (versions du 7 août 2025), Mistral Large (2411) et Magistral Medium (2507). Trois constats de cette étude :
- Les textes ont changé les résultats plus que le modèle. Le domaine et la langue d’un texte ont compté davantage que le choix parmi les quatre modèles.
- Une requête détaillée a aidé plus que des exemples dans la requête.
- Les modèles en ont proposé trop plutôt que trop peu, par exemple des mots généraux, plusieurs termes joints par et, et des expressions descriptives.
Les candidats qui ne figurent pas dans le texte
Un outil à base de règles, ou entraîné à marquer des mots, ne peut renvoyer que des mots qui figurent dans le texte. Un GML rédige sa réponse, si bien qu’un candidat peut différer du texte. Dans la même étude, environ 2 % des candidats ne figuraient pas tels quels dans le texte, ce qui est souvent compté comme une fabulation hallucinationfabulation de l'IA language modelsmodèles de langue Content generated by an AI model that is factually incorrect or fabricated, even though it may sound plausible.Contenu généré par un modèle d'IA qui est factuellement inexact ou fabriqué, même s'il peut sembler plausible. . La plupart étaient des formes retouchées de termes présents dans le texte, par exemple un terme abrégé donné en entier ou une ponctuation supprimée, et les vraies inventions étaient rares (Rigouts Terryn, 2026). Chaque candidat doit tout de même être vérifié dans le texte.
Sources
- Banerjee, S., Chakravarthi, B. R., & McCrae, J. P. (2024). Large Language Models for Few-Shot Automatic Term Extraction. In Natural Language Processing and Information Systems (NLDB 2024), Lecture Notes in Computer Science (pp. 137–150). Springer. https://doi.org/10.1007/978-3-031-70239-6_10
- Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
- Tran, H. T. H., González-Gallardo, C.-E., Delaunay, J., Doucet, A., & Pollak, S. (2024). Is Prompting What Term Extraction Needs?. In Text, Speech, and Dialogue (TSD 2024), Lecture Notes in Computer Science (pp. 17–29). Springer. https://doi.org/10.1007/978-3-031-70563-2_2