BaselinesLes étalons
TRA2600 To read for S9À lire pour la S9
TRA6008 S5 · in classS5 · en classe
A score compared with a simple method
A score does not say, on its own, whether a system is good. If you are told that a spam filter is right for 90 messages out of 100, you still need to know what a very simple method would score on the same messages. If 90 of the 100 messages are not spam, a filter that lets every message through is also right 90 times out of 100, and it has not stopped any spam (Figure 8figure 8).
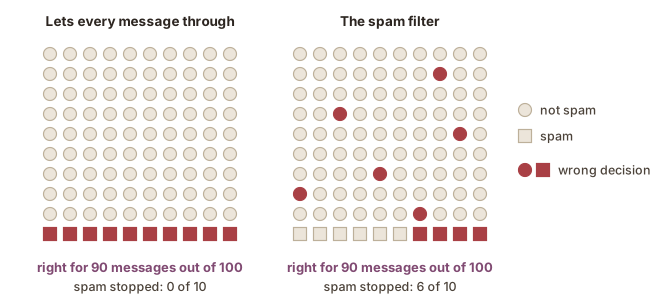
The score of such a simple method is called a baseline.
A baseline is evaluated exactly like the system, on the same evaluation data and, where there is one, against the same gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. and with the same measure, so that the two scores can be compared (see also the Interpreting a score page) (voir aussi la page Interpréter un score). A system that does not score clearly above its baseline has not shown that it does the task.
Baselines for classification
For a task where a system sorts items into classes (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), the table below gives three simple baselines.
| Baseline | What it does | What it scores |
|---|---|---|
| Random guess | chooses a class at random for each item | with two classes, right about half the time |
| Majority class | always answers the most frequent class | right as often as that class occurs: 90 % when nine items in ten belong to it |
| Most frequent answer for each item | gives each item the answer it had most often in a set of labelled examples; only possible where the same items come back, as words do | depends on the task, and can be high: about 92 % of the words for part-of-speech tagging of English, the example below |
A baseline can also be an existing tool: a new system is then expected to do better than the one it replaces.The third baseline is not always possible: it needs labelled examples, and the items of the test have to come back from those examples, as words do in running text. Jurafsky and Martin (2026) give it for part-of-speech tagging. No two emails are identical, so a spam filter has no such baseline.
In the examples above, the baselines were measured with accuracy accuracyexactitude evaluationévaluation The share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. , the share of items that receive the right answer. When the class to find is rare, as spam is, another measure such as the F1 score F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. is less likely to give a naive baseline a high score (see also the Precision, recall and F1 page) (voir aussi la page Précision, rappel et score F1).
Baseline and human performance
A score is interpreted between two points of comparison: the baseline, and the level people reach on the same task (see also the Agreement between annotators page) (voir aussi la page L'accord entre annotateurs).
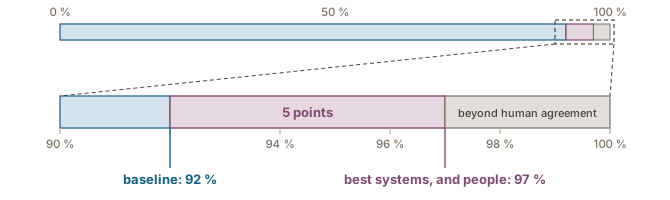
In part-of-speech tagging part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. , each word of a text is labelled as a noun, a verb, an adjective and so on. For English, Jurafsky and Martin (2026) report that a baseline which gives each word its most frequent label is right for about 92 % of the words, and that the best systems reach about 97 %, which is also about the level people reach (Figure 9figure 9). The systems therefore differ from the baseline by five points, and a score of 93 % for English is close to the baseline. The figures are for English only: for another language, both points of comparison have to be measured again.
Un score comparé à une méthode simple
Un score ne dit pas, à lui seul, si un système est bon. Si l’on vous dit qu’un filtre antipourriel a raison pour 90 messages sur 100, il vous reste à savoir quel score une méthode très simple obtiendrait sur les mêmes messages. Si 90 des 100 messages ne sont pas des pourriels, un filtre qui laisse passer tous les messages a lui aussi raison 90 fois sur 100, et il n’a arrêté aucun pourriel (Figure 8figure 8).
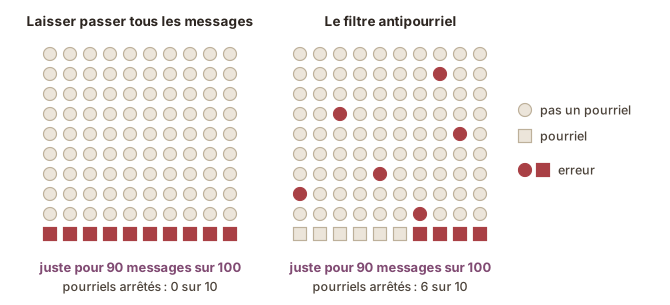
Le score d’une telle méthode simple s’appelle un étalon.
Un étalon est évalué exactement comme le système, sur les mêmes données d’évaluation et, lorsqu’il y en a un, par rapport au même étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. et avec la même mesure, afin que les deux scores puissent être comparés (see also the Interpreting a score page) (voir aussi la page Interpréter un score). Un système qui n’obtient pas un score nettement supérieur à son étalon n’a pas montré qu’il accomplit la tâche.
Les étalons pour la classification
Pour une tâche où un système répartit des éléments en classes (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), le tableau ci-dessous présente trois étalons simples.
| Étalon | Ce qu’il fait | Ce qu’il obtient |
|---|---|---|
| Réponse au hasard | choisit une classe au hasard pour chaque élément | avec deux classes, a raison environ une fois sur deux |
| Classe majoritaire | répond toujours la classe la plus fréquente | a raison aussi souvent que cette classe apparaît : 90 % lorsque neuf éléments sur dix lui appartiennent |
| Réponse la plus fréquente pour chaque élément | donne à chaque élément la réponse qu’il a reçue le plus souvent dans un ensemble d’exemples étiquetés ; possible seulement lorsque les mêmes éléments reviennent, comme le font les mots | dépend de la tâche, et peut être élevé : environ 92 % des mots pour l’étiquetage morphosyntaxique de l’anglais, l’exemple ci-dessous |
Un étalon peut aussi être un outil existant : on attend alors d’un nouveau système qu’il fasse mieux que celui qu’il remplace.Le troisième étalon n’est pas toujours possible : il lui faut des exemples étiquetés, et les éléments du test doivent revenir dans ces exemples, comme le font les mots dans un texte suivi. Jurafsky et Martin (2026) le donnent pour l’étiquetage morphosyntaxique. Il n’y a pas deux courriels identiques, de sorte qu’un filtre antipourriel n’a pas d’étalon de ce type.
Dans les exemples ci-dessus, les étalons ont été mesurés avec l’exactitude accuracyexactitude evaluationévaluation The share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. , la proportion d’éléments qui reçoivent la bonne réponse. Quand la classe à trouver est rare, comme les pourriels, une autre mesure, par exemple le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. , risque moins de donner un score élevé à un étalon naïf (see also the Precision, recall and F1 page) (voir aussi la page Précision, rappel et score F1).
L’étalon et la performance humaine
Un score s’interprète entre deux points de comparaison : l’étalon, et le niveau que des personnes atteignent pour la même tâche (see also the Agreement between annotators page) (voir aussi la page L'accord entre annotateurs).
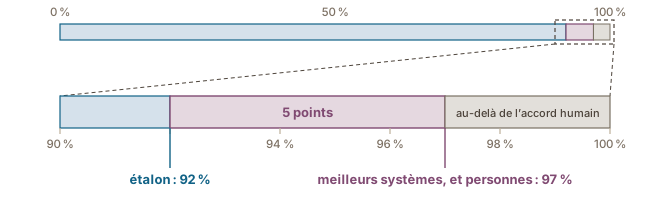
En étiquetage morphosyntaxique part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. , chaque mot d’un texte reçoit une étiquette : nom, verbe, adjectif, etc. Pour l’anglais, Jurafsky et Martin (2026) rapportent qu’un étalon qui donne à chaque mot son étiquette la plus fréquente a raison pour environ 92 % des mots, et que les meilleurs systèmes atteignent environ 97 %, ce qui est aussi à peu près le niveau que des personnes atteignent (Figure 9figure 9). Les systèmes diffèrent donc de l’étalon de cinq points, et un score de 93 % pour l’anglais est proche de l’étalon. Ces chiffres ne valent que pour l’anglais : pour une autre langue, les deux points de comparaison doivent être mesurés de nouveau.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/