Statistical methods: termhood and unithoodMéthodes statistiques : degré de termitude et degré de figement
TRA2600 S8 · in classS8 · en classe
TRA6008 OptionalFacultatif
Termhood and unithood
When thinking of automating a task, the first thing we can trust a computer with is counting. So how can we define terms through counting? The two concepts that statistical methods for term extraction automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. try to capture are termhood and unithood (Kageura & Umino, 1996).
The table below sets out the question each concept answers, what is counted to measure it, and the assumption behind the count.
| Question | What is counted | Assumption | |
|---|---|---|---|
| Termhood | Is the unit tied to the domain? Piaffe belongs to dressage, yesterday does not. | How often a candidate occurs in a corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. of texts about the domain, often set against a general reference corpus | A term occurs relatively more often in the texts of its domain than in general text |
| Unithood | Do the words of a unit of several words form one unit? Flying change does; the horse changes does not, although its words often appear together. | How often the words of a candidate occur together, and how often each occurs on its own | The words of a term occur together more often than unrelated words do |
Termhood: comparing two corpora
A specialized corpus and a general one, such as a large collection of newspaper articles (Drouin, 2003), are never the same size, so the counts themselves cannot be compared. The comparison uses relative frequencies: the number of occurrences divided by the size of the corpus, often given per million words (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus). The table below gives six words, with illustrative figures.
| Word | Dressage corpus (200,000 words) | Per million | General corpus (100 million words) | Per million | How many times more frequent in dressage |
|---|---|---|---|---|---|
| the | 12,105 | 60,525 | 6,031,000 | 60,310 | 1.0 |
| next | 153 | 765 | 70,400 | 704 | 1.1 |
| horse | 1,874 | 9,370 | 25,300 | 253 | 37 |
| canter | 468 | 2,340 | 1,240 | 12.4 | 189 |
| piaffe | 31 | 155 | 12 | 0.12 | 1,292 |
| collection | 63 | 315 | 19,800 | 198 | 1.6 |
Figure 9figure 9 draws four of those words. Counted in occurrences, every word is more frequent in the general corpus, because that corpus is 500 times larger. Counted per million words, the six words of the table fall into four cases:
- the and next are about as frequent in both corpora, so nothing ties them to dressage;
- horse is far more frequent in the dressage corpus, but it is also a common word elsewhere;
- canter and piaffe hardly occur outside texts about riding;
- collection is a dressage term, but it is only 1.6 times more frequent in the dressage corpus, because it is also an everyday word.
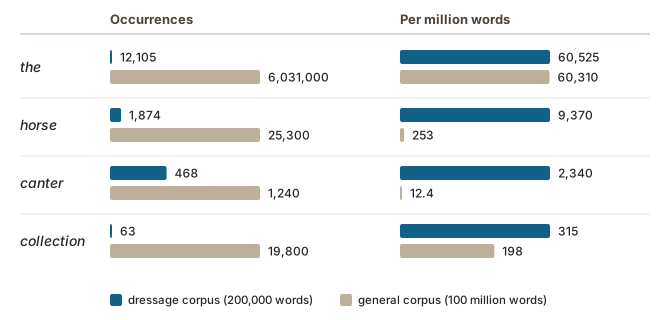
Corpus tools offer the same comparison under another name: Sketch Engine’s Keywords function lists the words that are far more frequent in your corpus than in a reference corpus of general language (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
A worked example: the log-likelihood ratio
Relative frequencies leave one question open: a word can be more frequent in a small corpus by chance, especially when it occurs only a few times. Statistical measures of termhood therefore take into account how much evidence there is, as well as how large the difference is.
The log-likelihood ratio serves here as a worked example. It is a common measure (Lefever & Rigouts Terryn, 2024), but one among many. The goal is to understand the principle; the exact formula and the mathematical details are not needed for that.
For each word, e.g., canter, the calculation goes through four steps, with the figures of the frequency table above:
- Counts. Canter occurs 468 times in the dressage corpus of 200,000 words, and 1,240 times in the general corpus of 100 million words.
- Relative frequencies. 468 divided by 200,000 is 2,340 occurrences per million words in the dressage corpus; 1,240 divided by 100 million is 12.4 per million in the general corpus. Canter is about 190 times more frequent in the dressage corpus.
- Expected counts. The two corpora together contain 1,708 occurrences of canter, and the dressage corpus is about 0.2% of all the text. If canter were equally frequent everywhere, about 3 of the 1,708 occurrences would be in the dressage corpus (0.2% of 1,708). There are 468.
- Score. The log-likelihood ratio compares the counts that were observed with the counts that were expected, 468 against about 3, and gives canter a score of 3,818. A word whose counts are exactly as expected scores zero. The further the counts are from the expected ones, and the more occurrences there are to support the difference, the higher the score.
Figure 10figure 10 gives, for the six words of the frequency table, how many times more frequent each word is in the dressage corpus, how often it occurs there, and its log-likelihood ratio.
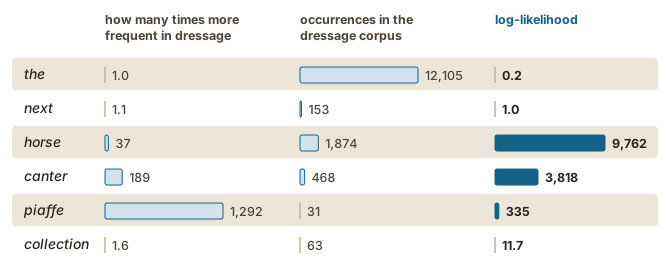
Three things can be read from the figure:
- The has by far the most occurrences and a score close to zero. Frequency alone says nothing about how specific a word is.
- Piaffe is about 1,300 times more frequent in the dressage corpus, the largest difference of the six, but it scores far below horse, which is only 37 times more frequent. Thirty-one occurrences are less evidence than 1,874.
- A high score needs both: a clear difference and enough occurrences to support it.
- Collection scores 11.7, far below piaffe, which has half as many occurrences. It is a dressage term, the way a horse shifts its weight towards its hindquarters, and also an everyday word, as in an art collection (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes). A program counts written forms and cannot tell the two senses apart, so the everyday uses in the general corpus pull the score down.
When a difference counts
A less clear case shows why the score is needed. The table below gives two words that are both one and a half times more frequent in the dressage corpus than in the general one, with illustrative figures.
| Word | Occurrences in the dressage corpus | Per million | Per million in the general corpus | How many times more frequent in dressage | Log-likelihood ratio |
|---|---|---|---|---|---|
| weather | 7 | 35 | 23 | 1.5 | 1.1 |
| leg | 312 | 1,560 | 1,026 | 1.5 | 47.8 |
The difference in relative frequency is the same for both words, but seven occurrences are too few to rely on: one or two more or fewer would change the picture. Three hundred and twelve occurrences are enough.
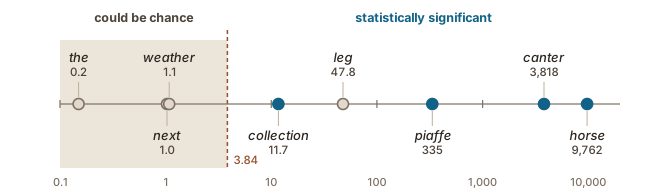
By the usual convention, a score above 3.84 means that a difference of that size would come about by chance less than 5 times in 100, and the difference is then called statistically significant.The thresholds are given with the log-likelihood calculator of the UCREL centre at Lancaster University: 3.84 for 5 chances in 100 and 6.63 for 1 in 100 (read 1 October 2026). Figure 11figure 11 places the eight words of the two tables on either side of that threshold.
The scores in a term extractor
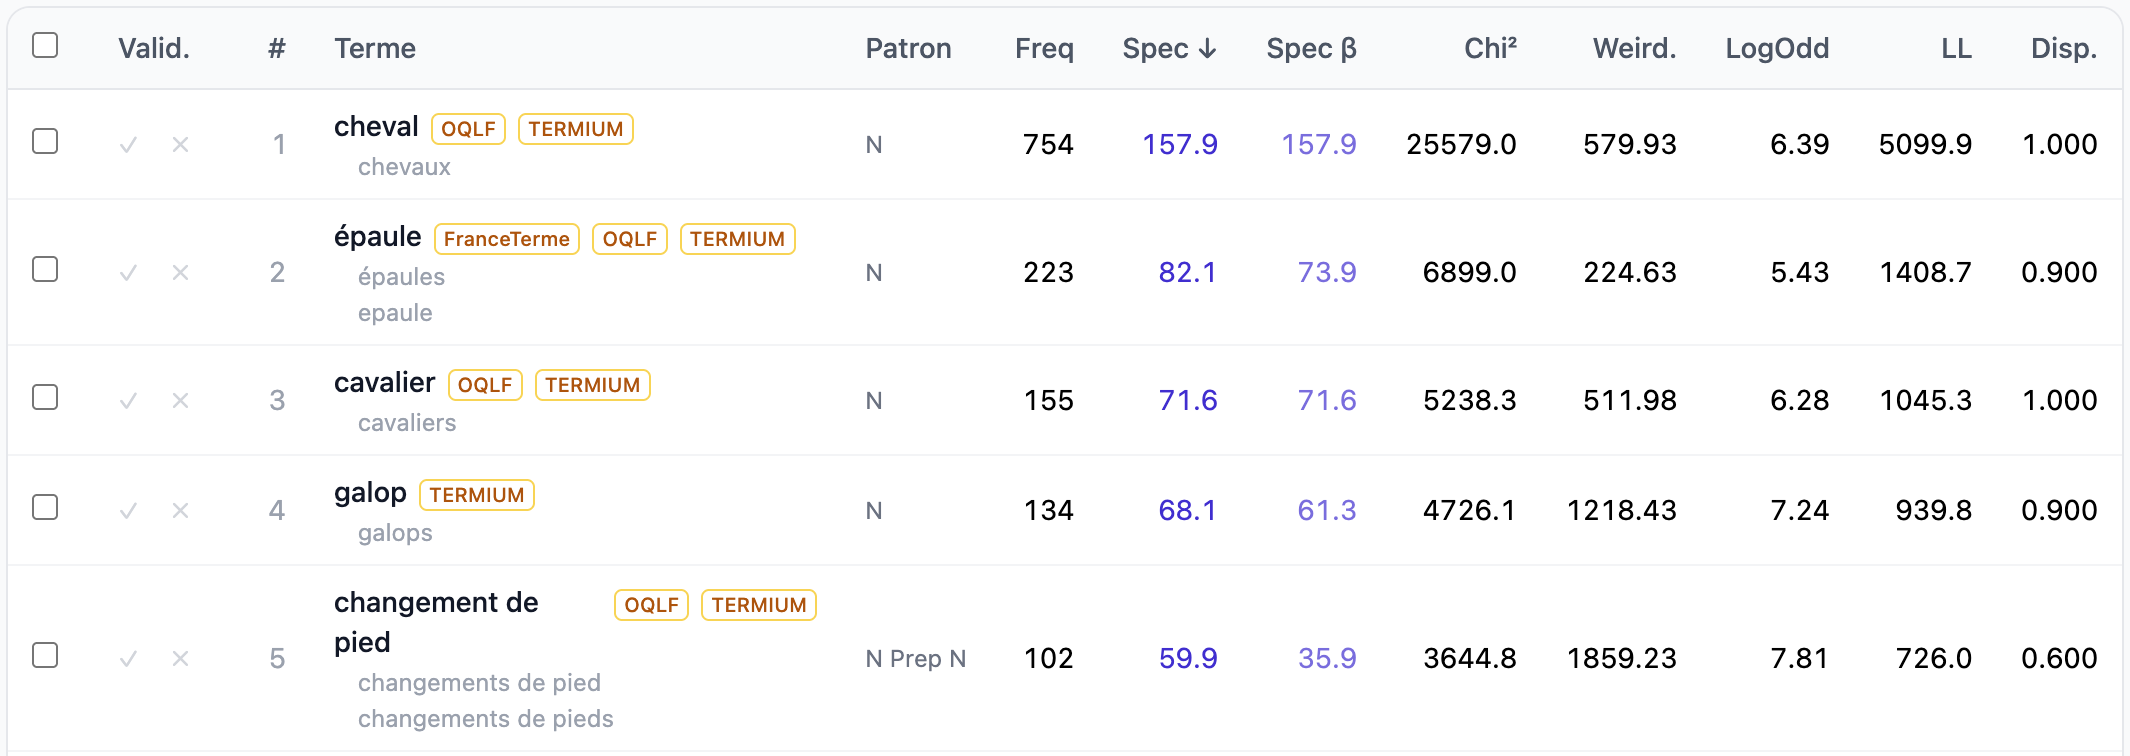
A term extractor reports these numbers for each candidate. In TermoStat’s list of results (Figure 12figure 12), each row gives the frequency of the candidate in the corpus (Freq) and several scores computed against a reference corpus, the log-likelihood ratio (LL) among them (see also the TermoStat: a hybrid extractor page) (voir aussi la page TermoStat : un extracteur hybride).
Unithood: words that occur together
Flying and change are both ordinary words, but in dressage texts they occur side by side far more often than chance would put them together. Good and horse also occur together often, but mostly because both are frequent. Measures of unithood compare how often the words of a candidate occur together with how often each occurs on its own (Lefever & Rigouts Terryn, 2024).
Unithood alone does not identify terms. It measures how firmly words stick together, which is also true of fixed expressions that are not terms, such as in the end or on the other hand (Kageura & Umino, 1996). Measures designed for terms of several words, such as the C-value (Frantzi et al., 2000), exist for that reason, and it is also why the statistical measures are usually combined with the linguistic patterns (see also the Hybrid term extraction page) (voir aussi la page L'extraction hybride de termes).
Strengths and limits of statistical methods
The table below sums up what statistical methods do well, what they need, and the two ways in which they fail: candidates that are not terms (noise noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. ) and terms that are missed (silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. ) (see also the False positives and false negatives page, in the Evaluating language technology module) (voir aussi la page Faux positifs et faux négatifs, dans le module L'évaluation des technologies langagières).
| In practice | |
|---|---|
| Strength | They need no knowledge of the language: the same counts work for English, French or Dutch, provided a general corpus exists in that language. |
| Requirement | They need enough text: a few pages give too few occurrences for the measure to separate the terms from the rest. |
| Silence | A word that occurs once or twice scores low, however specialized it is, so rare terms are easily missed (Rigouts Terryn et al., 2019). A term that is also an everyday word, such as collection, scores low too, because it is frequent in general text as well. |
| Noise | A high score does not make a term: a word can be frequent in these texts for another reason, such as the name of a rider, and a fragment of a longer term scores as readily as the whole term. |
Le degré de termitude et le degré de figement
Quand on songe à automatiser une tâche, compter est la première chose qu’on peut confier à un ordinateur. Comment définir des termes en comptant ? Les deux notions que les méthodes statistiques d’extraction de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. cherchent à saisir sont le degré de termitude et le degré de figement (Kageura et Umino, 1996).
Le tableau ci-dessous présente la question à laquelle répond chaque notion, ce qu’on compte pour la mesurer, et l’hypothèse derrière ce compte.
| Question | Ce qu’on compte | Hypothèse | |
|---|---|---|---|
| Degré de termitude | L’unité est-elle liée au domaine ? Piaffer appartient au dressage, hier non. | Le nombre d’occurrences d’un candidat dans un corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. de textes du domaine, souvent comparé à un corpus de référence général | Un terme apparaît relativement plus souvent dans les textes de son domaine que dans les textes généraux |
| Degré de figement | Les mots d’une unité de plusieurs mots forment-ils une seule unité ? Oui pour changement de pied ; non pour le cheval change, même si ces mots apparaissent souvent ensemble. | Le nombre de fois où les mots d’un candidat apparaissent ensemble, et le nombre de fois où chacun apparaît seul | Les mots d’un terme apparaissent ensemble plus souvent que des mots sans lien |
Le degré de termitude : comparer deux corpus
Un corpus spécialisé et un corpus général, par exemple un grand ensemble d’articles de journaux (Drouin, 2003), n’ont jamais la même taille, si bien que les nombres d’occurrences ne peuvent pas être comparés tels quels. La comparaison se fait avec des fréquences relatives : le nombre d’occurrences divisé par la taille du corpus, souvent exprimé par million de mots (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus). Le tableau ci-dessous donne six mots, avec des chiffres fournis à titre d’illustration.
| Mot | Corpus de dressage (200 000 mots) | Par million | Corpus général (100 millions de mots) | Par million | Combien de fois plus fréquent en dressage |
|---|---|---|---|---|---|
| le | 12 105 | 60 525 | 6 031 000 | 60 310 | 1,0 |
| prochain | 153 | 765 | 70 400 | 704 | 1,1 |
| cheval | 1 874 | 9 370 | 25 300 | 253 | 37 |
| galop | 468 | 2 340 | 1 240 | 12,4 | 189 |
| piaffer | 31 | 155 | 12 | 0,12 | 1 292 |
| passage | 63 | 315 | 19 800 | 198 | 1,6 |
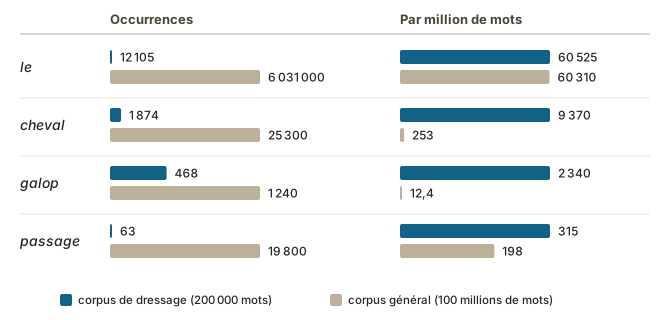
La Figure 9figure 9 représente quatre de ces mots. En nombre d’occurrences, chaque mot est plus fréquent dans le corpus général, parce que ce corpus est 500 fois plus grand. Par million de mots, les six mots du tableau se répartissent en quatre cas :
- le et prochain sont à peu près aussi fréquents dans les deux corpus, si bien que rien ne les rattache au dressage ;
- cheval est beaucoup plus fréquent dans le corpus de dressage, mais c’est aussi un mot courant ailleurs ;
- galop et piaffer n’apparaissent presque pas en dehors des textes sur l’équitation ;
- passage est un terme du dressage, mais il n’est que 1,6 fois plus fréquent dans le corpus de dressage, parce que c’est aussi un mot courant.
Les outils d’analyse de corpus proposent la même comparaison sous un autre nom : la fonction Keywords de Sketch Engine dresse la liste des mots beaucoup plus fréquents dans votre corpus que dans un corpus de référence de langue générale (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Un exemple détaillé : le rapport de vraisemblance
Les fréquences relatives laissent une question ouverte : un mot peut être plus fréquent dans un petit corpus par hasard, surtout s’il n’y apparaît que quelques fois. Les mesures statistiques du degré de termitude tiennent donc compte de la quantité d’indices disponibles, en plus de l’ampleur de la différence.
Le rapport de vraisemblance (angl. log-likelihood ratio) sert ici d’exemple détaillé. C’est une mesure courante (Lefever et Rigouts Terryn, 2024), mais une parmi beaucoup d’autres. Le but est d’en comprendre le principe ; la formule exacte et les détails mathématiques ne sont pas nécessaires pour cela.
Pour chaque mot, par exemple galop, le calcul passe par quatre étapes, avec les chiffres du tableau de fréquences ci-dessus :
- Les occurrences. Galop apparaît 468 fois dans le corpus de dressage de 200 000 mots, et 1 240 fois dans le corpus général de 100 millions de mots.
- Les fréquences relatives. 468 divisé par 200 000 donne 2 340 occurrences par million de mots dans le corpus de dressage ; 1 240 divisé par 100 millions donne 12,4 par million dans le corpus général. Galop est environ 190 fois plus fréquent dans le corpus de dressage.
- Les occurrences attendues. Les deux corpus contiennent ensemble 1 708 occurrences de galop, et le corpus de dressage représente environ 0,2 % de tout le texte. Si galop était aussi fréquent partout, environ 3 des 1 708 occurrences se trouveraient dans le corpus de dressage (0,2 % de 1 708). Il y en a 468.
- Le score. Le rapport de vraisemblance compare les occurrences observées aux occurrences attendues, 468 contre 3 environ, et donne à galop un score de 3 818. Un mot dont les occurrences correspondent exactement à ce qui est attendu obtient zéro. Plus les occurrences s’éloignent de ce qui est attendu, et plus elles sont nombreuses à appuyer cette différence, plus le score est élevé.
La Figure 10figure 10 donne, pour les six mots du tableau de fréquences, combien de fois chaque mot est plus fréquent dans le corpus de dressage, combien de fois il y apparaît, et son rapport de vraisemblance.
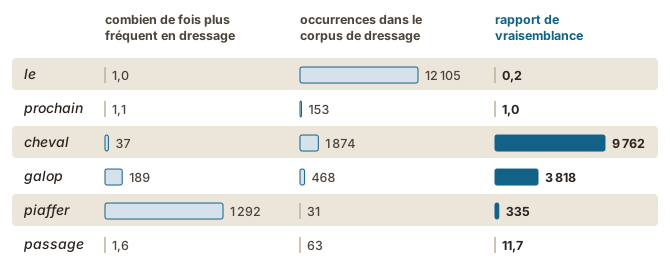
La figure permet de lire trois choses :
- Le a de loin le plus d’occurrences et un score proche de zéro. La fréquence seule ne dit rien de la spécificité d’un mot.
- Piaffer est environ 1 300 fois plus fréquent dans le corpus de dressage, la plus grande différence des six, mais son score est bien inférieur à celui de cheval, qui n’est que 37 fois plus fréquent. Trente et une occurrences sont un indice plus faible que 1 874.
- Un score élevé demande les deux : une différence nette et assez d’occurrences pour l’appuyer.
- Passage obtient 11,7, bien en dessous de piaffer, qui a deux fois moins d’occurrences. C’est un terme du dressage, un trot très rassemblé et relevé, et aussi un mot courant, comme dans un passage pour piétons (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes). Un programme compte des formes écrites et ne peut pas distinguer les deux sens, si bien que les emplois courants du corpus général font baisser le score.
À partir de quand une différence compte
Un cas moins net montre pourquoi le score est nécessaire. Le tableau ci-dessous donne deux mots qui sont tous deux une fois et demie plus fréquents dans le corpus de dressage que dans le corpus général, avec des chiffres fournis à titre d’illustration.
| Mot | Occurrences dans le corpus de dressage | Par million | Par million dans le corpus général | Combien de fois plus fréquent en dressage | Rapport de vraisemblance |
|---|---|---|---|---|---|
| météo | 7 | 35 | 23 | 1,5 | 1,1 |
| jambe | 312 | 1 560 | 1 026 | 1,5 | 47,8 |
La différence de fréquence relative est la même pour les deux mots, mais sept occurrences sont trop peu pour s’y fier : une ou deux de plus ou de moins changeraient le tableau. Trois cent douze occurrences suffisent.
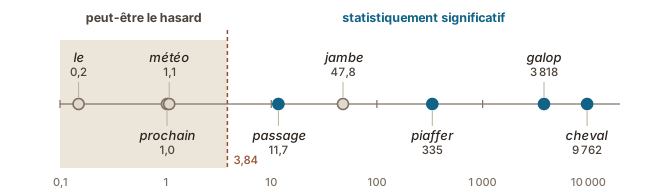
Par convention, un score supérieur à 3,84 signifie qu’une différence de cette ampleur apparaîtrait par hasard moins de 5 fois sur 100, et la différence est alors dite statistiquement significative.Les seuils sont donnés avec le calculateur du rapport de vraisemblance du centre UCREL de l’Université de Lancaster : 3,84 pour 5 chances sur 100 et 6,63 pour 1 sur 100 (consulté le 1er octobre 2026). La Figure 11figure 11 place les huit mots des deux tableaux de part et d’autre de ce seuil.
Les scores dans un extracteur de termes
Un extracteur de termes donne ces chiffres pour chaque candidat. Dans la liste de résultats de TermoStat (Figure 12figure 12), chaque ligne indique la fréquence du candidat dans le corpus (Freq) et plusieurs scores calculés par rapport à un corpus de référence, dont le rapport de vraisemblance (LL) (see also the TermoStat: a hybrid extractor page) (voir aussi la page TermoStat : un extracteur hybride).
Le degré de figement : des mots qui apparaissent ensemble
Changement et pied sont deux mots ordinaires, mais dans les textes sur le dressage ils apparaissent côte à côte bien plus souvent que le hasard ne les ferait se rencontrer. Bon et cheval apparaissent souvent ensemble eux aussi, mais surtout parce que les deux sont fréquents. Les mesures du degré de figement comparent le nombre de fois où les mots d’un candidat apparaissent ensemble au nombre de fois où chacun apparaît seul (Lefever et Rigouts Terryn, 2024).
Le degré de figement ne suffit pas à identifier les termes. Il mesure la solidité du lien entre des mots, et ce lien est tout aussi solide dans des expressions figées qui ne sont pas des termes, comme à la fin ou d’autre part (Kageura et Umino, 1996). Des mesures conçues pour les termes de plusieurs mots, comme la C-value (Frantzi et al., 2000), existent pour cette raison, et c’est aussi pourquoi les mesures statistiques sont le plus souvent combinées aux patrons morphosyntaxiques (see also the Hybrid term extraction page) (voir aussi la page L'extraction hybride de termes).
Les forces et les limites des méthodes statistiques
Le tableau ci-dessous résume ce que les méthodes statistiques font bien, ce qu’il leur faut, et les deux façons dont elles échouent : les candidats qui ne sont pas des termes (le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. ) et les termes manqués (le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. ) (see also the False positives and false negatives page, in the Evaluating language technology module) (voir aussi la page Faux positifs et faux négatifs, dans le module L'évaluation des technologies langagières).
| En pratique | |
|---|---|
| Force | Elles n’ont besoin d’aucune connaissance de la langue : les mêmes comptes valent pour l’anglais, le français ou le néerlandais, à condition qu’un corpus général existe dans cette langue. |
| Condition | Il leur faut assez de texte : quelques pages donnent trop peu d’occurrences pour que la mesure sépare les termes du reste. |
| Silence | Un mot qui apparaît une ou deux fois obtient un score faible, aussi spécialisé soit-il, si bien que les termes rares sont facilement manqués (Rigouts Terryn et al., 2019). Un terme qui est aussi un mot courant, comme passage, obtient lui aussi un score faible, parce qu’il est également fréquent dans les textes généraux. |
| Bruit | Un score élevé ne fait pas un terme : un mot peut être fréquent dans ces textes pour une autre raison, comme le nom d’un cavalier, et un fragment d’un terme plus long obtient un score aussi facilement que le terme entier. |
Sources
- Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
- Frantzi, K., Ananiadou, S., & Mima, H. (2000). Automatic recognition of multi-word terms: the C-value/NC-value method. International Journal on Digital Libraries, 3(2), 115–130. https://doi.org/10.1007/s007999900023
- Kageura, K., & Umino, B. (1996). Methods of automatic term recognition: A review. Terminology, 3(2), 259–289. https://doi.org/10.1075/term.3.2.03kag
- Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
- Rayson, P., & Garside, R. (2000). Comparing Corpora using Frequency Profiling. Proceedings of the Workshop on Comparing Corpora, 38th Annual Meeting of the Association for Computational Linguistics, 1–6. https://aclanthology.org/W00-0901/
- Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117