Human preference rankingsLes classements fondés sur les préférences humaines
Two answers, one vote
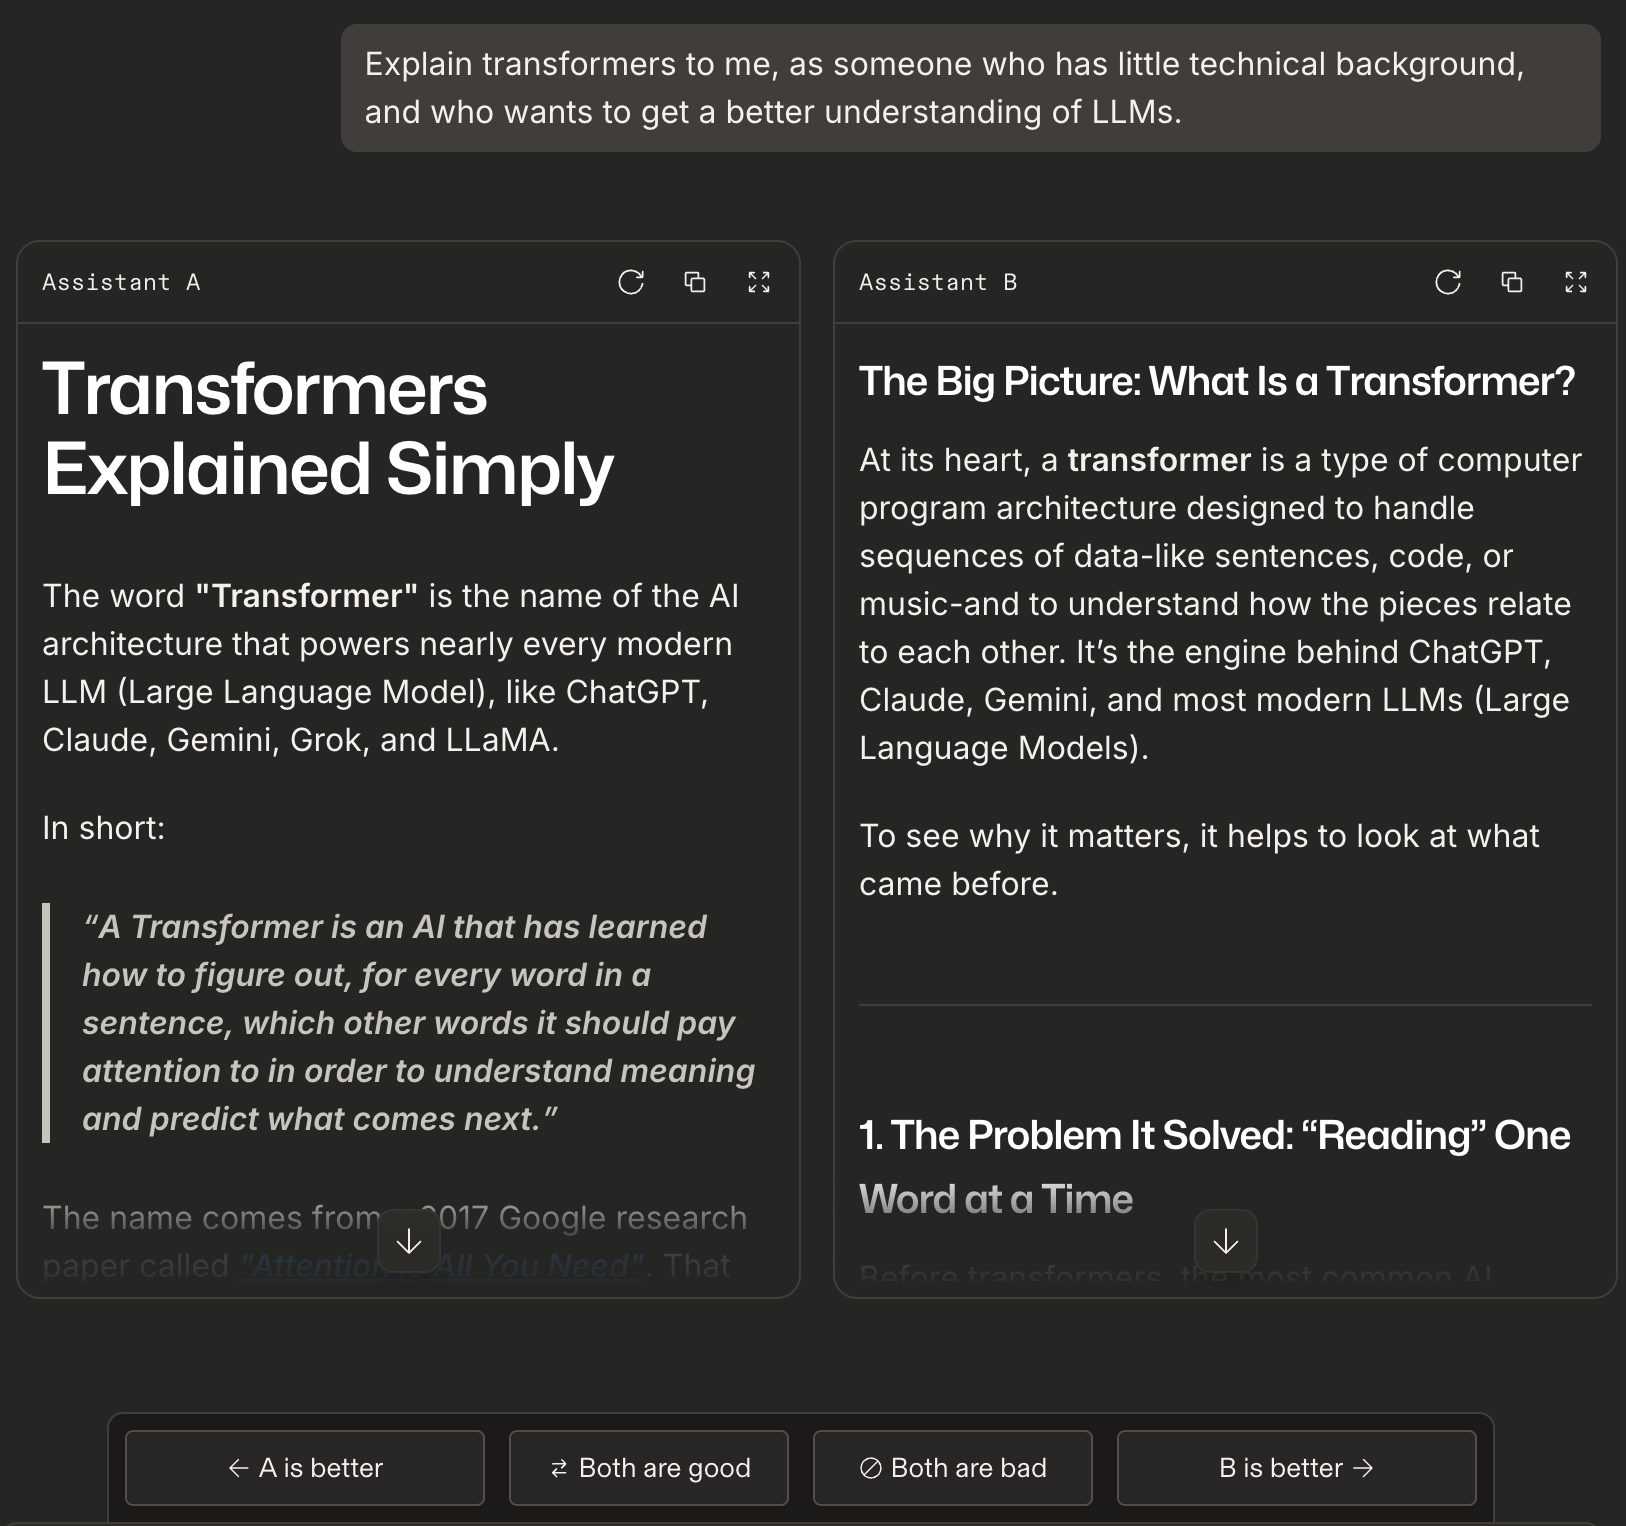
On an arena site, a visitor types a question and two anonymous models answer side by side (Figure 2figure 2). The vote says which answer is better, or that both are good or both are bad, and only then are the two names revealed. Millions of such votes, combined with a statistical model of paired comparisons, give each model a score and the models a ranking (Zheng et al., 2023; Chiang et al., 2024).
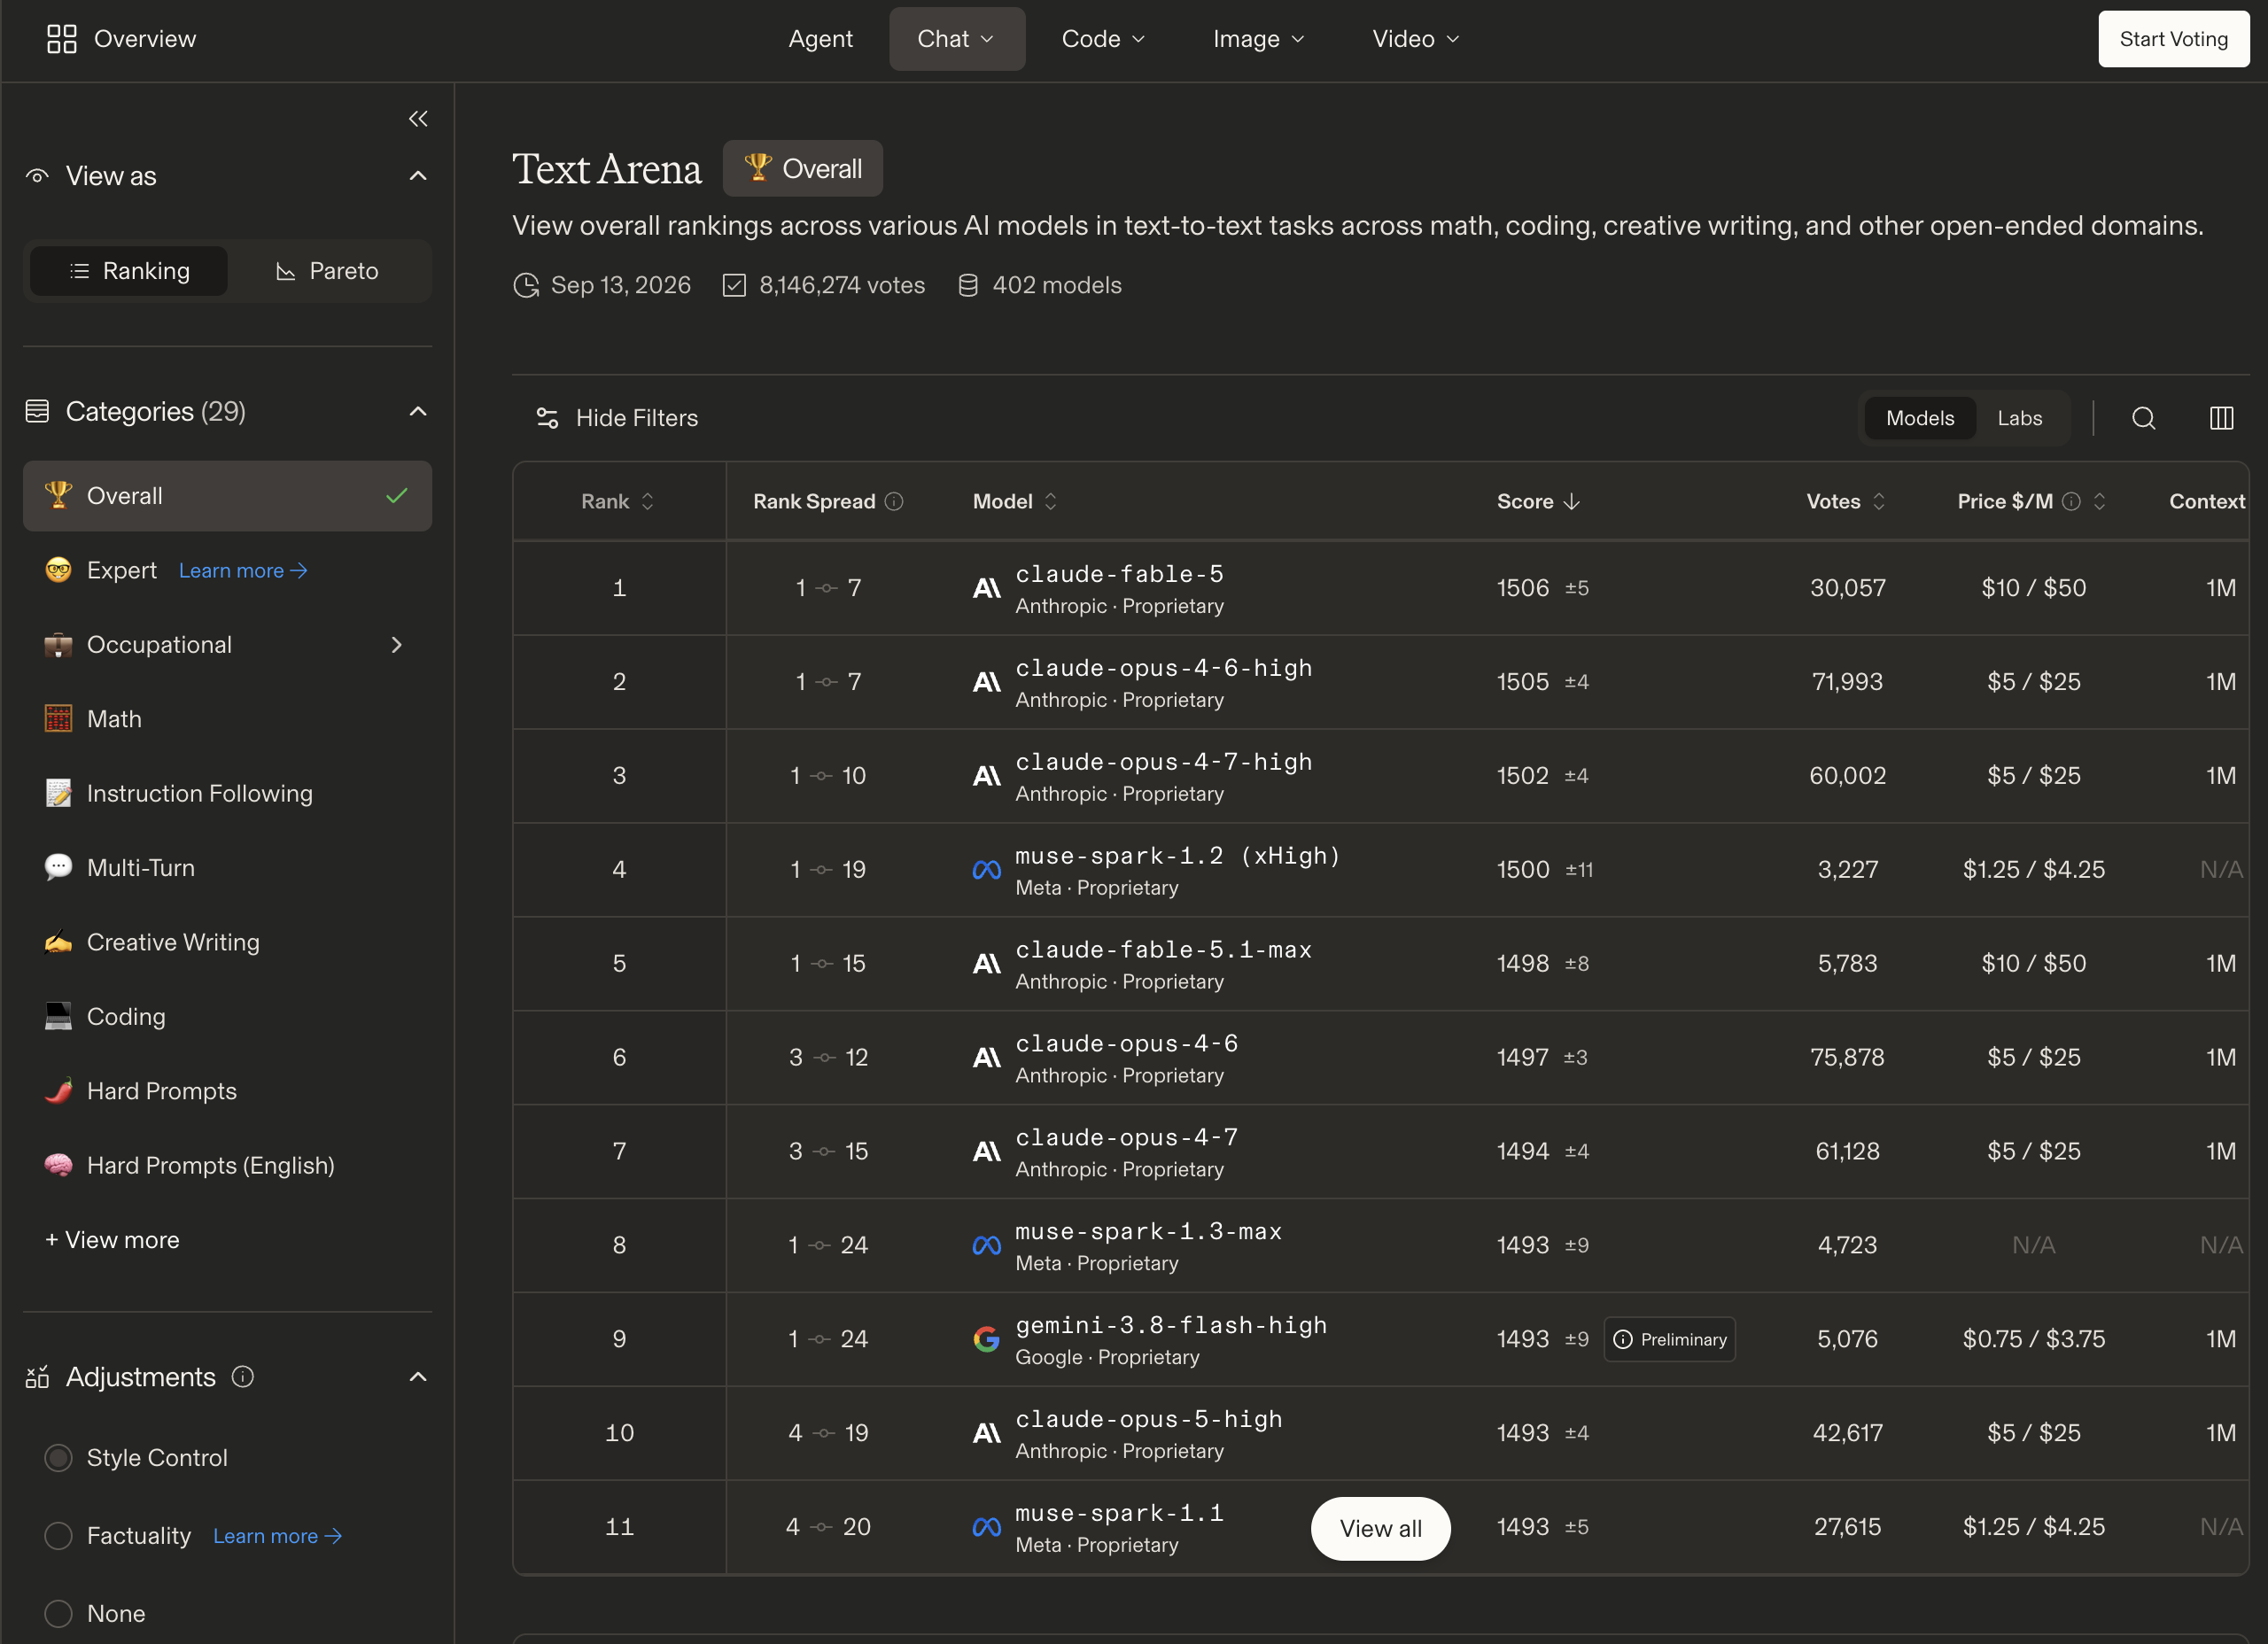
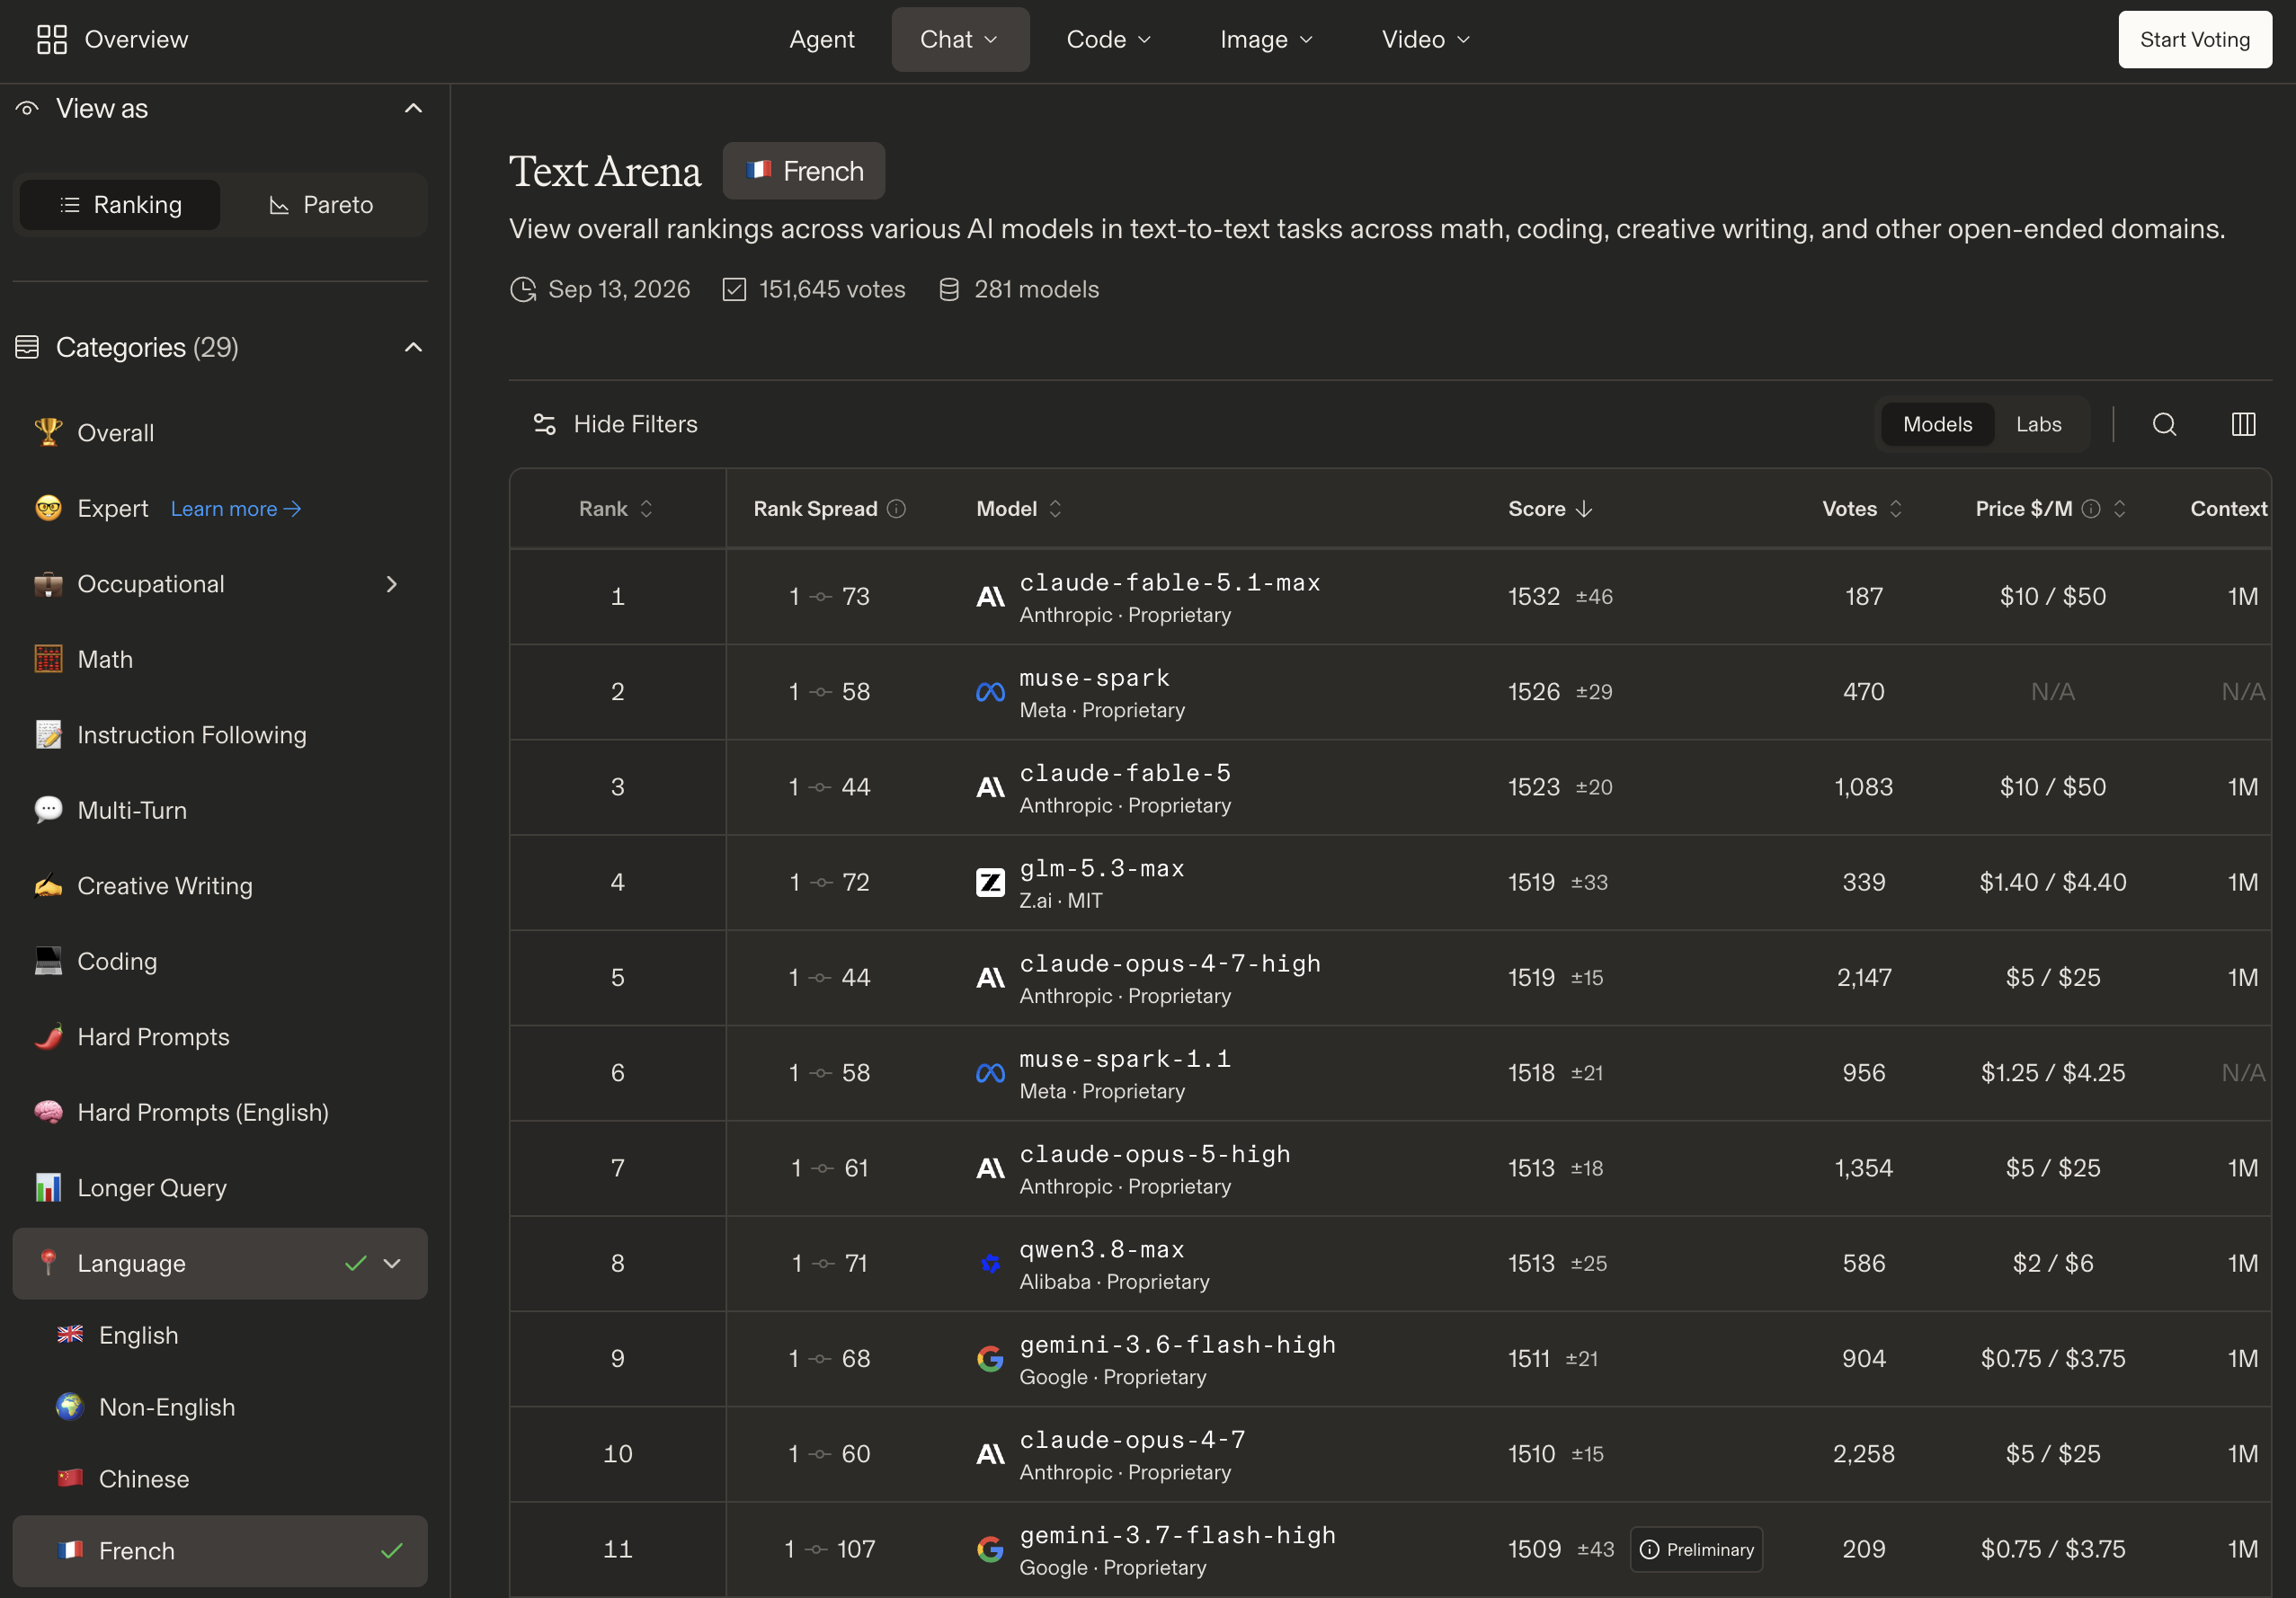
Because the questions are whatever people bring, the ranking reflects the questions people actually ask, which a fixed test cannot, and because the answers are anonymous, a brand cannot be voted for by name. The best-known such site, Chatbot Arena, now called Arena, began as a research project at the University of California, Berkeley, and became a company in 2025. Its text leaderboard listed over four hundred models and eight million votes when read for this page (Figure 3figure 3).arena.ai, formerly lmarena.ai, read 17 September 2026: 402 models, 8,146,274 votes, leaderboard dated 13 September 2026. On the move from academic project to company: Bloomberg, Chatbot Arena group goes from academic project to $600 million startup, 21 May 2025.
What a preference is not
It is not correctness. Checking the facts in an answer takes time, so a vote tends to reward what reads well, and a long answer full of facts can win while containing errors. Arena therefore corrects for this: style control, which discounts length and formatting, is applied by default, and an optional factuality factualityfactualité evaluationévaluation The extent to which the factual claims in generated content are correct according to reliable evidence about the world.Mesure dans laquelle les affirmations factuelles d'un contenu généré sont correctes au regard de preuves fiables sur le monde. adjustment scores how many of an answer’s claims are confirmed when they are checked automatically against the web.Arena, Factuality in the Arena, 14 July 2026, updated 31 July 2026, read 17 September 2026: “a long response with many facts may seem comprehensive and win a human preference vote, but it may also introduce factual errors”; the factuality ranking starts “as a non-default toggle”, and by Arena’s measurement how much people like a model and how factual it is are only weakly related. Style control was selected by default on the leaderboard the same day.
It is not your task. The ranking aggregates everybody’s questions, so a model that wins overall may be weaker on yours.
It is not equal for every model. Singh et al. (2025b) found that one provider had tested 27 private variants of a model on the arena before making one of them public, and that two providers each received about a fifth of the arena’s data while 83 open-weight models open-weight modelmodèle à poids ouverts AIIA An AI model whose trained parameters, commonly called weights, are made available for others to download.Modèle d'IA dont les paramètres entraînés, appelés poids, sont offerts au téléchargement. together received under a third.Measured from January 2024 to April 2025, before the arena became a company. Such an imbalance lets the largest providers tune their models toward the arena itself.
It moves. A release next month reorders the ranking, and the rating of a model that is no longer updated drifts as the others move around it.
Deux réponses, un vote
Sur un site d’arène, une personne tape une question, et deux modèles anonymes y répondent côte à côte (Figure 2figure 2). Le vote indique quelle réponse est la meilleure, ou que les deux sont bonnes ou les deux mauvaises, et ce n’est qu’ensuite que les noms des deux modèles apparaissent. Des millions de votes de ce genre, combinés à un modèle statistique de comparaisons par paires, donnent un score à chaque modèle et un classement de l’ensemble (Zheng et al., 2023 ; Chiang et al., 2024).
Comme les questions sont celles que les gens apportent, le classement reflète les questions que l’on pose réellement, ce qu’un test fixe ne peut pas faire, et comme les réponses sont anonymes, on ne peut pas voter pour une marque. Le site le plus connu de ce genre, Chatbot Arena, aujourd’hui appelé Arena, a commencé comme projet de recherche à l’Université de Californie à Berkeley et est devenu une entreprise en 2025. Son classement de textes comptait plus de quatre cents modèles et huit millions de votes au moment de la consultation pour cette page (Figure 3figure 3).arena.ai, anciennement lmarena.ai, consulté le 17 septembre 2026 : 402 modèles, 8 146 274 votes, classement daté du 13 septembre 2026. Sur le passage du projet universitaire à l’entreprise : Bloomberg, Chatbot Arena group goes from academic project to $600 million startup, 21 mai 2025.
Ce qu’une préférence n’est pas
Ce n’est pas l’exactitude. Vérifier les faits d’une réponse prend du temps : un vote tend donc à récompenser ce qui se lit bien, et une longue réponse pleine de faits peut l’emporter tout en contenant des erreurs. Arena corrige donc ce biais : le contrôle du style, qui neutralise la longueur et la mise en forme, s’applique par défaut, et un ajustement facultatif de factualité factualityfactualité evaluationévaluation The extent to which the factual claims in generated content are correct according to reliable evidence about the world.Mesure dans laquelle les affirmations factuelles d'un contenu généré sont correctes au regard de preuves fiables sur le monde. note la part des affirmations d’une réponse qui tiennent lorsqu’on les vérifie automatiquement sur le Web.Arena, Factuality in the Arena, 14 juillet 2026, mis à jour le 31 juillet 2026, consulté le 17 septembre 2026 : « a long response with many facts may seem comprehensive and win a human preference vote, but it may also introduce factual errors » ; le classement de factualité commence « as a non-default toggle », et selon la mesure d’Arena, le fait qu’un modèle plaise et le fait qu’il soit factuel ne sont que faiblement liés. Le contrôle du style était sélectionné par défaut sur le classement le même jour.
Ce n’est pas votre tâche. Le classement agrège les questions de tout le monde : un modèle qui l’emporte au classement général peut être moins bon sur les vôtres.
Ce n’est pas égal pour tous les modèles. Singh et al. (2025b) ont constaté qu’un fournisseur avait testé 27 variantes privées d’un modèle sur l’arène avant d’en rendre une publique, et que deux fournisseurs avaient reçu chacun environ un cinquième des données de l’arène, alors que 83 modèles à poids ouverts open-weight modelmodèle à poids ouverts AIIA An AI model whose trained parameters, commonly called weights, are made available for others to download.Modèle d'IA dont les paramètres entraînés, appelés poids, sont offerts au téléchargement. en avaient reçu ensemble moins d’un tiers.Mesures de janvier 2024 à avril 2025, avant que l’arène devienne une entreprise. Un tel déséquilibre permet aux plus grands fournisseurs d’ajuster leurs modèles en fonction de l’arène elle-même.
Il évolue sans cesse. Une nouvelle version le mois suivant réordonne le classement, et la note d’un modèle qui n’est plus mis à jour dérive à mesure que les autres se déplacent autour de lui.
Sources
- Chiang, W.-L., Zheng, L., Sheng, Y., Angelopoulos, A. N., Li, T., Li, D., et al. (2024). Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference. Proceedings of the 41st International Conference on Machine Learning (PMLR 235). https://proceedings.mlr.press/v235/chiang24b.html
- Singh, S., Nan, Y., Wang, A., D'Souza, D., Kapoor, S., Üstün, A., et al. (2025b). The Leaderboard Illusion. Advances in Neural Information Processing Systems 38 (NeurIPS 2025), Datasets and Benchmarks Track. https://openreview.net/forum?id=4Ae8edNqm0
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems 36 (NeurIPS 2023), Datasets and Benchmarks Track. https://proceedings.neurips.cc/paper_files/paper/2023/hash/91f18a1287b398d378ef22505bf41832-Abstract-Datasets_and_Benchmarks.html