Tokenizing a text with rulesSegmenter un texte avec des règles
TRA2600S5 · in classS5 · en classe
A task for rules
Cutting a text into words looks like a task made for rules: it is narrow,
and the rules seem easy to state
completely (see also the Rule-based systems page, in the Foundations of AI & NLP module) (voir aussi la page Les systèmes à base de règles, dans le module Fondements de l'IA et du TAL). You do it
without thinking, the first rule is obvious, and nothing about it seems to
need understanding.
Writing the rules, one text at a time
Writing the rules means testing them on one text after another. Each text
below breaks the rules written so far, and the fix is a new rule or a new
exception
(Figure 2figure 2).
Each text appears first as it is written and as the rules so far cut it:
before moving to the next stage, decide where the cut goes wrong and which
rule you would add.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. Seven French texts, each shown as written and as the rules so far cut it, then as the new rules cut it, with the list of rules it takes.
Two of these rules are unlike the others. The fixed expressions such as
aujourd’hui cannot be described by a pattern: someone has to write them
out, and the list is never complete. And unfusing au, du and des is
right for a tool that analyzes grammar, which needs à le, but a tool that
counts words would leave them whole: the right cut depends on what the
output is for.
Seven short texts already need three rules and seven exceptions, and the
list is far from complete. A task that looks simple becomes complex very
quickly.
The list is written for one language and one kind of text. French
numbers use a comma where English numbers use a full stop, and a rule set
for tweets is not a rule set for legal documents.
The list is never finished, because language keeps producing cases
nobody wrote a rule for.
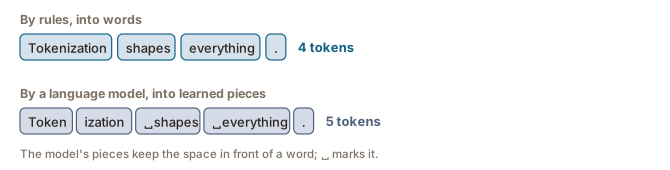
Figure 3. One sentence cut by a rule-based tokenizer, into four words, and by the tokenizer of a language model, into five pieces. The second cut was read off OpenAI's o200k_base vocabulary on 29 August 2026.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Updated 6 October 2026
Une tâche pour des règles
Couper un texte en mots semble une tâche faite pour des règles : elle est
étroite, et les règles paraissent faciles à énoncer
entièrement (see also the Rule-based systems page, in the Foundations of AI & NLP module) (voir aussi la page Les systèmes à base de règles, dans le module Fondements de l'IA et du TAL). Vous la
faites sans y penser, la première règle est évidente, et rien ne semble
demander de comprendre quoi que ce soit.
Écrire les règles, un texte à la fois
Écrire les règles, c’est les tester sur un texte après l’autre. Chaque texte
ci-dessous met en défaut les règles écrites jusque-là, et la correction est
une nouvelle règle ou une nouvelle exception
(Figure 2figure 2).
Chaque texte apparaît d’abord tel qu’il est écrit et tel que les règles déjà
là le coupent : avant de passer à l’étape suivante, repérez où la coupe se
trompe et quelle règle vous ajouteriez.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. Sept textes français, chacun montré tel qu'écrit et tel que le coupent les règles déjà là, puis tel que le coupent les nouvelles règles, avec la liste des règles qu'il faut.
Deux de ces règles ne ressemblent pas aux autres. Les expressions figées
comme aujourd’hui ne se décrivent pas par un motif : quelqu’un doit en
rédiger la liste, et cette liste n’est jamais complète. Et décomposer au,
du et des convient à un outil qui analyse la grammaire, qui a besoin de
à le, mais un outil qui compte les mots les laisserait entiers : la bonne
coupe dépend de l’usage qu’on fera du résultat.
Sept textes courts demandent déjà trois règles et sept exceptions, et la
liste est loin d’être complète. Une tâche qui paraît simple devient
complexe très vite.
La liste est écrite pour une langue et un type de texte. Les nombres
français emploient une virgule là où les nombres anglais emploient un
point, et un ensemble de règles pour des messages de réseaux sociaux ne convient pas à des
documents juridiques.
La liste n’est jamais terminée, parce que la langue produit sans cesse
des cas pour lesquels personne n’a écrit de règle.
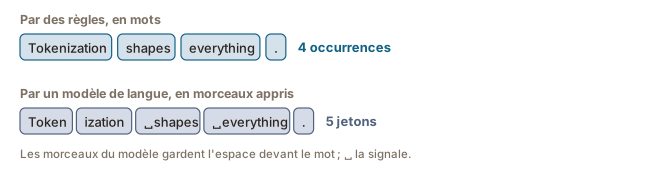
Figure 3. Une phrase anglaise coupée par un segmenteur à base de règles, en quatre mots, et par le segmenteur d'un modèle de langue, en cinq morceaux. La seconde coupe a été relevée dans le vocabulaire o200k_base d'OpenAI le 29 août 2026.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Mise à jour 6 octobre 2026
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/