Model collapseEffondrement du modèle
TRA6008 To read for S3À lire pour la S3
Training data incest
Every corpus described so far was gathered by crawling, and the web has changed: a substantial and growing part of the text on it was produced by a language model. So the corpus for the next model contains the output of the last one, and nothing in the pipeline can reliably tell the two apart.
The effect goes by other names. It circulates as Habsburg AI, after the royal house whose portraits record the effects of inbreeding, for a system trained so heavily on the output of other systems that its features come out exaggerated and distorted; also as AI inbreeding, and as model autophagy disorder.
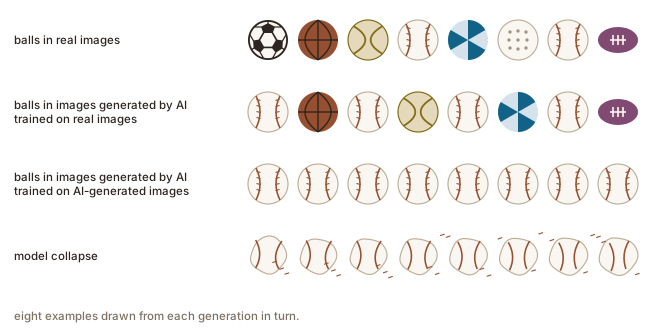
What happens when training on generated output?
Shumailov et al. (2024) trained models on data generated by their predecessors, over several generations, and found a consistent pattern. A model’s output over-represents what was common in its training, so the next model sees a narrower world than the one before it, and after enough repetitions the output degenerates. The first things to go are whatever was least represented to begin with: a regional variant, a specialized term that has a frequent near synonym, a construction that is correct without being the one a model reaches for first.
L’inceste des données d’entraînement
Tous les corpus décrits jusqu’ici ont été réunis par exploration, et le Web a changé : une part substantielle et croissante du texte qui s’y trouve a été produite par un modèle de langue. Le corpus du prochain modèle contient donc la sortie du précédent, et rien dans la chaîne de traitement ne permet de les distinguer de façon fiable.
Le phénomène porte d’autres noms. Il circule sous celui d’IA Habsbourg, du nom de la maison royale dont les portraits gardent la trace des effets de la consanguinité, pour un système entraîné si lourdement sur la sortie d’autres systèmes que ses traits ressortent exagérés et déformés ; on parle aussi de consanguinité de l’IA et de trouble d’autophagie des modèles.
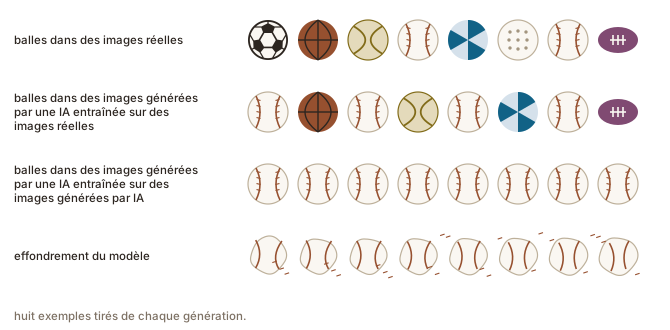
Que se passe-t-il quand on s’entraîne sur du texte généré ?
Shumailov et al. (2024) ont entraîné des modèles sur des données produites par leurs prédécesseurs, sur plusieurs générations, et ont constaté un motif constant. La sortie d’un modèle surreprésente ce qui était fréquent dans son entraînement : le modèle suivant voit donc un monde plus étroit que celui d’avant, et après assez de répétitions la sortie dégénère. Ce qui disparaît en premier, c’est ce qui était le moins représenté au départ : une variante régionale, un terme spécialisé doublé d’un quasi-synonyme fréquent, une construction correcte sans être celle vers laquelle un modèle se tourne d’abord.
Sources
- Gerstgrasser, M., Schaeffer, R., Dey, A., Rafailov, R., Sleight, H., Hughes, J., et al. (2024). Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data. ICML 2024 Workshop on Foundation Models in the Wild (arXiv:2404.01413). https://arxiv.org/abs/2404.01413
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631. https://doi.org/10.1038/s41586-024-07566-y