One-hot vectorsLes vecteurs 1 parmi n
TRA6008 To read for S2À lire pour la S2
The first vector representation of words that the field actually used works like a row of switches with one of them on. Each word in a 100,000-word vocabulary gets its own position, and is represented as a vector of 100,000 numbers: zeros everywhere, except a single 1 at that word’s position.
angelic = [1, 0, 0, 0, ..., 0, 0, 0]
ape     = [0, 1, 0, 0, ..., 0, 0, 0]
apple   = [0, 0, 1, 0, ..., 0, 0, 0]
ardour  = [0, 0, 0, 1, ..., 0, 0, 0]
...
zebra = [0, 0, 0, 0, ..., 0, 0, 1]The false ordering is gone. No word’s vector is larger than another’s; zebra is no longer “more” than ape. In the geometry of the space, each word now owns its own axis, and every pair of words stands at exactly the same distance, like the corners of a perfectly symmetric figure.
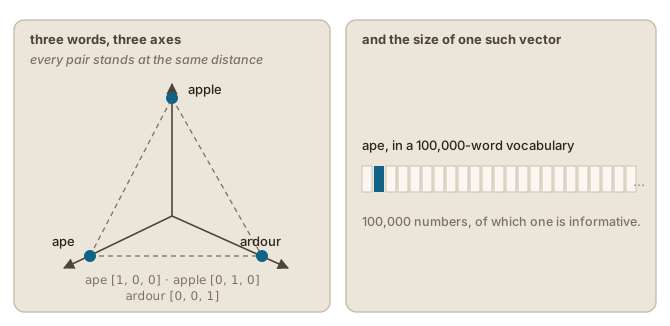
Exactly the same distance is also the new problem. Ardour is now precisely as different from zeal as from zebra: the representation contains no similarity information at all, for anyone. It identifies words the way a locker number identifies a student, saying nothing about them.
There is a practical objection too. These vectors are enormous, and almost all of their content is zeros: 100,000 numbers per word, of which one is informative.
The numbered list crammed every word onto one axis and invented differences; the one-hot vector gives every word its own axis and erases all resemblance.
La première représentation vectorielle des mots que le domaine ait réellement utilisée fonctionne comme une rangée d’interrupteurs dont un seul est allumé. Chaque mot d’un vocabulaire de 100 000 mots reçoit sa propre position et est représenté par un vecteur de 100 000 nombres : des zéros partout, sauf un seul 1 à la position de ce mot.
ananas = [1, 0, 0, 0, ..., 0, 0, 0]
ange   = [0, 1, 0, 0, ..., 0, 0, 0]
animal = [0, 0, 1, 0, ..., 0, 0, 0]
ardeur = [0, 0, 0, 1, ..., 0, 0, 0]
...
zèle = [0, 0, 0, 0, ..., 0, 0, 1]L’ordre trompeur a disparu. Le vecteur d’un mot n’est jamais plus grand que celui d’un autre ; zèbre n’est plus « plus » qu’ananas. Dans la géométrie de l’espace, chaque mot possède désormais son propre axe, et chaque paire de mots se tient exactement à la même distance, comme les sommets d’une figure parfaitement symétrique.
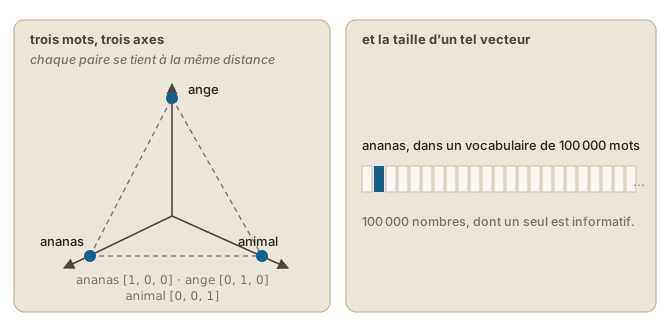
Cette distance identique est aussi le nouveau problème. Ardeur est maintenant exactement aussi différent de zèle que de zèbre : la représentation ne contient aucune information de similarité, pour personne. Elle identifie les mots comme un numéro de casier identifie un étudiant, sans rien dire de lui.
Il y a aussi une objection pratique. Ces vecteurs sont énormes et leur contenu est presque entièrement fait de zéros : 100 000 nombres par mot, dont un seul est informatif.
La liste numérotée entassait tous les mots sur un seul axe et inventait des différences ; le vecteur 1 parmi n donne à chaque mot son propre axe et efface toute ressemblance. Ce qu’il faut se situe entre les deux : des vecteurs comptant un nombre modeste de dimensions, partagées par tous les mots, où les valeurs placent les mots de sens proches près les uns des autres.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/