Statistical translationLa traduction statistique
TRA6008 To read for S7À lire pour la S7
Learning from human translations
The second generation replaced the linguist’s rules with counts. Its raw material is a parallel corpus parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. : a large collection of texts with their translations, aligned sentence by sentence. The first statistical systems, around 1990, were made possible by the Hansard, the proceedings of the Canadian Parliament in English and French (Jurafsky & Martin, 2026). The corpora that followed are still used to train and test systems today.
| Corpus | Source | Size |
|---|---|---|
| Europarl (Koehn, 2005) | proceedings of the European Parliament | 400 000 to 2 million sentences in each of 21 languages |
| United Nations Parallel Corpus (Ziemski et al., 2016) | UN documents | about 10 million sentences in the six official languages |
| OPUS (Tiedemann, 2012) | a collection of corpora: subtitles, web pages that exist in several languages, software documentation | varies by corpus and pair |
A system learns most easily from a parallel corpus whose alignment is good, that is, in which each source sentence or segment is paired with its equivalent in the target language. The alignment can already be there: a translator working in a CAT tool computer-assisted translation (CAT)traduction assistée par ordinateur (TAO) CAT toolsTAO Software that assists a human translator during the translation process, commonly by dividing texts into segments and providing functions such as translation-memory retrieval, terminology management, consistency checks and file management.Logiciel qui assiste un traducteur humain pendant le processus de traduction, généralement en divisant les textes en segments et en offrant des fonctions comme la recherche en mémoire de traduction, la gestion terminologique, les vérifications de cohérence et la gestion des fichiers. translates segment by segment, and the tool saves each source segment with its target segment in a translation memory translation memory (TM)mémoire de traduction (MT) CAT toolsTAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text.Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. . Otherwise it is created afterwards with automatic alignment alignment²alignement CAT toolsTAO The process of pairing a source text with an existing translation of it, segment by segment, so that the pairs can be stored as translation units in a translation memory.Opération qui consiste à apparier un texte source et une traduction déjà existante de ce texte, segment par segment, afin d'en stocker les paires comme unités de traduction dans une mémoire de traduction. tools, whose quality varies (see also the Wordfast: alignment chapter, in the CAT tools module) (voir aussi le chapitre Wordfast : alignement, dans le module Outils de TAO). A translation memory is therefore very close to an aligned parallel corpus, with one difference: it does not always keep the segments in their original order or with their context. For a statistical system that difference does not matter, since it translates one sentence at a time.
Translation model, language model and decoder
The parts of a statistical system are shown in Figure 2figure 2 (Jurafsky & Martin, 2026).
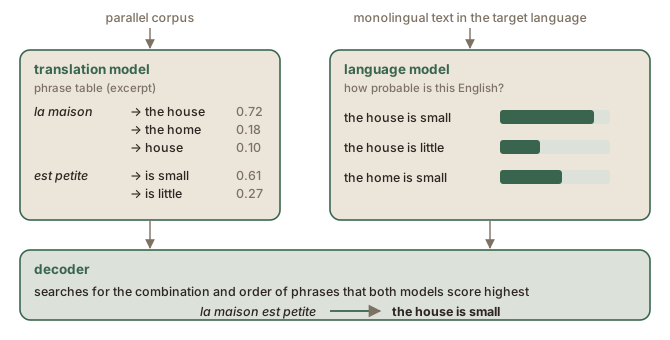
- The translation model contains the bilingual knowledge: for each source word or phrase, the target words or phrases paired with it in the corpus, each with a probability. In the phrase-based systems that became standard in the 2000s, this is a table of phrase pairs, the phrase table.
- The language model language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. contains the knowledge of the target language, learned from monolingual text, which is far more plentiful than parallel text. It says how probable a sequence of target words is, which lets the system prefer the house is small to the house is little when both are in the phrase table.
- The decoder combines the two: it takes every phrase pair that matches the source sentence and searches for the combination and order whose probability is highest under both models together.
The reference textbook of this generation is Koehn (2010).
The whole system is built from counts, so it is the second paradigm, machine learning machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. , with the features featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. chosen by people (see also the turn to machine learning page, in the Foundations of AI & NLP module) (voir aussi la page Le virage vers l'apprentissage automatique, dans le module Fondements de l'IA et du TAL). Everything the system has about the two languages comes from its parallel corpus and its monolingual text.
How the phrase table is learned
Deciphering a menu
You can try the reasoning yourself on a menu in a language you do not read, for example the four dishes in the table below. If you read Chinese, the steps work the same way for a menu in any language you do not know.
| On the menu | In English |
|---|---|
| 虾仁炒饭 | Shrimp fried rice |
| 牛肉炒饭 | Beef fried rice |
| 牛肉面 | Beef noodles |
| 炒面 | Fried noodles |
- Two dishes are fried rice, and the only signs they have in common are 炒饭, so 炒饭 probably means fried rice.
- Two dishes contain beef, and they have 牛肉 in common, so 牛肉 means beef: two signs for one English word.
- In 牛肉面, once 牛肉 is beef, the one sign left, 面, must be noodles.
- In 炒面, once 面 is noodles, 炒 must be fried, which leaves 饭 in 炒饭 for rice.
- In the first dish, 虾仁 is then the only candidate left for shrimp.
You have matched every sign to an English word without reading the menu, only by comparing which signs and which English words occur together. Real translations are less tidy: the same menu could translate 炒面 as chow mein, and that dish would then tell you nothing about fried or noodles.
What the system does
A statistical system applies the same idea to millions of sentence pairs, with counts in place of reasoning.
- At the start, the system has no information about either language. Every word of a source sentence is equally likely to translate every word of its target sentence (Brown et al., 1993).
- The system counts and recalculates, many times over. Words that keep occurring in the same sentence pairs gain probability; once a word’s translation is clear, the other words of the pair are left to share the rest. The effect is close to the elimination you did on the menu. The result is a word alignment: in each sentence pair, each word is paired with its probable translation (Brown et al., 1993).
- The system then collects phrase pairs, sequences of words that are aligned only with each other, such as 炒面 and fried noodles (Koehn et al., 2003).
- The probability in the phrase table is a share. Of all the times a source phrase was paired with something, it is the share of times it was paired with this translation (Koehn et al., 2003). If 炒面 occurred 1 000 times, 700 times with fried noodles, 250 times with chow mein and 50 times with noodles, the three probabilities would be 0.70, 0.25 and 0.05 (illustrative numbers).
The language model and large language models
The language model of a statistical system belongs to the same family as the large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (LLMs) behind today’s chatbots: every language model gives a probability to a sequence of words (Jurafsky & Martin, 2026). The two differ in how they reach that probability and in what they are used for.
- What the model takes into account. In this generation the language models were n-gram n-gramn-gramme corporacorpus A sequence of n consecutive items from a text, usually words: bigrams (n = 2), trigrams (n = 3), and so on.Suite de n éléments consécutifs d'un texte, généralement des mots : bigrammes (n = 2), trigrammes (n = 3), etc. models, which estimate each word from the few words before it, counted in monolingual text. An LLM is a neural network neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. that takes the whole preceding text into account, up to the limit of its context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). .
- Whether the model produces text. In a statistical system the language model does not produce any text of its own: the phrase table proposes the candidates and the language model only scores them. An LLM produces the text itself, one token at a time, by choosing among the tokens it gives a high probability (see also the LLMs as next-word predictors chapter, in the LLM lifecycle module) (voir aussi le chapitre Les GML, prédicteurs du mot suivant, dans le module Cycle de vie des GML).
Dependence on the training data
The quality of a statistical system depends mainly on its training data:
- the more translated words a system was trained on, the more reliable its counts;
- the closer the training data is to the text to translate, in domain and in style, the better the output: a system trained on parliamentary proceedings translates proceedings well and a product manual less well;
- languages and domains with little parallel text are served badly, a problem the neural generation inherited (see also the Remaining failures page) (voir aussi la page Les échecs qui subsistent).
Apprendre des traductions humaines
La deuxième génération a remplacé les règles des linguistes par des comptages. Sa matière première est un corpus parallèle parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. : une grande collection de textes accompagnés de leurs traductions, alignés phrase par phrase. Les premiers systèmes statistiques, vers 1990, ont été rendus possibles par le Hansard, le compte rendu des débats du Parlement du Canada en anglais et en français (Jurafsky & Martin, 2026). Les corpus qui ont suivi servent encore aujourd’hui à entraîner et à tester des systèmes.
| Corpus | Provenance | Taille |
|---|---|---|
| Europarl (Koehn, 2005) | les débats du Parlement européen | de 400 000 à 2 millions de phrases dans chacune de 21 langues |
| Corpus parallèle des Nations Unies (Ziemski et al., 2016) | des documents de l’ONU | environ 10 millions de phrases dans les six langues officielles |
| OPUS (Tiedemann, 2012) | une collection de corpus : sous-titres, pages Web publiées en plusieurs langues, documentation de logiciels | variable selon le corpus et la paire |
Un système apprend le plus facilement d’un corpus parallèle bien aligné, c’est-à-dire dans lequel chaque phrase ou segment source est apparié à son équivalent dans la langue cible. L’alignement peut être déjà là : un traducteur qui travaille dans un outil de traduction assistée par ordinateur computer-assisted translation (CAT)traduction assistée par ordinateur (TAO) CAT toolsTAO Software that assists a human translator during the translation process, commonly by dividing texts into segments and providing functions such as translation-memory retrieval, terminology management, consistency checks and file management.Logiciel qui assiste un traducteur humain pendant le processus de traduction, généralement en divisant les textes en segments et en offrant des fonctions comme la recherche en mémoire de traduction, la gestion terminologique, les vérifications de cohérence et la gestion des fichiers. (TAO) traduit segment par segment, et l’outil enregistre chaque segment source avec son segment cible dans une mémoire de traduction translation memory (TM)mémoire de traduction (MT) CAT toolsTAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text.Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. . Sinon, il est créé après coup avec des outils d’alignement alignment²alignement CAT toolsTAO The process of pairing a source text with an existing translation of it, segment by segment, so that the pairs can be stored as translation units in a translation memory.Opération qui consiste à apparier un texte source et une traduction déjà existante de ce texte, segment par segment, afin d'en stocker les paires comme unités de traduction dans une mémoire de traduction. automatique, dont la qualité varie (see also the Wordfast: alignment chapter, in the CAT tools module) (voir aussi le chapitre Wordfast : alignement, dans le module Outils de TAO). Une mémoire de traduction est donc très proche d’un corpus parallèle aligné, à une différence près : elle ne conserve pas toujours les segments dans leur ordre d’origine ni avec leur contexte. Pour un système statistique, cette différence n’a pas d’importance, puisqu’il traduit une phrase à la fois.
Modèle de traduction, modèle de langue et décodeur
La Figure 2figure 2 présente les composantes d’un système statistique (Jurafsky & Martin, 2026).
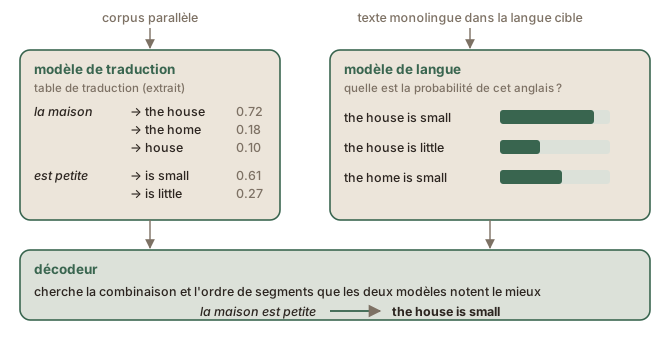
- Le modèle de traduction contient les connaissances bilingues : pour chaque mot ou segment source, les mots ou segments cibles qui lui sont appariés dans le corpus, chacun avec une probabilité. Dans les systèmes fondés sur les segments, devenus la norme dans les années 2000, il s’agit d’une table de paires de segments, la table de traduction (angl. phrase table).
- Le modèle de langue language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. contient les connaissances sur la langue cible, apprises à partir de textes monolingues, bien plus abondants que les textes parallèles. Il indique la probabilité d’une suite de mots cibles, ce qui permet au système de préférer the house is small à the house is little quand les deux figurent dans la table de traduction.
- Le décodeur combine les deux : il prend toutes les paires de segments qui correspondent à la phrase source et cherche la combinaison et l’ordre dont la probabilité est la plus élevée selon les deux modèles réunis.
L’ouvrage de référence de cette génération est celui de Koehn (2010).
Tout le système repose sur des comptages : il relève donc du deuxième paradigme, l’apprentissage automatique machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. , avec des attributs featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. choisis par des personnes (see also the turn to machine learning page, in the Foundations of AI & NLP module) (voir aussi la page Le virage vers l'apprentissage automatique, dans le module Fondements de l'IA et du TAL). Tout ce dont le système dispose sur les deux langues vient de son corpus parallèle et de ses textes monolingues.
Comment la table de traduction est apprise
Déchiffrer un menu
Vous pouvez essayer ce raisonnement vous-même sur un menu dans une langue que vous ne lisez pas, par exemple les quatre plats du tableau ci-dessous. Si vous lisez le chinois, les étapes fonctionnent de la même façon avec un menu dans n’importe quelle langue que vous ne connaissez pas.
| Sur le menu | En français |
|---|---|
| 虾仁炒饭 | Riz sauté aux crevettes |
| 牛肉炒饭 | Riz sauté au bœuf |
| 牛肉面 | Nouilles au bœuf |
| 炒面 | Nouilles sautées |
- Deux plats sont du riz sauté, et les seuls signes qu’ils ont en commun sont 炒饭 : 炒饭 veut donc probablement dire riz sauté.
- Deux plats contiennent du bœuf, et ils ont 牛肉 en commun : 牛肉 veut donc dire bœuf, deux signes pour un seul mot français.
- Dans 牛肉面, une fois 牛肉 identifié comme bœuf, le seul signe qui reste, 面, doit vouloir dire nouilles.
- Dans 炒面, une fois 面 identifié comme nouilles, 炒 doit vouloir dire sautées, ce qui laisse 饭, dans 炒饭, pour riz.
- Dans le premier plat, 虾仁 est alors le seul candidat qui reste pour crevettes.
Vous avez associé chaque signe à un mot français sans lire le menu, uniquement en comparant quels signes et quels mots français apparaissent ensemble. Les traductions réelles sont moins nettes : le même menu pourrait traduire 炒面 par chow mein, et ce plat ne vous apprendrait alors rien sur sautées ni sur nouilles.
Ce que fait le système
Un système statistique applique la même idée à des millions de paires de phrases, avec des comptages à la place du raisonnement.
- Au départ, le système ne dispose d’aucune information sur l’une ou l’autre langue. Chaque mot d’une phrase source a autant de chances de traduire n’importe quel mot de sa phrase cible (Brown et al., 1993).
- Le système compte et recalcule, un grand nombre de fois. Les mots qui reviennent sans cesse dans les mêmes paires de phrases gagnent en probabilité ; une fois la traduction d’un mot établie, les autres mots de la paire se partagent le reste. L’effet est proche de l’élimination que vous avez faite sur le menu. Le résultat est un alignement des mots : dans chaque paire de phrases, chaque mot est apparié à sa traduction probable (Brown et al., 1993).
- Le système recueille ensuite des paires de segments, des suites de mots qui ne sont alignées qu’entre elles, comme 炒面 et nouilles sautées (Koehn et al., 2003).
- La probabilité dans la table de traduction est une proportion. Sur toutes les fois où un segment source a été apparié à quelque chose, c’est la proportion des fois où il a été apparié à cette traduction (Koehn et al., 2003). Si 炒面 apparaissait 1 000 fois, dont 700 fois avec nouilles sautées, 250 fois avec chow mein et 50 fois avec nouilles, les trois probabilités seraient 0,70, 0,25 et 0,05 (chiffres fictifs).
Le modèle de langue et les grands modèles de langue
Le modèle de langue d’un système statistique appartient à la même famille que les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML, angl. large language models) derrière les agents conversationnels actuels : tout modèle de langue attribue une probabilité à une suite de mots (Jurafsky & Martin, 2026). Les deux diffèrent par la façon dont ils obtiennent cette probabilité et par l’usage qui en est fait.
- Ce que le modèle prend en compte. Dans cette génération, les modèles de langue étaient des modèles n-grammes n-gramn-gramme corporacorpus A sequence of n consecutive items from a text, usually words: bigrams (n = 2), trigrams (n = 3), and so on.Suite de n éléments consécutifs d'un texte, généralement des mots : bigrammes (n = 2), trigrammes (n = 3), etc. , qui estiment chaque mot à partir des quelques mots qui le précèdent, comptés dans des textes monolingues. Un GML est un réseau de neurones neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. qui prend en compte tout le texte qui précède, dans la limite de sa fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). .
- Si le modèle produit du texte. Dans un système statistique, le modèle de langue ne produit aucun texte de lui-même : la table de traduction propose les candidats, et le modèle de langue se contente de les noter. Un GML produit lui-même le texte, un jeton à la fois, en choisissant parmi les jetons auxquels il attribue une forte probabilité (see also the LLMs as next-word predictors chapter, in the LLM lifecycle module) (voir aussi le chapitre Les GML, prédicteurs du mot suivant, dans le module Cycle de vie des GML).
La dépendance aux données d’entraînement
La qualité d’un système statistique dépend surtout de ses données d’entraînement :
- plus le système a été entraîné sur un grand nombre de mots traduits, plus ses comptages sont fiables ;
- plus les données d’entraînement sont proches du texte à traduire, par le domaine et par le style, meilleur est le résultat : un système entraîné sur des débats parlementaires traduit bien des débats et moins bien un manuel de produit ;
- les langues et les domaines qui disposent de peu de textes parallèles sont mal servis, un problème dont la génération neuronale a hérité (see also the Remaining failures page) (voir aussi la page Les échecs qui subsistent).
Sources
- Brown, P. F., Della Pietra, S. A., Della Pietra, V. J., & Mercer, R. L. (1993). The Mathematics of Statistical Machine Translation: Parameter Estimation. Computational Linguistics, 19(2), 263–311. https://aclanthology.org/J93-2003/
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Koehn, P. (2005). Europarl: A Parallel Corpus for Statistical Machine Translation. Proceedings of Machine Translation Summit X, Phuket, 79–86. https://aclanthology.org/2005.mtsummit-papers.11/
- Koehn, P. (2010). Statistical Machine Translation. Cambridge University Press. https://doi.org/10.1017/CBO9780511815829
- Koehn, P., Och, F. J., & Marcu, D. (2003). Statistical Phrase-Based Translation. Proceedings of the 2003 Human Language Technology Conference of the North American Chapter of the Association for Computational Linguistics, 127–133. https://aclanthology.org/N03-1017/
- Tiedemann, J. (2012). Parallel Data, Tools and Interfaces in OPUS. Proceedings of the Eighth International Conference on Language Resources and Evaluation (LREC'12), Istanbul, 2214–2218. https://aclanthology.org/L12-1246/
- Ziemski, M., Junczys-Dowmunt, M., & Pouliquen, B. (2016). The United Nations Parallel Corpus v1.0. Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC'16), Portorož, 3530–3534. https://aclanthology.org/L16-1561/