Remaining failuresLes échecs qui subsistent
TRA6008 To read for S7À lire pour la S7
The weaknesses found at WMT
WMT, the yearly comparison of machine translation systems held at the Conference on Machine Translation, reports specific weaknesses even in the best systems (Kocmi et al., 2024b, 2025) (see also the trend across editions page) (voir aussi la page La tendance d'une édition à l'autre):
- speech input, the hardest domain two years running, most likely because the systems translate an automatic transcription and inherit its errors;
- low-resource languages, where the human evaluation of 2025 showed weaknesses in all the models tested, in Egyptian Arabic and in Maasai;
- specific phenomena tested by targeted test suites: non-standard input, complex syntax, domain terminology, the choice and agreement of gender.
By contrast, in the domains tested in 2024, the best systems’ translations from English into Spanish were close to the human references.
The Last Translation Benchmark
Standard test sets test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. are close to saturation: the best systems score so high on them that the tests barely tell them apart and no longer show where they fail (Zouhar et al., 2026). The Last Translation Benchmark benchmarktest de performances evaluationévaluation A standardized evaluation used to measure and compare how AI systems perform on particular tasks or capabilities.Évaluation normalisée servant à mesurer et à comparer la performance de systèmes d'IA sur des tâches ou des capacités données. was built the other way round, from examples that the leading systems get wrong (Figure 7figure 7).
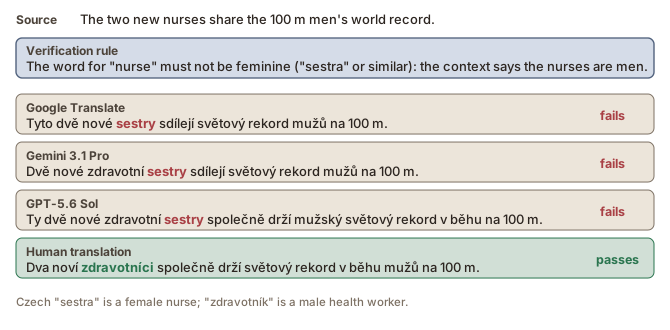
- The contributors. 260 contributors from 177 institutions, each submitting sentences, images, audio or video that they knew to be hard, with a correct translation of their own; every submission is reviewed by another contributor. The first version, LTBv1, contains 3 456 examples in 109 languages (Zouhar et al., 2026).
- The admission test. An example is accepted only if most of the systems shown to the contributor fail it and the human translation passes: the benchmark contains hard cases by construction, and says nothing about the quality of a typical translation.
- The scoring. Each example comes with one or more verification rules describing the failure to look for (“the word for nurse must not be feminine”). A model checks each translation against each rule, and a translation passes only if it satisfies them all. The score of a system is the share of examples it passes.
| System | Examples passed |
|---|---|
| Human translations (the contributors’) | 99.8 % |
| Gemini 3.1 Pro | 41.9 % |
| GPT-5.6 Sol | 31.8 % |
| GPT-5.6 Luna | 19.3 % |
| Claude Sonnet 4.5 | 6.0 % |
| NLLB 3.3B, an encoder-decoder system | 2.0 % |
| Google Translate | 1.6 % |
- Ordinary metrics did not flag the failures. On the same translations, ordinary metrics and a large language model used as judge gave scores in the range the authors label “good”, while the share of examples passed stayed low. A judge given the rule detected the error; a judge asked only to rate the translation usually did not (Zouhar et al., 2026) (see also the A large language model as judge page, in the Evaluating language technology module) (voir aussi la page Un grand modèle de langue comme juge, dans le module L'évaluation des technologies langagières).
- Told the rule, the models mostly passed. Given the verification rules in the prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. , the models’ pass rate rose to about 90 %: they satisfy the requirement once it is stated, but they do not apply it unprompted.
Sources of difficulty
From the examples collected, the authors built a taxonomy of the sources of difficulty, drawn in Figure 8figure 8. The largest groups are the classic difficulties of translation: polysemy polysemypolysémie linguisticslinguistique The property of a word or lemma having two or more related senses.Propriété d'un mot ou d'un lemme qui possède deux sens apparentés ou plus. , metaphor, cultural knowledge and the specifics of a language variety.
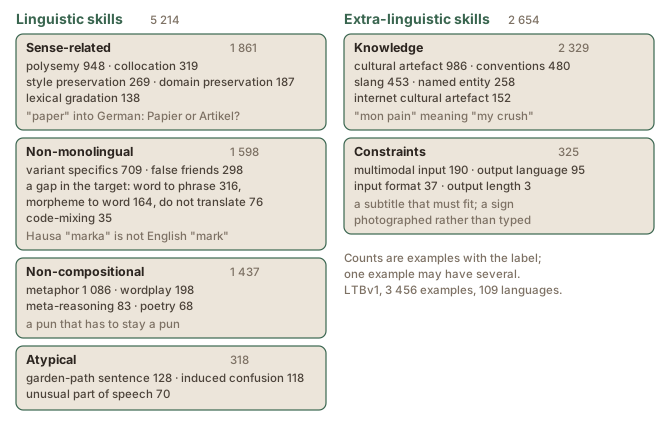
| Difficulty | Example | Result |
|---|---|---|
| Polysemy in a domain | English paper, meaning an article, into German | most models wrote Papier, the material, where Artikel or the loanword Paper was needed |
| Internet culture and slang | French mon pain for my crush, with a borrowed whippin | several models kept bread |
| A false friend | Hausa marka, heavy rain, which looks like English mark | one service wrote this monsoon is marked |
| Meta-reasoning | Italian Come si dice formaggio in inglese? | most models translated formaggio too, producing a question that answers itself |
Languages with little data
The results of WMT and of the Last Translation Benchmark mostly concern well-resourced language pairs. For most of the world’s languages there is no large parallel corpus parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. . A well-resourced language has the same problem in a domain with little translated text.
- Remedies. Two remedies are backtranslation, where a system trained for the opposite direction turns monolingual target text into synthetic parallel data, and multilingual models, which draw on a related language that has more data (Jurafsky & Martin, 2026).
- Data quality. In a manual audit of large parallel corpora, many had fewer than half of their sentences of acceptable quality, for instance repeated web text or wrong translations. This suggests that speakers of the languages concerned were not involved enough in building them (Jurafsky & Martin, 2026).
- Benchmarks. The benchmarks themselves lean toward well-resourced languages: the Last Translation Benchmark’s examples skew toward English, with 73 % translating into it (Zouhar et al., 2026) (see also the Linguistic hegemony page, in the Critical issues with LLMs module) (voir aussi la page L'hégémonie linguistique, dans le module Enjeux critiques des GML).
Les faiblesses relevées à WMT
WMT, la comparaison annuelle des systèmes de traduction automatique tenue lors de la conférence sur la traduction automatique (Conference on Machine Translation), relève des faiblesses précises même chez les meilleurs systèmes (Kocmi et al., 2024b, 2025) (see also the trend across editions page) (voir aussi la page La tendance d'une édition à l'autre) :
- l’entrée orale, le domaine le plus difficile deux années de suite, très probablement parce que les systèmes traduisent une transcription automatique et en héritent les erreurs ;
- les langues peu dotées, où l’évaluation humaine de 2025 a montré des faiblesses dans tous les modèles testés, en arabe égyptien et en maasaï ;
- des phénomènes précis examinés par des séries de tests ciblées : les entrées non standard, la syntaxe complexe, la terminologie d’un domaine, le choix et l’accord du genre.
Par contraste, dans les domaines testés en 2024, les traductions de l’anglais vers l’espagnol des meilleurs systèmes étaient proches des références humaines.
Le Last Translation Benchmark
Les jeux de données de test test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. habituels approchent de la saturation : les meilleurs systèmes y obtiennent des scores si élevés que ces tests les départagent à peine et ne montrent plus où ils échouent (Zouhar et al., 2026). Le Last Translation Benchmark, un test de performances benchmarktest de performances evaluationévaluation A standardized evaluation used to measure and compare how AI systems perform on particular tasks or capabilities.Évaluation normalisée servant à mesurer et à comparer la performance de systèmes d'IA sur des tâches ou des capacités données. , a été construit dans l’autre sens, à partir d’exemples que les principaux systèmes traduisent mal (Figure 7figure 7).
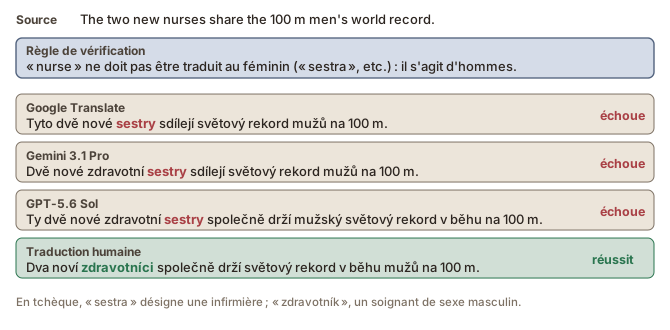
- Les contributeurs. 260 contributeurs de 177 établissements ont chacun soumis des phrases, des images, des fichiers audio ou des vidéos qu’ils savaient difficiles, avec leur propre traduction correcte ; chaque soumission est révisée par un autre contributeur. La première version, LTBv1, contient 3 456 exemples dans 109 langues (Zouhar et al., 2026).
- Le critère d’admission. Un exemple n’est accepté que si la plupart des systèmes montrés au contributeur échouent et que la traduction humaine réussit : le test ne contient que des cas difficiles par construction, et ne dit rien de la qualité d’une traduction ordinaire.
- La notation. Chaque exemple est accompagné d’une ou de plusieurs règles de vérification qui décrivent l’échec à rechercher (« le mot pour nurse ne doit pas être au féminin »). Un modèle vérifie chaque traduction au regard de chaque règle, et une traduction ne réussit que si elle les respecte toutes. Le score d’un système est la proportion d’exemples qu’il réussit.
| Système | Exemples réussis |
|---|---|
| Traductions humaines (celles des contributeurs) | 99,8 % |
| Gemini 3.1 Pro | 41,9 % |
| GPT-5.6 Sol | 31,8 % |
| GPT-5.6 Luna | 19,3 % |
| Claude Sonnet 4.5 | 6,0 % |
| NLLB 3.3B, un système encodeur-décodeur | 2,0 % |
| Google Traduction | 1,6 % |
- Les mesures habituelles n’ont pas signalé les échecs. Sur les mêmes traductions, les mesures habituelles et un grand modèle de langue employé comme juge ont donné des scores dans la plage que les auteurs qualifient de « bonne », alors que la proportion d’exemples réussis restait faible. Un juge à qui l’on donnait la règle détectait l’erreur ; un juge à qui l’on demandait seulement d’évaluer la traduction ne la détectait généralement pas (Zouhar et al., 2026) (see also the A large language model as judge page, in the Evaluating language technology module) (voir aussi la page Un grand modèle de langue comme juge, dans le module L'évaluation des technologies langagières).
- Une fois la règle donnée, les modèles ont surtout réussi. Avec les règles de vérification dans la requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. , le taux de réussite des modèles a atteint environ 90 % : ils respectent l’exigence une fois qu’elle est énoncée, mais ne l’appliquent pas d’eux-mêmes.
Les sources de difficulté
À partir des exemples recueillis, les auteurs ont établi une taxinomie des sources de difficulté, présentée dans la Figure 8figure 8. Les groupes les plus nombreux sont les difficultés classiques de la traduction : la polysémie polysemypolysémie linguisticslinguistique The property of a word or lemma having two or more related senses.Propriété d'un mot ou d'un lemme qui possède deux sens apparentés ou plus. , la métaphore, les connaissances culturelles et les particularités d’une variété de langue.
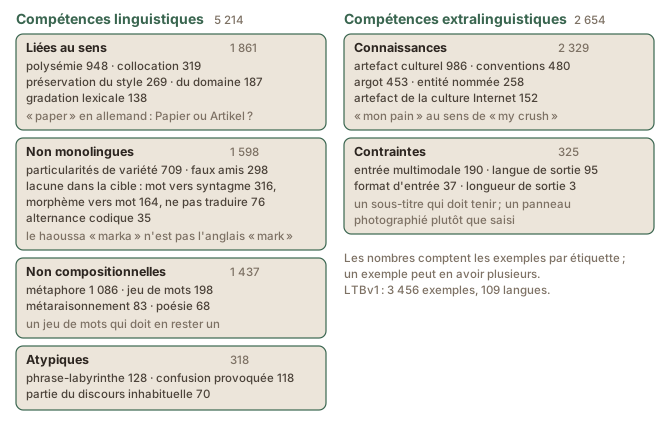
| Difficulté | Exemple | Résultat |
|---|---|---|
| Polysémie dans un domaine | l’anglais paper, au sens d’article, vers l’allemand | la plupart des modèles ont écrit Papier, la matière, là où il fallait Artikel ou l’emprunt Paper |
| Culture Internet et argot | le français mon pain au sens de my crush, avec l’emprunt whippin | plusieurs modèles ont gardé bread |
| Un faux ami | le haoussa marka, forte pluie, qui ressemble à l’anglais mark | un service a écrit this monsoon is marked |
| Métaraisonnement | l’italien Come si dice formaggio in inglese? | la plupart des modèles ont aussi traduit formaggio, ce qui donne une question qui contient sa réponse |
Les langues peu dotées
Les résultats de WMT et du Last Translation Benchmark portent surtout sur des paires de langues bien dotées. Pour la plupart des langues du monde, il n’existe pas de grand corpus parallèle parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. . Une langue bien dotée connaît le même problème dans un domaine où il existe peu de textes traduits.
- Les solutions. Deux solutions sont la rétrotraduction, où un système entraîné pour la direction inverse transforme des textes monolingues de la langue cible en données parallèles synthétiques, et les modèles multilingues, qui s’appuient sur une langue apparentée disposant de plus de données (Jurafsky & Martin, 2026).
- La qualité des données. Dans un audit manuel de grands corpus parallèles, beaucoup comptaient moins de la moitié de phrases de qualité acceptable, par exemple du texte Web répété ou des traductions erronées. Cela laisse penser que les locuteurs des langues concernées n’ont pas été assez associés à leur constitution (Jurafsky & Martin, 2026).
- Les tests de performances. Les tests de performances eux-mêmes penchent vers les langues bien dotées : 73 % des exemples du Last Translation Benchmark se traduisent vers l’anglais (Zouhar et al., 2026) (see also the Linguistic hegemony page, in the Critical issues with LLMs module) (voir aussi la page L'hégémonie linguistique, dans le module Enjeux critiques des GML).
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
- Kocmi, T., Avramidis, E., Bawden, R., Bojar, O., Dvorkovich, A., Federmann, C., et al. (2024b). Findings of the WMT24 General Machine Translation Shared Task: The LLM Era Is Here but MT Is Not Solved Yet. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1–46. https://doi.org/10.18653/v1/2024.wmt-1.1
- Zouhar, V., Bafna, N., Choudhary, M., Züfle, M., Rajaee, S., Chen, P., et al. (2026). Last Translation Benchmark. Preprint, arXiv:2609.04173. http://arxiv.org/abs/2609.04173