Neural translationLa traduction neuronale
TRA6008 To read for S7À lire pour la S7
A single network
Neural machine translation, the third generation of machine translation systems, did away with the three separate components of statistical machine translation (Figure 1figure 1). Training on a parallel corpus parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. remained central, but there is no longer a phrase table or a separate language model: a single network is trained to turn a source sentence into a target sentence, and along the way it learns its own vectors for the words of both languages (word embeddings word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. ). This is deep learning deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. , the third of the four paradigms of language technology, applied to translation (see also the How a network learns page, in the Foundations of AI & NLP module) (voir aussi la page Comment un réseau apprend, dans le module Fondements de l'IA et du TAL).
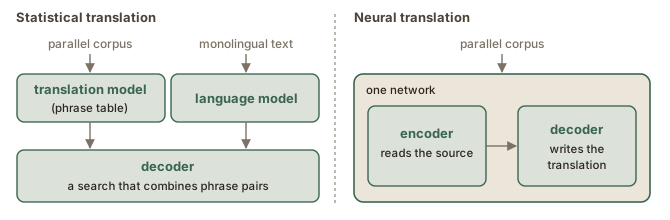
A decoder remains, but the word now names a different thing. In a statistical system the decoder was the search that combined phrase pairs; in a neural system it is the half of the network that writes the translation. The other half, the encoder, reads the source sentence, and the design takes its name from these two halves:
An encoder-decoder model turns one sequence of words into another. Models that do this form a wider family, with a name of its own:
Translation is the typical case: the output is in another language, and often differs from the source in length and word order. Figure 2figure 2 follows one such sentence through a transformer encoder-decoder, the design of today’s translation systems (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres). The source has six words and the translation five, a suivi becomes the single word followed, and noir comes after chien where black comes before dog.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
- The encoder reads the whole source sentence at once and turns each word into a contextual embedding contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. : a vector that depends on the words around it, so the same word gets a different vector in a different sentence. This lets the system translate an ambiguous word according to its context (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
- The decoder starts from a start signal. To choose the first word, it draws through cross-attention cross-attentionattention croisée deep learningapprentissage profond An attention mechanism in which the queries come from one sequence or component and the keys and values come from another.Mécanisme d'attention dans lequel les requêtes proviennent d'une séquence ou d'un composant et les clés et valeurs d'un autre. on the vectors of every source word, and each of those vectors already reflects the whole sentence. Jean is therefore chosen with all of Jean a suivi le chien noir in view, not from Jean alone.
- The decoder then writes one token token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. (a word or a piece of a word) at a time. Each token written becomes its next input, and for each new token the decoder draws on the source and, through self-attention self-attentionautoattention deep learningapprentissage profond An attention mechanism that allows each token in a sequence to assign different weights to other relevant tokens in the same sequence and combine information from them.Mécanisme d'attention qui permet à chaque jeton d'une séquence d'attribuer des poids différents aux autres jetons pertinents de la même séquence et de combiner l'information qu'ils portent. , on everything already written (Jurafsky & Martin, 2026). Each position produces the word after it: the vector at the, the last word written, is the one that chooses black, so its attention goes mostly to noir, the last word of the source. When the itself was produced, one step earlier, the attention went mostly to le. The decoder does not translate word by word: the source word it draws on most is the one behind the word being written, wherever it is in the sentence.
- A written token is not revised. Every later token is built on it, so a poor early choice affects everything written after it (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML).
- Attention, then the transformer. The attention mechanism attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). lets the decoder draw on any word of the source, wherever it is in the sentence. The transformer transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. , the architecture of the systems built for translation today, is built on attention throughout, which lets it process all the words of a sentence at once and so train much faster (Vaswani et al., 2017; Jurafsky & Martin, 2026).Bahdanau et al. (2015) first added attention to neural translation, on recurrent networks, which read and write one word after another. The transformer of Vaswani et al. (2017) replaced the recurrent networks with attention throughout.
Subwords and a shared vocabulary
A neural system works with a vocabulary vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. fixed in advance: a list of tokens that are pieces of words rather than whole words (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres). In a translation system, the source and the target share this vocabulary, which makes it easy to copy a name unchanged from one side to the other: Ndiaye is cut into the same pieces in the French and in the English of Figure 3figure 3. Because the tokens are pieces of words, the same system also handles languages written without spaces between words, such as Chinese or Thai (Jurafsky & Martin, 2026).
Choosing the words
At each step the decoder gives a probability to every token of its vocabulary, and one of them has to be chosen. The simplest method takes the most probable token at every step (greedy decoding greedy decodingdécodage glouton language modelsmodèles de langue A decoding method that selects the single most probable next token at every generation step. The selected token is added to the sequence, and the procedure repeats until generation stops.Méthode de décodage qui retient, à chaque étape de génération, l'unique jeton le plus probable. ), but that can produce a worse sentence: a token that looked best at one step may make the next steps worse. Translation systems therefore usually choose with a method called beam search:
In Figure 4figure 4, greedy decoding is stuck with the literal have, while beam search also keeps am and finds I am hungry.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Translation systems typically keep 5 to 10 candidate sentences open at once (the beam width) and extend them in parallel (Jurafsky & Martin, 2026), so the token that looked best at the first step can still lose to a candidate that began with a less probable one. Beam search does not guarantee the best sentence either: a candidate dropped early cannot come back.
Large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. are usually decoded differently. Beam search suits a constrained task such as translation, where the output has to correspond closely to one source text. For open-ended writing, always taking the most probable text makes the output generic and repetitive, so large language models usually draw the next token at random, with the more probable tokens more likely to be drawn: this is called sampling samplingéchantillonnage language modelsmodèles de langue A decoding method that uses an element of randomness to select the next token generated by a language model.Méthode de décodage qui introduit une part de hasard dans le choix du prochain jeton généré par un modèle de langue. (Jurafsky & Martin, 2026). Sampling is one reason the same translation request to a chatbot can produce different translations (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML).
Un seul réseau
La traduction automatique neuronale, troisième génération de systèmes de traduction automatique, a supprimé les trois composantes séparées de la traduction automatique statistique (Figure 1figure 1). L’entraînement sur un corpus parallèle parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. est resté central, mais il n’y a plus de table de traduction ni de modèle de langue séparé : un seul réseau est entraîné à transformer une phrase source en phrase cible, et il apprend au passage ses propres vecteurs pour les mots des deux langues (plongements lexicaux word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. ). C’est l’apprentissage profond deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. , le troisième des quatre paradigmes des technologies langagières, appliqué à la traduction (see also the How a network learns page, in the Foundations of AI & NLP module) (voir aussi la page Comment un réseau apprend, dans le module Fondements de l'IA et du TAL).
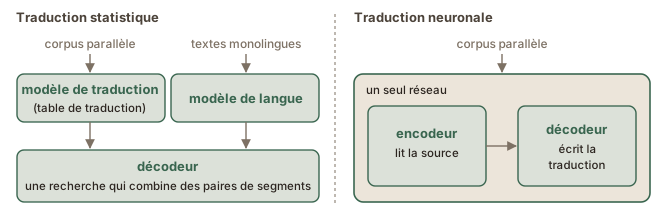
Un décodeur demeure, mais le mot désigne maintenant autre chose. Dans un système statistique, le décodeur était la recherche qui combinait les paires de segments ; dans un système neuronal, c’est la moitié du réseau qui écrit la traduction. L’autre moitié, l’encodeur, lit la phrase source, et l’architecture tire son nom de ces deux moitiés :
Un modèle encodeur-décodeur transforme une séquence de mots en une autre. Les modèles qui font cela forment une famille plus large, qui a son propre nom :
La traduction en est le cas typique : le résultat est dans une autre langue, et diffère souvent de la source par sa longueur et l’ordre des mots. La Figure 2figure 2 suit une telle phrase à travers un encodeur-décodeur à transformeur, l’architecture des systèmes de traduction actuels (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres). La source compte six mots et la traduction cinq, a suivi devient le seul mot followed, et noir vient après chien alors que black vient avant dog.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
- L’encodeur lit toute la phrase source d’un coup et transforme chaque mot en un plongement contextuel contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. : un vecteur qui dépend des mots qui l’entourent, si bien que le même mot reçoit un vecteur différent dans une autre phrase. Cela permet au système de traduire un mot ambigu selon son contexte (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
- Le décodeur part d’un signal de début. Pour choisir le premier mot, il puise, par l’attention croisée cross-attentionattention croisée deep learningapprentissage profond An attention mechanism in which the queries come from one sequence or component and the keys and values come from another.Mécanisme d'attention dans lequel les requêtes proviennent d'une séquence ou d'un composant et les clés et valeurs d'un autre. , dans les vecteurs de tous les mots sources, et chacun de ces vecteurs reflète déjà toute la phrase. Jean est donc choisi avec l’ensemble de Jean a suivi le chien noir en vue, et non à partir de Jean seul.
- Le décodeur écrit ensuite un jeton token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. (un mot ou un morceau de mot) à la fois. Chaque jeton écrit devient son entrée suivante, et pour chaque nouveau jeton, le décodeur puise dans la source et, par l’autoattention self-attentionautoattention deep learningapprentissage profond An attention mechanism that allows each token in a sequence to assign different weights to other relevant tokens in the same sequence and combine information from them.Mécanisme d'attention qui permet à chaque jeton d'une séquence d'attribuer des poids différents aux autres jetons pertinents de la même séquence et de combiner l'information qu'ils portent. , dans tout ce qui est déjà écrit (Jurafsky & Martin, 2026). Chaque position produit le mot qui la suit : le vecteur de the, le dernier mot écrit, est celui qui choisit black, si bien que son attention va surtout à noir, le dernier mot de la source. Quand the a lui-même été produit, une étape plus tôt, l’attention allait surtout à le. Le décodeur ne traduit donc pas mot à mot : le mot source dans lequel il puise le plus est celui qui correspond au mot en cours d’écriture, où qu’il se trouve.
- Un jeton écrit n’est pas révisé. Tous les jetons suivants reposent sur lui, si bien qu’un mauvais choix au début se répercute sur la suite (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML).
- L’attention, puis le transformeur. Le mécanisme d’attention attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). permet au décodeur de puiser dans n’importe quel mot de la source, où qu’il se trouve dans la phrase. Le transformeur transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. , l’architecture des systèmes conçus pour la traduction aujourd’hui, repose entièrement sur l’attention, ce qui lui permet de traiter tous les mots d’une phrase à la fois et donc d’être entraîné beaucoup plus vite (Vaswani et al., 2017 ; Jurafsky & Martin, 2026).Bahdanau et al. (2015) ont les premiers ajouté l’attention à la traduction neuronale, sur des réseaux récurrents, qui lisent et écrivent un mot après l’autre. Le transformeur de Vaswani et al. (2017) a remplacé les réseaux récurrents par l’attention partout.
Des morceaux de mots et un vocabulaire commun
Un système neuronal travaille avec un vocabulaire vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. fixé à l’avance : une liste de jetons qui sont des morceaux de mots plutôt que des mots entiers (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres). Dans un système de traduction, la source et la cible partagent ce vocabulaire, ce qui permet de copier facilement un nom tel quel d’un côté à l’autre : Ndiaye est découpé de la même façon dans le français et dans l’anglais de la Figure 3figure 3. Comme les jetons sont des morceaux de mots, le même système traite aussi les langues qui s’écrivent sans espaces entre les mots, comme le chinois ou le thaï (Jurafsky & Martin, 2026).
Le choix des mots
À chaque étape, le décodeur attribue une probabilité à chaque jeton de son vocabulaire, et il faut en choisir un. La méthode la plus simple prend le jeton le plus probable à chaque étape (décodage glouton greedy decodingdécodage glouton language modelsmodèles de langue A decoding method that selects the single most probable next token at every generation step. The selected token is added to the sequence, and the procedure repeats until generation stops.Méthode de décodage qui retient, à chaque étape de génération, l'unique jeton le plus probable. ), mais elle peut produire une phrase moins bonne : un jeton qui semblait le meilleur à une étape peut dégrader les étapes suivantes. Les systèmes de traduction choisissent donc généralement avec une méthode appelée recherche en faisceau :
Dans la Figure 4figure 4, le décodage glouton reste prisonnier du littéral have, alors que la recherche en faisceau garde aussi am et trouve I am hungry.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Les systèmes de traduction gardent généralement de 5 à 10 phrases candidates ouvertes à la fois (la largeur du faisceau) et les prolongent en parallèle (Jurafsky & Martin, 2026), si bien que le jeton qui semblait le meilleur à la première étape peut perdre face à une candidate qui a commencé par un jeton moins probable. La recherche en faisceau ne garantit pas non plus la meilleure phrase : une candidate écartée tôt ne peut plus revenir.
Les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. sont généralement décodés autrement. La recherche en faisceau convient à une tâche contrainte comme la traduction, où le résultat doit correspondre étroitement à un texte source. Pour l’écriture libre, prendre toujours le texte le plus probable rend le résultat générique et répétitif ; les grands modèles de langue tirent donc généralement le jeton suivant au hasard, les jetons les plus probables ayant le plus de chances d’être tirés : c’est l’échantillonnage samplingéchantillonnage language modelsmodèles de langue A decoding method that uses an element of randomness to select the next token generated by a language model.Méthode de décodage qui introduit une part de hasard dans le choix du prochain jeton généré par un modèle de langue. (Jurafsky & Martin, 2026). L’échantillonnage explique en partie qu’une même demande de traduction adressée à un agent conversationnel puisse produire des traductions différentes (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML).
Sources
- Bahdanau, D., Cho, K., & Bengio, Y. (2015). Neural Machine Translation by Jointly Learning to Align and Translate. Third International Conference on Learning Representations (ICLR 2015), oral presentation; arXiv:1409.0473. https://arxiv.org/abs/1409.0473
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NIPS 2017). https://papers.nips.cc/paper_files/paper/2017/hash/3f5ee243547dee91fbd053c1c4a845aa-Abstract.html