Machine translation in a translator's workLa traduction automatique dans le travail du traducteur
TRA6008 To read for S7À lire pour la S7
CAT tool, translation service or chatbot
Machine translation is requested from three kinds of place.
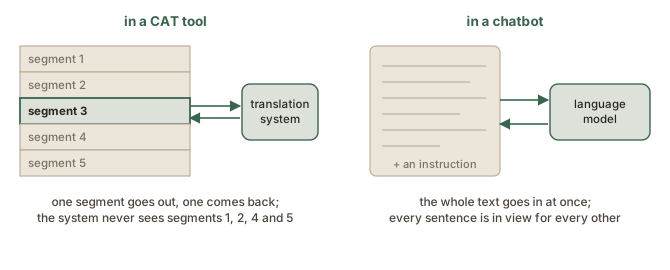
- In a CAT tool. The tool divides the document into segments because its translation memory works segment by segment, and the machine translation connection sends those same segments, one at a time, so the system is given one sentence with nothing before or after it. Only professional translators work this way (see also the Wordfast: tags and machine translation chapter, in the CAT tools module) (voir aussi le chapitre Wordfast : balises et traduction automatique, dans le module Outils de TAO).
- On a translation service, a website or an app, anyone pastes a sentence, a paragraph or an entire file.
- In a chatbot, the whole text goes in with an instruction.
The generation of the system decides how much of the surrounding text it uses. Statistical and neural systems translate one sentence at a time whatever they are given: a document pasted into a service of that generation is cut into sentences, and each is translated in isolation, as it would be in a CAT tool (see also the Neural translation page) (voir aussi la page La traduction neuronale). A large language model can take the whole text as its unit, so the surrounding sentences are in view, and the errors change with it. Figure 5figure 5 shows the two extremes.
The pair of sentences below shows the first kind of error. A system that is given only the first sentence has no way to settle the engineer’s gender, which French needs in order to write ingénieur or ingénieure; the second sentence settles it.
I spoke to the engineer this morning. She will send the drawings on Friday.
Läubli et al. (2018) found that raters comparing whole documents preferred the human translation more clearly than raters comparing isolated sentences: some errors of a fluent system only show once the surrounding sentences are in view.
Post-editing
A person who corrects the draft a system produced is post-editing it.
- For some uses the raw output is good enough: a text read once for its gist, or a site where the reader is told that the translation was generated. In the many cases where a wrong sentence has a cost, the output is a draft whatever produced it, a neural system or a chatbot, and it has to be checked against the source, because a fluent sentence does not show where it is wrong (see also the Checking the answer page, in the Using LLMs module) (voir aussi la page Vérifier la réponse, dans le module Utiliser les GML).
- The errors to expect depend on the generation that produced the draft: a term rendered by its most common equivalent rather than the client’s, a calque of the source idiom, a number or a name silently changed, a pronoun resolved the wrong way.
- Some tools learn from the corrections as the work goes. In adaptive machine translation, each segment you validate is fed back into the system, which adjusts its next proposals. With a large language model large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. , the same effect comes from placing earlier translations from the memory in the prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. as examples (Moslem et al., 2023).
The destination of the text
Unless you run a local translation system, any machine translation system you use means that the texts you send for translation leave your computer and go to the provider’s servers. The provider’s terms, the plan and your settings decide what happens to them there (see also the Training, retention and privacy settings page, in the Using LLMs module) (voir aussi la page Entraînement, conservation et paramètres de confidentialité, dans le module Utiliser les GML). Decide where the text goes before a client’s confidential document is pasted anywhere.
Outil de TAO, service de traduction ou agent conversationnel
La traduction automatique est demandée depuis trois sortes d’endroits.
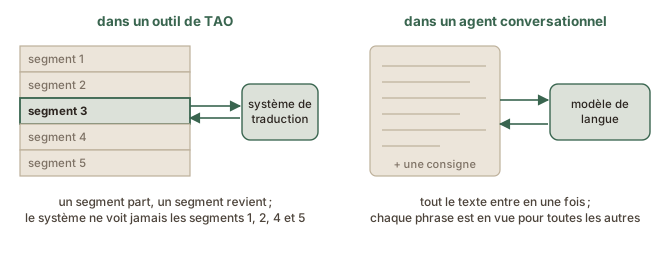
- Dans un outil de TAO. L’outil découpe le document en segments parce que sa mémoire de traduction fonctionne segment par segment, et la connexion de traduction automatique envoie ces mêmes segments, un à la fois : le système reçoit donc une phrase, sans rien avant ni après. Seuls les traducteurs professionnels travaillent ainsi (see also the Wordfast: tags and machine translation chapter, in the CAT tools module) (voir aussi le chapitre Wordfast : balises et traduction automatique, dans le module Outils de TAO).
- Sur un service de traduction, un site web ou une application, n’importe qui colle une phrase, un paragraphe ou un fichier entier.
- Dans un agent conversationnel, le texte entier entre avec une consigne.
La génération du système décide de la part du texte environnant qu’il utilise. Les systèmes statistiques et neuronaux traduisent une phrase à la fois, quoi qu’on leur donne : un document collé dans un service de cette génération est découpé en phrases, et chacune est traduite isolément, comme elle le serait dans un outil de TAO (see also the Neural translation page) (voir aussi la page La traduction neuronale). Un grand modèle de langue peut prendre le texte entier pour unité ; les phrases voisines sont alors en vue, et les erreurs changent avec elles. La Figure 5figure 5 montre les deux extrêmes.
La paire de phrases ci-dessous montre le premier type d’erreur. Un système qui ne reçoit que la première phrase n’a aucun moyen de trancher le genre de la personne, que le français doit pourtant marquer pour écrire ingénieur ou ingénieure ; la deuxième phrase le tranche.
I spoke to the engineer this morning. She will send the drawings on Friday.
Läubli et al. (2018) ont constaté que les évaluateurs qui comparaient des documents entiers préféraient la traduction humaine plus nettement que ceux qui comparaient des phrases isolées : certaines erreurs d’un système fluide n’apparaissent que lorsque les phrases voisines sont en vue.
La postédition
Une personne qui corrige le brouillon produit par un système fait de la postédition.
- Pour certains usages, le résultat brut suffit : un texte lu une fois pour en saisir l’essentiel, ou un site où le lecteur est averti que la traduction a été générée. Dans les nombreux cas où une phrase erronée a un coût, le résultat est un brouillon, quel que soit le système qui l’a produit, système neuronal ou agent conversationnel, et il doit être vérifié par rapport à la source, parce qu’une phrase fluide ne montre pas où elle est fausse (see also the Checking the answer page, in the Using LLMs module) (voir aussi la page Vérifier la réponse, dans le module Utiliser les GML).
- Les erreurs à prévoir dépendent de la génération qui a produit le brouillon : un terme rendu par son équivalent le plus courant plutôt que par celui du client, un calque de l’expression idiomatique de la source, un nombre ou un nom changé sans avertissement, un pronom résolu dans le mauvais sens.
- Certains outils apprennent des corrections au fil du travail. En traduction automatique adaptative, chaque segment que vous validez est renvoyé au système, qui ajuste ses propositions suivantes. Avec un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. , le même effet s’obtient en plaçant dans la requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. , comme exemples, des traductions antérieures tirées de la mémoire (Moslem et al., 2023).
La destination du texte
À moins d’utiliser un système de traduction local, tout système de traduction automatique que vous employez implique que les textes que vous envoyez à traduire quittent votre ordinateur pour les serveurs du fournisseur. Les conditions du fournisseur, le forfait et vos réglages décident de ce qu’il en advient (see also the Training, retention and privacy settings page, in the Using LLMs module) (voir aussi la page Entraînement, conservation et paramètres de confidentialité, dans le module Utiliser les GML). Décidez où le texte va avant de coller le document confidentiel d’un client où que ce soit.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Läubli, S., Sennrich, R., & Volk, M. (2018). Has machine translation achieved human parity? A case for document-level evaluation. Proceedings of EMNLP 2018, 4791–4796. https://aclanthology.org/D18-1512/
- Moslem, Y., Haque, R., Kelleher, J. D., & Way, A. (2023). Adaptive Machine Translation with Large Language Models. Proceedings of the 24th Annual Conference of the European Association for Machine Translation (EAMT 2023), 227–237. https://aclanthology.org/2023.eamt-1.22/