The company a word keepsLa compagnie que tient un mot
TRA6008 S2 · in classS2 · en classe
Five blanks
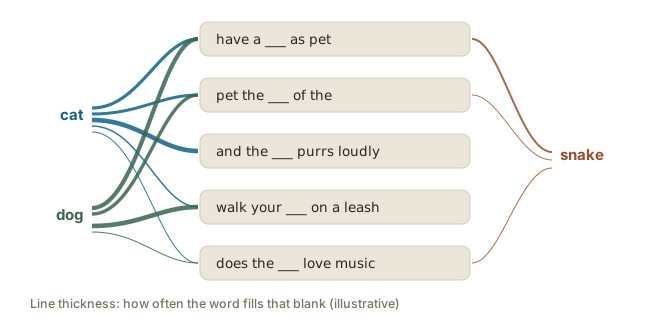
Suppose you are given five fragments of text, each with one word missing:
- have a ___ as pet
- pet the ___ of the
- and the ___ purrs loudly
- walk your ___ on a leash
- does the ___ love music
Which words could fill the blank? Cat goes into the first three without any trouble; the leash makes you hesitate. Dog goes into the pet, the petting and the leash, and fails at the purring. The last fragment takes any of them, which is why it tells you so little. So the two words share most of their contexts, and the ones they do not share are exactly the ones you would expect: a cat purrs, a dog is walked.
Now try snake. It fits have a ___ as pet, and after that it gets harder: a snake does not purr, and a snake on a leash is a very big stretch. Snake shares one or two contexts with cat and dog and not the rest. A word like democracy fits none of the five.
Not only whether a word can fill a blank counts, but how often it does. Cat turns up before purrs far more often than after walk your, and a system that counts contexts in a large collection of text sees that difference directly.
What the blanks show
Words with related meanings turn up in similar contexts, and the more two words’ contexts overlap, the closer their meanings tend to be. Linguists formulated this in the 1950s, Joos, Harris and Firth among them (Jurafsky & Martin, 2026), and Firth put it in one sentence: “You shall know a word by the company it keeps” (Firth, 1957).
Why this suits a machine
The idea is useful for a machine because of what it does not require:
- No definitions. Nobody has to say what cat means.
- No labels. Nobody has to mark examples by hand.
- No hand-picked axes. Nobody chooses the dimensions of the space, or where each word goes on them.
It does require text, in quantity. Contexts are observable: any large collection of text shows directly which words surround which. So a system can build a workable stand-in for meaning just by reading enough text.
Cinq trous
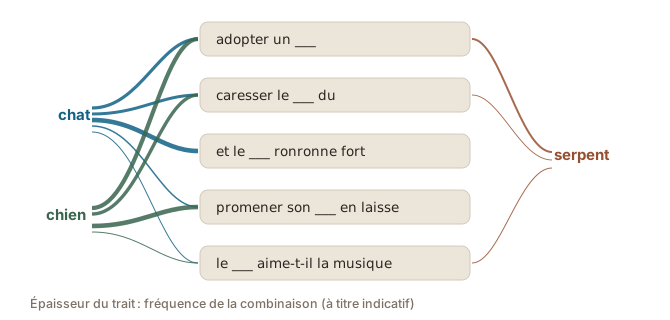
Supposons qu’on vous donne cinq fragments de texte, chacun avec un mot manquant :
- adopter un ___
- caresser le ___ du
- et le ___ ronronne fort
- promener son ___ en laisse
- le ___ aime-t-il la musique
Quels mots pourraient remplir le trou ? Chat entre sans peine dans les trois premiers ; la laisse fait hésiter. Chien entre dans l’adoption, la caresse et la laisse, et échoue sur le ronronnement. Le dernier fragment accepte n’importe lequel des trois, et c’est pourquoi il vous apprend si peu. Les deux mots partagent donc la plupart de leurs contextes, et ceux qu’ils ne partagent pas sont exactement ceux qu’on attendrait : un chat ronronne, on promène un chien.
Essayez maintenant serpent. Il va avec adopter un ___, et ensuite, cela se complique : un serpent ne ronronne pas, et un serpent en laisse, c’est vraiment tiré par les cheveux. Serpent partage un ou deux contextes avec chat et chien, et pas le reste. Un mot comme démocratie ne remplit aucun des cinq.
Il ne suffit pas qu’un mot puisse remplir un trou : la fréquence à laquelle il le fait compte aussi. Chat précède ronronne bien plus souvent qu’il ne suit promener son, et un système qui compte les contextes dans un grand ensemble de textes voit cette différence directement.
Ce que montrent les trous
Les mots dont le sens est apparenté apparaissent dans des contextes semblables, et plus les contextes de deux mots se recoupent, plus leurs sens ont tendance à être proches. Des linguistes l’ont formulé dans les années 1950, Joos, Harris et Firth parmi eux (Jurafsky et Martin, 2026), et Firth l’a résumé en une phrase : « You shall know a word by the company it keeps » (Firth, 1957).
Pourquoi cela convient à une machine
L’idée est utile à une machine par ce qu’elle n’exige pas :
- Aucune définition. Personne n’a à dire ce que chat veut dire.
- Aucune annotation. Personne n’a à marquer des exemples à la main.
- Aucun axe choisi à la main. Personne ne choisit les dimensions de l’espace, ni la place de chaque mot sur celles-ci.
Il faut en revanche du texte, en quantité. Les contextes sont observables : n’importe quel grand ensemble de textes montre directement quels mots entourent quels autres. Un système peut donc se construire un substitut utilisable du sens simplement en lisant assez de texte.
Sources
- Firth, J. R. (1957). A synopsis of linguistic theory 1930–1955. Studies in Linguistic Analysis (Special volume of the Philological Society), Blackwell, 1–32. https://quoteinvestigator.com/2022/09/18/word-company/
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/