Spelling and countingÉpeler et compter
TRA6008 OptionalFacultatif
Mocking GPT-4o’s letter-counting skills
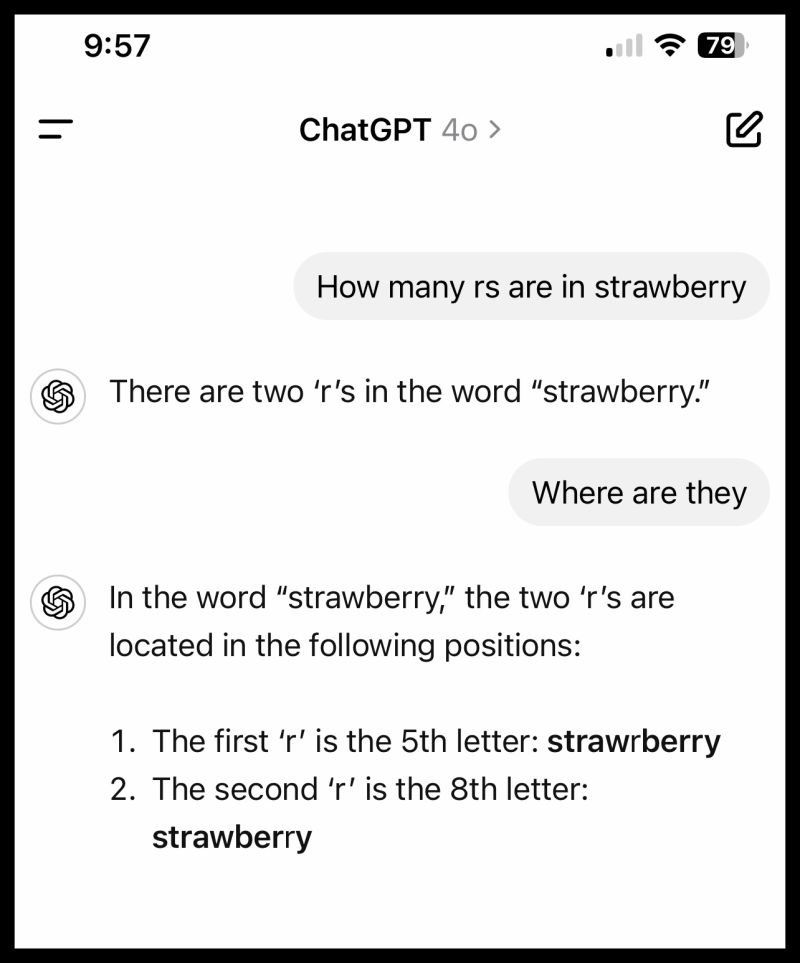
In mid-2024 a question made the rounds online: how many rs are there in strawberry? GPT-4o, a model for which there was a lot of media attention and hype because it was supposed to be so intelligent and impressive, stubbornly insisted there were only two. The discrepancy made the example go viral: this model was able to do much more than humans in some senses, but could not perform this basic counting task?!
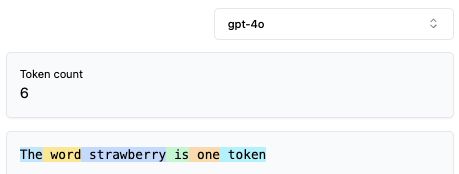
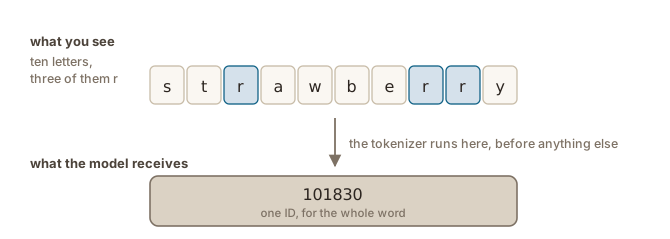
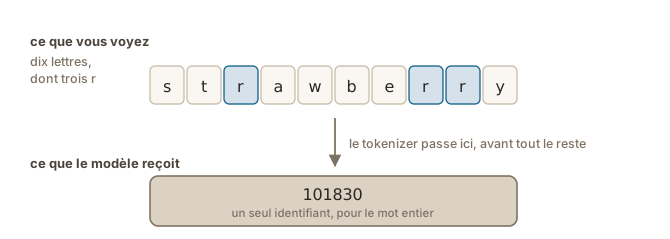
The explanation is the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. . The model never sees s-t-r-a-w-b-e-r-r-y. Inside a sentence, which is how the question reaches it, strawberry is one token, and what reaches the model is that token’s number. A number says nothing about the shape of the word it stands for: not how many letters it has, not which ones, not their order. The model has no explicit information about spelling at all. Everything it knows about a token comes from the contexts in which that token appeared in its training text, so what it knows about the spelling of strawberry is whatever the text said about it, in words, the way it knows the capital of a country.
Knowing a spelling and using it
Edman et al. (2024) tested this systematically. Asked to spell out a frequent word letter by letter, the models they tested got it nearly always right: text about spelling is in the training data training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. , and the model has learned, as a fact about the token, what letters it stands for. Asked to do something with those letters, whether a word contains a given letter, what it becomes if every e is deleted or if two letters are swapped, the same models failed, while managing the same operations on whole words. The gap between the word-level and the letter-level version of one task reached 73 points of accuracy accuracyexactitude evaluationévaluation The share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. .
The same limit affects every task that works on letters: spelling a word backwards, counting characters for a length limit, building an acronym from initials, judging a rhyme from its spelling.
The same question two years later
Asked the same question on 11 September 2026, ChatGPT and Claude both answer three.
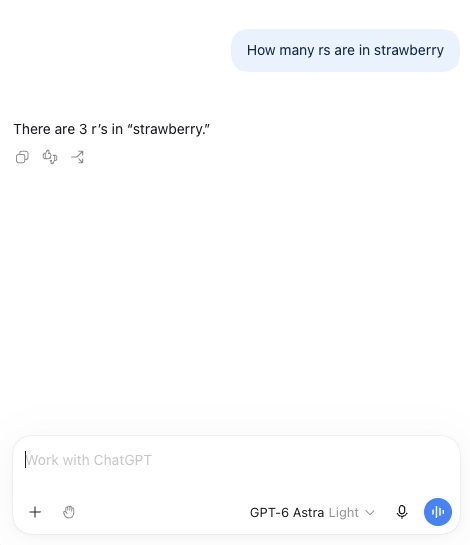
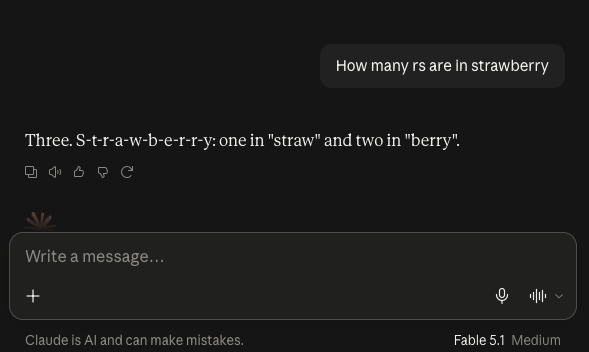
Does this mean the models of 2026 are better than GPT-4o? They are a lot better, but this question is not the proof of it. A failure this famous ends up in the training data, and a rule may well have been added so that this one question gets a good answer. The mechanism has not changed: the model still receives tokens, and a rarer word, another letter or another language can find the same limit again.
Can they spell better, then? Yes, but they can still make mistakes. Anecdotally, what I notice in my own use is that models have become much more likely to spot a spelling error or a typo when I ask them to review a document, which they were poor at two years ago.
A third possibility is that a system answers a question like this by writing a few lines of code and running them. That would be overkill here, and neither system did it, but models are much better at writing code than at giving exact answers about letters, and the harnesses now built around them let them call a tool when one is relevant.
Se moquer de GPT-4o, qui ne sait pas compter les lettres
Au milieu de 2024, une question a circulé en ligne : combien y a-t-il de r dans strawberry ? GPT-4o, un modèle qui avait reçu beaucoup d’attention médiatique et suscité beaucoup d’enthousiasme parce qu’il était censé être si intelligent et si impressionnant, soutenait obstinément qu’il n’y en avait que deux. Le décalage a rendu l’exemple viral : ce modèle pouvait faire bien plus que les humains à certains égards, mais n’arrivait pas à accomplir cette tâche de comptage élémentaire ?!
L’explication est le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. . Le modèle ne voit jamais s-t-r-a-w-b-e-r-r-y. Dans une phrase, et c’est ainsi que la question lui parvient, strawberry est un seul jeton, et ce qui parvient au modèle est le numéro de ce jeton. Un numéro ne dit rien de la forme du mot qu’il représente : ni combien de lettres il compte, ni lesquelles, ni leur ordre. Le modèle n’a aucune information explicite sur l’orthographe. Tout ce qu’il sait d’un jeton vient des contextes dans lesquels ce jeton est apparu dans ses textes d’entraînement ; ce qu’il sait de l’orthographe de strawberry est donc ce que les textes en ont dit, en mots, de la même façon qu’il connaît la capitale d’un pays.
Connaître une orthographe et s’en servir
Edman et al. (2024) ont testé cela systématiquement. Invités à épeler un mot fréquent lettre par lettre, les modèles testés y arrivaient presque toujours : des textes sur l’orthographe figurent dans les données d’entraînement training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. , et le modèle a appris, comme un fait à propos du jeton, quelles lettres il représente. Invités à faire quelque chose de ces lettres, dire si un mot contient une lettre donnée, ce qu’il devient si chaque e est supprimé ou si deux lettres sont interverties, les mêmes modèles échouaient, alors qu’ils réussissaient les mêmes opérations sur des mots entiers. L’écart entre la version au niveau des mots et la version au niveau des lettres d’une même tâche atteignait 73 points d’exactitude accuracyexactitude evaluationévaluation The share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. .
La même limite touche toute tâche qui porte sur les lettres : épeler un mot à l’envers, compter des caractères pour respecter une longueur maximale, former un acronyme à partir d’initiales, juger d’une rime d’après l’orthographe.
La même question deux ans plus tard
Posée le 11 septembre 2026, la même question reçoit la réponse « trois » de ChatGPT comme de Claude.
Cela veut-il dire que les modèles de 2026 sont meilleurs que GPT-4o ? Ils sont bien meilleurs, mais cette question n’en est pas la preuve. Un échec aussi célèbre finit dans les données d’entraînement, et une règle a fort bien pu être ajoutée pour que cette question précise reçoive une bonne réponse. Le mécanisme n’a pas changé : le modèle reçoit toujours des jetons, et un mot plus rare, une autre lettre ou une autre langue peut retrouver la même limite.
Épellent-ils mieux, alors ? Oui, mais ils peuvent encore se tromper. De façon anecdotique, ce que je constate dans mon propre usage, c’est que les modèles sont devenus beaucoup plus susceptibles de repérer une faute d’orthographe ou une coquille quand je leur demande de réviser un document, ce qu’ils faisaient mal il y a deux ans.
Une troisième possibilité est qu’un système réponde à une question comme celle-ci en écrivant quelques lignes de code et en les exécutant. Ce serait disproportionné ici, et aucun des deux systèmes ne l’a fait, mais les modèles sont bien meilleurs pour écrire du code que pour donner des réponses exactes sur des lettres, et les environnements construits autour d’eux leur permettent désormais d’appeler un outil quand c’est pertinent.
Sources
- Edman, L., Schmid, H., & Fraser, A. (2024). CUTE: Measuring LLMs' Understanding of Their Tokens. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 3017–3026. https://aclanthology.org/2024.emnlp-main.177/
Sources
- Edman, L., Schmid, H., & Fraser, A. (2024). CUTE: Measuring LLMs' Understanding of Their Tokens. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 3017–3026. https://aclanthology.org/2024.emnlp-main.177/