PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
🔒 TRA6008 · Project briefsTRA6008 · Consignes des projetsis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
TRA6008 · Project briefsTRA6008 · Consignes des projets
Project 1 · Terminology: the full instructionsProjet 1 · Terminologie : les consignes complètes
Le calendrier du projet
lun.mar.mer.jeu.ven.sam.dim.
Séance 4 · Projet 1 : présentation du travail de projet, questionnaire de profil, début de l'annotation, formation des équipes
Échéance · Réponse à la question du consentement (AnnoTerm) (envoyée en classe le 3 septembre 2026)
Évaluation · Annotation du Projet 1 et questionnaire de fin de tâche (23 h 59)
Séance 5 · Projet 1 : calcul de l'accord, précision, rappel et F1, retour sur la notion de terme et sur l'extraction automatique
Échéance · Module sur l'extraction terminologique (à lire avant la séance, une fois l'annotation remise)
Évaluation · Parcours sur les formats d'échange (23 h 59)
Séance 6, évaluation · Présentations du Projet 1
Échéance · Listes de TermoStat et de l'agent, par équipe (par courriel, au plus tard à 23 h 59, avec les diapositives s'il y en a)
Pas de cours (période d'activités libres)
Évaluation · Rapports du Projet 1 (23 h 59, sur StudiUM)
14 séance
28 évaluation
30 autre échéance
5 jeudi sans cours
Ce que demande le projet
Le premier projet porte sur l’extraction de termes, en trois temps :
Annoter : vous marquez vous-même, dans dix textes, ce qui est un terme
et ce qui n’en est pas.
Comparer : vous mettez vos décisions à côté de celles des huit autres
personnes, et vous mesurez l’écart.
Évaluer : vous faites travailler un outil d’extraction et un agent
conversationnel sur les mêmes textes, et vous jugez ce qu’ils produisent.
Les équipes : trois équipes de trois, formées à la séance 4, chacune avec
un agent conversationnel différent (Claude, ChatGPT ou Gemini), pour comparer
les résultats d’une équipe à l’autre. L’équipe à qui revient Gemini peut
proposer un autre agent, à condition qu’il repose sur une autre famille de
modèles.
L’annotation, terminée le 4 octobre 2026
L’annotation s’est faite individuellement et en silence, sur INCEpTION, avec
deux questionnaires, de profil et de fin de tâche. Les consignes d’annotation
servent encore pour la section 1 du rapport individuel :
Les règles sur les ressources permises pendant l’annotation sont les plus strictes du trimestre, et c’est voulu. La tâche
consiste à décider vous-même, texte en main, ce qui est un terme et ce qui n’en
est pas. Un outil qui vous propose des candidats ne vous aide pas à faire
cette tâche : il la fait à votre place, et ce qu’il produit n’est plus votre
jugement. Or c’est votre jugement, et son écart avec celui des autres, que le
projet mesure. La règle courte : vous pouvez poser des questions sur un mot,
pas sur le texte. Tout ce qui vous aide à comprendre la langue et le domaine
est permis ; tout ce qui vous suggère quoi annoter est interdit.
Permis :
consulter un dictionnaire, TERMIUM Plus, le GDT, une encyclopédie, une
recherche générale sur le domaine ;
demander à un agent conversationnel ce que veut dire un mot, dans quel
domaine il s’emploie, quelle est sa catégorie grammaticale dans une phrase
donnée, ou de vous en donner des exemples d’usage ;
relire les consignes d’annotation autant de fois que nécessaire, et me poser
des questions dessus.
Interdit :
demander à un agent conversationnel quels mots d’un passage sont des termes,
d’extraire les termes d’un texte, d’en tirer une liste de candidats ou de
mots-clés, sous quelque formulation que ce soit ;
coller tout ou partie des textes du projet dans un agent conversationnel pour
lui demander de les analyser ;
utiliser un extracteur de termes ou une fonction d’extraction de mots-clés
sur les textes du projet ;
chercher une version déjà annotée des textes, ou une liste de termes déjà
publiée pour ces documents précis ;
comparer votre annotation avec celle d’une autre personne avant l’échéance.
Deux exemples :
Permis : vous rencontrez « débit de dose » dans le texte, sans savoir ce
que c’est. Vous demandez à un agent conversationnel ce que l’expression
désigne, et il vous répond que c’est une quantité de rayonnement reçue par
unité de temps. Vous décidez ensuite vous-même si c’est un terme du domaine
au sens des consignes.
Interdit : vous collez le paragraphe qui contient « débit de dose » et
vous demandez quels éléments du paragraphe sont des termes techniques. Peu
importe que vous suiviez ou non la réponse : la tâche est faite.
Ce qui est interdit avant l’échéance devient le cœur du
travail après : le troisième temps consiste justement à faire travailler un outil et un
agent sur les mêmes textes. Si vous vous demandez si un usage précis est
permis, posez-moi la question avant plutôt qu’après.
La dimension recherche
L’annotation du Projet 1 sert aussi de premier groupe d’annotateurs à une
étude que je mène sur l’annotation terminologique, AnnoTerm. Votre charge de
travail et votre note sont exactement les mêmes que vous participiez à l’étude
ou non : le projet compte pour 20 %, il est corrigé selon les mêmes critères,
et rien dans la correction ne dépend de votre décision.
Ce qui change, en revanche, c’est la forme de la tâche. Plusieurs
contraintes du Projet 1 viennent de l’étude et non de la pédagogie, et une
contrainte dont on connaît la raison se supporte mieux qu’une contrainte
arbitraire :
les textes sont fixés et identiques pour tout le monde ;
la plateforme est imposée ;
la consigne d’annotation est unique et ne se négocie pas ;
il est interdit d’en discuter avant la remise ;
l’échéance est ferme ;
les outils qui proposent des candidats sont interdits.
Sur quoi porte le consentement
Le projet, vous le faites en entier dans tous les cas. Le consentement porte
sur une seule chose : que vos données servent aussi à l’étude que nous
comptons publier. Vous pouvez donc faire tout le projet et refuser cela. La
question vous a été envoyée pendant la séance du 3 septembre 2026, par un courriel de
Noah Tremblay Taillon menant à un questionnaire LimeSurvey ; votre réponse est
attendue pour le 1er octobre 2026. Elle ne passe pas par moi : je n’ai pas accès aux
réponses, et je n’apprends qu’après la remise des notes finales qui a consenti
à l’étude et qui n’y a pas consenti.
Les deux questionnaires du projet, eux, sont des travaux de cours, et je vois
vos réponses comme je vois vos annotations. La seule chose que je ne vois
pas, c’est votre réponse à la question du consentement.
Retirer son consentement
Vous pouvez retirer votre consentement jusqu’au 1er novembre 2026, sans avoir à
vous justifier et sans aucune conséquence sur le cours. La demande passe par
Noah, jamais par moi. Ce retrait ne vous retire pas du projet, qui reste noté
comme pour tout le monde : il veut dire seulement que vos données ne serviront
pas à l’étude publiée.
L’encadrement éthique
L’étude a reçu l’approbation du comité d’éthique de la recherche en arts et en
humanités le 24 août 2026 (dossier 2026-8835, CERAH). Elle est financée par le
FRQNT (2025-NCM-362349).
This page is only available in French.
Automatic term extraction (from rules to large language models)Extraction automatique de termes (des règles aux grands modèles de langue)
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
A term is a single unit. The word terminology is used in two
senses: the set of all the terms of a domain (the terminology of dressage),
and the discipline that studies terms and how to record them.
Terms take up a real share of a translator’s time. In studies from the
2000s, translators estimated that they spent roughly 15 to 30% of their
working time on terminology, most of it on looking terms up (Champagne,
2004; Gornostay, 2010).Both studies date from before neural
machine translation and large language models, and no comparable figures
for today’s tools are cited here. The share depends on the
translator and on the field: in Champagne’s study it was highest in
financial institutions and lowest in language firms, and the participants
put it at 40 to 60% for a translator new to the job. Translating a term
often takes knowledge of the domain as well as of the two languages.
Translators are therefore among the main users of terminological resources
such as termbases and glossaries.
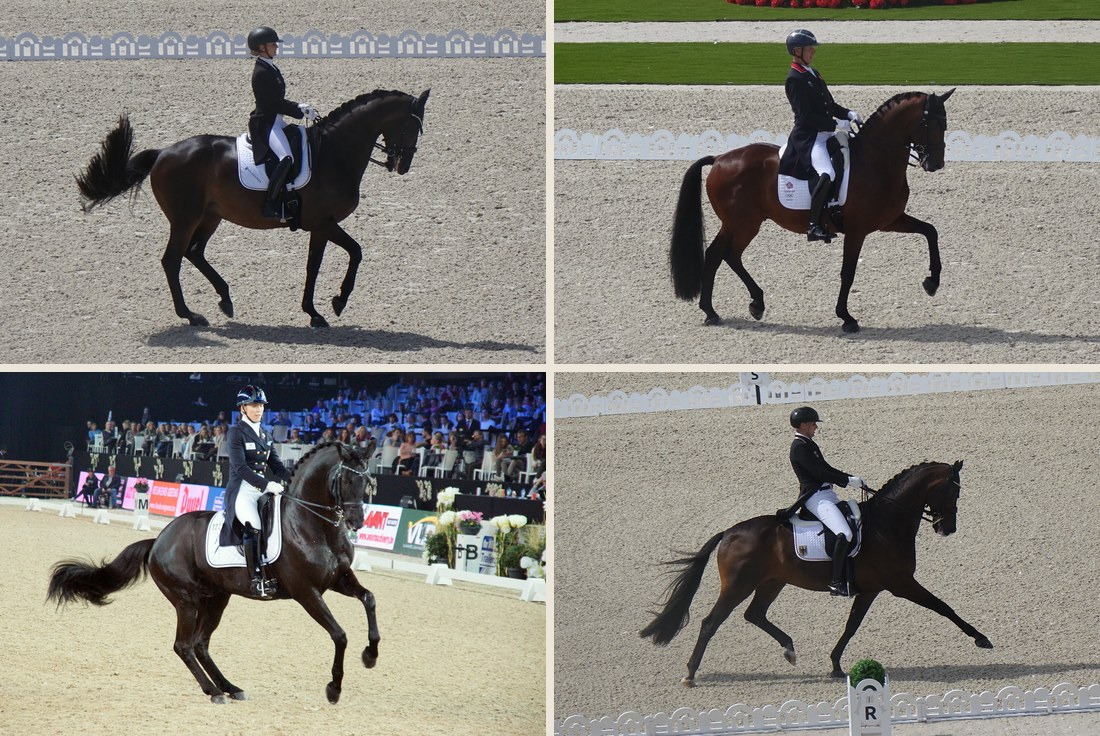
Figure 1figure 1 shows four of the movements that dressage terms name.The photographs are from
Wikimedia Commons, cropped and resized: the piaffe,
the passage
and the extended trot
by Eponimm, under CC BY 4.0;
the canter pirouette
by World Dressage Masters, under CC BY 2.0.
Figure 1. Four movements of dressage, each with a term of its own: piaffe and passage (top), canter pirouette and extended trot (bottom). Photographs by Eponimm (CC BY 4.0) and World Dressage Masters (CC BY 2.0), Wikimedia Commons.
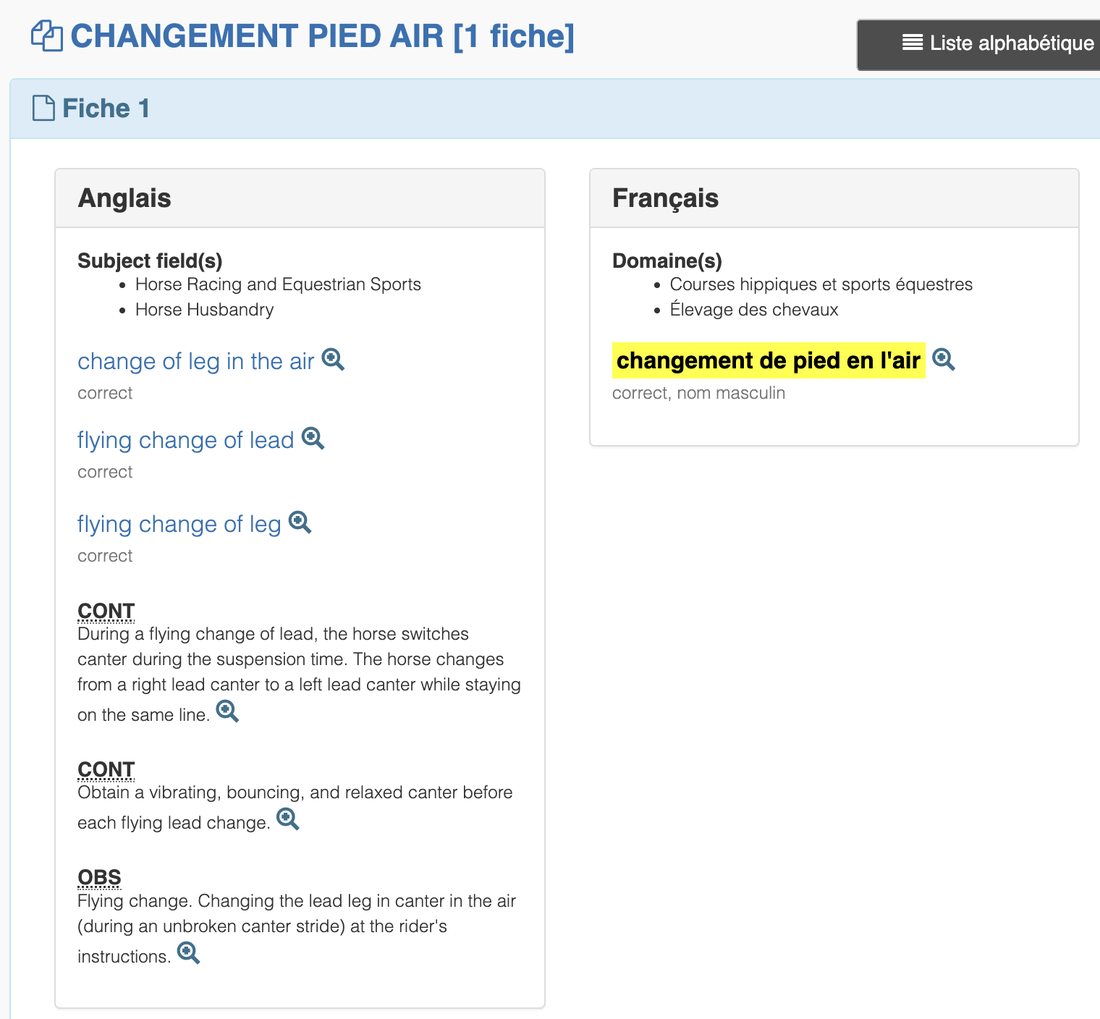
Terms are often recorded in termbases, which tend to organize them by
concept. In a multilingual termbase, you can then see the terms used for one
concept in several languages. The example in Figure 2figure 2, taken from TERMIUM Plus, also shows that the ideal of one term per concept
in each language is often not reached in practice: the record suggests three
English terms for a single French one.
Figure 2. A term bank record, here TERMIUM Plus (read 30 September 2026): one concept, the terms that name it in each language, its subject field, and contexts.
Terms of several words
In the texts a translator works on, many terms are longer than one word.
Flying change names one movement, in which the horse changes its leading
leg in the air between two strides of canter, and its meaning does not follow
from flying and change looked up separately. Recognizing a term therefore
includes deciding where it starts and where it ends: in “the collected canter
pirouette”, you might record canter pirouette, collected canter,
canter, pirouette, or all four.
Sources
Champagne, G. (2004). The Economic Value of Terminology: an Exploratory Study. Report submitted to the Translation Bureau of Canada, 30 April 2004. Guy Champagne Inc., Montreal.
Gornostay, T. (2010). Terminology Management in Real Use. Proceedings of the 5th International Biannual Conference “Applied Linguistics in Research and Education” in Memoriam Rajmund Piotrowski (1922-2009), Saint Petersburg.
ISO (2019). ISO 1087:2019 Terminology work and terminology science — Vocabulary. International Organization for Standardization, 2nd ed.. https://www.iso.org/standard/62330.html
Un terme est une unité. Le mot terminologie s’emploie en deux sens :
l’ensemble des termes d’un domaine (la terminologie du dressage), et la
discipline qui étudie les termes et la façon de les consigner.
Les termes occupent une part réelle du temps de traduction. Dans des études
des années 2000, des traducteurs estimaient consacrer de 15 à 30 % environ
de leur temps de travail à la terminologie, surtout à la recherche de termes
(Champagne, 2004 ; Gornostay, 2010).Les deux études datent
d’avant la traduction automatique neuronale et les grands modèles de langue,
et aucun chiffre comparable pour les outils d’aujourd’hui n’est cité
ici. Cette part dépend de la personne et du secteur : dans l’étude
de Champagne, elle était la plus élevée dans les institutions financières et
la plus faible dans les cabinets de traduction, et les participants
l’estimaient à 40 à 60 % pour une personne qui débute dans le métier.
Traduire un terme demande souvent de connaître le domaine, en plus des deux
langues. Les traducteurs comptent donc parmi les principaux utilisateurs de
ressources terminologiques comme les bases terminologiques et les
glossaires.
La Figure 1figure 1 montre quatre des mouvements que désignent les termes du dressage.Les photographies viennent
de Wikimedia Commons, recadrées et redimensionnées : le piaffer,
le passage
et le trot allongé
par Eponimm, sous licence CC BY 4.0 ;
la pirouette au galop
par World Dressage Masters, sous licence CC BY 2.0.
Figure 1. Quatre mouvements du dressage, chacun avec son terme : piaffer et passage (en haut), pirouette au galop et trot allongé (en bas). Photographies d'Eponimm (CC BY 4.0) et de World Dressage Masters (CC BY 2.0), Wikimedia Commons.
Les termes sont souvent consignés dans des bases terminologiques, qui tendent
à les organiser par concept. Dans une base multilingue, vous voyez alors les
termes employés pour un même concept dans plusieurs langues. L’exemple de la
Figure 2figure 2, tiré de TERMIUM Plus, montre aussi que l’idéal d’un seul terme par
concept dans chaque langue ne se vérifie souvent pas en pratique : la fiche
propose trois termes anglais pour un seul terme français.
Figure 2. Une fiche de banque terminologique, ici TERMIUM Plus (consultée le 30 septembre 2026) : un concept, les termes qui le désignent dans chaque langue, son domaine et des contextes.
Les termes de plusieurs mots
Dans les textes sur lesquels travaille une traductrice ou un traducteur,
beaucoup de termes dépassent un mot. Changement de pied désigne un seul
mouvement, dans lequel le cheval change de pied en l’air entre deux foulées
de galop, et son sens ne se déduit pas de changement et de pied cherchés
séparément. Reconnaître un terme suppose donc de décider où il commence et où
il finit : dans « la pirouette au galop rassemblé », vous pourriez consigner
pirouette au galop, galop rassemblé, galop, pirouette, ou les quatre.
Sources
Champagne, G. (2004). The Economic Value of Terminology: an Exploratory Study. Report submitted to the Translation Bureau of Canada, 30 avril 2004. Guy Champagne Inc., Montreal.
Gornostay, T. (2010). Terminology Management in Real Use. Proceedings of the 5th International Biannual Conference “Applied Linguistics in Research and Education” in Memoriam Rajmund Piotrowski (1922-2009), Saint Petersburg.
ISO (2019). ISO 1087:2019 Terminology work and terminology science — Vocabulary. International Organization for Standardization, 2nd ed.. https://www.iso.org/standard/62330.html
Where people disagree about termsLes points de désaccord sur les termes
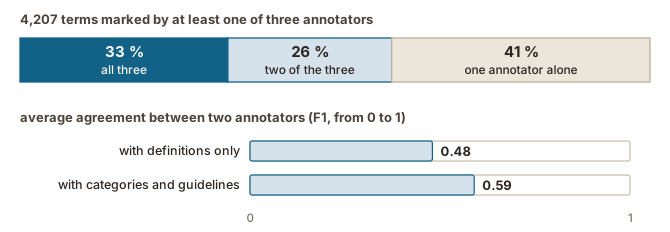
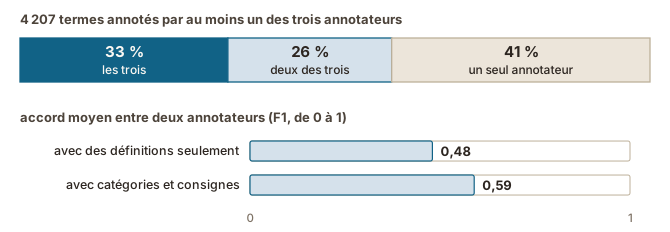
Figure 3. Three annotators on the same texts: the share of terms marked by all three, by two and by one, and the average agreement between two annotators depending on what they were given (Rigouts Terryn et al., 2020a).
Term boundaries
In “the horse moves on in posting trot”, is the term posting trot, trot,
posting, or all three? There is no universally correct answer to that
question, so this is where annotation guidelines can reduce some of the
variation. The guidelines of the ACTER dataset, for instance, answer “all three”: when
part of a longer term is a term in its own right, the longer term and the
shorter one are both marked. In the dressage texts, posting
trot was marked as a whole, and posting and trot were marked as well
(Rigouts Terryn, 2021a).
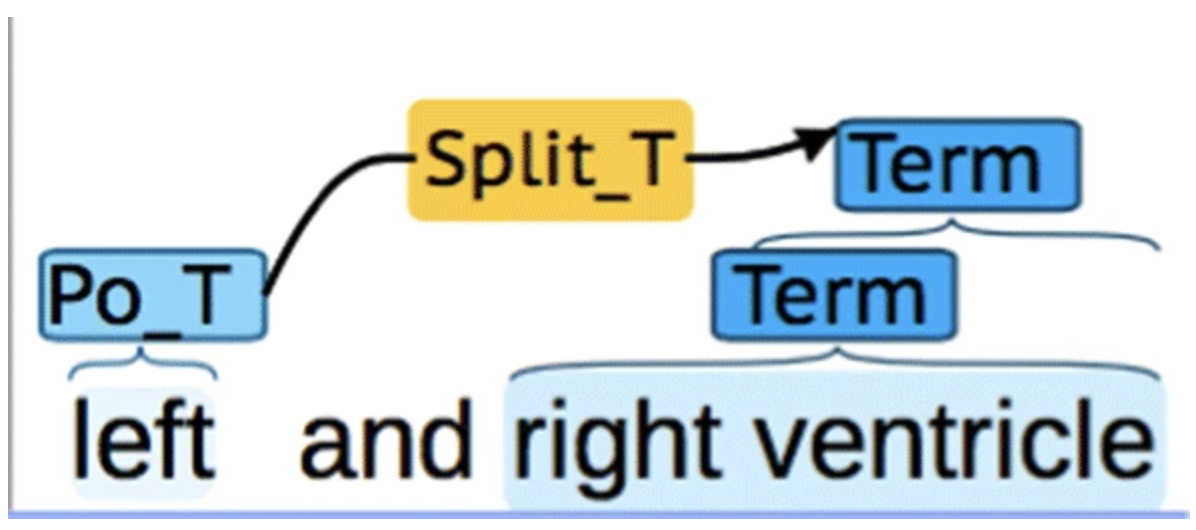
Other annotation schemes keep only the longest unit (Liu et al., 2025). Terms interrupted by other words
are another case to settle: in “collected and extended trot”, collected trot
is there in meaning but never appears as such in the text.
Figure 4figure 4 shows both cases as an annotation tool records them.
Figure 4. Nested and split terms in the BRAT annotation tool, from the annotation of a term extraction dataset: ventricle inside right ventricle, and left ventricle, which the text never writes in full, recorded as a part linked to the term it belongs to (Rigouts Terryn et al., 2020a).
Everyday words with a specialized sense
Some terms look like ordinary words; the table below gives three from
dressage. A reader who does not know the domain reads straight past them;
for a translator, they are exactly the words that need checking.
Word
Everyday sense
In dressage
collection
a set of objects
the way a horse shifts its weight towards its hindquarters and shortens its strides; collected and collect follow it
contact
touching, or being in touch
the connection between the rider’s hands and the horse’s mouth through the reins
passage
a way through, or an extract from a text
a movement: a very collected, elevated trot
Three dressage terms that look like everyday words.
Annotators also disagree about how specialized a unit has to be to count as
a term. One way to make that decision explicit is to ask two separate
questions, as the ACTER guidelines do (Rigouts Terryn, 2021a):
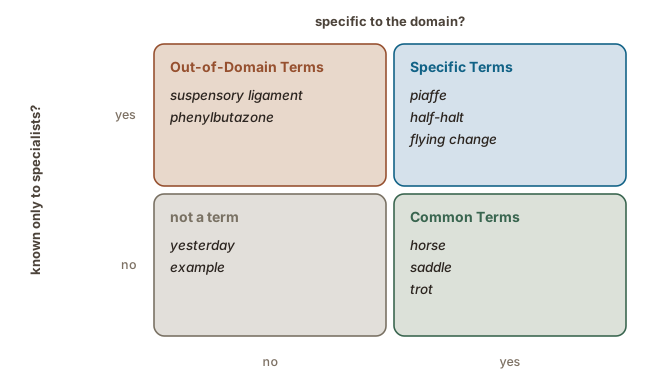
Is it specific to the domain? Does the unit relate to the subject of the
texts? This dimension is called domain specificity.
Is it specific in the lexicon? Is it known only to specialists, or is it
part of everyday vocabulary? This dimension is called lexicon specificity.
Different term labels can be defined from these two dimensions.
Figure 5figure 5 shows the three labels of the ACTER scheme: a unit that is specific on
both dimensions is a Specific Term, one that is specific to the domain only
is a Common Term, and one that is specific in the lexicon only is an
Out-of-Domain Term.
Figure 5. The two questions of the ACTER annotation scheme and the three labels they give, with examples chosen for dressage (after Rigouts Terryn, 2021a).
Both answers depend on who is asking, and the edge of the domain is a
decision too. When the dressage texts were annotated, terms from other
equestrian sports, such as gymkhana or voltige (vaulting), were labelled
as out of the domain, because the domain was taken to be dressage rather than
riding as a whole (Rigouts Terryn et al., 2019).
Knowing a domain well does not settle it either. I annotated the dressage
texts myself, and I know the sport well: I understood the terminology without
effort, but found it harder to tell terms from general vocabulary, because
the terms had become part of my own everyday vocabulary (Rigouts Terryn et
al., 2020a).
Two ways of settling the cases
A project that needs a list of terms has to settle the cases annotators
disagree about, such as term boundaries and everyday words with a
specialized sense. It can do so in two broad ways.
Categories. A scheme such as ACTER’s keeps the disagreement visible by
giving each unit a label: one of the three term labels above, or Named
Entity. A list can then be made strict or broad afterwards, by choosing
which labels count.
Neither way removes the disagreement. Every list of terms depends on such
choices, whether a person or a tool made it, and two lists made with
different choices cannot simply be compared as right and wrong.
Sources
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Liu, S., Lefever, E., & Hoste, V. (2025). MariATE: Automatic Term Extraction Using Large Language Models in the Maritime Domain. Proceedings of the 15th International Conference on Recent Advances in Natural Language Processing (RANLP 2025), 663–673. https://aclanthology.org/2025.ranlp-1.77/
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Figure 3. Trois annotateurs sur les mêmes textes : la part des termes retenus par les trois, par deux et par un seul, et l'accord moyen entre deux annotateurs selon ce qui leur était fourni (Rigouts Terryn et al., 2020a).
Les frontières d’un terme
Dans « le cheval repart au trot enlevé », le terme est-il trot enlevé,
trot, enlevé, ou les trois ? Cette question n’a pas de réponse
universellement correcte, et c’est donc là que des consignes d’annotation
peuvent réduire une partie de la variation. Les consignes du jeu de données ACTER, par exemple, répondent « les trois » : quand
une partie d’un terme plus long est elle-même un terme, le terme long et le
terme court sont tous deux annotés. Dans les textes anglais sur le dressage, posting
trot (trot enlevé) a été annoté en entier, et posting et trot l’ont été aussi
(Rigouts Terryn, 2021a).
D’autres schémas d’annotation ne gardent que l’unité la plus longue (Liu et al., 2025). Les termes interrompus par d’autres mots
sont un autre cas à trancher : dans « trot rassemblé et allongé », trot allongé
est là par le sens, mais n’apparaît jamais tel quel dans le texte.
La Figure 4figure 4 montre les deux cas tels qu’un outil d’annotation les enregistre.
Figure 4. Termes imbriqués et termes scindés dans l'outil d'annotation BRAT, lors de l'annotation d'un jeu de données d'extraction de termes : ventricle à l'intérieur de right ventricle, et left ventricle, que le texte n'écrit jamais en entier, enregistré comme une partie reliée au terme auquel elle appartient (Rigouts Terryn et al., 2020a).
Les mots courants qui ont un sens spécialisé
Certains termes ressemblent à des mots ordinaires ; le tableau ci-dessous en
donne trois, tirés du dressage. Une personne qui ne connaît pas le domaine ne
s’y arrête pas ; pour un traducteur, ce sont justement les mots à vérifier.
Mot
Sens courant
En dressage
rassembler
réunir des personnes ou des choses
l’attitude d’un cheval qui reporte son poids vers l’arrière-main et raccourcit ses foulées ; rassemblé en vient
contact
le fait de toucher, ou d’être en relation
la liaison entre les mains du cavalier et la bouche du cheval, par les rênes
passage
un endroit où l’on passe, ou un extrait de texte
un mouvement : un trot très rassemblé et relevé
Trois termes du dressage qui ressemblent à des mots courants.
Les annotateurs ne s’accordent pas non plus sur le degré de spécialisation
qu’une unité doit avoir pour compter comme terme. Une façon de rendre cette
décision explicite consiste à poser deux questions distinctes, comme le font
les consignes d’ACTER (Rigouts Terryn, 2021a) :
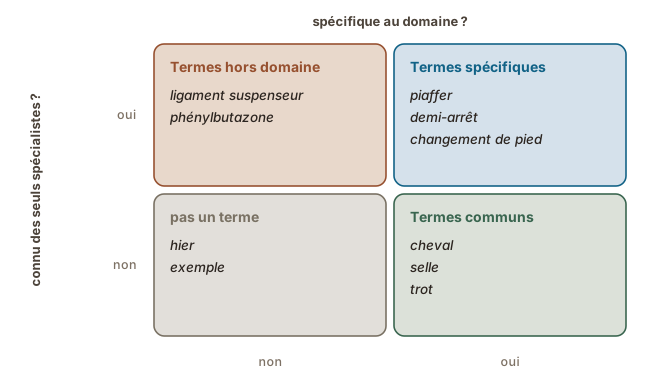
Est-elle spécifique au domaine ? L’unité se rapporte-t-elle au sujet des
textes ? Cette dimension s’appelle la spécificité au domaine.
Est-elle spécifique dans le lexique ? Est-elle connue des seuls spécialistes, ou
fait-elle partie du vocabulaire courant ? Cette dimension s’appelle la spécificité lexicale.
Ces deux dimensions permettent de définir différentes étiquettes de termes.
La Figure 5figure 5 montre les trois étiquettes du schéma d’ACTER : une unité spécifique sur
les deux dimensions est un terme spécifique (Specific Term), une unité spécifique au domaine seulement
est un terme commun (Common Term), et une unité spécifique dans le lexique seulement est un
terme hors domaine (Out-of-Domain Term).
Figure 5. Les deux questions du schéma d'annotation d'ACTER et les trois étiquettes qui en découlent, avec des exemples choisis pour le dressage (d'après Rigouts Terryn, 2021a).
Les deux réponses dépendent de la personne qui les donne, et la limite du domaine est
elle aussi une décision. Quand les textes sur le dressage ont été annotés, les termes d’autres
sports équestres, comme gymkhana ou voltige, ont été étiquetés
hors domaine, parce que le domaine retenu était le dressage et non
l’équitation dans son ensemble (Rigouts Terryn et al., 2019).
Bien connaître un domaine ne règle pas la question non plus. J’ai annoté moi-même les
textes sur le dressage, et je connais bien ce sport : je comprenais la terminologie sans
effort, mais j’avais plus de mal à distinguer les termes du vocabulaire général, parce que
ces termes faisaient désormais partie de mon vocabulaire courant (Rigouts Terryn et
al., 2020a).
Deux façons de trancher les cas
Un projet qui a besoin d’une liste de termes doit trancher les cas sur lesquels les annotateurs
ne s’accordent pas, comme les frontières d’un terme et les mots courants qui ont un
sens spécialisé. Il peut le faire de deux grandes façons.
Des catégories. Un schéma comme celui d’ACTER garde le désaccord visible en
donnant à chaque unité une étiquette : l’une des trois étiquettes de termes
ci-dessus, ou celle d’entité nommée. La liste peut ensuite être rendue stricte ou large,
selon les étiquettes retenues.
Aucune des deux façons ne supprime le désaccord. Toute liste de termes repose sur de tels
choix, qu’elle vienne d’une personne ou d’un outil, et deux listes établies avec
des choix différents ne peuvent pas simplement être comparées comme une bonne et une mauvaise.
Sources
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Liu, S., Lefever, E., & Hoste, V. (2025). MariATE: Automatic Term Extraction Using Large Language Models in the Maritime Domain. Proceedings of the 15th International Conference on Recent Advances in Natural Language Processing (RANLP 2025), 663–673. https://aclanthology.org/2025.ranlp-1.77/
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Term extraction as a taskL'extraction de termes comme tâche
Why extract terms
A list of the terms in a set of texts is useful in several kinds of work,
for instance:
for a translator, the terms in a client’s earlier documents show the
terminology that client uses;
the terms in a text you are about to translate can be looked up and settled
in one go before you start, where you would otherwise stop to research each
term as you come to it;
outside translation, the terms in a company’s manuals are the starting
point for a glossary for new staff, and the terms in a book for its index.
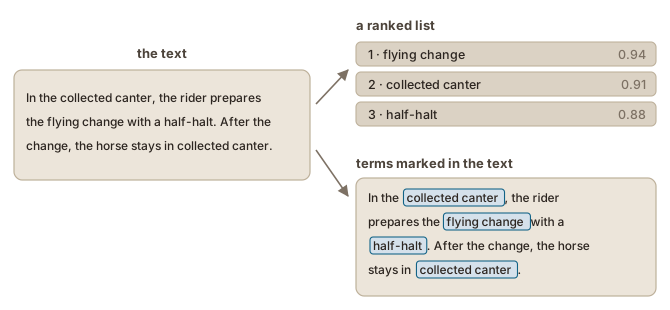
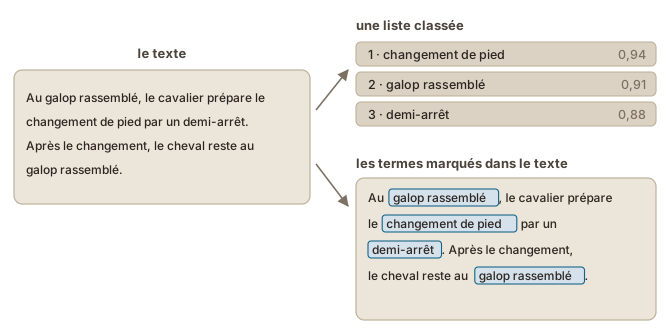
A term extractor can return its candidate terms in two forms (Figure 6figure 6):
A list. Each candidate appears once, however often it occurs, usually
ranked by a score that estimates how likely it is to be a term. The person
who validates the list decides where to stop reading it (Rigouts Terryn et
al., 2019).
The terms in the text. Every occurrence is marked where it appears, the
way a person highlights terms in a document (Lefever & Rigouts Terryn, 2024).
The same word can then be marked in one sentence and left unmarked in
another, where it has its everyday sense (Rigouts Terryn, 2021a).
Figure 6. The same text as a ranked list of candidates and as terms marked in the text. The scores are illustrative.
The challenge was therefore to translate the human notion of a term into
characteristics that a program can measure. Each method in this chapter is
one answer to that challenge, and each answer is imperfect in its own way.
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Pourquoi extraire des termes
La liste des termes d’un ensemble de textes est utile dans plusieurs types de
travail, par exemple :
pour un traducteur, les termes des documents antérieurs d’un client montrent
la terminologie que ce client emploie ;
les termes d’un texte que vous allez traduire peuvent être cherchés et fixés
en une fois avant de commencer, au lieu de vous arrêter pour chercher chaque
terme au moment où vous le rencontrez ;
en dehors de la traduction, les termes des manuels d’une entreprise sont le
point de départ d’un glossaire pour le nouveau personnel, et les termes d’un
livre, celui de son index.
Un extracteur de termes peut renvoyer ses candidats terminologiques sous deux formes (Figure 6figure 6) :
Une liste. Chaque candidat y figure une fois, quel que soit son nombre d’occurrences, le plus souvent
classé selon un score qui estime la probabilité qu’il soit un terme. La personne
qui valide la liste décide où arrêter sa lecture (Rigouts Terryn et
al., 2019).
Les termes dans le texte. Chaque occurrence est marquée là où elle apparaît, comme
lorsqu’on surligne les termes d’un document (Lefever et Rigouts Terryn, 2024).
Le même mot peut alors être marqué dans une phrase et ne pas l’être dans
une autre, où il a son sens courant (Rigouts Terryn, 2021a).
Figure 6. Le même texte sous forme de liste classée de candidats et sous forme de termes marqués dans le texte. Les scores sont donnés à titre d'illustration.
Le défi consistait donc à traduire la notion humaine de terme en
caractéristiques qu’un programme peut mesurer. Chaque méthode de ce chapitre est
une réponse à ce défi, et chaque réponse est imparfaite à sa manière.
Un agent conversationnel à qui l’on demande les termes d’un texte
Trois familles de méthodes d'extraction de termes.
Sources
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Hybrid term extractionL'extraction hybride de termes
Two methods with opposite weaknesses
Linguistic and statistical methods fail in different ways, as the table
below sets out, and each does well where the other fails.
Method
What it gives
What it lacks
Linguistic
candidates with the grammatical form of a term
any way of telling a term from another sequence of the same form
Statistical
a ranking of words by how specific they are to the domain
any account of grammar: it scores single words and fragments as readily as whole terms
What linguistic and statistical methods each give and lack.
A hybrid extractor combines the two.
The two steps
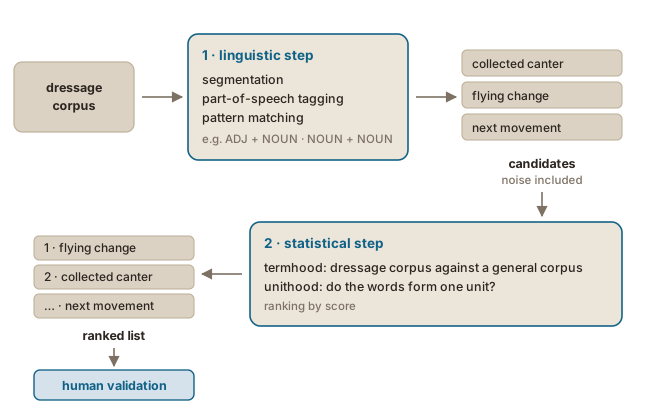
A hybrid extractor works in two steps (Figure 13figure 13).
Figure 13. The two steps of a hybrid term extractor, with examples from dressage.
The result is a list of candidates ordered from most to least likely to be a
term. Nothing in it says where the terms stop: the person who uses the list
chooses a cut-off, reads the top of it, or sets a threshold on the score
(Rigouts Terryn et al., 2019). TermoStat is a tool of this
kind (see also the TermoStat: a hybrid extractor page, in the Classical NLP module) (voir aussi la page TermoStat : un extracteur hybride, dans le module TAL classique).
Strengths and limits
The table below sets the strengths of a hybrid extractor beside its limits.
Strengths
Limits
Transparent. Each candidate is on the list because it matched a pattern and scored high, so you can see why it is there.
Repeatable. The same text gives the same list every time.
Rare terms are easily missed. A term that occurs once or twice scores low, however specialized it is (Rigouts Terryn et al., 2019).
The cut-off is yours. On a collection of Dutch texts about dressage, TermoStat’s full list contained almost two thirds of the terms people had marked, but fewer than one candidate in five was a term (Rigouts Terryn et al., 2019).
The patterns depend on the language. They are written for one language, and a term with an unusual structure falls outside them.
Strengths and limits of a hybrid term extractor.
On the size of the corpus, TermoStat’s guide recommends at least 50,000 words
and warns that under 10,000 few candidates come out as statistically
significant.TermoStat, Guide de l’utilisateur, version 4.0 beta,
read 30 September 2026. The Keywords function of Sketch Engine ranks
words by the same kind of comparison and has the same
limit (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Deux méthodes aux faiblesses opposées
Les méthodes linguistiques et statistiques échouent de façons différentes, comme le montre le
tableau ci-dessous, et chacune réussit là où l’autre échoue.
Méthode
Ce qu’elle apporte
Ce qui lui manque
Linguistique
des candidats qui ont la forme grammaticale d’un terme
un moyen de distinguer un terme d’une autre suite de même forme
Statistique
un classement des mots selon leur spécificité au domaine
toute prise en compte de la grammaire : elle donne un score aux mots isolés et aux fragments aussi facilement qu’aux termes entiers
Ce que les méthodes linguistiques et statistiques apportent, et ce qui leur manque.
Un extracteur hybride combine les deux.
Les deux étapes
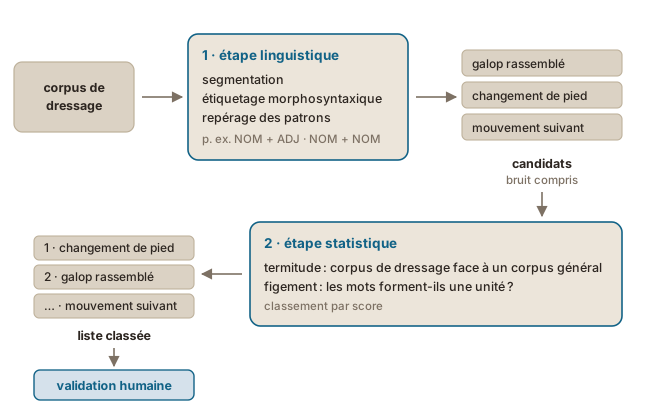
Un extracteur hybride procède en deux étapes (Figure 13figure 13).
Figure 13. Les deux étapes d'un extracteur de termes hybride, avec des exemples du dressage.
Le résultat est une liste de candidats classés du plus probable au moins probable comme
terme. Rien n’y indique où les termes s’arrêtent : la personne qui utilise la liste
choisit un seuil, en lit le début, ou fixe un score minimal
(Rigouts Terryn et al., 2019). TermoStat est un outil de ce
type (see also the TermoStat: a hybrid extractor page, in the Classical NLP module) (voir aussi la page TermoStat : un extracteur hybride, dans le module TAL classique).
Les forces et les limites
Le tableau ci-dessous met les forces d’un extracteur hybride en regard de ses limites.
Forces
Limites
Transparent. Chaque candidat figure dans la liste parce qu’il correspondait à un patron et a obtenu un score élevé : vous pouvez donc voir pourquoi il s’y trouve.
Reproductible. Le même texte donne chaque fois la même liste.
Les termes rares sont facilement manqués. Un terme qui apparaît une ou deux fois obtient un score faible, aussi spécialisé soit-il (Rigouts Terryn et al., 2019).
Le seuil vous revient. Sur un ensemble de textes néerlandais sur le dressage, la liste complète de TermoStat contenait près des deux tiers des termes annotés par des personnes, mais moins d’un candidat sur cinq était un terme (Rigouts Terryn et al., 2019).
Les patrons dépendent de la langue. Ils sont écrits pour une langue, et un terme de structure inhabituelle leur échappe.
Les forces et les limites d'un extracteur de termes hybride.
Sur la taille du corpus, le guide de TermoStat recommande au moins 50 000 mots
et prévient qu’en dessous de 10 000, peu de candidats ressortent comme statistiquement
significatifs.TermoStat, Guide de l’utilisateur, version 4.0 bêta,
consulté le 30 septembre 2026. La fonction Keywords de Sketch Engine classe
les mots selon le même type de comparaison et a la même
limite (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
TermoStat: a hybrid extractorTermoStat : un extracteur hybride
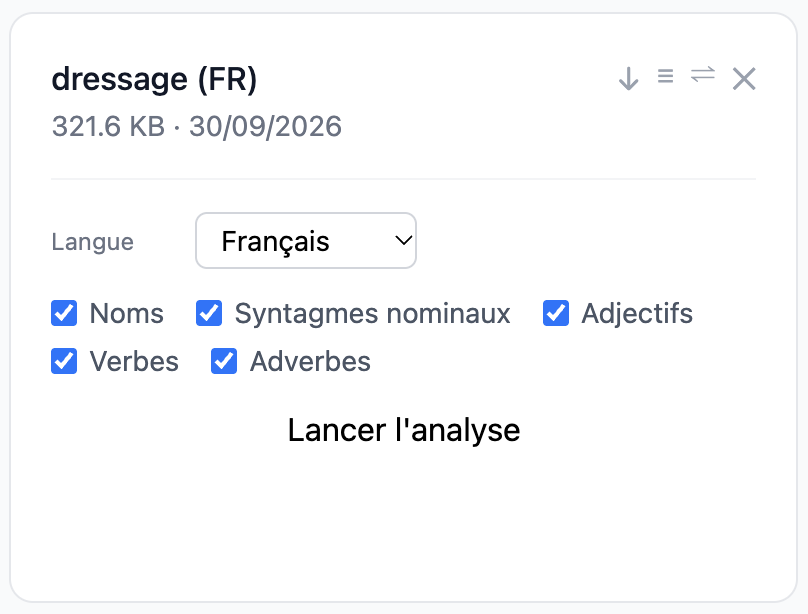
Running TermoStat takes three settingsTermoStat, Guide de l’utilisateur, version 4.0 beta, read
30 September 2026; the guide is in the tool’s Help menu, behind the login. (Figure 14figure 14):
the parts of speech to extract, among nouns, noun phrases, adjectives,
verbs and adverbs.
Figure 14. TermoStat's settings for one corpus: the language and the parts of speech to extract.
The ranked list and its scores
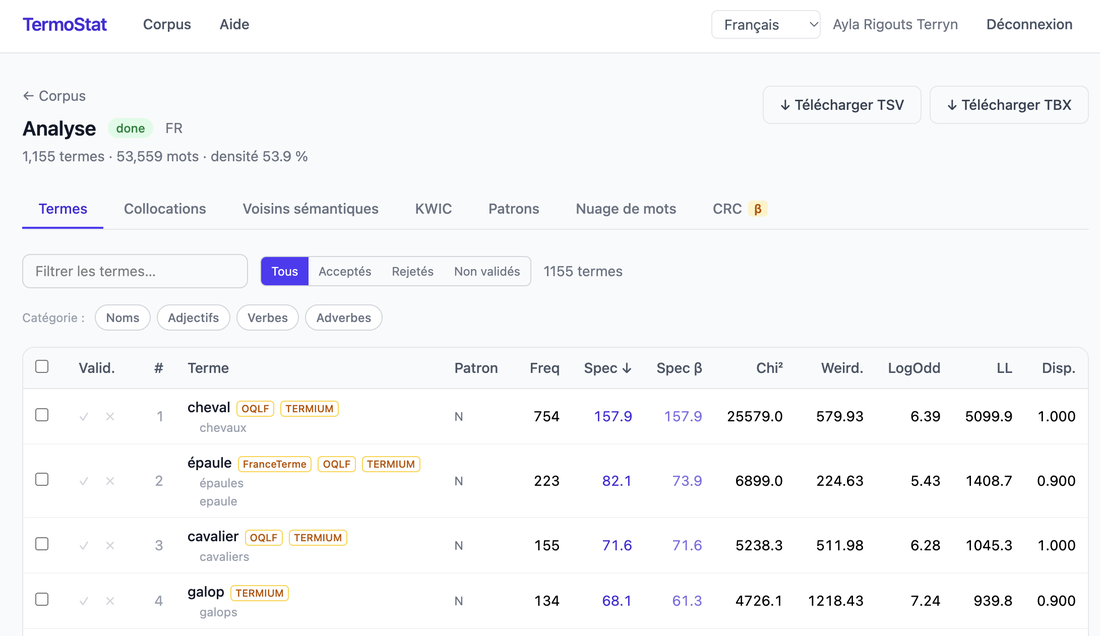
TermoStat returns a list of candidates ranked by specificity (Figure 15figure 15).
Each row gives the candidate, the forms it takes in the corpus, its
grammatical pattern, its frequency and its scores.
Figure 15. The top of TermoStat's ranked list for a French corpus about dressage: the candidates sorted by specificity, with their forms, pattern, frequency and scores, and the validation column on the left.
The first score, Spec, ranks the list (Drouin et al., 2020). The other
columns measure the same comparison in other ways, as the table below sets
out.
Column
What it measures
Spec
specificity: how far the candidate’s frequency in the corpus departs from the frequency the reference corpus predicts
Chi² and LL
two statistical tests of that difference, the chi-square and the log-likelihood; the guide calls the second more reliable for infrequent candidates
LogOdd
how many times more likely the candidate is in the corpus than in the reference corpus, on a logarithmic scale
Weird.
the candidate’s relative frequency in the corpus divided by its relative frequency in the reference corpus
Disp.
how evenly the candidate is spread over the corpus
Spec β
Spec multiplied by Disp., so that a candidate frequent in one document only moves down the list
The score columns of TermoStat's list, after its user guide (version 4.0 beta).
Term bank badges
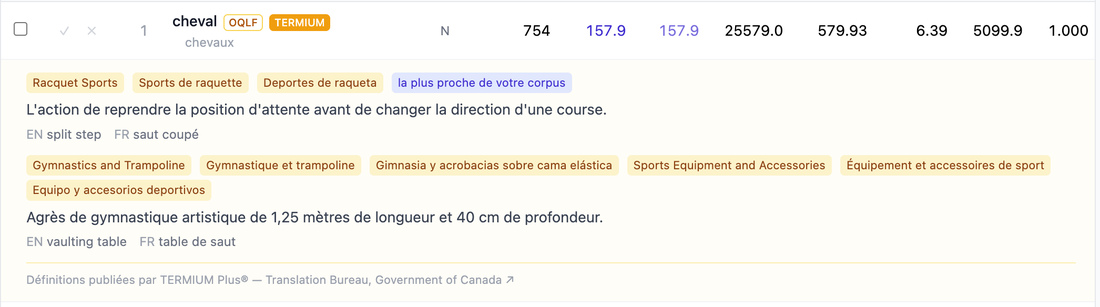
In TermoStat’s list of results, a badge beside a candidate names a term bank that publishes a definition for
it, and opening it shows the bank’s definitions with their subject fields
(Figure 16figure 16).
When a bank has several records, the tool orders them by how well they fit
the corpus. Its own guide calls that order a hint and not a verdict, right
about two times in three: for cheval, the records shown are a
racquet-sports move and a gymnastics apparatus.
Figure 16. The term bank records TermoStat found for one candidate: neither of them is the dressage sense.
Validating and exporting
In the first column of TermoStat’s list of results, every candidate can be
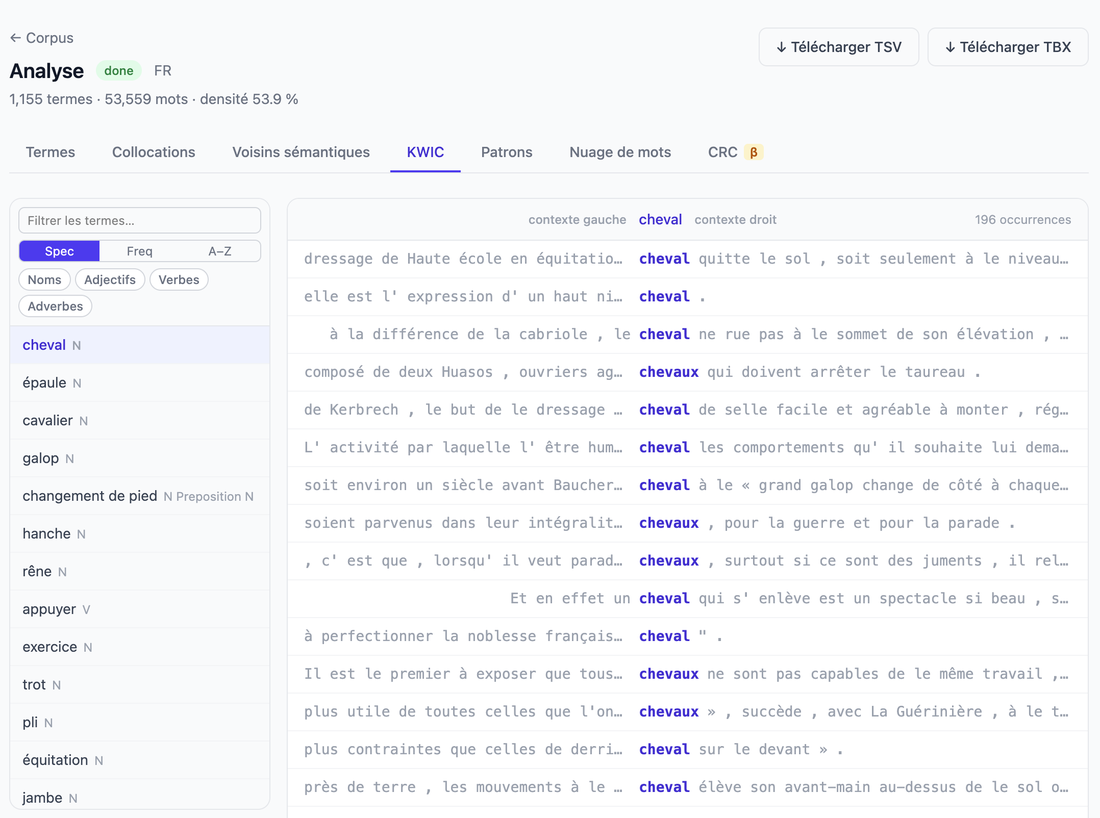
accepted or rejected, which is the validation step done inside the tool. The sentences a
candidate occurs in are the quickest check on a doubtful one (Figure 17figure 17):
they show whether the word always names a concept of the domain, or also
turns up in its everyday sense. Other tabs give its collocates, the
grammatical patterns of all the candidates, and a word cloud.
Figure 17. The occurrences of one candidate in context, the view a concordancer gives.
The list can be downloaded in two formats, which keep different parts of the
result. The spreadsheet (TSV) has every column of the list, one candidate per
row, and is the file to work from when you want to sort, filter or count; the
first twenty rows are below.
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Drouin, P., Morel, J.-B., & L'Homme, M.-C. (2020). Automatic Term Extraction from Newspaper Corpora: Making the Most of Specificity and Common Features. In B. Daille, K. Kageura & A. Rigouts Terryn (Eds.), Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020) (pp. 1–7). European Language Resources Association. https://aclanthology.org/2020.computerm-1.1/
Lancer TermoStat demande trois réglagesTermoStat, Guide de l’utilisateur, version 4.0 bêta, consulté le
30 septembre 2026 ; le guide se trouve dans le menu Aide de l’outil, après connexion. (Figure 14figure 14) :
les parties du discours à extraire, parmi les noms, les syntagmes nominaux, les adjectifs,
les verbes et les adverbes.
Figure 14. Les réglages de TermoStat pour un corpus : la langue et les parties du discours à extraire.
La liste classée et ses scores
TermoStat renvoie une liste de candidats classés par spécificité (Figure 15figure 15).
Chaque ligne donne le candidat, les formes qu’il prend dans le corpus, son
patron grammatical, sa fréquence et ses scores.
Figure 15. Le début de la liste classée de TermoStat pour un corpus français sur le dressage : les candidats triés par spécificité, avec leurs formes, leur patron, leur fréquence et leurs scores, et la colonne de validation à gauche.
Le premier score, Spec, classe la liste (Drouin et al., 2020). Les autres
colonnes mesurent la même comparaison d’autres façons, comme le présente le tableau
ci-dessous.
Colonne
Ce qu’elle mesure
Spec
la spécificité : l’écart entre la fréquence du candidat dans le corpus et la fréquence que prédit le corpus de référence
Chi² et LL
deux tests statistiques de cette différence, le chi-deux et le rapport de vraisemblance ; le guide juge le second plus fiable pour les candidats peu fréquents
LogOdd
combien de fois le candidat est plus probable dans le corpus que dans le corpus de référence, sur une échelle logarithmique
Weird.
la fréquence relative du candidat dans le corpus divisée par sa fréquence relative dans le corpus de référence
Disp.
la régularité de la répartition du candidat dans le corpus
Spec β
Spec multiplié par Disp., de sorte qu’un candidat fréquent dans un seul document descend dans la liste
Les colonnes de scores de la liste de TermoStat, d'après son guide de l'utilisateur (version 4.0 bêta).
Les badges de banques terminologiques
Dans la liste de résultats de TermoStat, un badge à côté d’un candidat nomme une banque terminologique qui en publie une
définition, et l’ouvrir affiche les définitions de la banque avec leurs domaines
(Figure 16figure 16).
Quand une banque a plusieurs fiches, l’outil les ordonne selon leur proximité avec
le corpus. Son propre guide présente cet ordre comme un indice et non comme un verdict, juste
environ deux fois sur trois : pour cheval, les fiches affichées concernent un
déplacement des sports de raquette et un agrès de gymnastique.
Figure 16. Les fiches de banques terminologiques que TermoStat a trouvées pour un candidat : aucune des deux ne correspond au sens du dressage.
La validation et l’exportation
Dans la première colonne de la liste de résultats de TermoStat, chaque candidat peut être
accepté ou rejeté : c’est l’étape de validation, faite dans l’outil même. Les phrases où un
candidat apparaît sont le moyen le plus rapide de vérifier un cas douteux (Figure 17figure 17) :
elles montrent si le mot désigne toujours un concept du domaine, ou s’il
apparaît aussi dans son sens courant. D’autres onglets donnent ses cooccurrents, les
patrons grammaticaux de tous les candidats et un nuage de mots.
Figure 17. Les occurrences d'un candidat en contexte, la vue que donne un concordancier.
La liste se télécharge dans deux formats, qui ne conservent pas les mêmes parties du
résultat. Le tableur (TSV) contient toutes les colonnes de la liste, un candidat par
ligne, et c’est le fichier à utiliser pour trier, filtrer ou compter ; les
vingt premières lignes figurent ci-dessous.
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Drouin, P., Morel, J.-B., & L'Homme, M.-C. (2020). Automatic Term Extraction from Newspaper Corpora: Making the Most of Specificity and Common Features. In B. Daille, K. Kageura & A. Rigouts Terryn (Eds.), Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020) (pp. 1–7). European Language Resources Association. https://aclanthology.org/2020.computerm-1.1/
Term extraction with LLMsL'extraction de termes avec les GML
whether a shorter term inside a longer one counts;
in what form to return each candidate.
Every decision on which people disagree becomes a decision written into the
prompt, so two people who prompt differently can get different lists from
the same model.
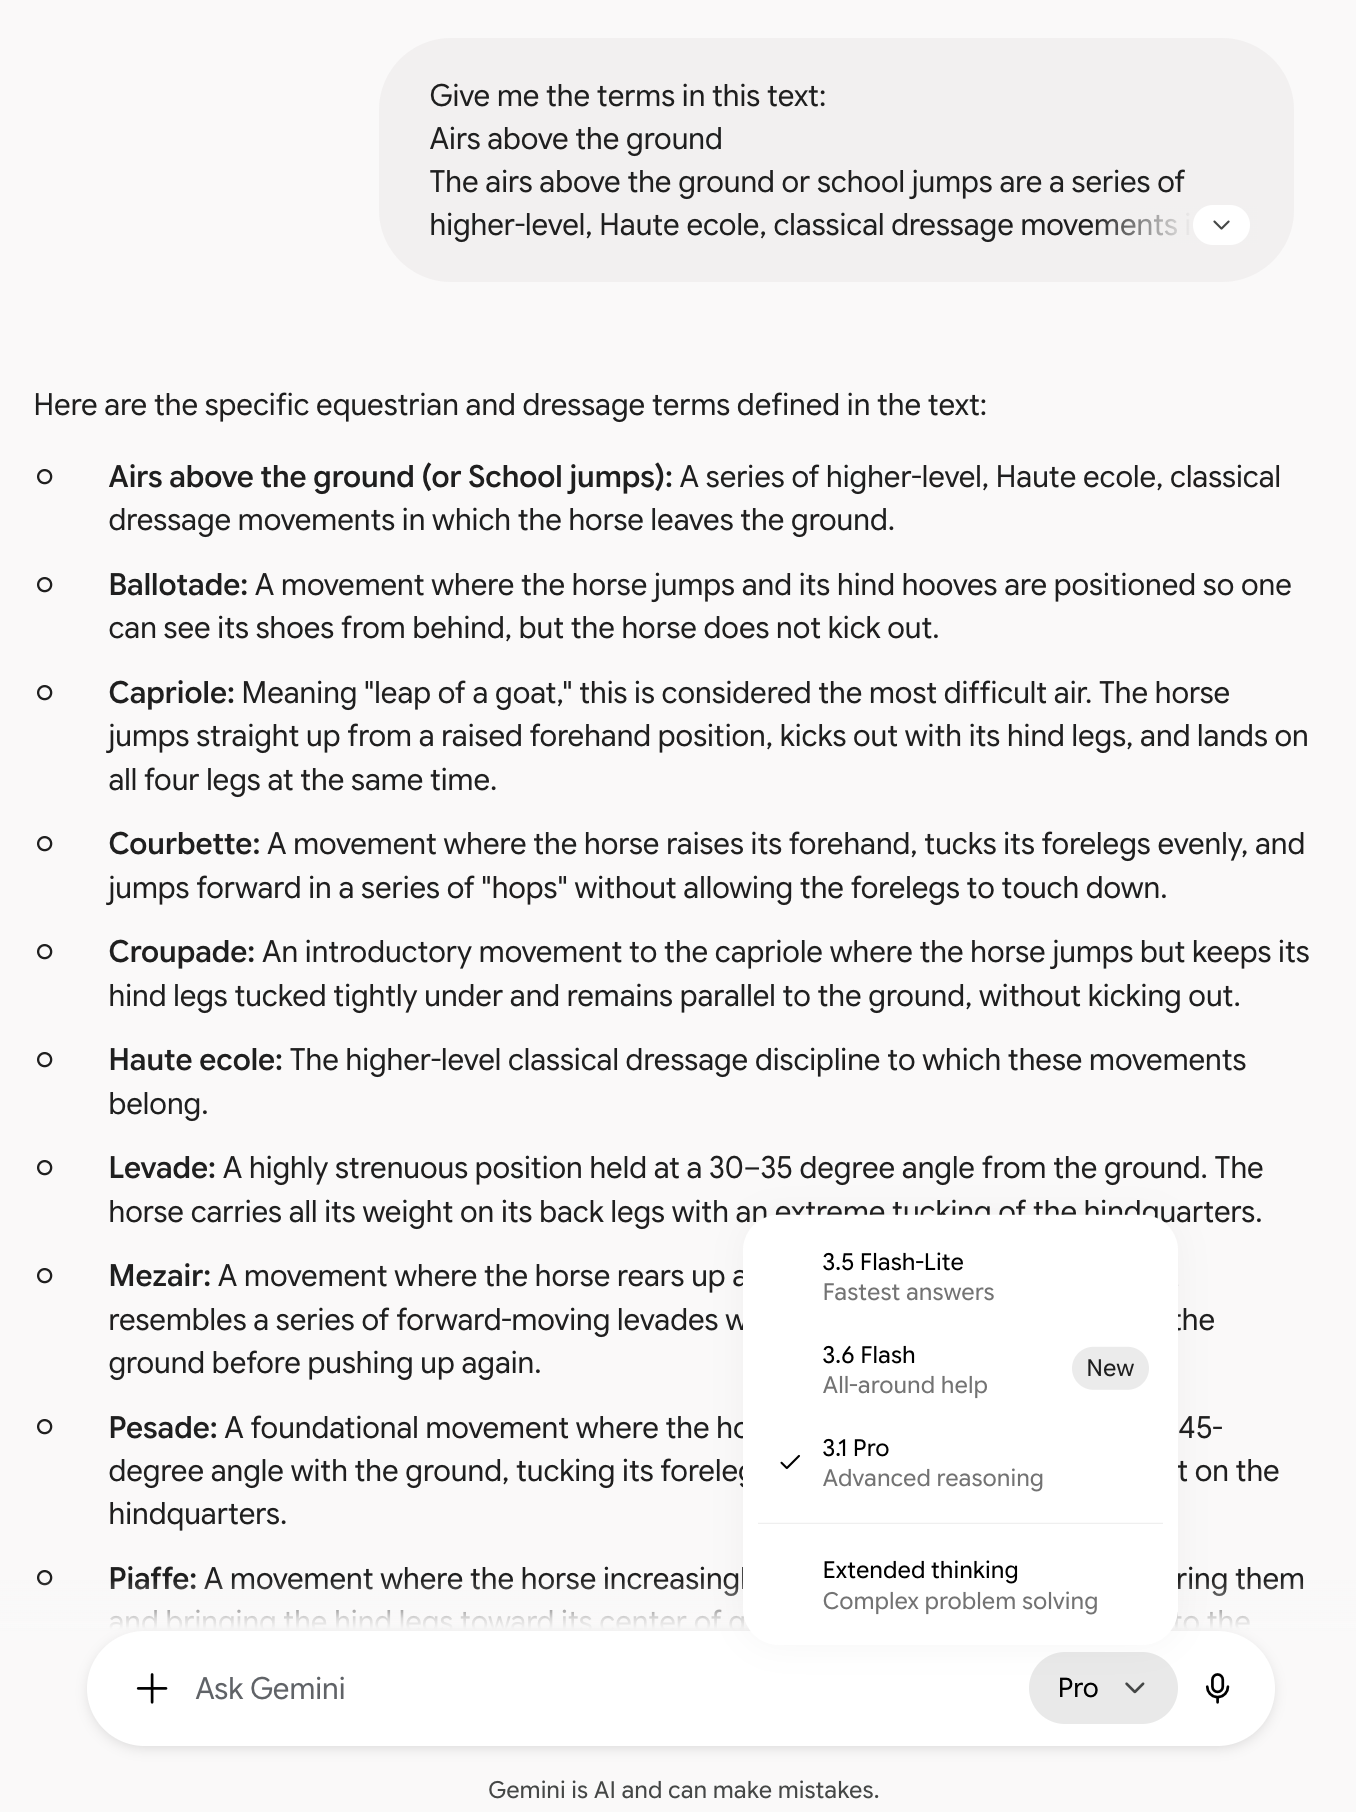
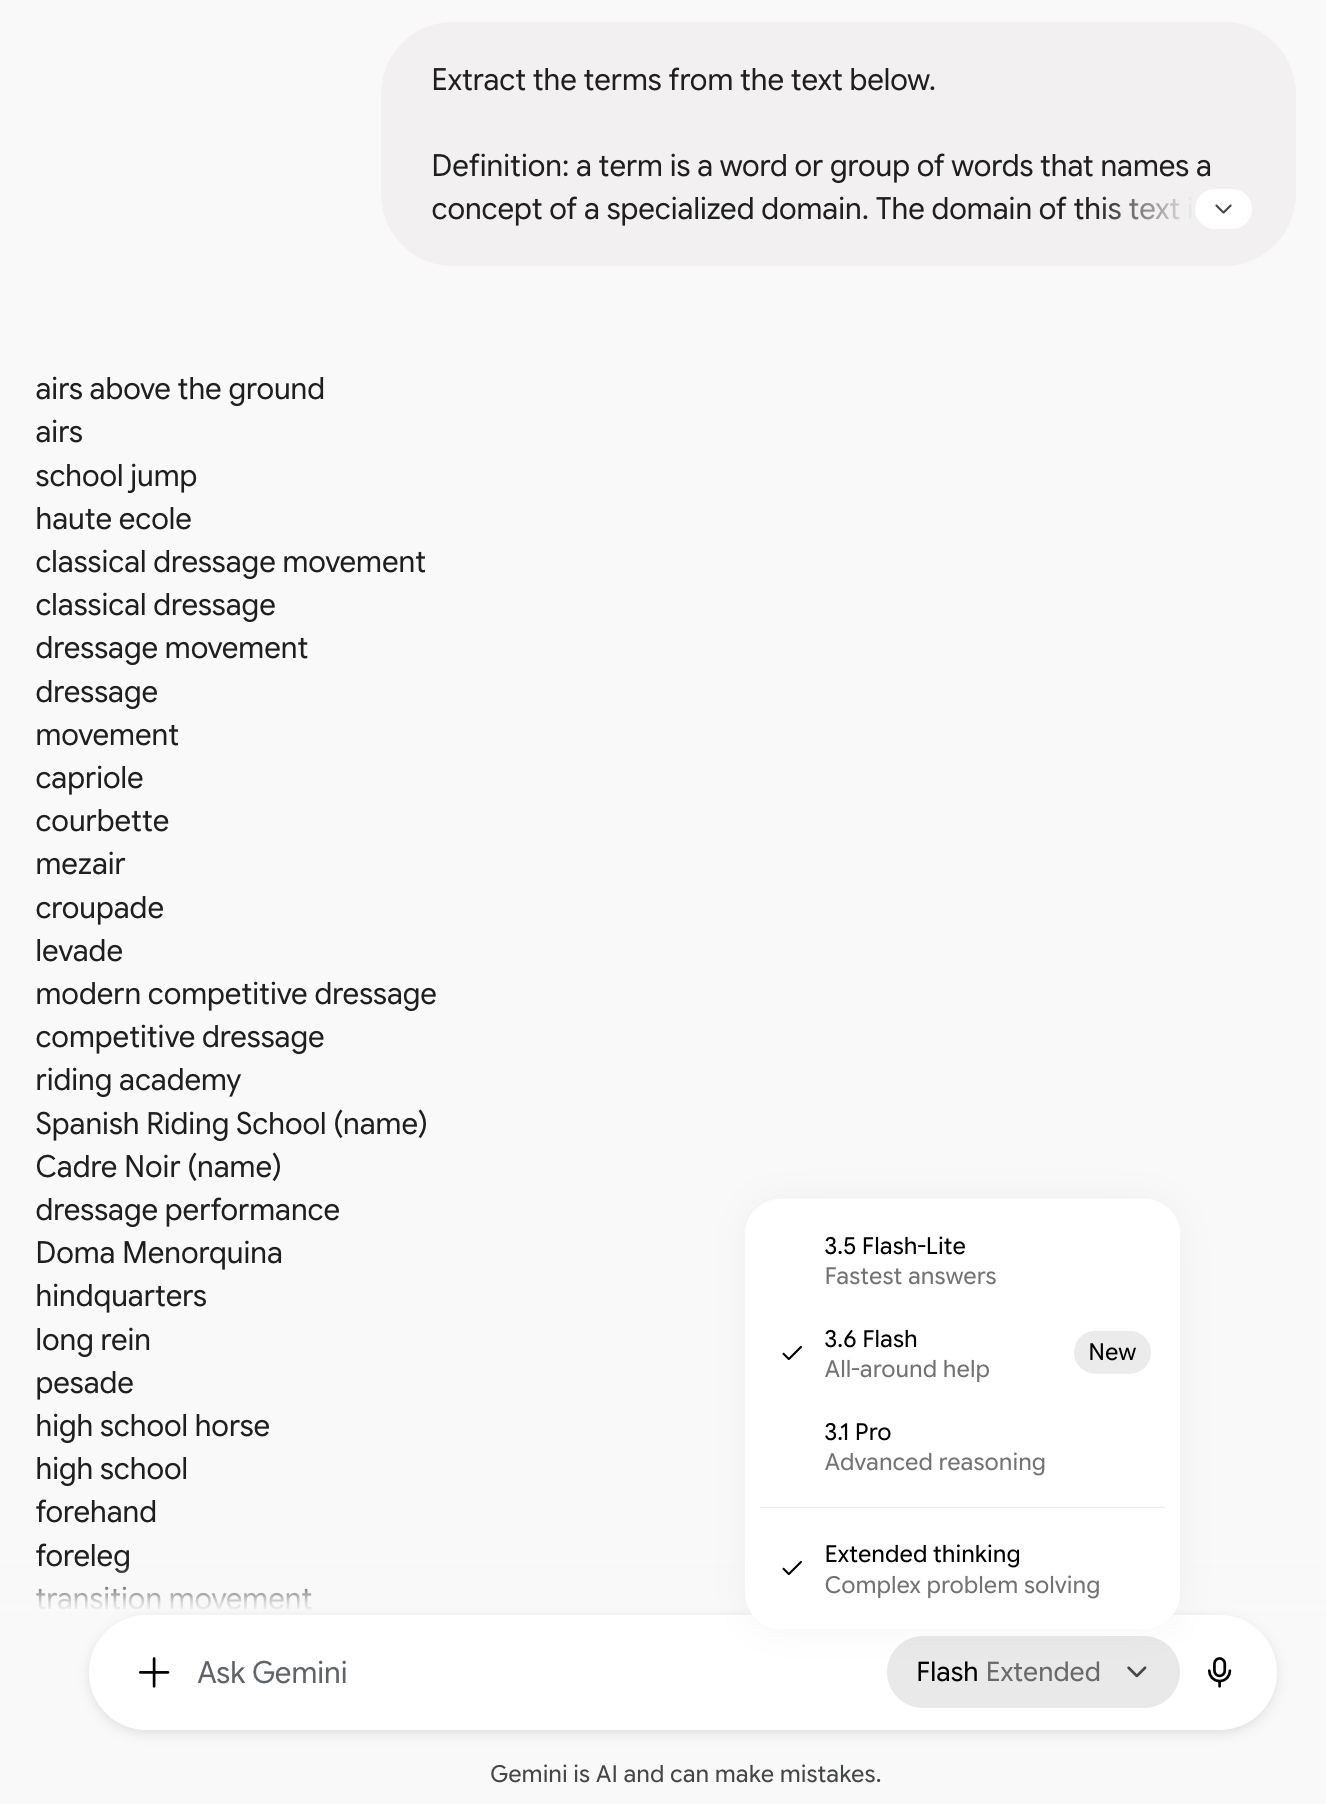
The two screenshots below show the difference on one text about dressage.
With a bare request (Figure 25figure 25), the chatbot returns the terms that the text defines, each with a
definition. With a prompt written like guidelines (Figure 26figure 26), the answer is a plain list in the form the prompt asked for.
Figure 25. A bare request: a text about dressage and the answer of one chatbot when nothing says what a term is (Gemini 3.1 Pro, 1 October 2026). The interface changes. Figure 26. The same text with a prompt written from annotation guidelines: the list follows the definition and the form it was given (Gemini 3.6 Flash with extended thinking, 1 October 2026).
Results of LLMs
Early studies, with GPT-3.5 and Llama 2, found that prompting an LLM came
close to tools trained on annotated examples (Banerjee et al., 2024; Tran et
al., 2024). With models available in 2025, the gap closed: on the twelve
corpora of the ACTER dataset, four LLMs were competitive with tools trained
for the task, and in the range of the agreement between annotators (Rigouts
Terryn, 2026) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).GPT-5 and GPT-5-mini (snapshots of 7 August 2025),
Mistral Large (2411) and Magistral Medium (2507). Three findings
of that study:
The texts changed the results more than the model did. The domain and
the language of a text counted for more than the choice among the four
models.
A detailed prompt helped more than examples in the prompt.
The models proposed too much rather than too little, for instance
general words, several terms joined by and, and descriptive phrases.
Banerjee, S., Chakravarthi, B. R., & McCrae, J. P. (2024). Large Language Models for Few-Shot Automatic Term Extraction. In Natural Language Processing and Information Systems (NLDB 2024), Lecture Notes in Computer Science (pp. 137–150). Springer. https://doi.org/10.1007/978-3-031-70239-6_10
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Tran, H. T. H., González-Gallardo, C.-E., Delaunay, J., Doucet, A., & Pollak, S. (2024). Is Prompting What Term Extraction Needs?. In Text, Speech, and Dialogue (TSD 2024), Lecture Notes in Computer Science (pp. 17–29). Springer. https://doi.org/10.1007/978-3-031-70563-2_2
si un terme court à l’intérieur d’un terme plus long compte ;
sous quelle forme renvoyer chaque candidat.
Chaque décision sur laquelle les personnes ne s’accordent pas devient une décision écrite dans la
requête, si bien que deux personnes qui formulent leur requête différemment peuvent obtenir des listes différentes
du même modèle.
Les deux captures d’écran ci-dessous montrent la différence sur un texte anglais sur le dressage.
Avec une demande nue (Figure 25figure 25), l’agent conversationnel renvoie les termes que le texte définit, chacun avec une
définition. Avec une requête rédigée comme des consignes (Figure 26figure 26), la réponse est une simple liste, sous la forme demandée par la requête.
Figure 25. Une demande nue : un texte sur le dressage et la réponse d'un agent conversationnel quand rien ne dit ce qu'est un terme (Gemini 3.1 Pro, 1er octobre 2026). L'interface change. Figure 26. Le même texte avec une requête rédigée à partir de consignes d'annotation : la liste suit la définition et la forme qui lui ont été données (Gemini 3.6 Flash avec réflexion étendue, 1er octobre 2026).
Banerjee, S., Chakravarthi, B. R., & McCrae, J. P. (2024). Large Language Models for Few-Shot Automatic Term Extraction. In Natural Language Processing and Information Systems (NLDB 2024), Lecture Notes in Computer Science (pp. 137–150). Springer. https://doi.org/10.1007/978-3-031-70239-6_10
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Tran, H. T. H., González-Gallardo, C.-E., Delaunay, J., Doucet, A., & Pollak, S. (2024). Is Prompting What Term Extraction Needs?. In Text, Speech, and Dialogue (TSD 2024), Lecture Notes in Computer Science (pp. 17–29). Springer. https://doi.org/10.1007/978-3-031-70563-2_2
Comparing term extraction methodsComparer les méthodes d'extraction de termes
No single difference settles the choice between a dedicated tool and an LLM,
but some situations point one way:
A large corpus in one domain, to go through the same way every time,
suits a dedicated tool: its ranked list can be read from the top, and
running it again gives the same list.
A single document, a language or domain no tool was trained for, or a
list you want with labels and remarks, suits an LLM.
A language with little text on the web is a reason for caution with
either: the results of LLMs on this task were obtained on languages with many
resources
(Rigouts Terryn, 2026).
The two can also be combined: a large LLM marks the terms in many texts, and
a much smaller, openly available model is trained on those marks, which
avoids sending every new text to a provider (Senger et al., 2025).
Typical errors of each method
Each method of this chapter tends to go wrong in its own way, as the table
below sums up.
Method
Typical errors
Linguistic
Proposes every sequence with the form of a term, such as little girl, and misses terms of an unusual form, such as on the bit
Statistical
Misses rare terms and terms that are also everyday words, such as collection, and proposes words that are frequent in the texts for another reason
Hybrid
Has the limits of both, and the result depends on where the ranked list is cut off
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Senger, E., Campbell, Y., van der Goot, R., & Plank, B. (2025). Crossing Domains without Labels: Distant Supervision for Term Extraction. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1366–1378. https://aclanthology.org/2025.emnlp-industry.95/
Ce qui distingue un extracteur de termes spécialisé d'un GML.
Aucune de ces différences ne tranche à elle seule entre un outil spécialisé et un GML,
mais certaines situations orientent le choix :
Un grand corpus dans un seul domaine, à traiter chaque fois de la même façon,
convient à un outil spécialisé : sa liste classée se lit à partir du début, et
le relancer donne la même liste.
Un seul document, une langue ou un domaine pour lesquels aucun outil n’a été entraîné, ou une
liste que vous voulez avec des étiquettes et des remarques, conviennent à un GML.
Une langue peu présente sur le web est une raison d’être prudent avec
l’un comme avec l’autre : les résultats des GML pour cette tâche ont été obtenus pour des langues bien dotées en ressources
(Rigouts Terryn, 2026).
Les deux peuvent aussi se combiner : un grand GML marque les termes dans de nombreux textes, et
un modèle beaucoup plus petit, librement accessible, est entraîné sur ces marques, ce qui
évite d’envoyer chaque nouveau texte à un fournisseur (Senger et al., 2025).
Les erreurs typiques de chaque méthode
Chaque méthode de ce chapitre tend à échouer à sa manière, comme le résume le tableau
ci-dessous.
Méthode
Erreurs typiques
Linguistique
Propose toute suite qui a la forme d’un terme, comme fillette joyeuse, et manque les termes de forme inhabituelle, comme sur la main
Statistique
Manque les termes rares et les termes qui sont aussi des mots courants, comme passage, et propose des mots fréquents dans les textes pour une autre raison
Hybride
A les limites des deux, et le résultat dépend de l’endroit où la liste classée est coupée
Réussit moins bien sur des textes différents de ceux de son entraînement, sur les termes de plusieurs mots et sur les termes qui sont aussi des mots courants
GML
En proposent trop, par exemple des mots généraux et plusieurs termes joints en un seul, et renvoient parfois une forme qui ne figure pas telle quelle dans le texte
Là où chaque méthode d'extraction de termes tend à échouer.
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Senger, E., Campbell, Y., van der Goot, R., & Plank, B. (2025). Crossing Domains without Labels: Distant Supervision for Term Extraction. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1366–1378. https://aclanthology.org/2025.emnlp-industry.95/
Evaluation foundationsFondements de l'évaluation
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Systematic evaluationL'évaluation systématique
Limits of a first impression
When you try out a language tool, for example a machine translation system, a
spelling checker or a chatbot, the obvious way to judge it is to look at some
of its results and decide whether they seem good. That first impression is
useful, but it is a weak basis for a conclusion:
it relies on the few examples you happened to try;
it depends on your own expertise, so another person can judge the same
results differently, and it does not work for a subject or a language in
which your own expertise is limited;
it cannot be compared with another person’s impression of another tool, or
with your own impression of the same tool a year later.
An evaluation is a more systematic way of judging a tool. The tool is run on
evaluation data chosen in advance and its output is judged by a method that
is stated, so that the result can be checked, repeated and compared.
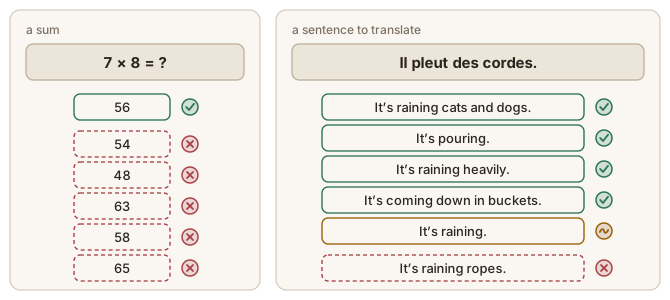
Figure 1. One of the main difficulties in evaluating NLP tasks is that there are often multiple correct answers. Compare, for instance, simple mathematics (1 correct answer, everything else wrong) with translation (multiple correct answers, maybe a few OK answers, some wrong answers).
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Les limites d’une première impression
Quand vous essayez un outil langagier, par exemple un système de traduction
automatique, un correcteur orthographique ou un agent conversationnel, la
façon la plus évidente de le juger consiste à regarder quelques-uns de ses
résultats et à décider s’ils semblent bons. Cette première impression est
utile, mais c’est une base fragile pour une conclusion :
elle dépend des quelques exemples que vous avez essayés ;
elle dépend de votre propre expertise, de sorte qu’une autre personne peut
juger les mêmes résultats autrement, et elle ne fonctionne pas pour un
sujet ou une langue où votre expertise est limitée ;
elle ne peut pas être comparée à l’impression d’une autre personne sur un
autre outil, ni à votre propre impression du même outil un an plus tard.
Une évaluation est une façon plus systématique de juger un outil. L’outil
fonctionne sur des données d’évaluation choisies à l’avance et sa sortie est
jugée selon une méthode déclarée, de sorte que le résultat peut être
vérifié, répété et comparé.
Figure 1. L'une des principales difficultés de l'évaluation des tâches du TAL est qu'il existe souvent plusieurs réponses correctes. Comparez, par exemple, un calcul simple (une seule réponse correcte, toutes les autres fausses) et la traduction (plusieurs réponses correctes, peut-être quelques réponses acceptables, quelques réponses fausses).
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. An evaluation of named entity recognition, the task of finding the names in a text: people mark the names first, and the output of the system is then compared with their answers. The marks are invented.
The general word for the answers that an output is compared with is the
reference. A gold standard is a reference that people produced. For a
translation system, it is a translation made by a person, called a reference
translation.
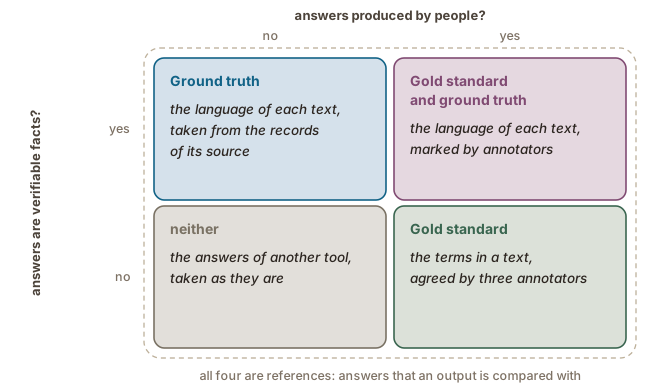
Ground truth is often used as a synonym of gold standard, but the two answer
different questions about a reference
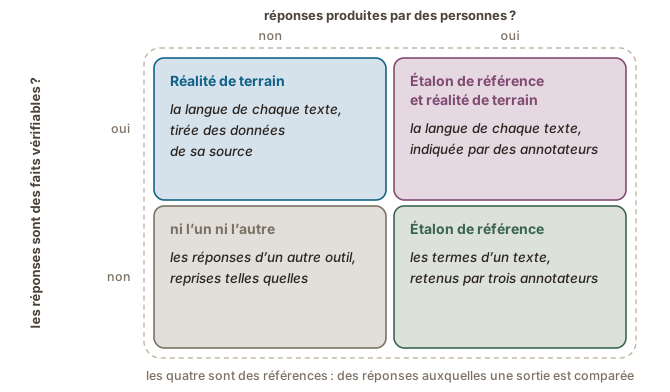
(Figure 4figure 4): a gold standard is produced by people, and a ground truth
consists of verifiable facts. Where the answers depend on judgement, people can
disagree and more than one answer can be correct (Basile et al., 2021), so a
gold standard is then not a ground truth.
Figure 4. Gold standard and ground truth answer two different questions about a reference. The examples are mine.
Limits of a gold standard
Every score computed against a gold standard is a comparison with one
particular set of answers, and that set has limits of its own:
It depends on the guidelines. The people who made it followed written
guidelines and decided the unclear cases, for instance whether names count
as terms or how long a term may be. Had they decided differently, the same
system would score differently on the same
text (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique).
For many language tasks, some of these decisions are a matter of judgement
(Basile et al., 2021).
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rebholz-Schuhmann, D., Jimeno Yepes, A. J., van Mulligen, E. M., Kang, N., Kors, J., Milward, D., et al. (2010). The CALBC Silver Standard Corpus for Biomedical Named Entities — A Study in Harmonizing the Contributions from Four Independent Named Entity Taggers. Proceedings of the Seventh International Conference on Language Resources and Evaluation (LREC'10). https://aclanthology.org/L10-1609/
Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722
Tan, Z., Li, D., Wang, S., Beigi, A., Jiang, B., Bhattacharjee, A., et al. (2024). Large Language Models for Data Annotation and Synthesis: A Survey. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 930–957. https://aclanthology.org/2024.emnlp-main.54/
La sortie et l’étalon de référence
La façon la plus courante d’évaluer un système de TAL est de comparer sa
sortie avec un étalon de référence (angl. gold
standard) (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières). L’étalon de
référence indique quelle aurait dû être la sortie, et il est le plus souvent
constitué des réponses que des personnes ont données pour la même entrée
(Jurafsky & Martin, 2026).
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. Une évaluation de la reconnaissance d'entités nommées, la tâche qui consiste à trouver les noms dans un texte : des personnes marquent d'abord les noms, puis la sortie du système est comparée à leurs réponses. Les annotations sont inventées.
Étalon de référence, référence et réalité de terrain
Le mot général pour les réponses auxquelles une sortie est comparée est la
référence. Un étalon de référence est une référence que des personnes ont
produite. Pour un système de traduction, c’est une traduction faite par une
personne, appelée traduction de référence.
Le terme réalité de terrain (angl. ground truth) est souvent employé comme
synonyme d’étalon de référence, mais les deux répondent à des questions
différentes sur une référence
(Figure 4figure 4) : un étalon de référence est produit par des personnes, et une
réalité de terrain est constituée de faits vérifiables. Lorsque les réponses
dépendent d’un jugement, les personnes peuvent être en désaccord et
plusieurs réponses peuvent être correctes (Basile et al., 2021) : un étalon
de référence n’est alors pas une réalité de terrain.
Figure 4. L'étalon de référence et la réalité de terrain répondent à deux questions différentes sur une référence. Les exemples sont les miens.
Les limites d’un étalon de référence
Chaque score calculé par rapport à un étalon de référence est une comparaison
avec un ensemble de réponses particulier, et cet ensemble a ses propres
limites :
Il dépend des consignes. Les personnes qui l’ont établi ont suivi des
consignes écrites et ont tranché les cas flous, par exemple si les noms
propres comptent comme des termes, ou quelle longueur un terme peut avoir.
Si elles avaient décidé autrement, le même système obtiendrait un autre
score sur le même
texte (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique).
Pour beaucoup de tâches langagières, une partie de ces décisions relève du
jugement (Basile et al., 2021).
Il énumère un nombre limité de réponses. Pour un système qui produit du
texte, comme un système de traduction ou un agent conversationnel, une
sortie peut être bonne sans ressembler à aucune d’elles, et c’est l’une des
raisons pour lesquelles des personnes jugent aussi de telles sorties
directement (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
Sources
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rebholz-Schuhmann, D., Jimeno Yepes, A. J., van Mulligen, E. M., Kang, N., Kors, J., Milward, D., et al. (2010). The CALBC Silver Standard Corpus for Biomedical Named Entities — A Study in Harmonizing the Contributions from Four Independent Named Entity Taggers. Proceedings of the Seventh International Conference on Language Resources and Evaluation (LREC'10). https://aclanthology.org/L10-1609/
Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722
Tan, Z., Li, D., Wang, S., Beigi, A., Jiang, B., Bhattacharjee, A., et al. (2024). Large Language Models for Data Annotation and Synthesis: A Survey. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 930–957. https://aclanthology.org/2024.emnlp-main.54/
Agreement between annotatorsL'accord entre annotateurs
Inter-annotator agreement is a measure of the reliability of a gold standard:
high agreement suggests that the annotators understood the guidelines in the
same way (Artstein & Poesio, 2008). In
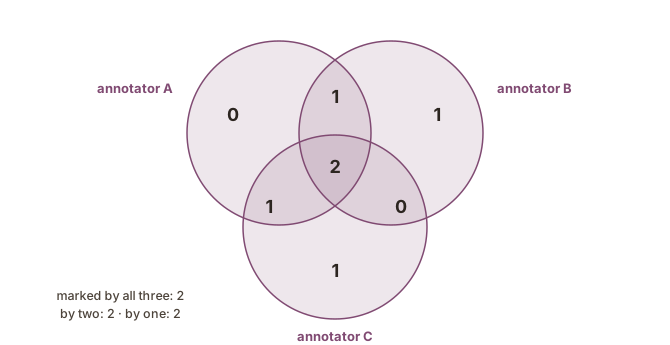
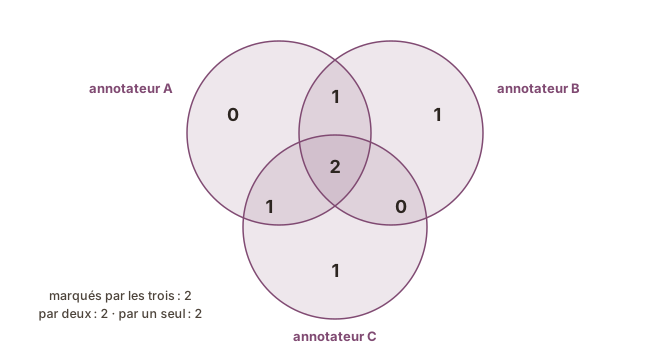
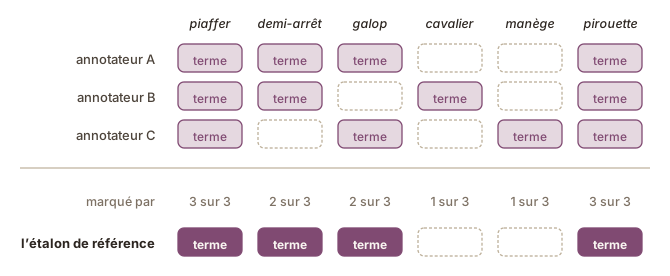
Figure 5figure 5, three annotators have marked six units between them, and only two
of the six were marked by all three.
Figure 5. Three annotators marking the terms of one short text: the number of units marked by each combination of them. The example is invented.
The simplest measure is the share of items on which the annotators gave the
same answer. Part of any agreement arises by chance, and some measures
correct for it (Artstein & Poesio, 2008). When annotators mark things in
running text, such as terms, their agreement can be measured with the same
scores as a system (Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
Low and high agreement
Low agreement is a finding about the task. Either some annotators are
wrong, or the guidelines do not fit the data (Artstein & Poesio, 2008). For
many language tasks there is a third possibility, that more than one answer
is right (Basile et al., 2021).
A task with low agreement is harder to evaluate, and often harder to
automate. The gold standard that a system is scored against is itself
uncertain, and where people do not agree on the answer, a system has no
consistent answer to learn or to reproduce. In a review of published results
in biomedical NLP, Boguslav and Cohen (2017) found that tasks with higher
agreement between annotators also had higher system scores.
High agreement is not proof. Reliability is a precondition for a
gold standard being right, but two people can share the same mistaken idea and
agree completely (Artstein & Poesio, 2008).
Combining several annotators
Most evaluations compare a system with a single gold standard, so the
differences between annotators have to be settled. This step is called
adjudication, and it can be done in several ways, for instance:
Discussion: the annotators compare their results and settle each
difference together.
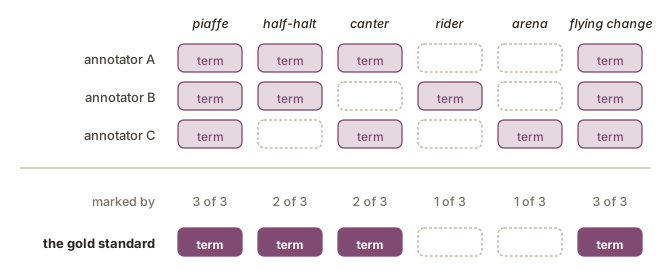
Majority vote: a unit goes into the gold standard when most of the
annotators marked it. Figure 6figure 6 applies it to the three annotators of
Figure 5figure 5.
One person checks: a single experienced annotator makes or reviews
every decision, which keeps the gold standard consistent but makes it one
person’s view.
Figure 6. A majority vote: three annotators mark the terms, and the gold standard keeps the units that at least two of them marked. The example is invented.
Combining the annotations is not the only option. An evaluation can also keep
the annotations of each person and compare a system with all of them, so that
the items on which people disagree are counted as well (Basile et al., 2021).
The agreement is often assumed to be the upper limit of what a system can
reach, but systems do score above it (Boguslav & Cohen, 2017). A higher score
is not always feasible, and it is not always desirable: a much higher score
can mean that the system reproduces the choices of the particular people who
made the gold standard.
Sources
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Boguslav, M., & Cohen, K. B. (2017). Inter-Annotator Agreement and the Upper Limit on Machine Performance: Evidence from Biomedical Natural Language Processing. Studies in Health Technology and Informatics, 245, 298–302. https://doi.org/10.3233/978-1-61499-830-3-298
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131
L’accord inter-annotateurs est une mesure de la fiabilité d’un étalon de
référence : un accord élevé suggère que les annotateurs ont compris les
consignes de la même façon (Artstein & Poesio, 2008). Dans
Figure 5figure 5, trois annotateurs ont marqué six unités à eux trois, et seules deux
des six ont été marquées par les trois.
Figure 5. Trois annotateurs marquent les termes d'un court texte : le nombre d'unités marquées par chaque combinaison d'annotateurs. L'exemple est inventé.
La mesure la plus simple est la proportion d’éléments pour lesquels les
annotateurs ont donné la même réponse. Une partie de tout accord est due au
hasard, et certaines mesures en tiennent compte (Artstein & Poesio, 2008).
Lorsque les annotateurs marquent des éléments dans un texte suivi, comme des
termes, leur accord peut être mesuré avec les mêmes scores qu’un système
(Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
Accord faible et accord élevé
Un accord faible est un constat sur la tâche. Soit certains
annotateurs se trompent, soit les consignes ne conviennent pas aux données
(Artstein & Poesio, 2008). Pour beaucoup de tâches langagières, il existe
une troisième possibilité : plusieurs réponses sont correctes (Basile et
al., 2021).
Une tâche où l’accord est faible est plus difficile à évaluer, et
souvent plus difficile à automatiser. L’étalon de référence auquel un
système est comparé est lui-même incertain, et lorsque les personnes ne
s’entendent pas sur la réponse, un système n’a pas de réponse constante à
apprendre ou à reproduire. Dans une analyse de résultats publiés en TAL
biomédical, Boguslav et Cohen (2017) ont constaté que les tâches où
l’accord entre annotateurs était plus élevé obtenaient aussi des scores de
systèmes plus élevés.
Un accord élevé n’est pas une preuve. La fiabilité est une condition
préalable pour qu’un étalon de référence soit juste, mais deux personnes
peuvent partager la même idée fausse et être entièrement d’accord (Artstein
& Poesio, 2008).
Combiner plusieurs annotateurs
La plupart des évaluations comparent un système à un seul étalon de
référence : les différences entre annotateurs doivent donc être tranchées.
Cette étape s’appelle l’arbitrage, et elle peut se faire de plusieurs
façons, par exemple :
La discussion : les annotateurs comparent leurs résultats et tranchent
chaque différence ensemble.
Le vote majoritaire : une unité entre dans l’étalon de référence
lorsque la majorité des annotateurs l’ont marquée. La Figure 6figure 6 l’applique aux trois annotateurs de
Figure 5figure 5.
La vérification par une seule personne : un seul annotateur
expérimenté prend ou révise chaque décision, ce qui garde l’étalon de
référence cohérent, mais en fait le point de vue d’une seule personne.
Figure 6. Un vote majoritaire : trois annotateurs marquent les termes, et l'étalon de référence garde les unités qu'au moins deux d'entre eux ont marquées. L'exemple est inventé.
Combiner les annotations n’est pas la seule possibilité. Une évaluation peut
aussi conserver les annotations de chaque personne et comparer un système à
toutes, de sorte que les éléments sur lesquels les personnes sont en
désaccord sont comptés eux aussi (Basile et al., 2021).
L’accord et le score d’un système
Un score par rapport à un étalon de référence ne peut pas être interprété
sans l’accord entre les personnes qui l’ont établi. Lorsque deux personnes
soigneuses atteignent 0,6 l’une par rapport à l’autre, un système qui
atteint 0,6 par rapport à l’une d’elles fait à peu près aussi bien que le
ferait une deuxième
personne (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
L’accord est souvent considéré comme la limite supérieure de ce qu’un
système peut atteindre, mais des systèmes obtiennent bel et bien des scores
supérieurs (Boguslav & Cohen, 2017). Un score plus élevé n’est pas toujours
réalisable, et il n’est pas toujours souhaitable : un score beaucoup plus
élevé peut signifier que le système reproduit les choix des personnes qui
ont établi l’étalon de référence.
Sources
Artstein, R., & Poesio, M. (2008). Inter-coder agreement for computational linguistics. Computational Linguistics, 34(4), 555–596. https://doi.org/10.1162/coli.07-034-R2
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Boguslav, M., & Cohen, K. B. (2017). Inter-Annotator Agreement and the Upper Limit on Machine Performance: Evidence from Biomedical Natural Language Processing. Studies in Health Technology and Informatics, 245, 298–302. https://doi.org/10.3233/978-1-61499-830-3-298
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131
BaselinesLes étalons
A score compared with a simple method
A score does not say, on its own, whether a system is good. If you are told
that a spam filter is right for 90 messages out of 100, you still need to know
what a very simple method would score on the same messages. If 90 of the 100
messages are not spam, a filter that lets every message through is also right
90 times out of 100, and it has not stopped any spam
(Figure 8figure 8).
Figure 8. The same 100 messages judged twice: by letting every message through, and by a spam filter. Both are right for 90 messages. The example is invented.
The score of such a simple method is called a baseline.
right as often as that class occurs: 90 % when nine items in ten belong to it
Most frequent answer for each item
gives each item the answer it had most often in a set of labelled examples; only possible where the same items come back, as words do
depends on the task, and can be high: about 92 % of the words for part-of-speech tagging of English, the example below
Three simple baselines for a classification task.
A baseline can also be an existing tool: a new system is then expected to do
better than the one it replaces.The third baseline is not always
possible: it needs labelled examples, and the items of the test have to come
back from those examples, as words do in running text. Jurafsky and Martin
(2026) give it for part-of-speech tagging. No two emails are identical, so a
spam filter has no such baseline.
Figure 9. Part-of-speech tagging of English: the share of words labelled correctly by the baseline, and by the best systems and by people, with the top of the scale enlarged (Jurafsky & Martin, 2026).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Un score comparé à une méthode simple
Un score ne dit pas, à lui seul, si un système est bon. Si l’on vous dit
qu’un filtre antipourriel a raison pour 90 messages sur 100, il vous reste à
savoir quel score une méthode très simple obtiendrait sur les mêmes
messages. Si 90 des 100 messages ne sont pas des pourriels, un filtre qui
laisse passer tous les messages a lui aussi raison 90 fois sur 100, et il
n’a arrêté aucun pourriel
(Figure 8figure 8).
Figure 8. Les mêmes 100 messages jugés deux fois : en laissant passer tous les messages, et par un filtre antipourriel. Les deux ont raison pour 90 messages. L'exemple est inventé.
Le score d’une telle méthode simple s’appelle un étalon.
avec deux classes, a raison environ une fois sur deux
Classe majoritaire
répond toujours la classe la plus fréquente
a raison aussi souvent que cette classe apparaît : 90 % lorsque neuf éléments sur dix lui appartiennent
Réponse la plus fréquente pour chaque élément
donne à chaque élément la réponse qu’il a reçue le plus souvent dans un ensemble d’exemples étiquetés ; possible seulement lorsque les mêmes éléments reviennent, comme le font les mots
dépend de la tâche, et peut être élevé : environ 92 % des mots pour l’étiquetage morphosyntaxique de l’anglais, l’exemple ci-dessous
Trois étalons simples pour une tâche de classification.
Un étalon peut aussi être un outil existant : on attend alors d’un nouveau
système qu’il fasse mieux que celui qu’il remplace.Le troisième
étalon n’est pas toujours possible : il lui faut des exemples étiquetés, et
les éléments du test doivent revenir dans ces exemples, comme le font les
mots dans un texte suivi. Jurafsky et Martin (2026) le donnent pour
l’étiquetage morphosyntaxique. Il n’y a pas deux courriels identiques, de
sorte qu’un filtre antipourriel n’a pas d’étalon de ce type.
Figure 9. Étiquetage morphosyntaxique de l'anglais : la proportion de mots étiquetés correctement par l'étalon, par les meilleurs systèmes et par des personnes, avec le haut de l'échelle agrandi (Jurafsky & Martin, 2026).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Interpreting a scoreInterpréter un score
What a score depends on
A score of 0.53 for a term extractor, or of 80 % for a chatbot on a set of
questions, looks like a property of the system, but five other things
produced it:
What counts as correct. An evaluation has to decide how strictly an
output must match the gold standard. For example, if a tool returns
half-halts and the gold standard has half-halt, the output can be
counted as correct or as wrong. The stricter the rule, the lower the
score (see also the Matching rules page, in the Evaluating language technology module) (voir aussi la page Les règles de correspondance, dans le module L'évaluation des technologies langagières).
A score says how often a system was wrong, but not how. Whatever the way of
evaluating, looking at the output itself always adds something to the score,
and it can be done in two ways:
Qualitative error analysis: a person reads a sample of the output,
wrong and correct, and describes what the system does.
Error analysis has two uses:
It finds flaws that a score does not show. For example, a
large language model can score very poorly because its answers are not
in the format that was asked for, so the program that counts them cannot
read them, although the answers themselves are good.
A difference between two scores means something only when the texts, the
gold standard or the judges, and the rule for what counts as correct are the
same for both.
Even then, a small difference can arise by chance. The smaller the evaluation
data, the more easily that happens, and for a system built on a large
language model, two runs of the same evaluation can already give different
scores. Statistical significance tests estimate whether a difference is
larger than chance would produce (Dror et al., 2018). In practice, a
difference is more convincing when the evaluation data are large, when the
evaluation was run several times, and when the difference is larger than the
variation between runs.
Sources
Dror, R., Baumer, G., Shlomov, S., & Reichart, R. (2018). The Hitchhiker's Guide to Testing Statistical Significance in Natural Language Processing. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 1383–1392. https://doi.org/10.18653/v1/P18-1128
Freitag, M., Foster, G., Grangier, D., Ratnakar, V., Tan, Q., & Macherey, W. (2021). Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation. Transactions of the Association for Computational Linguistics, 9, 1460–1474. https://doi.org/10.1162/tacl_a_00437
Ouyang, S., Zhang, J. M., Harman, M., & Wang, M. (2025). An Empirical Study of the Non-Determinism of ChatGPT in Code Generation. ACM Transactions on Software Engineering and Methodology, 34(2). https://doi.org/10.1145/3697010
Rigouts Terryn, A., Hoste, V., Drouin, P., & Lefever, E. (2020b). TermEval 2020: Shared Task on Automatic Term Extraction Using the Annotated Corpora for Term Extraction Research (ACTER) Dataset. Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020), 85–94. https://aclanthology.org/2020.computerm-1.12/
Ce dont dépend un score
Un score de 0,53 pour un extracteur de termes, ou de 80 % pour un agent
conversationnel sur un ensemble de questions, a l’air d’une propriété du
système, mais cinq autres éléments l’ont produit :
Les sorties comptées comme correctes. Une évaluation doit décider avec
quelle rigueur une sortie doit correspondre à l’étalon de référence. Par
exemple, si un outil renvoie demi-arrêts et que l’étalon de référence
contient demi-arrêt, la sortie peut être comptée comme correcte ou comme
fausse. Plus la règle est stricte, plus le score est
bas (see also the Matching rules page, in the Evaluating language technology module) (voir aussi la page Les règles de correspondance, dans le module L'évaluation des technologies langagières).
Un score dit à quelle fréquence un système s’est trompé, mais pas comment.
Quelle que soit la façon d’évaluer, examiner la sortie elle-même ajoute
toujours quelque chose au score, et cela peut se faire de deux façons :
L’analyse qualitative des erreurs : une personne lit un échantillon de
la sortie, fautif et correct, et décrit ce que fait le système.
L’analyse des erreurs a deux utilités :
Elle révèle des défauts qu’un score ne montre pas. Par exemple, un
grand modèle de langue peut obtenir un très mauvais score parce que ses
réponses ne sont pas dans le format demandé, de sorte que le programme qui
les compte ne peut pas les lire, alors que les réponses elles-mêmes sont
bonnes.
Une différence entre deux scores n’a de sens que si les textes, l’étalon de
référence ou les juges, et la règle qui fixe les sorties comptées comme
correctes sont les mêmes pour les deux.
Même dans ce cas, une petite différence peut être due au hasard. Plus les
données d’évaluation sont peu nombreuses, plus cela se produit facilement,
et pour un système construit sur un grand modèle de langue, deux exécutions
de la même évaluation peuvent déjà donner des scores différents. Les tests
de signification statistique estiment si une différence est plus grande que
ce que le hasard produirait (Dror et al., 2018). En pratique, une différence
est plus convaincante lorsque les données d’évaluation sont nombreuses,
lorsque l’évaluation a été exécutée plusieurs fois et lorsque la différence
est plus grande que la variation entre les exécutions.
Sources
Dror, R., Baumer, G., Shlomov, S., & Reichart, R. (2018). The Hitchhiker's Guide to Testing Statistical Significance in Natural Language Processing. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 1383–1392. https://doi.org/10.18653/v1/P18-1128
Freitag, M., Foster, G., Grangier, D., Ratnakar, V., Tan, Q., & Macherey, W. (2021). Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation. Transactions of the Association for Computational Linguistics, 9, 1460–1474. https://doi.org/10.1162/tacl_a_00437
Ouyang, S., Zhang, J. M., Harman, M., & Wang, M. (2025). An Empirical Study of the Non-Determinism of ChatGPT in Code Generation. ACM Transactions on Software Engineering and Methodology, 34(2). https://doi.org/10.1145/3697010
Rigouts Terryn, A., Hoste, V., Drouin, P., & Lefever, E. (2020b). TermEval 2020: Shared Task on Automatic Term Extraction Using the Annotated Corpora for Term Extraction Research (ACTER) Dataset. Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020), 85–94. https://aclanthology.org/2020.computerm-1.12/
Evaluating extraction and classificationÉvaluation de l'extraction et de la classification
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
False positives and false negativesFaux positifs et faux négatifs
Extraction and classification
This chapter is about two kinds of system
(Figure 1figure 1):
For example, a term extractor, a tool that lists the specialized terms of a
text, is run on a sentence about dressage, an equestrian sport
(Figure 2figure 2):
the tool returns a list of three candidates: flying change, last corner
and collected canter;
the gold standard is a list of three terms: flying change, half-halt
and collected canter.
Two candidates are on both lists, so they are correct. The tool has also
made two errors, of different kinds:
last corner was returned, but it is not a term;
half-halt is a term, but it was not returned.
Figure 2. A text, the list of the gold standard and the list a tool returned: two correct candidates, one term that was missed and one candidate that is not a term.
The four outcomes
When the output of a system is compared with a gold standard, every decision
is one of four cases, defined in the boxes below and often abbreviated TP, FP,
FN and TN.
In the example above, flying change and collected canter are true
positives, last corner is a false positive and half-halt is a false
negative. The true negatives are everything else in the text.
Figure 3figure 3 builds up the four cases for a term
extractor.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. The four outcomes as regions: what is in the gold standard, what the system returned, and where the two overlap.
Jurafsky and Martin (2026) present the same four cases as a table, called a
confusion matrix, for a system that sorts items into two classes, such as a
spam filter: a message stopped by mistake is a false positive, and spam that
reaches the inbox is a false negative.
In the gold standard
Not in the gold standard
Returned by the system
true positive
false positive
Not returned by the system
false negative
true negative
The four outcomes as a confusion matrix.
Noise and silence
The false positives are also called noise, and the false negatives silence.
You can interpret the two words quite literally: noise is output that should
not be there, and silence is output that is missing.
True negatives
The fourth case differs between the two kinds of system
(Figure 4figure 4):
For a spam filter, each message is one item, so the true negatives, the
messages that are not spam and were let through, can be counted.
For a system that finds things in a text, such as a term extractor, the
true negatives would be every word and every sequence of words that is not
a term and was not returned. Such units vary in length and overlap, so
their number is not well defined (Hripcsak & Rothschild, 2005).
Figure 4. True negatives in the two kinds of system: messages can be counted, but the units of a text that are not terms vary in length and overlap.
The two errors work against each other. A tool set to return more candidates
misses fewer terms, but it also returns more units that are not terms. A tool
set to return fewer candidates does the reverse.
In Figure 5figure 5, a tool has ranked twelve candidates, and the
list is cut at three points. The further down the list the cut is made, the
fewer terms are missed and the more noise comes with them. An evaluation
therefore reports each of the two errors as well as a score that combines
them.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 5. One ranked list of candidates cut at three points, against a gold standard of eight terms.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Extraction et classification
Ce chapitre porte sur deux types de système
(Figure 1figure 1) :
Figure 1. Les deux types de système de ce chapitre : l'un donne la liste des éléments qu'il a repérés dans un texte, l'autre donne une étiquette à chaque élément.
Par exemple, un extracteur de termes, un outil qui dresse la liste des termes
spécialisés d’un texte, traite une phrase sur le dressage, un sport équestre
(Figure 2figure 2) :
l’outil propose une liste de trois candidats : changement de pied,
dernier coin et galop rassemblé ;
l’étalon de référence est une liste de trois termes : changement de pied,
demi-arrêt et galop rassemblé.
Deux candidats figurent sur les deux listes : ils sont donc corrects. L’outil
a aussi fait deux erreurs, de types différents :
dernier coin a été proposé, mais ce n’est pas un terme ;
demi-arrêt est un terme, mais il n’a pas été trouvé.
Figure 2. Un texte, la liste de l'étalon de référence et la liste proposée par un outil : deux candidats corrects, un terme manqué et un candidat qui n'est pas un terme.
Les quatre cas
Quand la sortie d’un système est comparée à un étalon de référence, chaque
décision correspond à l’un de quatre cas, définis dans les encadrés
ci-dessous et souvent abrégés VP, FP, FN et VN.
Dans l’exemple ci-dessus, changement de pied et galop rassemblé sont des
vrais positifs, dernier coin est un faux positif et demi-arrêt est un
faux négatif. Les vrais négatifs sont tout le reste du texte.
La Figure 3figure 3 construit les quatre cas pour un extracteur
de termes.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. Les quatre cas sous forme de zones : ce qui est dans l'étalon de référence, ce que le système a trouvé, et là où les deux se chevauchent.
Jurafsky et Martin (2026) présentent les mêmes quatre cas sous forme de
tableau, appelé matrice de confusion, pour un système qui classe des éléments
en deux classes, comme un filtre antipourriel : un message arrêté par erreur
est un faux positif, et un pourriel qui arrive dans la boîte de réception est
un faux négatif.
Dans l’étalon de référence
Absent de l’étalon de référence
Trouvé par le système
vrai positif
faux positif
Non trouvé par le système
faux négatif
vrai négatif
Les quatre cas sous forme de matrice de confusion.
Le bruit et le silence
L’ensemble des faux positifs s’appelle aussi le bruit, et l’ensemble des faux
négatifs, le silence. Les deux mots peuvent se comprendre littéralement : le
bruit est ce qui ne devrait pas se trouver dans la sortie, et le silence, ce
qui y manque.
Les vrais négatifs
Le quatrième cas n’est pas le même pour les deux types de système
(Figure 4figure 4) :
Pour un filtre antipourriel, chaque message est un élément : les vrais
négatifs, les messages qui ne sont pas des pourriels et que le filtre a
laissés passer, peuvent donc être comptés.
Pour un système qui repère des éléments dans un texte, comme un extracteur
de termes, les vrais négatifs seraient chaque mot et chaque suite de mots
qui n’est pas un terme et n’a pas été trouvée. Ces unités varient en
longueur et se chevauchent : leur nombre n’est donc pas bien défini
(Hripcsak & Rothschild, 2005).
Figure 4. Les vrais négatifs dans les deux types de système : les messages peuvent être comptés, mais les unités d'un texte qui ne sont pas des termes varient en longueur et se chevauchent.
Les deux erreurs s’opposent. Un outil réglé pour proposer plus de candidats
manque moins de termes, mais il propose aussi plus d’unités qui ne sont pas
des termes. Un outil réglé pour proposer moins de candidats fait l’inverse.
Dans Figure 5figure 5, un outil a classé douze candidats, et la
liste est coupée à trois endroits. Plus la coupure se fait bas dans la liste,
moins il manque de termes, et plus il y a de bruit. Une évaluation indique
donc chacune des deux erreurs, en plus d’un score qui les combine.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 5. Une liste classée de candidats coupée à trois endroits, comparée à un étalon de référence de huit termes.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Precision, recall and F1Précision, rappel et score F1
Figure 6. The parts that precision and recall are calculated from: the terms in the gold standard, the candidates the system returned, and their overlap.
Each score can be explained in several ways, and one may be clearer to you
than the others:
In this example, a term extractor returns ten candidates for a short text
about dressage, and the gold standard for that text has nine terms
(Figure 7figure 7).
Figure 7. A gold standard of nine terms and the ten candidates of a tool, coloured by outcome.
Five candidates are on both lists, so there are 5 true positives, 5 false
positives and 4 false negatives
(Figure 8figure 8):
precision = 5 / (5 + 5) = 0.50;
recall = 5 / (5 + 4) = 0.56.
Figure 8. Precision and recall measure the same overlap against two different totals: what the system returned, and what the gold standard contains.
The F1 score
The F1 score combines precision and recall into one number.
It is twice their product divided by their sum:
F1 = 2 × precision × recall / (precision + recall), here
2 × 0.50 × 0.56 / (0.50 + 0.56) = 0.53. As a harmonic mean, it is closer to
the lower of the two values than an ordinary average would be (Jurafsky &
Martin, 2026), so a tool cannot score well by doing one thing only. For
example, if a tool returned every word and every sequence of words of a text,
it would have perfect recall, a precision close to zero, and an F1 score
close to zero (Figure 9figure 9).
Figure 9. The F1 score and the ordinary average of precision and recall, for the tool of the worked example and for a tool that returns everything.
The scores change with the number of candidates a tool returns.
Figure 10figure 10 gives the three scores after each candidate of the ranked list of
Figure 5figure 5: as more candidates are kept, precision falls and recall
rises, and the F1 score is highest after seven candidates.
Figure 10. Precision, recall and F1 after each candidate of one ranked list, against a gold standard of eight terms.
More than two classes
When a system sorts items into more than two classes, for example emails into
urgent, normal and spam, precision and recall are calculated for each class.
The scores of the classes are then averaged (macroaveraging), or the
decisions for all classes are pooled before the calculation (microaveraging),
in which case the most frequent class has the most influence on the result
(Jurafsky & Martin, 2026).
Figure 11figure 11 calculates it for a spam filter and 100 messages: 10 of the
messages are spam, and the filter stops 6 of them and 6 messages that are not
spam.
Figure 11. The same 100 messages judged by a spam filter and by letting every message through: the same accuracy, very different recall.
Accuracy is misleading when the class to find is rare, as the second matrix
shows. Jurafsky and Martin (2026) give a more extreme example: a million social media
posts, of which a hundred are about the product a company wants to follow: a system that labels every
post as not about the product is right for 99.99 % of the posts, but it has
found none of the hundred. Precision and recall do not count the true
negatives, so the same system has a recall of
zero (see also the Baselines page, in the Evaluating language technology module) (voir aussi la page Les étalons, dans le module L'évaluation des technologies langagières).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Figure 6. Les parties à partir desquelles se calculent la précision et le rappel : les termes de l'étalon de référence, les candidats proposés par le système, et leur chevauchement.
Chaque score peut s’expliquer de plusieurs façons, et l’une d’elles vous
paraîtra peut-être plus claire que les autres :
Précision
sous forme de formule : précision = VP / (VP + FP) ;
Dans cet exemple, un extracteur de termes propose dix candidats pour un
court texte sur le dressage, et l’étalon de référence de ce texte compte neuf
termes
(Figure 7figure 7).
Figure 7. Un étalon de référence de neuf termes et les dix candidats d'un outil, en couleur selon le cas.
Cinq candidats figurent sur les deux listes : il y a donc 5 vrais positifs,
5 faux positifs et 4 faux négatifs
(Figure 8figure 8) :
précision = 5 / (5 + 5) = 0,50 ;
rappel = 5 / (5 + 4) = 0,56.
Figure 8. La précision et le rappel mesurent le même chevauchement par rapport à deux totaux différents : ce que le système a trouvé, et ce que contient l'étalon de référence.
Le score F1
Le score F1 combine la précision et le rappel en un seul nombre.
Il vaut deux fois leur produit, divisé par leur somme :
F1 = 2 × précision × rappel / (précision + rappel), ici
2 × 0,50 × 0,56 / (0,50 + 0,56) = 0,53. Comme moyenne harmonique, il est plus
proche de la plus basse des deux valeurs que ne le serait une moyenne
ordinaire (Jurafsky & Martin, 2026) : un outil ne peut donc pas obtenir un bon
score en ne faisant qu’une seule chose. Par exemple, si un outil proposait
chaque mot et chaque suite de mots d’un texte, il aurait un rappel parfait,
une précision proche de zéro et un score F1 proche de zéro
(Figure 9figure 9).
Figure 9. Le score F1 et la moyenne ordinaire de la précision et du rappel, pour l'outil de l'exemple détaillé et pour un outil qui propose tout.
Les scores changent avec le nombre de candidats qu’un outil propose.
La Figure 10figure 10 donne les trois scores après chaque candidat de la liste classée de
Figure 5figure 5 : à mesure qu’on garde plus de candidats, la précision baisse et
le rappel augmente, et le score F1 est le plus élevé après sept candidats.
Figure 10. La précision, le rappel et le score F1 après chaque candidat d'une liste classée, comparée à un étalon de référence de huit termes.
Plus de deux classes
Quand un système classe des éléments en plus de deux classes, par exemple des
courriels en urgents, normaux et pourriels, la précision et le rappel se
calculent pour chaque classe. On fait ensuite la moyenne des scores des
classes (macromoyenne), ou on regroupe les décisions de toutes les classes
avant le calcul (micromoyenne) ; dans ce cas, la classe la plus fréquente
pèse le plus sur le résultat (Jurafsky & Martin, 2026).
La Figure 11figure 11 la calcule pour un filtre antipourriel et 100 messages : 10
de ces messages sont des pourriels, et le filtre en arrête 6, ainsi que 6
messages qui ne sont pas des pourriels.
Figure 11. Les mêmes 100 messages jugés par un filtre antipourriel et en laissant passer tous les messages : la même exactitude, un rappel très différent.
L’exactitude est trompeuse quand la classe à trouver est rare, comme le
montre la deuxième matrice. Jurafsky et Martin (2026) donnent un exemple plus
extrême : un million de publications sur les réseaux sociaux, dont une
centaine portent sur le produit qu’une entreprise veut suivre. Un système qui
étiquette chaque publication comme ne portant pas sur le produit a raison
pour 99,99 % des publications, mais il n’a trouvé aucune des cent. La
précision et le rappel ne comptent pas les vrais négatifs : le même système a
donc un rappel de
zéro (see also the Baselines page, in the Evaluating language technology module) (voir aussi la page Les étalons, dans le module L'évaluation des technologies langagières).
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Practice: precision, recall and F1Pratique : précision, rappel et score F1
The gold standard has eight terms and the tool found four of them. Recall is the share of the terms of the gold standard that the tool found: 4 / 8 = 0.50.
La référence compte huit termes et l'outil en a trouvé quatre. Le rappel est la part des termes de la référence que l'outil a trouvés : 4 / 8 = 0,50.
ExerciseExercice 3 · the F1 scorele score F1not startedà fairesolvedréussikeep tryingà retravailler
What is the F1 score of the tool? Round the answer to two decimals.
Quel est le score F1 de l'outil ? Arrondissez la réponse à deux décimales.
Show the explanationVoir l'explication
The F1 score is twice the product of precision and recall, divided by their sum: 2 × 0.67 × 0.50 / (0.67 + 0.50) = 0.57. It lies between the two values, closer to the lower one.
Le score F1 vaut deux fois le produit de la précision et du rappel, divisé par leur somme : 2 × 0,67 × 0,50 / (0,67 + 0,50) = 0,57. Il se situe entre les deux valeurs, plus près de la plus basse.
A second tool returns twenty candidates for the same text, and all eight terms of the gold standard are among them. Which of the following statements is true?
Un deuxième outil propose vingt candidats pour le même texte, et les huit termes de la référence en font partie. Lequel des énoncés suivants est exact ?
Show the solutionVoir la solution
The second tool has a recall of 8 / 8 = 1.00 and a precision of 8 / 20 = 0.40. Its F1 score is therefore 2 × 0.40 × 1.00 / (0.40 + 1.00) = 0.57, the same as the first tool's.
Two tools can reach the same F1 score with opposite errors: the first misses half of the terms, and most of the second tool's candidates are not terms. That is why an evaluation reports precision and recall as well as the F1 score.
Le deuxième outil a un rappel de 8 / 8 = 1,00 et une précision de 8 / 20 = 0,40. Son score F1 est donc de 2 × 0,40 × 1,00 / (0,40 + 1,00) = 0,57, comme celui du premier outil.
Deux outils peuvent obtenir le même score F1 avec des erreurs opposées : le premier manque la moitié des termes, et la plupart des candidats du second ne sont pas des termes. C'est pourquoi une évaluation indique la précision et le rappel en plus du score F1.
Partial matches and cut-off in term extraction. Reported scores differ greatly depending
on how strict the evaluation is, for example on whether partial matches are
accepted, and they change with the point at which a ranked list is cut off
(Rigouts Terryn et al., 2019).
Unique terms or occurrences. Scores for every occurrence in the running text
and scores for a list of unique terms can lead to different conclusions,
for example about the language or the domain in which a system does best
(Rigouts Terryn et al., 2022b).
A strict comparison has two outcomes, correct or not, but many candidates of
a term extractor are between the two
(Figure 13figure 13):
the candidate is part of a term in the gold standard;
the candidate is a term of the gold standard with another word attached;
the candidate would be a term for some purposes and not for others.
Figure 13. Between a candidate that is wrong and one that is right: three cases a strict comparison counts as errors.
The same cases come up in named entity recognition, for instance Curie for
Marie Curie, or the University of Paris with one word too many. A strict
evaluation counts all of them as errors. A more lenient evaluation
accepts some of them and gives higher scores, so scores obtained with
different rules cannot be compared.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Correspondances partielles et seuil en extraction de termes. Les scores
publiés varient beaucoup selon la rigueur de l’évaluation, par exemple selon
que les correspondances partielles sont acceptées ou non, et ils changent
avec l’endroit où une liste classée est coupée (Rigouts Terryn et al.,
2019).
Termes uniques ou occurrences. Les scores calculés sur chaque
occurrence dans le texte et les scores calculés sur une liste de termes
uniques peuvent mener à des conclusions différentes, par exemple sur la
langue ou le domaine où un système réussit le mieux (Rigouts Terryn et al.,
2022b).
Une comparaison stricte n’a que deux issues, correct ou non, mais beaucoup de
candidats d’un extracteur de termes se situent entre les deux
(Figure 13figure 13) :
le candidat est une partie d’un terme de l’étalon de référence ;
le candidat est un terme de l’étalon de référence auquel s’ajoute un autre
mot ;
le candidat serait un terme pour certains usages, mais pas pour d’autres.
Figure 13. Entre un candidat faux et un candidat juste : trois cas qu'une comparaison stricte compte comme des erreurs.
Les mêmes cas se présentent en reconnaissance d’entités nommées, par exemple
Curie pour Marie Curie, ou l’Université de Paris avec un mot de trop.
Une évaluation stricte les compte tous comme des erreurs. Une évaluation plus
souple en accepte certains et donne des scores plus élevés : des scores
obtenus avec des règles différentes ne peuvent donc pas être comparés.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Agreement as an F1 scoreL'accord mesuré par le score F1
Measured this way, the IAA between people is on the same scale as the score
of a system, and the two can be set side by side.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
Figure 14. Deux annotateurs évalués l'un par rapport à l'autre : la précision et le rappel s'inversent selon l'étalon de référence, et le score F1 ne change pas.
Mesuré ainsi, l’accord inter-annotateurs est sur la même échelle que le score
d’un système, et les deux peuvent être comparés directement.
Sources
Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
🔒 Projet 1 · The group's annotationsProjet 1 · Les annotations du groupeis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Projet 1 · The group's annotationsProjet 1 · Les annotations du groupe
The group's agreement scoresLes scores d'accord du groupe
#FORMAT=WebAnno TSV 3.3#T_SP=webanno.custom.Terme|Commentaire#Text=Among the various cardiovascular diseases, heart failure (HF) is projected to have the largest increases in incidence over the coming decades; therefore, improving HF prediction is of significant value.2-6 187-201 cardiovascular *[8] 2-7 202-210 diseases *[8] 2-8 210-211 , _ 2-9 212-217 heart *[9] 2-10 218-225 failure *[9] 2-11 226-227 ( _ 2-12 227-229 HF * 2-13 229-230 ) _ 2-14 231-233 is _ …2-20 264-273 increases _ 2-21 274-276 in _ 2-22 277-286 incidence *
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 1. Du fichier exporté au score F1, sur une phrase, entre deux annotateurs pris comme exemple, A et B.
Scores computed on 5 October 2026 from the INCEpTION export; initials instead of names.Scores calculés le 5 octobre 2026 à partir de l'export INCEpTION ; des initiales plutôt que des noms.
La colonne « moyenne », au bout de votre ligne, est votre accord moyen
avec les huit autres personnes, pour la langue et la règle choisies au-dessus
du tableau : c’est le chiffre que demande le rapport individuel (section 3.1,
règle 3).
Les couleurs vont du score le plus bas de ce tableau au plus haut ; la
légende donne les deux valeurs.
L’accord moyen du groupe est la moyenne des 36 scores F1 du tableau, une fois
par langue et par règle de correspondance.
Rule 1: exactRègle 1 : exacte
Rule 2: formRègle 2 : forme
Rule 3: pluralRègle 3 : pluriel
English textsTextes en anglais
Mean agreement (F1)Accord moyen (F1)
0.520,52
0.530,53
0.530,53
Terms marked by at least one personTermes marqués par au moins une personne
434
407
389
Mean size of a listTaille moyenne d'une liste
167
160
152
Shortest and longest listListe la plus courte et la plus longue
83 and 31783 et 317
79 and 29779 et 297
75 and 28175 et 281
Majority listListe majoritaire
133
127
118
French textsTextes en français
Mean agreement (F1)Accord moyen (F1)
0.590,59
0.590,59
0.600,60
Terms marked by at least one personTermes marqués par au moins une personne
414
379
357
Mean size of a listTaille moyenne d'une liste
174
160
153
Shortest and longest listListe la plus courte et la plus longue
108 and 250108 et 250
97 and 22997 et 229
94 and 21694 et 216
Majority listListe majoritaire
146
131
125
Ce que chaque règle de correspondance change pour ce groupe : l'accord moyen (la moyenne des 36 paires), le nombre de termes différents, la taille des listes et celle de la liste majoritaire.
Les règles de correspondance
Les règles 2 et 3 réunissent des formes que la règle 1 sépare, par exemple
« disease » et « diseases » (see also the Project 1 · Step by step page, in the Course materials module) (voir aussi la page Projet 1 · Pas à pas, dans le module Matériel de cours).
Le tableau montre ce que cela change pour ce groupe : de la règle 1 à la règle 3,
les termes différents, les listes et la liste majoritaire raccourcissent
d’environ un dixième en anglais et un peu plus en français, mais l’accord
monte à peine. Les désaccords portent donc rarement sur la forme d’un terme : ils
portent sur ce qui compte comme terme et sur ses frontières, que
les règles ne touchent pas.
L’anglais et le français
Le groupe s’accorde mieux sur les textes français, selon les trois
règles. Les textes français et anglais sont des résumés différents : l’écart
peut donc venir des textes autant que de la langue.
Le nombre de termes
Ensemble, les neuf personnes ont marqué bien plus de termes différents
qu’une seule liste n’en contient : selon la règle 3, 389 en anglais et 357 en
français, contre 152 et 153 dans une liste moyenne.
Les listes diffèrent par les termes retenus, et aussi par leur nombre :
en anglais, la plus longue compte près de quatre fois plus de termes que la
plus courte. Deux listes de tailles très différentes ne peuvent pas avoir un
F1 élevé, même si la plus courte est entièrement comprise dans la plus
longue : pour ces deux listes extrêmes, le F1 ne peut pas dépasser 0,42.
Par rapport à la recherche
Les scores d’accord du groupe sont du même ordre que ceux d’études publiées. Dans une étude
sur des résumés scientifiques en anglais sur l’insuffisance cardiaque, huit
personnes aux profils variés obtenaient un F1 moyen de 0,48 avec de simples
définitions du terme, et de 0,59 avec des consignes complètes, calculé comme
ici entre chaque paire de personnes et sur les formes distinctes (Rigouts
Terryn et al., 2020a, tableau 2). Un accord entre 0,5 et 0,6 reflète la
difficulté de la tâche.
Sources
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
This page is only available in French.
Comparing two lists, term by termComparer deux listes, terme par terme
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. Un vote majoritaire sur neuf listes fictives.
Le groupe et la référence
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.320,32
0.490,49
FD
1.001,00
0.360,36
0.530,53
GH
1.001,00
0.730,73
0.840,84
JD
1.001,00
0.380,38
0.550,55
JC
1.001,00
0.510,51
0.670,67
JP
1.001,00
0.360,36
0.530,53
LA
1.001,00
0.190,19
0.320,32
MI
1.001,00
0.360,36
0.530,53
VL
1.001,00
0.250,25
0.400,40
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.970,97
0.450,45
0.610,61
FD
0.910,91
0.470,47
0.620,62
GH
0.800,80
0.830,83
0.810,81
JD
0.930,93
0.500,50
0.650,65
JC
0.940,94
0.680,68
0.790,79
JP
0.920,92
0.480,48
0.630,63
LA
0.930,93
0.250,25
0.400,40
MI
0.990,99
0.510,51
0.670,67
VL
0.970,97
0.350,35
0.520,52
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.890,89
0.530,53
0.670,67
FD
0.760,76
0.510,51
0.610,61
GH
0.650,65
0.880,88
0.750,75
JD
0.850,85
0.580,58
0.690,69
JC
0.840,84
0.780,78
0.810,81
JP
0.860,86
0.580,58
0.690,69
LA
0.900,90
0.320,32
0.470,47
MI
0.940,94
0.620,62
0.740,74
VL
0.960,96
0.450,45
0.610,61
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.820,82
0.660,66
0.730,73
FD
0.620,62
0.560,56
0.590,59
GH
0.520,52
0.940,94
0.670,67
JD
0.690,69
0.640,64
0.670,67
JC
0.700,70
0.880,88
0.780,78
JP
0.730,73
0.660,66
0.690,69
LA
0.810,81
0.390,39
0.520,52
MI
0.810,81
0.730,73
0.770,77
VL
0.920,92
0.580,58
0.710,71
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.760,76
0.800,80
0.780,78
FD
0.500,50
0.590,59
0.550,55
GH
0.410,41
0.980,98
0.580,58
JD
0.560,56
0.680,68
0.610,61
JC
0.570,57
0.950,95
0.720,72
JP
0.610,61
0.730,73
0.670,67
LA
0.770,77
0.480,48
0.590,59
MI
0.690,69
0.810,81
0.740,74
VL
0.790,79
0.650,65
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.620,62
0.890,89
0.730,73
FD
0.420,42
0.670,67
0.520,52
GH
0.310,31
1.001,00
0.470,47
JD
0.470,47
0.790,79
0.590,59
JC
0.430,43
0.960,96
0.590,59
JP
0.490,49
0.790,79
0.600,60
LA
0.690,69
0.580,58
0.630,63
MI
0.550,55
0.870,87
0.670,67
VL
0.650,65
0.720,72
0.680,68
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.440,44
1.001,00
0.610,61
FD
0.280,28
0.720,72
0.400,40
GH
0.190,19
1.001,00
0.320,32
JD
0.340,34
0.900,90
0.490,49
JC
0.270,27
0.980,98
0.430,43
JP
0.370,37
0.950,95
0.530,53
LA
0.540,54
0.740,74
0.630,63
MI
0.360,36
0.920,92
0.520,52
VL
0.460,46
0.820,82
0.580,58
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.310,31
1.001,00
0.470,47
FD
0.240,24
0.860,86
0.370,37
GH
0.140,14
1.001,00
0.240,24
JD
0.250,25
0.950,95
0.400,40
JC
0.200,20
1.001,00
0.330,33
JP
0.270,27
0.980,98
0.420,42
LA
0.430,43
0.840,84
0.570,57
MI
0.280,28
1.001,00
0.430,43
VL
0.330,33
0.840,84
0.470,47
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.140,14
1.001,00
0.250,25
FD
0.130,13
1.001,00
0.230,23
GH
0.060,06
1.001,00
0.120,12
JD
0.120,12
1.001,00
0.220,22
JC
0.090,09
1.001,00
0.170,17
JP
0.130,13
1.001,00
0.230,23
LA
0.240,24
1.001,00
0.390,39
MI
0.130,13
1.001,00
0.230,23
VL
0.180,18
1.001,00
0.310,31
The 133 terms at least 5 of the 9 annotators markedLes 133 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 20 terms9 sur 9 · 20 termes
body mass index
cardiac resynchronization therapy
cardiovascular diseases
case-control analysis
CHF
clinical practice
congestive heart failure
cTnT
diabetes mellitus
ejection fraction
heart failure
heart rate
hyperkalemia
intubations
left ventricular ejection fraction
morbidity
mortality
spironolactone
systolic heart failure
Troponin T
8 of 9 · 23 terms8 sur 9 · 23 termes
biomarker
biomarkers
clinical trials
confidence intervals
CRT
diabetes
dialysis
dialysis-dependent patients
echocardiograms
emergency department
HF
high-sensitivity assay
hospitalization
implantation
International Classification of Diseases
intubated
laboratory report
NT-proBNP
periprocedural
reverse remodeling
Spironolactone
systolic blood pressure
β-blocker
7 of 9 · 18 terms7 sur 9 · 18 termes
acute kidney injury
AUCs
bundle branch morphology
CIs
confidence interval
Congestive heart failure
echocardiographic
ED
hazard ratio
heart failure patients
HF prediction model
implant
implantable cardioverter-defibrillator
N-terminal pro-B-type natriuretic peptide
NRIs
randomized trials
regression analyses
symptomatic systolic heart failure
6 of 9 · 37 terms6 sur 9 · 37 termes
Aldosterone receptor antagonists
all-cause hospitalization
angiotensin II receptor blocker
angiotensin-converting enzyme inhibitor
ARIC HF model
atherosclerosis
AUC
cardiac troponin T
cardiomyopathy
CHF patients
clinical characteristics
clinical status
Cox regression
CRT implantation
Crude rates
device implantation
diagnosed
dialysis patients
dialysis-dependent
ED physicians
ED visits
end-of-life treatment
heart failure risk
incident HF
incident systolic heart failure
integrated discrimination improvement
Intubation
laboratory report model
medications
net reclassification improvement
NRI
patients
physicians
prevalent coronary heart disease
severe hyperkalemia
sex-specific models
treatment
5 of 9 · 35 terms5 sur 9 · 35 termes
adverse events
Aldosterone
all-cause hospitalizations
antagonists
antihypertensive medication
ARIC
atherosclerosis risk
Atherosclerosis Risk in Communities
Cardiac resynchronization therapy
cardiomyopathy origin
cardioverter-defibrillator
CHF treatments
class I recommendation
coronary heart disease
deactivation
deterioration
Dialysis
Dialysis patients
HF hospitalizations
hospitalizations
implantable
intubation
Intubation rates
intubation rates
model fit
natriuretic peptide
Patient
Patients
receptor
Retrospective cohort
risk of hospitalization
serum potassium level
sex-specific model
Student t test
time-varying covariates
The 130 terms found in only one of the 9 listsLes 130 termes présents dans une seule des 9 listes
"laboratory report" model
-fold
6-month echocardiograms
advances
AIM
analysis
analyze
area under the receiver operating characteristic curve (AUC)
ARIC)
assay
assessed
assessment
associated
association
atherosclerosis risk in communities
average
baseline serum creatinine
benefit
body mass
Cardiac resynchronization
cardiac troponin
characteristic curve (AUC)
coefficient
collect
communicate
compelling improvement
CONCLUSION
conclusion
CONCLUSIONS
confidence
confidence intervals (CIs)
congestive heart failure (CHF)
consecutive patients
coronary
correlation
correlation coefficient R
Cox
Cox regression with time-varying covariates
creatinine level
Crude
cTnT and NT-proBNP
current/former smoking
deactivation discussions
declined
decrease
decreases
described
developed
device
dialysis-dependent patients with heart failure
dialysis-dependent patients with HF
discrimination
discrimination improvement
discussed
echocardiographic outcomes.
emergency department (ED)
evaluate
excluded
failure
heart
Heart Function
HF risk
hypothesize
identified
improvement
improvements
incident
increased
increased risk of hyperkalemia
increases
increases in incidence
initiated
interval
interview data
left ventricular ejection
life
male
mean
mean follow-up
median
medication use
mellitus
men
mEq
month
n =
N-terminal pro-B-type
N-terminal pro-B-type natriuretic peptide:
observed
operating characteristic curve
operating characteristic curve (AUC)
PARTICIPANTS
participants
patient awareness
patient's
perspective
prediction model.
preferences
process
qualitative
Rates
rates of annual ED visits
receptor antagonists
reclassification
reduce
regression
report model
RESULTS
resynchronization
resynchronization therapy
Retrospective
serious complications
simple sex-specific model
simpler laboratory report model
smoking
statistically
Student t test,
studies
systolic heart failure,
theory
timing
total ED visits
trials
Troponin T and N-terminal pro-B-type natriuretic peptide
use
use of spironolactone
value
ventricular
visits
women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.330,33
0.500,50
FD
1.001,00
0.380,38
0.550,55
GH
1.001,00
0.730,73
0.840,84
JD
1.001,00
0.390,39
0.560,56
JC
1.001,00
0.500,50
0.670,67
JP
1.001,00
0.380,38
0.550,55
LA
1.001,00
0.190,19
0.330,33
MI
1.001,00
0.370,37
0.540,54
VL
1.001,00
0.260,26
0.410,41
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.460,46
0.620,62
FD
0.910,91
0.490,49
0.640,64
GH
0.810,81
0.830,83
0.820,82
JD
0.940,94
0.510,51
0.660,66
JC
0.940,94
0.670,67
0.780,78
JP
0.920,92
0.490,49
0.640,64
LA
0.920,92
0.250,25
0.400,40
MI
0.990,99
0.510,51
0.680,68
VL
0.980,98
0.350,35
0.520,52
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.900,90
0.540,54
0.670,67
FD
0.760,76
0.520,52
0.620,62
GH
0.670,67
0.880,88
0.760,76
JD
0.860,86
0.590,59
0.700,70
JC
0.850,85
0.770,77
0.810,81
JP
0.860,86
0.590,59
0.700,70
LA
0.910,91
0.320,32
0.470,47
MI
0.930,93
0.610,61
0.740,74
VL
0.970,97
0.450,45
0.610,61
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.820,82
0.670,67
0.740,74
FD
0.620,62
0.590,59
0.600,60
GH
0.530,53
0.950,95
0.680,68
JD
0.700,70
0.670,67
0.680,68
JC
0.710,71
0.880,88
0.780,78
JP
0.720,72
0.670,67
0.700,70
LA
0.800,80
0.380,38
0.520,52
MI
0.810,81
0.730,73
0.760,76
VL
0.910,91
0.580,58
0.710,71
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.760,76
0.800,80
0.780,78
FD
0.520,52
0.640,64
0.570,57
GH
0.420,42
0.980,98
0.590,59
JD
0.570,57
0.710,71
0.630,63
JC
0.580,58
0.940,94
0.720,72
JP
0.610,61
0.740,74
0.670,67
LA
0.760,76
0.470,47
0.580,58
MI
0.690,69
0.800,80
0.740,74
VL
0.800,80
0.650,65
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.650,65
0.870,87
0.750,75
FD
0.440,44
0.680,68
0.540,54
GH
0.340,34
1.001,00
0.510,51
JD
0.500,50
0.780,78
0.610,61
JC
0.470,47
0.960,96
0.630,63
JP
0.500,50
0.760,76
0.600,60
LA
0.700,70
0.550,55
0.610,61
MI
0.580,58
0.860,86
0.700,70
VL
0.710,71
0.730,73
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.440,44
1.001,00
0.610,61
FD
0.280,28
0.750,75
0.410,41
GH
0.200,20
1.001,00
0.330,33
JD
0.340,34
0.920,92
0.500,50
JC
0.280,28
0.980,98
0.440,44
JP
0.360,36
0.950,95
0.530,53
LA
0.540,54
0.730,73
0.620,62
MI
0.360,36
0.920,92
0.520,52
VL
0.460,46
0.810,81
0.590,59
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.310,31
1.001,00
0.470,47
FD
0.240,24
0.880,88
0.370,37
GH
0.140,14
1.001,00
0.250,25
JD
0.260,26
0.950,95
0.400,40
JC
0.200,20
1.001,00
0.340,34
JP
0.270,27
0.980,98
0.420,42
LA
0.440,44
0.830,83
0.580,58
MI
0.280,28
1.001,00
0.440,44
VL
0.340,34
0.830,83
0.480,48
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.150,15
1.001,00
0.260,26
FD
0.130,13
1.001,00
0.230,23
GH
0.070,07
1.001,00
0.130,13
JD
0.130,13
1.001,00
0.230,23
JC
0.100,10
1.001,00
0.180,18
JP
0.130,13
1.001,00
0.230,23
LA
0.250,25
1.001,00
0.400,40
MI
0.130,13
1.001,00
0.240,24
VL
0.190,19
1.001,00
0.320,32
The 127 terms at least 5 of the 9 annotators markedLes 127 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 20 terms9 sur 9 · 20 termes
body mass index
cardiac resynchronization therapy
cardiovascular diseases
case-control analysis
CHF
clinical practice
congestive heart failure
cTnT
diabetes mellitus
ejection fraction
heart failure
heart rate
hyperkalemia
intubations
left ventricular ejection fraction
morbidity
mortality
spironolactone
systolic heart failure
Troponin T
8 of 9 · 22 terms8 sur 9 · 22 termes
biomarker
biomarkers
clinical trials
confidence intervals
CRT
diabetes
dialysis
dialysis-dependent patients
echocardiograms
emergency department
HF
high-sensitivity assay
hospitalization
implantation
International Classification of Diseases
intubated
laboratory report
NT-proBNP
periprocedural
reverse remodeling
systolic blood pressure
β-blocker
7 of 9 · 17 terms7 sur 9 · 17 termes
acute kidney injury
AUCs
bundle branch morphology
CIs
confidence interval
echocardiographic
ED
hazard ratio
heart failure patients
HF prediction model
implant
implantable cardioverter-defibrillator
N-terminal pro-B-type natriuretic peptide
NRIs
randomized trials
regression analyses
symptomatic systolic heart failure
6 of 9 · 42 terms6 sur 9 · 42 termes
Aldosterone receptor antagonists
all-cause hospitalization
angiotensin II receptor blocker
angiotensin-converting enzyme inhibitor
ARIC
ARIC HF model
atherosclerosis
Atherosclerosis Risk in Communities
AUC
baseline
cardiac troponin T
cardiomyopathy
CHF patients
clinical characteristics
clinical status
Cox regression
CRT implantation
Crude rates
device implantation
diagnosed
dialysis patients
dialysis-dependent
ED physicians
ED visits
end-of-life treatment
heart failure risk
incident HF
incident systolic heart failure
integrated discrimination improvement
Intubation
Intubation rates
laboratory report model
medications
net reclassification improvement
NRI
patients
physicians
prevalent coronary heart disease
severe hyperkalemia
sex-specific models
Student t test
treatment
5 of 9 · 26 terms5 sur 9 · 26 termes
adverse events
Aldosterone
all-cause hospitalizations
antagonists
antihypertensive medication
atherosclerosis risk
cardiomyopathy origin
cardioverter-defibrillator
CHF treatments
class I recommendation
coronary heart disease
deactivation
deterioration
end of life
HF hospitalizations
hospitalizations
implantable
model fit
natriuretic peptide
Patient
receptor
Retrospective cohort
risk of hospitalization
serum potassium level
sex-specific model
time-varying covariates
The 119 terms found in only one of the 9 listsLes 119 termes présents dans une seule des 9 listes
-fold
6-month echocardiograms
advances
AIM
analysis
analyze
area under the receiver operating characteristic curve (AUC
assay
assessed
assessment
associated
association
average
baseline serum creatinine
benefit
body mass
cardiac troponin
characteristic curve (AUC
coefficient
collect
communicate
compelling improvement
CONCLUSION
CONCLUSIONS
confidence
confidence intervals (CIs
congestive heart failure (CHF
consecutive patients
coronary
correlation
correlation coefficient R
Cox
Cox regression with time-varying covariates
creatinine level
Crude
cTnT and NT-proBNP
current/former smoking
deactivation discussions
declined
decrease
decreases
described
developed
device
dialysis-dependent patients with heart failure
dialysis-dependent patients with HF
discrimination
discrimination improvement
discussed
emergency department (ED
evaluate
excluded
failure
heart
Heart Function
HF risk
hypothesize
identified
improvement
improvements
incident
increased
increased risk of hyperkalemia
increases
increases in incidence
initiated
interval
interview data
left ventricular ejection
life
male
mean
mean follow-up
median
medication use
mellitus
men
mEq
month
n =
N-terminal pro-B-type
observed
operating characteristic curve
operating characteristic curve (AUC
participants
patient awareness
patient's
perspective
prediction model
preferences
process
qualitative
rates of annual ED visits
receptor antagonists
reclassification
reduce
regression
report model
RESULTS
resynchronization
resynchronization therapy
Retrospective
serious complications
simple sex-specific model
simpler laboratory report model
smoking
statistically
studies
theory
timing
total ED visits
trials
Troponin T and N-terminal pro-B-type natriuretic peptide
use
use of spironolactone
value
ventricular
visits
women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.330,33
0.490,49
FD
1.001,00
0.400,40
0.570,57
GH
1.001,00
0.720,72
0.840,84
JD
1.001,00
0.390,39
0.560,56
JC
1.001,00
0.500,50
0.670,67
JP
1.001,00
0.380,38
0.550,55
LA
1.001,00
0.190,19
0.320,32
MI
1.001,00
0.360,36
0.530,53
VL
1.001,00
0.260,26
0.410,41
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.460,46
0.620,62
FD
0.910,91
0.510,51
0.650,65
GH
0.810,81
0.830,83
0.820,82
JD
0.930,93
0.510,51
0.660,66
JC
0.930,93
0.660,66
0.770,77
JP
0.920,92
0.490,49
0.640,64
LA
0.920,92
0.250,25
0.400,40
MI
0.990,99
0.510,51
0.670,67
VL
0.980,98
0.360,36
0.530,53
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.900,90
0.540,54
0.670,67
FD
0.760,76
0.550,55
0.640,64
GH
0.670,67
0.880,88
0.760,76
JD
0.850,85
0.600,60
0.700,70
JC
0.840,84
0.770,77
0.800,80
JP
0.860,86
0.600,60
0.710,71
LA
0.910,91
0.320,32
0.470,47
MI
0.930,93
0.610,61
0.740,74
VL
0.970,97
0.460,46
0.620,62
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.810,81
0.670,67
0.730,73
FD
0.620,62
0.620,62
0.620,62
GH
0.520,52
0.950,95
0.670,67
JD
0.700,70
0.680,68
0.690,69
JC
0.700,70
0.880,88
0.780,78
JP
0.730,73
0.690,69
0.710,71
LA
0.790,79
0.380,38
0.510,51
MI
0.810,81
0.730,73
0.770,77
VL
0.910,91
0.590,59
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.740,74
0.810,81
0.770,77
FD
0.520,52
0.680,68
0.590,59
GH
0.410,41
0.980,98
0.580,58
JD
0.570,57
0.730,73
0.640,64
JC
0.580,58
0.950,95
0.720,72
JP
0.610,61
0.760,76
0.680,68
LA
0.750,75
0.470,47
0.580,58
MI
0.680,68
0.810,81
0.740,74
VL
0.800,80
0.690,69
0.740,74
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.650,65
0.860,86
0.740,74
FD
0.440,44
0.710,71
0.540,54
GH
0.340,34
1.001,00
0.510,51
JD
0.510,51
0.800,80
0.630,63
JC
0.480,48
0.970,97
0.640,64
JP
0.520,52
0.790,79
0.630,63
LA
0.690,69
0.540,54
0.610,61
MI
0.600,60
0.880,88
0.710,71
VL
0.710,71
0.750,75
0.730,73
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.460,46
0.980,98
0.630,63
FD
0.300,30
0.780,78
0.440,44
GH
0.210,21
1.001,00
0.350,35
JD
0.370,37
0.920,92
0.520,52
JC
0.300,30
0.980,98
0.470,47
JP
0.390,39
0.950,95
0.550,55
LA
0.560,56
0.700,70
0.620,62
MI
0.410,41
0.950,95
0.570,57
VL
0.480,48
0.820,82
0.610,61
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.340,34
1.001,00
0.500,50
FD
0.250,25
0.880,88
0.390,39
GH
0.150,15
1.001,00
0.270,27
JD
0.270,27
0.950,95
0.420,42
JC
0.220,22
1.001,00
0.360,36
JP
0.290,29
0.980,98
0.440,44
LA
0.480,48
0.840,84
0.610,61
MI
0.310,31
1.001,00
0.470,47
VL
0.370,37
0.860,86
0.510,51
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.170,17
1.001,00
0.290,29
FD
0.140,14
1.001,00
0.250,25
GH
0.080,08
1.001,00
0.140,14
JD
0.150,15
1.001,00
0.260,26
JC
0.110,11
1.001,00
0.200,20
JP
0.150,15
1.001,00
0.260,26
LA
0.290,29
1.001,00
0.450,45
MI
0.160,16
1.001,00
0.270,27
VL
0.220,22
1.001,00
0.360,36
The 118 terms at least 5 of the 9 annotators markedLes 118 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 22 terms9 sur 9 · 22 termes
biomarker
body mass index
cardiac resynchronization therapy
cardiovascular diseases
case-control analysis
CHF
clinical practice
congestive heart failure
cTnT
diabetes mellitus
ejection fraction
heart failure
heart rate
hyperkalemia
intubations
left ventricular ejection fraction
morbidity
mortality
NRI
spironolactone
systolic heart failure
Troponin T
8 of 9 · 21 terms8 sur 9 · 21 termes
AUC
clinical trials
confidence interval
CRT
diabetes
dialysis
dialysis-dependent patients
echocardiograms
emergency department
HF
high-sensitivity assay
hospitalization
implantation
International Classification of Diseases
intubated
laboratory report
NT-proBNP
periprocedural
reverse remodeling
systolic blood pressure
β-blocker
7 of 9 · 17 terms7 sur 9 · 17 termes
acute kidney injury
all-cause hospitalization
bundle branch morphology
CIs
echocardiographic
ED
hazard ratio
heart failure patients
HF prediction model
implant
implantable cardioverter-defibrillator
N-terminal pro-B-type natriuretic peptide
randomized trials
regression analyses
sex-specific models
symptomatic systolic heart failure
treatment
6 of 9 · 36 terms6 sur 9 · 36 termes
Aldosterone receptor antagonists
angiotensin II receptor blocker
angiotensin-converting enzyme inhibitor
ARIC
ARIC HF model
atherosclerosis
Atherosclerosis Risk in Communities
baseline
cardiac troponin T
cardiomyopathy
CHF patients
clinical characteristics
clinical status
Cox regression
CRT implantation
Crude rates
device implantation
diagnosed
dialysis patients
dialysis-dependent
ED physicians
ED visits
end-of-life treatment
heart failure risk
incident HF
incident systolic heart failure
integrated discrimination improvement
Intubation rates
laboratory report model
medication
net reclassification improvement
patients
physicians
prevalent coronary heart disease
severe hyperkalemia
Student t test
5 of 9 · 22 terms5 sur 9 · 22 termes
adverse events
Aldosterone
antagonists
antihypertensive medication
atherosclerosis risk
cardiomyopathy origin
cardioverter-defibrillator
CHF treatments
class I recommendation
coronary heart disease
deactivation
deterioration
end of life
HF hospitalization
implantable
model fit
natriuretic peptide
receptor
Retrospective cohort
risk of hospitalization
serum potassium level
time-varying covariates
The 115 terms found in only one of the 9 listsLes 115 termes présents dans une seule des 9 listes
-fold
6-month echocardiograms
advances
AIM
analysis
analyze
area under the receiver operating characteristic curve (AUC
assay
assessed
assessment
associated
association
average
baseline serum creatinine
body mass
cardiac troponin
characteristic curve (AUC
coefficient
collect
communicate
compelling improvement
CONCLUSION
confidence
confidence intervals (CIs
congestive heart failure (CHF
consecutive patients
coronary
correlation
correlation coefficient R
Cox
Cox regression with time-varying covariates
creatinine level
Crude
cTnT and NT-proBNP
current/former smoking
deactivation discussions
declined
decrease
described
developed
device
dialysis-dependent patients with heart failure
dialysis-dependent patients with HF
discrimination
discrimination improvement
discussed
emergency department (ED
evaluate
excluded
failure
heart
Heart Function
HF risk
hypothesize
identified
improvements
incident
increased
increased risk of hyperkalemia
increases
increases in incidence
initiated
interval
interview data
left ventricular ejection
life
male
mean
mean follow-up
median
medication use
mellitus
men
mEq
month
n =
N-terminal pro-B-type
observed
operating characteristic curve
operating characteristic curve (AUC
participants
patient awareness
patient's
perspective
prediction model
preferences
process
qualitative
rates of annual ED visits
receptor antagonists
reclassification
reduce
regression
report model
RESULTS
resynchronization
resynchronization therapy
Retrospective
serious complications
simple sex-specific model
simpler laboratory report model
smoking
statistically
studies
theory
timing
total ED visits
trials
Troponin T and N-terminal pro-B-type natriuretic peptide
use
use of spironolactone
value
ventricular
visits
women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.450,45
0.620,62
FD
1.001,00
0.290,29
0.450,45
GH
1.001,00
0.600,60
0.750,75
JD
1.001,00
0.510,51
0.680,68
JC
1.001,00
0.560,56
0.720,72
JP
1.001,00
0.420,42
0.600,60
LA
1.001,00
0.260,26
0.410,41
MI
1.001,00
0.390,39
0.560,56
VL
1.001,00
0.290,29
0.450,45
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.630,63
0.770,77
FD
0.960,96
0.400,40
0.570,57
GH
0.880,88
0.770,77
0.820,82
JD
0.880,88
0.650,65
0.750,75
JC
0.870,87
0.700,70
0.780,78
JP
0.950,95
0.580,58
0.730,73
LA
0.840,84
0.320,32
0.460,46
MI
0.960,96
0.540,54
0.690,69
VL
0.980,98
0.410,41
0.580,58
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.940,94
0.770,77
0.850,85
FD
0.900,90
0.480,48
0.630,63
GH
0.770,77
0.850,85
0.810,81
JD
0.760,76
0.720,72
0.740,74
JC
0.790,79
0.820,82
0.810,81
JP
0.880,88
0.690,69
0.770,77
LA
0.820,82
0.400,40
0.540,54
MI
0.850,85
0.610,61
0.710,71
VL
0.950,95
0.510,51
0.660,66
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.830,83
0.860,86
0.840,84
FD
0.790,79
0.540,54
0.640,64
GH
0.660,66
0.930,93
0.770,77
JD
0.680,68
0.810,81
0.740,74
JC
0.690,69
0.900,90
0.780,78
JP
0.810,81
0.800,80
0.810,81
LA
0.780,78
0.470,47
0.590,59
MI
0.750,75
0.690,69
0.720,72
VL
0.900,90
0.610,61
0.730,73
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.730,73
0.930,93
0.820,82
FD
0.720,72
0.600,60
0.650,65
GH
0.580,58
0.990,99
0.730,73
JD
0.590,59
0.860,86
0.700,70
JC
0.590,59
0.940,94
0.720,72
JP
0.720,72
0.870,87
0.790,79
LA
0.760,76
0.560,56
0.650,65
MI
0.660,66
0.730,73
0.690,69
VL
0.860,86
0.700,70
0.770,77
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.630,63
0.950,95
0.760,76
FD
0.650,65
0.630,63
0.640,64
GH
0.490,49
0.990,99
0.650,65
JD
0.540,54
0.930,93
0.680,68
JC
0.510,51
0.960,96
0.670,67
JP
0.640,64
0.920,92
0.760,76
LA
0.670,67
0.580,58
0.620,62
MI
0.600,60
0.800,80
0.690,69
VL
0.830,83
0.810,81
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.510,51
0.970,97
0.670,67
FD
0.560,56
0.700,70
0.620,62
GH
0.380,38
0.990,99
0.550,55
JD
0.450,45
0.980,98
0.610,61
JC
0.410,41
0.970,97
0.570,57
JP
0.530,53
0.960,96
0.680,68
LA
0.610,61
0.680,68
0.640,64
MI
0.510,51
0.840,84
0.630,63
VL
0.730,73
0.910,91
0.810,81
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.370,37
0.970,97
0.530,53
FD
0.470,47
0.810,81
0.600,60
GH
0.280,28
0.990,99
0.430,43
JD
0.330,33
0.990,99
0.490,49
JC
0.300,30
1.001,00
0.460,46
JP
0.380,38
0.960,96
0.550,55
LA
0.520,52
0.800,80
0.630,63
MI
0.400,40
0.910,91
0.550,55
VL
0.560,56
0.960,96
0.700,70
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.150,15
1.001,00
0.260,26
FD
0.220,22
1.001,00
0.360,36
GH
0.110,11
1.001,00
0.200,20
JD
0.130,13
1.001,00
0.230,23
JC
0.120,12
1.001,00
0.210,21
JP
0.150,15
1.001,00
0.270,27
LA
0.250,25
1.001,00
0.400,40
MI
0.170,17
1.001,00
0.290,29
VL
0.230,23
1.001,00
0.370,37
The 146 terms at least 5 of the 9 annotators markedLes 146 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 27 terms9 sur 9 · 27 termes
arythmies ventriculaires
auto-soins
bêta-bloquants
cardiopathies congénitales
d'insuffisance rénale
DNP
endopeptidase
l'ANP
L'asynchronisme
l'enzyme de conversion
l'hypertension artérielle
l'Incidence hospitalière
l'insuffisance cardiaque
l'urodilatine
maladie chronique
marqueurs pronostiques
molécules
mortalité hospitalière
NPR-C
NT-proBNP
post chirurgie
profil épidémiologique
Resynchronisation cardiaque
système rénine-angiotensine
Système Rénine-Angiotensine-Aldostérone
vasodilatatrice
Épidémiologie
8 of 9 · 43 terms8 sur 9 · 43 termes
Antagonistes
BNP
brain natriuretic peptide
cardiomyocyte
cardiopathie
cardiopathie congénitale
circulation sanguine
CNP
concentration plasmatique
d'IC
d'insuffisance cardiaque
diurétique
dysfonction ventriculaire
dysfonction ventriculaire gauche
développement clinique
fonction ventriculaire
hypertensive
inhibiteurs
ischémique
l'angiotensine II
l'asynchronisme
l'autodétermination
l'expansion volémique
l'IC
l'incidence hospitalière
natriurétique
néphropathie diabètique
pathologies cardiaques congénitales
peptides
peptides natriurétiques
plan de traitement
pratique clinique
proBNP
pré-proBNP
resynchronisation
récepteur de clairance
rénales
symptômes
thérapeutique
ventricule droit systémique
ventricule unique
échographique
équimolaire
7 of 9 · 27 terms7 sur 9 · 27 termes
activité biologique
antagonistes
B-type natriuretic peptide
centrales
clivé
d'inhiber
diagnostic
dosage
fonction rénale
fraction d'éjection ventriculaire gauche
hospitalisations
IC
intervention infirmière de soutien
interventions
L'autodétermination
l'hospitalisation
l'Ic
L'incidence hospitalière standardisée
l'Insuffisance cardiaque
L'épidémiologie
marqueurs
mort subite
NPR-A
peptide
récepteurs AT1
syndromes coronariens aigus
traitement
6 of 9 · 26 terms6 sur 9 · 26 termes
biologiques
calcium
cardiopathies
cliniques
clivage
congénitales
d'hospitalisation
diète
GI
groupe d'intervention
intervention infirmière
L'IC
L'insuffisance cardiaque
l'insuffisance rénale chronique
l'élimination
non-peptidiques
patients
prise en charge
récepteur
stimulation cardiaque de resynchronisation
synthétisé
TAD
techniques d'immunodosage automatisées
ventriculaire
voie orale
études cliniques
5 of 9 · 23 terms5 sur 9 · 23 termes
amélioration clinique
arythmies
concentration
congénitaux
d'affiliation
d'autonomie
d'immunodosage
dysfonction ventriculaire avec bloc de branche droit
groupe anatomique
hospitalisés
l'angiotensine
L'incidence hospitalière
l'insuffisance cardiaque gauche
l'insuffisance cardiaque gauche avec bloc de branche gauche
l'intervention
multicentriques
pathologies
physiologiquement
Resynchronisation
rénale
théorie de l'autodétermination
vasculaires
étude pilote
The 127 terms found in only one of the 9 listsLes 127 termes présents dans une seule des 9 listes
adultes
amélioration clinique et échographique
analytique
Antagonistes des récepteurs AT1 de l'angiotensine II
antagonistes non-peptidiques des récepteurs de l'angiotensine
appel téléphonique
aspects
AT1
besoin d'affiliation,
biologique
bloc
blocage du système
branche gauche
bénéfices à long terme
cas
challenges
chirurgie
CNP,
Conclusion
congénitale
critique
d'inhiber le système
de façon équimolaire
diurétique et natriurétique
dysfonction
dysfonction ventriculaire avec bloc de branche
développement
développement de l'insuffisance cardiaque
Effet
effets
famille
fonction ventriculaire de l'insuffisance cardiaque
fraction d'éjection
fréquence de l'insuffisance cardiaque
fréquence de l'insuffisance cardiaque à fonction systolique préservée
groupe anatomique et fonctionnel
groupe d'intervention (GI)
groupes de patients
hospitalisations répétées
hospitalière
implications
infirmière
inhibiteurs de l'enzyme
interpréter
intervention
l'angiotensine II.
l'effet
l'expansion volémique.
l'incidence
l'incidence hospitalière de l'IC
l'installation progressive
l'installation progressive de l'insuffisance cardiaque
l'Insuffisance cardiaque (IC)
l'âge moyen
l'étude ETICS
l'étude prospective ETICS
la circulation sanguine
La concentration plasmatique
la fonction rénale
la néphropathie diabètique
la resynchronisation
La stimulation cardiaque
La stimulation cardiaque de resynchronisation
Le dosage
le système rénine-angiotensine
les antagonistes du calcium
les inhibiteurs de l'enzyme de conversion de l'angiotensine
les récepteurs AT1 de l'angiotensine II
les syndromes coronariens aigus
Les études cliniques
limitée
long terme
modèle
modèle de l'insuffisance cardiaque
modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
mono
mono- ou multicentriques
mort
natriuretic
natriuretic peptide
par liaison
parent
patients atteints d'IC
patients atteints d'IC.
patients jeunes
pistes
population de patients
post chirurgie de cardiopathie congénitale
poussée d'IC
pratique des auto-soins
première poussée
première poussée d'IC
problèmes
pronostiques
prospective
précocement
prévention de l'insuffisance rénale
prévention de l'insuffisance rénale chronique
randomisée à deux groupes
rapport homme/femme
recherches
rendu de résultat
restrictions
resynchronisation en post chirurgie de cardiopathie congénitale
récepteurs AT1 de l'angiotensine II
Rénine-Angiotensine-Aldostérone
résultat
Résultats
résultats
Résultats de l'étude ETICS
soins
Somme
soutien
standardisée
systémique
sévères
traitement de l'hypertension artérielle
voie orale,
à deux groupes
à fonction systolique
à long terme
âge
équivalentes
étude
études mono
études mono-
évaluée
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.450,45
0.620,62
FD
1.001,00
0.320,32
0.480,48
GH
1.001,00
0.600,60
0.750,75
JD
1.001,00
0.520,52
0.680,68
JC
1.001,00
0.560,56
0.720,72
JP
1.001,00
0.430,43
0.600,60
LA
1.001,00
0.260,26
0.410,41
MI
1.001,00
0.390,39
0.560,56
VL
1.001,00
0.280,28
0.440,44
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.620,62
0.760,76
FD
0.960,96
0.430,43
0.590,59
GH
0.900,90
0.770,77
0.830,83
JD
0.890,89
0.650,65
0.750,75
JC
0.870,87
0.690,69
0.770,77
JP
0.960,96
0.580,58
0.730,73
LA
0.830,83
0.300,30
0.440,44
MI
0.950,95
0.520,52
0.680,68
VL
0.980,98
0.400,40
0.560,56
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.940,94
0.760,76
0.840,84
FD
0.910,91
0.520,52
0.670,67
GH
0.780,78
0.860,86
0.810,81
JD
0.760,76
0.720,72
0.740,74
JC
0.780,78
0.800,80
0.790,79
JP
0.880,88
0.690,69
0.770,77
LA
0.820,82
0.390,39
0.530,53
MI
0.840,84
0.600,60
0.700,70
VL
0.940,94
0.490,49
0.650,65
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.820,82
0.860,86
0.840,84
FD
0.780,78
0.590,59
0.670,67
GH
0.650,65
0.930,93
0.770,77
JD
0.670,67
0.820,82
0.740,74
JC
0.670,67
0.890,89
0.760,76
JP
0.800,80
0.810,81
0.810,81
LA
0.770,77
0.470,47
0.580,58
MI
0.750,75
0.690,69
0.720,72
VL
0.890,89
0.600,60
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.720,72
0.920,92
0.810,81
FD
0.720,72
0.660,66
0.690,69
GH
0.570,57
0.990,99
0.720,72
JD
0.580,58
0.870,87
0.700,70
JC
0.570,57
0.930,93
0.710,71
JP
0.720,72
0.890,89
0.790,79
LA
0.750,75
0.560,56
0.640,64
MI
0.650,65
0.720,72
0.680,68
VL
0.850,85
0.700,70
0.770,77
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.610,61
0.940,94
0.750,75
FD
0.650,65
0.710,71
0.680,68
GH
0.480,48
1.001,00
0.650,65
JD
0.530,53
0.940,94
0.670,67
JC
0.490,49
0.950,95
0.650,65
JP
0.640,64
0.940,94
0.760,76
LA
0.660,66
0.580,58
0.620,62
MI
0.600,60
0.800,80
0.690,69
VL
0.820,82
0.810,81
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.500,50
0.970,97
0.660,66
FD
0.570,57
0.770,77
0.650,65
GH
0.380,38
1.001,00
0.560,56
JD
0.440,44
0.980,98
0.610,61
JC
0.400,40
0.970,97
0.570,57
JP
0.530,53
0.970,97
0.680,68
LA
0.620,62
0.680,68
0.650,65
MI
0.510,51
0.850,85
0.640,64
VL
0.740,74
0.910,91
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.380,38
0.970,97
0.550,55
FD
0.480,48
0.880,88
0.620,62
GH
0.290,29
1.001,00
0.450,45
JD
0.330,33
0.980,98
0.500,50
JC
0.310,31
1.001,00
0.470,47
JP
0.400,40
0.970,97
0.560,56
LA
0.540,54
0.790,79
0.640,64
MI
0.410,41
0.910,91
0.560,56
VL
0.580,58
0.950,95
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.180,18
1.001,00
0.300,30
FD
0.250,25
1.001,00
0.400,40
GH
0.130,13
1.001,00
0.230,23
JD
0.150,15
1.001,00
0.270,27
JC
0.140,14
1.001,00
0.250,25
JP
0.180,18
1.001,00
0.310,31
LA
0.310,31
1.001,00
0.470,47
MI
0.200,20
1.001,00
0.340,34
VL
0.280,28
1.001,00
0.430,43
The 131 terms at least 5 of the 9 annotators markedLes 131 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 30 terms9 sur 9 · 30 termes
ANP
arythmies ventriculaires
asynchronisme
auto-soins
bêta-bloquants
cardiopathies congénitales
CNP
DNP
endopeptidase
enzyme de conversion
expansion volémique
hypertension artérielle
Incidence hospitalière
insuffisance cardiaque
insuffisance rénale
maladie chronique
marqueurs pronostiques
molécules
mortalité hospitalière
NPR-C
NT-proBNP
post chirurgie
profil épidémiologique
resynchronisation
Resynchronisation cardiaque
système rénine-angiotensine
Système Rénine-Angiotensine-Aldostérone
urodilatine
vasodilatatrice
Épidémiologie
8 of 9 · 36 terms8 sur 9 · 36 termes
angiotensine II
antagonistes
autodétermination
BNP
brain natriuretic peptide
cardiomyocyte
cardiopathie
cardiopathie congénitale
circulation sanguine
concentration plasmatique
diurétique
dysfonction ventriculaire
dysfonction ventriculaire gauche
développement clinique
fonction ventriculaire
hypertensive
IC
inhibiteurs
ischémique
natriurétique
néphropathie diabètique
pathologies cardiaques congénitales
peptides
peptides natriurétiques
plan de traitement
pratique clinique
proBNP
pré-proBNP
récepteur de clairance
rénales
symptômes
thérapeutique
ventricule droit systémique
ventricule unique
échographique
équimolaire
7 of 9 · 22 terms7 sur 9 · 22 termes
activité biologique
B-type natriuretic peptide
centrales
clivé
diagnostic
dosage
fonction rénale
fraction d'éjection ventriculaire gauche
hospitalisation
hospitalisations
incidence hospitalière standardisée
inhiber
intervention infirmière de soutien
interventions
marqueurs
mort subite
NPR-A
peptide
récepteurs AT1
syndromes coronariens aigus
traitement
voie orale
6 of 9 · 22 terms6 sur 9 · 22 termes
biologiques
calcium
cardiopathies
cliniques
clivage
congénitales
diète
GI
groupe d'intervention
insuffisance rénale chronique
intervention infirmière
non-peptidiques
patients
prise en charge
récepteur
stimulation cardiaque de resynchronisation
synthétisé
TAD
techniques d'immunodosage automatisées
ventriculaire
élimination
études cliniques
5 of 9 · 21 terms5 sur 9 · 21 termes
affiliation
amélioration clinique
angiotensine
arythmies
autonomie
concentration
congénitaux
dysfonction ventriculaire avec bloc de branche droit
groupe anatomique
hospitalisés
immunodosage
insuffisance cardiaque gauche
insuffisance cardiaque gauche avec bloc de branche gauche
intervention
multicentriques
pathologies
physiologiquement
rénale
théorie de l'autodétermination
vasculaires
étude pilote
The 111 terms found in only one of the 9 listsLes 111 termes présents dans une seule des 9 listes
adultes
amélioration clinique et échographique
analytique
Antagonistes des récepteurs AT1 de l'angiotensine II
antagonistes non-peptidiques des récepteurs de l'angiotensine
appel téléphonique
aspects
AT1
biologique
bloc
blocage du système
branche gauche
bénéfices à long terme
cas
challenges
chirurgie
Conclusion
congénitale
critique
de façon équimolaire
diurétique et natriurétique
dysfonction
dysfonction ventriculaire avec bloc de branche
développement
développement de l'insuffisance cardiaque
Effet
effets
famille
fonction ventriculaire de l'insuffisance cardiaque
fraction d'éjection
fréquence de l'insuffisance cardiaque
fréquence de l'insuffisance cardiaque à fonction systolique préservée
groupe anatomique et fonctionnel
groupe d'intervention (GI
groupes de patients
hospitalisations répétées
hospitalière
implications
incidence
incidence hospitalière de l'IC
infirmière
inhiber le système
inhibiteurs de l'enzyme
installation progressive
installation progressive de l'insuffisance cardiaque
interpréter
la circulation sanguine
La concentration plasmatique
la fonction rénale
la néphropathie diabètique
la resynchronisation
La stimulation cardiaque
La stimulation cardiaque de resynchronisation
Le dosage
le système rénine-angiotensine
les antagonistes du calcium
les inhibiteurs de l'enzyme de conversion de l'angiotensine
les récepteurs AT1 de l'angiotensine II
les syndromes coronariens aigus
Les études cliniques
limitée
long terme
modèle
modèle de l'insuffisance cardiaque
modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
mono
mono- ou multicentriques
mort
natriuretic
natriuretic peptide
par liaison
parent
patients jeunes
pistes
population de patients
post chirurgie de cardiopathie congénitale
poussée d'IC
pratique des auto-soins
première poussée
première poussée d'IC
problèmes
pronostiques
prospective
précocement
prévention de l'insuffisance rénale
prévention de l'insuffisance rénale chronique
randomisée à deux groupes
rapport homme/femme
recherches
rendu de résultat
restrictions
resynchronisation en post chirurgie de cardiopathie congénitale
récepteurs AT1 de l'angiotensine II
Rénine-Angiotensine-Aldostérone
résultat
Résultats de l'étude ETICS
soins
Somme
soutien
standardisée
systémique
sévères
traitement de l'hypertension artérielle
à deux groupes
à fonction systolique
à long terme
âge moyen
équivalentes
étude ETICS
étude prospective ETICS
évaluée
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.460,46
0.630,63
FD
1.001,00
0.330,33
0.500,50
GH
1.001,00
0.600,60
0.750,75
JD
1.001,00
0.520,52
0.690,69
JC
1.001,00
0.570,57
0.720,72
JP
1.001,00
0.430,43
0.600,60
LA
1.001,00
0.260,26
0.420,42
MI
1.001,00
0.380,38
0.550,55
VL
1.001,00
0.300,30
0.460,46
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.970,97
0.630,63
0.770,77
FD
0.960,96
0.450,45
0.610,61
GH
0.910,91
0.780,78
0.840,84
JD
0.890,89
0.660,66
0.760,76
JC
0.860,86
0.700,70
0.770,77
JP
0.960,96
0.580,58
0.720,72
LA
0.830,83
0.310,31
0.450,45
MI
0.960,96
0.520,52
0.670,67
VL
0.980,98
0.410,41
0.580,58
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.930,93
0.760,76
0.840,84
FD
0.920,92
0.550,55
0.690,69
GH
0.790,79
0.860,86
0.820,82
JD
0.770,77
0.720,72
0.740,74
JC
0.780,78
0.790,79
0.790,79
JP
0.900,90
0.680,68
0.780,78
LA
0.820,82
0.390,39
0.530,53
MI
0.870,87
0.590,59
0.700,70
VL
0.940,94
0.500,50
0.660,66
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.810,81
0.860,86
0.830,83
FD
0.810,81
0.620,62
0.700,70
GH
0.670,67
0.940,94
0.780,78
JD
0.670,67
0.820,82
0.740,74
JC
0.670,67
0.890,89
0.760,76
JP
0.810,81
0.800,80
0.810,81
LA
0.770,77
0.470,47
0.580,58
MI
0.770,77
0.680,68
0.720,72
VL
0.890,89
0.610,61
0.730,73
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.710,71
0.930,93
0.810,81
FD
0.730,73
0.690,69
0.710,71
GH
0.580,58
1.001,00
0.730,73
JD
0.590,59
0.870,87
0.700,70
JC
0.570,57
0.930,93
0.710,71
JP
0.720,72
0.880,88
0.790,79
LA
0.740,74
0.560,56
0.640,64
MI
0.670,67
0.730,73
0.700,70
VL
0.850,85
0.720,72
0.780,78
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.620,62
0.950,95
0.750,75
FD
0.660,66
0.740,74
0.700,70
GH
0.490,49
1.001,00
0.660,66
JD
0.540,54
0.940,94
0.690,69
JC
0.500,50
0.950,95
0.650,65
JP
0.650,65
0.930,93
0.770,77
LA
0.660,66
0.580,58
0.620,62
MI
0.620,62
0.790,79
0.700,70
VL
0.820,82
0.820,82
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.510,51
0.960,96
0.670,67
FD
0.590,59
0.810,81
0.690,69
GH
0.400,40
1.001,00
0.570,57
JD
0.450,45
0.980,98
0.620,62
JC
0.400,40
0.950,95
0.570,57
JP
0.550,55
0.960,96
0.700,70
LA
0.620,62
0.670,67
0.640,64
MI
0.540,54
0.850,85
0.660,66
VL
0.740,74
0.920,92
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.390,39
0.970,97
0.550,55
FD
0.500,50
0.910,91
0.650,65
GH
0.300,30
1.001,00
0.460,46
JD
0.340,34
0.980,98
0.510,51
JC
0.320,32
1.001,00
0.480,48
JP
0.410,41
0.970,97
0.580,58
LA
0.540,54
0.790,79
0.640,64
MI
0.440,44
0.910,91
0.590,59
VL
0.580,58
0.950,95
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.190,19
1.001,00
0.320,32
FD
0.260,26
1.001,00
0.420,42
GH
0.140,14
1.001,00
0.250,25
JD
0.170,17
1.001,00
0.290,29
JC
0.150,15
1.001,00
0.270,27
JP
0.200,20
1.001,00
0.340,34
LA
0.330,33
1.001,00
0.500,50
MI
0.230,23
1.001,00
0.370,37
VL
0.290,29
1.001,00
0.450,45
The 125 terms at least 5 of the 9 annotators markedLes 125 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 31 terms9 sur 9 · 31 termes
ANP
arythmies ventriculaires
asynchronisme
auto-soins
bêta-bloquants
cardiopathie
cardiopathies congénitales
CNP
DNP
endopeptidase
enzyme de conversion
expansion volémique
hypertension artérielle
Incidence hospitalière
insuffisance cardiaque
insuffisance rénale
maladie chronique
marqueurs pronostiques
molécules
mortalité hospitalière
NPR-C
NT-proBNP
post chirurgie
profil épidémiologique
resynchronisation
Resynchronisation cardiaque
système rénine-angiotensine
Système Rénine-Angiotensine-Aldostérone
urodilatine
vasodilatatrice
Épidémiologie
8 of 9 · 34 terms8 sur 9 · 34 termes
angiotensine II
antagonistes
autodétermination
BNP
brain natriuretic peptide
cardiomyocyte
circulation sanguine
concentration plasmatique
diurétique
dysfonction ventriculaire
dysfonction ventriculaire gauche
développement clinique
fonction ventriculaire
hypertensive
IC
inhibiteurs
ischémique
natriurétique
néphropathie diabètique
pathologies cardiaques congénitales
peptides
peptides natriurétiques
plan de traitement
pratique clinique
proBNP
pré-proBNP
récepteur de clairance
rénales
symptômes
thérapeutique
ventricule droit systémique
ventricule unique
échographique
équimolaire
7 of 9 · 21 terms7 sur 9 · 21 termes
activité biologique
B-type natriuretic peptide
centrales
clivé
diagnostic
dosage
fonction rénale
fraction d'éjection ventriculaire gauche
hospitalisation
incidence hospitalière standardisée
inhiber
intervention
intervention infirmière de soutien
marqueurs
mort subite
NPR-A
récepteur
récepteurs AT1
syndromes coronariens aigus
traitement
voie orale
6 of 9 · 20 terms6 sur 9 · 20 termes
biologiques
calcium
cliniques
clivage
congénitales
diète
GI
groupe d'intervention
insuffisance rénale chronique
intervention infirmière
non-peptidiques
patients
prise en charge
stimulation cardiaque de resynchronisation
synthétisé
TAD
techniques d'immunodosage automatisées
ventriculaire
élimination
études cliniques
5 of 9 · 19 terms5 sur 9 · 19 termes
affiliation
amélioration clinique
angiotensine
arythmies
autonomie
concentration
congénitaux
dysfonction ventriculaire avec bloc de branche droit
groupe anatomique
hospitalisés
immunodosage
insuffisance cardiaque gauche
insuffisance cardiaque gauche avec bloc de branche gauche
multicentriques
pathologies
physiologiquement
théorie de l'autodétermination
vasculaires
étude pilote
The 106 terms found in only one of the 9 listsLes 106 termes présents dans une seule des 9 listes
amélioration clinique et échographique
analytique
Antagonistes des récepteurs AT1 de l'angiotensine II
antagonistes non-peptidiques des récepteurs de l'angiotensine
appel téléphonique
aspects
AT1
bloc
blocage du système
branche gauche
bénéfices à long terme
cas
challenges
chirurgie
Conclusion
critique
de façon équimolaire
diurétique et natriurétique
dysfonction
dysfonction ventriculaire avec bloc de branche
développement
développement de l'insuffisance cardiaque
effets
famille
fonction ventriculaire de l'insuffisance cardiaque
fraction d'éjection
fréquence de l'insuffisance cardiaque
fréquence de l'insuffisance cardiaque à fonction systolique préservée
groupe anatomique et fonctionnel
groupe d'intervention (GI
groupes de patients
hospitalisations répétées
hospitalière
implications
incidence
incidence hospitalière de l'IC
infirmière
inhiber le système
inhibiteurs de l'enzyme
installation progressive
installation progressive de l'insuffisance cardiaque
interpréter
la circulation sanguine
La concentration plasmatique
la fonction rénale
la néphropathie diabètique
la resynchronisation
La stimulation cardiaque
La stimulation cardiaque de resynchronisation
Le dosage
le système rénine-angiotensine
les antagonistes du calcium
les inhibiteurs de l'enzyme de conversion de l'angiotensine
les récepteurs AT1 de l'angiotensine II
les syndromes coronariens aigus
Les études cliniques
limitée
long terme
modèle
modèle de l'insuffisance cardiaque
modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
mono
mono- ou multicentriques
mort
natriuretic
natriuretic peptide
par liaison
parent
patients jeunes
pistes
population de patients
post chirurgie de cardiopathie congénitale
poussée d'IC
pratique des auto-soins
première poussée
première poussée d'IC
problèmes
pronostiques
prospective
précocement
prévention de l'insuffisance rénale
prévention de l'insuffisance rénale chronique
randomisée à deux groupes
rapport homme/femme
recherches
rendu de résultat
restrictions
resynchronisation en post chirurgie de cardiopathie congénitale
récepteurs AT1 de l'angiotensine II
Rénine-Angiotensine-Aldostérone
Résultats de l'étude ETICS
soins
Somme
soutien
standardisée
systémique
sévères
traitement de l'hypertension artérielle
à deux groupes
à fonction systolique
à long terme
âge moyen
équivalentes
étude ETICS
étude prospective ETICS
évaluée
Scores computed on 5 October 2026 from the INCEpTION export; initials instead of names.Scores calculés le 5 octobre 2026 à partir de l'export INCEpTION ; des initiales plutôt que des noms.
Lire les graphiques
Le seuil se change dans le menu : plus il est bas, plus la référence est
longue.
Les barres comptent les termes selon le nombre de personnes qui les ont
marqués. Une longue barre à gauche : beaucoup de termes présents dans une
seule liste.
Les termes listés sont ceux qu’au moins cinq personnes ont marqués,
puis, à part, ceux qui ne figurent que dans une des neuf listes.
This page is only available in French.
🔒 Projet 1 · Step by stepProjet 1 · Pas à pasis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Projet 1 · Step by stepProjet 1 · Pas à pas
Project 1 · Step by stepProjet 1 · Pas à pas
Le projet en sept étapes
Le Projet 1 se fait en sept étapes, dans cet ordre. La première est terminée.
Étape
Qui
Pour quand
1. Annoter les dix textes
individuel
4 octobre 2026 (fait)
2. Lire les scores d’accord
individuel, puis en équipe
dès maintenant, pour la séance 6
3. Tirer une liste de TermoStat
en équipe
séance 6, 15 octobre 2026
4. Tirer une liste de l’agent conversationnel
en équipe
séance 6, 15 octobre 2026
5. Calculer les scores des deux systèmes
individuel et en équipe
séance 6, 15 octobre 2026
6. Envoyer les quatre listes et présenter
en équipe
séance 6, 15 octobre 2026
7. Rédiger les deux rapports
individuel et en équipe
25 octobre 2026, 23 h 59
Les sept étapes du Projet 1.
Le Projet 1 vaut 20 % de la note du cours, sur 100 points : 10 pour
l’annotation terminée et les deux questionnaires, 15 pour la présentation, 30
pour le rapport d’équipe et 45 pour le rapport individuel.
Où trouver chaque résultat
Tout est sur le site, sauf les dix textes en .txt, sur StudiUM. Aucun
fichier de scores ne vous est envoyé : chaque score se consulte ou se calcule
sur l’une des quatre pages ci-dessous, en choisissant la langue et la règle de
correspondance en haut de la page.
Ce que vous cherchez
Où
Ce que vous y choisissez
les dix textes, pour TermoStat, pour l’agent et pour retrouver vos segments
StudiUM, en .txt
en_01 à en_05, fr_01 à fr_05
votre F1 moyen avec les huit autres, et votre accord le plus haut et le plus bas
votre ligne : la colonne « Moyenne » et les autres cases. Le même F1 moyen se recopie sur les deux lignes de sa langue dans le tableau 3.1 du rapport individuel : il ne dépend pas du système
le F1 entre deux personnes, dont les membres de votre équipe
Où se trouve chaque élément du Projet 1, et ce que vous choisissez sur la page.
Quelle règle de correspondance utiliser
Par défaut, la règle 3, dans les deux rapports : les écarts qui restent
portent sur ce qui compte comme terme, le sujet du projet. Les trois règles
seulement aux deux questions qui les demandent : 3.2 du rapport individuel et
3.1 du rapport d’équipe.
la casse, les espaces et traits d’union, le type d’apostrophe, l’article élidé
« ProBNP » et « probnp », « l’insuffisance cardiaque » et « insuffisance cardiaque »
3 · singulier et pluriel confondus
la règle 2, plus le -s ou le -x final du pluriel
« facteur de risque » et « facteurs de risque », mais pas « principal » et « principaux »
Les trois règles de correspondance, de la plus stricte à la plus souple.
Rien d’autre n’est mis en commun : « congénital » et « congénitale », ou un
terme et sa reformulation, restent deux formes sous les trois règles.
Où l'écart entre les règles compte
Les exemples se prennent dans les listes de la règle 3. Sous la règle 1,
un candidat juste mais écrit autrement que dans la référence (« disease »
pour « diseases ») peut compter à la fois comme bruit et comme silence : vous
commenteriez une différence d’écriture au lieu d’un désaccord sur ce qu’est
un terme.
L’écart entre les règles est une information en soi. Un score qui monte
beaucoup de la règle 1 à la règle 3 veut dire qu’une partie des erreurs ne
portait que sur la forme ; un score qui ne bouge presque pas veut dire que
les écarts portent sur le choix des termes.
En comparant l’anglais et le français (question 4.2 du rapport
d’équipe), regardez aussi si l’écart entre les règles diffère d’une langue à
l’autre.
Les chiffres dans les rapports : la tendance avant le détail
Les tableaux donnent les chiffres ; votre texte dit ce qu’ils montrent
ensemble : quel système fait mieux, en anglais ou en français, plutôt en
précision ou en rappel, et où il se situe par rapport à l’accord entre vous.
La moyenne avant les cas particuliers : votre F1 moyen avec les huit
autres dit plus que chacune des huit cases ; votre accord le plus haut et le
plus bas servent de repères.
Quelques centièmes d’écart ne sont pas un résultat : avec une liste
majoritaire d’environ 120 termes, un terme de plus ou de moins déplace le
rappel de près d’un centième. Commentez un chiffre isolé seulement quand il
rompt la tendance, et dites alors pourquoi.
Les exemples font le reste : un écart qui compte s’explique avec deux ou
trois termes tirés de vos listes, pas avec d’autres chiffres.
Vous situez votre annotation par rapport à celles des huit autres personnes,
individuellement d’abord, puis en équipe. Règle 3, en anglais et en français.
Sur Comparer deux listes, terme par terme,
votre liste contre la liste majoritaire : deux termes de la majorité que vous
n’avez pas retenus, et deux de vos termes que la majorité n’a pas gardés.
Cette matière fait la section 2 du rapport individuel.
Cette matière fait la section 2 du rapport d’équipe.
3. Tirer une liste de TermoStat
En équipe, une liste par langue : les cinq fichiers .txt d’une langue, pris
sur StudiUM, en un seul passage (TermoStat accepte plusieurs fichiers). Le seuil se choisit avant
de calculer le moindre score.
Comment faire
Choisissez les catégories grammaticales à garder, et notez pourquoi.
Lancez l’extraction et téléchargez le résultat en TSV, pas en TBX : le
TSV garde la spécificité de chaque candidat.
Choisissez le seuil. Par défaut, TermoStat trie les candidats selon leur
score de spécificité, la colonne « Spec », du plus spécifique au moins
spécifique. Le seuil est une valeur de cette colonne : vous gardez les
candidats dont le score l’atteint ou la dépasse, c’est-à-dire le haut de la
liste, et vous écartez les autres. Vous pouvez aussi garder la liste
entière, sans seuil. Notez votre choix et sa raison en deux ou trois
phrases.
Sur la page de calcul, entrez cette valeur dans le champ « Seuil » : la page
applique le seuil elle-même au fichier TSV complet.
Les scores à rapporter sont ceux de la liste au seuil choisi. Essayer d’autres
seuils après coup, pour voir ce qu’ils changent, est permis. Vos réglages et
leur raison font la section 1.1 du rapport d’équipe.
4. Tirer une liste de l’agent conversationnel
En équipe, avec l’agent de votre équipe : une conversation et une liste par
langue, sur les cinq fichiers .txt de cette langue. Le but : une liste aussi proche
que possible de ce que vous ajouteriez à votre propre base terminologique.
rapport d’équipe, sections 3 et 4 ; rapport individuel, 3.1
Les deux calculs à faire, selon la référence choisie dans la page.
Dans les listes de bruit et de silence de la règle 3, relevez tout de suite des
exemples : pour chaque système, deux candidats erronés et deux termes manqués,
d’un même type, que le fonctionnement du système explique (section 4.1 du
rapport d’équipe).
6. Envoyer les listes et présenter, à la séance 6
Le 15 octobre 2026, une présentation de 15 à 20 minutes en classe. Les
diapositives ne sont pas obligatoires, mais un support visuel aide à montrer
des exemples et des scores ; le tableau de la classe peut aussi servir.
Une seule personne peut faire l’essentiel de la présentation : vous n’avez
pas à vous relayer. Chaque membre de l’équipe doit toutefois pouvoir répondre
aux questions et prendre part à la discussion, qui compte pour 4 des 15
points. Je vous suggère aussi que chacun présente brièvement ses propres choix
d’annotation, puisque c’est là que vos trois annotations divergent.
Les quatre listes de l’équipe, et vos diapositives si vous en avez, s’envoient
dans un même courriel au plus tard le 15 octobre 2026 à 23 h 59, avant ou après
la présentation.
Les quatre fichiers à envoyer
Par courriel, à ayla.rigouts.terryn@umontreal.ca,
au plus tard le 15 octobre 2026 à 23 h 59, avec le seuil de TermoStat retenu pour
chaque langue dans le corps du message :
TermoStat_[Agent]_EN.tsv et TermoStat_[Agent]_FR.tsv, tels que
téléchargés ;
Agent_[Agent]_EN.txt et Agent_[Agent]_FR.txt, un candidat par ligne.
[Agent] est le nom de l’agent de votre équipe, par exemple
TermoStat_Claude_EN.tsv. Je les ajoute au site pour que les trois équipes
comparent leurs résultats ; cette comparaison fait la section 5 du rapport
d’équipe. Les conversations avec l’agent ne sont pas partagées : à la présentation,
vous montrez ce que vous avez essayé et votre requête finale, avec des
exemples, mais la conversation entière reste à l’équipe et n’est remise qu’à
moi, avec le rapport.
Ce qui est noté dans la présentation
La présentation sert à partager votre expérience avec les autres équipes et à
en discuter avant d’écrire les rapports. Ce qui compte, ce sont des exemples
concrets et ce que vous avez vécu, pas une analyse terminée : l’analyse est
notée dans les rapports. De 15 à 20 minutes par équipe, discussion comprise.
Critère
Points
Ce qui vaut tous les points
Vos annotations
4
comment vous avez décidé, où vos trois annotations divergent, avec des exemples
Votre agent conversationnel
4
votre expérience avec lui : ce que vous avez essayé, ce qui a marché ou non, des exemples de ses réponses, et ce qu’il fait autrement que TermoStat
TermoStat, brièvement
1
vos réglages et vos scores, pour que les équipes puissent se comparer. Un seul point, parce que TermoStat est le même outil pour toutes les équipes : seuls ses réglages peuvent un peu différer
La discussion
4
des réponses claires aux questions, et de l’intérêt pour les résultats des autres équipes
Clarté et présentation
2
on comprend ce que vous avez fait, la présentation est structurée et tient dans le temps prévu
Les critères de la présentation, sur 15 points.
7. Rédiger les deux rapports
Pour le 25 octobre 2026, 23 h 59, en PDF, sur les gabarits, à déposer sur
StudiUM dans deux remises, « Projet 1 · Rapport individuel » et « Projet 1 ·
Rapport d’équipe ». Chaque membre de l’équipe dépose le même rapport d’équipe :
chacun a ainsi une remise officielle, et la note et les commentaires du rapport
d’équipe, les mêmes pour tous, vous sont transmis sur StudiUM. Chaque question
donne ses points, et chaque gabarit commence par un tableau qui dit sur quelle
page trouver chaque chiffre demandé.
Les sections des deux rapports et l'étape d'où vient leur matière.
Les agents conversationnels dans les rapports
Les agents conversationnels sont permis pour les rapports et la présentation,
comme toute autre ressource.
Ce qui est noté, c’est ce que vous avez compris et ce que vous pensez :
vos décisions, vos exemples, vos chiffres, votre position sur les cas où les
autres personnes ou les outils ne sont pas d’accord avec vous. Un agent
conversationnel n’a rien de tout cela ; un agent qui vous aide à structurer,
à reformuler ou à vérifier un calcul ne vous coûte rien.
Déclarez-le : à la fin de chaque rapport, en une ligne, quel agent vous
avez utilisé et pour quoi. Aucun usage n’a à être justifié ; un usage non
déclaré, lui, relève du règlement sur l’intégrité.
This page is only available in French.
🔒 Projet 1 · The two systems' scoresProjet 1 · Les scores des deux systèmesis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Projet 1 · The two systems' scoresProjet 1 · Les scores des deux systèmes
Scoring TermoStat and the chatbotCalculer les scores de TermoStat et de l'agent
Ce qu’il vous faut
Pour chaque langue, les deux listes de l’équipe, une par système :
le fichier TSV de TermoStat, tel que téléchargé. Exportez le TSV plutôt
que le TBX : le TSV garde la spécificité de chaque candidat, ce qui permet
d’appliquer votre seuil ici, alors que le TBX ne garde que les formes ;
Correct candidates and terms found can differ for TermoStat: one of its lines can match several forms of the reference.Pour TermoStat, les candidats corrects et les termes trouvés peuvent différer : une même ligne peut correspondre à plusieurs formes de la référence.