Who decides what is rightQui décide de ce qui est juste
TRA6008 S3 · in classS3 · en classe
A target set by few people
Correcting a model for bias requires a target: a decision about which answers are biased and which are acceptable (see also the Correcting bias page) (voir aussi la page Corriger les biais). That decision has no neutral version, and the people who make it are few (Figure 15figure 15).
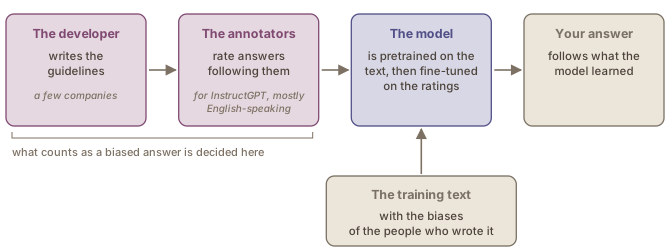
- The developer writes the guidelines a model is trained to follow, and some developers publish them (see also the Model specifications: deciding how a chatbot behaves page, in the LLM lifecycle module) (voir aussi la page Les spécifications de modèle : décider du comportement d'un agent conversationnel, dans le module Cycle de vie des GML).
- The annotators who compare and rate answers during fine-tuning fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. apply those guidelines with their own judgement. Ouyang et al. (2022) state that their method aligns a model “to the stated preferences of a specific group of people (mostly our labelers and researchers), rather than any broader notion of ‘human values’”, and that their annotators were “primarily English-speaking”.
A target set this way reflects the decisions of the people who set it. Those decisions need not match the values of the culture they come from, let alone anyone else’s.
The decisions show in the models. Santurkar et al. (2023) compared the opinions of language models language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. with those of 60 demographic groups in American opinion polls. OpenAI’s models tuned on human feedback came closest to people who are “liberal, high income, well-educated”, which, the authors note, lines up with the demographics of the people who gave that feedback.text-davinci-002 and text-davinci-003, models of 2022, compared on survey questions about the United States.
A similar pattern shows across countries: the answers of OpenAI’s models resemble the cultural values of English-speaking and Protestant European countries (Tao et al., 2024) (see also the Cultural defaults page) (voir aussi la page Les choix culturels par défaut).
What you can do
The most visible forms of bias have become harder to find: current chat models pass explicit bias tests. The bias that remains lies in their defaults, and defaults can be steered and checked:
- State the audience and the culture you are writing for. It moves the answers closer to that culture in most cases, though not all (see also the Steering toward a culture page) (voir aussi la page Orienter les réponses vers une culture).
- Compare answers across groups. Asking the same question about two groups, or with two names, shows differences that one answer on its own hides.
- Keep your own judgement for decisions about people. Scoring résumés and choosing between candidates are tasks on which studies in this chapter found bias.
Une cible fixée par peu de personnes
Corriger les biais d’un modèle suppose une cible : une décision sur les réponses qui sont biaisées et celles qui sont acceptables (see also the Correcting bias page) (voir aussi la page Corriger les biais). Cette décision n’a pas de version neutre, et les personnes qui la prennent sont peu nombreuses (Figure 15figure 15).
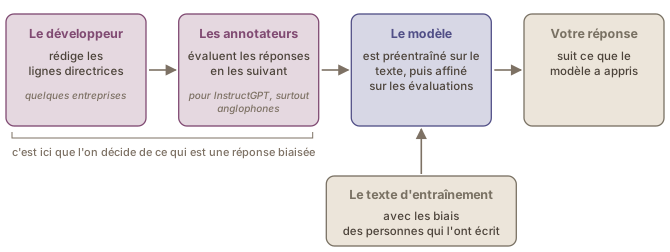
- Le développeur rédige les lignes directrices qu’un modèle est entraîné à suivre, et certains développeurs les publient (see also the Model specifications: deciding how a chatbot behaves page, in the LLM lifecycle module) (voir aussi la page Les spécifications de modèle : décider du comportement d'un agent conversationnel, dans le module Cycle de vie des GML).
- Les annotateurs qui comparent et évaluent les réponses pendant l’affinage fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. appliquent ces lignes directrices avec leur propre jugement. Ouyang et al. (2022) écrivent que leur méthode aligne un modèle « to the stated preferences of a specific group of people (mostly our labelers and researchers), rather than any broader notion of ‘human values’ » [ma traduction : « sur les préférences déclarées d’un groupe particulier de personnes (surtout nos annotateurs et nos chercheurs), plutôt que sur une notion plus large de “valeurs humaines” »], et que leurs annotateurs étaient « primarily English-speaking » [ma traduction : « principalement anglophones »].
Une cible fixée de cette façon reflète les décisions des personnes qui la fixent. Ces décisions ne correspondent pas forcément aux valeurs de la culture dont elles viennent, encore moins à celles des autres.
Les décisions se voient dans les modèles. Santurkar et al. (2023) ont comparé les opinions de modèles de langue language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. à celles de 60 groupes démographiques dans des sondages d’opinion américains. Les modèles d’OpenAI affinés sur des rétroactions humaines se rapprochaient le plus des personnes « liberal, high income, well-educated » [ma traduction : « libérales, à revenu élevé, très instruites »], ce qui, notent les auteurs, correspond au profil démographique des personnes qui avaient fourni ces rétroactions.text-davinci-002 et text-davinci-003, des modèles de 2022, comparés sur des questions d’enquête portant sur les États-Unis.
On observe une tendance semblable d’un pays à l’autre : les réponses des modèles d’OpenAI ressemblent aux valeurs culturelles des pays anglophones et des pays protestants d’Europe (Tao et al., 2024) (see also the Cultural defaults page) (voir aussi la page Les choix culturels par défaut).
Ce que vous pouvez faire
Les formes les plus visibles de biais sont devenues plus difficiles à trouver : les agents conversationnels actuels réussissent les tests de biais explicites. Ce qui reste se trouve dans leurs choix par défaut, et ces choix peuvent être orientés et vérifiés :
- Précisez le public et la culture pour lesquels vous écrivez. Cela rapproche les réponses de cette culture dans la plupart des cas, mais pas dans tous (see also the Steering toward a culture page) (voir aussi la page Orienter les réponses vers une culture).
- Comparez les réponses d’un groupe à l’autre. Poser la même question à propos de deux groupes, ou avec deux prénoms, révèle des différences qu’une réponse isolée masque.
- Gardez votre propre jugement pour les décisions qui concernent des personnes. Noter des CV et choisir entre des candidats font partie des tâches sur lesquelles des études de ce chapitre ont trouvé des biais.
Sources
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html
- Santurkar, S., Durmus, E., Ladhak, F., Lee, C., Liang, P., & Hashimoto, T. (2023). Whose Opinions Do Language Models Reflect?. Proceedings of the 40th International Conference on Machine Learning, PMLR 202, 29971–30004. https://proceedings.mlr.press/v202/santurkar23a.html
- Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346