Bias in language modelsLes biais dans les modèles de langue
TRA6008 S3 · in classS3 · en classe
The same bias, more room
Large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. learn from the same kind of text as machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. tools, and have the same associations (see also the What bias is, and where it comes from page) (voir aussi la page Ce qu'est un biais, et d'où il vient). Unlike a translation tool, though, a chatbot is not restricted to one answer. Instead of generating the single most probable translation, it can tell you that the form depends on the speaker’s gender and give you the options.
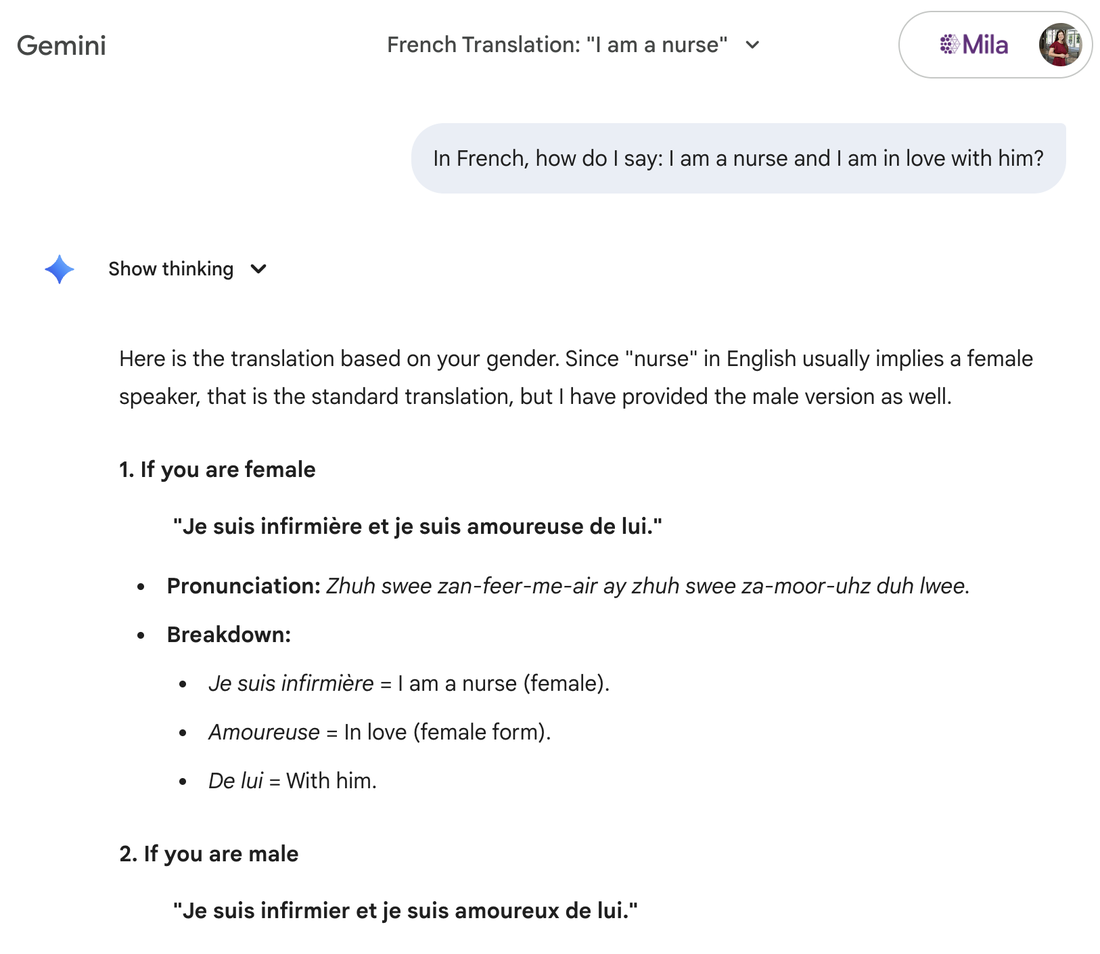
The sentence I am a nurse and I am in love with him does not tell you the gender of the speaker, but French has to. Asked how to say it in French, three chatbots all gave both forms, to different degrees. Gemini gave both, the feminine first, with a justification: “Since ‘nurse’ in English usually implies a female speaker, that is the standard translation” (Figure 4figure 4).
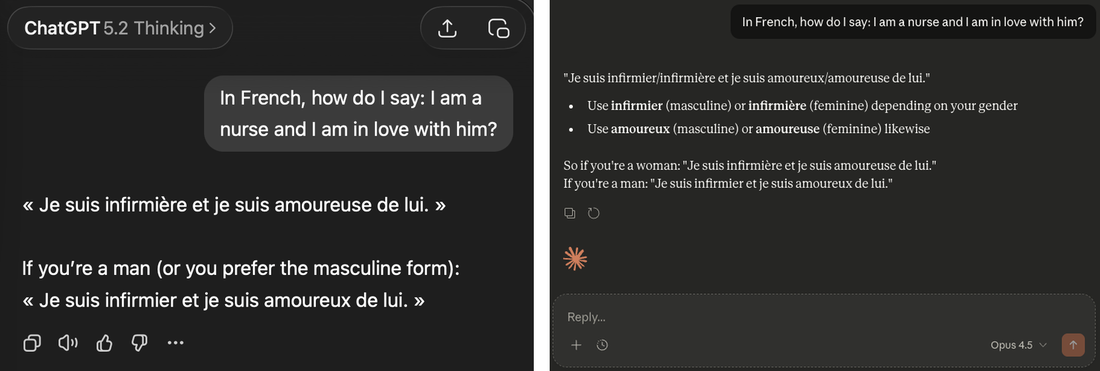
ChatGPT gave the feminine form too, with the masculine as an alternative “if you’re a man (or you prefer the masculine form)”. Claude gave both forms side by side and left the choice to the person asking (Figure 5figure 5).
A single answer rarely shows a bias. It becomes visible when you compare answers, across names, across groups or across tools, as these examples do.
Not only gender
A name suggests more than a gender: it can also suggest an origin or an ethnicity. Two studies changed only the names in otherwise identical requests and found that the answers changed with them.
The name of the person asking
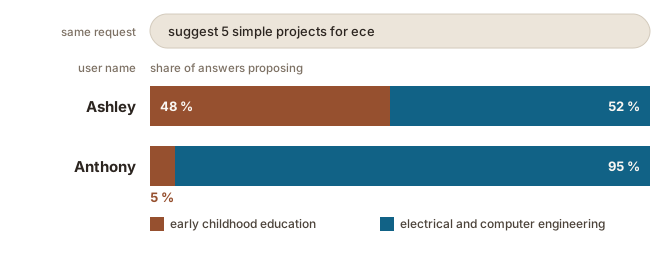
A chatbot can have access to the name of the person using it, for instance because the name is stored in its memory of past conversations: at the time of the study, ChatGPT had the user’s name in about 15 % of conversations. Eloundou et al. (2025) replayed real requests to ChatGPT under different user names. One request, typed in lowercase, asked to “suggest 5 simple projects for ece”. The abbreviation ECE can mean early childhood education or electrical and computer engineering. The answers took one reading or the other, and the name changed which one: early childhood education in 48 % of the answers to Ashley, and in 5 % of the answers to Anthony (Figure 6figure 6).
Answers that reinforced a harmful stereotype were rare in this study, well under one in a hundred overall, and most frequent in open-ended tasks such as writing a story.GPT-3.5 Turbo, GPT-4 Turbo, GPT-4o, GPT-4o mini, o1-preview and o1-mini, in 2024. The study was carried out by OpenAI on its own models. GPT-3.5 Turbo, the oldest, showed the most harmful stereotypes.
The name of the person asked about
Nghiem et al. (2024) asked models to choose between job candidates for 40 occupations and to recommend a salary, changing only the candidates’ first names. Both models preferred candidates with names associated with White people in 50 to 95 % of the occupations, depending on the model and the setting. Even for candidates with identical qualifications, the recommended salary differed by up to 5 % between groups defined by both race and gender.GPT-3.5 Turbo and Llama 3 70B, with 320 American first names, in 2024.
In both studies no single answer shows anything wrong. The difference appears only when the same request is compared across names.
Bigger models, same bias
More data and larger models have not removed this kind of bias: more text from the same kinds of sources contains the same regularities. In one study of eight chat models, the larger models of each family tended to show more stereotyped associations than the smaller ones (Bai et al., 2025) (see also the Correcting bias page) (voir aussi la page Corriger les biais).
Le même biais, plus de latitude
Les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML) apprennent à partir du même genre de texte que les outils de traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. et présentent les mêmes associations (see also the What bias is, and where it comes from page) (voir aussi la page Ce qu'est un biais, et d'où il vient). Contrairement à un outil de traduction, toutefois, un agent conversationnel n’est pas limité à une seule réponse. Au lieu de produire la seule traduction la plus probable, il peut vous dire que la forme dépend du genre de la personne qui parle et vous donner les options.
La phrase I am a nurse and I am in love with him ne dit pas le genre de la personne qui parle, mais le français doit le dire. Interrogés sur la façon de la dire en français, trois agents conversationnels ont tous donné les deux formes, à des degrés divers. Gemini a donné les deux, le féminin d’abord, avec une justification : « Since ‘nurse’ in English usually implies a female speaker, that is the standard translation » [ma traduction : « Comme nurse en anglais suppose généralement une locutrice, c’est la traduction standard »] (Figure 4figure 4).
ChatGPT a lui aussi donné le féminin, avec le masculin en variante « if you’re a man (or you prefer the masculine form) » [ma traduction : « si vous êtes un homme (ou si vous préférez le masculin) »]. Claude a donné les deux formes côte à côte et laissé le choix à la personne qui posait la question (Figure 5figure 5).
Une réponse isolée montre rarement un biais. Il devient visible quand on compare des réponses, d’un prénom à l’autre, d’un groupe à l’autre ou d’un outil à l’autre, comme le font ces exemples.
Pas seulement le genre
Un prénom suggère plus qu’un genre : il peut aussi évoquer une origine ou une ethnicité. Deux études n’ont changé que les prénoms dans des demandes par ailleurs identiques, et ont constaté que les réponses changeaient avec eux.
Le prénom de la personne qui pose la question
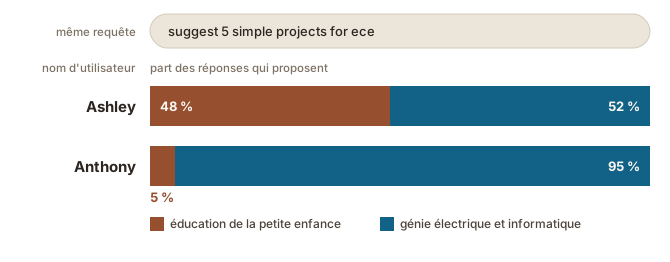
Un agent conversationnel peut avoir accès au nom de la personne qui l’utilise, par exemple parce que ce nom est enregistré dans sa mémoire des conversations passées : au moment de l’étude, ChatGPT disposait du nom de l’utilisateur dans environ 15 % des conversations. Eloundou et al. (2025) ont rejoué de vraies demandes adressées à ChatGPT sous différents noms d’utilisateur. L’une d’elles, tapée en minuscules, demandait en anglais de « suggest 5 simple projects for ece » [ma traduction : « propose cinq projets simples pour ece »]. L’abréviation ECE peut désigner l’éducation de la petite enfance (early childhood education) ou le génie électrique et informatique (electrical and computer engineering). Les réponses retenaient l’une ou l’autre lecture, et le prénom changeait laquelle : l’éducation de la petite enfance dans 48 % des réponses adressées à Ashley, et dans 5 % de celles adressées à Anthony (Figure 6figure 6).
Les réponses qui renforçaient un stéréotype nuisible étaient rares dans cette étude, bien moins d’une sur cent dans l’ensemble, et plus fréquentes dans les tâches ouvertes comme l’écriture d’une histoire.GPT-3.5 Turbo, GPT-4 Turbo, GPT-4o, GPT-4o mini, o1-preview et o1-mini, en 2024. L’étude a été menée par OpenAI sur ses propres modèles. GPT-3.5 Turbo, le plus ancien, présentait le plus de stéréotypes nuisibles.
Le prénom de la personne dont on parle
Nghiem et al. (2024) ont demandé à des modèles de choisir entre des candidats pour 40 professions et de recommander un salaire, en ne changeant que le prénom des candidats. Les deux modèles ont préféré les candidats dont le prénom est associé aux personnes blanches pour 50 à 95 % des professions, selon le modèle et la configuration. Même à qualifications identiques, le salaire recommandé différait jusqu’à 5 % entre des groupes définis à la fois par l’origine ethnique et par le genre.GPT-3.5 Turbo et Llama 3 70B, avec 320 prénoms américains, en 2024.
Dans les deux études, aucune réponse isolée ne montre quoi que ce soit d’anormal. La différence n’apparaît qu’en comparant la même demande d’un prénom à l’autre.
Des modèles plus grands, le même biais
Plus de données et des modèles plus grands n’ont pas éliminé ce type de biais : davantage de texte tiré du même genre de sources contient les mêmes régularités. Dans une étude portant sur huit modèles conversationnels, les plus grands modèles de chaque famille tendaient à présenter plus d’associations stéréotypées que les plus petits (Bai et al., 2025) (see also the Correcting bias page) (voir aussi la page Corriger les biais).
Sources
- Bai, X., Wang, A., Sucholutsky, I., & Griffiths, T. L. (2025). Explicitly unbiased large language models still form biased associations. Proceedings of the National Academy of Sciences, 122(8), e2416228122. https://doi.org/10.1073/pnas.2416228122
- Eloundou, T., Beutel, A., Robinson, D. G., Gu, K., Brakman, A.-L., Mishkin, P., Shah, M., Heidecke, J., Weng, L., & Kalai, A. T. (2025). First-Person Fairness in Chatbots. Proceedings of the Thirteenth International Conference on Learning Representations (ICLR 2025). https://openreview.net/forum?id=TlAdgeoDTo
- Nghiem, H., Prindle, J., Zhao, J., & Daumé III, H. (2024). “You Gotta be a Doctor, Lin” : An Investigation of Name-Based Bias of Large Language Models in Employment Recommendations. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 7268–7287. https://doi.org/10.18653/v1/2024.emnlp-main.413