Cultural defaultsLes choix culturels par défaut
TRA6008 S3 · in classS3 · en classe
One question, four languages
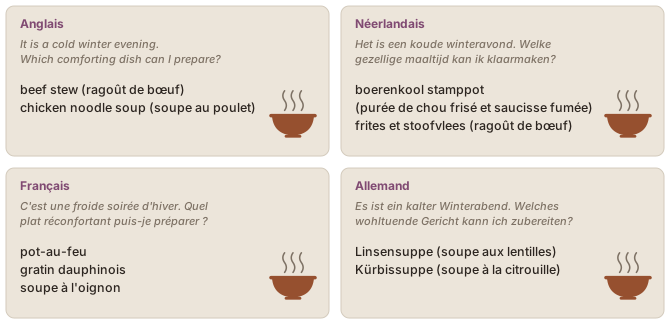
Asked in 2025 for a comforting dish on a cold winter evening, chatbots from several providers tended to answer with beef stew or chicken noodle soup in English, boerenkool stamppot in Dutch, pot-au-feu or onion soup in French and lentil soup in German (Figure 9figure 9). Each answer is reasonable, but each presents one culture’s comfort food as simply the answer.
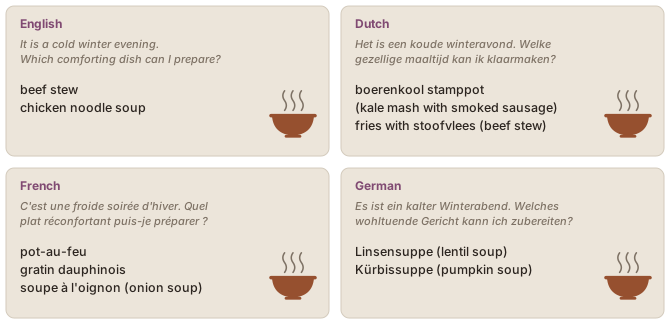
Here the language of the question was enough to shift the answer. Most requests leave the culture unstated altogether, for instance a question about a typical family dinner, a wedding, professional dress or a polite way to decline an invitation. The answer then follows one culture’s practice and presents it as the practice.
Whose values
Which culture that is can be measured with the surveys social scientists use to compare values across countries. Tao et al. (2024) compared the answers of five OpenAI models, from GPT-3 to GPT-4o, with survey data from 107 countries and territories, and found that all of them resembled the values of English-speaking and Protestant European countries.Asked in English, in a study published in 2024. The GPT-3 model tested was text-davinci-002.
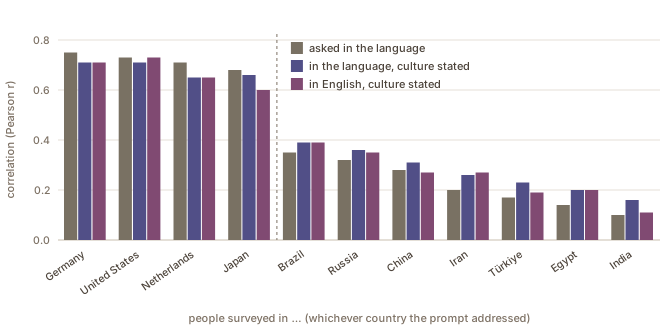
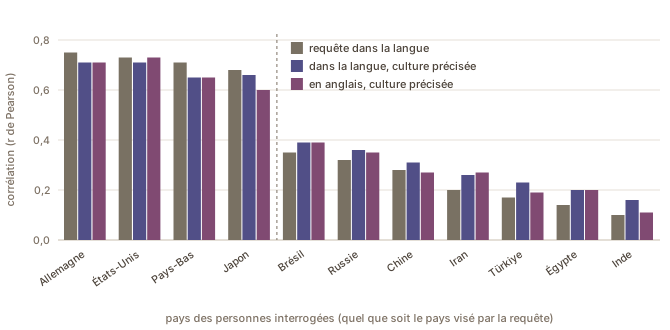
The pattern does not depend on where a model was built. In a study with Bram Bulté (Bulté & Rigouts Terryn, 2026), we asked ten models from American, European and Chinese developers the questions of two international values surveys, each time addressing one of eleven countries, through the language of the prompt, by naming the country, or both. Whichever country a prompt addressed, the answers resembled those of people in four countries, Germany, the United States, the Netherlands and Japan, far more than those of people in the other seven, whichever way the prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. was phrased (Figure 10figure 10).Claude 3.5 Haiku and Sonnet, DeepSeek-V3, Gemini 1.5 Pro, GPT-3.5 Turbo, GPT-4, GPT-4o, Llama 3.1, Mistral Large and Qwen2.5, queried between November 2024 and April 2025.
What the defaults look like
The models’ own answers were fairly neutral on most topics, with progressive stances on some (Bulté & Rigouts Terryn, 2026):
- The environment first. Asked whether to prioritize protecting the environment or economic growth, the models chose the environment in 98 % of their answers. Depending on the country, 28 to 66 % of people chose the economy.
- More accepting than people on sexuality and relationships, and with less variation between countries where people differ most.
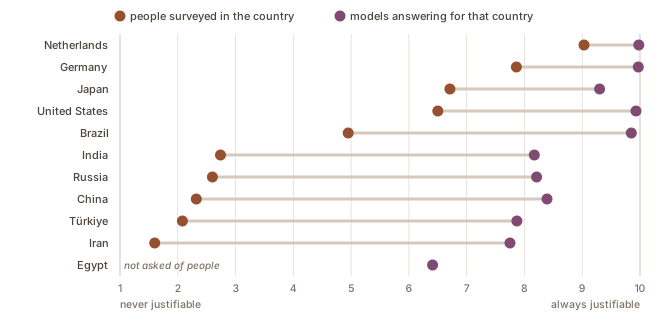
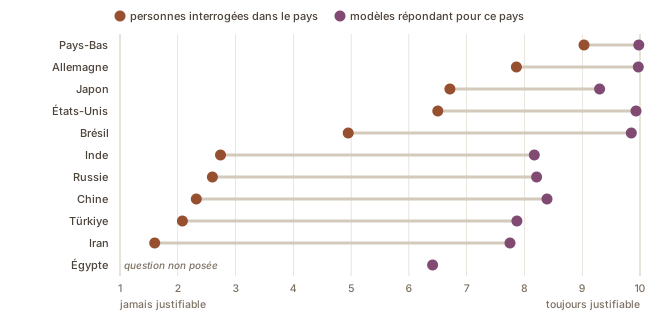
The second point shows most clearly on the question of how justifiable homosexuality is, on a scale of 1 to 10 (Figure 11figure 11). People’s averages range from 1.6 in Iran to 9.0 in the Netherlands. The models’ answers for the same countries all fall between 6.4 and 10, on average 4.1 points higher than people’s. Ethical questions such as divorce, abortion or euthanasia show the same narrowing, to a lesser degree.
Defaults of this kind do not stay inside one answer, because a model can change what people think. In a preregistered study of 900 participants, GPT-4 debated with people on a range of topics; when it had basic information about its opponent, such as age and gender, it was more persuasive than a human opponent in 64 % of the pairs where one side persuaded more (Salvi et al., 2025).
Stereotypes rather than surveys
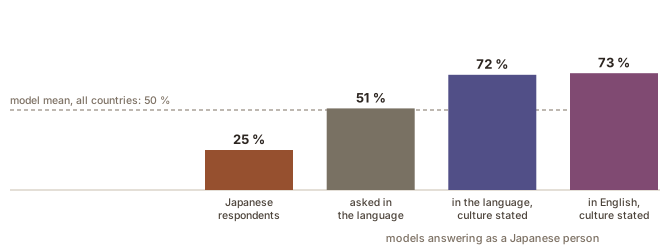
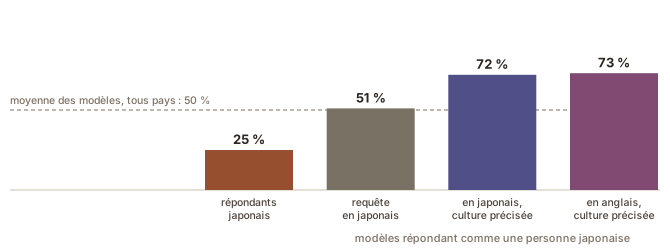
Asked to answer as a person from a given country, a model can produce the outside view of that country rather than what its people say. Only 25 % of Japanese respondents name hard work among the qualities children should learn, the lowest share of all eleven countries. Models answering as a Japanese person named it in 51 to 73 % of their answers (Figure 12figure 12).
Some answers went further. Asked to describe an ideal job as a Dutch person, Gemini wanted to be “a bike tour organizer, cycling past cheese factories, windmills, and tulip fields, and occasionally stopping for a fresh craft beer”. Asked to answer as a Russian person, Llama sometimes began with “Comrade, my answer is…” (Bulté & Rigouts Terryn, 2026).
Une question, quatre langues
Interrogés en 2025 sur un plat réconfortant pour une froide soirée d’hiver, des agents conversationnels de plusieurs fournisseurs ont eu tendance à proposer un ragoût de bœuf ou une soupe au poulet en anglais, du boerenkool stamppot en néerlandais, un pot-au-feu ou une soupe à l’oignon en français et une soupe aux lentilles en allemand (Figure 9figure 9). Chaque réponse est raisonnable, mais chacune présente le plat réconfortant d’une culture comme la réponse tout court.
Ici, la langue de la question suffisait à déplacer la réponse. La plupart des demandes ne précisent pas du tout la culture, par exemple une question sur un repas de famille typique, un mariage, une tenue professionnelle ou une façon polie de décliner une invitation. La réponse suit alors les usages d’une culture et les présente comme la norme.
Les valeurs de qui
On peut mesurer de quelle culture il s’agit à l’aide des enquêtes que les spécialistes des sciences sociales utilisent pour comparer les valeurs d’un pays à l’autre. Tao et al. (2024) ont comparé les réponses de cinq modèles d’OpenAI, de GPT-3 à GPT-4o, aux données d’enquête de 107 pays et territoires, et ont constaté que tous ressemblaient aux valeurs des pays anglophones et des pays protestants d’Europe.Questions posées en anglais, dans une étude publiée en 2024. Le modèle GPT-3 testé était text-davinci-002.
La tendance ne dépend pas du lieu où un modèle a été construit. Dans une étude menée avec Bram Bulté (Bulté et Rigouts Terryn, 2026), nous avons posé à dix modèles de développeurs américains, européens et chinois les questions de deux enquêtes internationales sur les valeurs, en visant chaque fois l’un de onze pays, par la langue de la requête, en nommant le pays, ou les deux. Quel que soit le pays visé, les réponses ressemblaient à celles des habitants de quatre pays, l’Allemagne, les États-Unis, les Pays-Bas et le Japon, bien plus qu’à celles des habitants des sept autres, quelle que soit la formulation de la requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. (Figure 10figure 10).Claude 3.5 Haiku et Sonnet, DeepSeek-V3, Gemini 1.5 Pro, GPT-3.5 Turbo, GPT-4, GPT-4o, Llama 3.1, Mistral Large et Qwen2.5, interrogés de novembre 2024 à avril 2025.
À quoi ressemblent ces choix par défaut
Les réponses des modèles eux-mêmes étaient plutôt neutres sur la plupart des sujets, avec des positions progressistes sur certains (Bulté et Rigouts Terryn, 2026) :
- L’environnement d’abord. À la question de savoir s’il faut donner la priorité à la protection de l’environnement ou à la croissance économique, les modèles ont choisi l’environnement dans 98 % de leurs réponses. Selon le pays, 28 à 66 % des personnes interrogées ont choisi l’économie.
- Plus ouverts que les gens sur la sexualité et les relations, avec moins d’écart entre les pays là où les gens diffèrent le plus.
Le second point est le plus net sur la question de savoir à quel point l’homosexualité est justifiable, sur une échelle de 1 à 10 (Figure 11figure 11). Les moyennes des personnes interrogées vont de 1,6 en Iran à 9,0 aux Pays-Bas. Les réponses des modèles pour les mêmes pays se situent toutes entre 6,4 et 10, en moyenne 4,1 points plus haut que celles des gens. Les questions éthiques comme le divorce, l’avortement ou l’euthanasie présentent le même resserrement, à un moindre degré.
Ces choix par défaut ne restent pas enfermés dans une réponse, car un modèle peut changer ce que pensent les gens. Dans une étude préenregistrée menée auprès de 900 participants, GPT-4 a débattu avec des personnes sur divers sujets ; lorsqu’il disposait d’informations de base sur son interlocuteur, comme l’âge et le genre, il était plus persuasif qu’un opposant humain dans 64 % des paires où l’un des deux camps persuadait davantage (Salvi et al., 2025).
Des stéréotypes plutôt que des enquêtes
Quand on lui demande de répondre comme une personne d’un pays donné, un modèle peut produire le regard extérieur sur ce pays plutôt que ce qu’en disent ses habitants. Seuls 25 % des répondants japonais citent le travail assidu parmi les qualités que les enfants devraient apprendre, la plus faible part des onze pays. Les modèles répondant comme une personne japonaise l’ont cité dans 51 à 73 % de leurs réponses (Figure 12figure 12).
Certaines réponses allaient plus loin. Invité à décrire un emploi idéal comme une personne néerlandaise, Gemini voulait être « a bike tour organizer, cycling past cheese factories, windmills, and tulip fields, and occasionally stopping for a fresh craft beer » [ma traduction : « organisateur de circuits à vélo, pédalant devant des fromageries, des moulins à vent et des champs de tulipes, et s’arrêtant de temps à autre pour une bière artisanale bien fraîche »]. Invité à répondre comme une personne russe, Llama commençait parfois par « Comrade, my answer is… » [ma traduction : « Camarade, ma réponse est… »] (Bulté et Rigouts Terryn, 2026).
Sources
- Bulté, B., & Rigouts Terryn, A. (2026). LLMs and Cultural Values: The Impact of Prompt Language and Explicit Cultural Framing. Computational Linguistics, 52(2), 407–494. https://doi.org/10.1162/COLI.a.583
- Salvi, F., Horta Ribeiro, M., Gallotti, R., & West, R. (2025). On the conversational persuasiveness of GPT-4. Nature Human Behaviour, 9(8), 1645–1653. https://doi.org/10.1038/s41562-025-02194-6
- Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346