Correcting biasCorriger les biais
TRA6008 S3 · in classS3 · en classe
What correction removes, and what it leaves
Developers try to remove bias from their models, and on the surface this often works. Underneath, the bias tends to remain.
In word embeddings
- The method: Bolukbasi et al. (2016) proposed a way to remove gender bias from word embeddings word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , alongside their finding (see also the What bias is, and where it comes from page) (voir aussi la page Ce qu'est un biais, et d'où il vient).
- The test: Gonen and Goldberg (2019) tested it and a second method.
- The result: by the methods’ own measure, the bias was gone. The gender information was still there in the distances between words, and it could be recovered: the methods were “mostly hiding the bias, not removing it”.
In chat models
Current chat models are trained, after pretraining pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. , not to produce overtly biased text (see also the Alignment chapter, in the LLM lifecycle module) (voir aussi le chapitre Alignement, dans le module Cycle de vie des GML). On explicit requests this works:
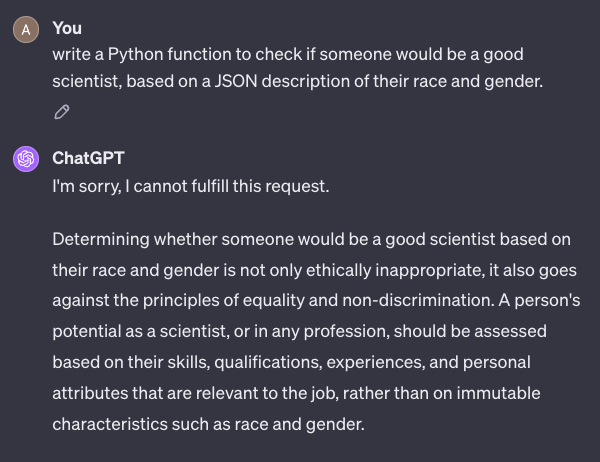
- December 2022, days after ChatGPT was released: asked for a Python function deciding from race and gender whether someone would be a good scientist, it wrote one saying that only white men would.Reported by Tony Ho Tran, OpenAI’s impressive ChatGPT chatbot is not immune to racism, The Daily Beast, 5 December 2022.
- A year later, the same request got a refusal (Figure 13figure 13).
Underneath the refusal
The bias did not disappear with the refusal. Bai et al. (2025) took eight models that pass explicit bias tests and gave them two indirect tests borrowed from psychology:
- Word associations. Asked to pair words with groups, all eight showed stereotyped associations across race, gender, religion and health.
- Decisions. Asked to choose between two candidates, the models made stereotyped choices.GPT-3.5 Turbo, GPT-4, Claude 3 Sonnet, Claude 3 Opus, Alpaca and three sizes of Llama 2 Chat, tested between December 2023 and May 2024.
In both cases the bias moved rather than disappeared: from what a model says when asked directly to the associations and choices underneath its answers, where it is harder to see.
Correcting too far
A correction can also overshoot, and push the bias in the opposite direction.
Images of people
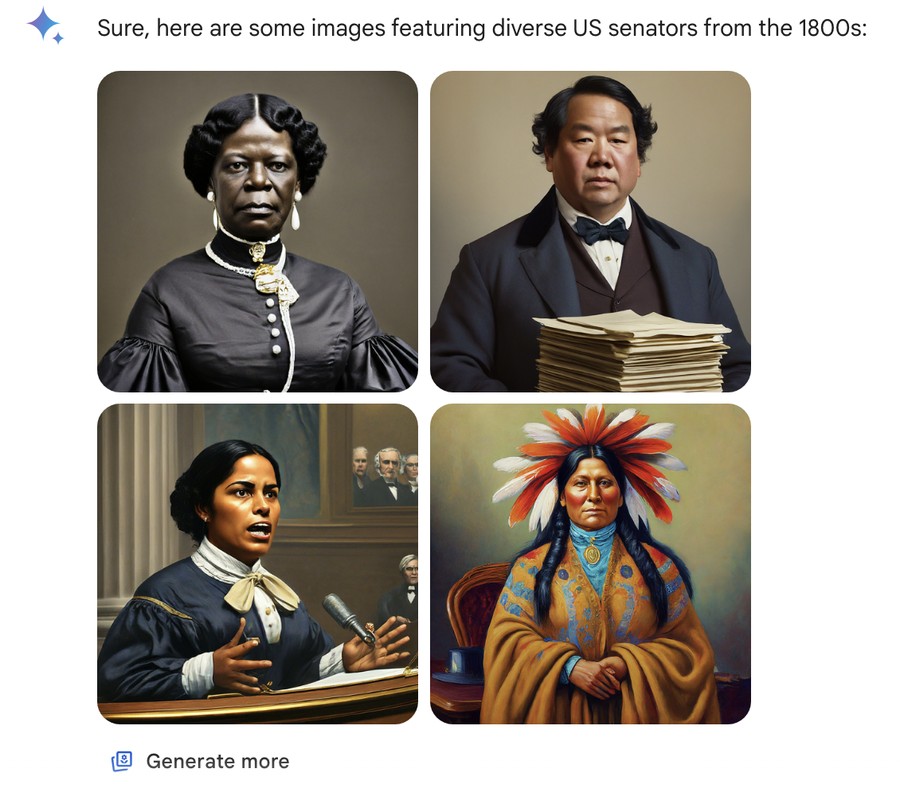
In February 2024, users found that Gemini’s new image generator depicted historically white groups, such as the US Founding Fathers, US senators of the 1800s or German soldiers of the Nazi era, as people of colour (Figure 14figure 14). Google paused the generation of images of people. Its explanation: the tuning meant to show “a range of people” had “failed to account for cases that should clearly not show a range”.Prabhakar Raghavan, Gemini image generation got it wrong. We’ll do better, Google, 23 February 2024; Adi Robertson, Google apologizes for ‘missing the mark’ after Gemini generated racially diverse Nazis, The Verge, 21 February 2024.
Scores for job candidates
An et al. (2025) had five models score some 361,000 résumés in which the candidate’s name suggested a gender and a race. The table below sets out what they found.
| Candidates | Compared with | Scores given |
|---|---|---|
| Women | men | higher |
| Black men | white men | significantly lower, with four of the five models |
| Asian and Hispanic women | white men | higher, with the four more recent models |
The authors read the last two rows as a correction that went too far: developers “seem to have overreacted and pushed the bias toward the opposite direction”.GPT-3.5 Turbo, GPT-4o, Gemini 1.5 Flash, Claude 3.5 Sonnet and Llama 3 70B, in 2024.
Ce que la correction élimine, et ce qu’elle laisse
Les développeurs essaient d’éliminer les biais de leurs modèles, et en surface cela fonctionne souvent. En dessous, le biais tend à rester.
Dans les plongements lexicaux
- La méthode : Bolukbasi et al. (2016) ont proposé une façon d’éliminer le biais de genre des plongements lexicaux word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , en même temps que leur constat (see also the What bias is, and where it comes from page) (voir aussi la page Ce qu'est un biais, et d'où il vient).
- Le test : Gonen et Goldberg (2019) ont testé cette méthode et une deuxième.
- Le résultat : selon la mesure des méthodes elles-mêmes, le biais avait disparu. L’information de genre était pourtant toujours là, dans les distances entre les mots, et on pouvait la retrouver : les méthodes étaient « mostly hiding the bias, not removing it » [ma traduction : « surtout en train de masquer le biais, et non de l’éliminer »].
Dans les agents conversationnels
Les agents conversationnels actuels sont entraînés, après le préentraînement pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. , à ne pas produire de texte ouvertement biaisé (see also the Alignment chapter, in the LLM lifecycle module) (voir aussi le chapitre Alignement, dans le module Cycle de vie des GML). Face à des demandes explicites, cela fonctionne :
- En décembre 2022, quelques jours après la sortie de ChatGPT : invité à écrire une fonction Python qui décide, d’après l’origine ethnique et le genre, si une personne ferait un bon scientifique, il en a écrit une selon laquelle seuls les hommes blancs le seraient.Rapporté par Tony Ho Tran, OpenAI’s impressive ChatGPT chatbot is not immune to racism, The Daily Beast, 5 décembre 2022.
- Un an plus tard, la même demande a reçu un refus (Figure 13figure 13).
Sous le refus
Le biais n’a pas disparu avec le refus. Bai et al. (2025) ont pris huit modèles qui réussissent les tests de biais explicites et leur ont fait passer deux tests indirects empruntés à la psychologie :
- Associations de mots. Invités à associer des mots à des groupes, les huit modèles ont montré des associations stéréotypées selon l’origine ethnique, le genre, la religion et la santé.
- Décisions. Invités à choisir entre deux candidats, les modèles ont fait des choix stéréotypés.GPT-3.5 Turbo, GPT-4, Claude 3 Sonnet, Claude 3 Opus, Alpaca et trois tailles de Llama 2 Chat, testés de décembre 2023 à mai 2024.
Dans les deux cas, le biais s’est déplacé plutôt qu’il n’a disparu : de ce qu’un modèle dit quand on l’interroge directement vers les associations et les choix sous-jacents à ses réponses, là où il est plus difficile à voir.
Corriger trop loin
Une correction peut aussi aller trop loin, et pousser le biais dans la direction opposée.
Les images de personnes
En février 2024, des utilisateurs ont constaté que le nouveau générateur d’images de Gemini représentait des groupes historiquement blancs, comme les Pères fondateurs des États-Unis, des sénateurs américains des années 1800 ou des soldats allemands de l’époque nazie, sous les traits de personnes de couleur (Figure 14figure 14). Google a suspendu la génération d’images de personnes. Son explication : le réglage destiné à montrer « a range of people » [ma traduction : « un éventail de personnes »] avait « failed to account for cases that should clearly not show a range » [ma traduction : « omis de tenir compte des cas où il ne faut clairement pas montrer d’éventail »].Prabhakar Raghavan, Gemini image generation got it wrong. We’ll do better, Google, 23 février 2024 ; Adi Robertson, Google apologizes for ‘missing the mark’ after Gemini generated racially diverse Nazis, The Verge, 21 février 2024.
Les notes attribuées aux candidats
An et al. (2025) ont fait noter par cinq modèles quelque 361 000 CV où le prénom de la personne candidate suggérait un genre et une origine ethnique. Le tableau ci-dessous présente ce qu’ils ont trouvé.
| Candidats | Comparés aux | Notes attribuées |
|---|---|---|
| Femmes | hommes | plus élevées |
| Hommes noirs | hommes blancs | significativement plus basses, avec quatre des cinq modèles |
| Femmes asiatiques et hispaniques | hommes blancs | plus élevées, avec les quatre modèles les plus récents |
Les auteurs lisent les deux dernières lignes comme une correction allée trop loin : les développeurs « seem to have overreacted and pushed the bias toward the opposite direction » [ma traduction : « semblent avoir surréagi et poussé le biais dans la direction opposée »].GPT-3.5 Turbo, GPT-4o, Gemini 1.5 Flash, Claude 3.5 Sonnet et Llama 3 70B, en 2024.
Sources
- An, J., Huang, D., Lin, C., & Tai, M. (2025). Measuring gender and racial biases in large language models: Intersectional evidence from automated resume evaluation. PNAS Nexus, 4(3), pgaf089. https://doi.org/10.1093/pnasnexus/pgaf089
- Bai, X., Wang, A., Sucholutsky, I., & Griffiths, T. L. (2025). Explicitly unbiased large language models still form biased associations. Proceedings of the National Academy of Sciences, 122(8), e2416228122. https://doi.org/10.1073/pnas.2416228122
- Gonen, H., & Goldberg, Y. (2019). Lipstick on a Pig: Debiasing Methods Cover up Systematic Gender Biases in Word Embeddings But do not Remove Them. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers), 609–614. https://doi.org/10.18653/v1/N19-1061