What one use costsCe que coûte une utilisation
TRA6008 S3 · in classS3 · en classe
What makes one use cost more
The energy used to answer one request depends on three things, and for each of them you often have a choice.
- The size of the model. Mistral reports that impacts are “roughly proportional to model size”: a model ten times larger costs about ten times as much for the same number of tokens token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. (Mistral AI, 2025). A smaller model that is adequate for the task therefore costs less, and most providers offer several sizes (see also the Families, generations and tiers page, in the Using LLMs module) (voir aussi la page Familles, générations et niveaux, dans le module Utiliser les GML).
- The number of tokens generated. A long answer costs more than a short one, and so does a model set to reason at a higher effort level reasoning efforteffort de raisonnement language modelsmodèles de langue A setting that controls how much computation a model spends on an answer, which in practice means how many tokens it generates.Paramètre qui détermine la quantité de calcul qu'un modèle consacre à une réponse, c'est-à-dire, en pratique, le nombre de jetons qu'il génère. , which generates many more tokens before its answer (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML). An agent AI agentagent agentsagents An AI system that selects and carries out actions toward a goal, often by using tools or calling other programs and adapting later actions to the results it receives.Système d'IA qui choisit et exécute des actions en vue d'un but, souvent en utilisant des outils ou en appelant d'autres programmes et en adaptant ses actions ultérieures aux résultats reçus. that works through several steps generates more again, and long documents supplied with a prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. add to the cost as well (International Energy Agency, 2026). Each retry is another full generation, so asking well once costs less than asking three times.
- The kind of output. Images and video cost far more than text, by factors that differ from one study to the next, as the table below shows.
| Output | Compared with | Estimate | Source |
|---|---|---|---|
| A high-resolution image | a short text query | up to about ten times as much | International Energy Agency (2026) |
| An image | a text generation of ten tokens, on average | about sixty times as much | Luccioni et al. (2024), open models measured in 2023 |
| A video | a short text query | hundreds to thousands of times as much, depending on length and resolution | International Energy Agency (2026) |
| A clip of about five seconds | an image in Luccioni et al. (2024) | about thirty times as much | Delavande et al. (2025), one open video model |
The estimates differ because the models, the settings and what was measured differ, so a multiplier like these is worth quoting only with its date and its source.
From a short answer to an agent
The kind of use can change the energy of one request far more than the size of the model does. In a comparison the International Energy Agency (2026, p. 29) drew from standardized measurements on open models, one plain text answer from a medium-sized model used 0.05 watt-hours on the chips, a larger model 0.31, the medium model with reasoning reasoningraisonnement language modelsmodèles de langue The process of using available information to draw conclusions or work toward the solution of a problem.Processus consistant à utiliser l'information disponible pour tirer des conclusions ou progresser vers la solution d'un problème. turned on 7.6, and an agent combining reasoning with four to six calls in a row about 50: a thousand times the first (Figure 7figure 7). A full smartphone charge takes about 19 watt-hours (U.S. Environmental Protection Agency, 2026), so the plain answer is about a four-hundredth of a charge, and the agent with reasoning about two and a half charges.
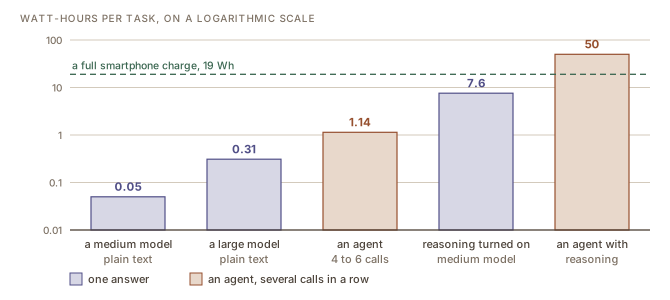
That agent is a moderate one. An agent that works on a task for hours makes many more calls, and several agents working at once multiply the count again. Agents can also keep running while nobody is waiting for their answer, so the energy they use is no longer tied to the time anyone spends in front of the screen (International Energy Agency, 2026, p. 29).
When a smaller model is enough
A smaller model built for one task is often proposed as the answer to the energy use of general-purpose models. It is the answer for some tasks, but not for others.
Luccioni et al. (2024) found that general-purpose generative models used orders of magnitude more energy than models built for one task, on question answering and sentiment classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. . On summarization, the gap was much smaller, and it came mostly from the size of the models.The general-purpose models were open models, Flan-T5 and BLOOMz, measured in 2023, with at most 11 billion parameters parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. , far smaller than the models behind today’s chat products.
- Where a small model is enough: a narrow task with plenty of examples, for instance sorting messages into categories or recognizing the language of a text. The possible answers are few and known in advance, so a small system trained for that one job can do it well, and repeated many times, it uses far less energy than a general-purpose model.
- Where it falls short: a task that draws on broad knowledge, for instance translating or summarizing a text, or answering an open question. Language is ambiguous, and resolving the ambiguity often takes knowledge of the world as well as of the language (see also the Ambiguity page, in the Language as numbers module) (voir aussi la page Ambiguïté, dans le module Le langage en nombres). A small system learns only what its training examples show, where a general model has learned from far more text. In translation, for instance, the systems that human evaluators rank best are now built on large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (Kocmi et al., 2025).
A model too small for the task can also end up costing more, if it takes several tries to give an answer you can use (see also the Putting it in proportion page) (voir aussi la page Remettre en proportion).
Where the query runs
The same model, the same query and the same number of tokens produce different emissions in two places, because the carbon depends on the electricity used. Generating a kilowatt-hour directly emits about 960 grams of CO2 from coal, about 390 from a modern gas plant, and practically nothing from wind, solar, hydroelectric or nuclear power. Averaged over their mix, grids emit about 240 grams per kilowatt-hour in Europe, 350 in the United States and around 600 in China and Southeast Asia (International Energy Agency, 2025, p. 78; Figure 8figure 8).These are direct emissions only, averaged over 2021 to 2023: the figures leave out what building and supplying the power plants emits.
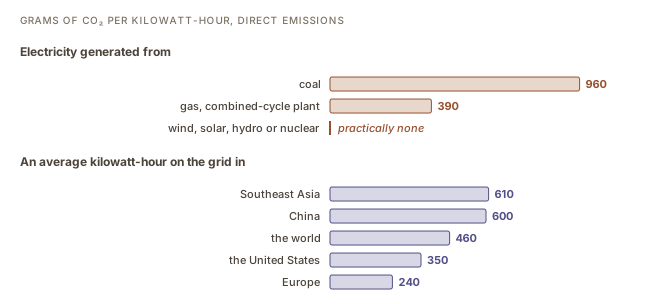
Your query is answered in a data centre data centrecentre de traitement de données environmentenvironnement A facility that houses computing, storage, and networking equipment, together with supporting infrastructure such as power supplies, cooling systems, and security systems.Installation qui abrite de l'équipement de calcul, de stockage et de réseau, ainsi que les infrastructures de soutien comme l'alimentation électrique, les systèmes de refroidissement et les systèmes de sécurité. , which draws its electricity from the grid it is connected to.
A data centre on a grid supplied by hydroelectric or nuclear power therefore produces a small fraction of the emissions of one on a coal-heavy grid. The difference is invisible to you: a chat interface does not say where your request was served.
Many operators also buy renewable electricity by contract. Most of these contracts cover a volume of electricity over a year rather than each hour of use, so the electricity a data centre actually draws can still come partly from gas or coal (International Energy Agency, 2025, p. 75).
Ce qui fait augmenter le coût d’une utilisation
L’énergie nécessaire pour répondre à une requête dépend de trois choses, et pour chacune, vous avez souvent le choix.
- La taille du modèle. Mistral indique que les impacts sont « roughly proportional to model size » [ma traduction : « à peu près proportionnels à la taille du modèle »] : un modèle dix fois plus grand coûte environ dix fois plus pour le même nombre de jetons token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. (Mistral AI, 2025). Un modèle plus petit, suffisant pour la tâche, coûte donc moins, et la plupart des fournisseurs proposent plusieurs tailles (see also the Families, generations and tiers page, in the Using LLMs module) (voir aussi la page Familles, générations et niveaux, dans le module Utiliser les GML).
- Le nombre de jetons produits. Une longue réponse coûte plus qu’une courte, tout comme un modèle réglé pour raisonner avec un effort de raisonnement reasoning efforteffort de raisonnement language modelsmodèles de langue A setting that controls how much computation a model spends on an answer, which in practice means how many tokens it generates.Paramètre qui détermine la quantité de calcul qu'un modèle consacre à une réponse, c'est-à-dire, en pratique, le nombre de jetons qu'il génère. plus élevé, qui produit beaucoup plus de jetons avant sa réponse (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML). Un agent AI agentagent agentsagents An AI system that selects and carries out actions toward a goal, often by using tools or calling other programs and adapting later actions to the results it receives.Système d'IA qui choisit et exécute des actions en vue d'un but, souvent en utilisant des outils ou en appelant d'autres programmes et en adaptant ses actions ultérieures aux résultats reçus. qui passe par plusieurs étapes en produit davantage encore, et les longs documents fournis avec une requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. ajoutent aussi au coût (International Energy Agency, 2026). Chaque nouvel essai est une génération complète : bien formuler sa demande une fois coûte moins que la formuler trois fois.
- Le type de sortie. Les images et la vidéo coûtent bien plus que le texte, selon des facteurs qui varient d’une étude à l’autre, comme le montre le tableau ci-dessous.
| Sortie | Comparée à | Estimation | Source |
|---|---|---|---|
| Une image haute résolution | une courte requête en texte | jusqu’à environ dix fois plus | International Energy Agency (2026) |
| Une image | une génération de texte de dix jetons, en moyenne | environ soixante fois plus | Luccioni et al. (2024), modèles ouverts mesurés en 2023 |
| Une vidéo | une courte requête en texte | de centaines à des milliers de fois plus, selon la durée et la résolution | International Energy Agency (2026) |
| Un extrait d’environ cinq secondes | une image dans Luccioni et al. (2024) | environ trente fois plus | Delavande et al. (2025), un modèle vidéo ouvert |
Les estimations diffèrent parce que les modèles, les réglages et ce qui a été mesuré diffèrent : un tel multiplicateur ne vaut la peine d’être cité qu’avec sa date et sa source.
D’une courte réponse à un agent
Le type d’utilisation peut modifier l’énergie d’une requête bien plus que la taille du modèle. Dans une comparaison que l’Agence internationale de l’énergie (2026, p. 29) a tirée de mesures normalisées sur des modèles ouverts, une réponse en texte seul d’un modèle de taille moyenne consommait 0,05 wattheure sur les puces, un modèle plus grand 0,31, le modèle moyen avec le raisonnement reasoningraisonnement language modelsmodèles de langue The process of using available information to draw conclusions or work toward the solution of a problem.Processus consistant à utiliser l'information disponible pour tirer des conclusions ou progresser vers la solution d'un problème. activé 7,6, et un agent combinant le raisonnement avec quatre à six appels à la suite environ 50 : mille fois la première (Figure 7figure 7). Une recharge complète de téléphone intelligent demande environ 19 wattheures (U.S. Environmental Protection Agency, 2026) : la réponse en texte seul représente donc environ un quatre-centième de recharge, et l’agent avec raisonnement environ deux recharges et demie.
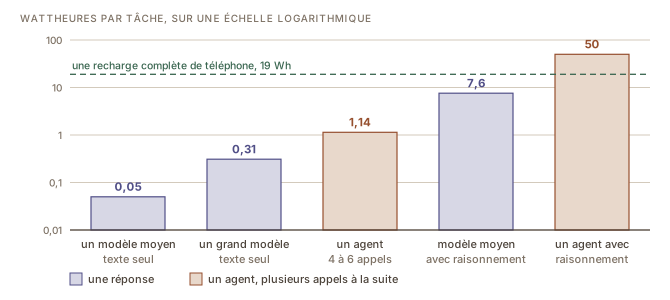
Cet agent est modéré. Un agent qui travaille sur une tâche pendant des heures fait bien plus d’appels, et plusieurs agents qui travaillent en même temps multiplient encore le compte. Les agents peuvent aussi continuer de tourner alors que personne n’attend leur réponse, si bien que l’énergie qu’ils consomment n’est plus liée au temps que quelqu’un passe devant l’écran (International Energy Agency, 2026, p. 29).
Quand un modèle plus petit suffit
Un modèle plus petit, conçu pour une seule tâche, est souvent présenté comme la solution à la consommation d’énergie des modèles généralistes. C’est la solution pour certaines tâches, mais pas pour d’autres.
Luccioni et al. (2024) ont constaté que les modèles génératifs généralistes consommaient plusieurs ordres de grandeur d’énergie de plus que des modèles conçus pour une seule tâche, pour la réponse à des questions et la classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. du sentiment. Pour le résumé, l’écart était bien plus faible, et il venait surtout de la taille des modèles.Les modèles généralistes étaient des modèles ouverts, Flan-T5 et BLOOMz, mesurés en 2023, avec au plus 11 milliards de paramètres parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. , bien moins que les modèles qui font tourner les produits conversationnels actuels.
- Là où un petit modèle suffit : une tâche étroite, avec beaucoup d’exemples, par exemple trier des messages par catégorie ou reconnaître la langue d’un texte. Les réponses possibles sont peu nombreuses et connues d’avance : un petit système entraîné pour cette seule tâche peut bien s’en acquitter et, répété un grand nombre de fois, il consomme bien moins d’énergie qu’un modèle généraliste.
- Là où il ne suffit pas : une tâche qui fait appel à de vastes connaissances, par exemple traduire ou résumer un texte, ou répondre à une question ouverte. La langue est ambiguë, et lever l’ambiguïté demande souvent une connaissance du monde autant que de la langue (see also the Ambiguity page, in the Language as numbers module) (voir aussi la page Ambiguïté, dans le module Le langage en nombres). Un petit système n’apprend que ce que montrent ses exemples d’entraînement, alors qu’un modèle généraliste a appris sur bien plus de texte. En traduction, par exemple, les systèmes que les évaluateurs humains classent en tête reposent désormais sur des grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (Kocmi et al., 2025).
Un modèle trop petit pour la tâche peut aussi finir par coûter plus cher s’il faut plusieurs essais pour obtenir une réponse utilisable (see also the Putting it in proportion page) (voir aussi la page Remettre en proportion).
Là où la requête est traitée
Le même modèle, la même requête et le même nombre de jetons produisent des émissions différentes à deux endroits, parce que le carbone dépend de l’électricité utilisée. Produire un kilowattheure émet directement environ 960 grammes de CO2 avec du charbon, environ 390 avec une centrale au gaz moderne, et pratiquement rien avec l’éolien, le solaire, l’hydroélectricité ou le nucléaire. En moyenne, selon leur composition, les réseaux émettent environ 240 grammes par kilowattheure en Europe, 350 aux États-Unis et autour de 600 en Chine et en Asie du Sud-Est (International Energy Agency, 2025, p. 78 ; Figure 8figure 8).Il s’agit uniquement des émissions directes, en moyenne de 2021 à 2023 : les chiffres excluent ce qu’émettent la construction et l’approvisionnement des centrales.
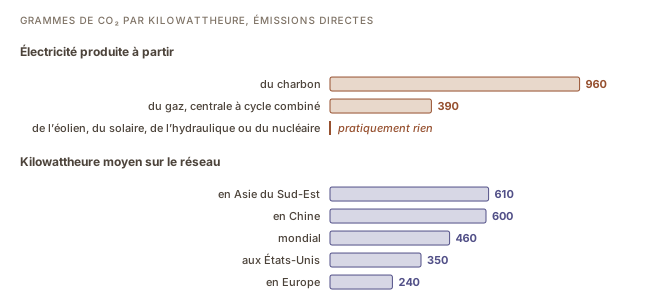
Votre requête reçoit sa réponse dans un centre de traitement de données data centrecentre de traitement de données environmentenvironnement A facility that houses computing, storage, and networking equipment, together with supporting infrastructure such as power supplies, cooling systems, and security systems.Installation qui abrite de l'équipement de calcul, de stockage et de réseau, ainsi que les infrastructures de soutien comme l'alimentation électrique, les systèmes de refroidissement et les systèmes de sécurité. , qui tire son électricité du réseau auquel il est raccordé.
Un centre de traitement de données sur un réseau alimenté par l’hydroélectricité ou le nucléaire produit donc une petite fraction des émissions d’un centre sur un réseau dominé par le charbon. La différence vous est invisible : une interface conversationnelle ne dit pas où votre requête a été traitée.
Beaucoup d’exploitants achètent aussi de l’électricité renouvelable par contrat. La plupart de ces contrats couvrent un volume d’électricité sur une année plutôt que chaque heure d’utilisation, si bien que l’électricité qu’un centre de traitement de données consomme réellement peut encore venir en partie du gaz ou du charbon (International Energy Agency, 2025, p. 75).
Sources
- Delavande, J., Pierrard, R., & Luccioni, A. S. (2025). Video Killed the Energy Budget: Characterizing the Latency and Power Regimes of Open Text-to-Video Models. arXiv preprint arXiv:2509.19222. https://doi.org/10.48550/arXiv.2509.19222
- International Energy Agency (2025). Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/energy-and-ai
- International Energy Agency (2026). Key Questions on Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/key-questions-on-energy-and-ai
- Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
- Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
- Mistral AI (2025). Our contribution to a global environmental standard for AI. Mistral AI, 22 July 2025. https://mistral.ai/news/our-contribution-to-a-global-environmental-standard-for-ai
- U.S. Environmental Protection Agency (2026). Greenhouse Gas Equivalencies Calculator - Calculations and References. U.S. Environmental Protection Agency, last updated 4 August 2026. https://www.epa.gov/energy/greenhouse-gases-equivalencies-calculator-calculations-and-references
Sources
- Delavande, J., Pierrard, R., & Luccioni, A. S. (2025). Video Killed the Energy Budget: Characterizing the Latency and Power Regimes of Open Text-to-Video Models. arXiv preprint arXiv:2509.19222. https://doi.org/10.48550/arXiv.2509.19222
- International Energy Agency (2025). Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/energy-and-ai
- International Energy Agency (2026). Key Questions on Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/key-questions-on-energy-and-ai
- Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
- Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
- Mistral AI (2025). Our contribution to a global environmental standard for AI. Mistral AI, 22 juillet 2025. https://mistral.ai/news/our-contribution-to-a-global-environmental-standard-for-ai
- U.S. Environmental Protection Agency (2026). Greenhouse Gas Equivalencies Calculator - Calculations and References. U.S. Environmental Protection Agency, last updated 4 août 2026. https://www.epa.gov/energy/greenhouse-gases-equivalencies-calculator-calculations-and-references