Training and inferenceEntraînement et inférence
TRA6008 S3 · in classS3 · en classe
Two costs, at different times
The environmental cost of a language model language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. is usually stated as a carbon footprint, in grams or tonnes of CO2 equivalent.
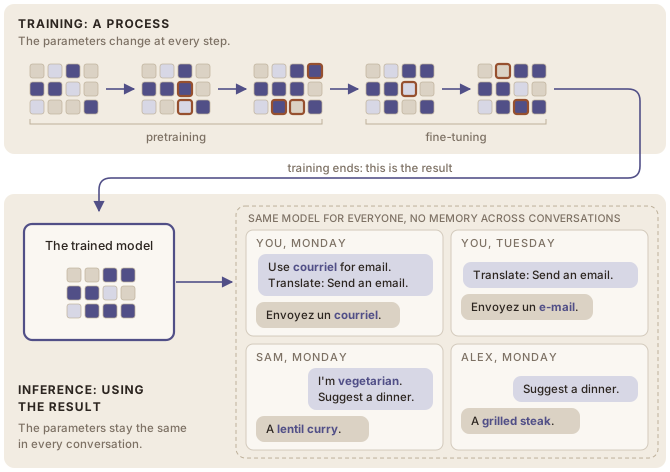
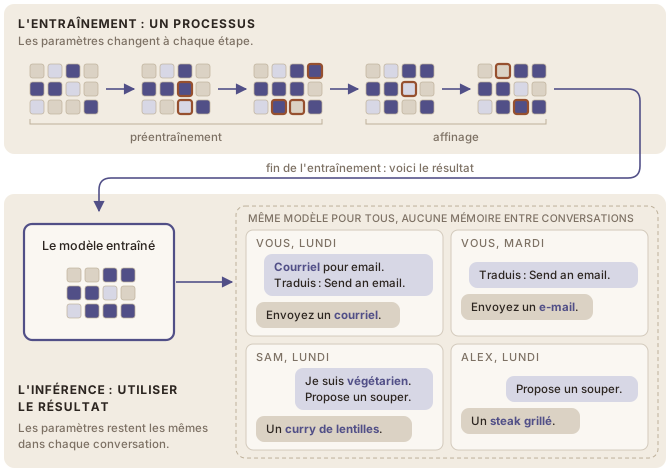
A language model causes emissions at two different times: once when it is trained, and again every time someone uses it. As a reminder, training adjusts the model’s parameters parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. step by step until the model is finished (see also the Pretraining chapter, in the LLM lifecycle module) (voir aussi le chapitre Préentraînement, dans le module Cycle de vie des GML), and inference inferenceinférence machine learningapprentissage automatique The stage in which a trained AI model processes new input to produce a prediction, classification, decision, or generated output.Étape au cours de laquelle un modèle d'IA entraîné traite une nouvelle entrée pour produire une prédiction, une classification, une décision ou une sortie générée. is the use of that finished model, whose parameters no longer change (Figure 2figure 2, reused from the inference chapter) (see also the Inference page, in the LLM lifecycle module) (voir aussi la page Inférence, dans le module Cycle de vie des GML).
How the two costs add up
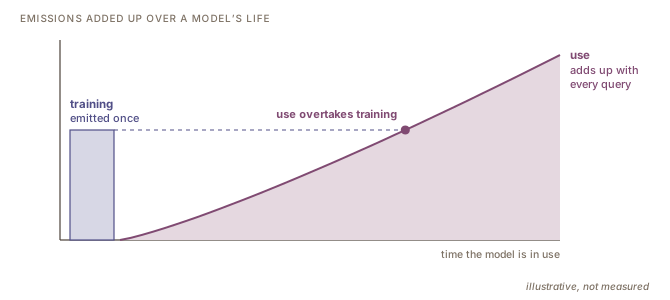
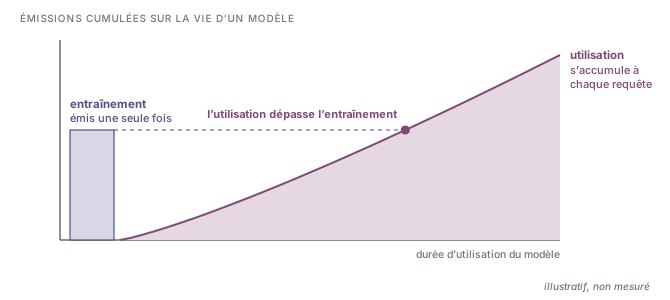
Training and use add up differently (Figure 3figure 3):
- Training emits once, before anyone uses the model, and declining to use the model does not undo those emissions. Divided among everyone who uses a widely used model, the share that falls on any one use is small: Masley (2026d) puts GPT-4’s training, divided among its 100 to 200 million weekly users, at about 75 to 150 grams of CO2 each, about what manufacturing a single CD emits.
- Use adds a little with every query. One query emits very little, but a widely used model answers a great many: ChatGPT alone was reported to receive about 2.5 billion prompts promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. a day in mid-2025 (International Energy Agency, 2026, p. 32). Across all users, use now outweighs training.
The International Energy Agency states the same for AI as a whole:
“The balance of AI-related energy consumption has already shifted decisively from training to inference” (International Energy Agency, 2026, p. 30).
Figures for one model
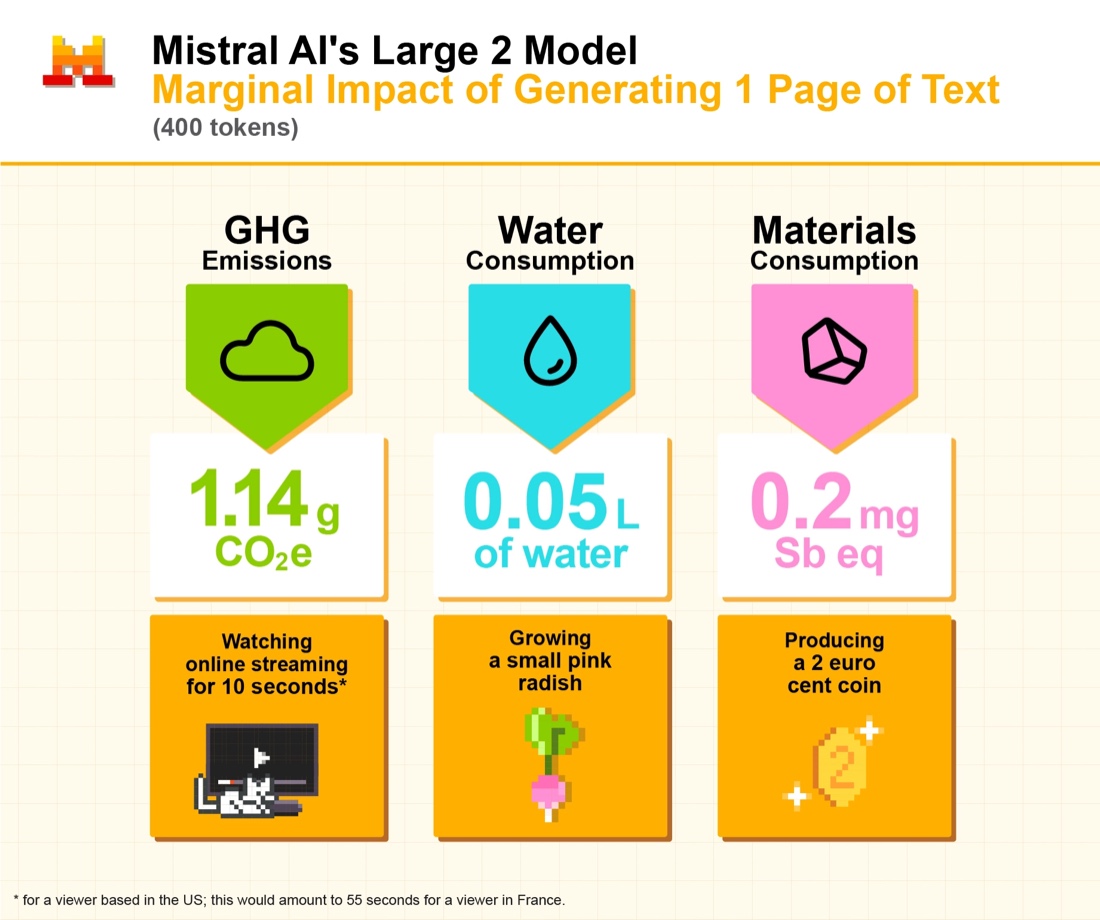
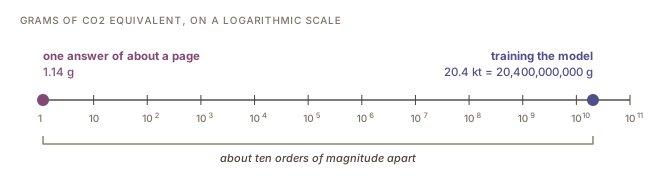
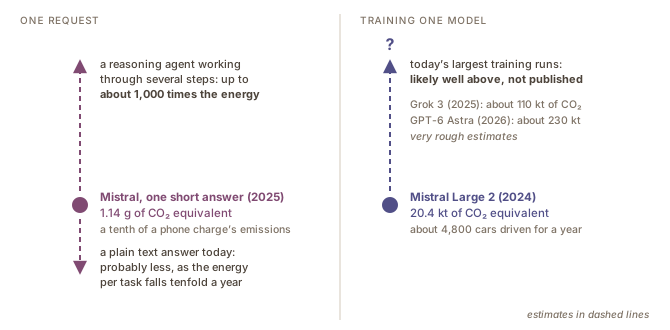
Mistral published figures for both costs of its Mistral Large 2 model (Mistral AI, 2025). For what it calls “the environmental footprint of training”, it reports 20.4 kilotonnes of CO2 equivalent (ktCO2e) and 281,000 cubic metres of water, “as of January 2025, and after 18 months of usage”. For one use of its chat assistant, a response of 400 tokens token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. (roughly a page), it reports 1.14 grams of CO2 equivalent and 45 millilitres of water. Both figures include the manufacture of the servers, not only the electricity, and the figure for one response leaves out the user’s own device.Mistral’s announcement does not say how the 18 months of usage enter the training figure; its results were to be published in the Base Empreinte database of ADEME, the French ecological transition agency.
Mistral’s own infographic puts one such answer in everyday terms, with comparisons of the company’s choosing (Figure 4figure 4).
By the yardsticks of the U.S. Environmental Protection Agency (2026), the training figure is about what 4,800 gasoline cars emit in a year of driving, and one answer is about a tenth of what charging a smartphone emits on the US grid.
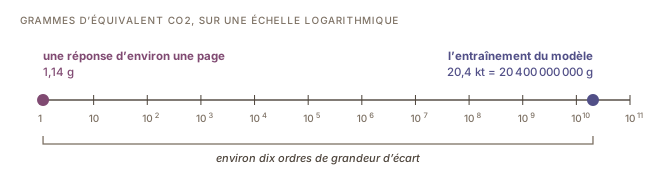
Mistral’s two figures are about ten orders of magnitude apart (Figure 5figure 5).
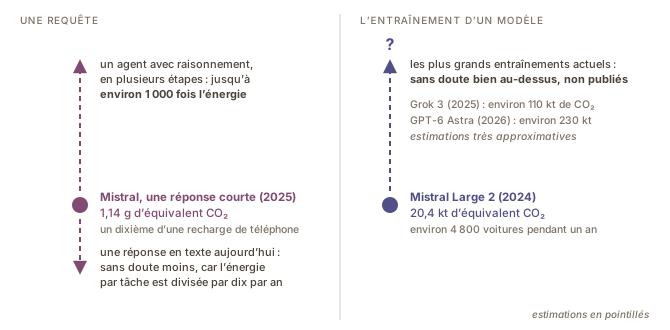
Both figures describe a model released in 2024, of 123 billion parameters according to Epoch AI (2026), and one short text answer (Figure 6figure 6). The largest training runs since then are far bigger: by a very rough estimate, training Grok 3 emitted about 110 kilotonnes of CO2 and GPT-6 Astra about 230, some five and eleven times Mistral’s figure.Epoch AI (2026) estimates that Grok 3 was trained on about 80,000 GPUs graphics processing unit (GPU)processeur graphique (GPU) computinginformatique A processor with a large number of cores that work in parallel, designed to render images, and now the standard hardware for training and running neural networks.Processeur doté d'un grand nombre de cœurs fonctionnant en parallèle, conçu pour produire des images, et devenu le matériel de référence pour entraîner et faire fonctionner des réseaux de neurones. drawing about 110 megawatts for about 90 days, and that the run behind GPT-6 Astra drew about 230 megawatts, for a duration it does not give. My calculation assumes 90 days for both and the world-average grid, about 460 grams of CO2 per kilowatt-hour (International Energy Agency, 2025, p. 78): about 240 gigawatt-hours and 110 kilotonnes for Grok 3, about 500 gigawatt-hours and 230 kilotonnes for GPT-6 Astra. Both count electricity only, where Mistral’s figure also counts manufacturing. For Grok 4, run largely on gas turbines, Masley (2026d) cites an Epoch AI estimate of about 310 gigawatt-hours and 154,000 tonnes of CO2, the same order of magnitude. No provider has published the emissions of a run that size, so Mistral’s training figure is likely well below that of today’s largest models. For a plain text answer, the figure is probably on the high side today, since the energy per task has been falling by at least an order of magnitude a year (International Energy Agency, 2026, p. 8). One request, however, can now mean a reasoning model reasoning modelmodèle de raisonnement language modelsmodèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference.Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. or an agent AI agentagent agentsagents An AI system that selects and carries out actions toward a goal, often by using tools or calling other programs and adapting later actions to the results it receives.Système d'IA qui choisit et exécute des actions en vue d'un but, souvent en utilisant des outils ou en appelant d'autres programmes et en adaptant ses actions ultérieures aux résultats reçus. working through many steps, which uses far more than a page of plain text (see also the What one use costs page) (voir aussi la page Ce que coûte une utilisation).
Deux coûts, à deux moments
Le coût environnemental d’un modèle de langue language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. s’exprime généralement sous forme d’empreinte carbone, en grammes ou en tonnes d’équivalent CO2.
Un modèle de langue cause des émissions à deux moments : une fois lors de son entraînement, puis chaque fois que quelqu’un l’utilise. Pour rappel, l’entraînement ajuste les paramètres parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle pas à pas jusqu’à ce que le modèle soit terminé (see also the Pretraining chapter, in the LLM lifecycle module) (voir aussi le chapitre Préentraînement, dans le module Cycle de vie des GML), et l’inférence inferenceinférence machine learningapprentissage automatique The stage in which a trained AI model processes new input to produce a prediction, classification, decision, or generated output.Étape au cours de laquelle un modèle d'IA entraîné traite une nouvelle entrée pour produire une prédiction, une classification, une décision ou une sortie générée. est l’utilisation de ce modèle terminé, dont les paramètres ne changent plus (Figure 2figure 2, reprise du chapitre sur l’inférence) (see also the Inference page, in the LLM lifecycle module) (voir aussi la page Inférence, dans le module Cycle de vie des GML).
Comment les deux coûts s’additionnent
L’entraînement et l’utilisation s’additionnent différemment (Figure 3figure 3) :
- L’entraînement émet une seule fois, avant que quiconque utilise le modèle, et renoncer à utiliser le modèle n’annule pas ces émissions. Répartie entre toutes les personnes qui utilisent un modèle très répandu, la part qui revient à chaque utilisation est faible : Masley (2026d) estime l’entraînement de GPT-4, réparti entre ses 100 à 200 millions d’utilisateurs hebdomadaires, à environ 75 à 150 grammes de CO2 chacun, à peu près ce qu’émet la fabrication d’un seul CD.
- L’utilisation ajoute un peu à chaque requête. Une requête émet très peu, mais un modèle très répandu en reçoit énormément : ChatGPT à lui seul aurait reçu environ 2,5 milliards de requêtes promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. par jour à la mi-2025 (International Energy Agency, 2026, p. 32). Tous utilisateurs confondus, l’utilisation dépasse désormais l’entraînement.
L’Agence internationale de l’énergie (AIE) dit la même chose pour l’IA dans son ensemble :
« The balance of AI-related energy consumption has already shifted decisively from training to inference » [ma traduction : « L’équilibre de la consommation d’énergie liée à l’IA s’est déjà nettement déplacé de l’entraînement vers l’inférence »] (International Energy Agency, 2026, p. 30).
Les chiffres d’un modèle
Mistral a publié des chiffres pour les deux coûts de son modèle Mistral Large 2 (Mistral AI, 2025). Pour ce qu’il appelle « the environmental footprint of training » [ma traduction : « l’empreinte environnementale de l’entraînement »], il déclare 20,4 kilotonnes d’équivalent CO2 (kt éq. CO2) et 281 000 mètres cubes d’eau, « as of January 2025, and after 18 months of usage » [ma traduction : « en janvier 2025, après 18 mois d’utilisation »]. Pour une utilisation de son assistant conversationnel, une réponse de 400 jetons token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. (environ une page), il déclare 1,14 gramme d’équivalent CO2 et 45 millilitres d’eau. Les deux chiffres incluent la fabrication des serveurs, pas seulement l’électricité, et le chiffre d’une réponse exclut l’appareil de l’utilisateur.L’annonce de Mistral ne précise pas comment les 18 mois d’utilisation entrent dans le chiffre de l’entraînement ; ses résultats devaient être publiés dans la Base Empreinte de l’ADEME, l’Agence de la transition écologique en France.
L’infographie de Mistral traduit une telle réponse en termes du quotidien, avec des comparaisons choisies par l’entreprise (Figure 4figure 4).
Selon les équivalences de l’agence américaine de protection de l’environnement (U.S. Environmental Protection Agency, 2026), le chiffre de l’entraînement correspond à peu près à ce qu’émettent 4 800 voitures à essence en un an, et une réponse à environ un dixième de ce qu’émet la recharge d’un téléphone intelligent sur le réseau américain.
Les deux chiffres de Mistral sont séparés d’environ dix ordres de grandeur (Figure 5figure 5).
Les deux chiffres décrivent un modèle sorti en 2024, de 123 milliards de paramètres selon Epoch AI (2026), et une courte réponse en texte (Figure 6figure 6). Les plus grands entraînements depuis sont bien plus importants : selon une estimation très approximative, l’entraînement de Grok 3 a émis environ 110 kilotonnes de CO2 et celui de GPT-6 Astra environ 230, soit cinq et onze fois le chiffre de Mistral.Epoch AI (2026) estime que Grok 3 a été entraîné sur environ 80 000 processeurs graphiques (GPU) graphics processing unit (GPU)processeur graphique (GPU) computinginformatique A processor with a large number of cores that work in parallel, designed to render images, and now the standard hardware for training and running neural networks.Processeur doté d'un grand nombre de cœurs fonctionnant en parallèle, conçu pour produire des images, et devenu le matériel de référence pour entraîner et faire fonctionner des réseaux de neurones. consommant environ 110 mégawatts pendant environ 90 jours, et que l’entraînement de GPT-6 Astra a consommé environ 230 mégawatts, pour une durée qu’il ne précise pas. Mon calcul suppose 90 jours pour les deux et le réseau mondial moyen, environ 460 grammes de CO2 par kilowattheure (International Energy Agency, 2025, p. 78) : environ 240 gigawattheures et 110 kilotonnes pour Grok 3, environ 500 gigawattheures et 230 kilotonnes pour GPT-6 Astra. Les deux ne comptent que l’électricité, alors que le chiffre de Mistral compte aussi la fabrication. Pour Grok 4, alimenté en grande partie par des turbines à gaz, Masley (2026d) cite une estimation d’Epoch AI d’environ 310 gigawattheures et 154 000 tonnes de CO2, du même ordre de grandeur. Aucun fournisseur n’a publié les émissions d’un entraînement de cette taille, si bien que le chiffre de Mistral pour l’entraînement est sans doute bien en dessous de celui des plus grands modèles actuels. Pour une réponse en texte seul, le chiffre est probablement élevé pour aujourd’hui, puisque l’énergie par tâche baisse d’au moins un ordre de grandeur par an (International Energy Agency, 2026, p. 8). Une requête peut toutefois désormais faire intervenir un modèle de raisonnement reasoning modelmodèle de raisonnement language modelsmodèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference.Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. ou un agent AI agentagent agentsagents An AI system that selects and carries out actions toward a goal, often by using tools or calling other programs and adapting later actions to the results it receives.Système d'IA qui choisit et exécute des actions en vue d'un but, souvent en utilisant des outils ou en appelant d'autres programmes et en adaptant ses actions ultérieures aux résultats reçus. qui passe par de nombreuses étapes, ce qui consomme bien plus qu’une page de texte seul (see also the What one use costs page) (voir aussi la page Ce que coûte une utilisation).
Sources
- Epoch AI (2026). Data on AI models. Online database, CC BY, epoch.ai (retrieved 9 September 2026). https://epoch.ai/data/ai-models
- International Energy Agency (2025). Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/energy-and-ai
- International Energy Agency (2026). Key Questions on Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/key-questions-on-energy-and-ai
- International Organization for Standardization (n.d.). Carbon footprint: Measuring and reducing our environmental impact. ISO. https://www.iso.org/renewable-energy/carbon-footprint
- Masley, A. (2026d). Training AI models doesn't emit that much. andymasley.com, 12 April 2026. https://andymasley.com/writing/training-ai-models-doesnt-emit-that/
- Mistral AI (2025). Our contribution to a global environmental standard for AI. Mistral AI, 22 July 2025. https://mistral.ai/news/our-contribution-to-a-global-environmental-standard-for-ai
- U.S. Environmental Protection Agency (2026). Greenhouse Gas Equivalencies Calculator - Calculations and References. U.S. Environmental Protection Agency, last updated 4 August 2026. https://www.epa.gov/energy/greenhouse-gases-equivalencies-calculator-calculations-and-references
Sources
- Epoch AI (2026). Data on AI models. Online database, CC BY, epoch.ai (retrieved 9 septembre 2026). https://epoch.ai/data/ai-models
- International Energy Agency (2025). Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/energy-and-ai
- International Energy Agency (2026). Key Questions on Energy and AI. International Energy Agency, Paris. https://www.iea.org/reports/key-questions-on-energy-and-ai
- International Organization for Standardization (n.d.). Carbon footprint: Measuring and reducing our environmental impact. ISO. https://www.iso.org/renewable-energy/carbon-footprint
- Masley, A. (2026d). Training AI models doesn't emit that much. andymasley.com, 12 avril 2026. https://andymasley.com/writing/training-ai-models-doesnt-emit-that/
- Mistral AI (2025). Our contribution to a global environmental standard for AI. Mistral AI, 22 juillet 2025. https://mistral.ai/news/our-contribution-to-a-global-environmental-standard-for-ai
- U.S. Environmental Protection Agency (2026). Greenhouse Gas Equivalencies Calculator - Calculations and References. U.S. Environmental Protection Agency, last updated 4 août 2026. https://www.epa.gov/energy/greenhouse-gases-equivalencies-calculator-calculations-and-references