Comment la mémoire se remplitComment la mémoire se remplit
TRA2600 S1 · in classS1 · en classe
Au premier projet, elle est vide
Au premier projet, la mémoire est vide : elle ne peut rien proposer tant que vous n’y avez rien mis. Elle se remplit à mesure que vous validez des segments, et par alignement de documents déjà traduits.
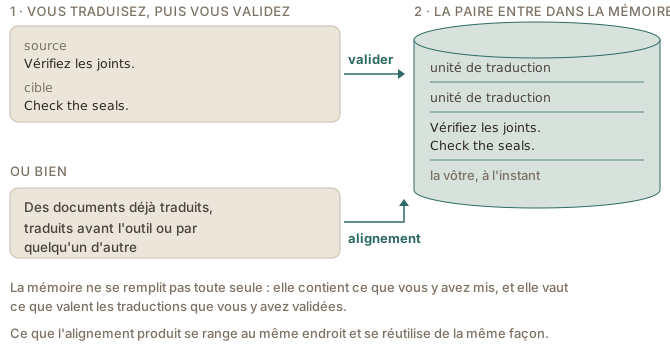
En traduisant
Vous traduisez un segment, vous le validez, et la paire entre dans la mémoire comme unité de traduction. Sur un document où les phrases se ressemblent, cela se voit vite : quelques segments validés suffisent pour que l’outil commence à en reproposer.
Valider un segment et passer au segment suivant sont deux actions différentes : cliquer sur la ligne d’en dessous vous déplace sans rien enregistrer, et seule la validation écrit dans la mémoire.
À partir de traductions existantes
Une mémoire peut aussi être remplie d’un coup, par alignement alignment²alignement CAT toolsTAO The process of pairing a source text with an existing translation of it, segment by segment, so that the pairs can be stored as translation units in a translation memory.Opération qui consiste à apparier un texte source et une traduction déjà existante de ce texte, segment par segment, afin d'en stocker les paires comme unités de traduction dans une mémoire de traduction. : l’opération apparie un texte source et sa traduction, segment par segment, et produit des unités de traduction qui se rangent dans la mémoire comme les autres.
Ce qu’on aligne : vos traductions antérieures, celles d’un collègue, les documents bilingues d’un client (see also the Wordfast: alignment chapter) (voir aussi le chapitre Wordfast : alignement).
Ce qu’une erreur validée vous coûte
Une mémoire contient ce qu’on y a mis, y compris les erreurs. Une traduction que vous validez aujourd’hui peut ressortir dans des mois, parfois dans des années, sur un projet dont vous ne savez encore rien. Et devant une correspondance à 100 % exact matchcorrespondance exacte CAT toolsTAO A translation-memory match in which the stored source segment is identical to the segment being translated, character for character, so the tool can insert the stored translation as it is.Correspondance de mémoire de traduction dans laquelle le segment source stocké est identique, caractère pour caractère, au segment à traduire, de sorte que l'outil peut insérer la traduction stockée telle quelle. , on relit moins : l’affichage donne à la proposition une autorité qu’elle n’a pas toujours méritée.
Une erreur validée coûte donc deux fois plutôt qu’une : au moment où elle passe, puis chaque fois qu’elle revient et qu’on la reconfirme sans la relire.
Ce que devient la cohérence
Le désordre ne vient pas que des erreurs. Une mémoire perd aussi sa cohérence à mesure qu’elle grossit. Sur quatre mémoires d’entreprise réelles, de 22 000 à 300 000 unités de traduction (Moorkens, 2011) :
- des segments qui ne diffèrent que par une majuscule, une espace, une ponctuation ou une balise inline tagbalise interne CAT toolsTAO A marker inside a segment standing for formatting or a code of the original document, a bold run or a footnote reference for instance, rather than for text to translate.Marqueur placé à l'intérieur d'un segment qui représente une mise en forme ou un code du document d'origine, par exemple un passage en gras ou un appel de note, et non du texte à traduire. avaient reçu des traductions franchement divergentes, à des années d’intervalle ;
- la différence la plus fréquente entre deux segments presque identiques était une simple majuscule.
Chacune de ces traductions pouvait être juste dans son projet. C’est leur coexistence dans une même mémoire qui pose problème, puisque l’outil les propose ensuite indifféremment.
Deux conséquences, dès maintenant
- Corrigez la mémoire, pas seulement le segment. Quand une proposition ne convient pas parce que ce qui est enregistré est fautif, corrigez la mémoire tout de suite si l’outil vous le permet, sinon notez-le très clairement. Corriger seulement le segment du projet en cours laisse l’erreur en place pour le projet suivant.
- Gardez des mémoires séparées quand les projets n’ont rien à voir : les phrases d’un client de machinerie n’ont aucune raison de ressortir dans une traduction juridique.
L’entretien courant
Le reste est de l’entretien : repérer les doublons, retirer les segments dépassés, corriger les découpages ratés. Un doublon apparent n’en est pas toujours un : deux unités identiques peuvent venir de deux endroits différents, et l’outil les garde séparées parce que leurs voisines diffèrent, ce qui est la condition d’une correspondance en contexte context matchcorrespondance en contexte CAT toolsTAO A translation-memory match in which the stored source segment is identical to the segment being translated and the segments around it match as well, so the stored translation was produced in the same surroundings.Correspondance de mémoire de traduction dans laquelle le segment source stocké est identique au segment à traduire et où les segments voisins correspondent également, de sorte que la traduction stockée a été produite dans le même entourage. . Cela se fait dans l’écran de gestion des mémoires (see also the Wordfast: alignment chapter) (voir aussi le chapitre Wordfast : alignement).
This page is only available in French.
Sources
- Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
- Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
- Moorkens, J. (2011). Translation memories guarantee consistency: Truth or fiction?. Proceedings of Translating and the Computer 33 (Aslib). https://aclanthology.org/2011.tc-1.17/