Term extraction as a taskL'extraction de termes comme tâche
TRA2600 S8 · in classS8 · en classe
TRA6008 To read for S5À lire pour la S5
Why extract terms
A list of the terms in a set of texts is useful in several kinds of work, for instance:
- for a translator, the terms in a client’s earlier documents show the terminology that client uses;
- the terms in a text you are about to translate can be looked up and settled in one go before you start, where you would otherwise stop to research each term as you come to it;
- outside translation, the terms in a company’s manuals are the starting point for a glossary for new staff, and the terms in a book for its index.
Marking those terms by hand is slow, and the result depends on the person doing it. Termbases do not solve the problem either: new terms appear all the time, and a termbase termbasebase terminologique terminologyterminologie A database of terminological entries organized by concept, grouping the terms of several languages with metadata such as definitions, domains and usage status.Base de données d'entrées terminologiques organisée par concept, contenant les termes de plusieurs langues et des métadonnées comme des définitions, des domaines et des marques d'usage. for your domain and your language pair may simply not exist. Many translators therefore build their own lists of terms from the texts they work on (Lefever & Rigouts Terryn, 2024).
From a text to candidate terms
Having a program find the terms in a text, or in a collection of texts on one subject, is called automatic term extraction.
No method is flawless, which is why the program’s output is called a list of candidates (Lefever & Rigouts Terryn, 2024).
The input is usually a specialized corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. , a collection of texts about one domain. Some methods need a large one, because they rely on how often words occur; others work on a single document or even a single sentence (Rigouts Terryn et al., 2022a).
Two forms of output
A term extractor can return its candidate terms in two forms (Figure 6figure 6):
- A list. Each candidate appears once, however often it occurs, usually ranked by a score that estimates how likely it is to be a term. The person who validates the list decides where to stop reading it (Rigouts Terryn et al., 2019).
- The terms in the text. Every occurrence is marked where it appears, the way a person highlights terms in a document (Lefever & Rigouts Terryn, 2024). The same word can then be marked in one sentence and left unmarked in another, where it has its everyday sense (Rigouts Terryn, 2021a).
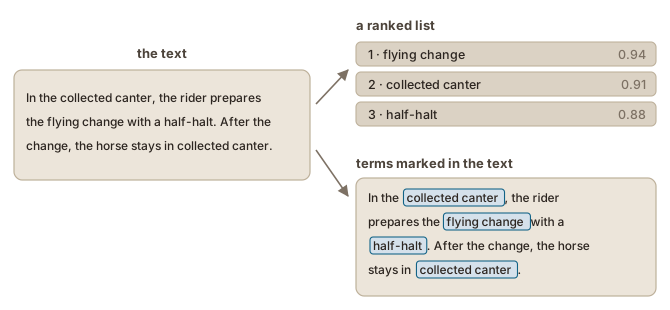
The two forms are also checked differently: a list is compared with another list, and marked text occurrence by occurrence (see also the Matching rules page, in the Evaluating language technology module) (voir aussi la page Les règles de correspondance, dans le module L'évaluation des technologies langagières).
Making the notion of a term measurable
Finding all the terms in a long text is slow and repetitive, which makes it a typical task to hand over to a computer. Before large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. , however, you could not simply tell a program to find the terms in a text. A program works with what it can count or check in the text itself, and the definition of a term, a word or group of words that names a concept in a specialized domain, gives it nothing of that kind.
The challenge was therefore to translate the human notion of a term into characteristics that a program can measure. Each method in this chapter is one answer to that challenge, and each answer is imperfect in its own way.
Three families of methods
Methods for term extraction fall into three broad families, but the older ones are still in use: tools built on rules remain competitive with machine learning machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. (Lefever & Rigouts Terryn, 2024). The table below sets the three side by side.
| Family | What it relies on | Example |
|---|---|---|
| Rule-based | Patterns of parts of speech, frequencies in a specialized corpus compared with a general one, or both combined | TermoStat |
| Supervised machine learning | Examples of terms marked by people, from which a model learns what a term looks like | HAMLET, D-Terminer |
| Large language models | A prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. describing what to extract, and the model’s training on very large amounts of text | A chatbot asked for the terms in a text |
Pourquoi extraire des termes
La liste des termes d’un ensemble de textes est utile dans plusieurs types de travail, par exemple :
- pour un traducteur, les termes des documents antérieurs d’un client montrent la terminologie que ce client emploie ;
- les termes d’un texte que vous allez traduire peuvent être cherchés et fixés en une fois avant de commencer, au lieu de vous arrêter pour chercher chaque terme au moment où vous le rencontrez ;
- en dehors de la traduction, les termes des manuels d’une entreprise sont le point de départ d’un glossaire pour le nouveau personnel, et les termes d’un livre, celui de son index.
Repérer ces termes à la main est lent, et le résultat dépend de la personne qui s’en charge. Les bases terminologiques ne règlent pas le problème non plus : de nouveaux termes apparaissent sans cesse, et une base terminologique termbasebase terminologique terminologyterminologie A database of terminological entries organized by concept, grouping the terms of several languages with metadata such as definitions, domains and usage status.Base de données d'entrées terminologiques organisée par concept, contenant les termes de plusieurs langues et des métadonnées comme des définitions, des domaines et des marques d'usage. pour votre domaine et votre paire de langues n’existe peut-être tout simplement pas. Beaucoup de traducteurs construisent donc leurs propres listes de termes à partir des textes sur lesquels ils travaillent (Lefever et Rigouts Terryn, 2024).
Du texte aux candidats terminologiques
Faire repérer par un programme les termes d’un texte, ou d’un ensemble de textes sur un même sujet, s’appelle l’extraction automatique de termes.
Aucune méthode n’est sans défaut, et c’est pourquoi le résultat du programme s’appelle une liste de candidats (Lefever et Rigouts Terryn, 2024).
L’entrée est le plus souvent un corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. spécialisé, c’est-à-dire un ensemble de textes sur un même domaine. Certaines méthodes en demandent un grand, parce qu’elles reposent sur la fréquence des mots ; d’autres fonctionnent sur un seul document, voire une seule phrase (Rigouts Terryn et al., 2022a).
Deux formes de résultat
Un extracteur de termes peut renvoyer ses candidats terminologiques sous deux formes (Figure 6figure 6) :
- Une liste. Chaque candidat y figure une fois, quel que soit son nombre d’occurrences, le plus souvent classé selon un score qui estime la probabilité qu’il soit un terme. La personne qui valide la liste décide où arrêter sa lecture (Rigouts Terryn et al., 2019).
- Les termes dans le texte. Chaque occurrence est marquée là où elle apparaît, comme lorsqu’on surligne les termes d’un document (Lefever et Rigouts Terryn, 2024). Le même mot peut alors être marqué dans une phrase et ne pas l’être dans une autre, où il a son sens courant (Rigouts Terryn, 2021a).
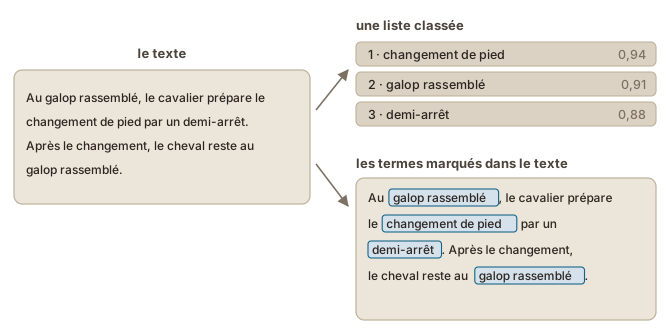
Les deux formes ne se vérifient pas non plus de la même façon : une liste se compare à une autre liste, et un texte marqué se compare occurrence par occurrence (see also the Matching rules page, in the Evaluating language technology module) (voir aussi la page Les règles de correspondance, dans le module L'évaluation des technologies langagières).
Rendre mesurable la notion de terme
Repérer tous les termes d’un long texte est lent et répétitif, ce qui en fait une tâche typique à confier à un ordinateur. Avant les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML), cependant, il n’était pas possible de simplement demander à un programme de trouver les termes d’un texte. Un programme travaille avec ce qu’il peut compter ou vérifier dans le texte lui-même, et la définition du terme, un mot ou un groupe de mots qui désigne un concept dans un domaine spécialisé, ne lui donne rien de tel.
Le défi consistait donc à traduire la notion humaine de terme en caractéristiques qu’un programme peut mesurer. Chaque méthode de ce chapitre est une réponse à ce défi, et chaque réponse est imparfaite à sa manière.
Trois familles de méthodes
Les méthodes d’extraction de termes se répartissent en trois grandes familles, mais les plus anciennes servent toujours : les outils à base de règles restent compétitifs face à l’apprentissage automatique machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. (Lefever et Rigouts Terryn, 2024). Le tableau ci-dessous présente les trois côte à côte.
| Famille | Sur quoi elle repose | Exemple |
|---|---|---|
| À base de règles | Des patrons de parties du discours, des fréquences dans un corpus spécialisé comparées à celles d’un corpus général, ou les deux combinés | TermoStat |
| Apprentissage automatique supervisé | Des exemples de termes annotés par des personnes, à partir desquels un modèle apprend à quoi ressemble un terme | HAMLET, D-Terminer |
| Grands modèles de langue | Une requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. qui décrit ce qu’il faut extraire, et l’entraînement du modèle sur de très grandes quantités de texte | Un agent conversationnel à qui l’on demande les termes d’un texte |
Sources
- Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
- Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
- Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/