Terms in two languagesLes termes dans deux langues
TRA2600 S8 · in classS8 · en classe
TRA6008 OptionalFacultatif
Bilingual term extraction
For a translator, a list of terms in one language is only half of the job. The other half is the equivalent in the target language. When translations already exist, for instance in a translation memory translation memory (TM)mémoire de traduction (MT) CAT toolsTAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text.Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. , the equivalents are in there, sentence by sentence.
Bilingual extraction from parallel texts has long worked through the alignment of the two sides: candidates are taken from words and phrases that the alignment links, then filtered on their frequencies (Lefever et al., 2009; Macken et al., 2013). D-Terminer’s bilingual mode works in two steps (Rigouts Terryn et al., 2022a):
- Monolingual extraction in each language. The terms are extracted separately from the source sentences and from the target sentences.
- Alignment. The words of each pair of aligned sentences are linked, and each source candidate gets a ranked list of target candidates that appear in the same sentences, with a score for how reliably they correspond (Figure 22figure 22).
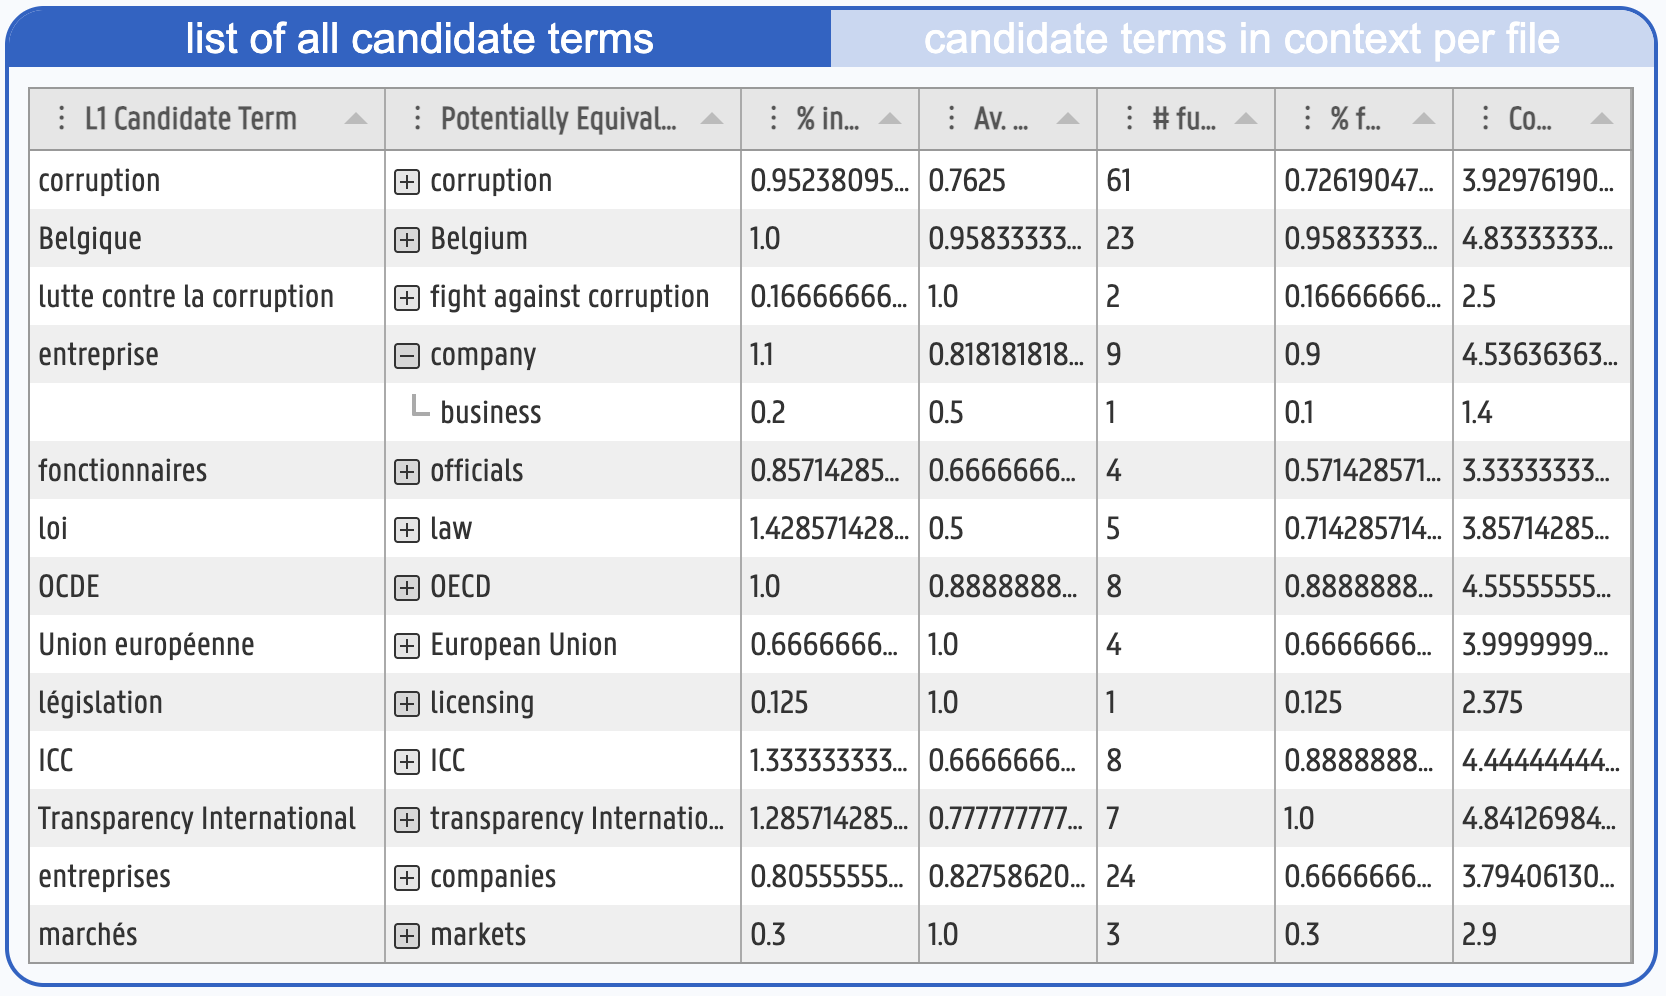
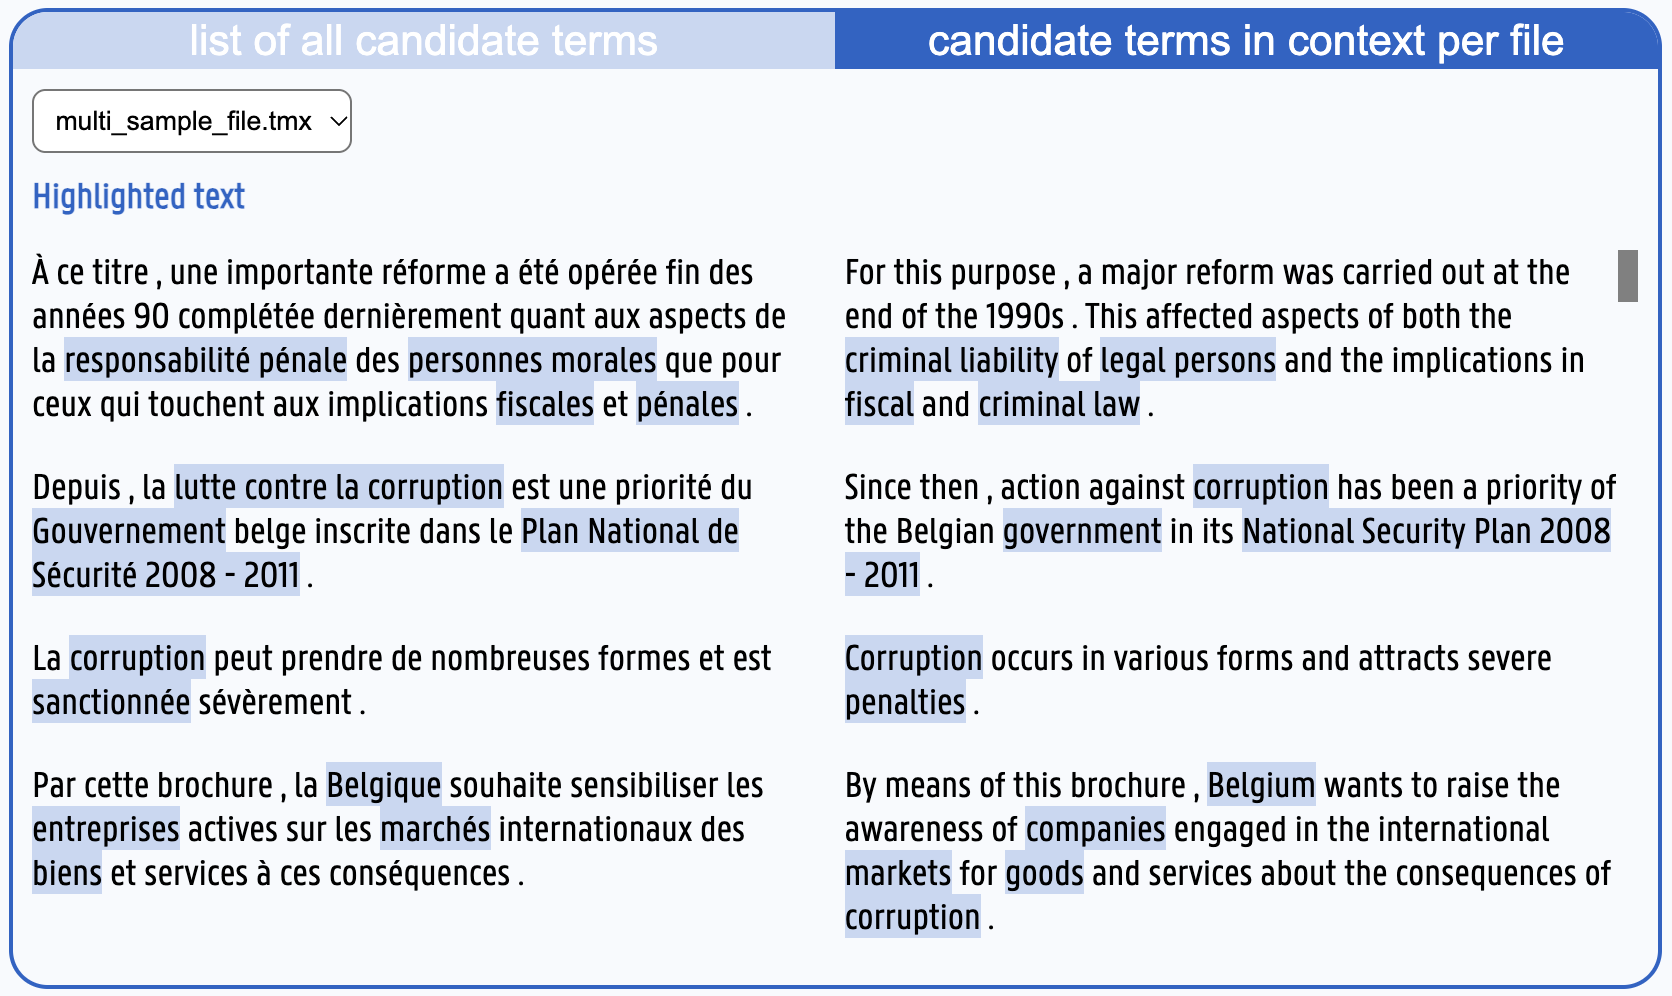
The demo shows the result in two views, on its own sample of French and English texts about corruption. In the list (Figure 23figure 23), each French candidate has one or more English candidates with their scores: entreprise has company first and business second. Some pairs need checking, such as législation with licensing. In the context view (Figure 24figure 24), the candidates are marked in the aligned sentences of both languages.
In an evaluation of this bilingual mode on English and Dutch texts about corruption, the first target candidate was a correct equivalent for about three source candidates in four (Rigouts Terryn et al., 2022a).
Causes of missing equivalents
The most common cause of a missing equivalent was the first step: the equivalent had never been extracted in the target language (Rigouts Terryn et al., 2022a). Languages build terms differently:
- Compounds. Dutch writes many terms as one word where English writes several, as in standaardclausules for standard clauses, so a unit extracted in one language may not be extracted in the other.
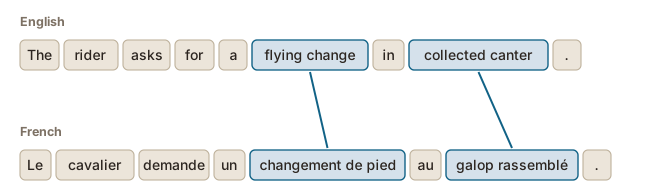
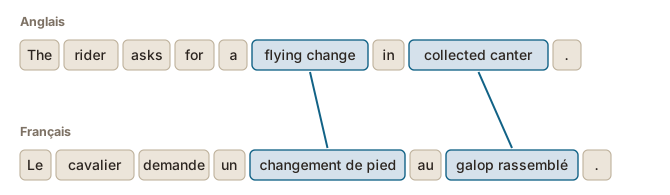
- Word order. The words of a term do not come in the same order in both languages, as in galop rassemblé for collected canter.
- Different formulations. A translator may use a noun in one language and a verb in the other, or a paraphrase instead of a term, and then the text offers no equivalent to extract.
Parallel and comparable corpora
A parallel corpus parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. contains translations, aligned sentence by sentence. Most specialized texts do not come with a translation, and a comparable corpus comparable corpuscorpus comparable corporacorpus A corpus containing texts in two or more languages (or language varieties) matched on subject, genre or communicative function, whose components are typically written originally in each language rather than translated: press articles written independently in French and in English on the same events, for instance.Corpus réunissant des textes en deux ou plusieurs langues (ou variétés de langue) appariés par sujet, genre ou fonction de communication, et dont les composantes sont généralement rédigées à l'origine dans chaque langue plutôt que traduites : par exemple des articles de presse rédigés indépendamment en français et en anglais sur les mêmes événements. , texts on the same subject written separately in each language, is often all there is. Of the four ACTER domains, all have comparable corpora in English, French and Dutch, and only corruption also has a parallel corpus (Rigouts Terryn et al., 2020a). In comparable texts, no sentence of one language corresponds to a sentence of the other, so the alignment step has nothing to work from, and finding equivalents becomes a harder problem.
L’extraction bilingue de termes
Pour une traductrice ou un traducteur, une liste de termes dans une seule langue n’est que la moitié du travail. L’autre moitié est l’équivalent dans la langue cible. Quand des traductions existent déjà, par exemple dans une mémoire de traduction translation memory (TM)mémoire de traduction (MT) CAT toolsTAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text.Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. , les équivalents s’y trouvent, phrase par phrase.
L’extraction bilingue à partir de textes parallèles passe depuis longtemps par l’alignement des deux côtés : les candidats sont tirés des mots et des groupes de mots que l’alignement relie, puis filtrés selon leurs fréquences (Lefever et al., 2009 ; Macken et al., 2013). Le mode bilingue de D-Terminer procède en deux étapes (Rigouts Terryn et al., 2022a) :
- L’extraction monolingue dans chaque langue. Les termes sont extraits séparément des phrases sources et des phrases cibles.
- L’alignement. Les mots de chaque paire de phrases alignées sont reliés, et chaque candidat source reçoit une liste classée de candidats cibles qui apparaissent dans les mêmes phrases, avec un score qui indique la fiabilité de la correspondance (Figure 22figure 22).
La démonstration présente le résultat dans deux vues, sur son propre échantillon de textes français et anglais sur la corruption. Dans la liste (Figure 23figure 23), chaque candidat français a un ou plusieurs candidats anglais avec leurs scores : entreprise a d’abord company, puis business. Certaines paires sont à vérifier, comme législation avec licensing. Dans la vue en contexte (Figure 24figure 24), les candidats sont marqués dans les phrases alignées des deux langues.
Dans une évaluation de ce mode bilingue sur des textes anglais et néerlandais sur la corruption, le premier candidat cible était un équivalent correct pour environ trois candidats sources sur quatre (Rigouts Terryn et al., 2022a).
Les causes des équivalents manquants
La cause la plus fréquente d’un équivalent manquant était la première étape : l’équivalent n’avait jamais été extrait dans la langue cible (Rigouts Terryn et al., 2022a). Les langues ne construisent pas leurs termes de la même façon :
- Les mots composés. Le néerlandais écrit en un seul mot beaucoup de termes que l’anglais écrit en plusieurs, comme standaardclausules pour standard clauses, si bien qu’une unité extraite dans une langue ne l’est pas forcément dans l’autre.
- L’ordre des mots. Les mots d’un terme ne viennent pas dans le même ordre dans les deux langues, comme dans collected canter pour galop rassemblé.
- Les formulations différentes. Une traduction peut employer un nom dans une langue et un verbe dans l’autre, ou une paraphrase à la place d’un terme, et le texte n’offre alors aucun équivalent à extraire.
Les corpus parallèles et les corpus comparables
Un corpus parallèle parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. contient des traductions, alignées phrase par phrase. La plupart des textes spécialisés n’ont pas de traduction, et un corpus comparable comparable corpuscorpus comparable corporacorpus A corpus containing texts in two or more languages (or language varieties) matched on subject, genre or communicative function, whose components are typically written originally in each language rather than translated: press articles written independently in French and in English on the same events, for instance.Corpus réunissant des textes en deux ou plusieurs langues (ou variétés de langue) appariés par sujet, genre ou fonction de communication, et dont les composantes sont généralement rédigées à l'origine dans chaque langue plutôt que traduites : par exemple des articles de presse rédigés indépendamment en français et en anglais sur les mêmes événements. , c’est-à-dire des textes sur le même sujet rédigés séparément dans chaque langue, est souvent tout ce qui existe. Les quatre domaines d’ACTER ont tous des corpus comparables en anglais, en français et en néerlandais, et seul celui de la corruption a aussi un corpus parallèle (Rigouts Terryn et al., 2020a). Dans des textes comparables, aucune phrase d’une langue ne correspond à une phrase de l’autre, si bien que l’étape d’alignement n’a rien sur quoi s’appuyer, et trouver les équivalents devient un problème plus difficile.
Sources
- Lefever, E., Macken, L., & Hoste, V. (2009). Language-independent bilingual terminology extraction from a multilingual parallel corpus. Proceedings of the 12th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2009), 496–504. https://aclanthology.org/E09-1057/
- Macken, L., Lefever, E., & Hoste, V. (2013). TExSIS: Bilingual terminology extraction from parallel corpora using chunk-based alignment. Terminology, 19(1), 1–30. https://doi.org/10.1075/term.19.1.01mac
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/