Machine-learning methods for term extractionMéthodes d'extraction de termes par apprentissage automatique
TRA2600 S8 · in classS8 · en classe
TRA6008 OptionalFacultatif
Learning from annotated examples
A hybrid extractor combines a few measures with rules and a cut-off that people chose. Supervised learning supervised (machine) learningapprentissage supervisé machine learningapprentissage automatique A form of machine learning in which a model learns from labelled examples.Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. replaces those choices with examples: from texts in which the terms are marked, a model learns how to combine many measures and where to draw the line between terms and the rest (Rigouts Terryn et al., 2019) (see also the From rules to machine learning chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des règles à l'apprentissage automatique, dans le module Fondements de l'IA et du TAL).
The measures are called features featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. . For each candidate they can describe, for instance, its termhood termhooddegré de termitude terminologyterminologie The degree to which a unit of language is related to the concepts of a specialized domain.Degré auquel une unité de la langue se rattache aux concepts d'un domaine spécialisé. and unithood unithooddegré de figement terminologyterminologie The degree to which a sequence of words forms a stable unit.Degré auquel une suite de mots forme une unité stable. , its length, its grammatical pattern, how often it occurs, and whether it is part of longer candidates (Lefever & Rigouts Terryn, 2024). The table below shows four candidates as a model receives them: one row of features each, and the label a person gave.
| Candidate | Words | Pattern | Occurrences | Times more frequent than in general text | Part of a longer candidate | Term? |
|---|---|---|---|---|---|---|
| collected canter | 2 | adjective + noun | 12 | 180 | yes | yes |
| piaffe | 1 | noun | 9 | 1,500 | no | yes |
| last corner | 2 | adjective + noun | 1 | 2 | no | no |
| good horse | 2 | adjective + noun | 3 | 4 | no | no |
Classifying candidates: HAMLET
HAMLET, a tool I developed with Véronique Hoste and Els Lefever, follows the steps of the hybrid method but learns them from examples. The grammatical patterns come from the annotated texts instead of a hand-written list, and a classifier labels each candidate as a term or not, from many features (Rigouts Terryn et al., 2021).
On the same Dutch texts about dressage, HAMLET proposed far fewer candidates than TermoStat, and a much larger share of them were terms, while TermoStat’s longer list contained somewhat more of the terms people had marked. HAMLET also found more of the terms that occurred only once, which a single frequency-based measure tends to miss (Rigouts Terryn et al., 2019).
HAMLET is one system of this kind among several. When teams tested their term extractors on the same data in a shared task shared tasktâche partagée evaluationévaluation A public evaluation exercise in which every participating team is given the same task, the same data and the same scoring, so that their systems can be compared directly.Exercice d'évaluation public où toutes les équipes participantes reçoivent la même tâche, les mêmes données et la même notation, de sorte que leurs systèmes se comparent directement. , the entries ranged from rule-based filtering of candidates and classifiers built on statistical features to fine-tuned BERT models (Rigouts Terryn et al., 2020b).
Sequence labelling
Sequence labelling is a second kind of supervised model for term extraction, and it does not start from a list of candidates. It reads the text word by word and gives each word a label, as Figure 18figure 18 shows: B for the first word of a term, I for a word inside a term, and O for a word outside any term (Rigouts Terryn et al., 2022b). This is called sequence labelling, and the same technique is used to find names in texts (see also the A tour of NLP tasks chapter) (voir aussi le chapitre Tour d'horizon des tâches du TAL).
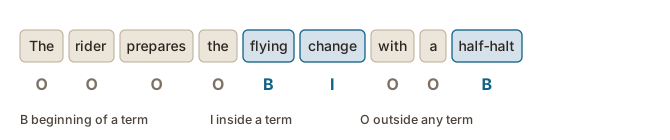
The models behind this approach are usually neural networks neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. that read each word through a contextual embedding contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. , a representation of the word that depends on the sentence around it. D-Terminer, a free online demonstration of my doctoral research rather than a full tool, uses such a model to mark terms in English, French, Dutch or German, and works even on a single sentence (Rigouts Terryn et al., 2022a).D-Terminer runs in the browser at lt3.ugent.be/dterminer; it is a demo of the method, with the limits of a demo.
The demo’s settings name the notions of this chapter (Figure 19figure 19): the labelling scheme, the domains of the annotated texts the model was trained on, and the kinds of term to return (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes).
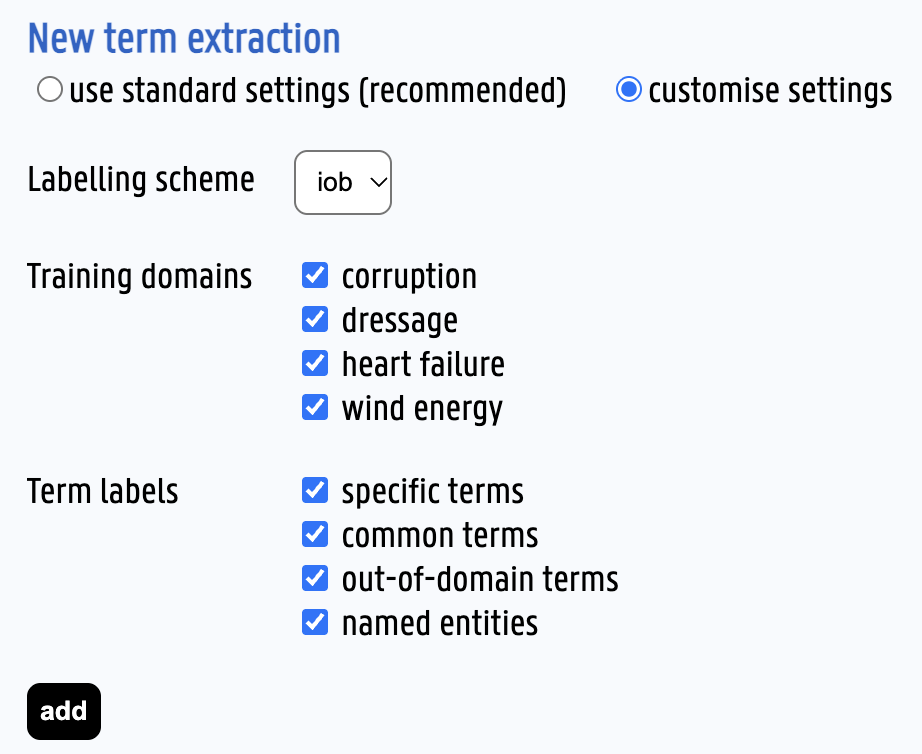
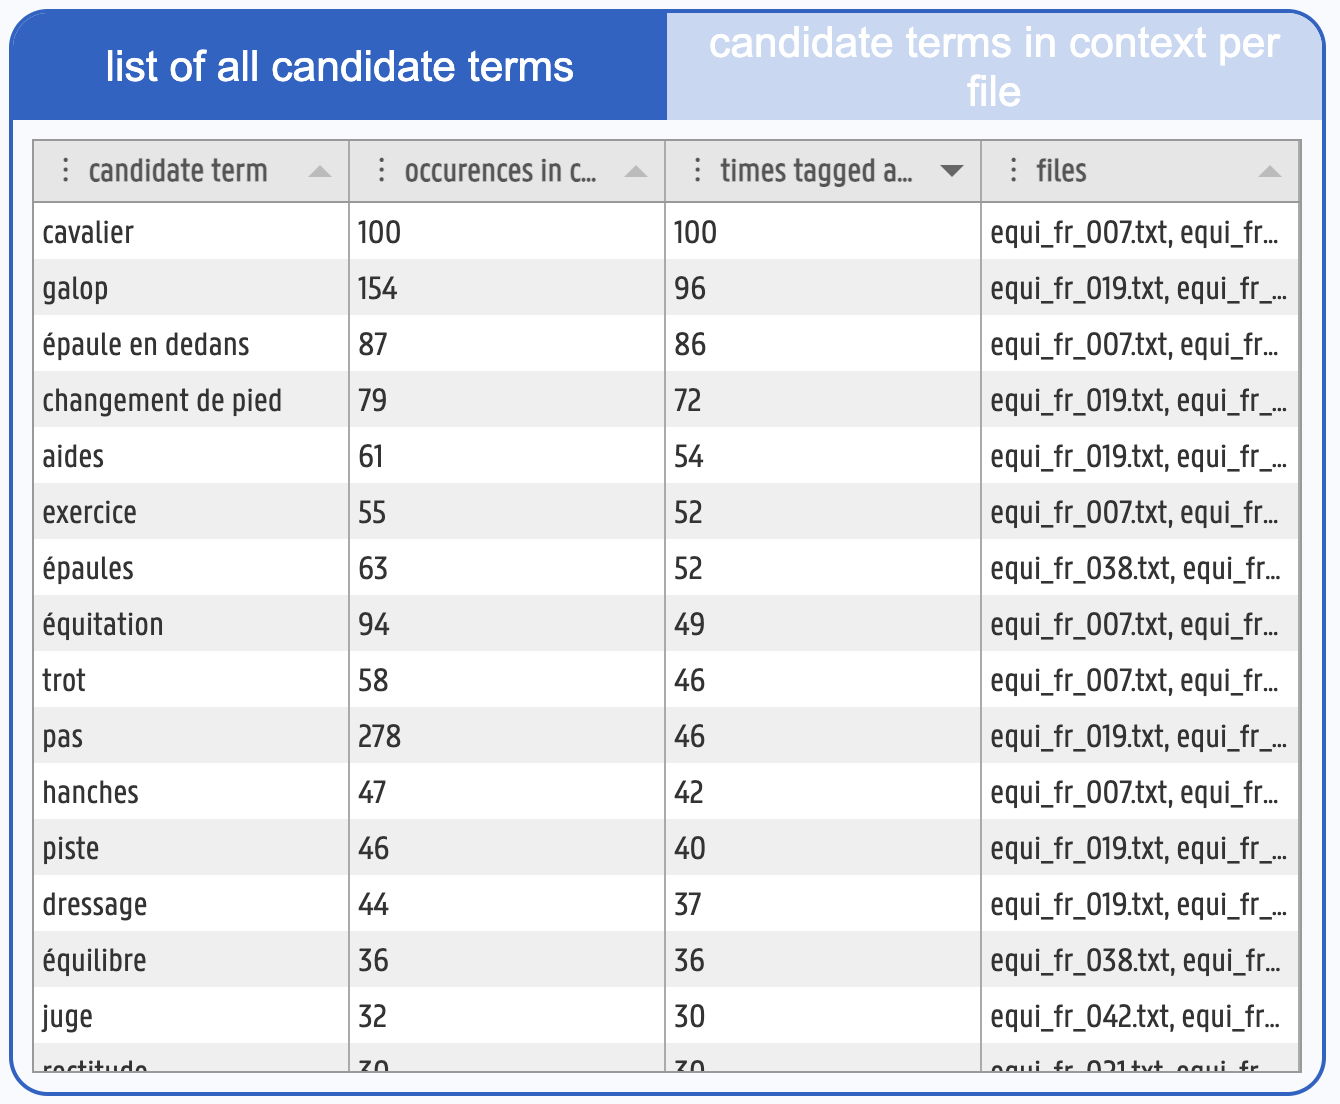
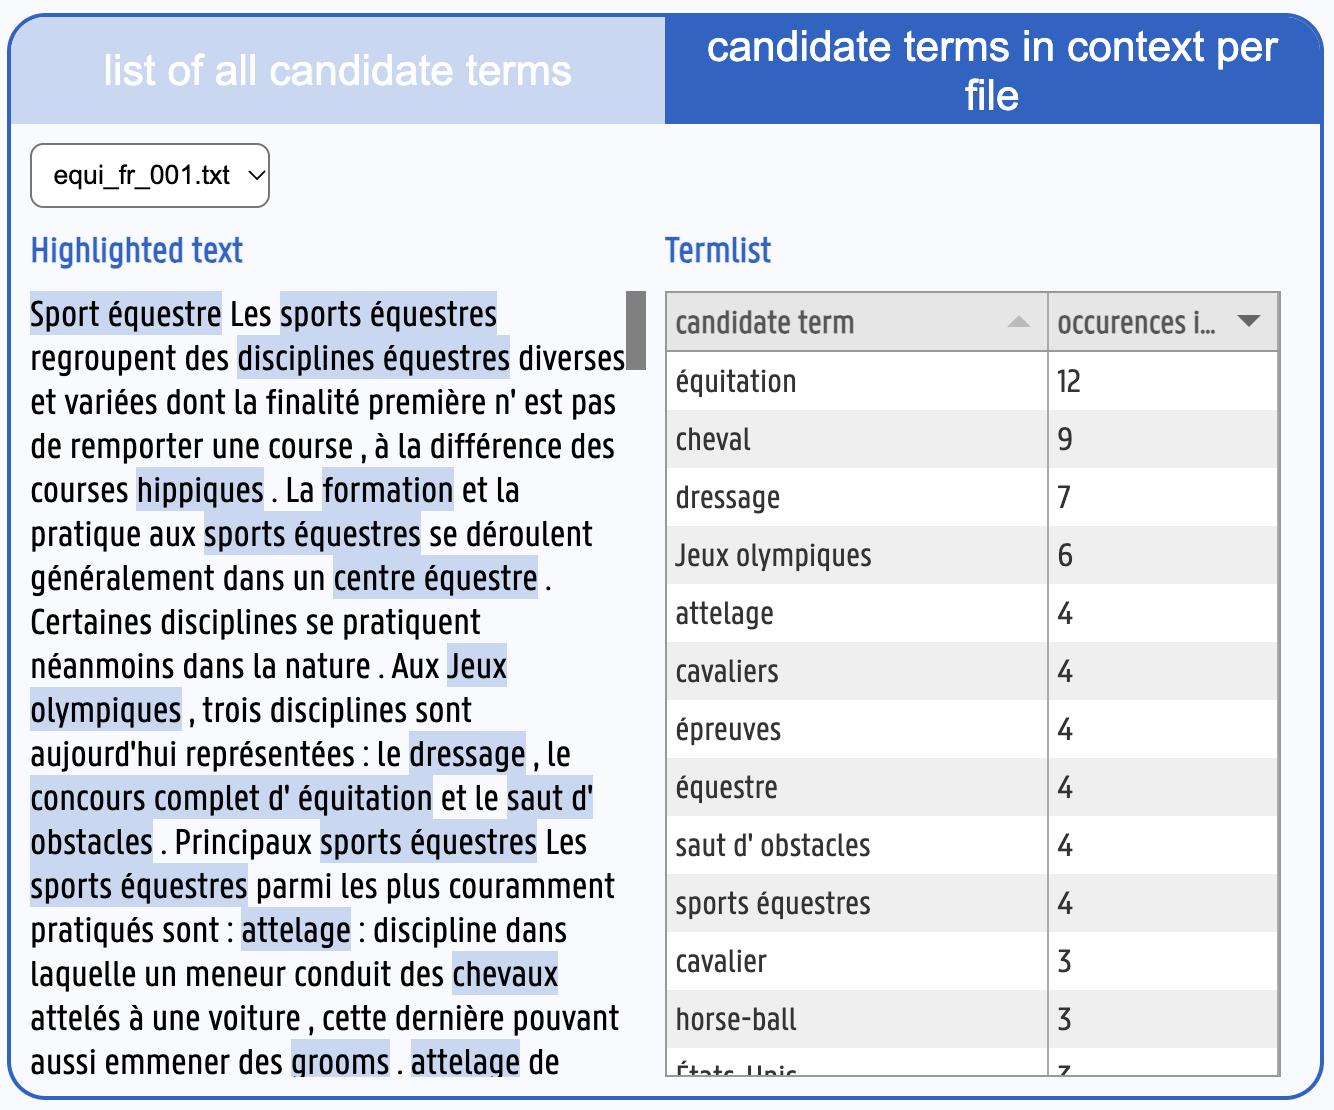
Its two views of a result are the two forms of output: a list, and the terms marked in the text. In the list (Figure 20figure 20), one column counts how often a candidate occurs in the corpus and another how often it was marked as a term. The two differ, because the model labels each occurrence separately: pas occurs 278 times in these French texts and is marked 46 times, since pas is the walk, a gait of the horse, and also the French word for “not”. The context view (Figure 21figure 21) shows the same candidates where they occur in one text.
Comparing the two approaches
A model that classifies candidates and a model that labels sequences differ in what they decide on and in what they can return, as the table below sets out (Rigouts Terryn et al., 2021, 2022a, 2022b).
| Classifying candidates | Sequence labelling | |
|---|---|---|
| What it labels | each candidate of a list, once | each word, in the sentence where it occurs |
| Output | a list of terms | terms marked in the text |
| The same word in two sentences | one decision for both | can be a term in one and not in the other |
| A shorter term inside a longer one | both can be kept | only the longest: one line of B, I and O labels cannot mark both |
| Amount of text | a corpus, since several features are frequencies | a single sentence is enough |
Factors that affect the results
The quality of a supervised extractor’s output varies more with the texts than with the kind of model. When a classifier of candidates and a sequence labeller were tested on the same twelve corpora corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. , four domains in three languages, their average scores were close, and the differences between domains and languages were larger than the difference between the two approaches (Rigouts Terryn et al., 2022b) (see also the Term extraction with LLMs page) (voir aussi la page L'extraction de termes avec les GML). The factors include, for instance:
- The language. Scores were lower in French than in Dutch. A likely reason is compounding: a Dutch term is often one compound word where French and English need several words, and terms of several words are harder to extract (Rigouts Terryn, 2026; Rigouts Terryn et al., 2022b).
- The domain. Texts about corruption gave the lowest scores in all three languages. They were also the hardest for people to annotate data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. , because their terms are harder to tell from general vocabulary (Rigouts Terryn, 2026; Rigouts Terryn et al., 2022b).
- The relevance of the training data training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. . A model does best on texts that resemble the ones it learned from (Rigouts Terryn et al., 2021).
- The amount of data. More annotated examples help (Rigouts Terryn et al., 2021), and a model that sorts a list also needs enough text to extract from, since several of its features are frequencies.
- The kind of term. Terms of several words, and terms that are also everyday words, are found less often than the others (Rigouts Terryn et al., 2022b).
- The method. The behaviour of a model that learned from examples is less predictable than a set of rules (Rigouts Terryn et al., 2021).
Apprendre à partir d’exemples annotés
Un extracteur hybride combine quelques mesures avec des règles et un seuil que des personnes ont choisis. L’apprentissage supervisé supervised (machine) learningapprentissage supervisé machine learningapprentissage automatique A form of machine learning in which a model learns from labelled examples.Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. remplace ces choix par des exemples : à partir de textes où les termes sont annotés, un modèle apprend à combiner de nombreuses mesures et à placer la limite entre les termes et le reste (Rigouts Terryn et al., 2019) (see also the From rules to machine learning chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des règles à l'apprentissage automatique, dans le module Fondements de l'IA et du TAL).
Ces mesures s’appellent des attributs featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. . Pour chaque candidat, ils peuvent décrire, par exemple, son degré de termitude termhooddegré de termitude terminologyterminologie The degree to which a unit of language is related to the concepts of a specialized domain.Degré auquel une unité de la langue se rattache aux concepts d'un domaine spécialisé. et son degré de figement unithooddegré de figement terminologyterminologie The degree to which a sequence of words forms a stable unit.Degré auquel une suite de mots forme une unité stable. , sa longueur, son patron grammatical, son nombre d’occurrences, et le fait qu’il fasse partie ou non de candidats plus longs (Lefever et Rigouts Terryn, 2024). Le tableau ci-dessous montre quatre candidats tels qu’un modèle les reçoit : une ligne d’attributs chacun, et l’étiquette qu’une personne a donnée.
| Candidat | Mots | Patron | Occurrences | Combien de fois plus fréquent que dans les textes généraux | Partie d’un candidat plus long | Terme ? |
|---|---|---|---|---|---|---|
| galop rassemblé | 2 | nom + adjectif | 12 | 180 | oui | oui |
| piaffer | 1 | nom | 9 | 1 500 | non | oui |
| dernier coin | 2 | adjectif + nom | 1 | 2 | non | non |
| bon cheval | 2 | adjectif + nom | 3 | 4 | non | non |
Classer des candidats : HAMLET
HAMLET, un outil que j’ai conçu avec Véronique Hoste et Els Lefever, suit les étapes de la méthode hybride, mais les apprend à partir d’exemples. Les patrons grammaticaux viennent des textes annotés, et non d’une liste écrite à la main, et un classifieur étiquette chaque candidat comme terme ou non, à partir de nombreux attributs (Rigouts Terryn et al., 2021).
Sur les mêmes textes néerlandais sur le dressage, HAMLET a proposé beaucoup moins de candidats que TermoStat, et une part bien plus grande de ces candidats étaient des termes, alors que la liste plus longue de TermoStat contenait un peu plus des termes que des personnes avaient annotés. HAMLET a aussi trouvé davantage de termes qui n’apparaissaient qu’une fois, qu’une seule mesure fondée sur la fréquence tend à manquer (Rigouts Terryn et al., 2019).
HAMLET est un système de ce type parmi d’autres. Quand des équipes ont testé leurs extracteurs de termes sur les mêmes données dans une tâche partagée shared tasktâche partagée evaluationévaluation A public evaluation exercise in which every participating team is given the same task, the same data and the same scoring, so that their systems can be compared directly.Exercice d'évaluation public où toutes les équipes participantes reçoivent la même tâche, les mêmes données et la même notation, de sorte que leurs systèmes se comparent directement. , les systèmes soumis allaient du filtrage de candidats à base de règles et de classifieurs fondés sur des attributs statistiques à des modèles BERT affinés (Rigouts Terryn et al., 2020b).
L’étiquetage de séquences
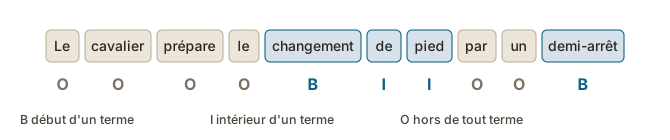
L’étiquetage de séquences est un second type de modèle supervisé pour l’extraction de termes, et il ne part pas d’une liste de candidats. Il lit le texte mot par mot et donne une étiquette à chaque mot, comme le montre la Figure 18figure 18 : B pour le premier mot d’un terme, I pour un mot à l’intérieur d’un terme, et O pour un mot en dehors de tout terme (Rigouts Terryn et al., 2022b). Cette méthode s’appelle l’étiquetage de séquences, et la même technique sert à repérer les noms propres dans les textes (see also the A tour of NLP tasks chapter) (voir aussi le chapitre Tour d'horizon des tâches du TAL).
Les modèles derrière cette approche sont le plus souvent des réseaux de neurones neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. qui lisent chaque mot à travers un plongement contextuel contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. , c’est-à-dire une représentation du mot qui dépend de la phrase où il se trouve. D-Terminer, une démonstration en ligne gratuite de ma recherche doctorale plutôt qu’un outil complet, utilise un tel modèle pour marquer les termes en anglais, en français, en néerlandais ou en allemand, et fonctionne même sur une seule phrase (Rigouts Terryn et al., 2022a).D-Terminer s’utilise dans le navigateur à l’adresse lt3.ugent.be/dterminer ; c’est une démonstration de la méthode, avec les limites d’une démonstration.
Les réglages de la démonstration nomment les notions de ce chapitre (Figure 19figure 19) : le schéma d’étiquetage, les domaines des textes annotés sur lesquels le modèle a été entraîné, et les types de termes à renvoyer (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes).
Ses deux vues d’un résultat sont les deux formes de résultat : une liste, et les termes marqués dans le texte. Dans la liste (Figure 20figure 20), une colonne compte les occurrences d’un candidat dans le corpus et une autre le nombre de fois où il a été marqué comme terme. Les deux diffèrent, parce que le modèle étiquette chaque occurrence séparément : pas apparaît 278 fois dans ces textes français et n’est marqué que 46 fois, puisque pas est à la fois une allure du cheval et l’adverbe de négation. La vue en contexte (Figure 21figure 21) montre les mêmes candidats là où ils apparaissent dans un texte.
Comparaison des deux approches
Un modèle qui classe des candidats et un modèle qui étiquette des séquences diffèrent par ce qu’ils étiquettent et par ce qu’ils peuvent renvoyer, comme le présente le tableau ci-dessous (Rigouts Terryn et al., 2021, 2022a, 2022b).
| Classement de candidats | Étiquetage de séquences | |
|---|---|---|
| Ce qu’il étiquette | chaque candidat d’une liste, une fois | chaque mot, dans la phrase où il apparaît |
| Résultat | une liste de termes | des termes marqués dans le texte |
| Le même mot dans deux phrases | une seule décision pour les deux | peut être un terme dans l’une et pas dans l’autre |
| Un terme court à l’intérieur d’un terme long | les deux peuvent être gardés | seulement le plus long : une seule ligne d’étiquettes B, I et O ne peut pas marquer les deux |
| Quantité de texte | un corpus, puisque plusieurs attributs sont des fréquences | une seule phrase suffit |
Les facteurs qui influencent les résultats
La qualité de ce que renvoie un extracteur supervisé varie davantage selon les textes que selon le type de modèle. Quand un classifieur de candidats et un étiqueteur de séquences ont été testés sur les douze mêmes corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. , quatre domaines dans trois langues, leurs scores moyens étaient proches, et les écarts entre domaines et entre langues étaient plus grands que l’écart entre les deux approches (Rigouts Terryn et al., 2022b) (see also the Term extraction with LLMs page) (voir aussi la page L'extraction de termes avec les GML). Parmi ces facteurs, par exemple :
- La langue. Les scores étaient plus faibles en français qu’en néerlandais. La composition en est une raison probable : un terme néerlandais est souvent un seul mot composé là où le français et l’anglais demandent plusieurs mots, et les termes de plusieurs mots sont plus difficiles à extraire (Rigouts Terryn, 2026 ; Rigouts Terryn et al., 2022b).
- Le domaine. Les textes sur la corruption ont donné les scores les plus faibles dans les trois langues. C’étaient aussi les plus difficiles à annoter data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. pour des personnes, parce que leurs termes se distinguent moins bien du vocabulaire général (Rigouts Terryn, 2026 ; Rigouts Terryn et al., 2022b).
- La pertinence des données d’entraînement training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. . Un modèle réussit le mieux sur des textes qui ressemblent à ceux à partir desquels il a appris (Rigouts Terryn et al., 2021).
- La quantité de données. Plus d’exemples annotés aident (Rigouts Terryn et al., 2021), et un modèle qui trie une liste a aussi besoin d’assez de texte d’où extraire, puisque plusieurs de ses attributs sont des fréquences.
- Le type de terme. Les termes de plusieurs mots, et les termes qui sont aussi des mots courants, sont moins souvent trouvés que les autres (Rigouts Terryn et al., 2022b).
- La méthode. Le comportement d’un modèle qui a appris à partir d’exemples est moins prévisible qu’un ensemble de règles (Rigouts Terryn et al., 2021).
Sources
- Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
- Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
- Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2021). HAMLET: Hybrid Adaptable Machine Learning approach to Extract Terminology. Terminology, 27(2), 254–293. https://doi.org/10.1075/term.20017.rig
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
- Rigouts Terryn, A., Hoste, V., Drouin, P., & Lefever, E. (2020b). TermEval 2020: Shared Task on Automatic Term Extraction Using the Annotated Corpora for Term Extraction Research (ACTER) Dataset. Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020), 85–94. https://aclanthology.org/2020.computerm-1.12/