Les correspondances telles que Wordfast les montreLes correspondances telles que Wordfast les montre
TRA2600 S2 · in classS2 · en classe
Une répétition à l’intérieur du document
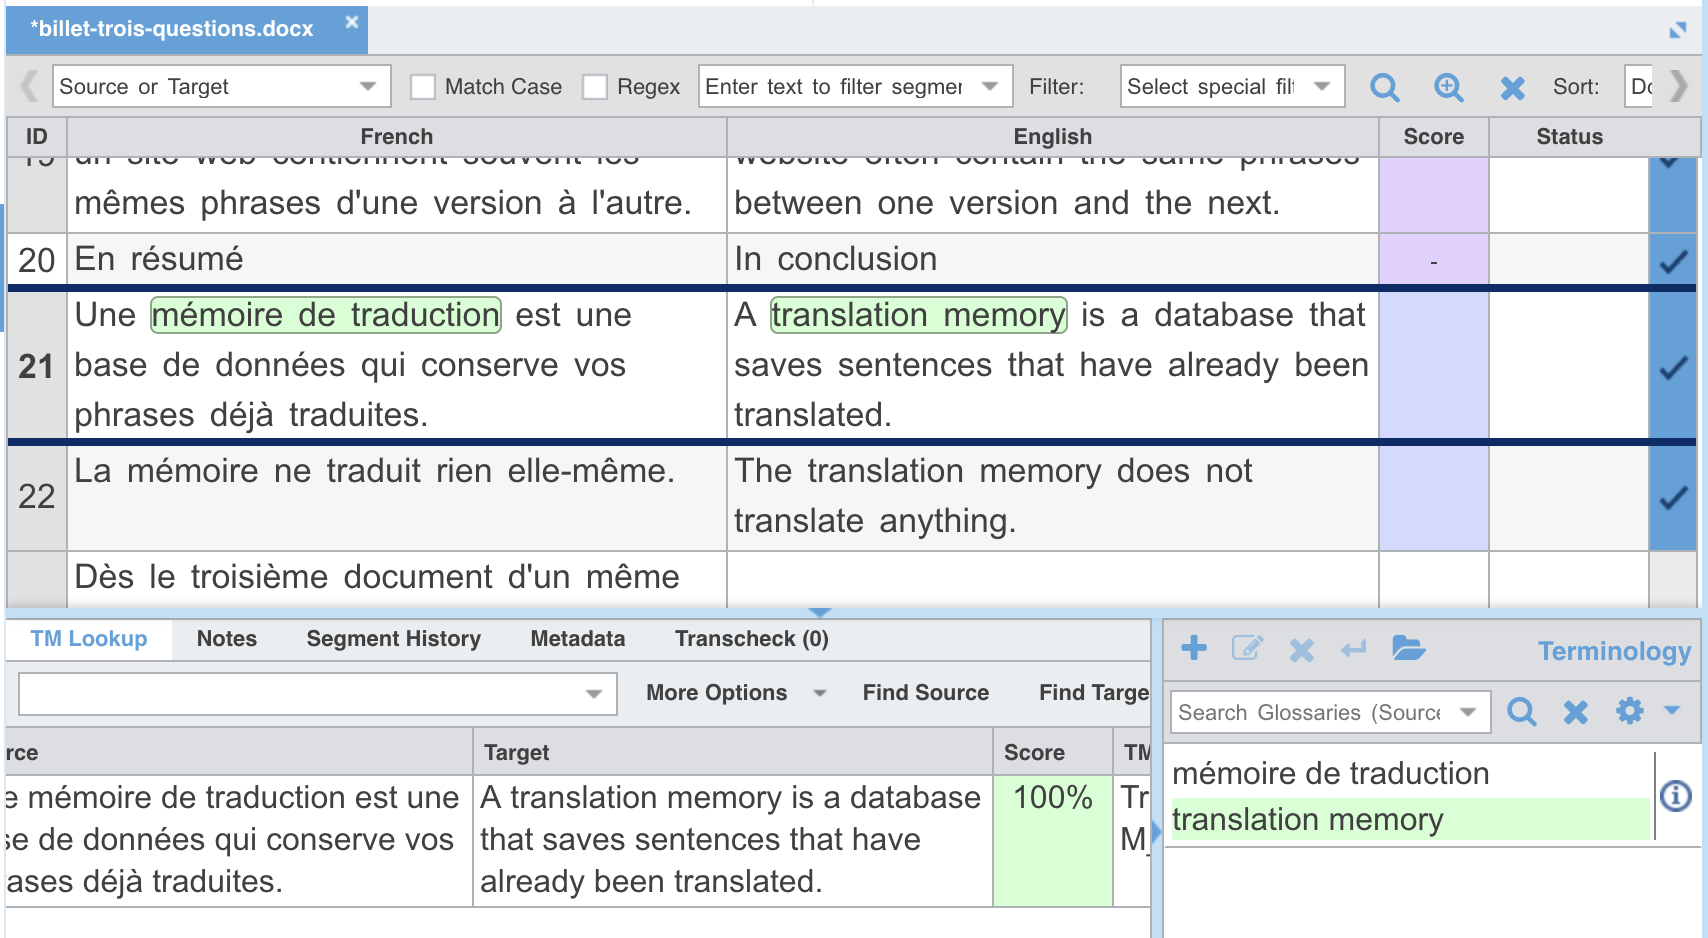
Deux segments identiques, et dès que vous validez le premier, Wordfast renseigne le second et le marque comme validé, avec une icône particulière dans la colonne de statut. Vous n’avez rien à faire, et c’est justement ce qui mérite attention (see also the Translation memories chapter) (voir aussi le chapitre Les mémoires de traduction).
Le piège est là : ce qui se propage est ce que vous aviez validé la première fois, bon ou mauvais. Une répétition propage donc aussi les erreurs, et elle les propage silencieusement.
Et si vous changez d’avis
Rien ne vous oblige à garder la proposition. Réécrivez la cible du second segment, et tant que vous n’avez pas validé, la mémoire continue de proposer l’ancienne version.
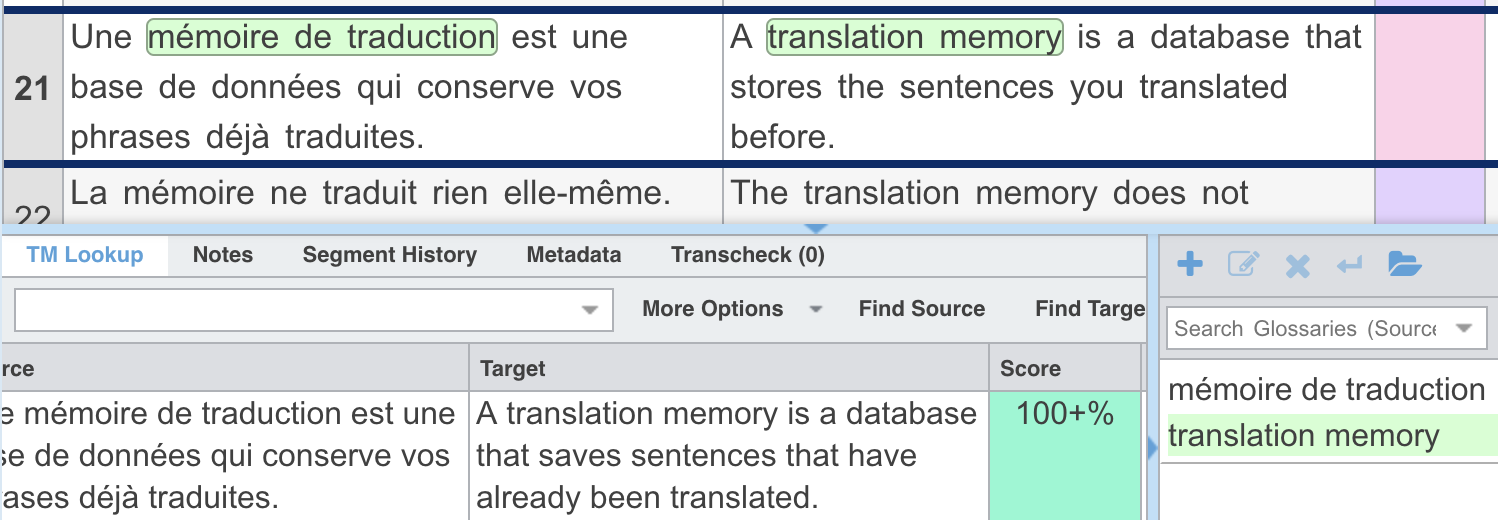
Validez, et la mémoire ne remplace pas l’ancienne unité : elle en garde deux.
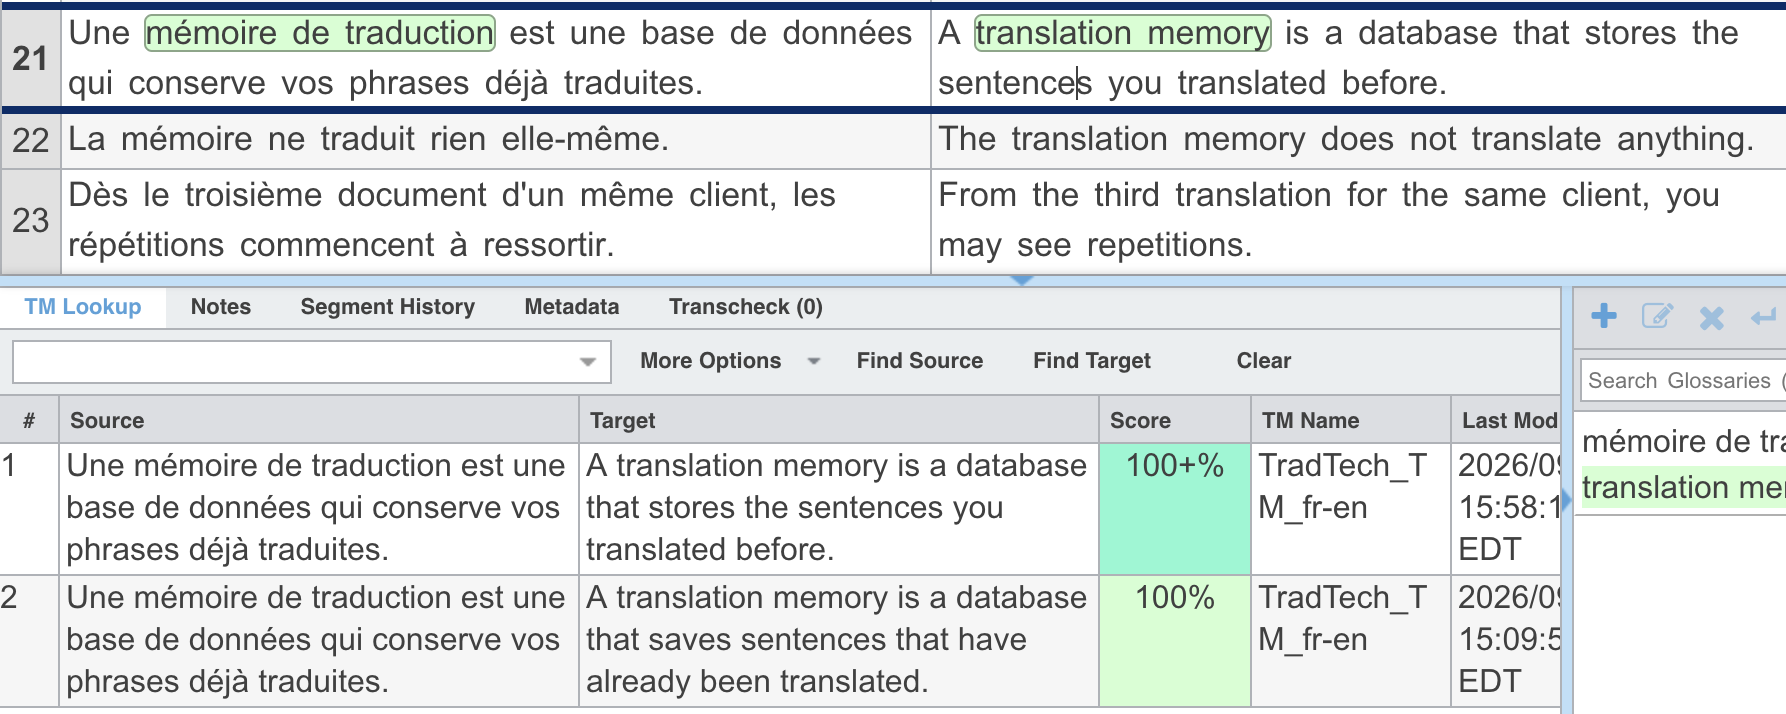
La prochaine fois que cette phrase se présentera, la mémoire proposera les deux et c’est vous qui trancherez. Le « 100+ % » de la première marque une correspondance en contexte context matchcorrespondance en contexte CAT toolsTAO A translation-memory match in which the stored source segment is identical to the segment being translated and the segments around it match as well, so the stored translation was produced in the same surroundings.Correspondance de mémoire de traduction dans laquelle le segment source stocké est identique au segment à traduire et où les segments voisins correspondent également, de sorte que la traduction stockée a été produite dans le même entourage. : la phrase est identique et ses voisines aussi.
Une mémoire accumule ainsi les variantes de ce qu’elle a vu passer. Les retirer suppose d’ouvrir la mémoire elle-même, ce qui se fait au moment où l’on y verse un contenu qu’on n’a pas tapé (see also the Wordfast: alignment chapter) (voir aussi le chapitre Wordfast : alignement).
Une correspondance partielle fuzzy matchcorrespondance partielle CAT toolsTAO A translation-memory match in which the stored source segment resembles the segment being translated without being identical to it, reported as a percentage below 100. The comparison is made segment by segment, so the percentage measures the distance between two segments as segmentation produced them, not between two texts.Correspondance de mémoire de traduction dans laquelle le segment source stocké ressemble au segment à traduire sans lui être identique, exprimée en pourcentage inférieur à 100. La comparaison se fait segment par segment : le pourcentage mesure donc la distance entre deux segments tels que la segmentation les a produits, et non entre deux textes. , et une absence de correspondance
Le score affiche le pourcentage quand la mémoire a trouvé quelque chose d’assez proche. Quand rien ne dépasse le seuil, la colonne reste vide.
Le segment 23 en donne un cas net.
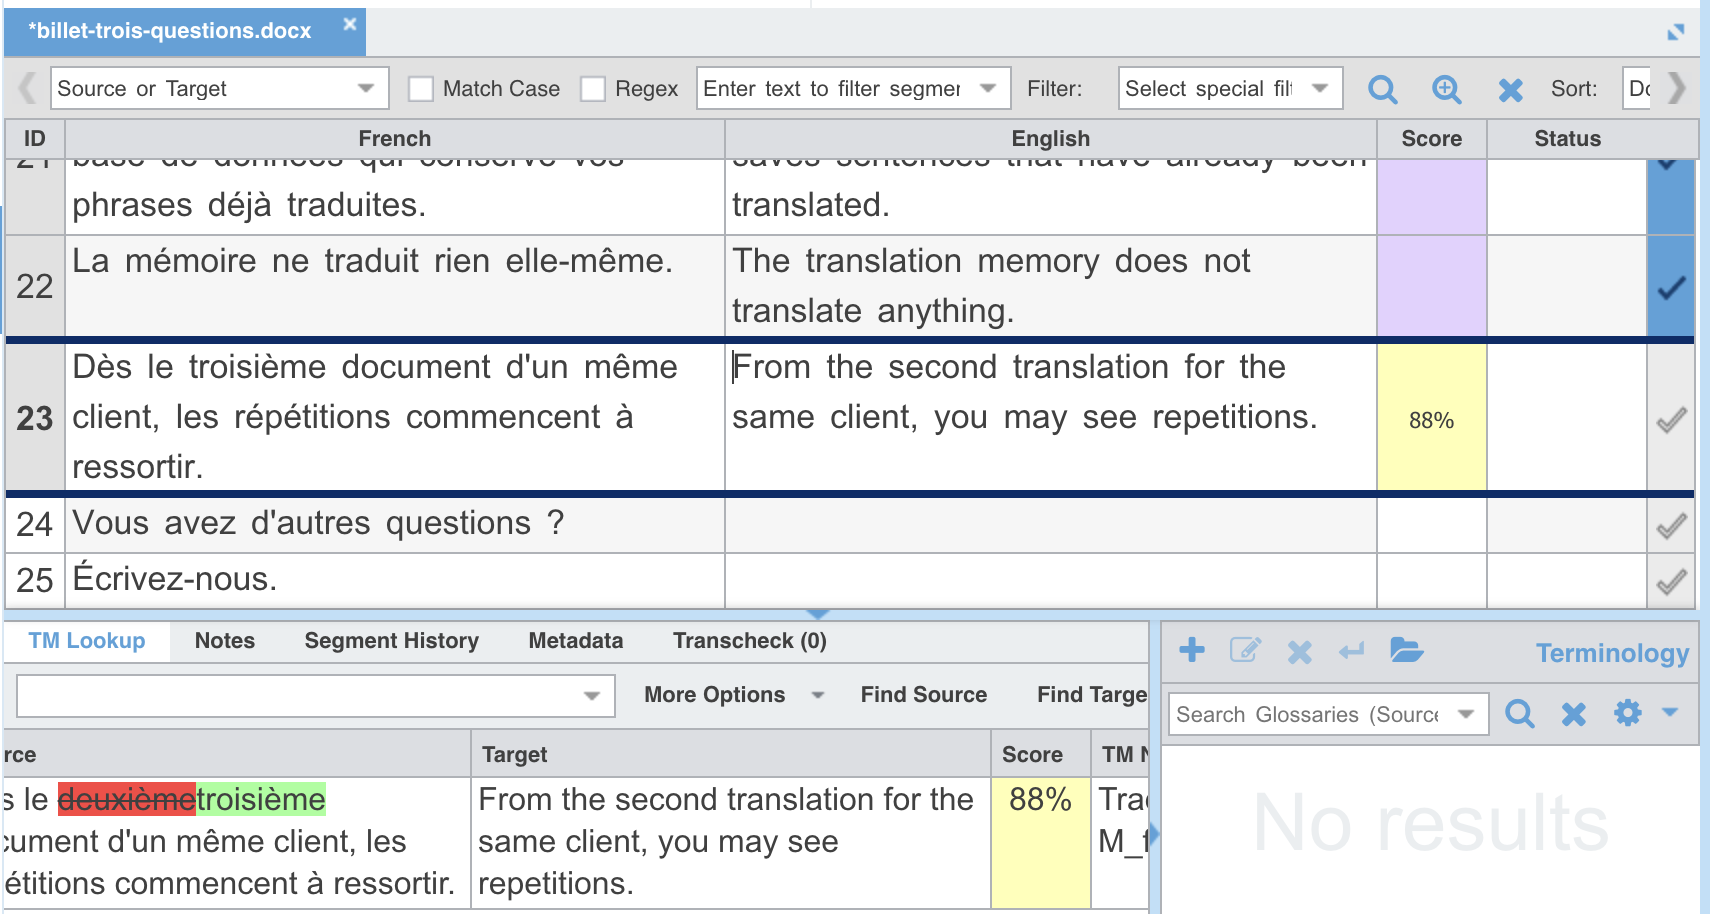
Le volet du bas montre exactement ce qui diffère : « deuxième » barré en rouge, « troisième » en vert. Et la traduction proposée, elle, dit toujours « second ». C’est le piège de la correspondance haute : elle est presque juste, donc on la relit moins, et le seul mot qui compte est justement celui qui est faux.
Deux segments peuvent dire la même chose et n’obtenir aucune correspondance, parce que la distance d’édition entre eux est trop grande : les mots et les caractères diffèrent trop, même si le sens est le même (see also the fuzzy match page) (voir aussi la page La correspondance partielle).
Le glossaire pendant la traduction
Quand un terme du glossaire apparaît dans le segment source, Wordfast le surligne, et la couleur dit si son équivalent se trouve dans votre traduction.
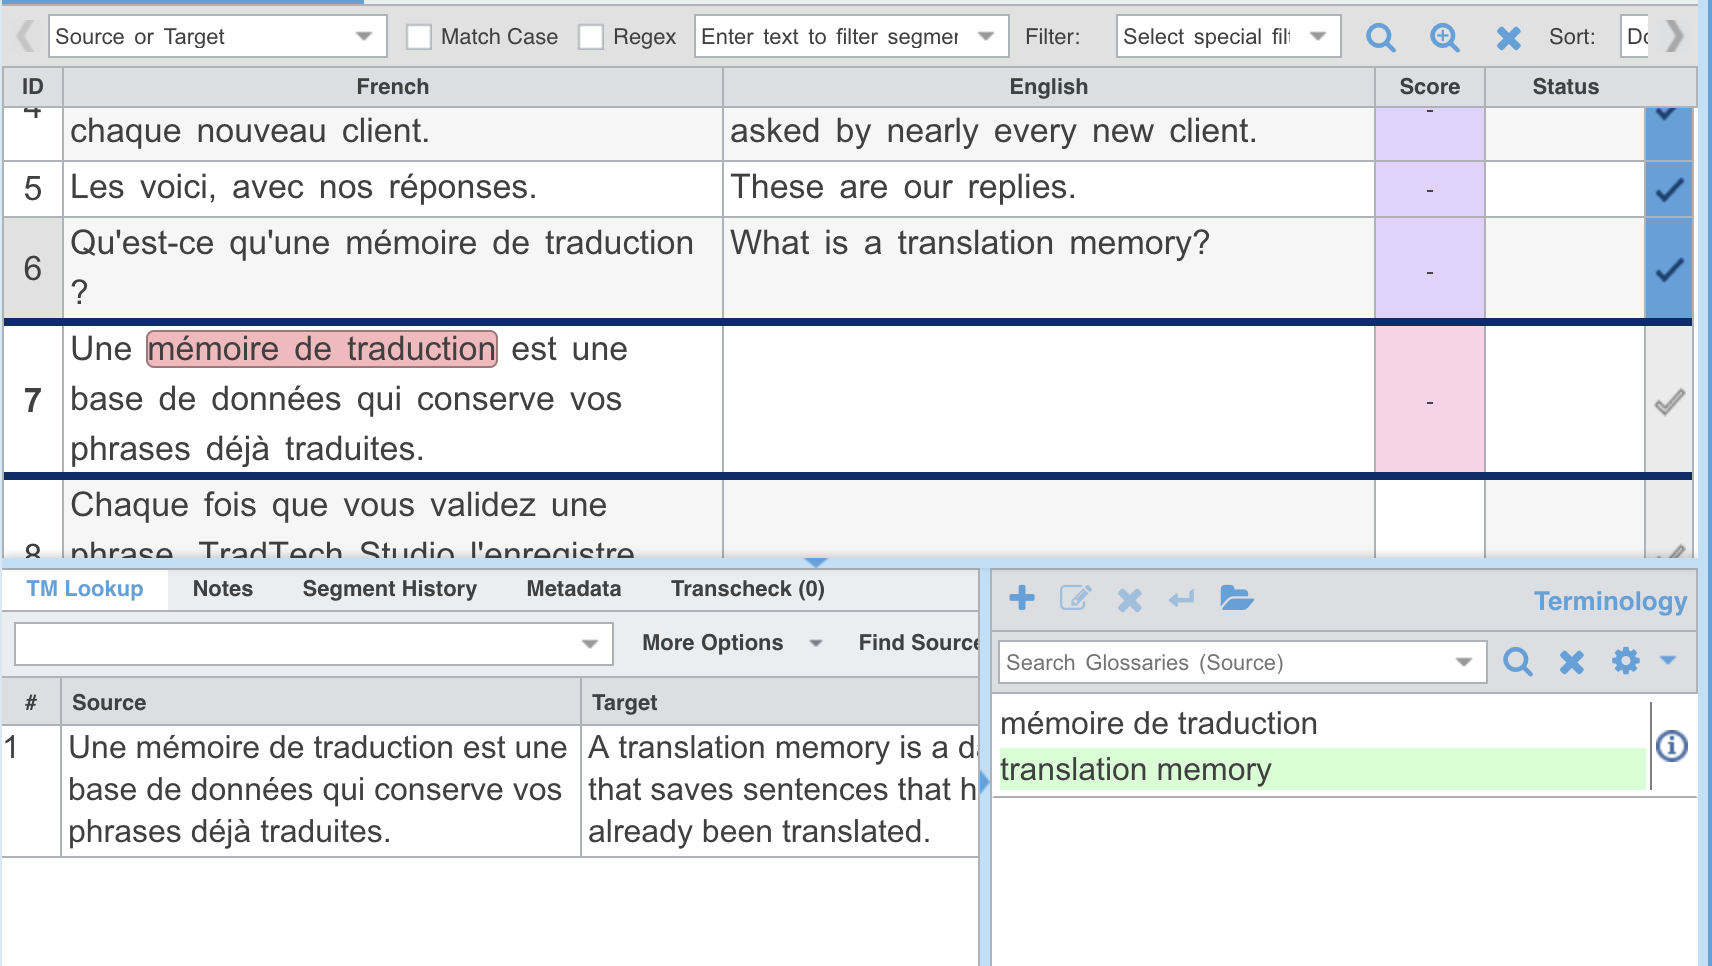
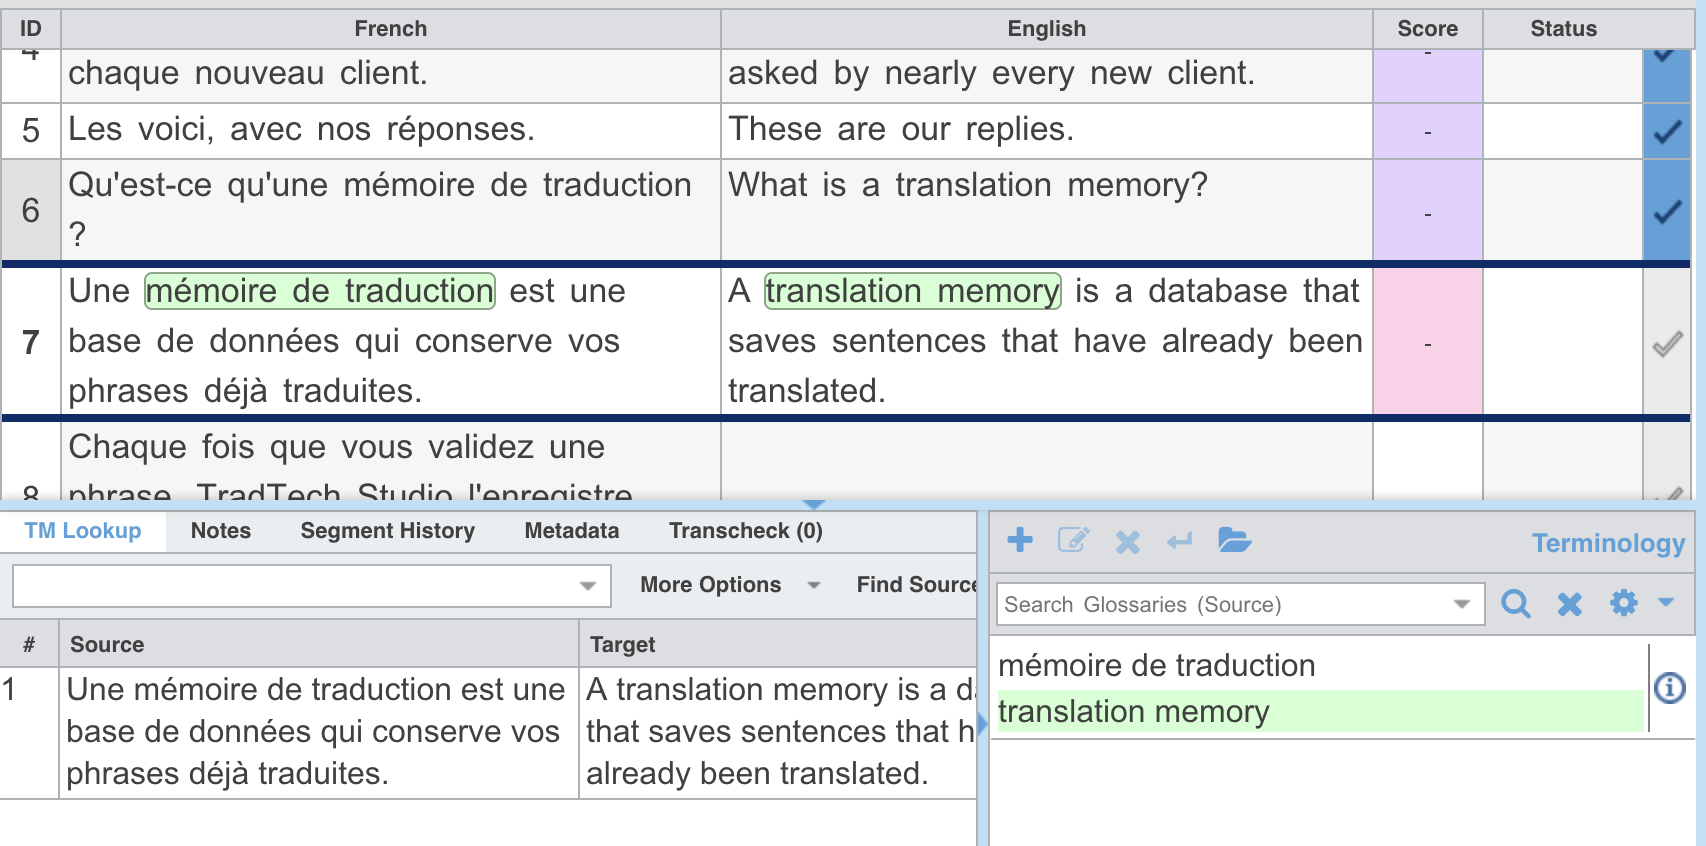
C’est un signalement, pas un verdict. Le terme peut être absent pour une bonne raison : une reformulation, un pronom qui reprend le terme, une tournure où il ne va pas. Wordfast ne reconnaît pas toujours une forme fléchie et signale alors un problème qui n’existe pas (see also the Wordfast: quality assurance and delivery chapter) (voir aussi le chapitre Wordfast : assurance de la qualité et livraison).
Chercher dans la mémoire, et l’alimenter d’un coup
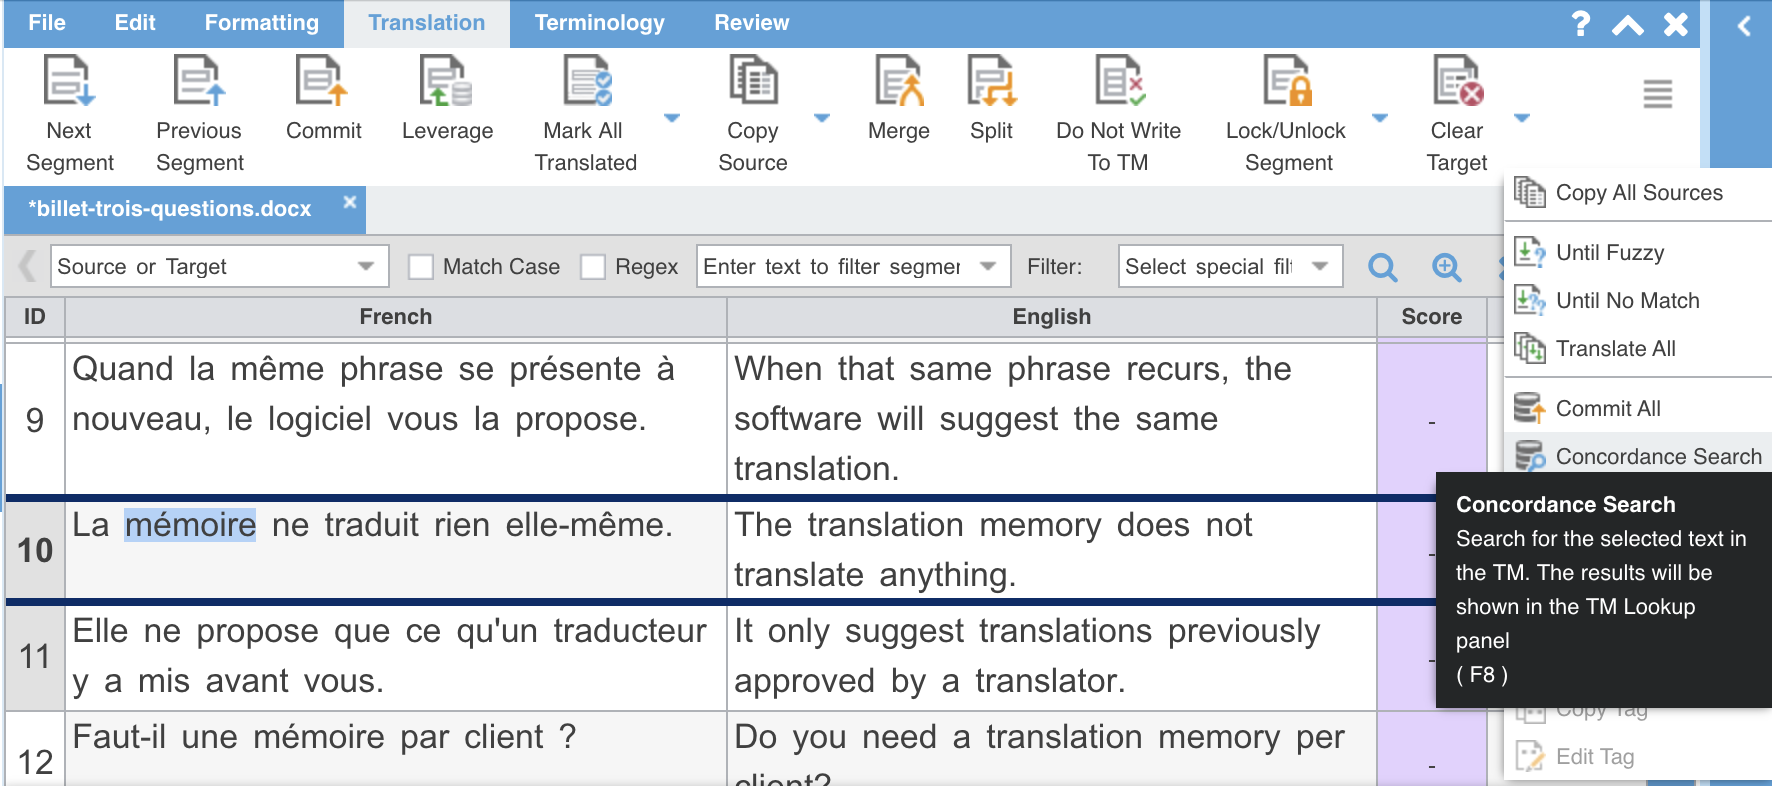
Deux commandes du menu du coin droit du ruban « Translation » portent sur la mémoire elle-même plutôt que sur le segment courant.
« Concordance Search » cherche un texte dans toute la mémoire et affiche, dans le volet « TM Lookup », les unités qui le contiennent. C’est une recherche en concordance concordanceconcordance corporacorpus A display of all occurrences of a word or expression in a corpus, each shown with its surrounding context, typically one occurrence per line with the search word aligned in the middle (the key word in context, or KWIC, format).Affichage de toutes les occurrences d'un mot ou d'une expression dans un corpus, chacune accompagnée de son contexte immédiat, généralement une occurrence par ligne avec le mot cherché aligné au centre (format KWIC, mot-clé en contexte). , la même idée que dans un outil d’analyse de corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. .
Supposons que vous vouliez vérifier une chose : avez-vous toujours rendu « mémoire » par translation memory, ou vous est-il arrivé d’écrire seulement memory ? Sélectionnez le mot dans un segment, puis lancez la commande, ou appuyez sur F8.
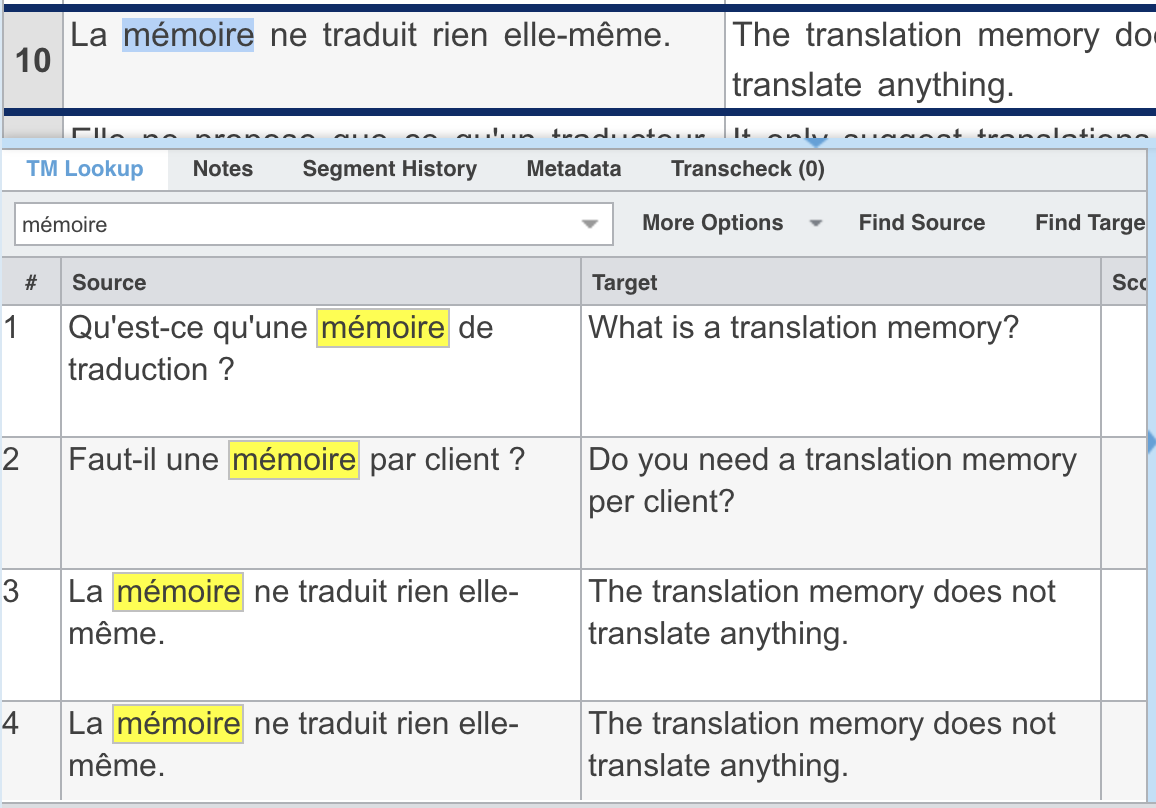
La réponse est nette ici : translation memory partout. La recherche accepte un mot comme une expression de plusieurs mots, et c’est le moyen le plus direct de retrouver comment quelque chose avait été rendu quand aucune correspondance ne se présente d’elle-même.
Les deux dernières lignes sont la même paire, enregistrée deux fois : c’est la phrase que vous avez validée à chacune de ses deux occurrences.
« Commit All » écrit d’un coup dans la mémoire tous les segments traduits du fichier. Utile quand vous avez travaillé sans valider segment par segment, et à manier avec précaution : ce qui part dans la mémoire y reste.
This page is only available in French.