AgentsLes agents
TRA6008 OptionalFacultatif
A goal instead of a question
An ordinary exchange with a chatbot is one question and one answer: you read what comes back and decide what to ask next. An agent AI agentagent agentsagents An AI system that selects and carries out actions toward a goal, often by using tools or calling other programs and adapting later actions to the results it receives.Système d'IA qui choisit et exécute des actions en vue d'un but, souvent en utilisant des outils ou en appelant d'autres programmes et en adaptant ses actions ultérieures aux résultats reçus. is given a goal instead, and it is the chatbot that decides what to do next, step after step, until it produces a result (Figure 27figure 27). A deep research run is one example (see also the Deep research page) (voir aussi la page La recherche approfondie): you ask one question, and dozens of searches follow from it without your choosing them.
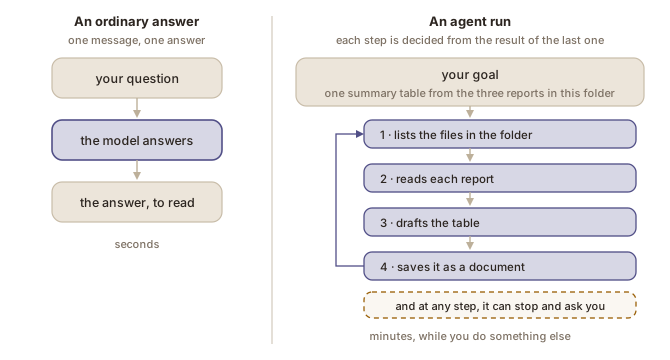
The model itself is unchanged: the same next-token prediction next-token predictionprédiction du jeton suivant language modelsmodèles de langue The task of estimating the probabilities of the tokens that could follow a given sequence of tokens.Tâche consistant à estimer les probabilités des jetons qui pourraient suivre une séquence de jetons donnée. , run again at each step, with its output routed to programs and their results added to the context. The difference is that nobody reads the intermediate results before the next step is taken.
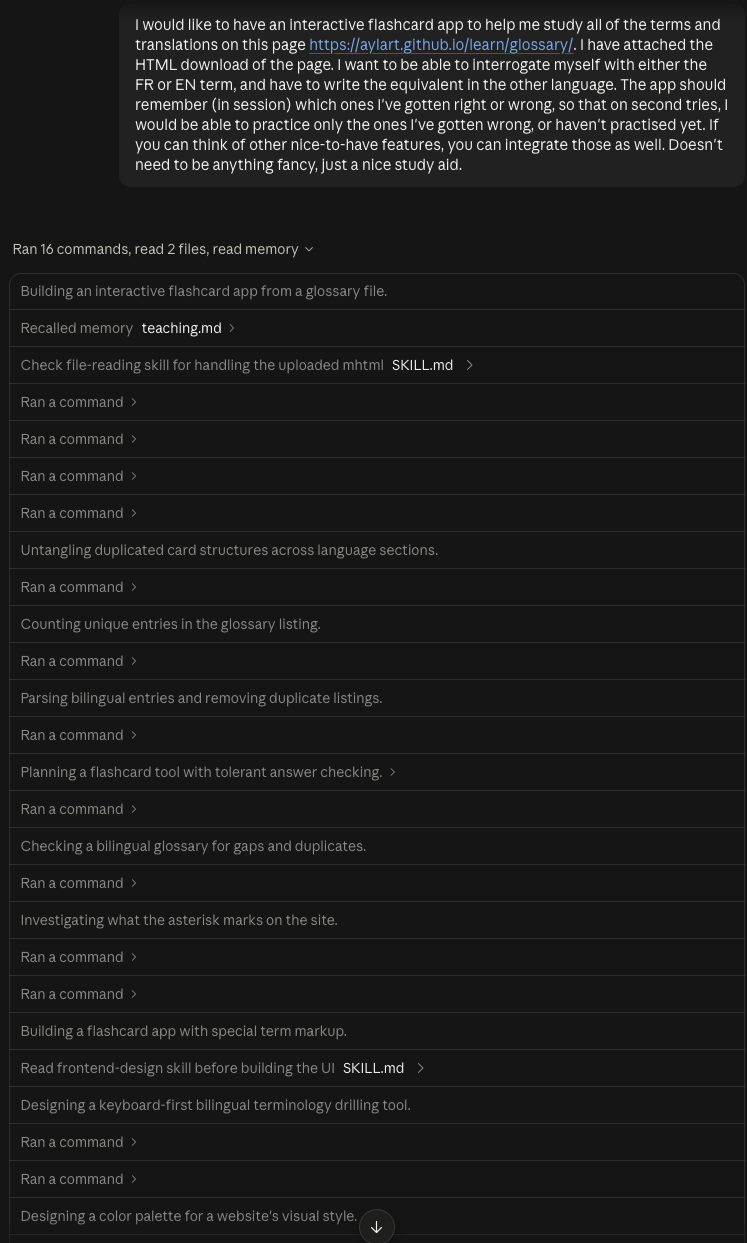
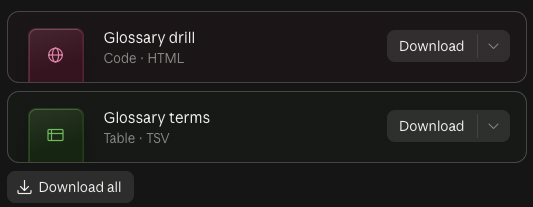
Asked for a study app built from the glossary of this site, Claude ran more than twenty commands before answering, each decided from what the last one returned: sorting out duplicated entries, counting the terms, checking the glossary for gaps, designing the interface (Figure 28figure 28). Two of the steps added text to the context, a note from its memory and the instructions of a skill (see also the What a chat product adds to the model page) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle). Two files came back, the app and the terms as a table (Figure 29figure 29).
What agents are asked to do
Chat products offer agents for a few kinds of work:
- A finished result, such as a report, a spreadsheet or a presentation. You describe what you want and add the material, and the files come back for you to edit.
- Operating a browser or your computer, by reading the screen, clicking and typing: the capability called computer use computer useutilisation d'un ordinateur agentsagents The capability of AI systems to control computer interfaces through screenshots, mouse movements, and keyboard input, to carry out a task.Capacité de systèmes d'IA à commander des interfaces informatiques au moyen de captures d'écran, de mouvements de souris et de saisies au clavier pour accomplir une tâche. . It comes as a browser built into the desktop app, as an extension that drives the browser you already use, or as a browser on the provider’s machines, which keeps working after you close your own.
- Software projects, the work of coding agents such as Claude Code and Codex.
- Tasks on a schedule: a request run again by itself, once or every week, a daily summary of your messages or a topic to follow. Some products can also start a task when something happens in a connected service, such as an email arriving.
Most of this runs on the provider’s machines, so it goes on when your computer is off; work on the files or the applications on your own machine needs the desktop app open.OpenAI Help Center, ChatGPT Work and Codex: “Work is an agent designed for longer, multi-step work and finished deliverables”; Using cloud browser in ChatGPT; Scheduled tasks in ChatGPT. Claude Help Center, Claude Cowork and chat are one Claude; Get started with Claude in Chrome. Gemini Apps Help, Schedule actions in Gemini Apps. Read 16 September 2026 and 17 September 2026.
Several agents on one task
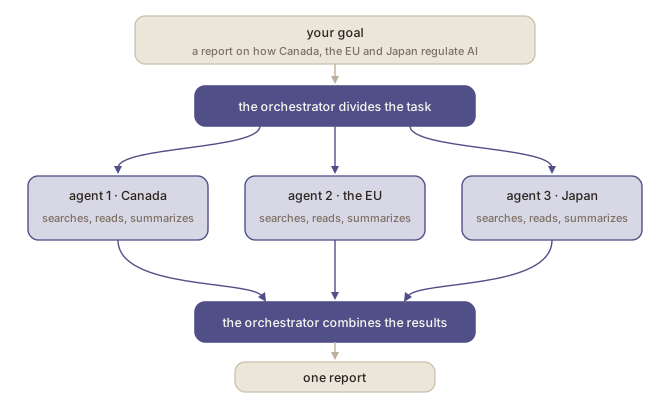
Some systems, for instance for scientific research or software development, divide one task among several agents, each given a part of it. An orchestrator receives the request, assigns the parts to specialized agents and combines what they return (Peykani et al., 2026, p. 18) (Figure 30figure 30). The agents work at the same time, each with its own context, so the task can be broader than one context has room for, and is done sooner.
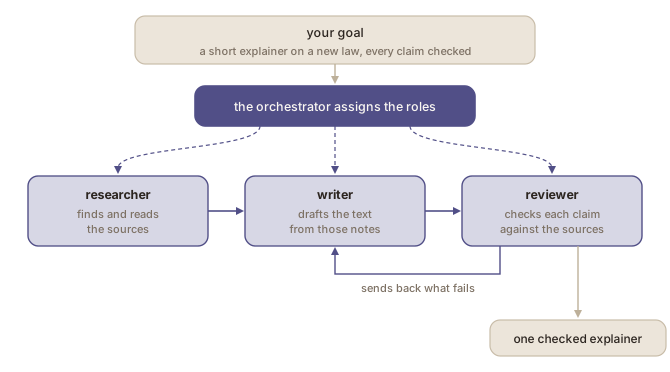
The parts need not be versions of one task. Each agent can instead be given a different role, and the roles can run side by side or in sequence, one agent’s output becoming the next one’s material (Peykani et al., 2026, pp. 2, 11). One agent might gather the sources, another draft the text, a third check each claim against the sources and send back the claims they do not support (Figure 31figure 31). The reviewer in such a chain is a model too, so its checks narrow the errors without ruling them out.
Chat products use the same arrangement. Claude’s Research, for instance, has a lead agent send several subagents searching in parallel and write the report from what they bring back. The cost grows with it: by Anthropic’s own measurement, such a system uses about fifteen times as many tokens as a chat.Anthropic, How we built our multi-agent research system, 13 June 2025, read 17 September 2026: “a lead agent coordinates the process while delegating to specialized subagents that operate in parallel”; “multi-agent systems use about 15× more tokens than chats”.
What changes for you
The goal replaces the conversation. In a chat you correct the answer as you go. Here you describe the result once and read it at the end, so the result depends on what you specify at the start: the material to use, the form of the result, what to do when something is missing.
A mistake propagates. Each step starts from the result of the last, so a file misread at step two is a table that is wrong at step four (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML). Nothing in the run catches that, since nothing in it has the right answer to compare against.
Its account of the run is not evidence. A list of steps, and a summary of what was done, are generated text like the rest of the answer. The result itself can be checked: the file, the changes made, the sources listed.
Acting is a different risk from answering. An agent that can send an email, change a file or buy something can do it wrongly, and a web page or a message it reads on the way can contain instructions aimed at it, which is called prompt injection prompt injectioninfiltration de requête AI safetysécurité de l'IA An attack in which untrusted input is incorporated into a prompt and interpreted by a generative AI system as instructions, causing the system to disregard or conflict with its intended instructions or to produce unintended outputs or actions.Attaque dans laquelle une entrée non fiable est incorporée à une requête et interprétée par un système d'IA générative comme des instructions, amenant le système à ignorer ou à contredire ses instructions prévues, ou à produire des sorties ou des actions non voulues. . Anything you cannot undo is best kept behind your approval, and the permissions of each connection decide what it may reach in the first place (see also the Code execution and connectors page) (voir aussi la page L'exécution de code et les connecteurs).
What a plan includes
These runs cost minutes of computing rather than one answer, so the plans limit them: an agent is usually on the paid plans, or comes with an allowance that resets, and the free plans get a few runs at most. Names, plans and limits change several times a year, so consult your provider’s plan comparison pages to get up-to-date information.Anthropic, plans and pricing; OpenAI, ChatGPT pricing. Read 16 September 2026.
Un objectif plutôt qu’une question
Un échange ordinaire avec un agent conversationnel, c’est une question et une réponse : vous lisez ce qui revient et décidez de ce que vous demanderez ensuite. À un agent AI agentagent agentsagents An AI system that selects and carries out actions toward a goal, often by using tools or calling other programs and adapting later actions to the results it receives.Système d'IA qui choisit et exécute des actions en vue d'un but, souvent en utilisant des outils ou en appelant d'autres programmes et en adaptant ses actions ultérieures aux résultats reçus. , on confie plutôt un objectif, et c’est l’agent conversationnel qui décide de la suite, étape après étape, jusqu’à produire un résultat (Figure 27figure 27). Une recherche approfondie en est un exemple (see also the Deep research page) (voir aussi la page La recherche approfondie) : vous posez une question, et des dizaines de recherches en découlent sans que vous les choisissiez.
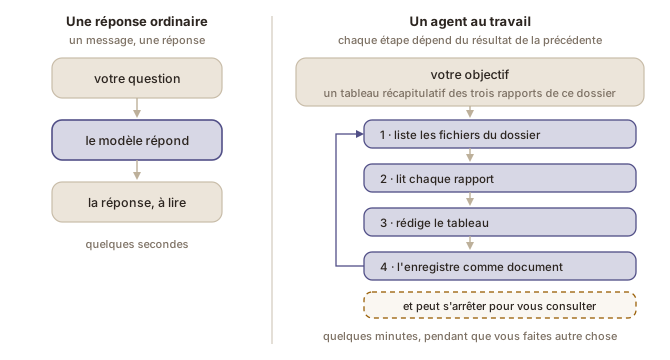
Le modèle lui-même ne change pas : la même prédiction du jeton suivant next-token predictionprédiction du jeton suivant language modelsmodèles de langue The task of estimating the probabilities of the tokens that could follow a given sequence of tokens.Tâche consistant à estimer les probabilités des jetons qui pourraient suivre une séquence de jetons donnée. , relancée à chaque étape, dont la sortie est acheminée vers des programmes et dont les résultats sont ajoutés au contexte. La différence, c’est que personne ne lit les résultats intermédiaires avant l’étape suivante.
Invité à créer une application d’étude à partir du glossaire de ce site, Claude a lancé plus de vingt commandes avant de répondre, chacune choisie d’après ce que la précédente avait renvoyé : démêler des entrées en double, compter les termes, repérer les lacunes du glossaire, concevoir l’interface (Figure 28figure 28). Deux des étapes ont ajouté du texte au contexte, une note tirée de sa mémoire et les instructions d’une compétence (see also the What a chat product adds to the model page) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle). Deux fichiers sont revenus, l’application et les termes sous forme de tableau (Figure 29figure 29).
Ce qu’on demande aux agents
Les agents conversationnels offrent cette possibilité pour quelques types de travail :
- Un résultat fini, comme un rapport, une feuille de calcul ou une présentation. Vous décrivez ce que vous voulez et fournissez le matériel, et les fichiers vous reviennent pour que vous les modifiiez.
- La conduite d’un navigateur ou de votre ordinateur, en lisant l’écran, en cliquant et en tapant : c’est ce qu’on appelle l’utilisation d’un ordinateur computer useutilisation d'un ordinateur agentsagents The capability of AI systems to control computer interfaces through screenshots, mouse movements, and keyboard input, to carry out a task.Capacité de systèmes d'IA à commander des interfaces informatiques au moyen de captures d'écran, de mouvements de souris et de saisies au clavier pour accomplir une tâche. . Elle se présente sous la forme d’un navigateur intégré à l’application de bureau, d’une extension qui pilote le navigateur que vous utilisez déjà, ou d’un navigateur qui tourne sur les machines du fournisseur et continue de travailler après la fermeture du vôtre.
- Des projets logiciels, le travail des agents de programmation comme Claude Code et Codex.
- Des tâches planifiées : une demande relancée d’elle-même, une fois ou chaque semaine, comme un résumé quotidien de vos messages ou un sujet à suivre. Certains produits peuvent aussi lancer une tâche quand quelque chose se produit dans un service connecté, par exemple à l’arrivée d’un courriel.
La plupart de ce travail tourne sur les machines du fournisseur et se poursuit donc quand votre ordinateur est éteint ; un travail sur les fichiers ou les applications de votre propre machine exige que l’application de bureau soit ouverte.OpenAI Help Center, ChatGPT Work and Codex : « Work is an agent designed for longer, multi-step work and finished deliverables » ; Using cloud browser in ChatGPT ; Scheduled tasks in ChatGPT. Claude Help Center, Claude Cowork and chat are one Claude ; Get started with Claude in Chrome. Gemini Apps Help, Schedule actions in Gemini Apps. Consultés le 16 septembre 2026 et le 17 septembre 2026.
Plusieurs agents pour une même tâche
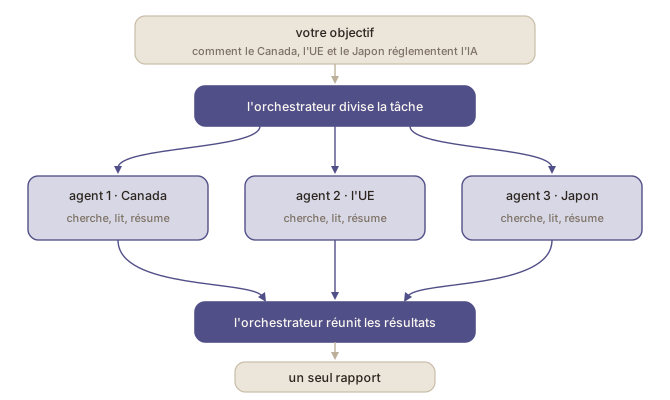
Certains systèmes, par exemple en recherche scientifique ou en développement logiciel, répartissent une tâche entre plusieurs agents, chacun chargé d’une partie. Un orchestrateur reçoit la demande, confie les parties à des agents spécialisés et réunit ce qu’ils renvoient (Peykani et al., 2026, p. 18) (Figure 30figure 30). Les agents travaillent en même temps, chacun avec son propre contexte : la tâche peut donc être plus vaste que ce que contiendrait un seul contexte, et elle est terminée plus tôt.
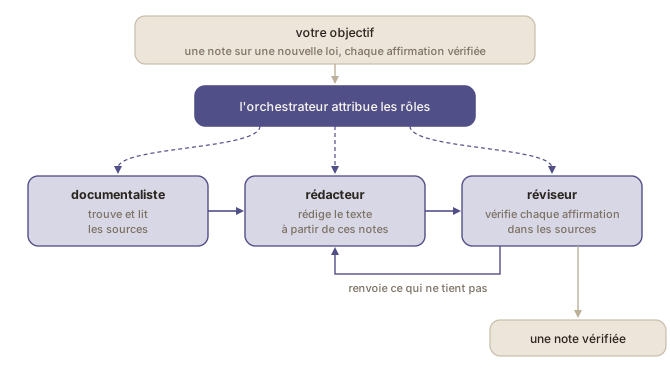
Les parties ne sont pas forcément des variantes d’une même tâche. Chaque agent peut aussi recevoir un rôle différent, et les rôles peuvent s’exercer côte à côte ou à la suite, le résultat d’un agent devenant le matériel du suivant (Peykani et al., 2026, p. 2 et 11). Un agent peut rassembler les sources, un autre rédiger le texte, un troisième vérifier chaque affirmation dans les sources et renvoyer ce qui ne tient pas (Figure 31figure 31). Dans une telle chaîne, le réviseur est lui aussi un modèle : ses vérifications réduisent les erreurs sans les exclure.
Les agents conversationnels utilisent le même dispositif. Dans la fonction Research de Claude, par exemple, un agent principal envoie plusieurs sous-agents chercher en parallèle, puis rédige le rapport à partir de ce qu’ils rapportent. Le coût augmente d’autant : selon la mesure d’Anthropic elle-même, un tel système consomme environ quinze fois plus de jetons qu’une conversation.Anthropic, How we built our multi-agent research system, 13 juin 2025, consulté le 17 septembre 2026 : « a lead agent coordinates the process while delegating to specialized subagents that operate in parallel » ; « multi-agent systems use about 15× more tokens than chats ».
Ce qui change pour vous
L’objectif remplace la conversation. Dans une conversation, vous corrigez la réponse au fur et à mesure. Ici, vous décrivez le résultat une fois et vous le lisez à la fin : le résultat dépend donc de ce que vous précisez au départ, soit le matériel à utiliser, la forme du résultat, ce qu’il faut faire quand quelque chose manque.
Une erreur se propage. Chaque étape part du résultat de la précédente : un fichier mal lu à l’étape deux devient un tableau faux à l’étape quatre (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML). Rien dans le déroulement ne le relève, puisque rien n’y dispose de la bonne réponse pour comparer.
Son compte rendu du travail ne prouve rien. Une liste d’étapes, et un résumé de ce qui a été fait, sont du texte généré comme le reste de la réponse. Le résultat lui-même peut être vérifié : le fichier, les modifications faites, les sources citées.
Agir comporte un autre risque que répondre. Un agent qui peut envoyer un courriel, modifier un fichier ou acheter quelque chose peut le faire de travers, et une page Web ou un message qu’il lit en chemin peut contenir des instructions qui lui sont destinées, ce qu’on appelle l’infiltration de requête prompt injectioninfiltration de requête AI safetysécurité de l'IA An attack in which untrusted input is incorporated into a prompt and interpreted by a generative AI system as instructions, causing the system to disregard or conflict with its intended instructions or to produce unintended outputs or actions.Attaque dans laquelle une entrée non fiable est incorporée à une requête et interprétée par un système d'IA générative comme des instructions, amenant le système à ignorer ou à contredire ses instructions prévues, ou à produire des sorties ou des actions non voulues. . Mieux vaut réserver à votre approbation tout ce qui est irréversible, et les autorisations de chaque connexion déterminent d’emblée ce qu’il peut atteindre (see also the Code execution and connectors page) (voir aussi la page L'exécution de code et les connecteurs).
Ce que comprend un forfait
Ces tâches coûtent des minutes de calcul plutôt qu’une seule réponse, et les forfaits les limitent donc : un agent est d’habitude réservé aux forfaits payants ou s’accompagne d’une allocation qui se renouvelle, et les forfaits gratuits n’ont droit qu’à quelques exécutions au plus. Les noms, les forfaits et les limites changent plusieurs fois par an : consultez les pages de comparaison des forfaits de votre fournisseur pour obtenir une information à jour.Anthropic, plans and pricing ; OpenAI, ChatGPT pricing. Consultés le 16 septembre 2026.
Sources
- Peykani, P., Ghanidel, S., Javadi-Sisi, I., Snasel, V., & Mirjalili, S. (2026). A Holistic Review of Agentic AI Frameworks, Applications, and Research Trajectories. Archives of Computational Methods in Engineering. https://doi.org/10.1007/s11831-026-10675-8
Sources
- Peykani, P., Ghanidel, S., Javadi-Sisi, I., Snasel, V., & Mirjalili, S. (2026). A Holistic Review of Agentic AI Frameworks, Applications, and Research Trajectories. Archives of Computational Methods in Engineering. https://doi.org/10.1007/s11831-026-10675-8