From NLP pipelines to language modelsDes chaînes de traitement aux modèles de langue
TRA2600 S5 · in classS5 · en classe
Pipelines and single models
Until recently, a system that did something with a text did it in steps, and each step was one task of the field. A program that extracts the names of companies from news articles first cuts the text into words, then labels each word with its grammatical class, then groups the words into phrases, and only then decides which phrases are names, which is named entity recognition named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. . Each step takes the output of the one before it as its input, which is why the arrangement is called a pipeline (Figure 4figure 4).
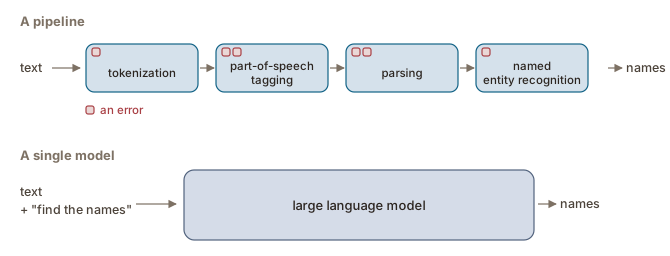
A large language model large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. can instead be asked for the end result directly: given a text and the instruction list the names of companies in this text, it returns a list, with no visible steps in between. For many tasks, that is now how the work gets done, and for most NLP tasks the best scores are reached by neural models of one kind or another, trained on large amounts of text (Jurafsky & Martin, 2026). The table below compares the two ways of working.
| Aspect | Pipeline | Single large language model |
|---|---|---|
| Building the system | Each component is built separately, with its own rules or annotated corpus and its own evaluation: a modest effort each time, for many components | Pretraining pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. one model takes an immense investment, which only a few organizations can make (see also the Who can afford to pretrain page, in the LLM lifecycle module) (voir aussi la page Qui peut se permettre un préentraînement, dans le module Cycle de vie des GML) |
| Taking on a new task | A new component, with new rules or a new annotated corpus | Often just a description of the task in a prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. , sometimes with a few examples or some fine-tuning fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. |
| What a user can reach | A ready-made tool for common tasks, but nothing for the others unless someone builds it | One tool for almost any task, through a chat window or a programming interface |
| Running it | Light: fast on an ordinary computer | More computing per text, usually on a provider’s servers, although smaller and faster models exist |
| Errors | An early error is passed down the line and can cause others; a later step can also be robust to it | No intermediate output, so no error is handed from step to step |
| Finding and fixing an error | You can see at which step an error was made and improve that step | Only the end result is visible; a user can rephrase the prompt, and changing the model is work for its developer or for someone fine-tuning it |
| Predictability | The same input gives the same output every time | The output can vary from one run to the next (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML) |
| Control and confidentiality | Often runs on your own computer, although many tools, machine translation among them, are online services | Usually a service run by a provider, which receives the text, although some models can run on your own computer |
The tasks have not disappeared. They are still the units in which systems are judged: a model is evaluated on named entity recognition, on translation or on summarization, one task at a time, against answers produced by people, and that is how its strengths and its gaps are found (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières). And pipelines still run inside many of the tools you use: the spelling and grammar checker of a word processor, the way a search engine matches a query to pages, or the spam filter of an email inbox are built from components of this kind.
Chaînes de traitement et modèle unique
Jusqu’à récemment, un système qui faisait quelque chose d’un texte procédait par étapes, et chaque étape était une tâche du domaine. Un programme qui extrait les noms d’entreprises d’articles de presse découpe d’abord le texte en mots, attribue ensuite à chaque mot sa catégorie grammaticale, regroupe les mots en syntagmes et ne décide qu’alors quels syntagmes sont des noms, ce qui est la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. . Chaque étape prend en entrée la sortie de la précédente, d’où le nom de chaîne de traitement (angl. pipeline) (Figure 4figure 4).
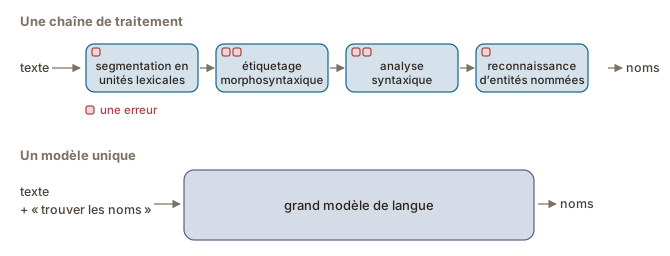
Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. peut au contraire être interrogé directement sur le résultat final : avec un texte et la consigne dresse la liste des noms d’entreprises de ce texte, il renvoie une liste, sans étape visible entre les deux. Pour de nombreuses tâches, c’est désormais ainsi que le travail se fait, et pour la plupart des tâches du TAL, les meilleurs scores sont atteints par des modèles neuronaux d’un type ou d’un autre, entraînés sur de grandes quantités de texte (Jurafsky & Martin, 2026). Le tableau ci-dessous compare les deux façons de travailler.
| Aspect | Chaîne de traitement | Grand modèle de langue unique |
|---|---|---|
| Construire le système | Chaque composant se construit séparément, avec ses propres règles ou son propre corpus annoté et sa propre évaluation : un effort modeste chaque fois, pour de nombreux composants | Le préentraînement pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. d’un seul modèle exige un investissement immense, que seules quelques organisations peuvent faire (see also the Who can afford to pretrain page, in the LLM lifecycle module) (voir aussi la page Qui peut se permettre un préentraînement, dans le module Cycle de vie des GML) |
| Prendre en charge une nouvelle tâche | Un nouveau composant, avec de nouvelles règles ou un nouveau corpus annoté | Souvent une simple description de la tâche dans une requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. , parfois avec quelques exemples ou un affinage fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. |
| Ce à quoi on a accès comme utilisateur | Un outil prêt à l’emploi pour les tâches courantes, mais rien pour les autres tant que personne ne le construit | Un seul outil pour presque toutes les tâches, par une fenêtre de clavardage ou une interface de programmation |
| L’exécuter | Léger : rapide sur un ordinateur ordinaire | Plus de calcul par texte, généralement sur les serveurs d’un fournisseur, même si des modèles plus petits et plus rapides existent |
| Les erreurs | Une erreur précoce se transmet le long de la chaîne et peut en causer d’autres ; une étape ultérieure peut aussi y résister | Pas de sortie intermédiaire, donc aucune erreur ne passe d’une étape à l’autre |
| Trouver et corriger une erreur | On voit à quelle étape une erreur s’est produite et on peut améliorer cette étape | Seul le résultat final est visible ; on peut reformuler la requête, et modifier le modèle revient à la personne qui l’a conçu ou à qui l’affine |
| Prévisibilité | La même entrée donne toujours la même sortie | La sortie peut varier d’une exécution à l’autre (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML) |
| Maîtrise et confidentialité | Tourne souvent sur votre propre ordinateur, même si beaucoup d’outils, dont la traduction automatique, sont des services en ligne | Généralement un service exploité par un fournisseur, qui reçoit le texte, même si certains modèles peuvent tourner sur votre propre ordinateur |
Les tâches n’ont pas disparu. Elles restent les unités dans lesquelles on évalue les systèmes : un modèle est évalué sur la reconnaissance d’entités nommées, la traduction ou le résumé automatique, une tâche à la fois, par rapport à des réponses produites par des personnes, et c’est ainsi qu’on découvre ses forces et ses lacunes (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières). Et des chaînes de traitement fonctionnent encore dans bien des outils que vous utilisez : le correcteur orthographique et grammatical d’un traitement de texte, la façon dont un moteur de recherche associe une requête à des pages ou le filtre antipourriel d’une messagerie sont construits à partir de composants de ce type.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/