Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
What the last two chapters settled
| The idea | What it gives | What it costs |
|---|---|---|
| A number per word, alphabetically | An identifier | An order and an arithmetic that mean nothing |
| A vector vectorvecteur machine learningapprentissage automatique An ordered list of numbers.Liste ordonnée de nombres. per word | Coordinates in a space, so distances exist | Nothing yet: the space has to be built |
| A one-hot vector | Identity with no false order | Every pair equally distant; 99,999 zeros per word |
What is still missing
- Numbers that say how words relate. So far cat is exactly as far from dog as it is from democracy.
- A representation that stays manageable and still says something. Giving every word its own slot takes tens of thousands of numbers to say one thing, and all but one of them are zero.
- A representation that can change with the sentence. Bank does not mean the same thing in every sentence it appears in, and one fixed set of numbers per word cannot follow that.
This chapter answers the first two. The third takes a chapter of its own (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
Words as coordinates
Suppose you want to place words in a two-dimensional space. You give the horizontal axis one meaning and the vertical axis another, then put each word where it belongs relative to those two meanings. Every word ends up with coordinates, which is to say a vector vectorvecteur machine learningapprentissage automatique An ordered list of numbers.Liste ordonnée de nombres. : here a list of two numbers, one per axis. Those numbers do more than locate the word. They say how it stands on each of the two meanings, and how far it is from every other word in the same space.
Speed and capacity
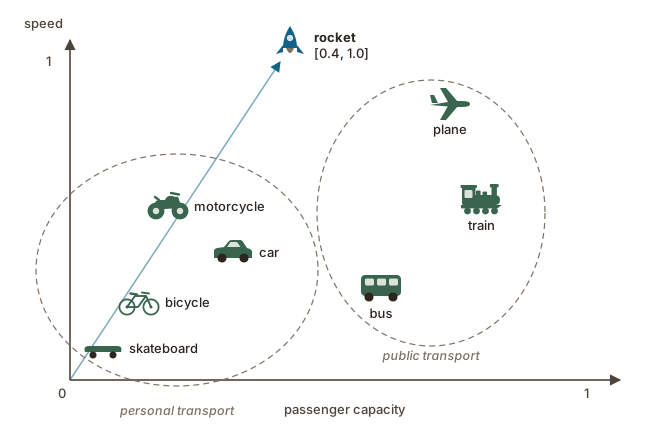
The idea is worked out for means of transport in Figure 1figure 1. The horizontal axis is passenger capacity and the vertical axis is speed, and most people would agree on roughly where each vehicle goes. A skateboard scores low on both: it does not travel fast and it carries one person. A rocket has maximal speed and more moderate capacity, giving it the vector [0.4, 1.0]. Where a one-hot vector only identified a word, that pair of numbers says something about the thing named, and it fixes how far the rocket stands from every other vehicle in the space.
Placing words this way also makes groups form on their own. Personal transport gathers on the left, public transport on the right, and the rocket sits apart, which is where it belongs. Nobody drew those groups; they follow from the coordinates.
Where the apple goes
So far this looks like a promising way to turn words into lists of numbers that mean something. Then: where would you put an apple in this space? The question makes no sense, because speed and capacity say nothing about an apple.
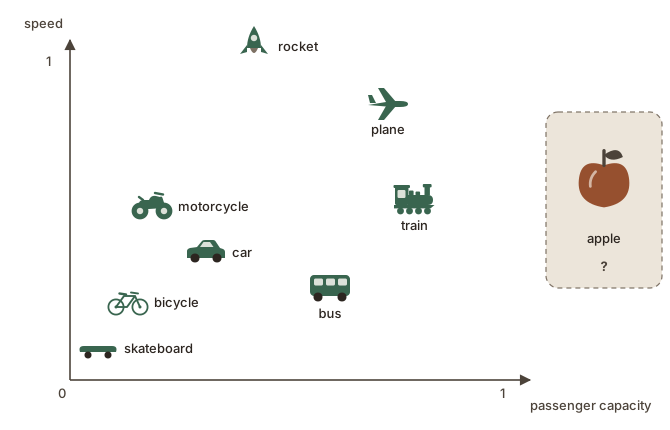
Two things follow. A space that fits a whole vocabulary needs many more than two dimensions, since it has to suit everything from skateboard to ardour. And once there are hundreds of dimensions and tens of thousands of words, neither the axes nor the positions can be chosen by a person.
Which leaves the question: how can numbers like these be found automatically, for every word in a vocabulary?
Build the transport space with the room before showing it: speed on one axis, capacity on the other, then ask where a skateboard, a bus and a rocket go. The apple is the screen after it, and the question that kills the hand-made version.
Five blanks
Suppose you are given five fragments of text, each with one word missing:
- have a ___ as pet
- pet the ___ of the
- and the ___ purrs loudly
- walk your ___ on a leash
- does the ___ love music
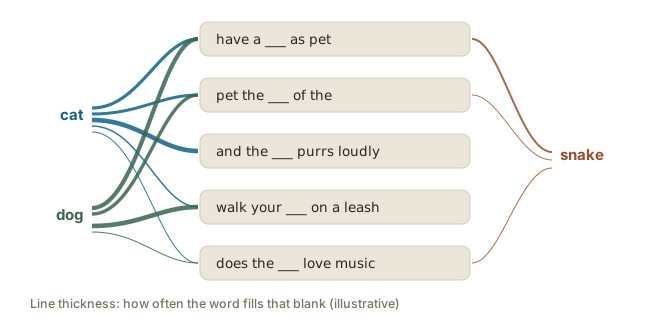
Which words could fill the blank? Cat goes into the first three without any trouble; the leash makes you hesitate. Dog goes into the pet, the petting and the leash, and fails at the purring. The last fragment takes any of them, which is why it tells you so little. So the two words share most of their contexts, and the ones they do not share are exactly the ones you would expect: a cat purrs, a dog is walked.
Now try snake. It fits have a ___ as pet, and after that it gets harder: a snake does not purr, and a snake on a leash is a very big stretch. Snake shares one or two contexts with cat and dog and not the rest. A word like democracy fits none of the five.
Not only whether a word can fill a blank counts, but how often it does. Cat turns up before purrs far more often than after walk your, and a system that counts contexts in a large collection of text sees that difference directly.
What the blanks show
Words with related meanings turn up in similar contexts, and the more two words’ contexts overlap, the closer their meanings tend to be. Linguists formulated this in the 1950s, Joos, Harris and Firth among them (Jurafsky & Martin, 2026), and Firth put it in one sentence: “You shall know a word by the company it keeps” (Firth, 1957).
Why this suits a machine
The idea is useful for a machine because of what it does not require:
- No definitions. Nobody has to say what cat means.
- No labels. Nobody has to mark examples by hand.
- No hand-picked axes. Nobody chooses the dimensions of the space, or where each word goes on them.
It does require text, in quantity. Contexts are observable: any large collection of text shows directly which words surround which. So a system can build a workable stand-in for meaning just by reading enough text.
Run the five blanks out loud and let the room fill them, one word at a time: cat, then dog, then snake, then democracy. Then the figure, then the Firth sentence.
Learning the positions from text
Mikolov et al. (2013a) published word2vec, a pair of architectures that put the distributional hypothesis distributional hypothesishypothèse distributionnelle embeddingsplongements The linguistic hypothesis that patterns of word use provide evidence about meaning: words that occur with similar neighbouring words are likely to have related or similar meanings.Hypothèse linguistique selon laquelle les régularités d'emploi des mots renseignent sur leur sens : les mots qui apparaissent avec des voisins semblables ont vraisemblablement des sens apparentés ou proches. to work at scale. Each word starts with a vector of a few hundred numbers, and those numbers are then adjusted on millions of sentences, nudging words toward each other whenever they occur in similar contexts. The method spread because it was efficient: high-quality vectors from 1.6 billion words in under a day, where earlier neural approaches cost far more. Related methods followed, GloVe among them (Pennington et al., 2014), and the family became the standard representation of words. Every word in the vocabulary vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. ends up with a vector, and all of them together make one embedding space.
Short, dense, and distances that mean something
Every property of these vectors contrasts with the one-hot representation:
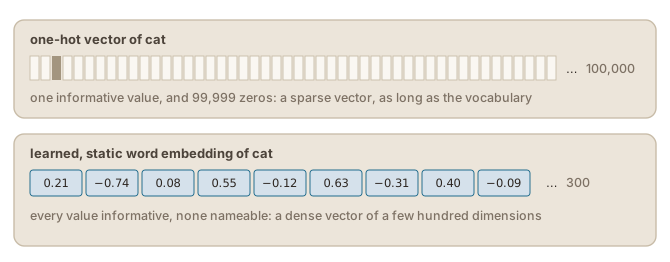
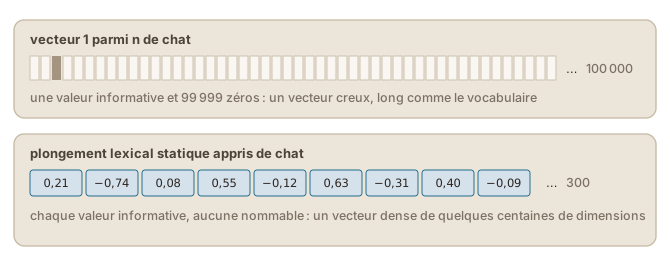
- Short instead of vocabulary-sized. Typically 100 to 300 dimensions rather than one per word.
- Dense instead of sparse. Every position has a meaningful value rather than a zero.
- Distance means something. Cat and dog end up close, snake farther, democracy elsewhere entirely, because their contexts imposed it during training.
No readable axes
The example with our means of transport showed axes that were interpretable: speed and capacity. The learned dimensions are not. They do not correspond to any nameable property, and looking at one value tells you nothing. In this representation a word’s meaning is the whole pattern of all its values together, and only comparisons between whole vectors are meaningful.
The habit to break: no single dimension stands for anything nameable. Only whole vectors compare. Say it explicitly, because the transport figure has just taught the opposite.
King minus man plus woman
Static word embeddings static word embeddingplongement lexical statique embeddingsplongements A numerical representation that assigns each word type, meaning each distinct word in a vocabulary, a single fixed vector learned from patterns in a corpus.Représentation numérique qui attribue à chaque type de mot, c'est-à-dire à chaque mot distinct d'un vocabulaire, un unique vecteur fixe appris à partir des régularités d'un corpus. like word2vec, one fixed vector per word, let you do arithmetic with words.
Take the vector for king, subtract the vector for man, and add the vector for woman. The point you land on is nearest the word queen (Mikolov et al., 2013b). Nothing in the training aimed at this. It falls out of the geometry: the displacement from man to king encodes something like royalty, and applying that same displacement to woman arrives near queen.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
One direction among many
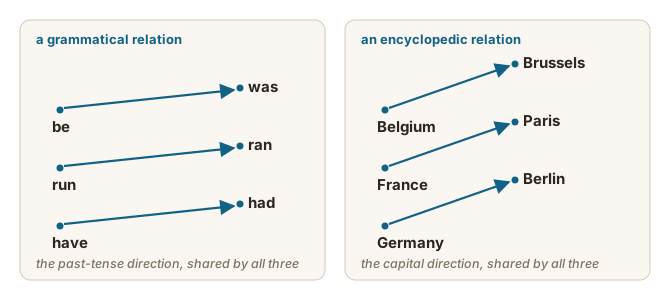
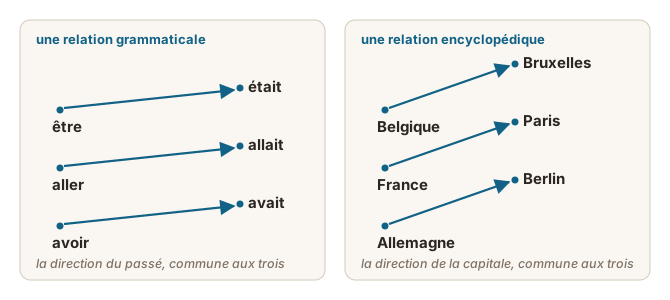
The royalty direction is one of many. Mikolov et al. (2013b) tested the pattern systematically on grammatical relations, a thousand questions each for comparatives (good is to better as rough is to rougher), plurals (year is to years) and verb tense (see is to saw as return is to returned), and found it there too. Encyclopedic relations behave the same way, a country and its capital among them (Jurafsky & Martin, 2026). The axes are still unreadable. The meaning is in the directions between whole vectors, and those can be looked for after the fact.
Carnegie Mellon’s browser demo does exactly that. The three screenshots below were taken from it on 9 September 2026, and the demo can change. They are dense, and a click opens each one larger.
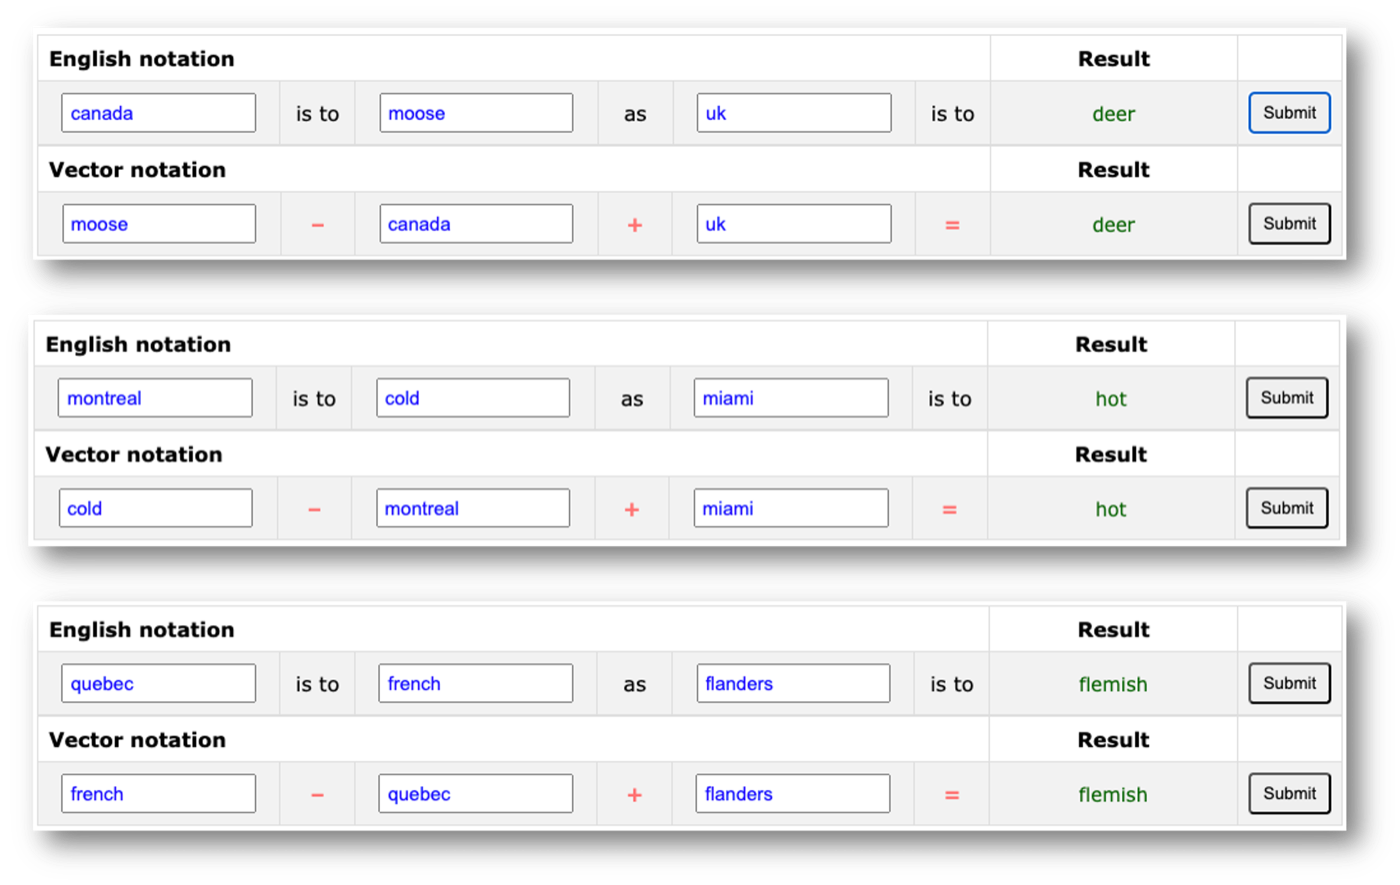
The same arithmetic on stereotypes
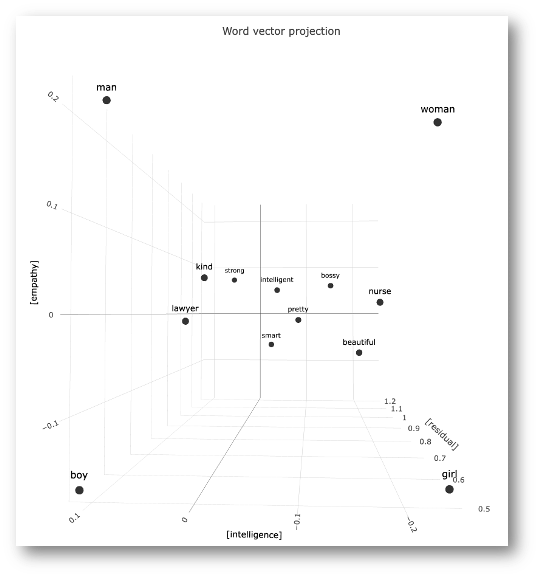
The arithmetic works on stereotypes too. In embeddings trained on Google News articles, man is to computer programmer as woman is to homemaker, and occupation words divide along a gender direction the same way king and queen divide along a royalty one (Bolukbasi et al., 2016).
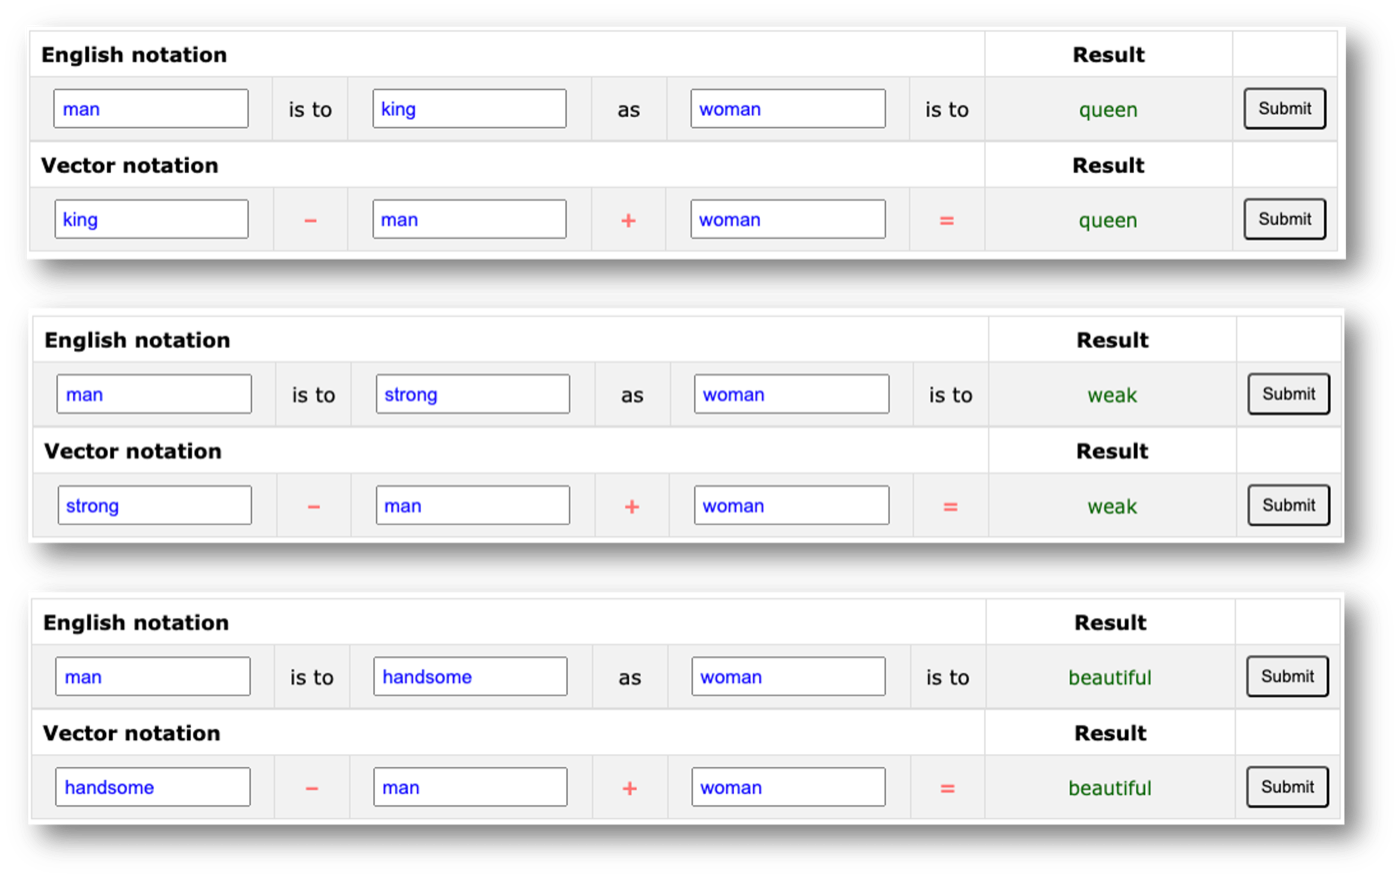
No programmer decided to put woman further from doctor and closer to nurse. The bias comes from the text: the vectors record how the words are used across millions of sentences, and people wrote those sentences. The method is working as designed. The consequences reach everything built on embeddings since (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML).
The CMU demo runs in a browser on word2vec and GloVe: try king − man + woman live, then take an analogy from the room’s working languages. Ask for an occupation analogy before showing the Bolukbasi result, so the bias arrives as something the room produced rather than as a warning.
Three limitations
New words get nothing
An embedding model has one vector for each word that occurred in its training text, so a word coined last year, a rare technical term or a typo has no vector and no representation at all. Morphologically rich languages make this worse, since their productive compounds and inflections produce forms no training corpus contains. Modern systems dissolve the problem by working with pieces of words instead (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres).
One vector averages every sense
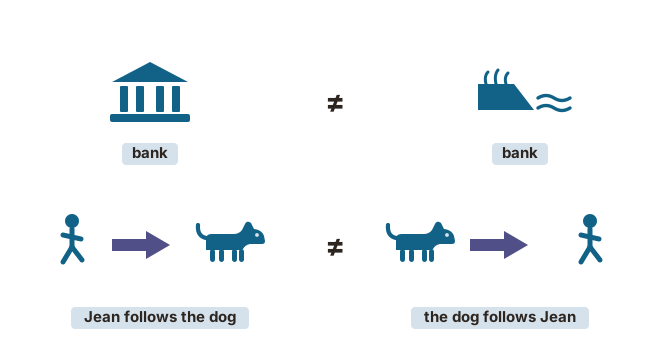
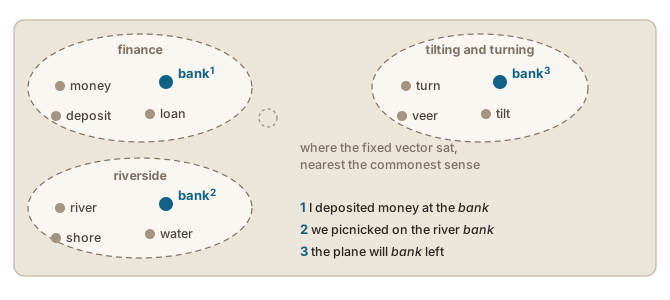
Bank is a financial institution in I deposited money at the bank and a strip of riverside in we picnicked on the river bank. A single vector for bank has to serve both sentences, so it lands somewhere between finance and geography, a compromise that is wrong everywhere. It is not even a fair compromise: the vector is an average over occurrences, so it sits nearest whichever sense is commonest in the training text, and the rarer sense is served worst. Translation feels this early, since choosing between rive and banque is exactly a decision about which sense is active.
Order is invisible
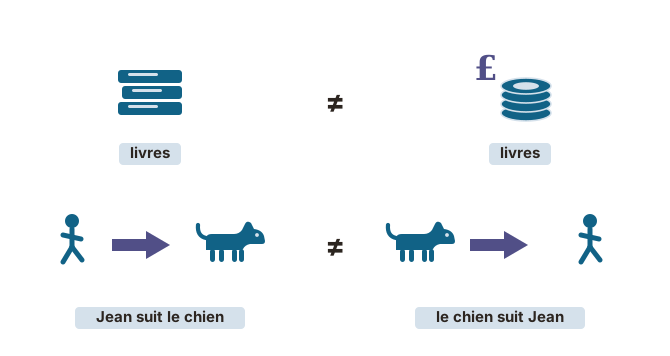
The dog follows Jean and Jean follows the dog contain the same words and do not describe the same walk, so any representation built by combining fixed word vectors struggles to tell them apart. Meaning depends on arrangement, and per-word vectors have nowhere to put arrangement.
Ce que les deux chapitres précédents ont établi
| L’idée | Ce qu’elle apporte | Ce qu’elle coûte |
|---|---|---|
| Un nombre par mot, par ordre alphabétique | Un identifiant | Un ordre et une arithmétique qui ne veulent rien dire |
| Un vecteur vectorvecteur machine learningapprentissage automatique An ordered list of numbers.Liste ordonnée de nombres. par mot | Des coordonnées dans un espace, donc des distances | Rien encore : l’espace reste à construire |
| Un vecteur 1 parmi n | Une identité sans faux ordre | Toutes les paires à égale distance ; 99 999 zéros par mot |
Ce qui manque encore
- Des nombres qui disent comment les mots se rapportent. Jusqu’ici, chat est exactement aussi loin de chien que de démocratie.
- Une représentation qui reste maniable et qui dit quelque chose. Donner à chaque mot sa propre case demande des dizaines de milliers de nombres pour dire une seule chose, et tous sauf un valent zéro.
- Une représentation qui peut changer avec la phrase. Livres ne veut pas dire la même chose dans toutes les phrases où le mot apparaît, et un seul jeu de nombres fixe par mot ne peut pas suivre.
Ce chapitre répond aux deux premiers points. Le troisième demande un chapitre à lui seul (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
Les mots comme coordonnées
Supposons que vous vouliez placer des mots dans un espace à deux dimensions. Vous donnez un sens à l’axe horizontal et un autre à l’axe vertical, puis vous posez chaque mot là où il se situe par rapport à ces deux sens. Chaque mot se retrouve avec des coordonnées, c’est-à-dire un vecteur vectorvecteur machine learningapprentissage automatique An ordered list of numbers.Liste ordonnée de nombres. : ici une liste de deux nombres, un par axe. Ces nombres font plus que localiser le mot. Ils disent comment il se situe sur chacun des deux sens, et à quelle distance il se trouve de tous les autres mots du même espace.
La vitesse et le nombre de passagers
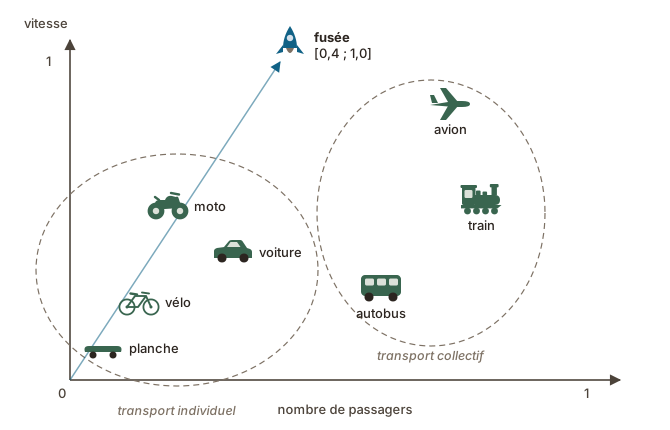
L’idée est développée pour des moyens de transport dans la Figure 1figure 1. L’axe horizontal est le nombre de passagers et l’axe vertical la vitesse, et la plupart des gens s’entendraient sur la place approximative de chaque véhicule. La planche est basse sur les deux : elle ne va pas vite et elle transporte une personne. La fusée a une vitesse maximale et une capacité plus modeste, ce qui lui donne le vecteur [0,4 ; 1,0]. Là où un vecteur 1 parmi n ne faisait qu’identifier un mot, cette paire de nombres dit quelque chose de la chose nommée, et elle fixe la distance entre la fusée et tous les autres véhicules de l’espace.
Placer les mots de cette façon fait aussi apparaître des groupes d’eux-mêmes. Le transport individuel se rassemble à gauche, le transport collectif à droite, et la fusée reste à part, là où elle a sa place. Personne n’a dessiné ces groupes ; ils découlent des coordonnées.
Où placer la pomme
Jusqu’ici, voilà une manière prometteuse de transformer des mots en listes de nombres qui veulent dire quelque chose. Puis : où placeriez-vous une pomme dans cet espace ? La question n’a aucun sens, parce que la vitesse et le nombre de passagers ne disent rien d’une pomme.
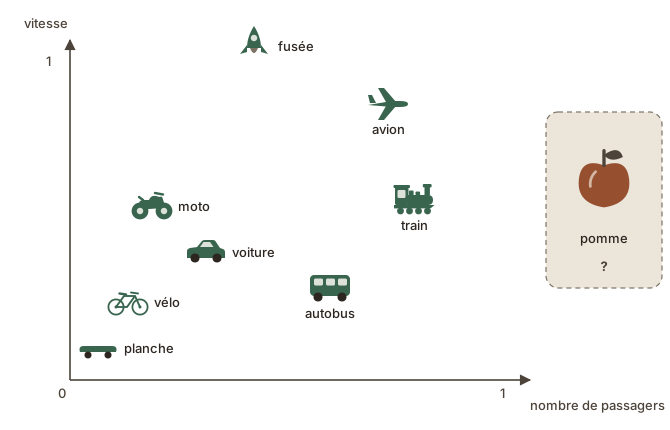
Deux conséquences. Un espace qui accueille un vocabulaire entier a besoin de bien plus de deux dimensions, puisqu’il doit convenir à tout, de planche à ardeur. Et dès qu’il y a des centaines de dimensions et des dizaines de milliers de mots, ni les axes ni les positions ne peuvent être choisis par une personne.
Reste la question : comment trouver automatiquement de tels nombres, pour chaque mot d’un vocabulaire ?
Construire l’espace des transports avec le groupe avant de le montrer : la vitesse sur un axe, le nombre de passagers sur l’autre, puis demander où vont une planche, un autobus et une fusée. La pomme arrive à l’écran suivant, avec la question qui tue la version faite à la main.
Cinq trous
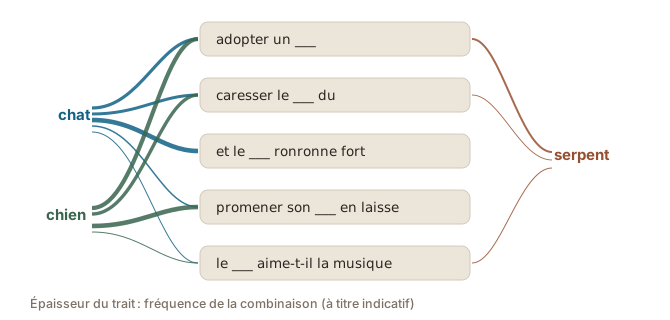
Supposons qu’on vous donne cinq fragments de texte, chacun avec un mot manquant :
- adopter un ___
- caresser le ___ du
- et le ___ ronronne fort
- promener son ___ en laisse
- le ___ aime-t-il la musique
Quels mots pourraient remplir le trou ? Chat entre sans peine dans les trois premiers ; la laisse fait hésiter. Chien entre dans l’adoption, la caresse et la laisse, et échoue sur le ronronnement. Le dernier fragment accepte n’importe lequel des trois, et c’est pourquoi il vous apprend si peu. Les deux mots partagent donc la plupart de leurs contextes, et ceux qu’ils ne partagent pas sont exactement ceux qu’on attendrait : un chat ronronne, on promène un chien.
Essayez maintenant serpent. Il va avec adopter un ___, et ensuite, cela se complique : un serpent ne ronronne pas, et un serpent en laisse, c’est vraiment tiré par les cheveux. Serpent partage un ou deux contextes avec chat et chien, et pas le reste. Un mot comme démocratie ne remplit aucun des cinq.
Il ne suffit pas qu’un mot puisse remplir un trou : la fréquence à laquelle il le fait compte aussi. Chat précède ronronne bien plus souvent qu’il ne suit promener son, et un système qui compte les contextes dans un grand ensemble de textes voit cette différence directement.
Ce que montrent les trous
Les mots dont le sens est apparenté apparaissent dans des contextes semblables, et plus les contextes de deux mots se recoupent, plus leurs sens ont tendance à être proches. Des linguistes l’ont formulé dans les années 1950, Joos, Harris et Firth parmi eux (Jurafsky et Martin, 2026), et Firth l’a résumé en une phrase : « You shall know a word by the company it keeps » (Firth, 1957).
Pourquoi cela convient à une machine
L’idée est utile à une machine par ce qu’elle n’exige pas :
- Aucune définition. Personne n’a à dire ce que chat veut dire.
- Aucune annotation. Personne n’a à marquer des exemples à la main.
- Aucun axe choisi à la main. Personne ne choisit les dimensions de l’espace, ni la place de chaque mot sur celles-ci.
Il faut en revanche du texte, en quantité. Les contextes sont observables : n’importe quel grand ensemble de textes montre directement quels mots entourent quels autres. Un système peut donc se construire un substitut utilisable du sens simplement en lisant assez de texte.
Lire les cinq trous à voix haute et laisser le groupe les remplir, un mot à la fois : chat, puis chien, puis serpent, puis démocratie. Ensuite la figure, puis la phrase de Firth.
Apprendre les positions à partir des textes
Mikolov et al. (2013a) publient word2vec, une paire d’architectures qui mettent l’hypothèse distributionnelle distributional hypothesishypothèse distributionnelle embeddingsplongements The linguistic hypothesis that patterns of word use provide evidence about meaning: words that occur with similar neighbouring words are likely to have related or similar meanings.Hypothèse linguistique selon laquelle les régularités d'emploi des mots renseignent sur leur sens : les mots qui apparaissent avec des voisins semblables ont vraisemblablement des sens apparentés ou proches. au travail à grande échelle. Chaque mot part d’un vecteur de quelques centaines de nombres, et ces nombres sont ensuite ajustés sur des millions de phrases, rapprochant les mots chaque fois qu’ils apparaissent dans des contextes semblables. La méthode s’est répandue parce qu’elle était efficace : des vecteurs de qualité obtenus à partir de 1,6 milliard de mots en moins d’une journée, là où les approches neuronales antérieures coûtaient bien davantage. D’autres méthodes ont suivi, dont GloVe (Pennington et al., 2014), et cette famille est devenue la représentation standard des mots. Chaque mot du vocabulaire vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. se retrouve avec un vecteur, et tous ensemble forment un espace de plongement.
Court, dense, et des distances qui veulent dire quelque chose
Chaque propriété de ces vecteurs contraste avec la représentation 1 parmi n :
- Court plutôt que long comme le vocabulaire. Typiquement de 100 à 300 dimensions, plutôt qu’une par mot.
- Dense plutôt que creux. Chaque position porte une valeur informative plutôt qu’un zéro.
- La distance veut dire quelque chose. Chat et chien se retrouvent proches, serpent plus loin, démocratie tout à fait ailleurs, parce que leurs contextes l’ont imposé pendant l’entraînement.
Des axes illisibles
L’exemple des moyens de transport montrait des axes interprétables : la vitesse et le nombre de passagers. Les dimensions apprises ne le sont pas. Elles ne correspondent à aucune propriété nommable, et regarder une seule valeur ne dit rien. Dans cette représentation, le sens d’un mot est le motif complet de toutes ses valeurs prises ensemble, et seules les comparaisons entre vecteurs entiers ont un sens.
L’habitude à casser : aucune dimension ne représente quoi que ce soit de nommable. Seuls des vecteurs entiers se comparent. Le dire explicitement, parce que la figure des transports vient d’enseigner le contraire.
Roi moins homme plus femme
Les plongements lexicaux statiques static word embeddingplongement lexical statique embeddingsplongements A numerical representation that assigns each word type, meaning each distinct word in a vocabulary, a single fixed vector learned from patterns in a corpus.Représentation numérique qui attribue à chaque type de mot, c'est-à-dire à chaque mot distinct d'un vocabulaire, un unique vecteur fixe appris à partir des régularités d'un corpus. comme word2vec, un vecteur fixe par mot, permettent de faire de l’arithmétique avec des mots.
Prenez le vecteur de roi, soustrayez le vecteur de homme, puis ajoutez le vecteur de femme. Le point où vous arrivez a pour plus proche voisin le mot reine (Mikolov et al., 2013b). Rien dans l’entraînement ne visait ce résultat. Il découle de la géométrie : le déplacement de homme vers roi encode quelque chose comme la royauté, et appliquer ce même déplacement à femme arrive près de reine.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Une direction parmi bien d’autres
La direction de la royauté est l’une parmi bien d’autres. Mikolov et al. (2013b) ont éprouvé le motif de façon systématique sur des relations grammaticales, mille questions chacune pour les comparatifs (good est à better ce que rough est à rougher), les pluriels (year est à years) et le temps des verbes (see est à saw ce que return est à returned), et il tenait. Les relations encyclopédiques se comportent de la même manière, dont celle d’un pays et de sa capitale (Jurafsky et Martin, 2026). Les axes restent illisibles. Le sens est dans les directions entre vecteurs entiers, et celles-ci peuvent se chercher après coup.
La démonstration en ligne de Carnegie Mellon fait exactement cela. Les trois captures ci-dessous en viennent, prises le 9 septembre 2026, et la démonstration peut changer. Elles sont denses ; un clic ouvre chacune en plus grand.
La même arithmétique sur les stéréotypes
L’arithmétique fonctionne aussi sur les stéréotypes. Dans des plongements entraînés sur des articles de Google News, man est à computer programmer ce que woman est à homemaker, et les noms de métiers se répartissent selon une direction de genre exactement comme roi et reine se répartissent selon une direction de royauté (Bolukbasi et al., 2016).
Aucun programmeur n’a décidé d’éloigner woman de doctor et de la rapprocher de nurse. Le biais vient des textes : les vecteurs enregistrent la manière dont les mots sont employés à travers des millions de phrases, et ce sont des personnes qui ont écrit ces phrases. La méthode fonctionne comme prévu. Les conséquences touchent tout ce qui a été construit sur des plongements depuis (see also the Critical issues with LLMs module) (voir aussi le module Enjeux critiques des GML).
La démonstration de CMU tourne dans un navigateur sur word2vec et GloVe : essayer roi − homme + femme en direct, puis prendre une analogie dans les langues de travail du groupe. Demander une analogie de métiers avant de montrer le résultat de Bolukbasi, pour que le biais arrive comme quelque chose que le groupe a produit et non comme un avertissement.
Trois limites
Les mots nouveaux n’obtiennent rien
Un modèle de plongements a un vecteur pour chaque mot rencontré à l’entraînement : un mot forgé l’an dernier, un terme technique rare ou une coquille n’a donc aucun vecteur et aucune représentation. Les langues à morphologie riche aggravent la situation, puisque leurs composés et leurs flexions productives produisent des formes qu’aucune base d’apprentissage ne contient. Les systèmes modernes dissolvent le problème en travaillant sur des morceaux de mots (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres).
Un seul vecteur fait la moyenne de tous les sens
Livres désigne une monnaie dans j’ai changé mille livres et des ouvrages dans j’ai emprunté trois livres. Un vecteur unique pour livres doit servir aux deux phrases : il atterrit donc quelque part entre la finance et la lecture, un compromis qui a tort partout. Ce n’est même pas un compromis équitable : le vecteur est une moyenne sur les occurrences, il se place donc au plus près du sens le plus fréquent dans les textes d’entraînement, et c’est le sens le plus rare qui est le plus mal servi. La traduction s’en aperçoit tôt, puisque choisir entre pounds et books est exactement une décision sur le sens actif.
L’ordre est invisible
Jean suit le chien et le chien suit Jean contiennent les mêmes mots et ne décrivent pas la même promenade ; toute représentation construite en combinant des vecteurs de mots fixes a donc du mal à les distinguer. Le sens dépend de l’agencement, et des vecteurs par mot n’ont nulle part où mettre l’agencement.
Three sentences, one word
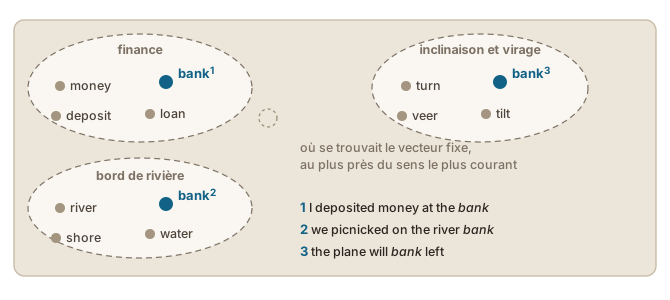
Take three sentences with bank in them:
- I deposited money at the bank.
- We picnicked on the river bank.
- The plane will bank left.
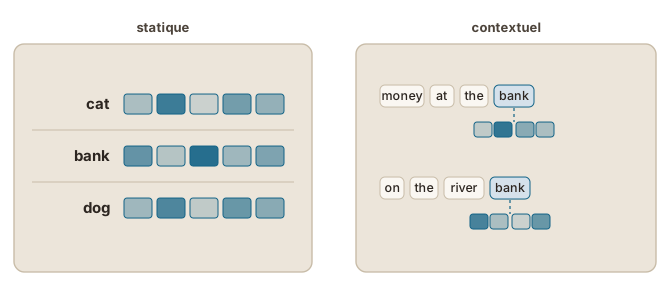
You would translate the word three different ways: banque, rive, virer. A fixed embedding gives all three the same vector.
A vector per occurrence
A contextual embedding sides with the translator. Instead of storing one finished vector per word, the model computes a vector for each occurrence, at the moment of use, from the whole sentence around it:
- the bank beside deposited and money comes out near the vocabulary of finance;
- the one beside river and picnicked, near geography;
- the one after will, in verb territory.
Same word, three vectors, each shaped by its company. Models that work this way arrived in the late 2010s, and ELMo was the landmark (Peters et al., 2018).
This is also where the material stops being machine learning machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. in general and becomes deep learning deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. . Word2vec kept its model deliberately simple, which let it train on billions of words (Mikolov et al., 2013a). Computing a vector for every occurrence takes many layers instead, and ELMo’s paper says so in its title, Deep contextualized word representations.
What happens to polysemy
Nobody lists the senses of bank or writes a rule to pick one. The senses simply stop being merged, because there is no single vector left for them to be merged into.
One consequence is easy to miss. A word no longer has “its vector”, the kind you could print in a table. It has a vector in each sentence, so the question “what does the model think bank means?” only has answers of the form “here, in this sentence”. Word meaning in isolation, the thing a dictionary records, has quietly left the system.
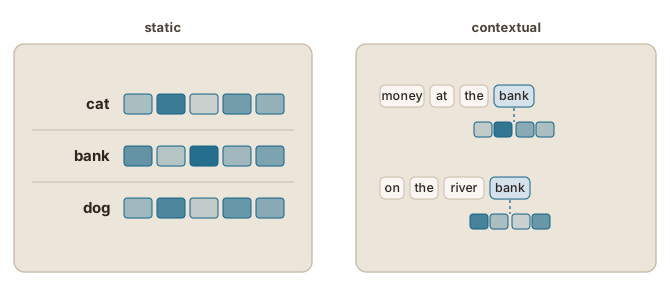
Three sentences on the board first: I deposited money at the bank, we picnicked on the river bank, the plane will bank left. Ask for the French of each. Then the figure: the room has already done what the model does.
Before or after
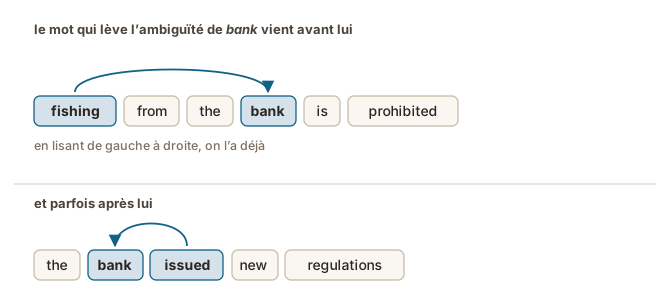
Where does the word that settles the ambiguity sit? Sometimes before the ambiguous word: in fishing from the bank is prohibited, fishing has settled the sense by the time bank arrives. Sometimes after it: in the bank issued new regulations, the deciding word only comes once bank has been read.
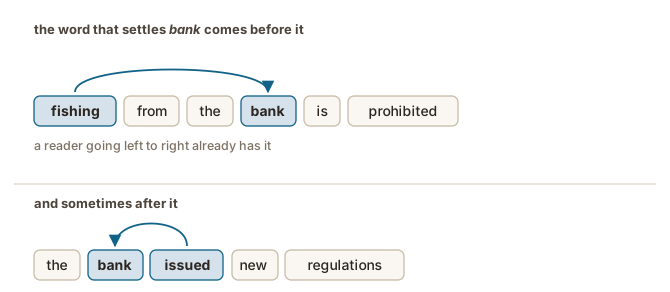
Reading both ways
ELMo already used both sides, but shallowly: one model read the sentence left to right, a second read it right to left, and their outputs were joined at the end, so the two directions were never combined during training (Devlin et al., 2019).
BERT is the model that put the two together.ELMo and BERT set a fashion, and the acronyms that followed were bent to land on Sesame Street characters: ERNIE, Grover, Big Bird.
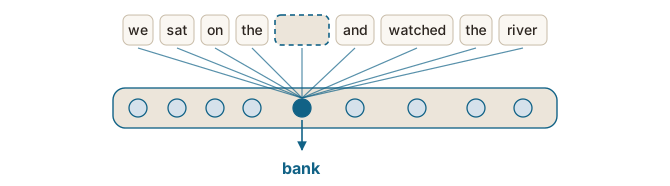
Training a language model normally means predicting the next word, and that forces a single direction: a model allowed to see what follows would simply be handed the answer. BERT changes the exercise. It hides about 15 per cent of the tokens token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. in a text and trains the model to restore each one from everything around it, on both sides (Devlin et al., 2019). Nothing is being generated here, so nothing is spoiled by reading ahead.
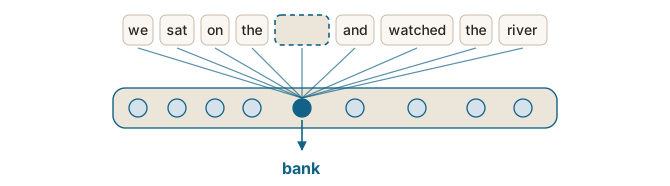
Every layer of the model therefore draws on both sides at once. The architecture underneath makes that possible (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
BERT reported new best results on eleven language-processing tasks, and this methodology became the standard: pretrain one model on raw text, then fine-tune it for each task. For translation, where the whole source text is there before any output is produced, reading it in both directions is the natural design.
What it costs
Two things.
- Computation. A fresh vector per occurrence, from the whole sentence, costs far more than looking up a stored one, so these models need serious hardware.
- Inspection. A static embedding table could at least be examined word by word. Contextual representations exist only inside a running model, one more step away from anything a person can read (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
The field judged the accuracy worth both.
The generator screen is the hinge to séance 3: a generator only ever sees what came before, which is why it commits to words it cannot revise. Worth naming now, so that behaviour is expected rather than surprising when the chatbots arrive.
What pretraining leaves you with
Pretraining leaves you with a model that turns any sentence into contextual embeddings contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. . It knows a great deal about the language it read and nothing about any particular task, which makes it worth keeping: one expensive training run, then many uses.
Two ways to use it
Its embeddings can be taken as they are and fed into a model of your own, which is how ELMo was used. Or the whole model can be kept and fine-tuned: a small output layer is added and trained on labelled examples for one task, so that what the model learned about language carries over to it (Devlin et al., 2019) (see also the Fine-tuning chapter, in the LLM lifecycle module) (voir aussi le chapitre Affinage, dans le module Cycle de vie des GML). Sentiment analysis, named-entity recognition and question answering were all built that way, and the task-specific training is small beside the pretraining.
That recipe still applies to a model like BERT. For large generative models, much of what once took a fine-tuned model of its own is now done by putting examples in the prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. instead (Brown et al., 2020) (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
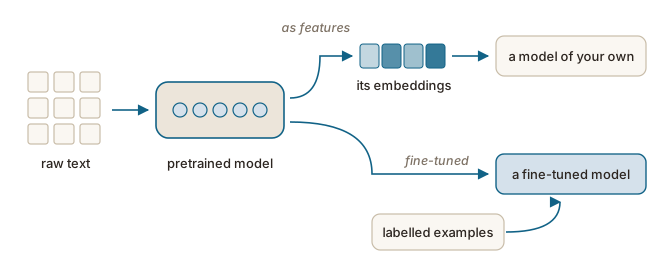
Two routes off one model: its embeddings as features, or the model itself fine-tuned. Say which one BERT made standard, and that the pretraining is the expensive half.
Trois phrases, un seul mot
Prenons trois phrases contenant bank :
- I deposited money at the bank.
- We picnicked on the river bank.
- The plane will bank left.
Vous traduiriez le mot de trois façons différentes : banque, rive, virer. Un plongement fixe donne le même vecteur aux trois.
Un vecteur par occurrence
Un plongement contextuel donne raison à la traductrice ou au traducteur. Au lieu de conserver un vecteur tout fait par mot, le modèle calcule un vecteur pour chaque occurrence, au moment de l’usage, à partir de toute la phrase qui l’entoure :
- le bank voisin de deposited et de money ressort près du vocabulaire de la finance ;
- celui qui voisine avec river et picnicked, près de la géographie ;
- celui qui suit will, du côté des verbes.
Même mot, trois vecteurs, chacun façonné par sa compagnie. Les modèles qui fonctionnent ainsi arrivent à la fin des années 2010, et ELMo en est le jalon (Peters et al., 2018).
C’est aussi ici que la matière cesse d’être de l’apprentissage automatique machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. en général pour devenir de l’apprentissage profond deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. . Word2vec gardait son modèle délibérément simple, ce qui lui a permis de s’entraîner sur des milliards de mots (Mikolov et al., 2013a). Calculer un vecteur pour chaque occurrence demande au contraire de nombreuses couches, et l’article d’ELMo le dit dans son titre, Deep contextualized word representations.
Ce que devient la polysémie
Personne ne dresse la liste des sens de bank ni n’écrit de règle pour en choisir un. Les sens cessent simplement d’être fusionnés, parce qu’il ne reste aucun vecteur unique dans lequel les fusionner.
Une conséquence passe facilement inaperçue. Un mot n’a plus « son vecteur », celui qu’on pourrait imprimer dans un tableau. Il a un vecteur dans chaque phrase, si bien que la question « que pense le modèle du sens de bank ? » n’admet que des réponses de la forme « ici, dans cette phrase ». Le sens d’un mot hors contexte, ce que consigne un dictionnaire, a discrètement quitté le système.
Trois phrases au tableau d’abord : I deposited money at the bank, we picnicked on the river bank, the plane will bank left. Demander la traduction française de chacune. Puis la figure : le groupe vient de faire ce que fait le modèle.
Avant ou après
Où se trouve le mot qui lève l’ambiguïté ? Parfois avant le mot ambigu : dans fishing from the bank is prohibited, fishing a déjà fixé le sens quand bank arrive. Parfois après lui : dans the bank issued new regulations, le mot décisif ne vient qu’une fois bank lu.
Lire dans les deux sens
ELMo utilisait déjà les deux côtés, mais superficiellement : un modèle lisait la phrase de gauche à droite, un second la lisait de droite à gauche, et leurs sorties étaient réunies à la fin, si bien que les deux sens ne se rencontraient jamais pendant l’entraînement (Devlin et al., 2019).
BERT est le modèle qui a réuni les deux.ELMo et BERT ont lancé une mode, et les acronymes qui ont suivi ont été tordus pour tomber sur des personnages de Sesame Street : ERNIE, Grover, Big Bird.
Entraîner un modèle de langue veut normalement dire prédire le mot suivant, et cela impose un sens unique : un modèle autorisé à voir ce qui suit se verrait simplement donner la réponse. BERT change l’exercice. Il masque environ 15 % des jetons token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. d’un texte et entraîne le modèle à rétablir chacun d’eux à partir de tout ce qui l’entoure, des deux côtés (Devlin et al., 2019). Rien n’est produit ici, donc rien n’est gâché si le modèle lit plus loin.
Chaque couche du modèle puise donc des deux côtés à la fois. L’architecture sous-jacente rend cela possible (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
BERT a établi de nouveaux records sur onze tâches de traitement de la langue, et cette méthodologie est devenue la norme : préentraîner un modèle sur du texte brut, puis l’affiner pour chaque tâche. En traduction, où tout le texte de départ est là avant qu’aucune sortie ne soit produite, le lire dans les deux sens est la conception naturelle.
Ce que cela coûte
Deux choses.
- Le calcul. Un vecteur neuf par occurrence, à partir de toute la phrase, coûte bien plus cher que d’en consulter un déjà rangé : ces modèles exigent donc du matériel sérieux.
- L’inspection. Une table de plongements statiques pouvait au moins s’examiner mot à mot. Les représentations contextuelles n’existent qu’à l’intérieur d’un modèle en train de tourner, un cran plus loin encore de ce qu’une personne peut lire (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
Le domaine a jugé que la précision valait les deux.
L’écran sur le générateur est la charnière vers la séance 3 : un générateur ne voit jamais que ce qui précède, et c’est pourquoi il s’engage sur des mots qu’il ne peut pas réviser. Cela vaut la peine de le nommer maintenant, pour que ce comportement soit attendu plutôt que surprenant quand les agents conversationnels arriveront.
Ce que laisse le préentraînement
Le préentraînement pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. laisse un modèle qui transforme n’importe quelle phrase en plongements contextuels contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. . Il en sait beaucoup sur la langue qu’il a lue et rien sur une tâche particulière, ce qui le rend précieux : un entraînement coûteux, puis de nombreux usages.
Deux façons de s’en servir
Ses plongements peuvent être pris tels quels et fournis à un modèle à vous, comme ELMo était utilisé. Ou le modèle entier peut être conservé et affiné (fine-tuning, aussi appelé réglage fin) : on y ajoute une petite couche de sortie, entraînée sur des exemples annotés pour une seule tâche, de sorte que ce que le modèle a appris de la langue lui profite (Devlin et al., 2019) (see also the Fine-tuning chapter, in the LLM lifecycle module) (voir aussi le chapitre Affinage, dans le module Cycle de vie des GML). L’analyse de sentiments, la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. et la réponse aux questions ont toutes été construites ainsi, et l’entraînement propre à la tâche est petit à côté du préentraînement.
Cette recette s’applique toujours à un modèle comme BERT. Pour les grands modèles génératifs, une bonne part de ce qui demandait autrefois un modèle affiné à part se fait maintenant en mettant des exemples dans la requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. (Brown et al., 2020) (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
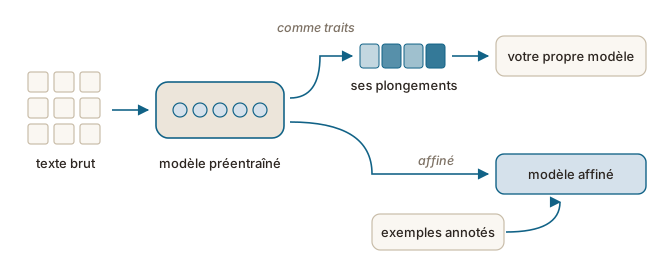
Deux voies à partir d’un seul modèle : ses plongements comme traits, ou le modèle lui-même affiné. Dire laquelle BERT a rendue standard, et que le préentraînement est la moitié coûteuse.
Context matters
Texts are full of context-dependent choices and interpretations, at every scale:
- the word that settles an ambiguity, thirty words earlier in the same sentence;
- the latter, referring to something named three sentences ago;
- a pronoun pointing back two paragraphs;
- a term defined in the introduction and used throughout.
One pass, and no going back
Before the transformer, a model read a sentence the way it arrives: one word at a time, updating a running summary as it went. ELMo was still built that way in 2018, with two passes over the sentence, each of them one word at a time (Peters et al., 2018).
That sounds natural, because it is how you read too. You commit as you go, and a later word sometimes breaks the reading you committed to: the horse raced past the barn fell sends you back to the beginning. Sentences like that are called garden-path sentences, tricking you into one reading at the beginning and making you reconsider at the end. Without the ability to go backwards, models would not be able to deal with this.
Processing one word at a time in order has a structural weakness as well. Everything the model knows about word 3 has to survive, inside that running summary, through the processing of words 4, 5 and 6 to matter at word 50. Each step blurs it a little, like a game of broken telephone.A party game: one player whispers a phrase to the next along a line, each passing on what they think they heard, and the last says aloud what reached them. Over a short span the message arrives; over a long one what arrives is a paraphrase of a paraphrase.
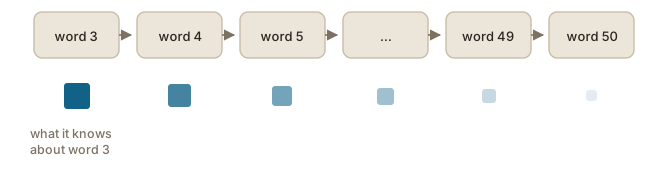
The links a text reaches back over are the hook, and the sentence is the scale to keep it at. Then the relay: everything the model knows about word 3 has to survive the processing of words 4, 5 and 6 to matter at word 50, and each step blurs it. The fix of 2017 did not improve the running summary, it removed it.
Attention is all you need
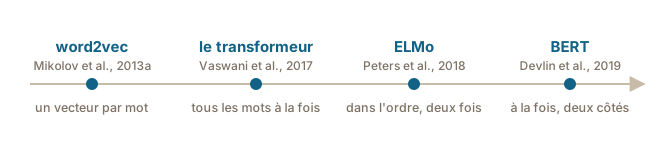
The 2017 paper that changed the field has its thesis in its title: “Attention Is All You Need” (Vaswani et al., 2017). The architecture it introduced, the transformer, drops reading order entirely. All the words of the input are processed at the same time, and each word can draw information directly from any other, whatever the distance between them. The first word of a long sentence no longer has to survive a relay to reach the last: the two are one connection apart.
This seminal paper, arguably among the most important ones to trigger the AI evolution we are currently experiencing, was actually about machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. ! The architecture was introduced, trained and measured as a translation model, on English to German and English to French, where it beat everything before it (Vaswani et al., 2017) (see also the impact on machine translation page, in the Language as numbers module) (voir aussi la page L'incidence sur la traduction automatique, dans le module Le langage en nombres).
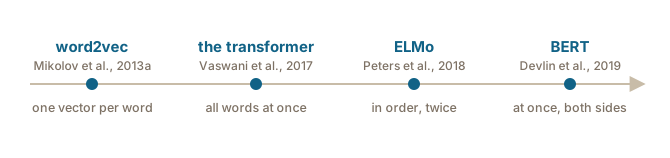
What about word order?
Dropping sequence creates an obvious problem. If nothing is processed “first”, how does the model know that the dog follows Jean differs from Jean follows the dog? The words alone no longer say.
The transformer’s answer is to make position part of each word’s representation. Before processing starts, every word’s vector is combined with a numerical encoding of where in the text it sits, like page numbers on a manuscript that has been taken apart: the pages can then be handled in any order without the original arrangement being lost.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
The title of the paper is the thesis: “Attention Is All You Need”. Then the problem dropping sequence creates: if nothing is processed first, what tells the model that the dog follows Jean differs from Jean follows the dog? Page numbers on a manuscript taken apart.
But which context?
Reading in both directions settled one question, whether the word that decides comes before or after (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres). It leaves another. Once every word is connected to every other, not all of those connections are worth the same, and the more context there is, the less of it counts equally.
Reading the bank was steep, you connect bank with steep and settle on the riverside sense without noticing you did it. The attention mechanism is the transformer’s version of that reflex: for each word, attention weights say how much every other word in the text should influence its representation.
Too tired, too wide
The classic demonstration comes from the transformer paper itself (Vaswani et al., 2017; visualization by Vig, 2019). Compare:
- the animal didn’t cross the street because it was too tired
- the animal didn’t cross the street because it was too wide
Changing a single word at the very end changes the meaning of the whole sentence, by changing which word we link it to: a tired it is the animal, a wide it is the street. Inside a trained transformer, the attention weights from it visibly shift between the two sentences, toward animal in the first and toward street in the second.
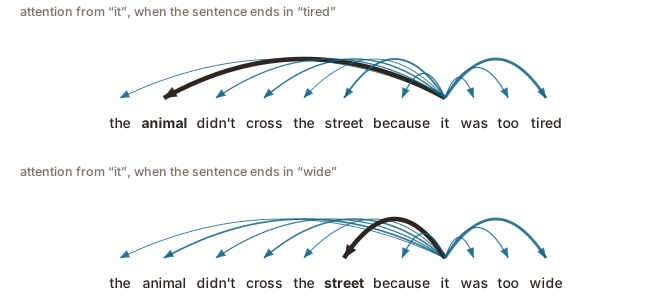
Nobody programmed the fact that streets are wide and animals get tired. That came out of patterns across millions of sentences: the distributional idea again, now applied to relationships inside a sentence rather than to which words resemble each other.
Learned once, worked out every time
Two different things are called weights here, and they are worth telling apart.
- The model’s weights weightpoids machine learningapprentissage automatique A real number attached to one input of a computing unit, learned during training, that sets how much that input counts towards the unit's output.Nombre réel attaché à une entrée d'une unité de calcul, appris pendant l'entraînement, qui détermine l'importance de cette entrée dans la sortie de l'unité. are learned. Everything the model picked up from its training text is in them, and every step of the computation runs through them. Training adjusts them over a large amount of text, and they stop changing when it ends (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
- The attention weights are worked out. They say how much each word of the text at hand should draw on each other word. The model computes them from those words, using the weights it learned, and computes them again for the next text. Nothing about the model changes while it does.
So the arcs in the figure above were not stored anywhere and looked up. They were computed for that sentence, and the other sentence gives other arcs.
This is the machinery the contextual-embeddings chapter left unexplained: the vector for this occurrence of bank is assembled from the words its attention selected, in the proportions it learned (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
So what is self-attention?
Attention always runs between two sets of words: the ones being given a representation, and the ones they draw on. Self-attention is the case where both sets are the same text. That happens everywhere above, each word of the sentence weighted against the other words of that same sentence.
The other case runs between two different texts, a source and the translation being written from it (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres). That use came first: attention was built for translation (Bahdanau et al., 2015), and the step taken in 2017 was to use it inside a single text as well (Vaswani et al., 2017).
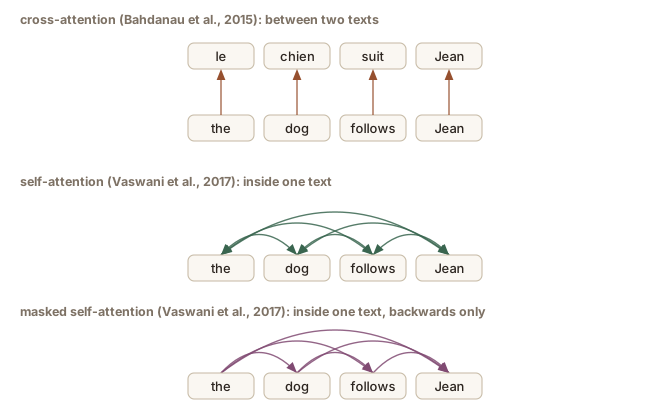
Masking starts to matter once a model writes rather than reads (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres).
Read the two sentences out and let the room feel it change owners before showing the figure. This is also the answer the contextual-embeddings chapter owed them: the vector for this occurrence of bank is assembled from the words its attention selected, in the proportions it learned.
Two halves, one translation
Being a translation model, the 2017 transformer transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. has to do two different things: read a source text, and produce a target text. It does them in two halves (Vaswani et al., 2017).
- The encoder takes the source and turns it into contextual representations, all words at the same time.
- The decoder writes the target one word at a time, and at each word it looks in two directions: back over what it has already written, and across at the encoder’s representations of the source.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 6figure 6 follows one sentence through both halves, le chien suit Jean becoming the dog follows Jean, caught at the moment the decoder produces follows. Training is over by then, so the figure shows one pass through a finished model (see also the Attention page, in the Language as numbers module) (voir aussi la page L'attention, dans le module Le langage en nombres). Training a translation model in the first place is a subject of its own (see also the What machine translation is chapter, in the Machine translation module) (voir aussi le chapitre Qu'est-ce que la traduction automatique, dans le module Traduction automatique).
- Into the encoder. Words become static vectors, and self-attention self-attentionautoattention deep learningapprentissage profond An attention mechanism that allows each token in a sequence to assign different weights to other relevant tokens in the same sequence and combine information from them.Mécanisme d'attention qui permet à chaque jeton d'une séquence d'attribuer des poids différents aux autres jetons pertinents de la même séquence et de combiner l'information qu'ils portent. turns those into contextual embeddings contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. , every word drawing on every other, in both directions. Translation needs that, since the word that settles a gender or a sense is available before the first target word is written (see also the impact on machine translation page, in the Language as numbers module) (voir aussi la page L'incidence sur la traduction automatique, dans le module Le langage en nombres).
- Across, with cross-attention. The vector being built for follows draws on the encoder’s vectors through cross-attention cross-attentionattention croisée deep learningapprentissage profond An attention mechanism in which the queries come from one sequence or component and the keys and values come from another.Mécanisme d'attention dans lequel les requêtes proviennent d'une séquence ou d'un composant et les clés et valeurs d'un autre. , mostly on the one for suit. Nothing restricts that link, so any source word can be drawn on, wherever it sits.
- Back, with masked self-attention. That same vector also draws on what the decoder has already written, the and dog. The fourth slot is empty, because the words after the one being produced do not exist yet, so attention over the target runs backwards only.
- Out of the decoder. The finished vector is mapped back to a word.
Direction belongs to the attention, not to the turning of words into vectors and back.
Encoder, decoder, or both?
Both halves are made of the same attention layers, so a model can keep one or keep both. The choice follows from the shape of the task: what goes in, and what has to come out.
- Encoder only, when the output is not a text. Sorting a document into a category, finding the names in it, judging how close two sentences are: the model has to read, not write, and what it produces is a label, a span or a set of vectors. BERT reads a whole text at once, in both directions, and a small task-specific layer is trained on top of its representations (Devlin et al., 2019) (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres). That makes an encoder-only model encoder-only modelmodèle à encodeur seul language modelsmodèles de langue A neural-network architecture that processes an input sequence and produces a contextual representation for each input token, without using a separate decoder to generate an output sequence.Architecture de réseau de neurones qui traite une séquence d'entrée et produit une représentation contextuelle de chaque jeton, sans décodeur distinct pour générer une séquence de sortie. .
- Decoder only, when the output continues the input. A chatbot’s answer and the prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. that produced it are one running text, so there is no separate thing to read: each word is produced from everything before it, the prompt included (Radford et al., 2019). That makes a decoder-only model decoder-only modelmodèle à décodeur seul language modelsmodèles de langue A transformer language-model architecture that uses a sequence of decoder blocks without a separate encoder.Architecture de modèle de langue à transformeur qui enchaîne des blocs décodeurs sans encodeur distinct. , and the behaviour of a generator comes from it (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML).
- Both, when one sequence becomes a different one. The output is not a continuation of the input and may be in another language, another form or another medium, so the input has to be read whole before the output is written and the two halves stay connected by cross-attention. Machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. is the case at hand, and it is not the only one: speech recognition works the same way, the encoder reading audio and the decoder writing text (Radford et al., 2023), as do speech translation and summarization.
The line is not a wall. A decoder-only model translates perfectly well when the source and its translation are given to it as one running text, which happens whenever a translation is asked of a chatbot (see also the Machine translation module) (voir aussi le module Traduction automatique).
The alignment figure is the hook for this room: each target word draws on the source words it renders, learned from examples rather than declared. The three colours are the three attentions, the same colours as the panel figure on the previous page. Then the three architectures, from the shape of the task rather than from the names.
Why “large” starts here
The transformer improved quality, and the deeper change was economic. A sequential model processes words like customers in a single queue: one at a time, however fast each step is. A transformer opens every checkout lane at once, which is exactly the workload graphics processors are built for.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Training on text collections that were unthinkably large in 2016 became routine within a few years, and model and data sizes grew by orders of magnitude (Hoffmann et al., 2022). Every system in the LLM lifecycle module is a transformer at heart (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML); without parallel processing, “large” would have stayed out of reach.
The cost of attention
Attention weighs every pair of words, so doubling the length of a text roughly quadruples the work. Somewhere, every model has to cap how much text it processes at once, and that cap is the context window: the reason a chatbot loses the thread of a long conversation, and the reason “translate this 200-page document in one go” is not how any of these systems works (see also the Counting in tokens page, in the Language as numbers module) (voir aussi la page Compter en jetons, dans le module Le langage en nombres).
Close on the aside rather than on the mechanism: high attention between two words means the training data made that connection useful for prediction, and nothing more. Whether pattern matching at this scale amounts to something more is the debate that opens at séance 3.
Read before you translate
When you translate, you need context before you can commit. You cannot start rendering a sentence on its first word: you read ahead, a few words at least, to see where it is going. Consider for instance the English-to-French translation in Figure 8figure 8.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
This is why transformers transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. , which can take in all the context of a sentence at once, so clearly outperformed the sequential models that came before them: she is one connection away from épuisée, wherever the two sit.
Where each target word comes from
While the decoder decoderdécodeur deep learningapprentissage profond A neural-network component or architecture used to generate an output sequence.Composant ou architecture de réseau de neurones servant à générer une séquence de sortie. writes coureuse, cross-attention cross-attentionattention croisée deep learningapprentissage profond An attention mechanism in which the queries come from one sequence or component and the keys and values come from another.Mécanisme d'attention dans lequel les requêtes proviennent d'une séquence ou d'un composant et les clés et valeurs d'un autre. weighs the words of the English sentence and runner dominates (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres). Do that at every target word and out comes a map between the two texts, close to what a translator means by alignment and to what a CAT tool computes when it aligns a file with its translation.
Nobody gave the model that map. It worked it out from millions of translated sentence pairs, four and a half million for the English-German system of the original paper (Vaswani et al., 2017).
Context stopped at the sentence
Attention did not change how much text goes in at once. Machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. went on working one sentence at a time for years, so a term settled in one sentence had no bearing on the next, and a pronoun could not reach back to the paragraph that named its referent. Translating with the whole document in view is its own line of work (Voita et al., 2019; Maruf et al., 2021), and feeding a text in whole became ordinary only with the long context windows context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). of today’s models (see also the Machine translation module) (voir aussi le module Traduction automatique).
Build the runner example with the room before the figure: ask for the French of I’m exhausted, said the runner, and let them find the two commitments before she arrives.
Le contexte compte
Les textes sont pleins de choix et d’interprétations qui dépendent du contexte, à toutes les échelles :
- le mot qui lève une ambiguïté, trente mots plus tôt dans la même phrase ;
- ce dernier, qui renvoie à quelque chose nommé trois phrases plus haut ;
- un pronom qui renvoie deux paragraphes en arrière ;
- un terme défini dans l’introduction et employé partout ensuite.
Un seul passage, sans retour
Avant le transformeur, un modèle lisait une phrase telle qu’elle arrive : un mot à la fois, en mettant à jour un résumé courant à mesure. ELMo était encore construit ainsi en 2018, avec deux passages sur la phrase, chacun un mot à la fois (Peters et al., 2018).
Cela paraît naturel, parce que c’est aussi votre façon de lire. Vous vous engagez à mesure, et un mot plus loin brise parfois la lecture à laquelle vous vous étiez engagé : the horse raced past the barn fell vous renvoie au début. On appelle ces phrases des phrases-pièges : elles vous entraînent vers une première lecture, puis vous forcent à revenir sur elle à la fin. Sans la possibilité de revenir en arrière, les modèles ne sauraient pas s’en tirer.
Traiter un mot à la fois, dans l’ordre, a aussi une faiblesse structurelle. Tout ce que le modèle sait du mot 3 doit survivre, dans ce résumé courant, au traitement des mots 4, 5 et 6 pour compter encore au mot 50. Chaque étape le brouille un peu, comme au téléphone arabe.Un jeu de société : un joueur chuchote une phrase au suivant le long d’une file, chacun transmet ce qu’il croit avoir entendu, et le dernier dit à voix haute ce qui lui est parvenu. Sur une courte distance, le message arrive ; sur une longue, il n’arrive plus que la paraphrase d’une paraphrase.
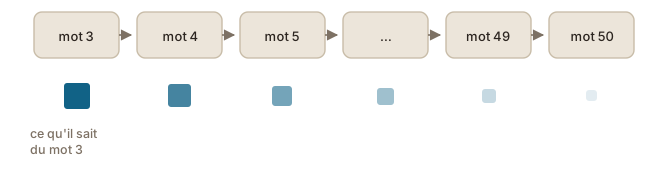
Les liens sur lesquels un texte revient sont l’accroche, et la phrase est l’échelle à laquelle s’en tenir. Puis le relais : tout ce que le modèle sait du mot 3 doit survivre au traitement des mots 4, 5 et 6 pour compter encore au mot 50, et chaque étape le brouille. Le correctif de 2017 n’a pas amélioré le résumé courant, il l’a supprimé.
Attention is all you need
L’article de 2017 qui a changé le domaine annonce sa thèse dans son titre : « Attention Is All You Need » (Vaswani et al., 2017). L’architecture qu’il présente, le transformeur, abandonne complètement l’ordre de lecture. Tous les mots de l’entrée sont traités en même temps, et chaque mot peut puiser de l’information directement dans n’importe quel autre, quelle que soit la distance. Le premier mot d’une longue phrase n’a plus à survivre à une course de relais pour atteindre le dernier : les deux sont à une seule connexion l’un de l’autre.
Cet article fondateur, sans doute l’un des plus importants pour déclencher l’évolution de l’IA que nous vivons actuellement, portait en fait sur la traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. ! L’architecture a été présentée, entraînée et mesurée comme un modèle de traduction, de l’anglais vers l’allemand et de l’anglais vers le français, où elle a battu tout ce qui la précédait (Vaswani et al., 2017) (see also the impact on machine translation page, in the Language as numbers module) (voir aussi la page L'incidence sur la traduction automatique, dans le module Le langage en nombres).
Et l’ordre des mots ?
Abandonner la séquence crée un problème évident. Si rien n’est traité « en premier », comment le modèle sait-il que le chien suit Jean diffère de Jean suit le chien ? Les mots seuls ne le disent plus.
La réponse du transformeur est de faire de la position une partie de la représentation de chaque mot. Avant que le traitement commence, le vecteur de chaque mot est combiné à un encodage numérique de sa place dans le texte, comme des numéros de page sur un manuscrit qu’on a défait : les pages peuvent ensuite être manipulées dans n’importe quel ordre sans que l’agencement d’origine soit perdu.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Le titre de l’article est la thèse : « Attention Is All You Need ». Puis le problème que crée l’abandon de la séquence : si rien n’est traité en premier, qu’est-ce qui dit au modèle que le chien suit Jean diffère de Jean suit le chien ? Des numéros de page sur un manuscrit défait.
Mais quel contexte ?
Lire dans les deux sens a réglé une question, celle de savoir si le mot décisif vient avant ou après (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres). Il en reste une autre. Dès que chaque mot est relié à tous les autres, toutes ces liaisons ne valent pas la même chose, et plus il y a de contexte, moins toutes ses parties comptent autant.
En lisant the bank was steep, vous rapprochez bank de steep et vous retenez le sens du bord de rivière sans vous en apercevoir. Le mécanisme d’attention est la version qu’en donne le transformeur : pour chaque mot, des poids d’attention disent à quel point chacun des autres mots du texte doit influencer sa représentation.
Trop fatigué, trop large
La démonstration classique vient de l’article même du transformeur (Vaswani et al., 2017 ; visualisation de Vig, 2019). Comparez :
- the animal didn’t cross the street because it was too tired
- the animal didn’t cross the street because it was too wide
Changer un seul mot tout à la fin change le sens de la phrase entière, en changeant le mot auquel on rattache it : un it fatigué est l’animal, un it large est la rue. Dans un transformeur entraîné, les poids d’attention depuis it se déplacent visiblement entre les deux phrases, vers animal dans la première et vers street dans la seconde.
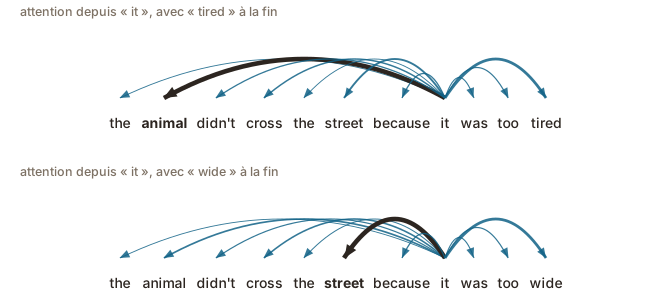
Personne n’a programmé le fait que les rues sont larges et que les animaux se fatiguent. Cela est ressorti de motifs relevés dans des millions de phrases : l’idée distributionnelle de nouveau, appliquée cette fois aux relations à l’intérieur d’une phrase plutôt qu’à la ressemblance entre les mots.
Appris une fois, établi chaque fois
Deux choses différentes s’appellent ici des poids, et elles valent la peine d’être distinguées.
- Les poids weightpoids machine learningapprentissage automatique A real number attached to one input of a computing unit, learned during training, that sets how much that input counts towards the unit's output.Nombre réel attaché à une entrée d'une unité de calcul, appris pendant l'entraînement, qui détermine l'importance de cette entrée dans la sortie de l'unité. du modèle sont appris. Tout ce que le modèle a retenu de ses textes d’entraînement s’y trouve, et chaque étape du calcul passe par eux. L’entraînement les ajuste sur une grande quantité de texte, et ils cessent de changer quand il se termine (see also the From neural networks to large language models chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue, dans le module Fondements de l'IA et du TAL).
- Les poids d’attention sont établis. Ils disent à quel point chaque mot du texte en cours doit puiser dans chacun des autres. Le modèle les calcule à partir de ces mots, avec les poids qu’il a appris, et les calcule de nouveau pour le texte suivant. Rien du modèle ne change pendant ce temps.
Les arcs de la figure ci-dessus n’étaient donc rangés nulle part avant d’être consultés. Ils ont été calculés pour cette phrase, et l’autre phrase donne d’autres arcs.
C’est le mécanisme que le chapitre sur les plongements contextuels laissait inexpliqué : le vecteur de cette occurrence de bank est assemblé à partir des mots que son attention a retenus, dans les proportions apprises (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
Alors, qu’est-ce que l’autoattention ?
L’attention s’exerce toujours entre deux ensembles de mots : ceux à qui l’on donne une représentation, et ceux dans lesquels ils puisent. L’autoattention est le cas où les deux ensembles sont le même texte. C’est ce qui se passe partout ci-dessus, chaque mot de la phrase pesé par rapport aux autres mots de cette même phrase.
Dans l’autre cas, elle s’exerce entre deux textes différents, un texte de départ et la traduction qu’on en écrit (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres). Cet usage est venu le premier : l’attention a été conçue pour la traduction (Bahdanau et al., 2015), et le pas franchi en 2017 a été de s’en servir aussi à l’intérieur d’un seul texte (Vaswani et al., 2017).
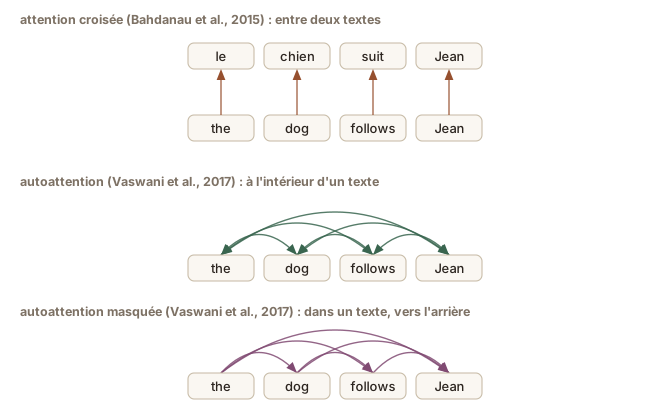
Le masquage commence à compter dès qu’un modèle écrit au lieu de lire (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres).
Lire les deux phrases à voix haute et laisser le groupe sentir it changer de propriétaire avant de montrer la figure. C’est aussi la réponse que le chapitre sur les plongements contextuels leur devait : le vecteur de cette occurrence de bank est assemblé à partir des mots que son attention a retenus, dans les proportions apprises.
Deux moitiés, une traduction
Étant un modèle de traduction, le transformeur transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. de 2017 doit faire deux choses différentes : lire un texte de départ et produire un texte d’arrivée. Il les confie à deux moitiés (Vaswani et al., 2017).
- L’encodeur prend le texte de départ et le transforme en représentations contextuelles, tous les mots en même temps.
- Le décodeur écrit le texte d’arrivée un mot à la fois, et à chaque mot il regarde dans deux directions : en arrière sur ce qu’il a déjà écrit, et de l’autre côté vers les représentations du texte de départ produites par l’encodeur.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
La Figure 6figure 6 suit une phrase à travers les deux moitiés, le chien suit Jean devenant the dog follows Jean, saisie au moment où le décodeur produit follows. L’entraînement est terminé à ce stade : la figure montre donc un seul passage dans un modèle achevé (see also the Attention page, in the Language as numbers module) (voir aussi la page L'attention, dans le module Le langage en nombres). L’entraînement d’un modèle de traduction est un sujet à part entière (see also the What machine translation is chapter, in the Machine translation module) (voir aussi le chapitre Qu'est-ce que la traduction automatique, dans le module Traduction automatique).
- Vers l’encodeur. Les mots deviennent des vecteurs statiques, et l’autoattention self-attentionautoattention deep learningapprentissage profond An attention mechanism that allows each token in a sequence to assign different weights to other relevant tokens in the same sequence and combine information from them.Mécanisme d'attention qui permet à chaque jeton d'une séquence d'attribuer des poids différents aux autres jetons pertinents de la même séquence et de combiner l'information qu'ils portent. les transforme en plongements contextuels contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. , chaque mot puisant dans tous les autres, dans les deux sens. La traduction a besoin de cela, puisque le mot qui règle un genre ou un sens est disponible avant que le premier mot d’arrivée soit écrit (see also the impact on machine translation page, in the Language as numbers module) (voir aussi la page L'incidence sur la traduction automatique, dans le module Le langage en nombres).
- De l’autre côté, avec l’attention croisée. Le vecteur en cours de construction pour follows puise dans les vecteurs de l’encodeur par l’attention croisée cross-attentionattention croisée deep learningapprentissage profond An attention mechanism in which the queries come from one sequence or component and the keys and values come from another.Mécanisme d'attention dans lequel les requêtes proviennent d'une séquence ou d'un composant et les clés et valeurs d'un autre. , surtout dans celui de suit. Rien ne restreint ce lien : n’importe quel mot de départ peut être utilisé, où qu’il se trouve.
- En arrière, avec l’autoattention masquée. Ce même vecteur puise aussi dans ce que le décodeur a déjà écrit, the et dog. La quatrième place est vide, parce que les mots qui suivent celui qu’on produit n’existent pas encore : l’attention sur le texte d’arrivée ne va donc que vers l’arrière.
- Hors du décodeur. Le vecteur terminé est ramené à un mot.
La direction appartient à l’attention, non au passage des mots aux vecteurs et des vecteurs aux mots.
Encodeur, décodeur ou les deux ?
Les deux moitiés sont faites des mêmes couches d’attention : un modèle peut donc n’en garder qu’une, ou garder les deux. Le choix découle de la forme de la tâche : ce qui entre, et ce qui doit sortir.
- L’encodeur seul, quand la sortie n’est pas un texte. Classer un document dans une catégorie, y trouver les noms propres, juger de la proximité de deux phrases : le modèle doit lire, pas écrire, et ce qu’il produit est une étiquette, un segment ou un ensemble de vecteurs. BERT lit un texte entier d’un coup, dans les deux sens, et une petite couche propre à la tâche est entraînée par-dessus ses représentations (Devlin et al., 2019) (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres). C’est un modèle à encodeur seul encoder-only modelmodèle à encodeur seul language modelsmodèles de langue A neural-network architecture that processes an input sequence and produces a contextual representation for each input token, without using a separate decoder to generate an output sequence.Architecture de réseau de neurones qui traite une séquence d'entrée et produit une représentation contextuelle de chaque jeton, sans décodeur distinct pour générer une séquence de sortie. .
- Le décodeur seul, quand la sortie prolonge l’entrée. La réponse d’un agent conversationnel et la requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. qui l’a produite forment un seul texte courant : il n’y a donc rien de distinct à lire, et chaque mot est produit à partir de tout ce qui précède, requête comprise (Radford et al., 2019). C’est un modèle à décodeur seul decoder-only modelmodèle à décodeur seul language modelsmodèles de langue A transformer language-model architecture that uses a sequence of decoder blocks without a separate encoder.Architecture de modèle de langue à transformeur qui enchaîne des blocs décodeurs sans encodeur distinct. , et le comportement d’un générateur vient de là (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML).
- Les deux, quand une séquence devient une séquence différente. La sortie ne prolonge pas l’entrée et peut être dans une autre langue, une autre forme ou un autre média : l’entrée doit donc être lue en entier avant que la sortie soit écrite, et les deux moitiés restent reliées par l’attention croisée. La traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. est le cas qui nous occupe, et ce n’est pas le seul : la reconnaissance de la parole fonctionne de la même manière, l’encodeur lisant l’audio et le décodeur écrivant le texte (Radford et al., 2023), comme la traduction de la parole et le résumé automatique.
La frontière n’est pas un mur. Un modèle à décodeur seul traduit très bien quand le texte de départ et sa traduction lui sont donnés comme un seul texte courant, ce qui arrive chaque fois qu’on demande une traduction à un agent conversationnel (see also the Machine translation module) (voir aussi le module Traduction automatique).
La figure de l’alignement est l’accroche pour ce groupe : chaque mot d’arrivée puise dans les mots de départ qu’il rend, appris sur des exemples plutôt que déclarés. Les trois couleurs sont les trois attentions, les mêmes que dans la figure à trois panneaux de la page précédente. Puis les trois architectures, à partir de la forme de la tâche plutôt que des noms.
Pourquoi le « grand » commence ici
Le transformeur a amélioré la qualité, et le changement le plus profond a été économique. Un modèle séquentiel traite les mots comme des clients dans une seule file : un à la fois, aussi rapide que soit chaque étape. Un transformeur ouvre toutes les caisses en même temps, ce qui est exactement la charge de travail pour laquelle les processeurs graphiques sont faits.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Entraîner sur des ensembles de textes d’une taille inimaginable en 2016 est devenu courant en quelques années, et la taille des modèles comme celle des données ont augmenté de plusieurs ordres de grandeur (Hoffmann et al., 2022). Tous les systèmes du module sur le cycle de vie des GML sont des transformeurs au fond (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML) ; sans le traitement parallèle, le « grand » serait resté hors de portée.
Le coût de l’attention
L’attention pèse chaque paire de mots : doubler la longueur d’un texte quadruple donc à peu près le travail. Chaque modèle doit plafonner quelque part la quantité de texte qu’il traite d’un coup, et ce plafond est la fenêtre contextuelle : la raison pour laquelle un agent conversationnel perd le fil d’une longue conversation, et la raison pour laquelle « traduis-moi ce document de 200 pages d’un coup » n’est pas la façon dont ces systèmes fonctionnent (see also the Counting in tokens page, in the Language as numbers module) (voir aussi la page Compter en jetons, dans le module Le langage en nombres).
Fermer sur l’encadré plutôt que sur le mécanisme : une attention élevée entre deux mots signifie que les données d’entraînement ont rendu cette liaison utile à la prédiction, et rien de plus. Savoir si la reconnaissance de motifs à cette échelle équivaut à quelque chose de plus est le débat qui s’ouvre à la séance 3.
Lire avant de traduire
Quand vous traduisez, il vous faut du contexte avant de pouvoir vous engager. Vous ne pouvez pas commencer à rendre une phrase dès son premier mot : vous lisez plus loin, quelques mots au moins, pour voir où elle va. Prenez par exemple la traduction de l’anglais vers le français de la Figure 8figure 8.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
C’est pourquoi les transformeurs transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. , qui peuvent prendre en compte tout le contexte d’une phrase à la fois, ont si nettement surpassé les modèles séquentiels qui les précédaient : she est à une seule connexion de épuisée, où que les deux se trouvent.
D’où vient chaque mot d’arrivée
Pendant que le décodeur decoderdécodeur deep learningapprentissage profond A neural-network component or architecture used to generate an output sequence.Composant ou architecture de réseau de neurones servant à générer une séquence de sortie. écrit coureuse, l’attention croisée cross-attentionattention croisée deep learningapprentissage profond An attention mechanism in which the queries come from one sequence or component and the keys and values come from another.Mécanisme d'attention dans lequel les requêtes proviennent d'une séquence ou d'un composant et les clés et valeurs d'un autre. pèse les mots de la phrase anglaise les uns contre les autres, et runner, le mot qu’il s’agit de rendre, domine (see also the Encoders and decoders page, in the Language as numbers module) (voir aussi la page Encodeurs et décodeurs, dans le module Le langage en nombres). Faites cela à chaque mot d’arrivée et il en sort une carte entre les deux textes : ce mot-ci rend ce mot-là. C’est proche de ce qu’une traductrice ou un traducteur appelle un alignement, et proche de ce que calcule un outil de TAO quand il aligne un fichier de départ avec sa traduction.
Personne n’a donné cette carte au modèle. Il l’a établie à partir de millions de paires de phrases traduites, quatre millions et demi pour le système anglais-allemand de l’article d’origine (Vaswani et al., 2017).
Le contexte s’est arrêté à la phrase
L’attention n’a pas changé la quantité de texte qui entre d’un coup. La traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. a continué pendant des années à travailler une phrase à la fois : un terme réglé dans une phrase n’avait donc aucune portée sur la suivante, et un pronom ne pouvait pas remonter au paragraphe qui nommait son référent. Traduire avec tout le document sous les yeux est un axe de recherche à part entière (Voita et al., 2019 ; Maruf et al., 2021), et fournir un texte entier n’est devenu ordinaire qu’avec les longues fenêtres contextuelles context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). des modèles d’aujourd’hui (see also the Machine translation module) (voir aussi le module Traduction automatique).
Construire l’exemple de la coureuse avec le groupe avant la figure : demander la traduction française de I’m exhausted, said the runner, et les laisser trouver les engagements pris avant que she arrive.
Not words, but tokens
Everything so far has said word: a vector for each word, attention between words. That is a simplification.
Take the sentence Tokenization shapes everything. You read three words and a full stop. Systems built to work with language cut it up in their own ways, as Figure 1figure 1 shows: 31 characters for one, five tokens for another, each token an entry in a vocabulary vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. with a number attached. This is why careful writing says “next-token prediction next-token predictionprédiction du jeton suivant language modelsmodèles de langue The task of estimating the probabilities of the tokens that could follow a given sequence of tokens.Tâche consistant à estimer les probabilités des jetons qui pourraient suivre une séquence de jetons donnée. ” rather than “next-word prediction”. Words are a human unit.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Frequency decides the cuts
The cuts are statistical. They fall where character sequences were frequent in
the text the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. was built on, which is why
Tokenization splits into Token and ization while shapes and
everything stay whole. In this example the split happens to align with the
linguistic structure of the word. That is not guaranteed at all.
The live demonstration goes here, and it needs a model open in front of the room rather than a slide: ask one to spell a word backwards, or to count the letters of a rare word, and show the same word split in Tiktokenizer beside it. Two warnings from the writing of this chapter. First, the famous strawberry question is patched in current models and will probably answer correctly, so pick a rarer word, or a task that manipulates the letters rather than reciting them. Second, whatever the answer, the point is not that the model is bad at counting: it is that the letters were never separate units it received. If a run produces something worth keeping, paste the transcript into the chapter and date it.
The tokenizer runs first
When you type a sentence into a chatbot, the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. runs first. It is not part of the language model language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. itself, but a completely separate program: trained before use, and from then on only executing the tokenization tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. , never influenced by the model. The two are still inseparable, because the model keeps one row of numbers for each entry in the tokenizer’s vocabulary vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. , so a model and its tokenizer travel together for life. Each token token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. is replaced by its number in that vocabulary, and those numbers are the only version of the text the model receives as input.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Spaces belong to the word that follows
The spaces are inside the tokens. In this tokenizer a space belongs to the word that follows it, which is why two of the boxes carry one and the first does not. The same word is therefore a different token at the start of a line and in the middle of a sentence, and a text already cut on its spaces is counted differently.
One row per token
Each ID number associated with a token can be seen as an address for that token. The model looks it up in that table of rows, and the row it finds there is a vector vectorvecteur machine learningapprentissage automatique An ordered list of numbers.Liste ordonnée de nombres. of the kind the earlier chapters built (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). Everything after that works on the vectors.
Vocabulary
Every model has a fixed list of tokens, chosen before training starts and never added to afterwards. Every text it will ever read or write has to be expressed using the tokens in that list, and whatever is not in the list cannot be represented at all.
How long that list should be is the question this page turns on, and the two obvious answers sit at either end.
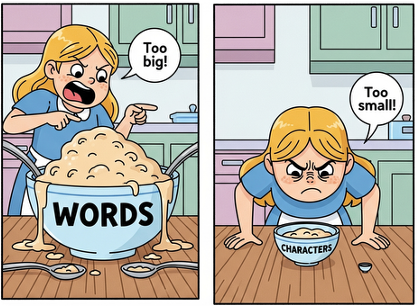
One number per word?
Each token would then be a unit that means something. But a list of words runs into three walls at once.
- It can never be complete. An average twenty-year-old native speaker of American English knows about 42,000 lemmas lemmalemme linguisticslinguistique The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller. (Brysbaert et al., 2016), and real text piles names, technical terms, foreign words, typos and yesterday’s coinages on top of that. No list contains every word of one language, let alone of all of them, and new words appear faster than any list can be revised.
- Rare entries stay poorly learned. A word seen a handful of times in training gets a vector built from those few occurrences, which is not enough to place it usefully. Enlarging the list adds entries of exactly that kind.
- Every entry costs. The model keeps one row of numbers per entry, and at every step it scores every entry in the list to decide what comes next. A longer list means more memory and more computing, for entries that are mostly rare.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
One number per character?
The list would be tiny, a few hundred entries at most, and nothing would ever be missing: any text at all can be spelled out, in any language, typos included. The cost is at the other end. A single character tells you almost nothing, t on its own means nothing, and a page of text becomes a very long run of them, as the character row of Figure 1figure 1 shows. The model would have to rebuild every word from scratch, every time one occurred.
Pieces in between
New words are mostly made of familiar pieces, and that is the way out. You can read antibacterial without having seen it before, because anti-, bacteri and -al are old acquaintances. A vocabulary of pieces, some of them whole words and some fragments, keeps the common words whole and can still spell out anything at all, down to single characters in the worst case.
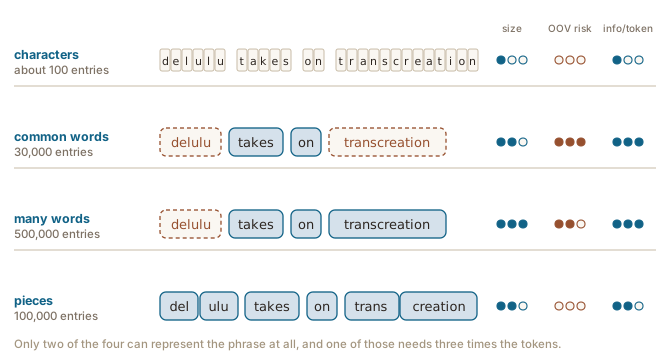
With the subword strategy, single characters are still part of the vocabulary as well. So when no larger piece matches, any sequence at all can still be covered by the individual characters, and there are no out-of-vocabulary problems left: not for a typo, a surname, a word in a language the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. barely saw, or a line of pure gibberish. What varies is the number of tokens. A familiar word is one token, and an unfamiliar one takes as many as it takes to spell it (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Vocabulary
Every model has a fixed list of tokens, chosen before training starts and never added to afterwards. Every text it will ever read or write has to be expressed using the tokens in that list, and whatever is not in the list cannot be represented at all.
How long that list should be is the question this page turns on, and the two obvious answers sit at either end.
One number per word?
Each token would then be a unit that means something. But a list of words runs into three walls at once.
- It can never be complete. An average twenty-year-old native speaker of American English knows about 42,000 lemmas lemmalemme linguisticslinguistique The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller. (Brysbaert et al., 2016), and real text piles names, technical terms, foreign words, typos and yesterday’s coinages on top of that. No list contains every word of one language, let alone of all of them, and new words appear faster than any list can be revised.
- Rare entries stay poorly learned. A word seen a handful of times in training gets a vector built from those few occurrences, which is not enough to place it usefully. Enlarging the list adds entries of exactly that kind.
- Every entry costs. The model keeps one row of numbers per entry, and at every step it scores every entry in the list to decide what comes next. A longer list means more memory and more computing, for entries that are mostly rare.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
One number per character?
The list would be tiny, a few hundred entries at most, and nothing would ever be missing: any text at all can be spelled out, in any language, typos included. The cost is at the other end. A single character tells you almost nothing, t on its own means nothing, and a page of text becomes a very long run of them, as the character row of Figure 1figure 1 shows. The model would have to rebuild every word from scratch, every time one occurred.
Pieces in between
New words are mostly made of familiar pieces, and that is the way out. You can read antibacterial without having seen it before, because anti-, bacteri and -al are old acquaintances. A vocabulary of pieces, some of them whole words and some fragments, keeps the common words whole and can still spell out anything at all, down to single characters in the worst case.
With the subword strategy, single characters are still part of the vocabulary as well. So when no larger piece matches, any sequence at all can still be covered by the individual characters, and there are no out-of-vocabulary problems left: not for a typo, a surname, a word in a language the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. barely saw, or a line of pure gibberish. What varies is the number of tokens. A familiar word is one token, and an unfamiliar one takes as many as it takes to spell it (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Learning the pieces by counting
Which pieces should a subword vocabulary contain? Choosing them by hand would be rule-writing all over again. The standard method, byte-pair encoding, learns them from a corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. with a procedure simple enough to state in three steps (Sennrich et al., 2016):
- Split the whole corpus into single characters. These are the first tokens.
- Count every pair of adjacent tokens, and merge the most frequent pair into one new token, everywhere it occurs.
- Repeat step 2 until the vocabulary reaches the size you chose.
Learned once, applied forever
Frequent words quickly get their own token (the is one of the first) and rarer ones stay in a few pieces. Length counts as well as frequency: every merge joins two neighbours, so a long word needs many of them before it is whole again, and a short word of the same frequency gets there sooner. Frequent endings and stems, -ing, -tion, get a token too, because they recur across thousands of words.
The counting happens once and produces a list of merges. That list is then applied unchanged to every text the model ever reads, including yours.
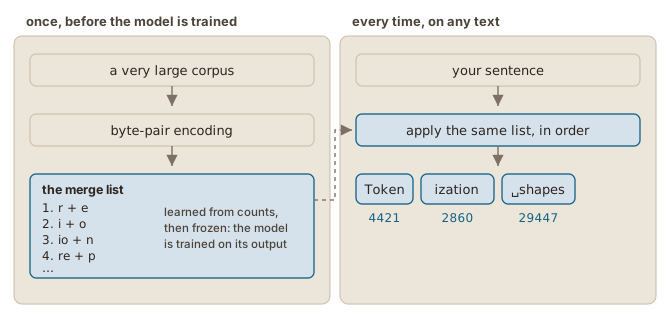
Counting pairs, one merge at a time
Here the whole training corpus is three words: representation, retention, repression. Three steps by hand are enough to see what kind of vocabulary comes out.
Start by splitting everything into characters, nine distinct ones in all:
r e p r e s e n t a t i o n
r e t e n t i o n
r e p r e s s i o n
Count adjacent pairs. The pair r e occurs five times (twice in
representation, once in retention, twice in repression), more than any
other, so it becomes the first new token:
re p re s e n t a t i o n
re t e n t i o n
re p re s s i o n
Recounting and merging seven more times, io then ion, then the three
merges that build repres and the two that make ent, leaves a corpus in
which no pair occurs more than once:
repres ent a t ion
re t ent ion
repres s ionClick the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Morphemes by accident
Seven tokens (repres, ent, a, t, ion, re, s) now cover all three
words. Counting pairs and nothing else found ion and ent, real English
morphemes, and repres, a shared stem. It also produced
repres·ent·a·t·ion, which no linguist would propose as a morphological
analysis of representation.
The same procedure at real scale
On a real corpus the process is the same at two different scales: millions of documents to start from, and a target vocabulary size that stops the merging while frequent pairs are still left to merge. Common words are rebuilt whole well before that point; the cut-off is what leaves the long tail in pieces. Sennrich et al. (2016), introducing the method for translation, used 59,500 merge operations for one language pair and 89,500 for another. Two of the basic building blocks for current large language models came out of machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. research: subword tokenization here, and the transformer transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. a year later (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres). The tokenizers tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. of today’s largest models run to a few hundred thousand.
Run the first merge with the room before showing the trace: three words on the board, count the pairs, find that r + e wins with five. Then the figure does the rest. The two things to draw out at the end: ion and ent are real morphemes nobody told it about, and repres·ent·a·t·ion is not a morphological analysis anyone would defend.
Paste and look
Any text pasted into a tokenizer comes back split, token by token.
The two screenshots below were taken on 8 September 2026 with GPT-4o selected, and cropped to the panels that matter. Both the interface and the splits change, so what you see today may not match them.
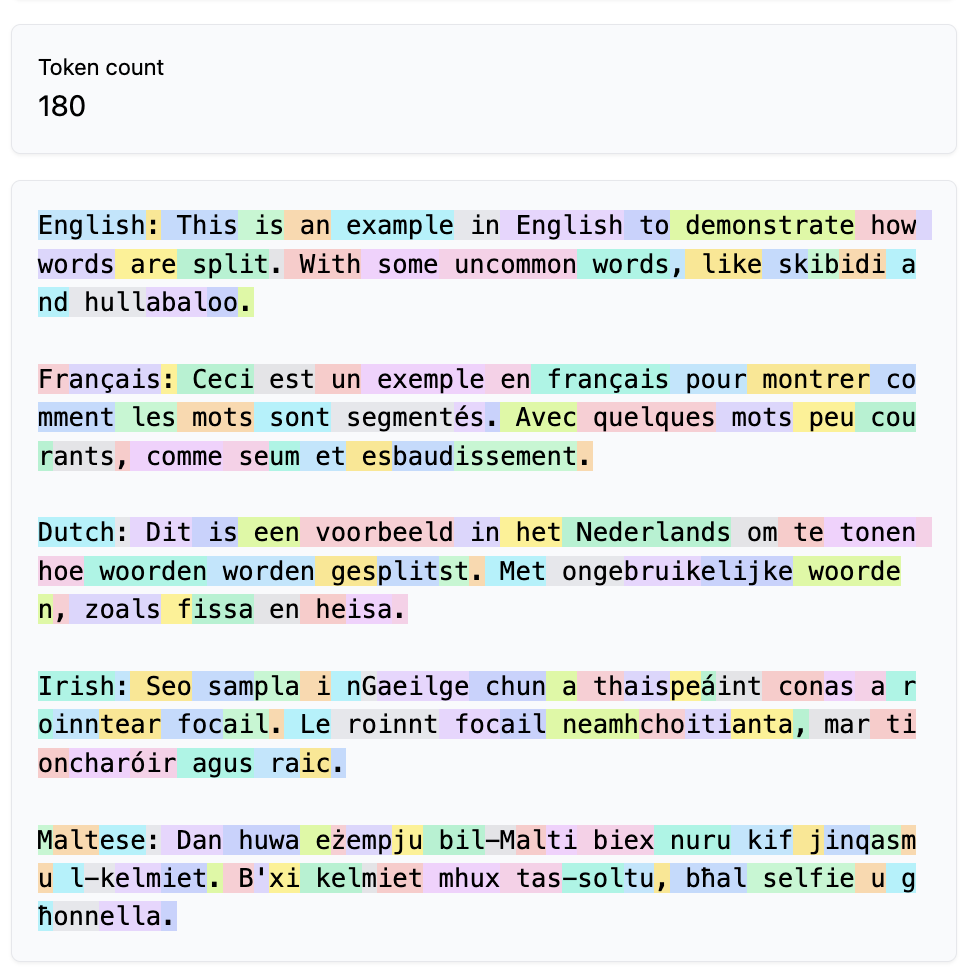
What you should see
- Common English words are one token each, because the merges that build them ran often enough.
- Rare words and typos shatter. Tokenization itself comes out in two or three pieces, and htis in more.
- Other languages cost more tokens for the same sentence, and the further a language is from the training text, the more it costs.
One vocabulary per model
The vocabulary behind the splitting is a design decision, and it has grown. GPT-2 worked with 50,257 tokens (Radford et al., 2019); the tokenizers OpenAI has released since, in its open tiktoken library, reach roughly 200,000. Much of that growth went to non-English text: a recent tokenizer keeps whole many French and Dutch words an older one fragmented. The differences between languages shrink without disappearing, and they can be measured (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Tiktokenizer offers a choice of models, and the most recent OpenAI one it lists is GPT-4o. That is the tool lagging rather than anything withheld: tiktoken maps GPT-5 to the same vocabulary as GPT-4o, so the split above is the current one. Other companies are less open about this than OpenAI. Anthropic publishes no tokenizer for Claude, only an endpoint that reports how many tokens a text costs, so for those models the count can be checked and the cuts cannot be seen.
Tiktokenizer live, and let the room supply the text: an English sentence, the same sentence in French, then a surname. The French cost is the result that matters for this course, and it is measured properly in the consequences chapter, read for séance 3.
Pas des mots, mais des jetons
Tout ce qui précède a dit mot : un vecteur par mot, de l’attention entre les mots. C’est une simplification.
Prenez la phrase Tokenization shapes everything. Vous y lisez trois mots et un point. Les systèmes construits pour travailler sur la langue la découpent chacun à leur manière, comme le montre la Figure 1figure 1 : 31 caractères pour l’un, cinq jetons pour l’autre, chaque jeton une entrée d’un vocabulaire vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. avec un numéro attaché. C’est pourquoi une écriture soignée dit « prédiction du jeton suivant next-token predictionprédiction du jeton suivant language modelsmodèles de langue The task of estimating the probabilities of the tokens that could follow a given sequence of tokens.Tâche consistant à estimer les probabilités des jetons qui pourraient suivre une séquence de jetons donnée. » plutôt que « prédiction du mot suivant ». Le mot est une unité humaine.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
La fréquence décide des coupes
Les coupes sont statistiques. Elles tombent là où des suites de caractères
étaient fréquentes dans les textes sur lesquels le
segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. a été construit, ce qui explique que
Tokenization se découpe en Token et ization alors que shapes et
everything restent entiers. Dans cet exemple, le découpage s’aligne par
hasard sur la structure linguistique du mot. Ce n’est pas garanti du tout.
La démonstration en direct va ici, et il faut un modèle ouvert devant le groupe plutôt qu’une diapositive : demander d’épeler un mot à l’envers, ou de compter les lettres d’un mot rare, et montrer le même mot découpé dans Tiktokenizer à côté. Deux avertissements issus de l’écriture de ce chapitre. D’abord, la fameuse question de strawberry est corrigée dans les modèles actuels et recevra probablement la bonne réponse : prendre un mot plus rare, ou une tâche qui manipule les lettres plutôt que de les réciter. Ensuite, quelle que soit la réponse, le point n’est pas que le modèle compte mal : c’est que les lettres n’ont jamais été des unités distinctes qu’il ait reçues. Si un essai donne quelque chose à garder, coller la transcription dans le chapitre et la dater.
Le segmenteur passe en premier
Quand vous tapez une phrase dans un agent conversationnel, le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. passe en premier. Il ne fait pas partie du modèle de langue language model (LM)modèle de langue language modelsmodèles de langue A machine-learning model that estimates how likely different sequences of language are.Modèle d'apprentissage automatique qui estime la probabilité de différentes séquences de langue. lui-même, mais est un programme entièrement distinct : entraîné avant usage, il ne fait ensuite qu’exécuter la jetonisation tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. , sans jamais être influencé par le modèle. Les deux restent malgré tout inséparables, parce que le modèle garde une rangée de nombres par entrée du vocabulaire vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. du segmenteur : un modèle et son segmenteur vont donc ensemble pour la vie. Chaque jeton token²jeton textuel² language modelsmodèles de langue A unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. est remplacé par son numéro dans ce vocabulaire, et ces nombres sont la seule version du texte que le modèle reçoit en entrée.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Les espaces appartiennent au mot qui suit
Les espaces sont à l’intérieur des jetons. Dans ce segmenteur, une espace appartient au mot qui la suit, ce qui explique que deux des cases en portent une et que la première n’en porte pas. Un même mot est donc un jeton différent au début d’une ligne et au milieu d’une phrase, et un texte déjà découpé sur ses espaces se compte autrement.
Une rangée par jeton
Chaque numéro d’identifiant associé à un jeton peut se voir comme une adresse pour ce jeton. Le modèle la consulte dans cette table de rangées, et la rangée qu’il y trouve est un vecteur vectorvecteur machine learningapprentissage automatique An ordered list of numbers.Liste ordonnée de nombres. du genre que les chapitres précédents ont construit (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). Tout ce qui suit travaille sur les vecteurs.
Le vocabulaire
Chaque modèle a une liste fixe de jetons, choisie avant le début de l’entraînement et jamais complétée ensuite. Tout texte qu’il lira ou écrira doit s’exprimer avec les jetons de cette liste, et ce qui n’y figure pas ne peut pas être représenté du tout.
Quelle doit être la longueur de cette liste ? C’est la question qui occupe cette page, et les deux réponses évidentes se trouvent aux deux extrémités.
Un numéro par mot ?
Chaque jeton serait alors une unité qui veut dire quelque chose. Mais une liste de mots se heurte à trois murs à la fois.
- Elle ne peut jamais être complète. Une personne moyenne de vingt ans dont l’anglais américain est la langue maternelle connaît environ 42 000 lemmes lemmalemme linguisticslinguistique The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller. (Brysbaert et al., 2016), et les textes réels y ajoutent des noms propres, des termes techniques, des mots étrangers, des coquilles et les néologismes d’hier. Aucune liste ne contient tous les mots d’une seule langue, encore moins de toutes, et les mots nouveaux apparaissent plus vite qu’aucune liste ne peut être révisée.
- Les entrées rares restent mal apprises. Un mot vu une poignée de fois à l’entraînement reçoit un vecteur construit sur ces quelques occurrences, ce qui ne suffit pas à le placer utilement. Agrandir la liste ajoute des entrées exactement de ce genre.
- Chaque entrée coûte. Le modèle garde une rangée de nombres par entrée, et à chaque étape il attribue un score à chaque entrée de la liste pour décider de la suite. Une liste plus longue veut dire plus de mémoire et plus de calcul, pour des entrées le plus souvent rares.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Un numéro par caractère ?
La liste serait minuscule, quelques centaines d’entrées au plus, et rien ne manquerait jamais : n’importe quel texte peut s’épeler, dans n’importe quelle langue, coquilles comprises. Le coût est à l’autre bout. Un caractère isolé ne dit presque rien, t tout seul ne veut rien dire, et une page de texte devient une très longue suite de caractères, comme le montre la rangée des caractères de la Figure 1figure 1. Le modèle devrait reconstruire chaque mot depuis le début, chaque fois qu’il en rencontre un.
Des morceaux entre les deux
Les mots nouveaux sont surtout faits de morceaux familiers, et c’est là que se trouve l’issue. Vous pouvez lire antibactérien sans l’avoir jamais vu, parce que anti-, bactér et -ien sont de vieilles connaissances. Un vocabulaire de morceaux, dont certains sont des mots entiers et d’autres des fragments, garde les mots courants entiers et peut malgré tout épeler n’importe quoi, jusqu’aux caractères isolés dans le pire des cas.
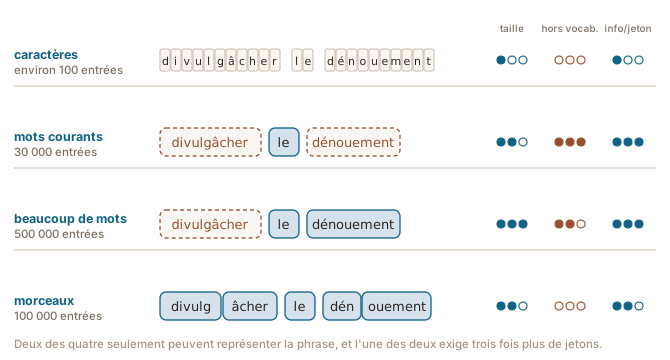
Avec la stratégie sous-lexicale, les caractères isolés font toujours partie du vocabulaire. Donc, quand aucun morceau plus grand ne correspond, n’importe quelle suite peut encore être couverte par les caractères individuels, et il ne reste aucun problème de mot hors vocabulaire : ni pour une coquille, ni pour un patronyme, ni pour un mot dans une langue que le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. a à peine vue, ni pour une ligne de pur charabia. Ce qui varie, c’est le prix. Un mot familier coûte un jeton, et un mot inconnu en coûte autant qu’il en faut pour l’épeler (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Le vocabulaire
Chaque modèle a une liste fixe de jetons, choisie avant le début de l’entraînement et jamais complétée ensuite. Tout texte qu’il lira ou écrira doit s’exprimer avec les jetons de cette liste, et ce qui n’y figure pas ne peut pas être représenté du tout.
Quelle doit être la longueur de cette liste ? C’est la question qui occupe cette page, et les deux réponses évidentes se trouvent aux deux extrémités.
Un numéro par mot ?
Chaque jeton serait alors une unité qui veut dire quelque chose. Mais une liste de mots se heurte à trois murs à la fois.
- Elle ne peut jamais être complète. Une personne moyenne de vingt ans dont l’anglais américain est la langue maternelle connaît environ 42 000 lemmes lemmalemme linguisticslinguistique The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller. (Brysbaert et al., 2016), et les textes réels y ajoutent des noms propres, des termes techniques, des mots étrangers, des coquilles et les néologismes d’hier. Aucune liste ne contient tous les mots d’une seule langue, encore moins de toutes, et les mots nouveaux apparaissent plus vite qu’aucune liste ne peut être révisée.
- Les entrées rares restent mal apprises. Un mot vu une poignée de fois à l’entraînement reçoit un vecteur construit sur ces quelques occurrences, ce qui ne suffit pas à le placer utilement. Agrandir la liste ajoute des entrées exactement de ce genre.
- Chaque entrée coûte. Le modèle garde une rangée de nombres par entrée, et à chaque étape il attribue un score à chaque entrée de la liste pour décider de la suite. Une liste plus longue veut dire plus de mémoire et plus de calcul, pour des entrées le plus souvent rares.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Un numéro par caractère ?
La liste serait minuscule, quelques centaines d’entrées au plus, et rien ne manquerait jamais : n’importe quel texte peut s’épeler, dans n’importe quelle langue, coquilles comprises. Le coût est à l’autre bout. Un caractère isolé ne dit presque rien, t tout seul ne veut rien dire, et une page de texte devient une très longue suite de caractères, comme le montre la rangée des caractères de la Figure 1figure 1. Le modèle devrait reconstruire chaque mot depuis le début, chaque fois qu’il en rencontre un.
Des morceaux entre les deux
Les mots nouveaux sont surtout faits de morceaux familiers, et c’est là que se trouve l’issue. Vous pouvez lire antibactérien sans l’avoir jamais vu, parce que anti-, bactér et -ien sont de vieilles connaissances. Un vocabulaire de morceaux, dont certains sont des mots entiers et d’autres des fragments, garde les mots courants entiers et peut malgré tout épeler n’importe quoi, jusqu’aux caractères isolés dans le pire des cas.
Avec la stratégie sous-lexicale, les caractères isolés font toujours partie du vocabulaire. Donc, quand aucun morceau plus grand ne correspond, n’importe quelle suite peut encore être couverte par les caractères individuels, et il ne reste aucun problème de mot hors vocabulaire : ni pour une coquille, ni pour un patronyme, ni pour un mot dans une langue que le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. a à peine vue, ni pour une ligne de pur charabia. Ce qui varie, c’est le prix. Un mot familier coûte un jeton, et un mot inconnu en coûte autant qu’il en faut pour l’épeler (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Apprendre les morceaux en comptant
Quels morceaux un vocabulaire sous-lexical doit-il contenir ? Les choisir à la main reviendrait à écrire des règles, encore une fois. La méthode standard, l’encodage par paires d’octets, les apprend d’un corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. avec une procédure assez simple pour tenir en trois étapes (Sennrich et al., 2016) :
- Découper tout le corpus en caractères isolés. Ce sont les premiers jetons.
- Compter chaque paire de jetons voisins, et fusionner la paire la plus fréquente en un nouveau jeton, partout où elle apparaît.
- Répéter l’étape 2 jusqu’à ce que le vocabulaire atteigne la taille choisie.
Appris une fois, appliqué pour toujours
Les mots fréquents obtiennent vite leur propre jeton (le est l’un des premiers) et les plus rares restent en quelques morceaux. La longueur compte aussi, en plus de la fréquence : chaque fusion joint deux voisins, un long mot a donc besoin de nombreuses fusions avant d’être entier de nouveau, et un mot court de même fréquence y arrive plus tôt. Les terminaisons et les radicaux fréquents, -ion, -ment, obtiennent aussi un jeton, parce qu’ils reviennent dans des milliers de mots.
Le comptage n’a lieu qu’une fois et produit une liste de fusions. Cette liste est ensuite appliquée sans changement à tous les textes que le modèle lira, y compris les vôtres.
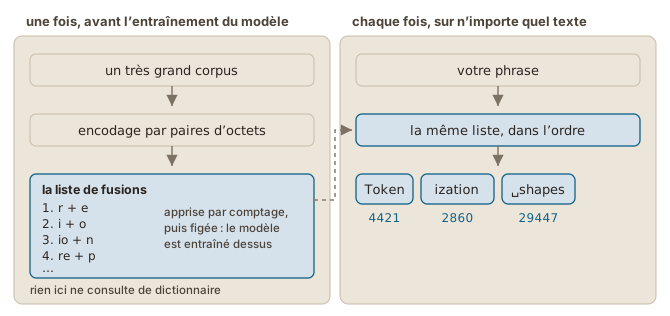
Compter les paires, une fusion à la fois
Ici, tout le corpus d’entraînement tient en trois mots : representation, retention, repression. Trois étapes à la main suffisent à voir quel genre de vocabulaire en sort.
On commence par tout découper en caractères, neuf caractères distincts en tout :
r e p r e s e n t a t i o n
r e t e n t i o n
r e p r e s s i o n
On compte les paires voisines. La paire r e apparaît cinq fois (deux fois
dans representation, une fois dans retention, deux fois dans
repression), plus que toute autre ; elle devient donc le premier nouveau
jeton :
re p re s e n t a t i o n
re t e n t i o n
re p re s s i o n
En recomptant et en fusionnant sept fois de plus, io puis ion, puis les
trois fusions qui construisent repres et les deux qui font ent, on obtient
un corpus où aucune paire n’apparaît plus d’une fois :
repres ent a t ion
re t ent ion
repres s ionClick the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Des morphèmes par accident
Sept jetons (repres, ent, a, t, ion, re, s) couvrent maintenant
les trois mots. Compter les paires et rien d’autre a trouvé ion et ent, de
vrais morphèmes de l’anglais, et repres, un radical commun. Cela a aussi
produit repres·ent·a·t·ion, qu’aucune linguiste ne proposerait comme analyse
morphologique de representation.
La même procédure à l’échelle réelle
Sur un corpus réel, le procédé est le même à deux échelles différentes : des millions de documents au départ, et une taille de vocabulaire visée qui arrête les fusions alors qu’il reste encore des paires fréquentes à fusionner. Les mots courants sont reconstruits entiers bien avant ce point ; c’est le seuil qui laisse la longue traîne en morceaux. Sennrich et al. (2016), en présentant la méthode pour la traduction, ont utilisé 59 500 opérations de fusion pour une paire de langues et 89 500 pour une autre. Deux des briques de base des grands modèles de langue actuels sont sorties de la recherche en traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. : la segmentation sous-lexicale ici, et le transformeur transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. un an plus tard (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres). Les segmenteurs tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. des plus grands modèles d’aujourd’hui vont jusqu’à quelques centaines de milliers.
Faire la première fusion avec le groupe avant de montrer la trace : trois mots au tableau, compter les paires, trouver que r + e gagne avec cinq. Ensuite la figure fait le reste. Les deux choses à faire ressortir à la fin : ion et ent sont de vrais morphèmes que personne ne lui a appris, et repres·ent·a·t·ion n’est pas une analyse morphologique défendable.
Coller un texte et regarder
N’importe quel texte collé dans un segmenteur en ressort découpé, jeton par jeton.
Les deux captures ci-dessous ont été prises le 8 septembre 2026 avec GPT-4o sélectionné, et rognées sur les panneaux qui comptent. L’interface comme les découpages changent : ce que vous verrez aujourd’hui peut ne pas y correspondre.
Ce que vous devriez voir
- Les mots anglais courants font un jeton chacun, parce que les fusions qui les construisent ont tourné assez souvent.
- Les mots rares et les coquilles éclatent. Tokenization lui-même ressort en deux ou trois morceaux, et htis en davantage.
- Les autres langues coûtent plus de jetons pour la même phrase, et plus une langue est éloignée des textes d’entraînement, plus elle coûte cher.
Un vocabulaire par modèle
Le vocabulaire derrière le découpage est une décision de conception, et il a grandi. GPT-2 travaillait avec 50 257 jetons (Radford et al., 2019) ; les segmenteurs qu’OpenAI a publiés depuis, dans sa bibliothèque ouverte tiktoken, atteignent environ 200 000. Une bonne part de cette croissance est allée aux textes non anglais : un segmenteur récent garde entiers de nombreux mots français et néerlandais qu’un ancien fragmentait. Les écarts entre les langues se réduisent sans disparaître, et ils se mesurent (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Tiktokenizer propose un choix de modèles, et le plus récent d’OpenAI qu’il énumère est GPT-4o. C’est l’outil qui est en retard, non quelque chose qu’on retiendrait : tiktoken associe GPT-5 au même vocabulaire que GPT-4o, si bien que le découpage ci-dessus est celui d’aujourd’hui. D’autres entreprises sont moins ouvertes qu’OpenAI là-dessus. Anthropic ne publie aucun segmenteur pour Claude, seulement un point d’accès qui indique combien de jetons coûte un texte : pour ces modèles, le compte se vérifie et les coupes ne se voient pas.
Tiktokenizer en direct, et laisser le groupe fournir le texte : une phrase anglaise, la même phrase en français, puis un nom de famille. Le coût du français est le résultat qui compte pour ce cours, et il est mesuré correctement dans le chapitre sur les conséquences, à lire pour la séance 3.
Autocomplete
Type Good into a message on your phone. Your keyboard will suggest the next words it predicts to be most likely: morning, night, luck. Add one letter, Good m, and the list narrows to morning. Nothing in the keyboard understands what you are writing. It is answering a single question: given the words already typed, which word is likely to come next?
Your keyboard answers from something small. The older way is a frequency table: the keyboard has counted which words followed Good, in the text it was built from and in your own past messages, and suggests the most frequent one. Current keyboards run a small neural network neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. instead, with a vocabulary of around ten thousand words and about a megabyte of storage on the phone (Hard et al., 2018). Either way it looks one or two words behind the cursor.
Click Figure 1figure 1 to test the quality of the autocomplete on my phone.
The same question with more behind it
Compare the results from the autocomplete in Figure 1figure 1 with what we have come to expect from large language models (LLMs) like ChatGPT, Claude, Gemini, etc.
To understand the difference in quality, consider these important differences:
- LLMs are far bigger. The keyboard’s model is around a million adjustable numbers, small enough to sit on the phone in your hand. LLMs have billions of them, and they run on hardware you never see.
- LLMs learned from far more text, written by other people. Your keyboard learned from a modest word list and from your own past messages. LLMs are trained on a very large and varied collection of text. Their vocabulary, their phrasing and their factual associations all come from there.
- LLMs read far more of what you already typed. Where the keyboard uses the last word or two, they take thousands of tokens of preceding text into account, so a pronoun twenty sentences back can still affect what they predict now.
- LLMs represent each word far more richly, and not the same way twice. Both turn words into word embeddings word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , vectors of numbers standing for a word (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). The keyboard’s are about ninety-six numbers long and fixed once, so bank is the same vector in every sentence you type. An LLM’s run to thousands of numbers and are recomputed for the sentence at hand by the attention mechanism attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). , which decides which of the earlier words matter for the word being predicted now (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
One objective to solve many tasks
While LLMs are trained just to predict the next most probable token, that single objective manages to create systems that are good at many tasks. This is quite different from the previous generation of NLP natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. systems, where we had more specialized dedicated tools per task. Instead of one translation model, one summarizing model, one code completion model, we now have one giant LLM able to do it all.
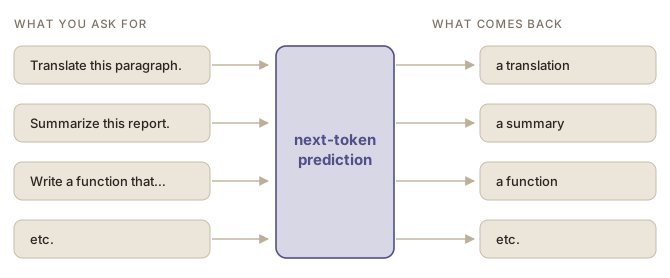
The keyboard figure is the hook: tapping the middle suggestion collapses into “of a bit of a bit of a bit”, and the same half-written message given to a model comes back finished. Worth typing live on a phone if the room wants to see it happen.
Large?
A phone keyboard and large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. are both language models. Clearly, the large here makes a big difference. So in what ways, specifically, is a large language model so large?
- Billions of parameters. Every association the model has picked up, between words, between a country and its capital, between a question and the shape of an answer, is stored across those numbers and nowhere else.
- A large context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). . An LLM takes thousands of tokens of text into account at once and weighs all of them, where earlier systems built on the same transformer transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. architecture usually worked a sentence at a time (Vaswani et al., 2017; Voita et al., 2019). The window is still bounded, though, and text that falls outside it might as well not exist (see also the Inference chapter, in the LLM lifecycle module) (voir aussi le chapitre Inférence, dans le module Cycle de vie des GML).
- A vast corpus of training text. The largest models are trained on close to as much text as can be gathered: a crawl web crawlingexploration du Web datadonnées The automated process of systematically discovering and retrieving pages or other resources from the Web.Processus automatisé de découverte et de récupération systématiques de pages ou d'autres ressources du Web. of the public web, plus books, reference works, news and code (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML). That breadth lets one model be asked about cooking, contract law and Python in the same conversation.
What GPT stands for
GPT is short for Generative Pre-trained Transformer, and each of the three letters names a property of the model. Radford et al. (2018) introduced the model the name comes from, describing the method as generative pre-training of a transformer-based language model; the acronym itself came into use later.
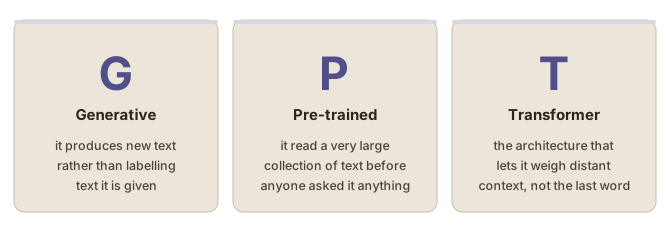
The aside on the page is worth a sentence out loud: nearly every current large language model is a transformer, so the two words get used as one, but nothing in the definition of a language model requires that architecture.
Finishing one sentence
Take an unfinished sentence: The bank was closed because…
Before anything sensible can follow, one thing has to be settled: which bank this is. The financial sense and the riverside sense lead to entirely different continuations, and the sentence so far does not say which is meant. This is the ambiguity a single fixed vector per word could not resolve (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
Settle it on the financial sense, and the continuation still depends on knowing how businesses work: a bank closes for a public holiday, for renovations, at the end of the working day, or permanently because it failed.
And even once you have settled the ambiguity and know enough about the world to suggest a plausible reason, the continuation still has to be grammatical. The bank was closed because holiday gives the right reason and is not a sentence.
What has to be learned
Predicting well across many different texts means having picked up several kinds of regularity at once:
- grammar, syntax and the conventions of a style;
- facts about the world, and the relations between the things named in it;
- patterns of reasoning, such as cause and effect or the order events happen in;
- how people actually use language, including implication and politeness.
None of this is taught separately. Guessing the next word needs all of it, so it all comes out of practising the guess.
Too much text to remember
The amount of text involved rules out the simplest explanation, that the model has the training text stored somewhere. Hoffmann et al. (2022) trained a model of 70 billion parameters on 1.4 trillion tokens. At roughly four characters a token, keeping that text would take about five terabytes, more than most laptops can store. The model that came out of it is 70 billion numbers at two bytes each, about 140 gigabytes, which fits on one laptop with room left over.
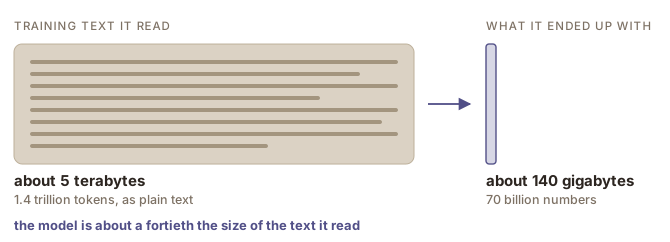
The text itself does not survive that reduction. To predict Paris after the capital of France is, a model does not need that sentence stored; it needs the association between France and Paris, which takes far less room and also works in sentences it has never seen. Karpathy calls the result a lossy compression of the training text (Karpathy, 2023).
It is a metaphor rather than a technical account, and it makes the right point: the output stays recognizably derived from text that was never kept (see also the Pretraining chapter, in the LLM lifecycle module) (voir aussi le chapitre Préentraînement, dans le module Cycle de vie des GML).
None of the four is taught separately: all of it is what it takes to guess the next word, so all of it comes out of practising that guess. Then the ratio: twenty tokens of training text per parameter, so the text cannot be in there. Karpathy’s “lossy compression” is a metaphor, and it makes the right point.
What happens after you press enter
Your prompt goes through the same four steps every time.
- The text is split into tokens (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres).
- Each token becomes a vector, and those vectors pass through the network’s layers.
- The model produces a score for every token in its vocabulary, turned into a probability.
- One token is picked, appended to the text, and the process starts again from step 1.
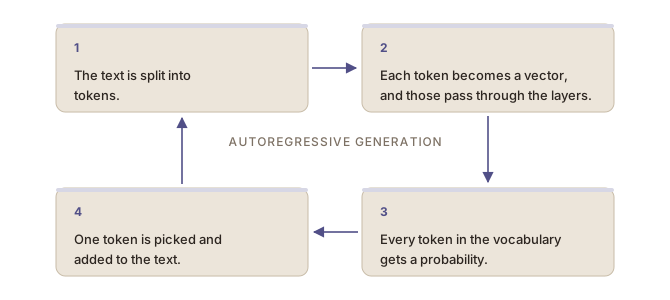
Every token gets a probability
The third step is the one that gets misread. Asked to continue My favourite colour is, the model does not decide on blue. It produces a number for every single token it knows, tens of thousands of them, and those numbers add up to one.
Most of them are absurd here and get probabilities near zero, but they are all scored. Choosing one of them is a separate step, taken after the computation, and the highest number does not always win (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML).
Why the text arrives the way it does
From the outside a model looks as though it reads your question once and writes the answer. Each token in that answer is a separate pass, and every pass reads the prompt together with everything the model has already added.
An answer of five hundred tokens is five hundred of those passes. Two consequences to consider:
- The output appears steadily rather than all at once, because each token has to wait for the one before it.
- The model has no draft. It commits to each token before computing the next, so it cannot plan a sentence, notice halfway that the ending will not work, and revise the beginning.
The second one is the point to land: it cannot plan a sentence, notice halfway that the ending will not work, and revise the beginning. Which choice is made from the distribution is a separate decision, taken after the computation, and that is the inference chapter at séance 3.
La saisie automatique
Tapez Good dans un message sur votre téléphone. Votre clavier vous proposera les mots qu’il juge les plus probables ensuite : morning, night, luck. Ajoutez une lettre, Good m, et la liste se réduit à morning. Rien dans le clavier ne comprend ce que vous écrivez. Il répond à une seule question : étant donné les mots déjà tapés, quel mot a le plus de chances de suivre ?
Votre clavier répond à partir de quelque chose de petit. La façon la plus ancienne est une table de fréquences : le clavier a compté quels mots suivaient Good, dans le texte à partir duquel il a été construit et dans vos propres messages, et il suggère le plus fréquent. Les claviers actuels font plutôt tourner un petit réseau de neurones neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. , avec un vocabulaire d’environ dix mille mots et près d’un mégaoctet de stockage sur le téléphone (Hard et al., 2018). Dans les deux cas, il regarde un mot ou deux avant le curseur.
Cliquez sur Figure 1figure 1 pour tester la qualité de la saisie automatique sur mon téléphone.
La même question, avec bien plus derrière
Comparez les résultats de la saisie automatique de Figure 1figure 1 avec ce que nous avons pris l’habitude d’attendre des grands modèles de langue (GML) comme ChatGPT, Claude, Gemini, etc.
Pour comprendre la différence de qualité, voici les différences importantes :
- Les GML sont bien plus gros. Le modèle du clavier compte environ un million de nombres ajustables, assez peu pour tenir dans le téléphone que vous avez en main. Les GML en ont des milliards, et ils tournent sur du matériel que vous ne voyez jamais.
- Les GML ont appris sur bien plus de texte, écrit par d’autres. Votre clavier a appris à partir d’une liste de mots modeste et de vos propres messages. Les GML sont entraînés sur une collection de textes très vaste et très variée. Leur vocabulaire, leurs tournures et leurs associations factuelles viennent tous de là.
- Les GML lisent bien plus de ce que vous avez déjà tapé. Là où le clavier se sert du dernier mot ou des deux derniers, ils prennent en compte des milliers de jetons de texte précédent, si bien qu’un pronom vingt phrases plus haut peut encore influer sur ce qu’ils prédisent maintenant.
- Les GML représentent chaque mot bien plus richement, et jamais deux fois de la même façon. Les deux transforment les mots en plongements lexicaux word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , des vecteurs de nombres qui tiennent lieu de mot (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). Ceux du clavier font environ quatre-vingt-seize nombres et sont fixés une fois pour toutes, de sorte que bank est le même vecteur dans toutes les phrases que vous tapez. Ceux d’un GML vont jusqu’à des milliers de nombres et sont recalculés pour la phrase en cours par le mécanisme d’attention attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). , qui décide quels mots précédents comptent pour le mot en train d’être prédit (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
Un seul objectif pour résoudre de nombreuses tâches
Alors que les GML sont entraînés uniquement à prédire le jeton suivant le plus probable, cet objectif unique parvient à créer des systèmes qui sont bons dans de nombreuses tâches. C’est très différent de la génération précédente de systèmes de TAL natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. , où l’on avait des outils spécialisés et dédiés, un par tâche. Au lieu d’un modèle de traduction, d’un modèle de résumé, d’un modèle de complétion de code, nous avons maintenant un seul GML géant capable de tout faire.
La figure du clavier est l’accroche : en touchant la suggestion du milieu, le message finit par tourner en rond, « je vous remercie de votre réponse je vous remercie ». Cliquer la figure étape par étape devant la salle. À faire en direct sur un téléphone si le groupe veut le voir arriver.
Grand ?
Un clavier de téléphone et les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. sont tous des modèles de langue. De toute évidence, le « grand » fait ici une grande différence. Alors, en quoi, précisément, un grand modèle de langue est-il si grand ?
- Des milliards de paramètres. Chaque association que le modèle a captée, entre des mots, entre un pays et sa capitale, entre une question et la forme d’une réponse, est stockée à travers ces nombres et nulle part ailleurs.
- Une grande fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). . Un GML prend en compte des milliers de jetons de texte à la fois et les pondère tous, là où les systèmes antérieurs bâtis sur la même architecture transformeur transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. travaillaient généralement une phrase à la fois (Vaswani et al., 2017 ; Voita et al., 2019). La fenêtre reste toutefois bornée, et le texte qui en sort n’existe pour ainsi dire plus (see also the Inference chapter, in the LLM lifecycle module) (voir aussi le chapitre Inférence, dans le module Cycle de vie des GML).
- Un corpus d’entraînement colossal. Les plus grands modèles sont entraînés sur presque tout le texte qu’il est possible de rassembler : une exploration du Web web crawlingexploration du Web datadonnées The automated process of systematically discovering and retrieving pages or other resources from the Web.Processus automatisé de découverte et de récupération systématiques de pages ou d'autres ressources du Web. public, plus des livres, des ouvrages de référence, des nouvelles et du code (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML). Cette ampleur permet d’interroger un même modèle sur la cuisine, le droit des contrats et Python dans une même conversation.
Ce que veut dire GPT
GPT est l’abréviation de Generative Pre-trained Transformer, et chacune des trois lettres nomme une propriété du modèle. Radford et al. (2018) ont présenté le modèle dont vient le nom, en décrivant la méthode comme un préentraînement génératif d’un modèle de langue fondé sur un transformeur ; l’acronyme lui-même s’est répandu plus tard.
L’encadré de la page vaut une phrase à voix haute : presque tous les grands modèles de langue actuels sont des transformeurs, d’où les deux termes employés comme un seul, mais rien dans la définition d’un modèle de langue n’exige cette architecture.
Terminer une phrase
Prenez une phrase inachevée : The bank was closed because…
Avant que quoi que ce soit de sensé puisse suivre, une chose doit être réglée : de quelle bank il s’agit. Le sens financier et le sens de la rive mènent à des suites entièrement différentes, et la phrase telle quelle ne dit pas lequel est visé. C’est l’ambiguïté qu’un vecteur unique et fixe par mot ne pouvait pas lever (see also the Contextual embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements contextuels, dans le module Le langage en nombres).
Réglez-la sur le sens financier, et la suite dépend encore de ce que l’on sait du fonctionnement des entreprises : une banque ferme pour un jour férié, pour des rénovations, à la fin de la journée de travail, ou définitivement parce qu’elle a fait faillite.
Et même une fois l’ambiguïté réglée et le monde assez bien connu pour proposer une raison plausible, la suite doit encore être grammaticale. The bank was closed because holiday donne la bonne raison et n’est pas une phrase.
Ce qu’il faut avoir appris
Bien prédire à travers des textes très divers suppose d’avoir capté plusieurs sortes de régularités à la fois :
- la grammaire, la syntaxe et les conventions d’un style ;
- des faits sur le monde, et les relations entre les choses qu’on y nomme ;
- des schémas de raisonnement, comme la cause et l’effet ou l’ordre dans lequel les événements se produisent ;
- la façon dont les gens emploient réellement la langue, sous-entendus et politesse compris.
Rien de tout cela n’est enseigné à part. Prédire le mot suivant exige tout cela, si bien que tout cela sort de l’exercice répété de la prédiction.
Trop de texte pour s’en souvenir
La quantité de texte en jeu écarte l’explication la plus simple, celle où le modèle aurait le texte d’entraînement stocké quelque part. Hoffmann et al. (2022) ont entraîné un modèle de 70 milliards de paramètres sur 1 400 milliards de jetons. À environ quatre caractères par jeton, conserver ce texte prendrait quelque cinq téraoctets, plus que ne contiennent la plupart des ordinateurs portables. Le modèle qui en est sorti, c’est 70 milliards de nombres à deux octets chacun, environ 140 gigaoctets, qui tiennent sur un seul portable avec de la place en trop.
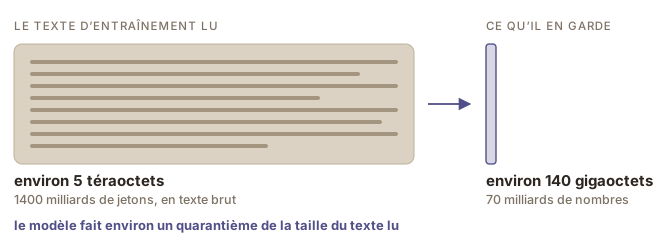
Le texte lui-même ne survit pas à cette réduction. Pour prédire Paris après the capital of France is, un modèle n’a pas besoin d’avoir cette phrase en mémoire : il a besoin de l’association entre la France et Paris, qui prend bien moins de place et vaut aussi dans des phrases qu’il n’a jamais vues. Karpathy (2023) appelle le résultat une compression avec perte du texte d’entraînement.
C’est une métaphore plutôt qu’un compte rendu technique, et elle vise juste : la sortie reste visiblement dérivée d’un texte qui n’a jamais été conservé (see also the Pretraining chapter, in the LLM lifecycle module) (voir aussi le chapitre Préentraînement, dans le module Cycle de vie des GML).
Rien de tout cela n’est enseigné à part : tout cela sort de l’exercice répété de la prédiction. Puis le rapport : conserver le texte prendrait cinq téraoctets, le modèle en fait cent quarante gigaoctets, donc le texte ne peut pas être dedans. La « compression avec perte » de Karpathy est une métaphore, et elle vise juste.
Ce qui se passe quand vous appuyez sur Entrée
Votre requête passe par les quatre mêmes étapes à chaque fois.
- Le texte est découpé en jetons (see also the Tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Jetonisation, dans le module Le langage en nombres).
- Chaque jeton devient un vecteur, et ces vecteurs traversent les couches du réseau.
- Le modèle produit une note pour chaque jeton de son vocabulaire, convertie en probabilité.
- Un jeton est choisi, ajouté au texte, et tout reprend à l’étape 1.
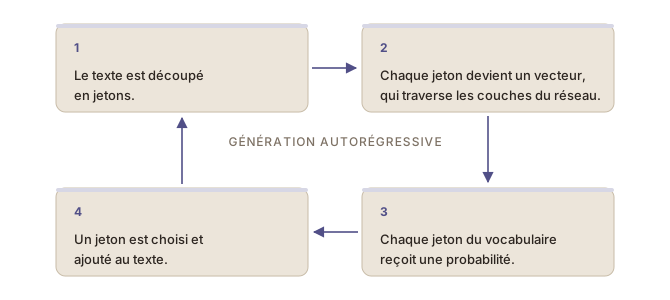
Chaque jeton reçoit une probabilité
La troisième étape est celle que l’on interprète mal. Quand on lui demande de continuer My favourite colour is, le modèle ne décide pas blue. Il produit un nombre pour chacun des jetons qu’il connaît, des dizaines de milliers, et ces nombres font 1 au total.
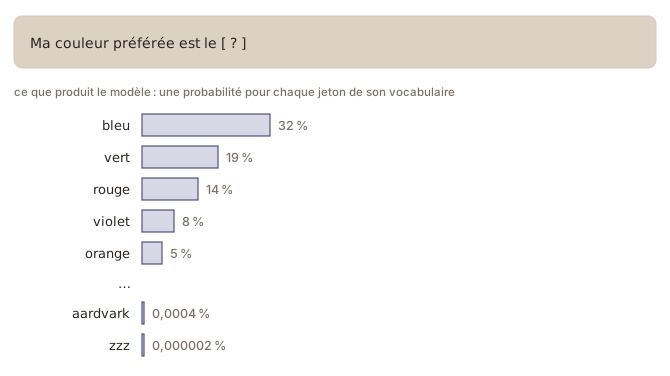
La plupart sont absurdes ici et reçoivent des probabilités proches de zéro, mais ils sont tous notés. En choisir un est une étape distincte, qui a lieu après le calcul, et le nombre le plus élevé ne l’emporte pas toujours (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML).
Pourquoi le texte arrive comme il arrive
Vu de l’extérieur, un modèle a l’air de lire votre question une fois et d’écrire la réponse. Chaque jeton de cette réponse est un passage distinct, et chaque passage lit la requête en même temps que tout ce que le modèle a déjà ajouté.
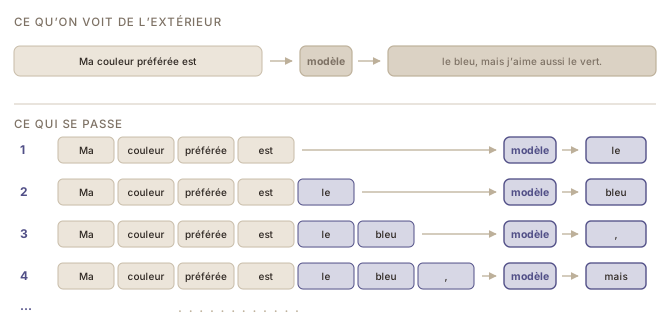
Une réponse de cinq cents jetons, ce sont cinq cents de ces passages. Deux conséquences à retenir :
- La sortie arrive progressivement plutôt que d’un seul coup, parce que chaque jeton doit attendre celui qui le précède.
- Le modèle n’a pas de brouillon. Il s’engage sur chaque jeton avant de calculer le suivant, si bien qu’il ne peut pas prévoir une phrase, s’apercevoir à mi-chemin que la fin ne fonctionnera pas, et revenir sur le début.
C’est la seconde qu’il faut faire passer : il ne peut pas prévoir une phrase, s’apercevoir à mi-chemin que la fin ne fonctionnera pas, et revenir sur le début. Le choix fait dans la distribution est une décision distincte, prise après le calcul, et c’est le chapitre sur l’inférence à la séance 3.
How much text goes into one model
The dataset assembled to train GPT-3 came to 499 billion tokens, of which the model saw 300 billion during training (Brown et al., 2020). A few years later, Chinchilla was trained on 1.4 trillion (Hoffmann et al., 2022). The published figures have gone on climbing since: 15.6 trillion tokens for Llama 3.1 in 2024 (Grattafiori et al., 2024), 36 trillion for Qwen3 in 2025 (Yang et al., 2025b).These are the figures that were published. OpenAI’s report on GPT-4 says it gives “no further details about the architecture (including model size), hardware, training compute, dataset construction, training method, or similar” (OpenAI, 2023), and the other large providers say no more, so the size of the models most people use today is a matter of estimate rather than record.
Those figures mean very little on their own, so here is a comparison to try to get a better grasp:
Reading at roughly five tokens a second, without stopping to eat or sleep, 1.4 trillion tokens would take somewhere near nine thousand years. Qwen3’s 36 trillion would take about two hundred and thirty thousand.
How the amounts have grown
The growth went into the text rather than into the model. Chinchilla and Llama 2 are smaller models than GPT-3 and were trained on several times more text, after Hoffmann et al. (2022) showed that for a given amount of computation a smaller model trained on more data does better (see also the Pretraining chapter, in the LLM lifecycle module) (voir aussi le chapitre Préentraînement, dans le module Cycle de vie des GML).
Neither figure describes the best-known models after 2023, because their builders stopped publishing the figures. Everything plotted here comes from the open-weight models open-weight modelmodèle à poids ouverts AIIA An AI model whose trained parameters, commonly called weights, are made available for others to download.Modèle d'IA dont les paramètres entraînés, appelés poids, sont offerts au téléchargement. ; the scale of the closed ones is a matter of outside estimate (Epoch AI, 2026).
Three things to say over the two charts. The reversal: Chinchilla and Llama 2 have fewer parameters than GPT-3 and were trained on far more text, because Hoffmann and colleagues showed the models of the day were too large for the amount of text they had been given. Kimi K3’s 2.8 trillion is the total it contains, and only about 104 billion run for any one token, so it is not the same measure as GPT-3’s 175 billion. And the reading comparison: 1.4 trillion tokens is nine thousand years of nonstop reading, 36 trillion about two hundred and thirty thousand.
Crawling the web
The largest single source for most models is a crawl of the public web.
A downloaded page comes with navigation menus, cookie banners, advertisements, boilerplate footers and the HTML that structures all of it, so the running text has to be pulled out of the markup first, and that extraction is itself imperfect.
What went into one published model
GPT-3 is a useful case because its composition was published, which is unusual (Brown et al., 2020).
| Source | Tokens | Share of training |
|---|---|---|
| Common Crawl (filtered) | 410 billion | 60 % |
| WebText2 | 19 billion | 22 % |
| Books1 | 12 billion | 8 % |
| Books2 | 55 billion | 8 % |
| Wikipedia | 3 billion | 3 % |
The table names sources it does not describe. Brown et al. (2020) account for Books1 and Books2 in a single phrase, “two internet-based books corpora”, and say nothing about what is in them or where they came from, although the two together come to 67 billion tokens and Books2 alone is the second largest source in the list.
A source’s share of the words is the amount of text it contributed. Its share of the training is the number of times the model read that text, and the two come apart: Common Crawl is 82 % of the words and 60 % of the training, while Wikipedia is well under 1 % of the words and 3 % of the training. So the model went through Wikipedia several times over while seeing much of the crawl once or not at all.
Sampling weights manage quality without anyone editing the text. Sources trusted to be clean and well written are read repeatedly; the messy bulk is read thinly.
No labels on any of it
None of this material arrives with annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. . No marker says which language a document is in, whether it is fiction, whether its claims were checked, or whether its author knew the subject. A medical paper and a post inventing a cure are both sequences of tokens whose next word can be predicted.
The point of the two bars: Common Crawl is 82 % of the words and 60 % of the training, Wikipedia 0.6 % of the words and 3 % of the training. Sampling weights manage quality without anyone touching the text: clean sources are reread, the messy bulk is read once or not at all.
Four things filtering tries to do
Whole sites are excluded first, through blocklists covering malware, adult content, banking pages and material judged extremist. Within what remains, automatic scoring drops pages that look like spam or gibberish, pages that repeat themselves, and pages that are mostly navigation and advertisement.
Near-duplicates are then removed. The same article is syndicated across dozens of sites, and a model trained on the same text hundreds of times gives it that much more weight, so deduplication is more important than it sounds. GPT-3’s builders describe both document-level fuzzy deduplication and the removal of documents overlapping with their evaluation sets (Brown et al., 2020).
Finally, there are attempts to remove personal information.
Why none of it works completely
These filters are automatic and approximate. Personal information appears in forms no pattern anticipates, a phone number written out in words or an address inside a scanned document, so some of it survives into the corpus and can resurface in what a model produces.
And “low quality” is not a property the text has. Somebody decides that this forum is worth keeping and that one is not, that this dialect reads as error-strewn, that this topic is unsuitable. Those decisions are usually made quickly, at scale, by people with a particular idea of what good writing looks like, and they end up shaping what a model treats as normal language (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
How much of a corpus is English
Xu et al. (2025) surveyed the corpora behind multilingual models and found several, GPT-3 among them, trained on text more than 90 % English. For GPT-3 their figures are 92.7 % English, 1.8 % French, 1.5 % German and 5.9 % everything else.
French, the second language on that list, is one of the best-served languages in the world, and it still accounts for under a fiftieth of what the model read.
There are many attempts at broadening language coverage, either in multilingual models that include more data in other languages, or in models dedicated to a single other language than English. Qwen3, released in 2025, was trained on text in 119 languages and dialects, against 29 for the model it replaced (Yang et al., 2025b). The reporting has not kept pace: almost no model in use publishes its shares, which is why GPT-3 is still the example anyone can quote precisely.
Part of this reflects the web, which is itself skewed toward English. The rest is decisions:
- which crawls to include;
- which quality filters to apply, since a filter trained on English rates other languages badly;
- whether to spend effort on languages that would each add little volume.
Joshi et al. (2020) documented how uneven the resources are across the world’s languages, with a small number well provided for and the great majority having almost nothing available at all.
Why this matters for translation
A general claim about what “an LLM” can do is not portable across languages. A model that drafts fluent English may be noticeably weaker in your other working language, and weaker again in a variety of that language: Quebec French rather than metropolitan French, a regional term, a domain where the local usage differs.
Volume is not the only factor. Models trained on many languages do better in a well-resourced language than models trained on that language alone, and they align best between English and the languages closest to it, which puts French in a comparatively good position on both counts. The benefit has a limit the field calls the curse of multilinguality: at a fixed model size, supporting more languages costs each of them (Xu et al., 2025).
This is a reason to test rather than assume. A model’s fluency is not evidence about its accuracy, and it is least reliable in exactly the places where you would be checking hardest anyway.
A second penalty, in tokens
The imbalance reaches the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. as well, and the tokenizer passes it on to everyone who uses the model. Because its subword vocabulary is learned mostly from English text, the same sentence costs more tokens in most other languages, and Petrov et al. (2023) measured differences large enough to matter. More tokens for the same content means three things at once:
- a smaller effective context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). , so less room for the document you are working on;
- slower responses;
- a larger bill, where a service charges by the token (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Training data incest
Every corpus described so far was gathered by crawling, and the web has changed: a substantial and growing part of the text on it was produced by a language model. So the corpus for the next model contains the output of the last one, and nothing in the pipeline can reliably tell the two apart.
The effect goes by other names. It circulates as Habsburg AI, after the royal house whose portraits record the effects of inbreeding, for a system trained so heavily on the output of other systems that its features come out exaggerated and distorted; also as AI inbreeding, and as model autophagy disorder.
What happens when training on generated output?
Shumailov et al. (2024) trained models on data generated by their predecessors, over several generations, and found a consistent pattern. A model’s output over-represents what was common in its training, so the next model sees a narrower world than the one before it, and after enough repetitions the output degenerates. The first things to go are whatever was least represented to begin with: a regional variant, a specialized term that has a frequent near synonym, a construction that is correct without being the one a model reaches for first.
Scope the finding honestly: Shumailov and colleagues replace the training data completely at every generation, which is the sharpest version of the problem and not the situation anyone is in. Gerstgrasser and colleagues tested the milder case, adding synthetic data to real data rather than replacing it, and found no collapse. A demonstrated mechanism and a reason to care about provenance, not a dated prediction.
Quelle quantité de texte entre dans un modèle
Le jeu de données réuni pour entraîner GPT-3 comptait 499 milliards de jetons, dont le modèle a vu 300 milliards pendant l’entraînement (Brown et al., 2020). Quelques années plus tard, Chinchilla était entraîné sur 1 400 milliards (Hoffmann et al., 2022). Les chiffres publiés n’ont cessé de grimper depuis : 15 600 milliards de jetons pour Llama 3.1 en 2024 (Grattafiori et al., 2024), 36 000 milliards pour Qwen3 en 2025 (Yang et al., 2025b).Ce sont là les chiffres qui ont été publiés. Le rapport d’OpenAI sur GPT-4 précise qu’il ne donne « aucun détail supplémentaire sur l’architecture (y compris la taille du modèle), le matériel, le calcul d’entraînement, la construction du jeu de données, la méthode d’entraînement ou autre » (OpenAI, 2023), et les autres grands fournisseurs n’en disent pas davantage. La taille des modèles que la plupart des gens utilisent aujourd’hui relève donc de l’estimation plutôt que du fait établi.
Ces chiffres ne veulent pas dire grand-chose en eux-mêmes ; voici donc une comparaison pour tenter de mieux les saisir :
À raison d’environ cinq jetons par seconde, sans s’arrêter pour manger ni pour dormir, 1 400 milliards de jetons prendraient près de neuf mille ans. Les 36 000 milliards de Qwen3 en prendraient environ deux cent trente mille.
Comment les quantités ont augmenté
La croissance est allée au texte plutôt qu’au modèle. Chinchilla et Llama 2 sont des modèles plus petits que GPT-3 et ont été entraînés sur plusieurs fois plus de texte, après que Hoffmann et al. (2022) ont montré qu’à quantité de calcul donnée, un modèle plus petit entraîné sur plus de données fait mieux (see also the Pretraining chapter, in the LLM lifecycle module) (voir aussi le chapitre Préentraînement, dans le module Cycle de vie des GML).
Ni l’une ni l’autre figure ne décrit les modèles les plus connus après 2023, parce que ceux qui les construisent ont cessé d’en publier les chiffres. Tout ce qui est représenté ici vient des modèles à poids ouverts open-weight modelmodèle à poids ouverts AIIA An AI model whose trained parameters, commonly called weights, are made available for others to download.Modèle d'IA dont les paramètres entraînés, appelés poids, sont offerts au téléchargement. ; l’échelle des modèles fermés relève de l’estimation externe (Epoch AI, 2026).
Trois choses à dire sur les deux courbes. Le renversement : Chinchilla et Llama 2 ont moins de paramètres que GPT-3 et ont été entraînés sur beaucoup plus de texte, parce que Hoffmann et al. ont montré que les modèles de l’époque étaient trop grands pour la quantité de texte qu’on leur donnait. Les 2 800 milliards de Kimi K3 sont le total : environ 104 milliards servent pour un jeton donné, ce n’est donc pas la même mesure que les 175 milliards de GPT-3. Et la comparaison de lecture : 1 400 milliards de jetons, c’est neuf mille ans de lecture sans arrêt ; 36 000 milliards, deux cent trente mille.
L’exploration du Web
La principale source, pour la plupart des modèles, est une exploration du Web public.
Une page téléchargée arrive avec ses menus de navigation, ses bandeaux de témoins, ses publicités, ses pieds de page standardisés et le HTML qui structure le tout ; il faut donc d’abord extraire le texte courant du balisage, et cette extraction est elle-même imparfaite.
Ce qui est entré dans un modèle publié
GPT-3 est un cas utile parce que sa composition a été publiée, ce qui est rare (Brown et al., 2020).
| Source | Jetons | Part de l’entraînement |
|---|---|---|
| Common Crawl (filtré) | 410 milliards | 60 % |
| WebText2 | 19 milliards | 22 % |
| Books1 | 12 milliards | 8 % |
| Books2 | 55 milliards | 8 % |
| Wikipédia | 3 milliards | 3 % |
Le tableau nomme des sources qu’il ne décrit pas. Brown et al. (2020) rendent compte de Books1 et de Books2 en une seule expression, « deux corpus de livres tirés d’Internet », et ne disent rien de leur contenu ni de leur provenance, alors que les deux réunis font 67 milliards de jetons et que Books2 est à lui seul la deuxième source en importance de la liste.
La part des mots d’une source est la quantité de texte qu’elle a fournie. Sa part de l’entraînement est le nombre de fois que le modèle a lu ce texte, et les deux se dissocient : Common Crawl représente 82 % des mots et 60 % de l’entraînement, tandis que Wikipédia est bien en dessous de 1 % des mots et compte pour 3 % de l’entraînement. Le modèle a donc parcouru Wikipédia plusieurs fois, alors qu’il n’a vu qu’une fois, ou pas du tout, une bonne partie de l’exploration.
Les poids d’échantillonnage gèrent la qualité sans que personne ne modifie le texte. Les sources jugées propres et bien écrites sont lues à répétition ; la masse brouillonne n’est lue que superficiellement.
Aucune étiquette sur tout cela
Aucun de ces textes n’arrive avec une annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. . Aucun marqueur n’indique en quelle langue est un document, s’il s’agit de fiction, si ses affirmations ont été vérifiées, ni si son auteur connaissait le sujet. Un article médical et une publication qui invente un remède sont l’un comme l’autre des suites de jetons dont on peut prédire le mot suivant.
Le point des deux barres : Common Crawl fait 82 % des mots et 60 % de l’entraînement, Wikipédia 0,6 % des mots et 3 % de l’entraînement. Les poids d’échantillonnage gèrent la qualité sans que personne ne touche au texte : les sources propres sont relues, la masse brouillonne est lue une fois ou pas du tout.
Quatre choses que le filtrage tente de faire
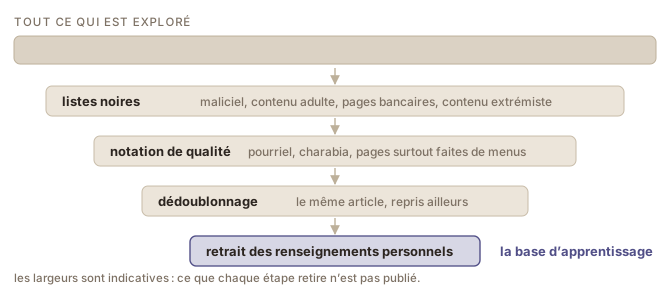
Des sites entiers sont d’abord exclus, au moyen de listes noires couvrant les maliciels, le contenu adulte, les pages bancaires et le contenu jugé extrémiste. Dans ce qui reste, une notation automatique écarte les pages qui ressemblent à du pourriel ou à du charabia, celles qui se répètent, et celles qui sont surtout faites de menus et de publicité.
Les quasi-doublons sont ensuite supprimés. Un même article est repris sur des dizaines de sites, et un modèle qui rencontre un texte des centaines de fois le pondère en conséquence : le dédoublonnage compte donc plus qu’il n’y paraît. Ceux qui ont construit GPT-3 décrivent à la fois un dédoublonnage approximatif au niveau du document et le retrait des documents recoupant leurs jeux d’évaluation (Brown et al., 2020).
Enfin, on tente de retirer les renseignements personnels.
Pourquoi rien de tout cela ne fonctionne complètement
Ces filtres sont automatiques et approximatifs. Les renseignements personnels apparaissent sous des formes qu’aucun motif n’anticipe, un numéro de téléphone écrit en toutes lettres ou une adresse à l’intérieur d’un document numérisé : une partie survit donc jusque dans le corpus et peut ressortir dans ce que produit un modèle.
Et la « faible qualité » n’est pas une propriété du texte. Quelqu’un décide que tel forum mérite d’être conservé et tel autre non, que tel dialecte se lit comme truffé de fautes, que tel sujet ne convient pas. Ces décisions se prennent en général vite, à grande échelle, par des gens qui ont une idée particulière de ce à quoi ressemble une bonne écriture, et elles finissent par façonner ce qu’un modèle traite comme une langue normale (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
Quelle part d’un corpus est en anglais
Xu et al. (2025) ont recensé les corpus derrière les modèles multilingues et en ont trouvé plusieurs, dont GPT-3, entraînés sur du texte anglais à plus de 90 %. Pour GPT-3, leurs chiffres sont 92,7 % d’anglais, 1,8 % de français, 1,5 % d’allemand et 5,9 % pour tout le reste.
Le français, deuxième langue de cette liste, est l’une des mieux servies au monde, et il ne représente pourtant pas un cinquantième de ce que le modèle a lu.
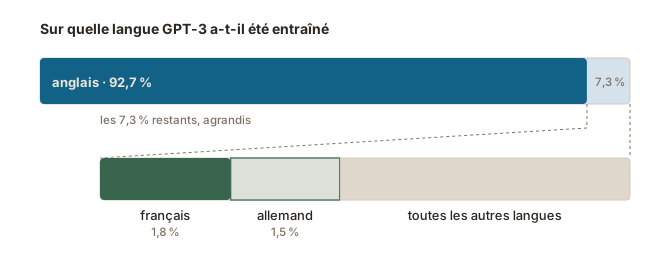
Les tentatives d’élargir la couverture linguistique sont nombreuses, soit dans des modèles multilingues qui intègrent davantage de données dans d’autres langues, soit dans des modèles consacrés à une seule autre langue que l’anglais. Qwen3, paru en 2025, a été entraîné sur du texte dans 119 langues et dialectes, contre 29 pour le modèle qu’il remplace (Yang et al., 2025b). La publication des chiffres n’a pas suivi : presque aucun modèle en usage ne publie ses proportions, et c’est pourquoi GPT-3 reste l’exemple que l’on peut citer avec précision.
Cela tient en partie au Web, lui-même orienté vers l’anglais. Le reste tient à des décisions :
- quelles explorations inclure ;
- quels filtres de qualité appliquer, puisqu’un filtre entraîné sur de l’anglais note mal les autres langues ;
- s’il vaut la peine de consacrer des efforts à des langues qui n’ajouteraient chacune que peu de volume.
Joshi et al. (2020) ont documenté à quel point les ressources sont inégales entre les langues du monde, un petit nombre étant bien pourvues et la grande majorité n’ayant presque rien de disponible.
Pourquoi cela compte en traduction
Une affirmation générale sur ce que « un GML » sait faire ne se transporte pas d’une langue à l’autre. Un modèle qui rédige un anglais fluide peut être nettement plus faible dans votre autre langue de travail, et plus faible encore dans une variété de cette langue : le français québécois plutôt que le français hexagonal, un terme régional, un domaine où l’usage local diffère.
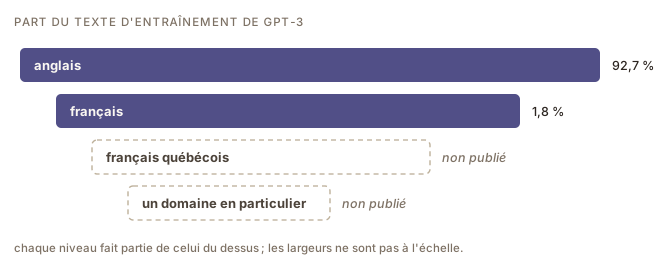
Le volume n’est pas le seul facteur. Les modèles entraînés sur de nombreuses langues font mieux dans une langue bien pourvue que les modèles entraînés sur cette seule langue, et ils alignent le mieux l’anglais et les langues qui en sont les plus proches, ce qui place le français en assez bonne position sur les deux plans. L’avantage a une limite que le domaine appelle la malédiction du multilinguisme : à taille de modèle fixe, prendre en charge plus de langues coûte à chacune d’elles (Xu et al., 2025).
C’est une raison de tester plutôt que de présumer. La fluidité d’un modèle ne renseigne pas sur son exactitude, et elle est la moins fiable précisément là où vous vérifieriez le plus attentivement de toute façon.
Une seconde pénalité, en jetons
Le déséquilibre atteint aussi le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. , et le segmenteur le transmet à quiconque utilise le modèle. Comme son vocabulaire de sous-mots est appris surtout sur du texte anglais, la même phrase coûte plus de jetons dans la plupart des autres langues, et Petrov et al. (2023) ont mesuré des écarts assez grands pour compter. Plus de jetons pour le même contenu, cela veut dire trois choses à la fois :
- une fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). effective plus petite, donc moins de place pour le document sur lequel vous travaillez ;
- des réponses plus lentes ;
- une facture plus élevée, là où un service facture au jeton (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
L’inceste des données d’entraînement
Tous les corpus décrits jusqu’ici ont été réunis par exploration, et le Web a changé : une part substantielle et croissante du texte qui s’y trouve a été produite par un modèle de langue. Le corpus du prochain modèle contient donc la sortie du précédent, et rien dans la chaîne de traitement ne permet de les distinguer de façon fiable.
Le phénomène porte d’autres noms. Il circule sous celui d’IA Habsbourg, du nom de la maison royale dont les portraits gardent la trace des effets de la consanguinité, pour un système entraîné si lourdement sur la sortie d’autres systèmes que ses traits ressortent exagérés et déformés ; on parle aussi de consanguinité de l’IA et de trouble d’autophagie des modèles.
Que se passe-t-il quand on s’entraîne sur du texte généré ?
Shumailov et al. (2024) ont entraîné des modèles sur des données produites par leurs prédécesseurs, sur plusieurs générations, et ont constaté un motif constant. La sortie d’un modèle surreprésente ce qui était fréquent dans son entraînement : le modèle suivant voit donc un monde plus étroit que celui d’avant, et après assez de répétitions la sortie dégénère. Ce qui disparaît en premier, c’est ce qui était le moins représenté au départ : une variante régionale, un terme spécialisé doublé d’un quasi-synonyme fréquent, une construction correcte sans être celle vers laquelle un modèle se tourne d’abord.
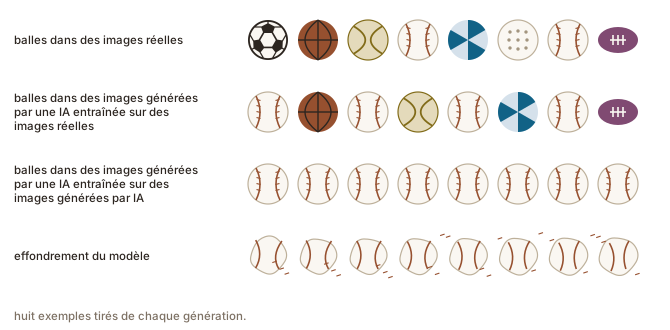
Cadrer le résultat honnêtement : Shumailov et al. remplacent entièrement les données à chaque génération, ce qui est la version la plus tranchée du problème et non la situation réelle. Gerstgrasser et al. ont éprouvé le cas plus modéré, en ajoutant des données synthétiques aux données réelles au lieu de les remplacer, et n’ont pas observé d’effondrement. Un mécanisme démontré et une raison de se soucier de la provenance, pas une prédiction datée.