Mitigating hallucinationsAtténuer les fabulations
TRA6008 S3 · in classS3 · en classe
What the developers do
Three approaches are in use, but none of them removes the problem.
Both studies used models of 2023. Zhang et al. (2024) tested refusal training on OpenLLaMA-3B and LLaMA 7B and 13B. Chen et al. (2024) tested retrieval on ChatGPT and several open 6B and 7B models, which did worst at declining when the retrieved documents did not contain the answer, at combining information from several documents, and at detecting false information in them.
The numbers date faster than the failures do. Each of these is a mitigation rather than a guarantee, and the September 2026 runs below show one of the same failures on current models: an answer based on a source that is wrong.
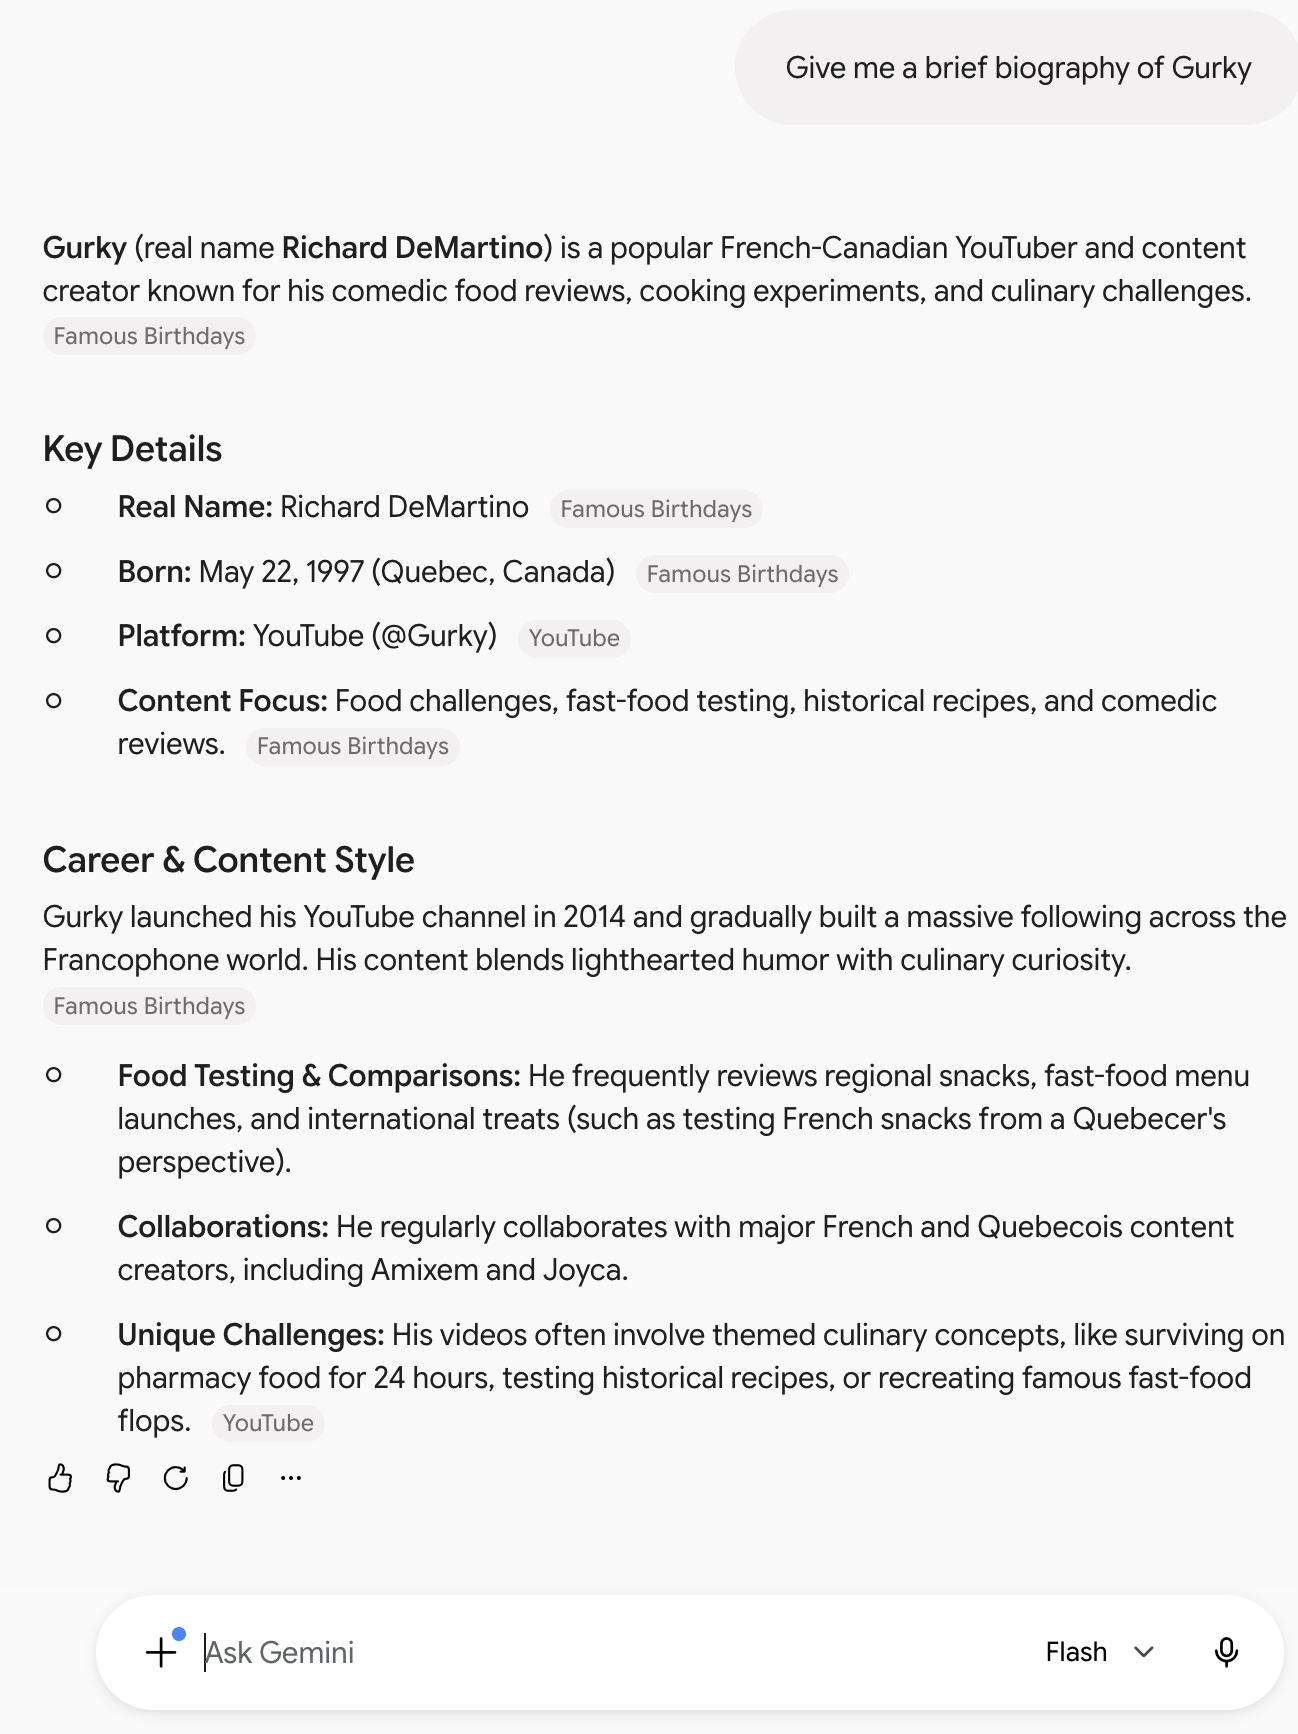
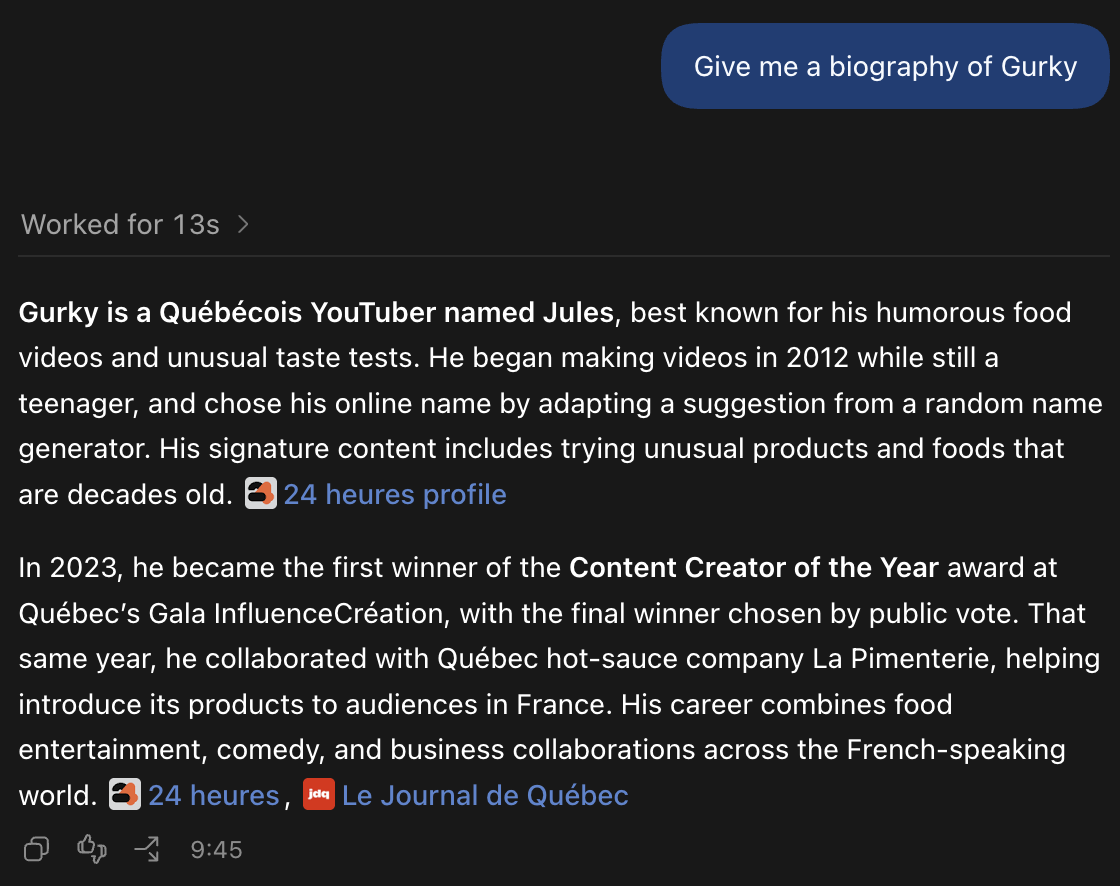
The biography of Gurky earlier in this chapter came from a model of 2025 answering from its parameters alone. Put to two chatbots in September 2026, the same question sent both of them to the web without being asked, and searching changed what went wrong rather than removing it.
The first searched and then used a celebrity birthday site, which gave it a full name and a birth date; the name is wrong (Figure 5figure 5).
The second found the Québec press instead and gave his first name correctly (Figure 6figure 6), although a second run of the same question took the wrong name from the same birthday site.
Asked in that conversation for his date of birth, it returned both sources, stated that the two conflict, and called the date unverified (Figure 7figure 7).
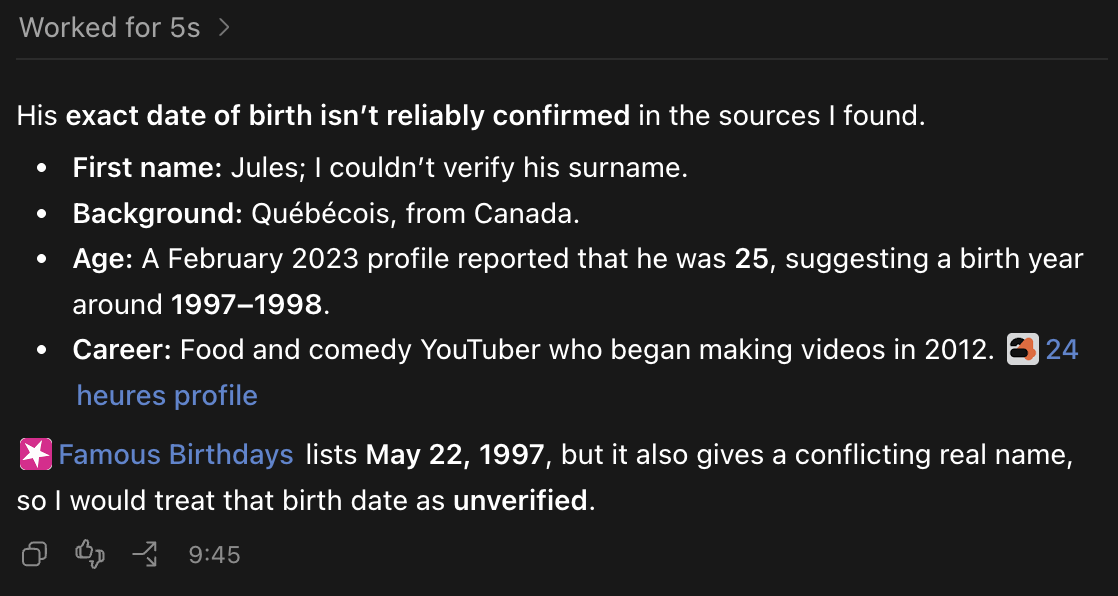
The three differ in which sources they found and in whether they said how far to trust them. A cited source can also be the wrong source altogether: asked to identify the news article a quoted excerpt came from, eight search tools gave an incorrect answer more than 60 % of the time, often naming a plausible article that was not the one quoted (Jaźwińska & Chandrasekar, 2025).A report from a journalism school’s research centre rather than a peer-reviewed study: 1,600 tests over eight AI search tools. So a link tells you what to check next rather than that the claim is true.
Hallucination rates are also tracked publicly. On the best known leaderboardVectara, Hallucination Leaderboard, last updated 11 May 2026 and read 17 September 2026: rates from 1.8 % upward, with GPT-5.4 at 7.0 % against 3.1 % for its smallest version. no model reaches zero, and the largest models are not always the lowest (see also the Reading a leaderboard page, in the Using LLMs module) (voir aussi la page Lire un classement, dans le module Utiliser les GML).
What you can do
Supplying the source
When the work you give a model is work on a text you already have, for instance translating it, summarizing it, rewriting it for a different reader or checking it against a list of terms, put that text in the context.
It cuts down how often the model goes wrong about that text, though not to zero. The errors that remain concern a document you have, so you can find them by reading, instead of needing to know the subject yourself. That is the difference between an extrinsic hallucination extrinsic hallucinationfabulation extrinsèque language modelsmodèles de langue Generated content that can be neither supported nor contradicted by the source or context against which the output is being evaluated.Contenu généré qui ne peut être ni appuyé ni contredit par la source ou le contexte servant à évaluer la sortie. and an intrinsic one.
What does not help
Asking a model to be more careful changes little: no part of it is responsible for care, and truth is not a variable in the process. Rereading an output for consistency does not help either, because the process produces consistency. The checks that work compare a claim with something outside the output (see also the Checking the answer page, in the Using LLMs module) (voir aussi la page Vérifier la réponse, dans le module Utiliser les GML).
Which details deserve suspicion
The risk is not spread evenly. Fabrication concentrates in specific, checkable details that were rare in the training text, for instance dates, numbers, names, page references, citations, quotations, legal provisions, and anything recent.
General explanation of a well-covered topic is far safer. On a subject written about many times over, an explanation is usually sound, and that is a large part of what these tools are useful for. Usually is not always, and such an explanation can be wrong about something central rather than about a detail, but it is a different order of risk from a fabricated citation.
So the checking follows the risk rather than covering everything. If you are going to verify three things in an output, verify the three most specific ones.
Fabricated references have been measured directly. Walters and Wilder (2023) checked every reference in short literature reviews written by two models of 2023: more than half of what GPT-3.5 produced did not exist, and just under a fifth of GPT-4’s. Of the references that did exist, between a quarter and almost half had at least one substantive error, most often in the volume, issue or page numbers or in the date.
Ce que font les concepteurs
Trois approches sont en usage, mais aucune ne supprime le problème.
Les deux études portaient sur des modèles de 2023. Zhang et al. (2024) ont testé l’entraînement au refus sur OpenLLaMA-3B et LLaMA 7B et 13B. Chen et coll. (2024) ont testé la récupération sur ChatGPT et sur plusieurs modèles ouverts de 6 et 7 milliards de paramètres, qui ont le plus échoué à refuser quand les documents récupérés ne contenaient pas la réponse, à combiner l’information de plusieurs documents et à détecter l’information fausse qui s’y trouvait.
Les chiffres vieillissent plus vite que les échecs. Chacune de ces approches est une atténuation plutôt qu’une garantie, et les essais de septembre 2026 ci-dessous montrent l’un des mêmes échecs sur des modèles actuels : une réponse appuyée sur une source fausse.
La biographie de Gurky présentée plus tôt dans ce chapitre venait d’un modèle de 2025 qui répondait à partir de ses seuls paramètres. Posée à deux agents conversationnels en septembre 2026, la même question les a tous deux envoyés sur le Web sans qu’on le leur demande, et la recherche a changé la nature de l’erreur plutôt que de la supprimer.
Le premier a cherché, puis s’en est remis à un site de célébrités et d’anniversaires, qui lui a fourni un nom complet et une date de naissance ; le nom est faux (Figure 5figure 5).
Le second a trouvé la presse québécoise et a donné son prénom correctement (Figure 6figure 6), même si un second essai de la même question a repris le nom faux au même site d’anniversaires.
Interrogé dans cette conversation sur sa date de naissance, il a rendu les deux sources, signalé qu’elles se contredisent et qualifié la date de non vérifiée (Figure 7figure 7).
Les trois diffèrent par les sources qu’ils ont trouvées et par ce qu’ils ont dit du crédit à leur accorder. Une source citée peut aussi être la mauvaise source : à qui leur demandait d’identifier l’article de presse d’où venait un extrait cité, huit outils de recherche ont donné une réponse erronée plus de 60 % du temps, en nommant souvent un article plausible qui n’était pas celui d’où venait la citation (Jaźwińska et Chandrasekar, 2025).Un rapport du centre de recherche d’une école de journalisme, et non une étude évaluée par les pairs : 1 600 essais sur huit outils de recherche par IA. Un lien vous dit donc quoi vérifier ensuite plutôt que la vérité de l’affirmation.
Les taux de fabulation font aussi l’objet d’un suivi public. Sur le classement le plus connuVectara, Hallucination Leaderboard, dernière mise à jour le 11 mai 2026, consulté le 17 septembre 2026 : des taux à partir de 1,8 %, avec GPT-5.4 à 7,0 % contre 3,1 % pour sa plus petite version. aucun modèle n’atteint zéro, et les plus grands modèles ne sont pas toujours les plus bas (see also the Reading a leaderboard page, in the Using LLMs module) (voir aussi la page Lire un classement, dans le module Utiliser les GML).
Ce que vous pouvez faire
Fournir la source
Quand le travail que vous confiez à un modèle porte sur un texte que vous avez déjà, par exemple le traduire, le résumer, le réécrire pour un autre lectorat ou le confronter à une liste de termes, mettez ce texte dans le contexte.
Cela réduit la fréquence des erreurs du modèle sur ce texte, sans la ramener à zéro. Ce qui reste porte sur un document que vous avez sous les yeux : vous pouvez donc le repérer en lisant, au lieu d’avoir à connaître le sujet vous-même. C’est la différence entre une fabulation extrinsèque extrinsic hallucinationfabulation extrinsèque language modelsmodèles de langue Generated content that can be neither supported nor contradicted by the source or context against which the output is being evaluated.Contenu généré qui ne peut être ni appuyé ni contredit par la source ou le contexte servant à évaluer la sortie. et une intrinsèque.
Ce qui ne sert à rien
Demander à un modèle d’être plus prudent ne change pas grand-chose : aucune partie de lui n’est chargée de la prudence, et la vérité n’est pas une variable du processus. Relire une sortie pour en vérifier la cohérence ne sert pas davantage, puisque le processus produit de la cohérence. Les vérifications qui fonctionnent comparent une affirmation à quelque chose d’extérieur à la sortie (see also the Checking the answer page, in the Using LLMs module) (voir aussi la page Vérifier la réponse, dans le module Utiliser les GML).
Quels détails méritent la méfiance
Le risque n’est pas réparti également. La fabrication se concentre sur les détails précis et vérifiables qui étaient rares dans le texte d’entraînement, par exemple les dates, les nombres, les noms, les renvois de pages, les références, les citations, les dispositions légales et tout ce qui est récent.
L’explication générale d’un sujet bien couvert est nettement plus sûre. Sur un sujet sur lequel on a écrit bien des fois, une explication est en général solide, et c’est pour une bonne part ce à quoi ces outils servent. En général ne veut pas dire toujours, et une telle explication peut se tromper sur quelque chose de central plutôt que sur un détail, mais ce n’est pas le même ordre de risque qu’une référence fabriquée.
La vérification suit donc le risque plutôt que de tout couvrir. Si vous devez vérifier trois choses dans une sortie, vérifiez les trois plus précises.
Les références fabriquées ont été mesurées directement. Walters et Wilder (2023) ont vérifié chaque référence dans de courtes revues de littérature écrites par deux modèles de 2023 : plus de la moitié de ce que GPT-3.5 a produit n’existait pas, contre un peu moins d’un cinquième pour GPT-4. Parmi les références qui existaient bel et bien, entre un quart et près de la moitié comportaient au moins une erreur de fond, le plus souvent dans le volume, le numéro, les pages ou la date.
Sources
- Chen, J., Lin, H., Han, X., & Sun, L. (2024). Benchmarking Large Language Models in Retrieval-Augmented Generation. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16), 17754–17762. https://doi.org/10.1609/aaai.v38i16.29728
- Jaźwińska, K., & Chandrasekar, A. (2025). AI Search Has a Citation Problem. Tow Center for Digital Journalism, Columbia Journalism Review, 6 March 2025. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
- Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv:2401.11817 (preprint). https://arxiv.org/abs/2401.11817
- Zhang, H., Diao, S., Lin, Y., Fung, Y. R., Lian, Q., Wang, X., Chen, Y., Ji, H., & Zhang, T. (2024). R-Tuning: Instructing Large Language Models to Say `I Don't Know'. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 7113–7139. https://doi.org/10.18653/v1/2024.naacl-long.394
Sources
- Chen, J., Lin, H., Han, X., & Sun, L. (2024). Benchmarking Large Language Models in Retrieval-Augmented Generation. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16), 17754–17762. https://doi.org/10.1609/aaai.v38i16.29728
- Jaźwińska, K., & Chandrasekar, A. (2025). AI Search Has a Citation Problem. Tow Center for Digital Journalism, Columbia Journalism Review, 6 mars 2025. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
- Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv:2401.11817 (preprint). https://arxiv.org/abs/2401.11817
- Zhang, H., Diao, S., Lin, Y., Fung, Y. R., Lian, Q., Wang, X., Chen, Y., Ji, H., & Zhang, T. (2024). R-Tuning: Instructing Large Language Models to Say `I Don't Know'. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 7113–7139. https://doi.org/10.18653/v1/2024.naacl-long.394