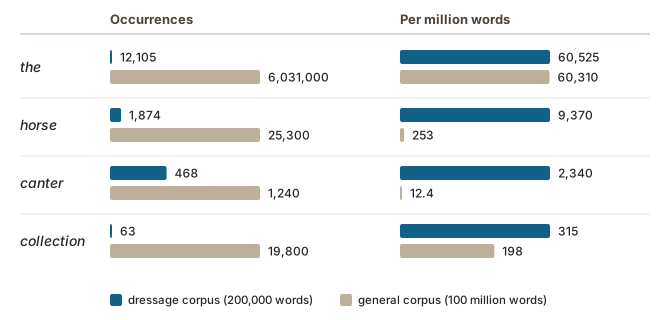Automatic term extraction (from rules to large language models)Extraction automatique de termes (des règles aux grands modèles de langue)
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
A term is a single unit. The word terminology is used in two
senses: the set of all the terms of a domain (the terminology of dressage),
and the discipline that studies terms and how to record them.
Terms take up a real share of a translator’s time. In studies from the
2000s, translators estimated that they spent roughly 15 to 30% of their
working time on terminology, most of it on looking terms up (Champagne,
2004; Gornostay, 2010).Both studies date from before neural
machine translation and large language models, and no comparable figures
for today’s tools are cited here. The share depends on the
translator and on the field: in Champagne’s study it was highest in
financial institutions and lowest in language firms, and the participants
put it at 40 to 60% for a translator new to the job. Translating a term
often takes knowledge of the domain as well as of the two languages.
Translators are therefore among the main users of terminological resources
such as termbases and glossaries.
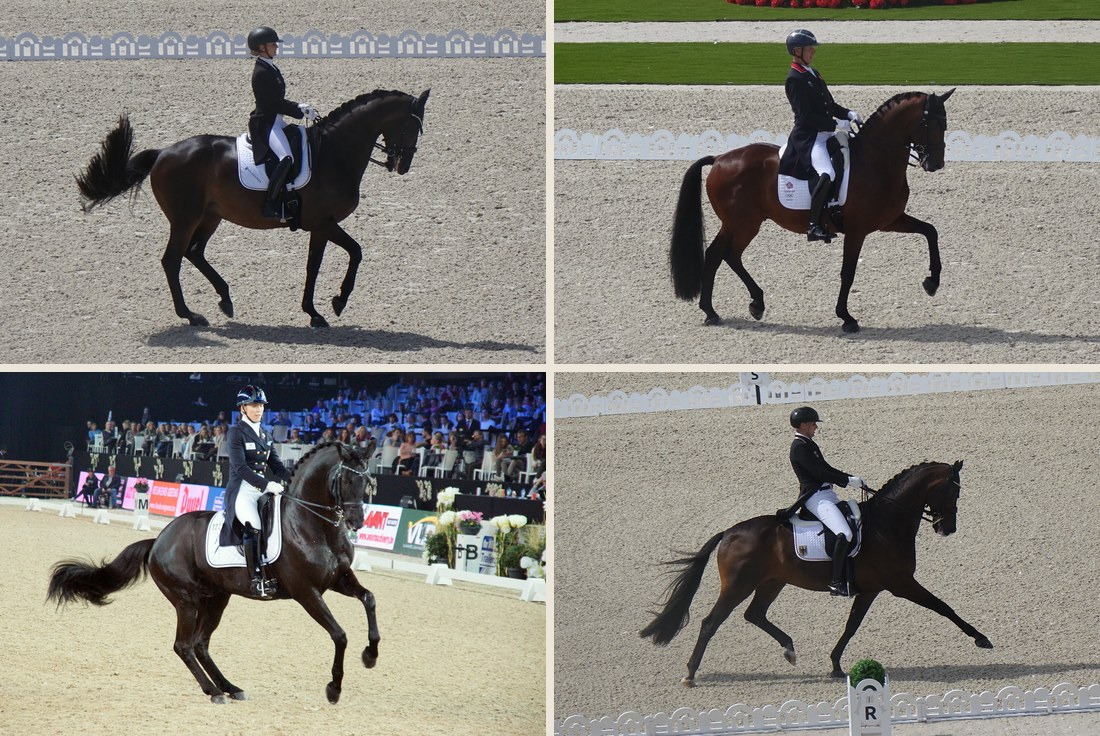
Figure 1figure 1 shows four of the movements that dressage terms name.The photographs are from
Wikimedia Commons, cropped and resized: the piaffe,
the passage
and the extended trot
by Eponimm, under CC BY 4.0;
the canter pirouette
by World Dressage Masters, under CC BY 2.0.
Figure 1. Four movements of dressage, each with a term of its own: piaffe and passage (top), canter pirouette and extended trot (bottom). Photographs by Eponimm (CC BY 4.0) and World Dressage Masters (CC BY 2.0), Wikimedia Commons.
Terms are often recorded in termbases, which tend to organize them by
concept. In a multilingual termbase, you can then see the terms used for one
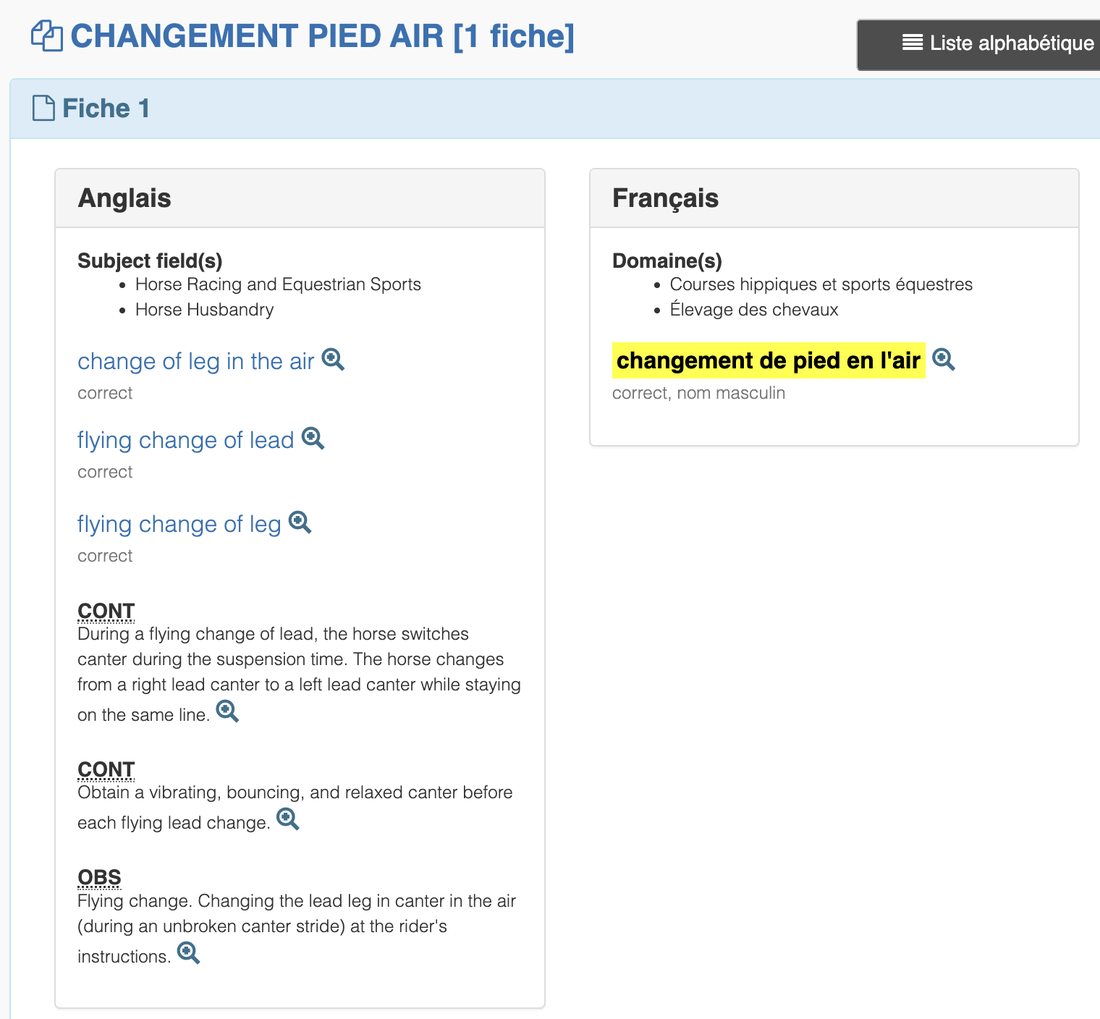
concept in several languages. The example in Figure 2figure 2, taken from TERMIUM Plus, also shows that the ideal of one term per concept
in each language is often not reached in practice: the record suggests three
English terms for a single French one.
Figure 2. A term bank record, here TERMIUM Plus (read 30 September 2026): one concept, the terms that name it in each language, its subject field, and contexts.
Terms of several words
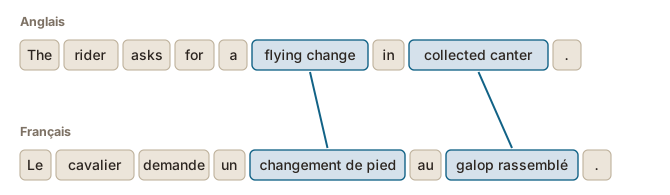
In the texts a translator works on, many terms are longer than one word.
Flying change names one movement, in which the horse changes its leading
leg in the air between two strides of canter, and its meaning does not follow
from flying and change looked up separately. Recognizing a term therefore
includes deciding where it starts and where it ends: in “the collected canter
pirouette”, you might record canter pirouette, collected canter,
canter, pirouette, or all four.
Sources
Champagne, G. (2004). The Economic Value of Terminology: an Exploratory Study. Report submitted to the Translation Bureau of Canada, 30 April 2004. Guy Champagne Inc., Montreal.
Gornostay, T. (2010). Terminology Management in Real Use. Proceedings of the 5th International Biannual Conference “Applied Linguistics in Research and Education” in Memoriam Rajmund Piotrowski (1922-2009), Saint Petersburg.
ISO (2019). ISO 1087:2019 Terminology work and terminology science — Vocabulary. International Organization for Standardization, 2nd ed.. https://www.iso.org/standard/62330.html
Un terme est une unité. Le mot terminologie s’emploie en deux sens :
l’ensemble des termes d’un domaine (la terminologie du dressage), et la
discipline qui étudie les termes et la façon de les consigner.
Les termes occupent une part réelle du temps de traduction. Dans des études
des années 2000, des traducteurs estimaient consacrer de 15 à 30 % environ
de leur temps de travail à la terminologie, surtout à la recherche de termes
(Champagne, 2004 ; Gornostay, 2010).Les deux études datent
d’avant la traduction automatique neuronale et les grands modèles de langue,
et aucun chiffre comparable pour les outils d’aujourd’hui n’est cité
ici. Cette part dépend de la personne et du secteur : dans l’étude
de Champagne, elle était la plus élevée dans les institutions financières et
la plus faible dans les cabinets de traduction, et les participants
l’estimaient à 40 à 60 % pour une personne qui débute dans le métier.
Traduire un terme demande souvent de connaître le domaine, en plus des deux
langues. Les traducteurs comptent donc parmi les principaux utilisateurs de
ressources terminologiques comme les bases terminologiques et les
glossaires.
La Figure 1figure 1 montre quatre des mouvements que désignent les termes du dressage.Les photographies viennent
de Wikimedia Commons, recadrées et redimensionnées : le piaffer,
le passage
et le trot allongé
par Eponimm, sous licence CC BY 4.0 ;
la pirouette au galop
par World Dressage Masters, sous licence CC BY 2.0.
Figure 1. Quatre mouvements du dressage, chacun avec son terme : piaffer et passage (en haut), pirouette au galop et trot allongé (en bas). Photographies d'Eponimm (CC BY 4.0) et de World Dressage Masters (CC BY 2.0), Wikimedia Commons.
Les termes sont souvent consignés dans des bases terminologiques, qui tendent
à les organiser par concept. Dans une base multilingue, vous voyez alors les
termes employés pour un même concept dans plusieurs langues. L’exemple de la
Figure 2figure 2, tiré de TERMIUM Plus, montre aussi que l’idéal d’un seul terme par
concept dans chaque langue ne se vérifie souvent pas en pratique : la fiche
propose trois termes anglais pour un seul terme français.
Figure 2. Une fiche de banque terminologique, ici TERMIUM Plus (consultée le 30 septembre 2026) : un concept, les termes qui le désignent dans chaque langue, son domaine et des contextes.
Les termes de plusieurs mots
Dans les textes sur lesquels travaille une traductrice ou un traducteur,
beaucoup de termes dépassent un mot. Changement de pied désigne un seul
mouvement, dans lequel le cheval change de pied en l’air entre deux foulées
de galop, et son sens ne se déduit pas de changement et de pied cherchés
séparément. Reconnaître un terme suppose donc de décider où il commence et où
il finit : dans « la pirouette au galop rassemblé », vous pourriez consigner
pirouette au galop, galop rassemblé, galop, pirouette, ou les quatre.
Sources
Champagne, G. (2004). The Economic Value of Terminology: an Exploratory Study. Report submitted to the Translation Bureau of Canada, 30 avril 2004. Guy Champagne Inc., Montreal.
Gornostay, T. (2010). Terminology Management in Real Use. Proceedings of the 5th International Biannual Conference “Applied Linguistics in Research and Education” in Memoriam Rajmund Piotrowski (1922-2009), Saint Petersburg.
ISO (2019). ISO 1087:2019 Terminology work and terminology science — Vocabulary. International Organization for Standardization, 2nd ed.. https://www.iso.org/standard/62330.html
Where people disagree about termsLes points de désaccord sur les termes
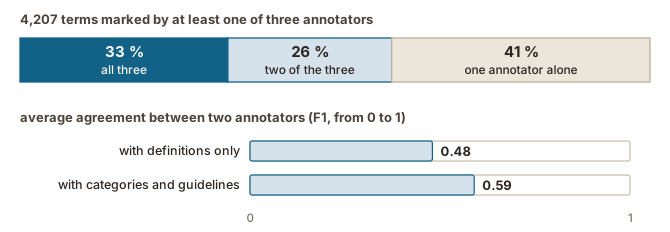
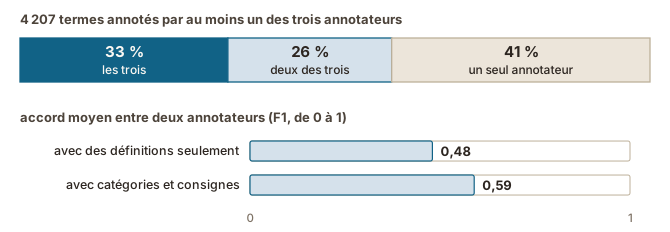
Figure 3. Three annotators on the same texts: the share of terms marked by all three, by two and by one, and the average agreement between two annotators depending on what they were given (Rigouts Terryn et al., 2020a).
Term boundaries
In “the horse moves on in posting trot”, is the term posting trot, trot,
posting, or all three? There is no universally correct answer to that
question, so this is where annotation guidelines can reduce some of the
variation. The guidelines of the ACTER dataset, for instance, answer “all three”: when
part of a longer term is a term in its own right, the longer term and the
shorter one are both marked. In the dressage texts, posting
trot was marked as a whole, and posting and trot were marked as well
(Rigouts Terryn, 2021a).
Other annotation schemes keep only the longest unit (Liu et al., 2025). Terms interrupted by other words
are another case to settle: in “collected and extended trot”, collected trot
is there in meaning but never appears as such in the text.
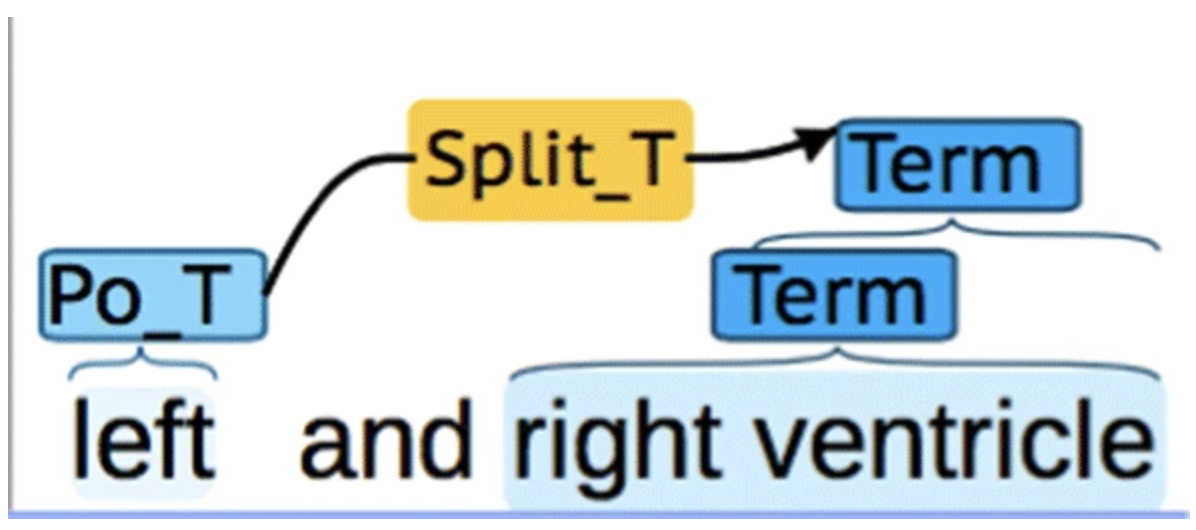
Figure 4figure 4 shows both cases as an annotation tool records them.
Figure 4. Nested and split terms in the BRAT annotation tool, from the annotation of a term extraction dataset: ventricle inside right ventricle, and left ventricle, which the text never writes in full, recorded as a part linked to the term it belongs to (Rigouts Terryn et al., 2020a).
Everyday words with a specialized sense
Some terms look like ordinary words; the table below gives three from
dressage. A reader who does not know the domain reads straight past them;
for a translator, they are exactly the words that need checking.
Word
Everyday sense
In dressage
collection
a set of objects
the way a horse shifts its weight towards its hindquarters and shortens its strides; collected and collect follow it
contact
touching, or being in touch
the connection between the rider’s hands and the horse’s mouth through the reins
passage
a way through, or an extract from a text
a movement: a very collected, elevated trot
Three dressage terms that look like everyday words.
Annotators also disagree about how specialized a unit has to be to count as
a term. One way to make that decision explicit is to ask two separate
questions, as the ACTER guidelines do (Rigouts Terryn, 2021a):
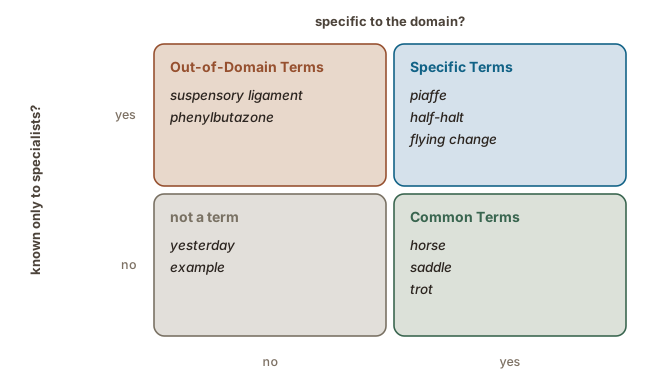
Is it specific to the domain? Does the unit relate to the subject of the
texts? This dimension is called domain specificity.
Is it specific in the lexicon? Is it known only to specialists, or is it
part of everyday vocabulary? This dimension is called lexicon specificity.
Different term labels can be defined from these two dimensions.
Figure 5figure 5 shows the three labels of the ACTER scheme: a unit that is specific on
both dimensions is a Specific Term, one that is specific to the domain only
is a Common Term, and one that is specific in the lexicon only is an
Out-of-Domain Term.
Figure 5. The two questions of the ACTER annotation scheme and the three labels they give, with examples chosen for dressage (after Rigouts Terryn, 2021a).
Both answers depend on who is asking, and the edge of the domain is a
decision too. When the dressage texts were annotated, terms from other
equestrian sports, such as gymkhana or voltige (vaulting), were labelled
as out of the domain, because the domain was taken to be dressage rather than
riding as a whole (Rigouts Terryn et al., 2019).
Knowing a domain well does not settle it either. I annotated the dressage
texts myself, and I know the sport well: I understood the terminology without
effort, but found it harder to tell terms from general vocabulary, because
the terms had become part of my own everyday vocabulary (Rigouts Terryn et
al., 2020a).
Two ways of settling the cases
A project that needs a list of terms has to settle the cases annotators
disagree about, such as term boundaries and everyday words with a
specialized sense. It can do so in two broad ways.
Categories. A scheme such as ACTER’s keeps the disagreement visible by
giving each unit a label: one of the three term labels above, or Named
Entity. A list can then be made strict or broad afterwards, by choosing
which labels count.
Neither way removes the disagreement. Every list of terms depends on such
choices, whether a person or a tool made it, and two lists made with
different choices cannot simply be compared as right and wrong.
Sources
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Liu, S., Lefever, E., & Hoste, V. (2025). MariATE: Automatic Term Extraction Using Large Language Models in the Maritime Domain. Proceedings of the 15th International Conference on Recent Advances in Natural Language Processing (RANLP 2025), 663–673. https://aclanthology.org/2025.ranlp-1.77/
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Figure 3. Trois annotateurs sur les mêmes textes : la part des termes retenus par les trois, par deux et par un seul, et l'accord moyen entre deux annotateurs selon ce qui leur était fourni (Rigouts Terryn et al., 2020a).
Les frontières d’un terme
Dans « le cheval repart au trot enlevé », le terme est-il trot enlevé,
trot, enlevé, ou les trois ? Cette question n’a pas de réponse
universellement correcte, et c’est donc là que des consignes d’annotation
peuvent réduire une partie de la variation. Les consignes du jeu de données ACTER, par exemple, répondent « les trois » : quand
une partie d’un terme plus long est elle-même un terme, le terme long et le
terme court sont tous deux annotés. Dans les textes anglais sur le dressage, posting
trot (trot enlevé) a été annoté en entier, et posting et trot l’ont été aussi
(Rigouts Terryn, 2021a).
D’autres schémas d’annotation ne gardent que l’unité la plus longue (Liu et al., 2025). Les termes interrompus par d’autres mots
sont un autre cas à trancher : dans « trot rassemblé et allongé », trot allongé
est là par le sens, mais n’apparaît jamais tel quel dans le texte.
La Figure 4figure 4 montre les deux cas tels qu’un outil d’annotation les enregistre.
Figure 4. Termes imbriqués et termes scindés dans l'outil d'annotation BRAT, lors de l'annotation d'un jeu de données d'extraction de termes : ventricle à l'intérieur de right ventricle, et left ventricle, que le texte n'écrit jamais en entier, enregistré comme une partie reliée au terme auquel elle appartient (Rigouts Terryn et al., 2020a).
Les mots courants qui ont un sens spécialisé
Certains termes ressemblent à des mots ordinaires ; le tableau ci-dessous en
donne trois, tirés du dressage. Une personne qui ne connaît pas le domaine ne
s’y arrête pas ; pour un traducteur, ce sont justement les mots à vérifier.
Mot
Sens courant
En dressage
rassembler
réunir des personnes ou des choses
l’attitude d’un cheval qui reporte son poids vers l’arrière-main et raccourcit ses foulées ; rassemblé en vient
contact
le fait de toucher, ou d’être en relation
la liaison entre les mains du cavalier et la bouche du cheval, par les rênes
passage
un endroit où l’on passe, ou un extrait de texte
un mouvement : un trot très rassemblé et relevé
Trois termes du dressage qui ressemblent à des mots courants.
Les annotateurs ne s’accordent pas non plus sur le degré de spécialisation
qu’une unité doit avoir pour compter comme terme. Une façon de rendre cette
décision explicite consiste à poser deux questions distinctes, comme le font
les consignes d’ACTER (Rigouts Terryn, 2021a) :
Est-elle spécifique au domaine ? L’unité se rapporte-t-elle au sujet des
textes ? Cette dimension s’appelle la spécificité au domaine.
Est-elle spécifique dans le lexique ? Est-elle connue des seuls spécialistes, ou
fait-elle partie du vocabulaire courant ? Cette dimension s’appelle la spécificité lexicale.
Ces deux dimensions permettent de définir différentes étiquettes de termes.
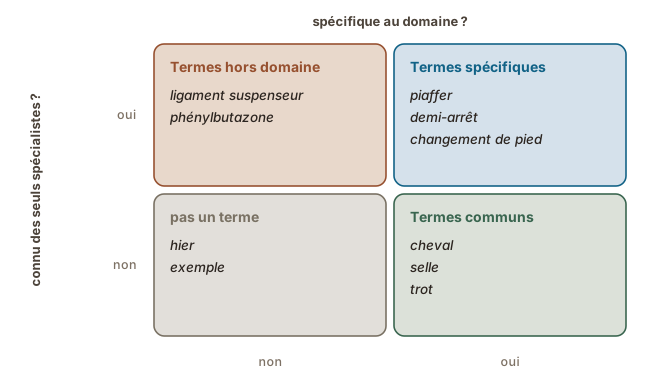
La Figure 5figure 5 montre les trois étiquettes du schéma d’ACTER : une unité spécifique sur
les deux dimensions est un terme spécifique (Specific Term), une unité spécifique au domaine seulement
est un terme commun (Common Term), et une unité spécifique dans le lexique seulement est un
terme hors domaine (Out-of-Domain Term).
Figure 5. Les deux questions du schéma d'annotation d'ACTER et les trois étiquettes qui en découlent, avec des exemples choisis pour le dressage (d'après Rigouts Terryn, 2021a).
Les deux réponses dépendent de la personne qui les donne, et la limite du domaine est
elle aussi une décision. Quand les textes sur le dressage ont été annotés, les termes d’autres
sports équestres, comme gymkhana ou voltige, ont été étiquetés
hors domaine, parce que le domaine retenu était le dressage et non
l’équitation dans son ensemble (Rigouts Terryn et al., 2019).
Bien connaître un domaine ne règle pas la question non plus. J’ai annoté moi-même les
textes sur le dressage, et je connais bien ce sport : je comprenais la terminologie sans
effort, mais j’avais plus de mal à distinguer les termes du vocabulaire général, parce que
ces termes faisaient désormais partie de mon vocabulaire courant (Rigouts Terryn et
al., 2020a).
Deux façons de trancher les cas
Un projet qui a besoin d’une liste de termes doit trancher les cas sur lesquels les annotateurs
ne s’accordent pas, comme les frontières d’un terme et les mots courants qui ont un
sens spécialisé. Il peut le faire de deux grandes façons.
Des catégories. Un schéma comme celui d’ACTER garde le désaccord visible en
donnant à chaque unité une étiquette : l’une des trois étiquettes de termes
ci-dessus, ou celle d’entité nommée. La liste peut ensuite être rendue stricte ou large,
selon les étiquettes retenues.
Aucune des deux façons ne supprime le désaccord. Toute liste de termes repose sur de tels
choix, qu’elle vienne d’une personne ou d’un outil, et deux listes établies avec
des choix différents ne peuvent pas simplement être comparées comme une bonne et une mauvaise.
Sources
Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
Liu, S., Lefever, E., & Hoste, V. (2025). MariATE: Automatic Term Extraction Using Large Language Models in the Maritime Domain. Proceedings of the 15th International Conference on Recent Advances in Natural Language Processing (RANLP 2025), 663–673. https://aclanthology.org/2025.ranlp-1.77/
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Term extraction as a taskL'extraction de termes comme tâche
Why extract terms
A list of the terms in a set of texts is useful in several kinds of work,
for instance:
for a translator, the terms in a client’s earlier documents show the
terminology that client uses;
the terms in a text you are about to translate can be looked up and settled
in one go before you start, where you would otherwise stop to research each
term as you come to it;
outside translation, the terms in a company’s manuals are the starting
point for a glossary for new staff, and the terms in a book for its index.
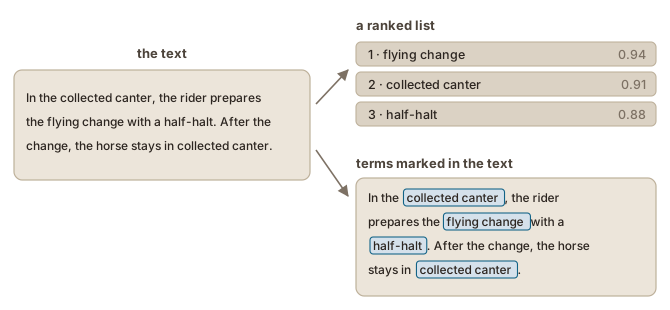
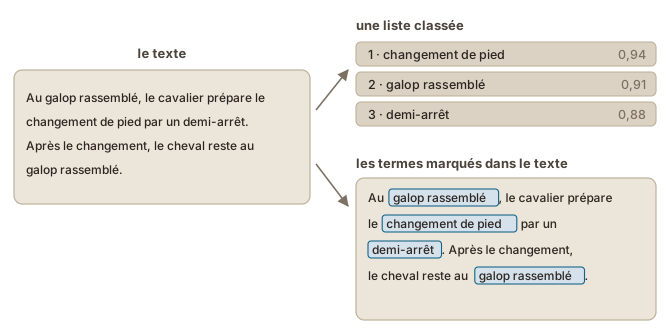
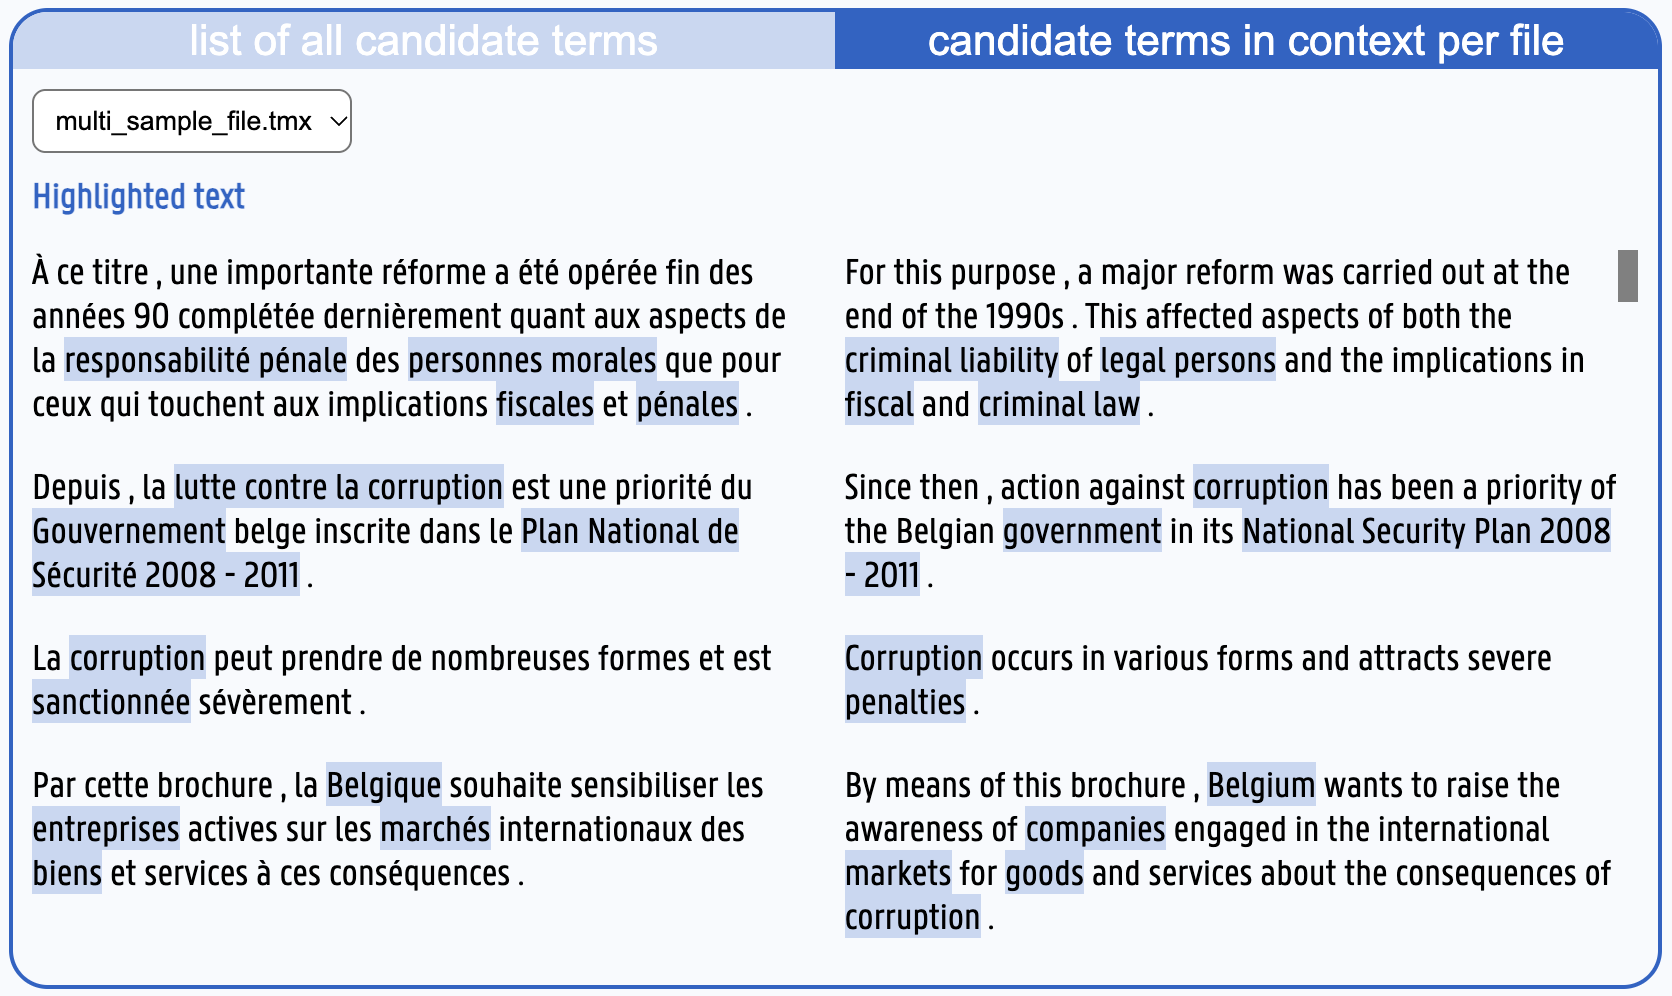
A term extractor can return its candidate terms in two forms (Figure 6figure 6):
A list. Each candidate appears once, however often it occurs, usually
ranked by a score that estimates how likely it is to be a term. The person
who validates the list decides where to stop reading it (Rigouts Terryn et
al., 2019).
The terms in the text. Every occurrence is marked where it appears, the
way a person highlights terms in a document (Lefever & Rigouts Terryn, 2024).
The same word can then be marked in one sentence and left unmarked in
another, where it has its everyday sense (Rigouts Terryn, 2021a).
Figure 6. The same text as a ranked list of candidates and as terms marked in the text. The scores are illustrative.
The challenge was therefore to translate the human notion of a term into
characteristics that a program can measure. Each method in this chapter is
one answer to that challenge, and each answer is imperfect in its own way.
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Pourquoi extraire des termes
La liste des termes d’un ensemble de textes est utile dans plusieurs types de
travail, par exemple :
pour un traducteur, les termes des documents antérieurs d’un client montrent
la terminologie que ce client emploie ;
les termes d’un texte que vous allez traduire peuvent être cherchés et fixés
en une fois avant de commencer, au lieu de vous arrêter pour chercher chaque
terme au moment où vous le rencontrez ;
en dehors de la traduction, les termes des manuels d’une entreprise sont le
point de départ d’un glossaire pour le nouveau personnel, et les termes d’un
livre, celui de son index.
Un extracteur de termes peut renvoyer ses candidats terminologiques sous deux formes (Figure 6figure 6) :
Une liste. Chaque candidat y figure une fois, quel que soit son nombre d’occurrences, le plus souvent
classé selon un score qui estime la probabilité qu’il soit un terme. La personne
qui valide la liste décide où arrêter sa lecture (Rigouts Terryn et
al., 2019).
Les termes dans le texte. Chaque occurrence est marquée là où elle apparaît, comme
lorsqu’on surligne les termes d’un document (Lefever et Rigouts Terryn, 2024).
Le même mot peut alors être marqué dans une phrase et ne pas l’être dans
une autre, où il a son sens courant (Rigouts Terryn, 2021a).
Figure 6. Le même texte sous forme de liste classée de candidats et sous forme de termes marqués dans le texte. Les scores sont donnés à titre d'illustration.
Le défi consistait donc à traduire la notion humaine de terme en
caractéristiques qu’un programme peut mesurer. Chaque méthode de ce chapitre est
une réponse à ce défi, et chaque réponse est imparfaite à sa manière.
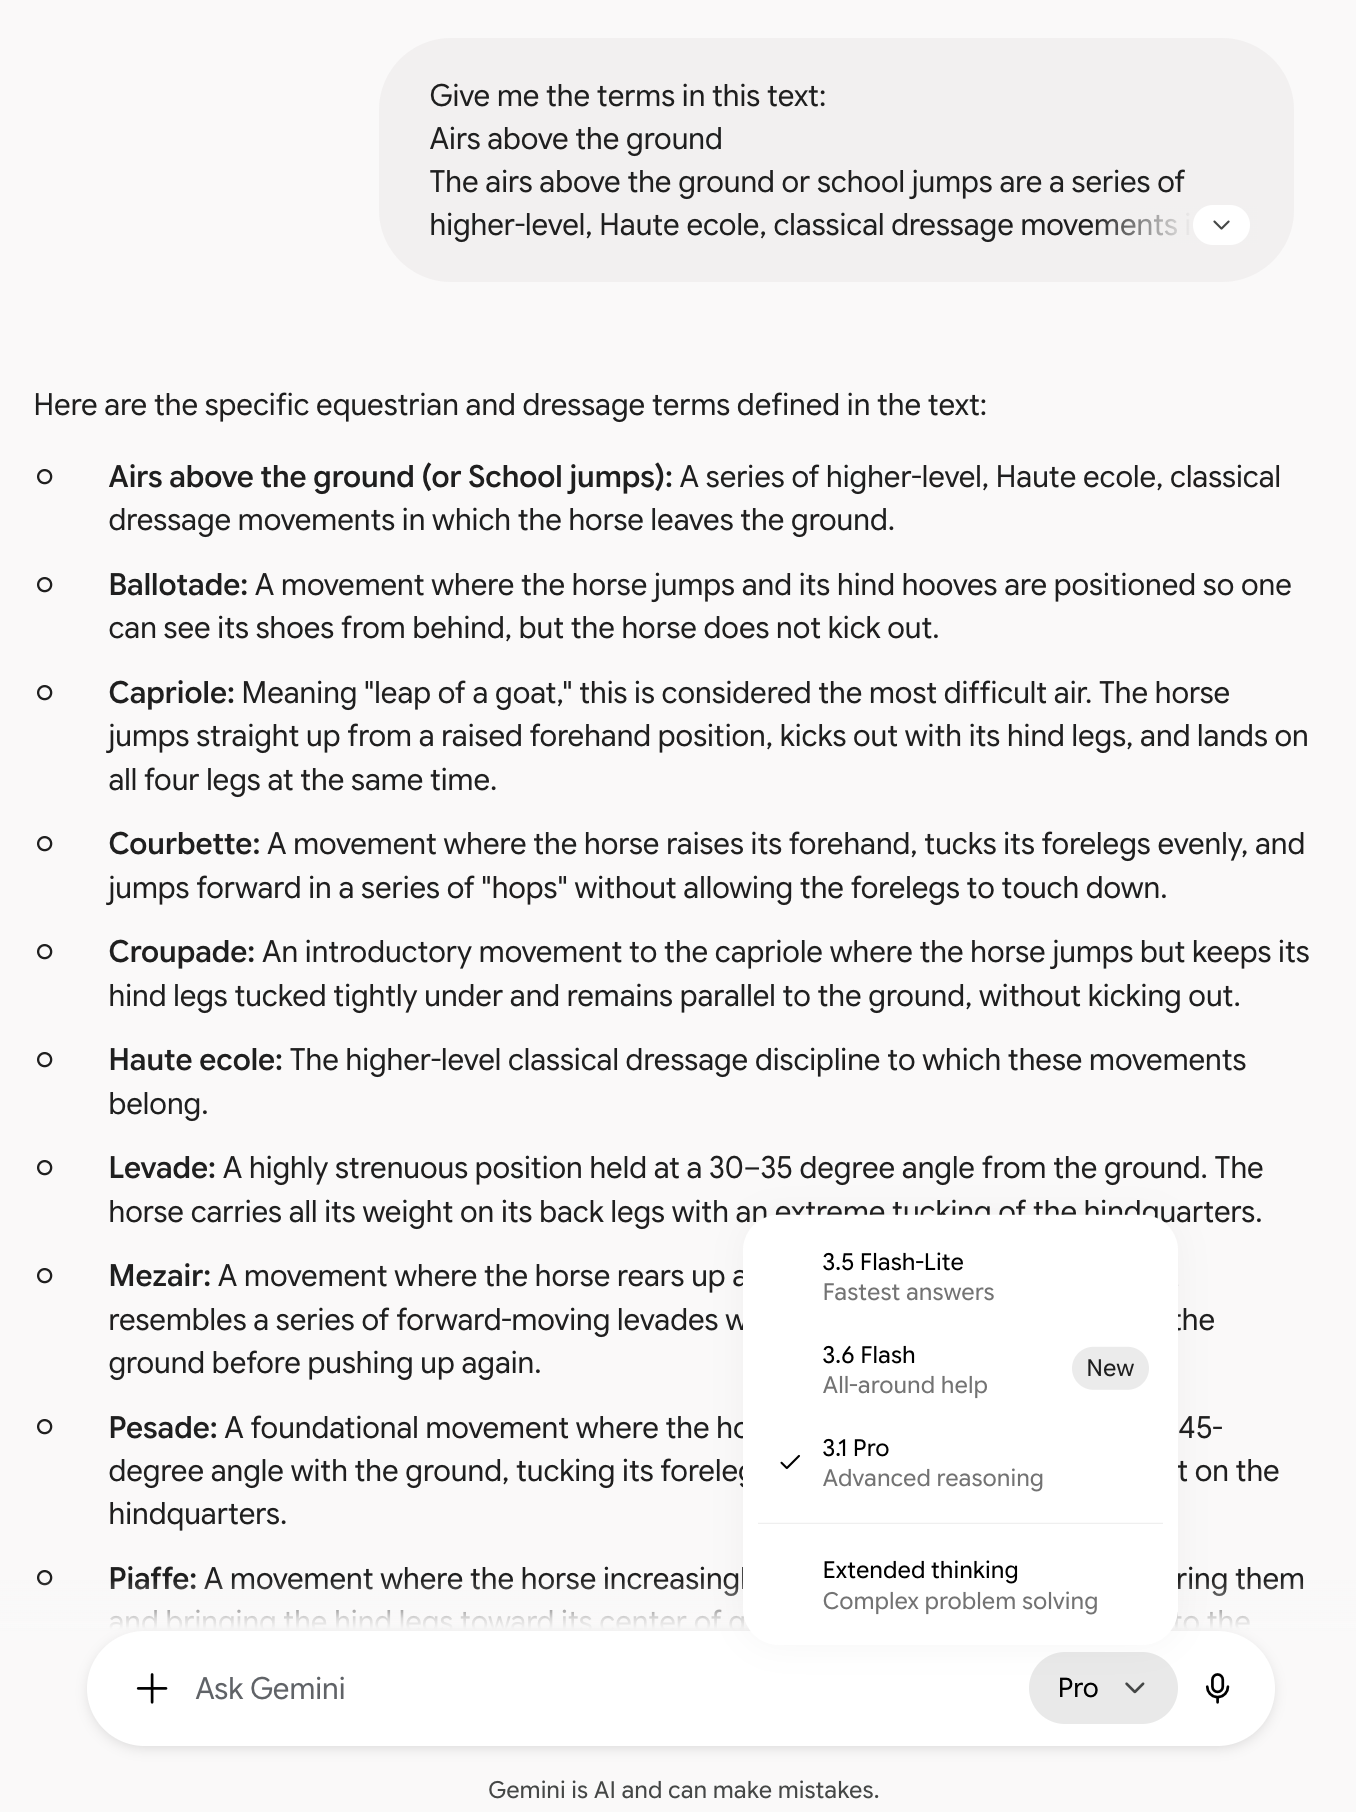
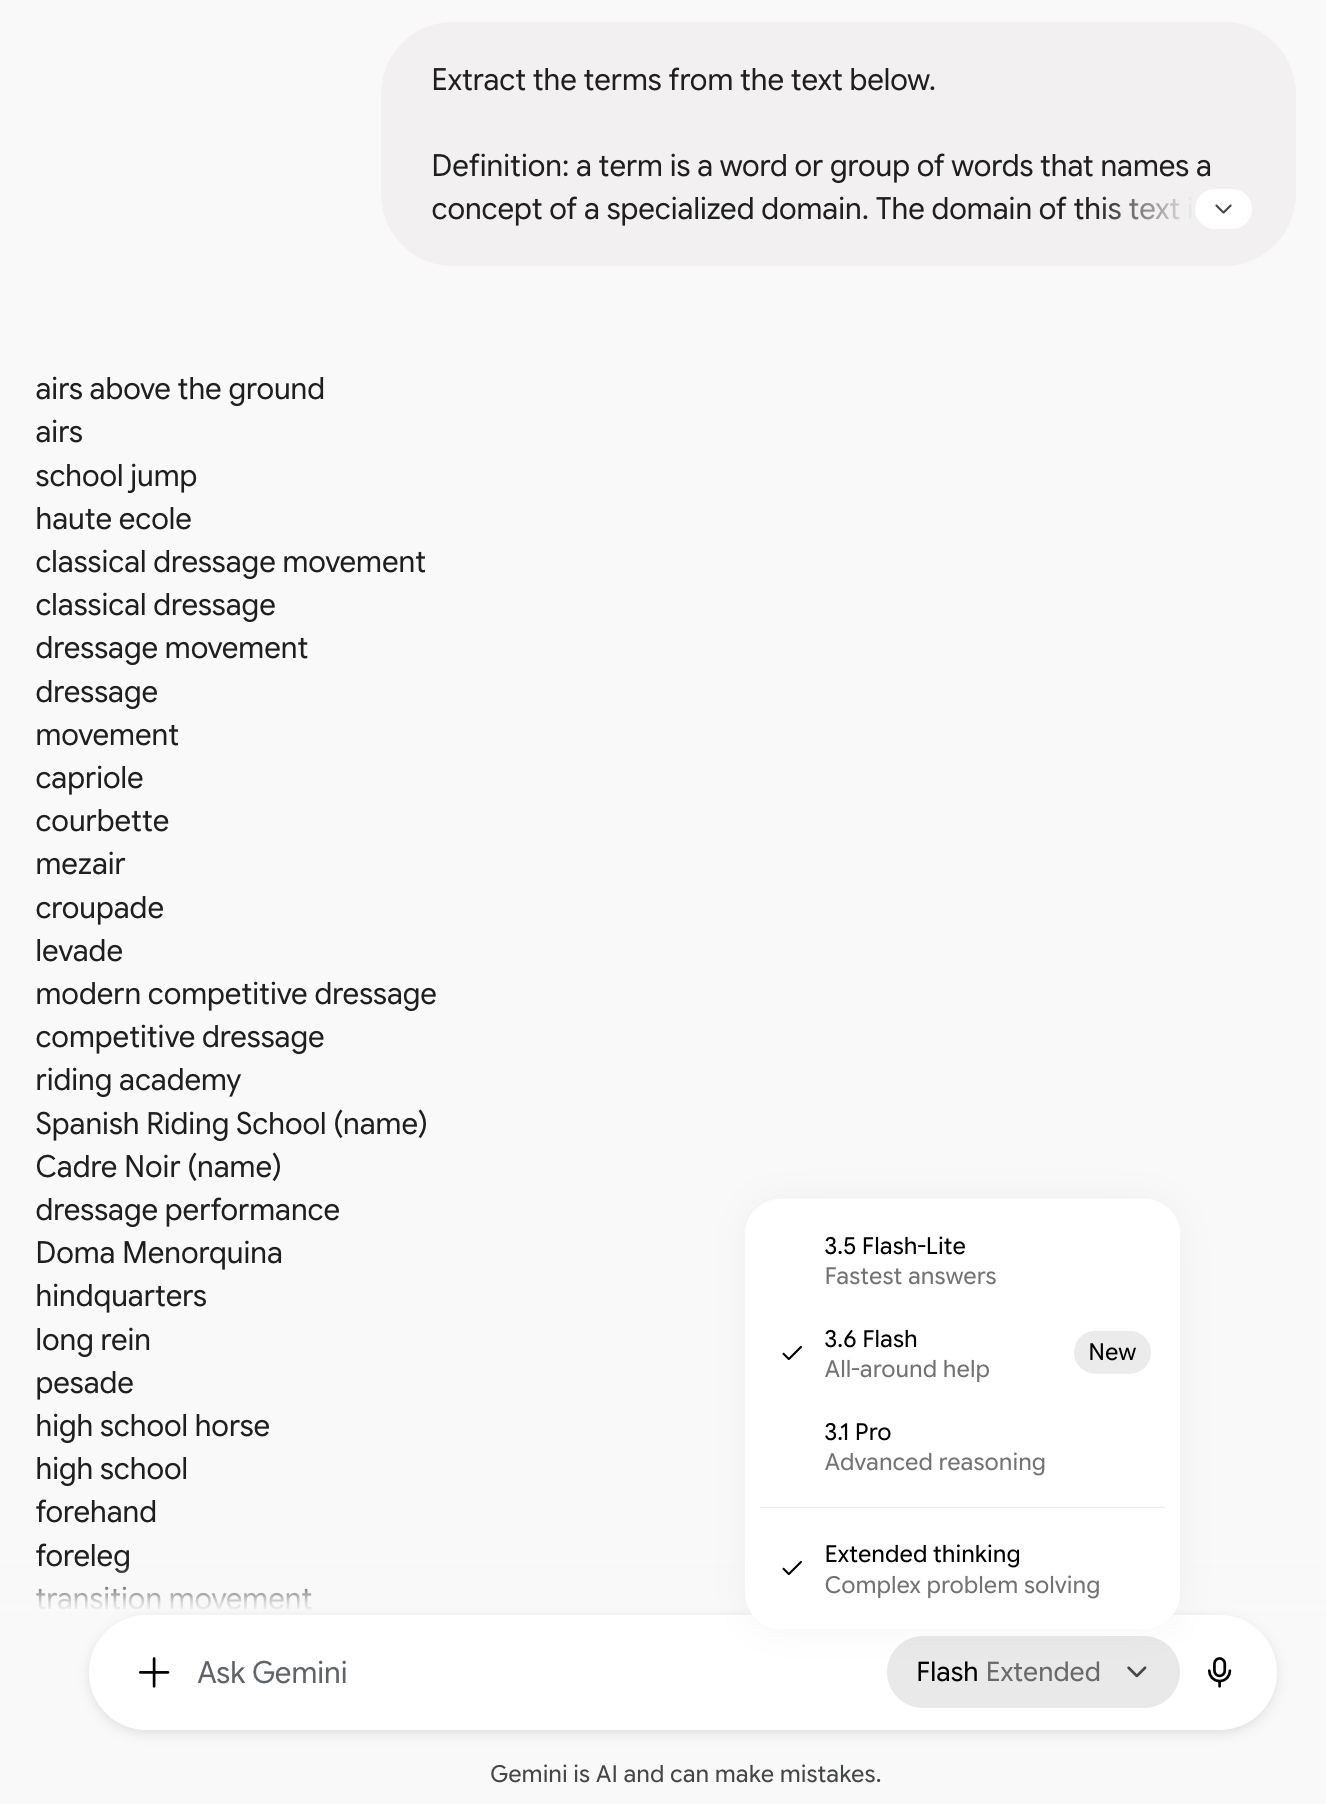
Un agent conversationnel à qui l’on demande les termes d’un texte
Trois familles de méthodes d'extraction de termes.
Sources
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Linguistic methods: part-of-speech patternsMéthodes linguistiques : les patrons morphosyntaxiques
Most terms are nouns or groups built around a noun, such as piaffe,
collected canter or canter pirouette, although adjectives, verbs and
adverbs can be terms too (Rigouts Terryn, 2021a).
If a program can get the parts of speech, and terms tend to have certain
sequences of them, then it can extract every sequence of that form. One of
the earliest algorithms for finding terms in text already worked this way
(Justeson & Katz, 1995).
The reasoning has a flaw: a noun or a group built around a noun can be a
term, but that does not mean that it is one.
Part-of-speech patterns
The linguistic method works in three steps (Lefever & Rigouts Terryn, 2024):
Typical patterns of terms, with a dressage example in each language where the pattern is common.
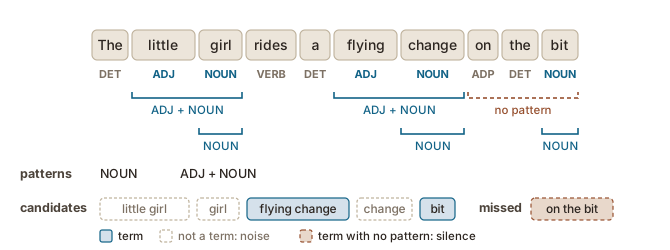
Figure 7figure 7 shows the three steps on one sentence, and what they return: five
candidates, of which two are terms, and one term that no pattern matches.
Figure 7. Tagging and pattern matching on one sentence, with the candidates the two patterns return and the term they miss. The tags are simplified.
Noise. In the sentence of Figure 7figure 7,
little girl has the same shape as flying change, and a pattern for
single nouns catches every noun in the text: girl, and change on its
own, which is only a fragment of a term.
It is nearly impossible to write every pattern a term can take, especially
since the tagger makes mistakes of its own (Rigouts Terryn et al., 2019).
The more patterns you have, the less likely you are to miss terms (less
silence), but the more likely you are to extract non-terms as well (more
noise).
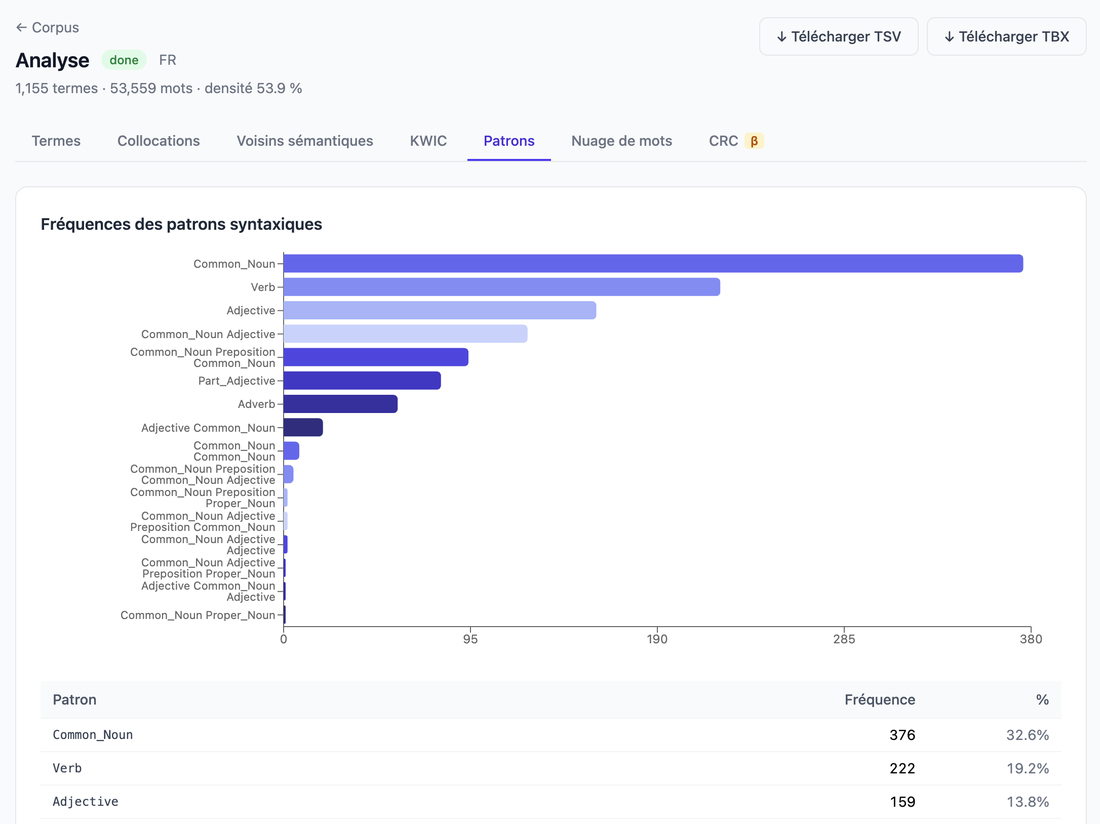
Figure 8. The grammatical patterns of the candidates TermoStat extracted from a French corpus about dressage (TermoStat 4.0 beta, 30 September 2026). The interface changes.
Patterns depend on the domain as well. A term that starts with a
preposition, such as on the bit, is common in dressage and uncommon in many
other domains, so a list of patterns that suits one domain can miss terms in
another.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Justeson, J. S., & Katz, S. M. (1995). Technical terminology: some linguistic properties and an algorithm for identification in text. Natural Language Engineering, 1(1), 9–27. https://doi.org/10.1017/S1351324900000048
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
La plupart des termes sont des noms ou des groupes construits autour d’un nom, comme piaffer,
galop rassemblé ou pirouette au galop, même si des adjectifs, des verbes et des
adverbes peuvent aussi être des termes (Rigouts Terryn, 2021a).
Si un programme peut obtenir les parties du discours, et si les termes tendent à suivre certaines
suites de parties du discours, il peut alors extraire toutes les suites de cette forme. L’un des
premiers algorithmes de repérage de termes dans un texte fonctionnait déjà ainsi
(Justeson et Katz, 1995).
Ce raisonnement a un défaut : un nom ou un groupe construit autour d’un nom peut être un
terme, mais cela ne veut pas dire qu’il en est un.
Les patrons morphosyntaxiques
La méthode linguistique procède en trois étapes (Lefever et Rigouts Terryn, 2024) :
Patrons typiques des termes, avec un exemple du dressage dans chaque langue où le patron est courant.
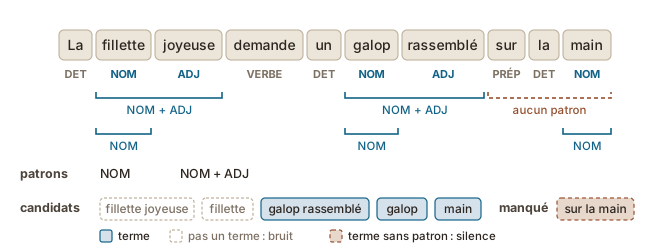
La Figure 7figure 7 montre les trois étapes sur une phrase, et ce qu’elles renvoient : cinq
candidats, dont trois sont des termes, et un terme qu’aucun patron ne retient.
Figure 7. L'étiquetage et le repérage des patrons sur une phrase, avec les candidats que renvoient les deux patrons et le terme qu'ils manquent. Les étiquettes sont simplifiées.
Le bruit. Dans la phrase de la Figure 7figure 7,
fillette joyeuse a la même forme que galop rassemblé, et un patron pour les
noms seuls retient tous les noms du texte, dont fillette.
Il est à peu près impossible d’écrire tous les patrons qu’un terme peut suivre, d’autant
que l’étiqueteur commet ses propres erreurs (Rigouts Terryn et al., 2019).
Plus vous avez de patrons, moins vous risquez de manquer des termes (moins de
silence), mais plus vous risquez d’extraire aussi des unités qui ne sont pas des termes (plus de
bruit).
Figure 8. Les patrons grammaticaux des candidats que TermoStat a extraits d'un corpus français sur le dressage (TermoStat 4.0 bêta, 30 septembre 2026). L'interface change.
Les patrons dépendent aussi du domaine. Un terme qui commence par une
préposition, comme sur la main, est courant en dressage et peu courant dans beaucoup
d’autres domaines, si bien qu’une liste de patrons adaptée à un domaine peut manquer des termes dans
un autre.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Justeson, J. S., & Katz, S. M. (1995). Technical terminology: some linguistic properties and an algorithm for identification in text. Natural Language Engineering, 1(1), 9–27. https://doi.org/10.1017/S1351324900000048
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2021a). ACTER terminology annotation guidelines. Ghent University, LT3 Language and Translation Technology Team. http://hdl.handle.net/1854/LU-8503113
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Statistical methods: termhood and unithoodMéthodes statistiques : degré de termitude et degré de figement
A term occurs relatively more often in the texts of its domain than in general text
Unithood
Do the words of a unit of several words form one unit? Flying change does; the horse changes does not, although its words often appear together.
How often the words of a candidate occur together, and how often each occurs on its own
The words of a term occur together more often than unrelated words do
Termhood and unithood: the question, the count and the assumption.
Termhood: comparing two corpora
A specialized corpus and a general one, such as a large collection of
newspaper articles (Drouin, 2003), are never the same size, so the counts
themselves cannot be compared. The comparison
uses relative frequencies: the number of occurrences divided by the size
of the corpus, often given per million words (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus).
The table below gives six words, with illustrative figures.
Word
Dressage corpus (200,000 words)
Per million
General corpus (100 million words)
Per million
How many times more frequent in dressage
the
12,105
60,525
6,031,000
60,310
1.0
next
153
765
70,400
704
1.1
horse
1,874
9,370
25,300
253
37
canter
468
2,340
1,240
12.4
189
piaffe
31
155
12
0.12
1,292
collection
63
315
19,800
198
1.6
Absolute and relative frequencies in a specialized and a general corpus. The figures are illustrative.
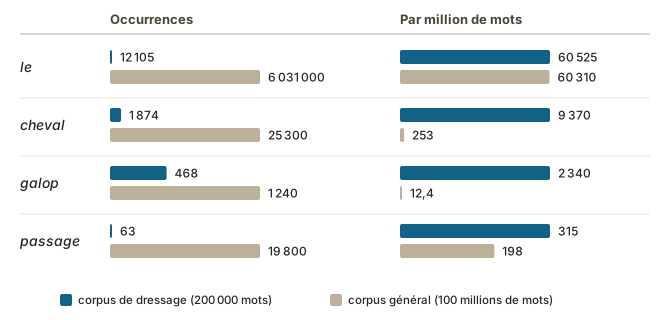
Figure 9figure 9 draws four of those words. Counted in occurrences, every word is
more frequent in the general corpus, because that corpus is 500 times larger.
Counted per million words, the six words of the table fall into four cases:
the and next are about as frequent in both corpora, so nothing ties
them to dressage;
horse is far more frequent in the dressage corpus, but it is also a
common word elsewhere;
canter and piaffe hardly occur outside texts about riding;
collection is a dressage term, but it is only 1.6 times more frequent in
the dressage corpus, because it is also an everyday word.
Figure 9. The same four words counted in occurrences and per million words. The figures are illustrative; the bars are to scale within each pair.
Corpus tools offer the same comparison under another name: Sketch Engine’s
Keywords function lists the words that are far more frequent in your corpus
than in a reference corpus of general language (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
A worked example: the log-likelihood ratio
Relative frequencies leave one question open: a word can be more frequent in
a small corpus by chance, especially when it occurs only a few times.
Statistical measures of termhood therefore take into account how much
evidence there is, as well as how large the difference is.
The log-likelihood ratio serves here as a worked example. It is a common
measure (Lefever & Rigouts Terryn, 2024), but one among many. The goal is to
understand the principle; the exact formula and the mathematical details are
not needed for that.
For each word, e.g., canter, the calculation goes through four steps, with
the figures of the frequency table above:
Counts.Canter occurs 468 times in the dressage corpus of 200,000
words, and 1,240 times in the general corpus of 100 million words.
Relative frequencies. 468 divided by 200,000 is 2,340 occurrences per
million words in the dressage corpus; 1,240 divided by 100 million is 12.4
per million in the general corpus. Canter is about 190 times more
frequent in the dressage corpus.
Expected counts. The two corpora together contain 1,708 occurrences of
canter, and the dressage corpus is about 0.2% of all the text. If
canter were equally frequent everywhere, about 3 of the 1,708
occurrences would be in the dressage corpus (0.2% of 1,708). There are
468.
Score. The log-likelihood ratio compares the counts that were observed
with the counts that were expected, 468 against about 3, and gives
canter a score of 3,818. A word whose counts are exactly as expected
scores zero. The further the counts are from the expected ones, and the
more occurrences there are to support the difference, the higher the
score.
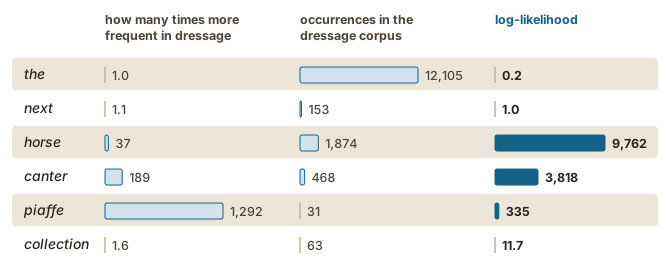
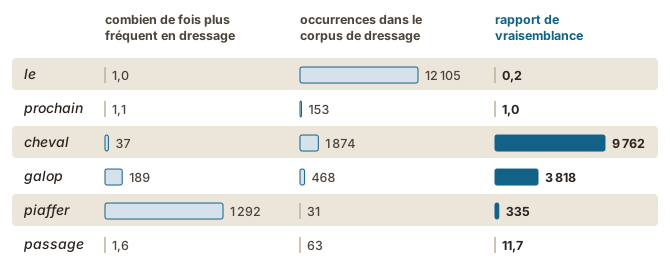
Figure 10figure 10 gives, for the six words of the frequency table, how many times more
frequent each word is in the dressage corpus, how often it occurs there, and
its log-likelihood ratio.
Figure 10. Three numbers for six words: the size of the difference, the number of occurrences, and the log-likelihood ratio that results. The figures are illustrative; the bars are to scale within each column.
Three things can be read from the figure:
The has by far the most occurrences and a score close to zero.
Frequency alone says nothing about how specific a word is.
Piaffe is about 1,300 times more frequent in the dressage corpus, the
largest difference of the six, but it scores far below horse, which is
only 37 times more frequent. Thirty-one occurrences are less evidence than
1,874.
A high score needs both: a clear difference and enough occurrences to
support it.
Collection scores 11.7, far below piaffe, which has half as many
occurrences. It is a dressage term, the way a horse shifts its weight
towards its hindquarters, and also an everyday word, as in an art
collection (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes).
A program counts written forms and cannot tell the two senses apart, so
the everyday uses in the general corpus pull the score down.
When a difference counts
A less clear case shows why the score is needed. The table below gives two
words that are both one and a half times more frequent in the dressage
corpus than in the general one, with illustrative figures.
Word
Occurrences in the dressage corpus
Per million
Per million in the general corpus
How many times more frequent in dressage
Log-likelihood ratio
weather
7
35
23
1.5
1.1
leg
312
1,560
1,026
1.5
47.8
Two words with the same difference in relative frequency and different scores. The figures are illustrative.
The difference in relative frequency is the same for both words, but seven
occurrences are too few to rely on: one or two more or fewer would change
the picture. Three hundred and twelve occurrences are enough.
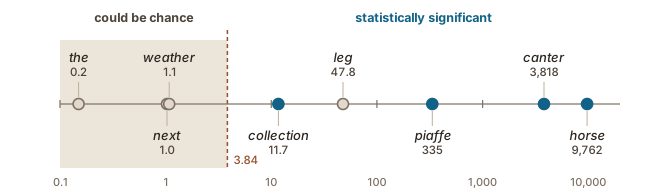
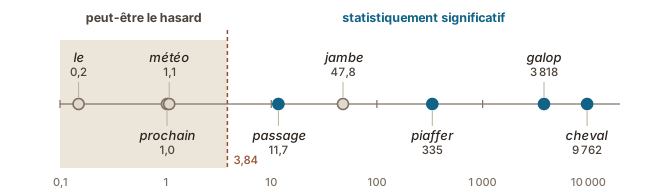
By the usual convention, a score above 3.84 means that a difference of that
size would come about by chance less than 5 times in 100, and the difference
is then called statistically significant.The thresholds are given with the log-likelihood calculator
of the UCREL centre at Lancaster University: 3.84 for 5 chances in 100 and
6.63 for 1 in 100 (read 1 October 2026).Figure 11figure 11 places the eight words of the two tables on either side of that threshold.
Figure 11. The scores of the eight example words and the threshold of 3.84, on a logarithmic scale. Filled dots are dressage terms. The figures are illustrative.
The scores in a term extractor
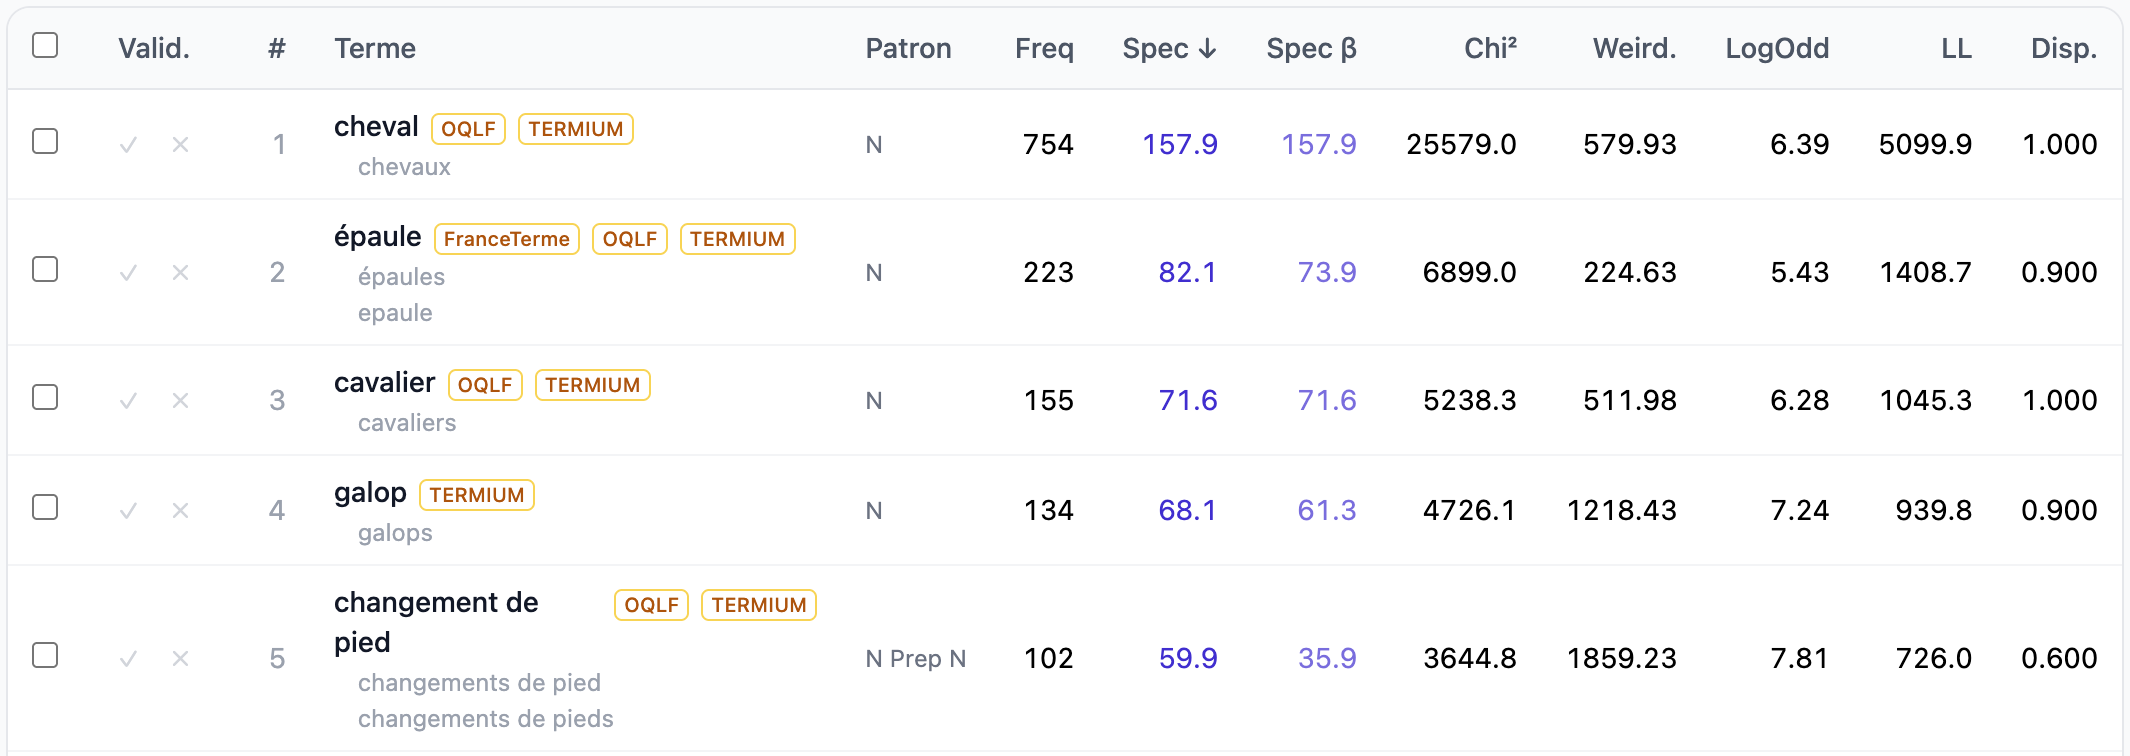
A term extractor reports these numbers for each candidate. In TermoStat’s
list of results (Figure 12figure 12), each row gives the frequency of the candidate in the corpus (Freq) and
several scores computed against a reference corpus, the log-likelihood ratio
(LL) among them (see also the TermoStat: a hybrid extractor page) (voir aussi la page TermoStat : un extracteur hybride).
Figure 12. The frequency and the scores of the first five candidates TermoStat extracted from a French corpus about dressage (TermoStat 4.0 beta, 1 October 2026). The interface changes.
Unithood: words that occur together
Flying and change are both ordinary words, but in dressage texts they
occur side by side far more often than chance would put them together. Good
and horse also occur together often, but mostly because both are frequent.
Measures of unithood compare how often the words of a candidate occur
together with how often each occurs on its own (Lefever & Rigouts Terryn,
2024).
Unithood alone does not identify terms. It measures how firmly words stick
together, which is also true of fixed expressions that are not terms, such as
in the end or on the other hand (Kageura & Umino, 1996). Measures designed
for terms of several words, such as the C-value (Frantzi et al., 2000),
exist for that reason, and it is also why the statistical measures are
usually combined with the linguistic
patterns (see also the Hybrid term extraction page) (voir aussi la page L'extraction hybride de termes).
They need no knowledge of the language: the same counts work for English, French or Dutch, provided a general corpus exists in that language.
Requirement
They need enough text: a few pages give too few occurrences for the measure to separate the terms from the rest.
Silence
A word that occurs once or twice scores low, however specialized it is, so rare terms are easily missed (Rigouts Terryn et al., 2019). A term that is also an everyday word, such as collection, scores low too, because it is frequent in general text as well.
Noise
A high score does not make a term: a word can be frequent in these texts for another reason, such as the name of a rider, and a fragment of a longer term scores as readily as the whole term.
Strengths and limits of statistical methods.
Sources
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Frantzi, K., Ananiadou, S., & Mima, H. (2000). Automatic recognition of multi-word terms: the C-value/NC-value method. International Journal on Digital Libraries, 3(2), 115–130. https://doi.org/10.1007/s007999900023
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rayson, P., & Garside, R. (2000). Comparing Corpora using Frequency Profiling. Proceedings of the Workshop on Comparing Corpora, 38th Annual Meeting of the Association for Computational Linguistics, 1–6. https://aclanthology.org/W00-0901/
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Un terme apparaît relativement plus souvent dans les textes de son domaine que dans les textes généraux
Degré de figement
Les mots d’une unité de plusieurs mots forment-ils une seule unité ? Oui pour changement de pied ; non pour le cheval change, même si ces mots apparaissent souvent ensemble.
Le nombre de fois où les mots d’un candidat apparaissent ensemble, et le nombre de fois où chacun apparaît seul
Les mots d’un terme apparaissent ensemble plus souvent que des mots sans lien
Le degré de termitude et le degré de figement : la question, le compte et l'hypothèse.
Le degré de termitude : comparer deux corpus
Un corpus spécialisé et un corpus général, par exemple un grand ensemble
d’articles de journaux (Drouin, 2003), n’ont jamais la même taille, si bien que les
nombres d’occurrences ne peuvent pas être comparés tels quels. La comparaison
se fait avec des fréquences relatives : le nombre d’occurrences divisé par la taille
du corpus, souvent exprimé par million de mots (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus).
Le tableau ci-dessous donne six mots, avec des chiffres fournis à titre d’illustration.
Mot
Corpus de dressage (200 000 mots)
Par million
Corpus général (100 millions de mots)
Par million
Combien de fois plus fréquent en dressage
le
12 105
60 525
6 031 000
60 310
1,0
prochain
153
765
70 400
704
1,1
cheval
1 874
9 370
25 300
253
37
galop
468
2 340
1 240
12,4
189
piaffer
31
155
12
0,12
1 292
passage
63
315
19 800
198
1,6
Fréquences absolues et relatives dans un corpus spécialisé et dans un corpus général. Les chiffres sont donnés à titre d'illustration.
La Figure 9figure 9 représente quatre de ces mots. En nombre d’occurrences, chaque mot est
plus fréquent dans le corpus général, parce que ce corpus est 500 fois plus grand.
Par million de mots, les six mots du tableau se répartissent en quatre cas :
le et prochain sont à peu près aussi fréquents dans les deux corpus, si bien que rien ne les
rattache au dressage ;
cheval est beaucoup plus fréquent dans le corpus de dressage, mais c’est aussi un
mot courant ailleurs ;
galop et piaffer n’apparaissent presque pas en dehors des textes sur l’équitation ;
passage est un terme du dressage, mais il n’est que 1,6 fois plus fréquent dans
le corpus de dressage, parce que c’est aussi un mot courant.
Figure 9. Les quatre mêmes mots comptés en occurrences et par million de mots. Les chiffres sont donnés à titre d'illustration ; les barres sont à l'échelle à l'intérieur de chaque paire.
Les outils d’analyse de corpus proposent la même comparaison sous un autre nom : la fonction
Keywords de Sketch Engine dresse la liste des mots beaucoup plus fréquents dans votre corpus
que dans un corpus de référence de langue générale (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Un exemple détaillé : le rapport de vraisemblance
Les fréquences relatives laissent une question ouverte : un mot peut être plus fréquent dans
un petit corpus par hasard, surtout s’il n’y apparaît que quelques fois.
Les mesures statistiques du degré de termitude tiennent donc compte de la quantité
d’indices disponibles, en plus de l’ampleur de la différence.
Le rapport de vraisemblance (angl. log-likelihood ratio) sert ici d’exemple détaillé. C’est une mesure
courante (Lefever et Rigouts Terryn, 2024), mais une parmi beaucoup d’autres. Le but est
d’en comprendre le principe ; la formule exacte et les détails mathématiques ne sont
pas nécessaires pour cela.
Pour chaque mot, par exemple galop, le calcul passe par quatre étapes, avec
les chiffres du tableau de fréquences ci-dessus :
Les occurrences.Galop apparaît 468 fois dans le corpus de dressage de 200 000
mots, et 1 240 fois dans le corpus général de 100 millions de mots.
Les fréquences relatives. 468 divisé par 200 000 donne 2 340 occurrences par
million de mots dans le corpus de dressage ; 1 240 divisé par 100 millions donne 12,4
par million dans le corpus général. Galop est environ 190 fois plus
fréquent dans le corpus de dressage.
Les occurrences attendues. Les deux corpus contiennent ensemble 1 708 occurrences de
galop, et le corpus de dressage représente environ 0,2 % de tout le texte. Si
galop était aussi fréquent partout, environ 3 des 1 708
occurrences se trouveraient dans le corpus de dressage (0,2 % de 1 708). Il y en a
468.
Le score. Le rapport de vraisemblance compare les occurrences observées
aux occurrences attendues, 468 contre 3 environ, et donne à
galop un score de 3 818. Un mot dont les occurrences correspondent exactement à ce qui est attendu
obtient zéro. Plus les occurrences s’éloignent de ce qui est attendu, et plus
elles sont nombreuses à appuyer cette différence, plus le score est
élevé.
La Figure 10figure 10 donne, pour les six mots du tableau de fréquences, combien de fois
chaque mot est plus fréquent dans le corpus de dressage, combien de fois il y apparaît, et
son rapport de vraisemblance.
Figure 10. Trois chiffres pour six mots : l'ampleur de la différence, le nombre d'occurrences, et le rapport de vraisemblance qui en résulte. Les chiffres sont donnés à titre d'illustration ; les barres sont à l'échelle à l'intérieur de chaque colonne.
La figure permet de lire trois choses :
Le a de loin le plus d’occurrences et un score proche de zéro.
La fréquence seule ne dit rien de la spécificité d’un mot.
Piaffer est environ 1 300 fois plus fréquent dans le corpus de dressage, la
plus grande différence des six, mais son score est bien inférieur à celui de cheval, qui n’est
que 37 fois plus fréquent. Trente et une occurrences sont un indice plus faible que
1 874.
Un score élevé demande les deux : une différence nette et assez d’occurrences pour
l’appuyer.
Passage obtient 11,7, bien en dessous de piaffer, qui a deux fois moins
d’occurrences. C’est un terme du dressage, un trot très rassemblé et relevé,
et aussi un mot courant, comme dans un passage pour
piétons (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes).
Un programme compte des formes écrites et ne peut pas distinguer les deux sens, si bien que
les emplois courants du corpus général font baisser le score.
À partir de quand une différence compte
Un cas moins net montre pourquoi le score est nécessaire. Le tableau ci-dessous donne deux
mots qui sont tous deux une fois et demie plus fréquents dans le corpus de dressage
que dans le corpus général, avec des chiffres fournis à titre d’illustration.
Mot
Occurrences dans le corpus de dressage
Par million
Par million dans le corpus général
Combien de fois plus fréquent en dressage
Rapport de vraisemblance
météo
7
35
23
1,5
1,1
jambe
312
1 560
1 026
1,5
47,8
Deux mots qui présentent la même différence de fréquence relative et des scores différents. Les chiffres sont donnés à titre d'illustration.
La différence de fréquence relative est la même pour les deux mots, mais sept
occurrences sont trop peu pour s’y fier : une ou deux de plus ou de moins changeraient
le tableau. Trois cent douze occurrences suffisent.
Par convention, un score supérieur à 3,84 signifie qu’une différence de cette
ampleur apparaîtrait par hasard moins de 5 fois sur 100, et la différence
est alors dite statistiquement significative.Les seuils sont donnés avec le calculateur du rapport de vraisemblance
du centre UCREL de l’Université de Lancaster : 3,84 pour 5 chances sur 100 et
6,63 pour 1 sur 100 (consulté le 1er octobre 2026). La Figure 11figure 11 place les huit mots des deux tableaux de part et d’autre de ce seuil.
Figure 11. Les scores des huit mots donnés en exemple et le seuil de 3,84, sur une échelle logarithmique. Les points pleins sont des termes du dressage. Les chiffres sont donnés à titre d'illustration.
Les scores dans un extracteur de termes
Un extracteur de termes donne ces chiffres pour chaque candidat. Dans la
liste de résultats de TermoStat (Figure 12figure 12), chaque ligne indique la fréquence du candidat dans le corpus (Freq) et
plusieurs scores calculés par rapport à un corpus de référence, dont le rapport de vraisemblance
(LL) (see also the TermoStat: a hybrid extractor page) (voir aussi la page TermoStat : un extracteur hybride).
Figure 12. La fréquence et les scores des cinq premiers candidats que TermoStat a extraits d'un corpus français sur le dressage (TermoStat 4.0 bêta, 1er octobre 2026). L'interface change.
Le degré de figement : des mots qui apparaissent ensemble
Changement et pied sont deux mots ordinaires, mais dans les textes sur le dressage ils
apparaissent côte à côte bien plus souvent que le hasard ne les ferait se rencontrer. Bon
et cheval apparaissent souvent ensemble eux aussi, mais surtout parce que les deux sont fréquents.
Les mesures du degré de figement comparent le nombre de fois où les mots d’un candidat apparaissent
ensemble au nombre de fois où chacun apparaît seul (Lefever et Rigouts Terryn,
2024).
Le degré de figement ne suffit pas à identifier les termes. Il mesure la solidité du lien entre des mots,
et ce lien est tout aussi solide dans des expressions figées qui ne sont pas des termes, comme
à la fin ou d’autre part (Kageura et Umino, 1996). Des mesures conçues
pour les termes de plusieurs mots, comme la C-value (Frantzi et al., 2000),
existent pour cette raison, et c’est aussi pourquoi les mesures statistiques sont
le plus souvent combinées aux patrons
morphosyntaxiques (see also the Hybrid term extraction page) (voir aussi la page L'extraction hybride de termes).
Les forces et les limites des méthodes statistiques
Elles n’ont besoin d’aucune connaissance de la langue : les mêmes comptes valent pour l’anglais, le français ou le néerlandais, à condition qu’un corpus général existe dans cette langue.
Condition
Il leur faut assez de texte : quelques pages donnent trop peu d’occurrences pour que la mesure sépare les termes du reste.
Silence
Un mot qui apparaît une ou deux fois obtient un score faible, aussi spécialisé soit-il, si bien que les termes rares sont facilement manqués (Rigouts Terryn et al., 2019). Un terme qui est aussi un mot courant, comme passage, obtient lui aussi un score faible, parce qu’il est également fréquent dans les textes généraux.
Bruit
Un score élevé ne fait pas un terme : un mot peut être fréquent dans ces textes pour une autre raison, comme le nom d’un cavalier, et un fragment d’un terme plus long obtient un score aussi facilement que le terme entier.
Les forces et les limites des méthodes statistiques.
Sources
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Frantzi, K., Ananiadou, S., & Mima, H. (2000). Automatic recognition of multi-word terms: the C-value/NC-value method. International Journal on Digital Libraries, 3(2), 115–130. https://doi.org/10.1007/s007999900023
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rayson, P., & Garside, R. (2000). Comparing Corpora using Frequency Profiling. Proceedings of the Workshop on Comparing Corpora, 38th Annual Meeting of the Association for Computational Linguistics, 1–6. https://aclanthology.org/W00-0901/
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Hybrid term extractionL'extraction hybride de termes
Two methods with opposite weaknesses
Linguistic and statistical methods fail in different ways, as the table
below sets out, and each does well where the other fails.
Method
What it gives
What it lacks
Linguistic
candidates with the grammatical form of a term
any way of telling a term from another sequence of the same form
Statistical
a ranking of words by how specific they are to the domain
any account of grammar: it scores single words and fragments as readily as whole terms
What linguistic and statistical methods each give and lack.
A hybrid extractor combines the two.
The two steps
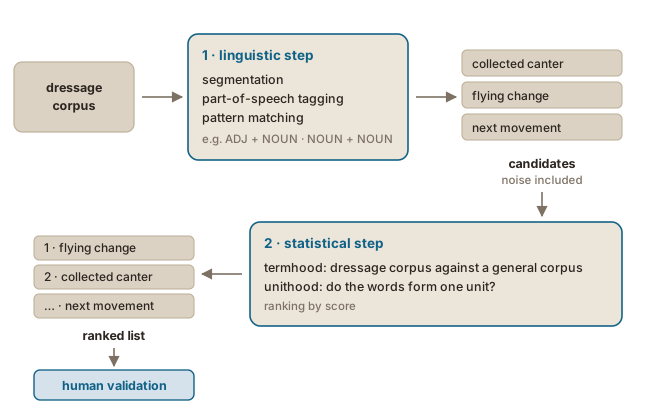
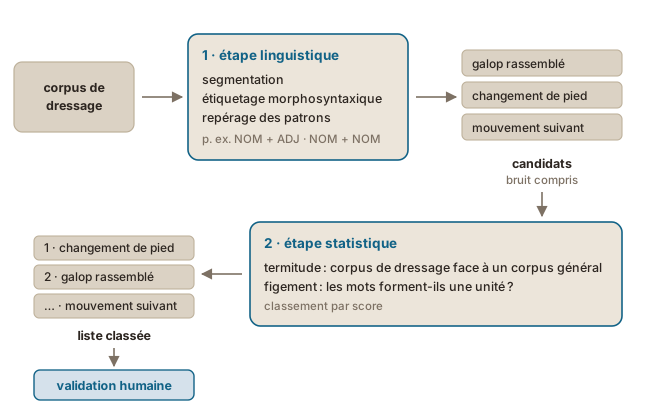
A hybrid extractor works in two steps (Figure 13figure 13).
Figure 13. The two steps of a hybrid term extractor, with examples from dressage.
The result is a list of candidates ordered from most to least likely to be a
term. Nothing in it says where the terms stop: the person who uses the list
chooses a cut-off, reads the top of it, or sets a threshold on the score
(Rigouts Terryn et al., 2019). TermoStat is a tool of this
kind (see also the TermoStat: a hybrid extractor page) (voir aussi la page TermoStat : un extracteur hybride).
Strengths and limits
The table below sets the strengths of a hybrid extractor beside its limits.
Strengths
Limits
Transparent. Each candidate is on the list because it matched a pattern and scored high, so you can see why it is there.
Repeatable. The same text gives the same list every time.
Rare terms are easily missed. A term that occurs once or twice scores low, however specialized it is (Rigouts Terryn et al., 2019).
The cut-off is yours. On a collection of Dutch texts about dressage, TermoStat’s full list contained almost two thirds of the terms people had marked, but fewer than one candidate in five was a term (Rigouts Terryn et al., 2019).
The patterns depend on the language. They are written for one language, and a term with an unusual structure falls outside them.
Strengths and limits of a hybrid term extractor.
On the size of the corpus, TermoStat’s guide recommends at least 50,000 words
and warns that under 10,000 few candidates come out as statistically
significant.TermoStat, Guide de l’utilisateur, version 4.0 beta,
read 30 September 2026. The Keywords function of Sketch Engine ranks
words by the same kind of comparison and has the same
limit (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Deux méthodes aux faiblesses opposées
Les méthodes linguistiques et statistiques échouent de façons différentes, comme le montre le
tableau ci-dessous, et chacune réussit là où l’autre échoue.
Méthode
Ce qu’elle apporte
Ce qui lui manque
Linguistique
des candidats qui ont la forme grammaticale d’un terme
un moyen de distinguer un terme d’une autre suite de même forme
Statistique
un classement des mots selon leur spécificité au domaine
toute prise en compte de la grammaire : elle donne un score aux mots isolés et aux fragments aussi facilement qu’aux termes entiers
Ce que les méthodes linguistiques et statistiques apportent, et ce qui leur manque.
Un extracteur hybride combine les deux.
Les deux étapes
Un extracteur hybride procède en deux étapes (Figure 13figure 13).
Figure 13. Les deux étapes d'un extracteur de termes hybride, avec des exemples du dressage.
Le résultat est une liste de candidats classés du plus probable au moins probable comme
terme. Rien n’y indique où les termes s’arrêtent : la personne qui utilise la liste
choisit un seuil, en lit le début, ou fixe un score minimal
(Rigouts Terryn et al., 2019). TermoStat est un outil de ce
type (see also the TermoStat: a hybrid extractor page) (voir aussi la page TermoStat : un extracteur hybride).
Les forces et les limites
Le tableau ci-dessous met les forces d’un extracteur hybride en regard de ses limites.
Forces
Limites
Transparent. Chaque candidat figure dans la liste parce qu’il correspondait à un patron et a obtenu un score élevé : vous pouvez donc voir pourquoi il s’y trouve.
Reproductible. Le même texte donne chaque fois la même liste.
Les termes rares sont facilement manqués. Un terme qui apparaît une ou deux fois obtient un score faible, aussi spécialisé soit-il (Rigouts Terryn et al., 2019).
Le seuil vous revient. Sur un ensemble de textes néerlandais sur le dressage, la liste complète de TermoStat contenait près des deux tiers des termes annotés par des personnes, mais moins d’un candidat sur cinq était un terme (Rigouts Terryn et al., 2019).
Les patrons dépendent de la langue. Ils sont écrits pour une langue, et un terme de structure inhabituelle leur échappe.
Les forces et les limites d'un extracteur de termes hybride.
Sur la taille du corpus, le guide de TermoStat recommande au moins 50 000 mots
et prévient qu’en dessous de 10 000, peu de candidats ressortent comme statistiquement
significatifs.TermoStat, Guide de l’utilisateur, version 4.0 bêta,
consulté le 30 septembre 2026. La fonction Keywords de Sketch Engine classe
les mots selon le même type de comparaison et a la même
limite (see also the Going further page, in the Corpus analysis module) (voir aussi la page Pour aller plus loin, dans le module L'analyse de corpus).
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
TermoStat: a hybrid extractorTermoStat : un extracteur hybride
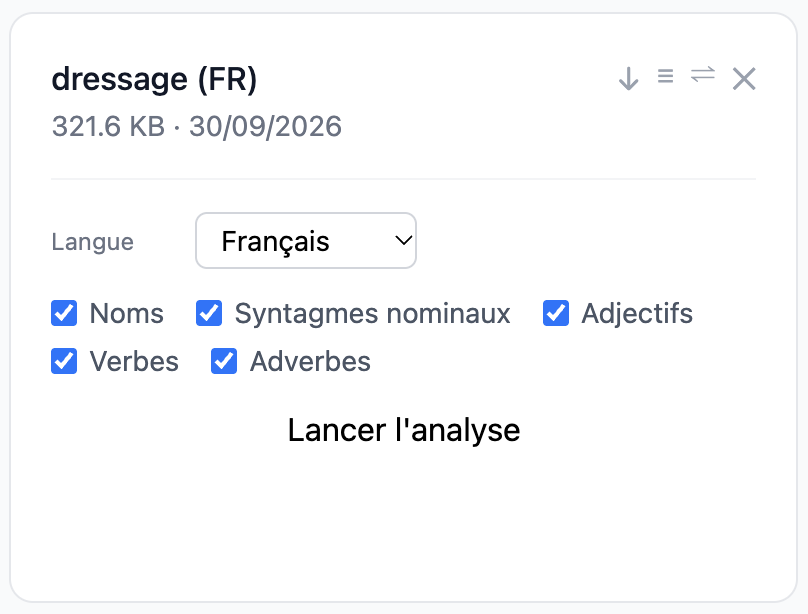
Running TermoStat takes three settingsTermoStat, Guide de l’utilisateur, version 4.0 beta, read
30 September 2026; the guide is in the tool’s Help menu, behind the login. (Figure 14figure 14):
the parts of speech to extract, among nouns, noun phrases, adjectives,
verbs and adverbs.
Figure 14. TermoStat's settings for one corpus: the language and the parts of speech to extract.
The ranked list and its scores
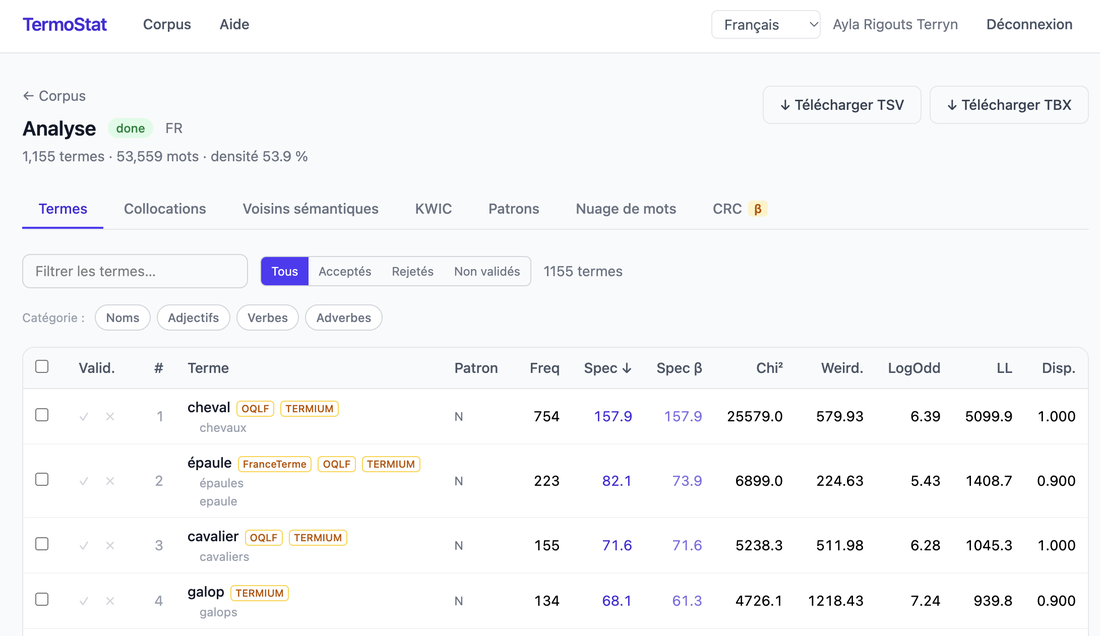
TermoStat returns a list of candidates ranked by specificity (Figure 15figure 15).
Each row gives the candidate, the forms it takes in the corpus, its
grammatical pattern, its frequency and its scores.
Figure 15. The top of TermoStat's ranked list for a French corpus about dressage: the candidates sorted by specificity, with their forms, pattern, frequency and scores, and the validation column on the left.
The first score, Spec, ranks the list (Drouin et al., 2020). The other
columns measure the same comparison in other ways, as the table below sets
out.
Column
What it measures
Spec
specificity: how far the candidate’s frequency in the corpus departs from the frequency the reference corpus predicts
Chi² and LL
two statistical tests of that difference, the chi-square and the log-likelihood; the guide calls the second more reliable for infrequent candidates
LogOdd
how many times more likely the candidate is in the corpus than in the reference corpus, on a logarithmic scale
Weird.
the candidate’s relative frequency in the corpus divided by its relative frequency in the reference corpus
Disp.
how evenly the candidate is spread over the corpus
Spec β
Spec multiplied by Disp., so that a candidate frequent in one document only moves down the list
The score columns of TermoStat's list, after its user guide (version 4.0 beta).
Term bank badges
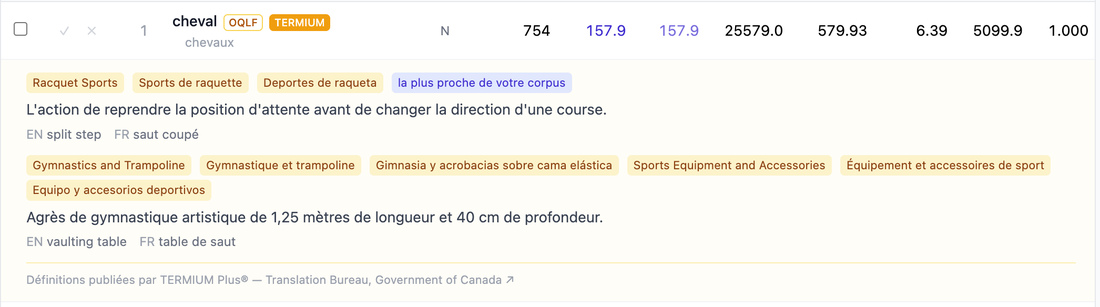
In TermoStat’s list of results, a badge beside a candidate names a term bank that publishes a definition for
it, and opening it shows the bank’s definitions with their subject fields
(Figure 16figure 16).
When a bank has several records, the tool orders them by how well they fit
the corpus. Its own guide calls that order a hint and not a verdict, right
about two times in three: for cheval, the records shown are a
racquet-sports move and a gymnastics apparatus.
Figure 16. The term bank records TermoStat found for one candidate: neither of them is the dressage sense.
Validating and exporting
In the first column of TermoStat’s list of results, every candidate can be
accepted or rejected, which is the validation step done inside the tool. The sentences a
candidate occurs in are the quickest check on a doubtful one (Figure 17figure 17):
they show whether the word always names a concept of the domain, or also
turns up in its everyday sense. Other tabs give its collocates, the
grammatical patterns of all the candidates, and a word cloud.
Figure 17. The occurrences of one candidate in context, the view a concordancer gives.
The list can be downloaded in two formats, which keep different parts of the
result. The spreadsheet (TSV) has every column of the list, one candidate per
row, and is the file to work from when you want to sort, filter or count; the
first twenty rows are below.
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Drouin, P., Morel, J.-B., & L'Homme, M.-C. (2020). Automatic Term Extraction from Newspaper Corpora: Making the Most of Specificity and Common Features. In B. Daille, K. Kageura & A. Rigouts Terryn (Eds.), Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020) (pp. 1–7). European Language Resources Association. https://aclanthology.org/2020.computerm-1.1/
Lancer TermoStat demande trois réglagesTermoStat, Guide de l’utilisateur, version 4.0 bêta, consulté le
30 septembre 2026 ; le guide se trouve dans le menu Aide de l’outil, après connexion. (Figure 14figure 14) :
les parties du discours à extraire, parmi les noms, les syntagmes nominaux, les adjectifs,
les verbes et les adverbes.
Figure 14. Les réglages de TermoStat pour un corpus : la langue et les parties du discours à extraire.
La liste classée et ses scores
TermoStat renvoie une liste de candidats classés par spécificité (Figure 15figure 15).
Chaque ligne donne le candidat, les formes qu’il prend dans le corpus, son
patron grammatical, sa fréquence et ses scores.
Figure 15. Le début de la liste classée de TermoStat pour un corpus français sur le dressage : les candidats triés par spécificité, avec leurs formes, leur patron, leur fréquence et leurs scores, et la colonne de validation à gauche.
Le premier score, Spec, classe la liste (Drouin et al., 2020). Les autres
colonnes mesurent la même comparaison d’autres façons, comme le présente le tableau
ci-dessous.
Colonne
Ce qu’elle mesure
Spec
la spécificité : l’écart entre la fréquence du candidat dans le corpus et la fréquence que prédit le corpus de référence
Chi² et LL
deux tests statistiques de cette différence, le chi-deux et le rapport de vraisemblance ; le guide juge le second plus fiable pour les candidats peu fréquents
LogOdd
combien de fois le candidat est plus probable dans le corpus que dans le corpus de référence, sur une échelle logarithmique
Weird.
la fréquence relative du candidat dans le corpus divisée par sa fréquence relative dans le corpus de référence
Disp.
la régularité de la répartition du candidat dans le corpus
Spec β
Spec multiplié par Disp., de sorte qu’un candidat fréquent dans un seul document descend dans la liste
Les colonnes de scores de la liste de TermoStat, d'après son guide de l'utilisateur (version 4.0 bêta).
Les badges de banques terminologiques
Dans la liste de résultats de TermoStat, un badge à côté d’un candidat nomme une banque terminologique qui en publie une
définition, et l’ouvrir affiche les définitions de la banque avec leurs domaines
(Figure 16figure 16).
Quand une banque a plusieurs fiches, l’outil les ordonne selon leur proximité avec
le corpus. Son propre guide présente cet ordre comme un indice et non comme un verdict, juste
environ deux fois sur trois : pour cheval, les fiches affichées concernent un
déplacement des sports de raquette et un agrès de gymnastique.
Figure 16. Les fiches de banques terminologiques que TermoStat a trouvées pour un candidat : aucune des deux ne correspond au sens du dressage.
La validation et l’exportation
Dans la première colonne de la liste de résultats de TermoStat, chaque candidat peut être
accepté ou rejeté : c’est l’étape de validation, faite dans l’outil même. Les phrases où un
candidat apparaît sont le moyen le plus rapide de vérifier un cas douteux (Figure 17figure 17) :
elles montrent si le mot désigne toujours un concept du domaine, ou s’il
apparaît aussi dans son sens courant. D’autres onglets donnent ses cooccurrents, les
patrons grammaticaux de tous les candidats et un nuage de mots.
Figure 17. Les occurrences d'un candidat en contexte, la vue que donne un concordancier.
La liste se télécharge dans deux formats, qui ne conservent pas les mêmes parties du
résultat. Le tableur (TSV) contient toutes les colonnes de la liste, un candidat par
ligne, et c’est le fichier à utiliser pour trier, filtrer ou compter ; les
vingt premières lignes figurent ci-dessous.
Drouin, P. (2003). Term extraction using non-technical corpora as a point of leverage. Terminology, 9(1), 99–115. https://doi.org/10.1075/term.9.1.06dro
Drouin, P., Morel, J.-B., & L'Homme, M.-C. (2020). Automatic Term Extraction from Newspaper Corpora: Making the Most of Specificity and Common Features. In B. Daille, K. Kageura & A. Rigouts Terryn (Eds.), Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020) (pp. 1–7). European Language Resources Association. https://aclanthology.org/2020.computerm-1.1/
Machine-learning methods for term extractionMéthodes d'extraction de termes par apprentissage automatique
Four candidates as rows of features, with the label from the annotation. The values are illustrative.
Classifying candidates: HAMLET
HAMLET, a tool I developed with Véronique Hoste and Els Lefever, follows the
steps of the hybrid method but learns them from examples. The grammatical
patterns come from the annotated texts instead of a hand-written list, and a
classifier labels each candidate as a term or not, from many features
(Rigouts Terryn et al., 2021).
On the same Dutch texts about dressage, HAMLET proposed far fewer candidates
than TermoStat, and a much larger share of them were terms, while
TermoStat’s longer list contained somewhat more of the terms people had
marked. HAMLET also found more of the terms that occurred only once, which a
single frequency-based measure tends to miss (Rigouts Terryn et al., 2019).
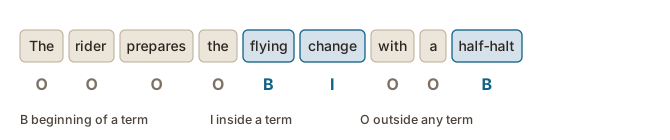
Sequence labelling is a second kind of supervised model for term extraction,
and it does not start from a list of candidates. It reads the text word by
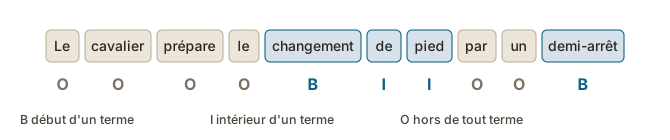
word and gives each word a label, as Figure 18figure 18
shows: B for the first word of a term, I for a word inside a term, and
O for a word outside any term (Rigouts Terryn et al., 2022b). This is
called sequence labelling, and the same technique is used to find names in
texts (see also the A tour of NLP tasks chapter) (voir aussi le chapitre Tour d'horizon des tâches du TAL).
Figure 18. Sequence labelling: each word is labelled as the beginning of a term (B), inside a term (I) or outside (O).
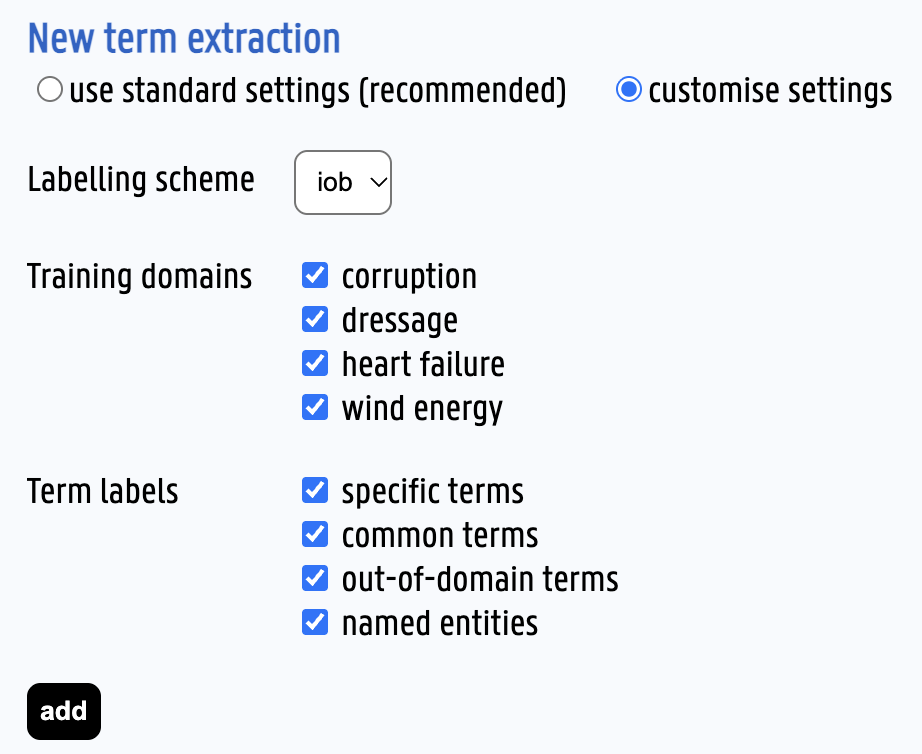
The demo’s settings name the notions of this chapter (Figure 19figure 19): the labelling scheme, the domains of the annotated texts
the model was trained on, and the kinds of term to
return (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes).
Figure 19. The settings of the D-Terminer demo: the labelling scheme, the training domains and the term labels (1 October 2026). The interface changes.
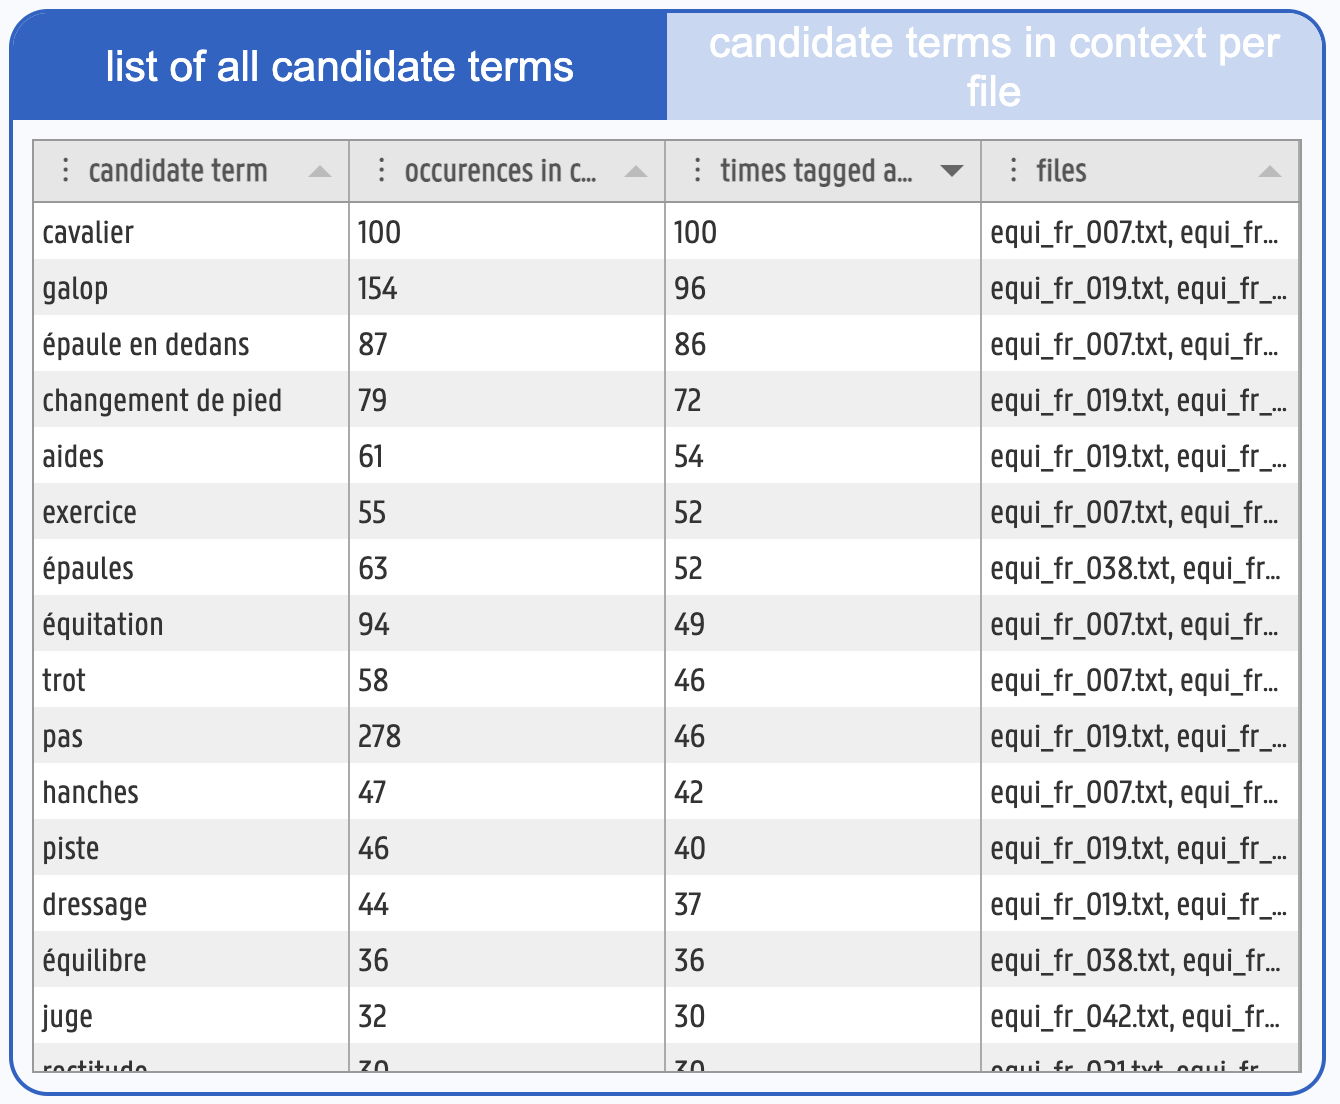
Its two views of a result are the two forms of output: a list, and the terms
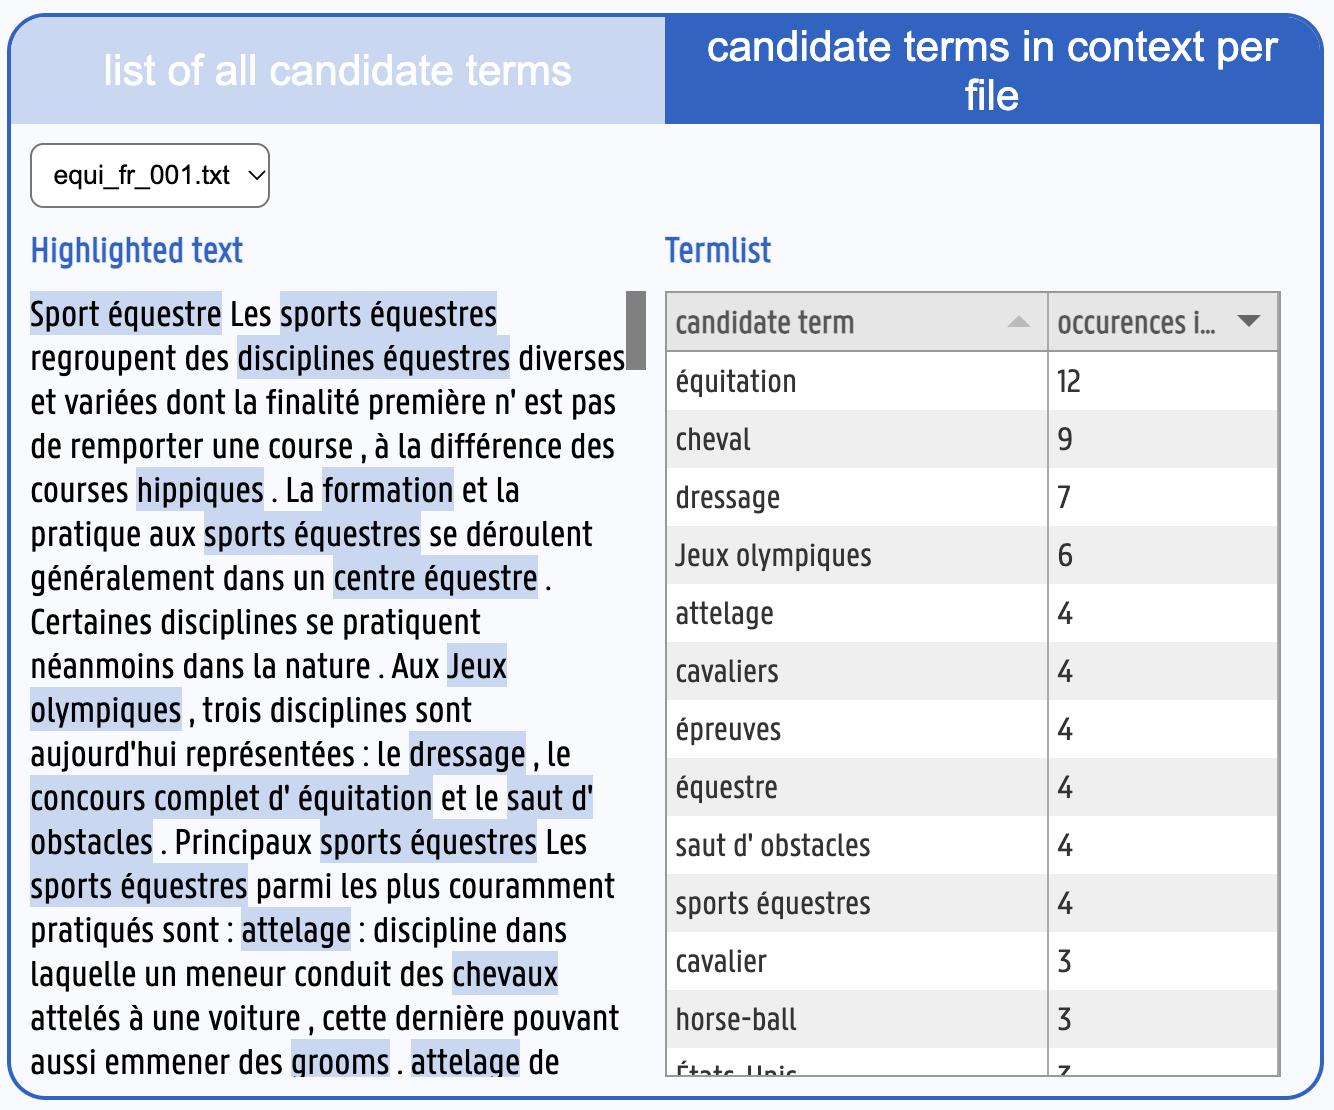
marked in the text. In the list (Figure 20figure 20), one column counts how often a candidate occurs in the corpus and another
how often it was marked as a term. The two differ, because the model labels
each occurrence separately: pas occurs 278 times in these French texts and is
marked 46 times, since pas is the walk, a gait of the horse, and also the
French word for “not”. The context view
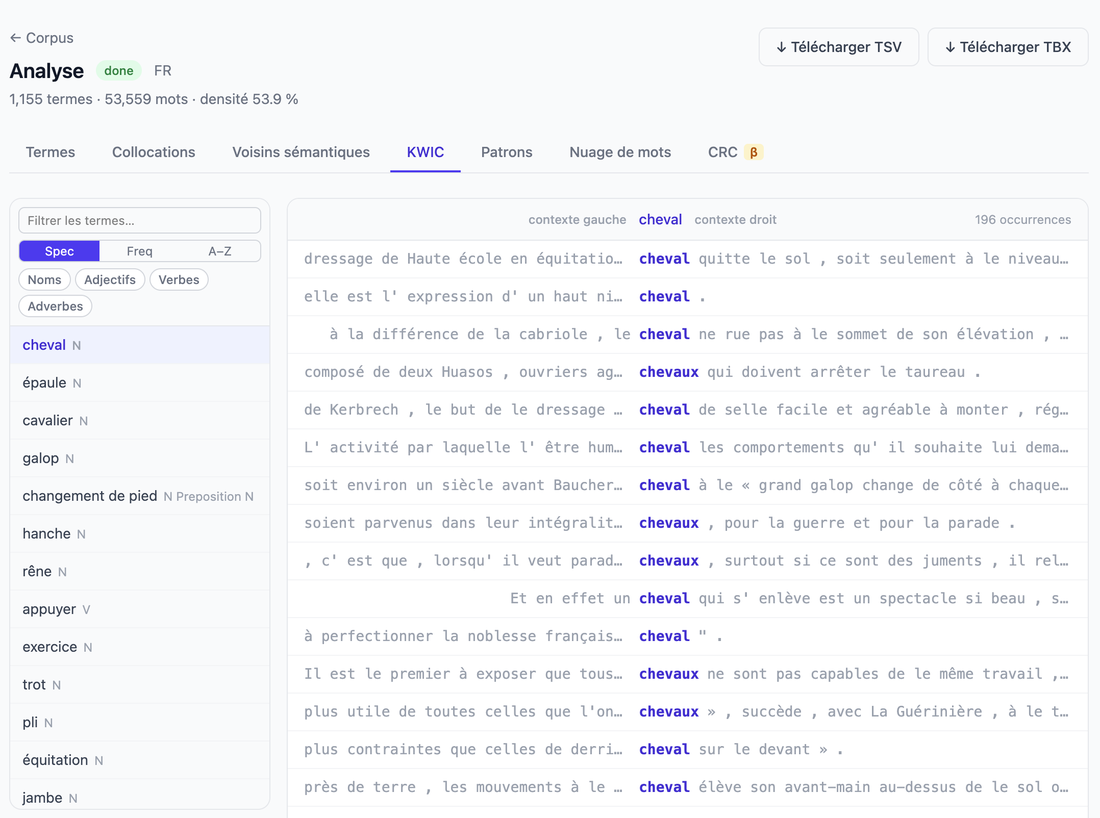
(Figure 21figure 21) shows the same candidates where they occur in one text.
Figure 20. The list view of the D-Terminer demo on French texts about dressage: each candidate once, with its occurrences in the corpus and the number of times it was marked as a term (1 October 2026). Figure 21. The context view of the D-Terminer demo: the candidates marked where they occur in one text, with the list for that text beside it (1 October 2026).
Comparing the two approaches
A model that classifies candidates and a model that labels sequences differ
in what they decide on and in what they can return, as the table below sets out (Rigouts Terryn et al., 2021, 2022a,
2022b).
Classifying candidates
Sequence labelling
What it labels
each candidate of a list, once
each word, in the sentence where it occurs
Output
a list of terms
terms marked in the text
The same word in two sentences
one decision for both
can be a term in one and not in the other
A shorter term inside a longer one
both can be kept
only the longest: one line of B, I and O labels cannot mark both
Amount of text
a corpus, since several features are frequencies
a single sentence is enough
A classifier of candidates and a sequence labeller, compared.
The language. Scores were lower in French than in Dutch. A likely
reason is compounding: a Dutch term is often one compound word where French
and English need several words, and terms of several words are harder to
extract (Rigouts Terryn, 2026; Rigouts Terryn et al., 2022b).
The amount of data. More annotated examples help (Rigouts Terryn et
al., 2021), and a model that sorts a list also needs enough text to
extract from, since several of its features are frequencies.
The kind of term. Terms of several words, and terms that are also
everyday words, are found less often than the others (Rigouts Terryn et
al., 2022b).
The method. The behaviour of a model that learned from examples is
less predictable than a set of rules (Rigouts Terryn et al., 2021).
Sources
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2021). HAMLET: Hybrid Adaptable Machine Learning approach to Extract Terminology. Terminology, 27(2), 254–293. https://doi.org/10.1075/term.20017.rig
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Rigouts Terryn, A., Hoste, V., Drouin, P., & Lefever, E. (2020b). TermEval 2020: Shared Task on Automatic Term Extraction Using the Annotated Corpora for Term Extraction Research (ACTER) Dataset. Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020), 85–94. https://aclanthology.org/2020.computerm-1.12/
Combien de fois plus fréquent que dans les textes généraux
Partie d’un candidat plus long
Terme ?
galop rassemblé
2
nom + adjectif
12
180
oui
oui
piaffer
1
nom
9
1 500
non
oui
dernier coin
2
adjectif + nom
1
2
non
non
bon cheval
2
adjectif + nom
3
4
non
non
Quatre candidats sous forme de lignes d'attributs, avec l'étiquette issue de l'annotation. Les valeurs sont données à titre d'illustration.
Classer des candidats : HAMLET
HAMLET, un outil que j’ai conçu avec Véronique Hoste et Els Lefever, suit les
étapes de la méthode hybride, mais les apprend à partir d’exemples. Les patrons
grammaticaux viennent des textes annotés, et non d’une liste écrite à la main, et un
classifieur étiquette chaque candidat comme terme ou non, à partir de nombreux attributs
(Rigouts Terryn et al., 2021).
Sur les mêmes textes néerlandais sur le dressage, HAMLET a proposé beaucoup moins de candidats
que TermoStat, et une part bien plus grande de ces candidats étaient des termes, alors que
la liste plus longue de TermoStat contenait un peu plus des termes que des personnes avaient
annotés. HAMLET a aussi trouvé davantage de termes qui n’apparaissaient qu’une fois, qu’une
seule mesure fondée sur la fréquence tend à manquer (Rigouts Terryn et al., 2019).
L’étiquetage de séquences est un second type de modèle supervisé pour l’extraction de termes,
et il ne part pas d’une liste de candidats. Il lit le texte mot par
mot et donne une étiquette à chaque mot, comme le montre la Figure 18figure 18 :
B pour le premier mot d’un terme, I pour un mot à l’intérieur d’un terme, et
O pour un mot en dehors de tout terme (Rigouts Terryn et al., 2022b). Cette méthode
s’appelle l’étiquetage de séquences, et la même technique sert à repérer les noms propres dans
les textes (see also the A tour of NLP tasks chapter) (voir aussi le chapitre Tour d'horizon des tâches du TAL).
Figure 18. L'étiquetage de séquences : chaque mot est étiqueté comme le début d'un terme (B), l'intérieur d'un terme (I) ou l'extérieur (O).
Les réglages de la démonstration nomment les notions de ce chapitre (Figure 19figure 19) : le schéma d’étiquetage, les domaines des textes annotés
sur lesquels le modèle a été entraîné, et les types de termes à
renvoyer (see also the Where people disagree about terms page) (voir aussi la page Les points de désaccord sur les termes).
Figure 19. Les réglages de la démonstration D-Terminer : le schéma d'étiquetage, les domaines d'entraînement et les étiquettes de termes (1er octobre 2026). L'interface change.
Ses deux vues d’un résultat sont les deux formes de résultat : une liste, et les termes
marqués dans le texte. Dans la liste (Figure 20figure 20), une colonne compte les occurrences d’un candidat dans le corpus et une autre
le nombre de fois où il a été marqué comme terme. Les deux diffèrent, parce que le modèle étiquette
chaque occurrence séparément : pas apparaît 278 fois dans ces textes français et n’est
marqué que 46 fois, puisque pas est à la fois une allure du cheval et
l’adverbe de négation. La vue en contexte
(Figure 21figure 21) montre les mêmes candidats là où ils apparaissent dans un texte.
Figure 20. La vue en liste de la démonstration D-Terminer sur des textes français sur le dressage : chaque candidat une fois, avec ses occurrences dans le corpus et le nombre de fois où il a été marqué comme terme (1er octobre 2026). Figure 21. La vue en contexte de la démonstration D-Terminer : les candidats marqués là où ils apparaissent dans un texte, avec la liste pour ce texte à côté (1er octobre 2026).
Comparaison des deux approches
Un modèle qui classe des candidats et un modèle qui étiquette des séquences diffèrent
par ce qu’ils étiquettent et par ce qu’ils peuvent renvoyer, comme le présente le tableau ci-dessous (Rigouts Terryn et al., 2021, 2022a,
2022b).
Classement de candidats
Étiquetage de séquences
Ce qu’il étiquette
chaque candidat d’une liste, une fois
chaque mot, dans la phrase où il apparaît
Résultat
une liste de termes
des termes marqués dans le texte
Le même mot dans deux phrases
une seule décision pour les deux
peut être un terme dans l’une et pas dans l’autre
Un terme court à l’intérieur d’un terme long
les deux peuvent être gardés
seulement le plus long : une seule ligne d’étiquettes B, I et O ne peut pas marquer les deux
Quantité de texte
un corpus, puisque plusieurs attributs sont des fréquences
une seule phrase suffit
Un classifieur de candidats et un étiqueteur de séquences, comparés.
La langue. Les scores étaient plus faibles en français qu’en néerlandais. La composition
en est une raison probable : un terme néerlandais est souvent un seul mot composé là où le français
et l’anglais demandent plusieurs mots, et les termes de plusieurs mots sont plus difficiles à
extraire (Rigouts Terryn, 2026 ; Rigouts Terryn et al., 2022b).
La quantité de données. Plus d’exemples annotés aident (Rigouts Terryn et
al., 2021), et un modèle qui trie une liste a aussi besoin d’assez de texte
d’où extraire, puisque plusieurs de ses attributs sont des fréquences.
Le type de terme. Les termes de plusieurs mots, et les termes qui sont aussi
des mots courants, sont moins souvent trouvés que les autres (Rigouts Terryn et
al., 2022b).
La méthode. Le comportement d’un modèle qui a appris à partir d’exemples est
moins prévisible qu’un ensemble de règles (Rigouts Terryn et al., 2021).
Sources
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Rigouts Terryn, A., Drouin, P., Hoste, V., & Lefever, E. (2019). Analysing the Impact of Supervised Machine Learning on Automatic Term Extraction: HAMLET vs TermoStat. Proceedings of the International Conference on Recent Advances in Natural Language Processing (RANLP 2019), 1012–1021. https://doi.org/10.26615/978-954-452-056-4_117
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2021). HAMLET: Hybrid Adaptable Machine Learning approach to Extract Terminology. Terminology, 27(2), 254–293. https://doi.org/10.1075/term.20017.rig
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022b). Tagging Terms in Text: A Supervised Sequential Labelling Approach to Automatic Term Extraction. Terminology, 28(1), 157–189. https://doi.org/10.1075/term.21010.rig
Rigouts Terryn, A., Hoste, V., Drouin, P., & Lefever, E. (2020b). TermEval 2020: Shared Task on Automatic Term Extraction Using the Annotated Corpora for Term Extraction Research (ACTER) Dataset. Proceedings of the 6th International Workshop on Computational Terminology (CompuTerm 2020), 85–94. https://aclanthology.org/2020.computerm-1.12/
Terms in two languagesLes termes dans deux langues
Bilingual extraction from parallel texts has long worked through the
alignment of the two sides: candidates are taken from words and phrases that
the alignment links, then filtered on their frequencies (Lefever et al.,
2009; Macken et al., 2013). D-Terminer’s bilingual mode works in two steps
(Rigouts Terryn et al., 2022a):
Monolingual extraction in each language. The terms are extracted
separately from the source sentences and from the target sentences.
Alignment. The words of each pair of aligned sentences are linked, and
each source candidate gets a ranked list of target candidates that appear
in the same sentences, with a score for how reliably they correspond
(Figure 22figure 22).
Figure 22. Terms extracted in each language, then linked through the aligned sentence pair.
The demo shows the result in two views, on its own sample of French and
English texts about corruption. In the list (Figure 23figure 23), each French candidate has one or more English candidates with their
scores: entreprise has company first and business second. Some pairs
need checking, such as législation with licensing. In the context view
(Figure 24figure 24), the candidates are marked in the aligned sentences of both languages.
Figure 23. D-Terminer's bilingual results on its French and English sample: for each French candidate, the English candidates found in the same sentences, with their scores (1 October 2026). The interface changes. Figure 24. The same result in context: the candidate terms marked in each pair of aligned sentences (1 October 2026).
In an evaluation of this bilingual mode on English and Dutch texts about
corruption, the first target candidate was a correct equivalent for about
three source candidates in four (Rigouts Terryn et al., 2022a).
Causes of missing equivalents
The most common cause of a missing equivalent was the first step: the
equivalent had never been extracted in the target language (Rigouts Terryn et
al., 2022a). Languages build terms differently:
Compounds. Dutch writes many terms as one word where English writes
several, as in standaardclausules for standard clauses, so a unit
extracted in one language may not be extracted in the other.
Word order. The words of a term do not come in the same order in both
languages, as in galop rassemblé for collected canter.
Different formulations. A translator may use a noun in one language and
a verb in the other, or a paraphrase instead of a term, and then the text
offers no equivalent to extract.
Lefever, E., Macken, L., & Hoste, V. (2009). Language-independent bilingual terminology extraction from a multilingual parallel corpus. Proceedings of the 12th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2009), 496–504. https://aclanthology.org/E09-1057/
Macken, L., Lefever, E., & Hoste, V. (2013). TExSIS: Bilingual terminology extraction from parallel corpora using chunk-based alignment. Terminology, 19(1), 1–30. https://doi.org/10.1075/term.19.1.01mac
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
L’extraction bilingue à partir de textes parallèles passe depuis longtemps par
l’alignement des deux côtés : les candidats sont tirés des mots et des groupes de mots que
l’alignement relie, puis filtrés selon leurs fréquences (Lefever et al.,
2009 ; Macken et al., 2013). Le mode bilingue de D-Terminer procède en deux étapes
(Rigouts Terryn et al., 2022a) :
L’extraction monolingue dans chaque langue. Les termes sont extraits
séparément des phrases sources et des phrases cibles.
L’alignement. Les mots de chaque paire de phrases alignées sont reliés, et
chaque candidat source reçoit une liste classée de candidats cibles qui apparaissent
dans les mêmes phrases, avec un score qui indique la fiabilité de la correspondance
(Figure 22figure 22).
Figure 22. Les termes extraits dans chaque langue, puis reliés au moyen de la paire de phrases alignées.
La démonstration présente le résultat dans deux vues, sur son propre échantillon de textes français et
anglais sur la corruption. Dans la liste (Figure 23figure 23), chaque candidat français a un ou plusieurs candidats anglais avec leurs
scores : entreprise a d’abord company, puis business. Certaines paires
sont à vérifier, comme législation avec licensing. Dans la vue en contexte
(Figure 24figure 24), les candidats sont marqués dans les phrases alignées des deux langues.
Figure 23. Les résultats bilingues de D-Terminer sur son échantillon français et anglais : pour chaque candidat français, les candidats anglais trouvés dans les mêmes phrases, avec leurs scores (1er octobre 2026). L'interface change. Figure 24. Le même résultat en contexte : les candidats terminologiques marqués dans chaque paire de phrases alignées (1er octobre 2026).
Dans une évaluation de ce mode bilingue sur des textes anglais et néerlandais sur la
corruption, le premier candidat cible était un équivalent correct pour environ
trois candidats sources sur quatre (Rigouts Terryn et al., 2022a).
Les causes des équivalents manquants
La cause la plus fréquente d’un équivalent manquant était la première étape : l’équivalent
n’avait jamais été extrait dans la langue cible (Rigouts Terryn et
al., 2022a). Les langues ne construisent pas leurs termes de la même façon :
Les mots composés. Le néerlandais écrit en un seul mot beaucoup de termes que l’anglais écrit en
plusieurs, comme standaardclausules pour standard clauses, si bien qu’une unité
extraite dans une langue ne l’est pas forcément dans l’autre.
L’ordre des mots. Les mots d’un terme ne viennent pas dans le même ordre dans les deux
langues, comme dans collected canter pour galop rassemblé.
Les formulations différentes. Une traduction peut employer un nom dans une langue et
un verbe dans l’autre, ou une paraphrase à la place d’un terme, et le texte
n’offre alors aucun équivalent à extraire.
Lefever, E., Macken, L., & Hoste, V. (2009). Language-independent bilingual terminology extraction from a multilingual parallel corpus. Proceedings of the 12th Conference of the European Chapter of the Association for Computational Linguistics (EACL 2009), 496–504. https://aclanthology.org/E09-1057/
Macken, L., Lefever, E., & Hoste, V. (2013). TExSIS: Bilingual terminology extraction from parallel corpora using chunk-based alignment. Terminology, 19(1), 1–30. https://doi.org/10.1075/term.19.1.01mac
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2022a). D-Terminer: Online Demo for Monolingual and Bilingual Automatic Term Extraction. Proceedings of the Workshop on Terminology in the 21st century: many faces, many places (TERM21), 33–40. https://aclanthology.org/2022.term-1.7/
Term extraction with LLMsL'extraction de termes avec les GML
whether a shorter term inside a longer one counts;
in what form to return each candidate.
Every decision on which people disagree becomes a decision written into the
prompt, so two people who prompt differently can get different lists from
the same model.
The two screenshots below show the difference on one text about dressage.
With a bare request (Figure 25figure 25), the chatbot returns the terms that the text defines, each with a
definition. With a prompt written like guidelines (Figure 26figure 26), the answer is a plain list in the form the prompt asked for.
Figure 25. A bare request: a text about dressage and the answer of one chatbot when nothing says what a term is (Gemini 3.1 Pro, 1 October 2026). The interface changes. Figure 26. The same text with a prompt written from annotation guidelines: the list follows the definition and the form it was given (Gemini 3.6 Flash with extended thinking, 1 October 2026).
Results of LLMs
Early studies, with GPT-3.5 and Llama 2, found that prompting an LLM came
close to tools trained on annotated examples (Banerjee et al., 2024; Tran et
al., 2024). With models available in 2025, the gap closed: on the twelve
corpora of the ACTER dataset, four LLMs were competitive with tools trained
for the task, and in the range of the agreement between annotators (Rigouts
Terryn, 2026) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).GPT-5 and GPT-5-mini (snapshots of 7 August 2025),
Mistral Large (2411) and Magistral Medium (2507). Three findings
of that study:
The texts changed the results more than the model did. The domain and
the language of a text counted for more than the choice among the four
models.
A detailed prompt helped more than examples in the prompt.
The models proposed too much rather than too little, for instance
general words, several terms joined by and, and descriptive phrases.
Banerjee, S., Chakravarthi, B. R., & McCrae, J. P. (2024). Large Language Models for Few-Shot Automatic Term Extraction. In Natural Language Processing and Information Systems (NLDB 2024), Lecture Notes in Computer Science (pp. 137–150). Springer. https://doi.org/10.1007/978-3-031-70239-6_10
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Tran, H. T. H., González-Gallardo, C.-E., Delaunay, J., Doucet, A., & Pollak, S. (2024). Is Prompting What Term Extraction Needs?. In Text, Speech, and Dialogue (TSD 2024), Lecture Notes in Computer Science (pp. 17–29). Springer. https://doi.org/10.1007/978-3-031-70563-2_2
si un terme court à l’intérieur d’un terme plus long compte ;
sous quelle forme renvoyer chaque candidat.
Chaque décision sur laquelle les personnes ne s’accordent pas devient une décision écrite dans la
requête, si bien que deux personnes qui formulent leur requête différemment peuvent obtenir des listes différentes
du même modèle.
Les deux captures d’écran ci-dessous montrent la différence sur un texte anglais sur le dressage.
Avec une demande nue (Figure 25figure 25), l’agent conversationnel renvoie les termes que le texte définit, chacun avec une
définition. Avec une requête rédigée comme des consignes (Figure 26figure 26), la réponse est une simple liste, sous la forme demandée par la requête.
Figure 25. Une demande nue : un texte sur le dressage et la réponse d'un agent conversationnel quand rien ne dit ce qu'est un terme (Gemini 3.1 Pro, 1er octobre 2026). L'interface change. Figure 26. Le même texte avec une requête rédigée à partir de consignes d'annotation : la liste suit la définition et la forme qui lui ont été données (Gemini 3.6 Flash avec réflexion étendue, 1er octobre 2026).
Banerjee, S., Chakravarthi, B. R., & McCrae, J. P. (2024). Large Language Models for Few-Shot Automatic Term Extraction. In Natural Language Processing and Information Systems (NLDB 2024), Lecture Notes in Computer Science (pp. 137–150). Springer. https://doi.org/10.1007/978-3-031-70239-6_10
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Tran, H. T. H., González-Gallardo, C.-E., Delaunay, J., Doucet, A., & Pollak, S. (2024). Is Prompting What Term Extraction Needs?. In Text, Speech, and Dialogue (TSD 2024), Lecture Notes in Computer Science (pp. 17–29). Springer. https://doi.org/10.1007/978-3-031-70563-2_2
Comparing term extraction methodsComparer les méthodes d'extraction de termes
No single difference settles the choice between a dedicated tool and an LLM,
but some situations point one way:
A large corpus in one domain, to go through the same way every time,
suits a dedicated tool: its ranked list can be read from the top, and
running it again gives the same list.
A single document, a language or domain no tool was trained for, or a
list you want with labels and remarks, suits an LLM.
A language with little text on the web is a reason for caution with
either: the results of LLMs on this task were obtained on languages with many
resources
(Rigouts Terryn, 2026).
The two can also be combined: a large LLM marks the terms in many texts, and
a much smaller, openly available model is trained on those marks, which
avoids sending every new text to a provider (Senger et al., 2025).
Typical errors of each method
Each method of this chapter tends to go wrong in its own way, as the table
below sums up.
Method
Typical errors
Linguistic
Proposes every sequence with the form of a term, such as little girl, and misses terms of an unusual form, such as on the bit
Statistical
Misses rare terms and terms that are also everyday words, such as collection, and proposes words that are frequent in the texts for another reason
Hybrid
Has the limits of both, and the result depends on where the ranked list is cut off
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Senger, E., Campbell, Y., van der Goot, R., & Plank, B. (2025). Crossing Domains without Labels: Distant Supervision for Term Extraction. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1366–1378. https://aclanthology.org/2025.emnlp-industry.95/
Ce qui distingue un extracteur de termes spécialisé d'un GML.
Aucune de ces différences ne tranche à elle seule entre un outil spécialisé et un GML,
mais certaines situations orientent le choix :
Un grand corpus dans un seul domaine, à traiter chaque fois de la même façon,
convient à un outil spécialisé : sa liste classée se lit à partir du début, et
le relancer donne la même liste.
Un seul document, une langue ou un domaine pour lesquels aucun outil n’a été entraîné, ou une
liste que vous voulez avec des étiquettes et des remarques, conviennent à un GML.
Une langue peu présente sur le web est une raison d’être prudent avec
l’un comme avec l’autre : les résultats des GML pour cette tâche ont été obtenus pour des langues bien dotées en ressources
(Rigouts Terryn, 2026).
Les deux peuvent aussi se combiner : un grand GML marque les termes dans de nombreux textes, et
un modèle beaucoup plus petit, librement accessible, est entraîné sur ces marques, ce qui
évite d’envoyer chaque nouveau texte à un fournisseur (Senger et al., 2025).
Les erreurs typiques de chaque méthode
Chaque méthode de ce chapitre tend à échouer à sa manière, comme le résume le tableau
ci-dessous.
Méthode
Erreurs typiques
Linguistique
Propose toute suite qui a la forme d’un terme, comme fillette joyeuse, et manque les termes de forme inhabituelle, comme sur la main
Statistique
Manque les termes rares et les termes qui sont aussi des mots courants, comme passage, et propose des mots fréquents dans les textes pour une autre raison
Hybride
A les limites des deux, et le résultat dépend de l’endroit où la liste classée est coupée
Réussit moins bien sur des textes différents de ceux de son entraînement, sur les termes de plusieurs mots et sur les termes qui sont aussi des mots courants
GML
En proposent trop, par exemple des mots généraux et plusieurs termes joints en un seul, et renvoient parfois une forme qui ne figure pas telle quelle dans le texte
Là où chaque méthode d'extraction de termes tend à échouer.
Lefever, E., & Rigouts Terryn, A. (2024). Computational Terminology. In Y. Peng et al. (Eds.), New Advances in Translation Technology: Applications and Pedagogy (pp. 141–159). Springer Nature. https://doi.org/10.1007/978-981-97-2958-6_8
Rigouts Terryn, A. (2026). Large Language Models Are Good Term Extractors: A Systematic Evaluation. Proceedings of the Fifteenth Language Resources and Evaluation Conference (LREC 2026), 7631–7643. https://doi.org/10.63317/49gta5itne3q
Senger, E., Campbell, Y., van der Goot, R., & Plank, B. (2025). Crossing Domains without Labels: Distant Supervision for Term Extraction. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1366–1378. https://aclanthology.org/2025.emnlp-industry.95/