Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
This teaching view only exists in French.
Les limites d’une première impression
Quand vous essayez un outil langagier, par exemple un système de traduction automatique, un correcteur orthographique ou un agent conversationnel, la façon la plus évidente de le juger consiste à regarder quelques-uns de ses résultats et à décider s’ils semblent bons. Cette première impression est utile, mais c’est une base fragile pour une conclusion :
- elle dépend des quelques exemples que vous avez essayés ;
- elle dépend de votre propre expertise, de sorte qu’une autre personne peut juger les mêmes résultats autrement, et elle ne fonctionne pas pour un sujet ou une langue où votre expertise est limitée ;
- elle ne peut pas être comparée à l’impression d’une autre personne sur un autre outil, ni à votre propre impression du même outil un an plus tard.
Une évaluation est une façon plus systématique de juger un outil. L’outil fonctionne sur des données d’évaluation choisies à l’avance et sa sortie est jugée selon une méthode déclarée, de sorte que le résultat peut être vérifié, répété et comparé.
Les tâches sans réponse correcte unique
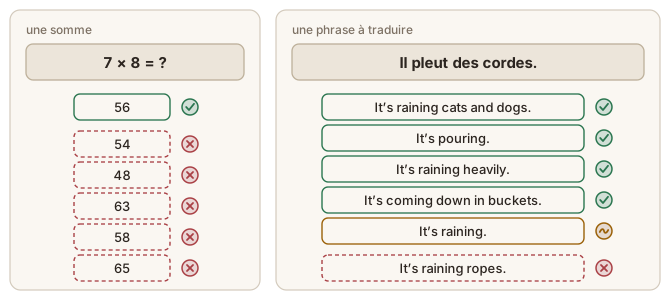
Pour les technologies langagières language technologytechnologie langagière NLPTAL The field that builds usable tools and services out of the computational processing of human language, such as machine translation systems, terminology tools, speech interfaces and writing aids. By extension, the term also names those tools themselves.Domaine consacré à la conception d'outils et de services utilisables à partir du traitement informatique de la langue humaine : systèmes de traduction automatique, outils terminologiques, interfaces vocales, aides à la rédaction. Par extension, le terme désigne aussi ces outils eux-mêmes. , une évaluation systématique est moins simple qu’il n’y paraît. Beaucoup de tâches du traitement automatique de la langue natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. (TAL) n’ont pas une réponse unique qui soit incontestablement correcte (Basile et al., 2021). Par exemple, une somme a une seule réponse correcte, mais une phrase peut être bien traduite de plusieurs façons (Figure 1figure 1), et deux spécialistes qui relèvent les termes d’un même texte produisent rarement la même liste (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique). Une évaluation doit donc établir quelles réponses sont considérées comme correctes avant de pouvoir compter quoi que ce soit.
Données d’évaluation, jugement et mesure
Une évaluation a besoin de trois éléments :
- Des données d’évaluation : les textes sur lesquels le système fonctionne, et qui n’ont pas servi à le construire (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
- Un jugement de la sortie : le plus souvent une comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. (angl. gold standard), qui indique quelle aurait dû être la sortie selon des personnes (see also the gold standard page, in the Evaluating language technology module) (voir aussi la page L'étalon de référence, dans le module L'évaluation des technologies langagières), mais des personnes peuvent aussi juger la sortie directement (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
- Une mesure : la règle qui transforme les jugements en un nombre.
Un score ne peut être interprété que lorsque les trois sont connus (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières).
Les mesures selon le type de tâche
La façon de juger la sortie, et la mesure utilisée, dépendent du type de sortie d’une tâche. Le tableau ci-dessous présente trois cas.
Pour les tâches du premier type, comme la reconnaissance d’entités nommées, l’évaluation a généralement supposé que chaque élément a une seule réponse correcte (Basile et al., 2021) (see also the Evaluating extraction and classification chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de l'extraction et de la classification, dans le module L'évaluation des technologies langagières). Les tâches qui produisent du texte, comme la traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , ne peuvent pas être évaluées à partir de cette hypothèse, parce que de nombreuses sorties différentes peuvent être correctes (see also the Evaluating machine translation chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de la traduction automatique, dans le module L'évaluation des technologies langagières). Un grand modèle de langue produit du texte quelle que soit la tâche, de sorte que son évaluation pose la même difficulté.
Les limites d’une première impression
Quand vous essayez un outil langagier, par exemple un système de traduction automatique, un correcteur orthographique ou un agent conversationnel, la façon la plus évidente de le juger consiste à regarder quelques-uns de ses résultats et à décider s’ils semblent bons. Cette première impression est utile, mais c’est une base fragile pour une conclusion :
- elle dépend des quelques exemples que vous avez essayés ;
- elle dépend de votre propre expertise, de sorte qu’une autre personne peut juger les mêmes résultats autrement, et elle ne fonctionne pas pour un sujet ou une langue où votre expertise est limitée ;
- elle ne peut pas être comparée à l’impression d’une autre personne sur un autre outil, ni à votre propre impression du même outil un an plus tard.
Une évaluation est une façon plus systématique de juger un outil. L’outil fonctionne sur des données d’évaluation choisies à l’avance et sa sortie est jugée selon une méthode déclarée, de sorte que le résultat peut être vérifié, répété et comparé.
Les tâches sans réponse correcte unique
Pour les technologies langagières language technologytechnologie langagière NLPTAL The field that builds usable tools and services out of the computational processing of human language, such as machine translation systems, terminology tools, speech interfaces and writing aids. By extension, the term also names those tools themselves.Domaine consacré à la conception d'outils et de services utilisables à partir du traitement informatique de la langue humaine : systèmes de traduction automatique, outils terminologiques, interfaces vocales, aides à la rédaction. Par extension, le terme désigne aussi ces outils eux-mêmes. , une évaluation systématique est moins simple qu’il n’y paraît. Beaucoup de tâches du traitement automatique de la langue natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. (TAL) n’ont pas une réponse unique qui soit incontestablement correcte (Basile et al., 2021). Par exemple, une somme a une seule réponse correcte, mais une phrase peut être bien traduite de plusieurs façons (Figure 1figure 1), et deux spécialistes qui relèvent les termes d’un même texte produisent rarement la même liste (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique). Une évaluation doit donc établir quelles réponses sont considérées comme correctes avant de pouvoir compter quoi que ce soit.
Données d’évaluation, jugement et mesure
Une évaluation a besoin de trois éléments :
- Des données d’évaluation : les textes sur lesquels le système fonctionne, et qui n’ont pas servi à le construire (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
- Un jugement de la sortie : le plus souvent une comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. (angl. gold standard), qui indique quelle aurait dû être la sortie selon des personnes (see also the gold standard page, in the Evaluating language technology module) (voir aussi la page L'étalon de référence, dans le module L'évaluation des technologies langagières), mais des personnes peuvent aussi juger la sortie directement (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
- Une mesure : la règle qui transforme les jugements en un nombre.
Un score ne peut être interprété que lorsque les trois sont connus (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières).
Les mesures selon le type de tâche
La façon de juger la sortie, et la mesure utilisée, dépendent du type de sortie d’une tâche. Le tableau ci-dessous présente trois cas.
Pour les tâches du premier type, comme la reconnaissance d’entités nommées, l’évaluation a généralement supposé que chaque élément a une seule réponse correcte (Basile et al., 2021) (see also the Evaluating extraction and classification chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de l'extraction et de la classification, dans le module L'évaluation des technologies langagières). Les tâches qui produisent du texte, comme la traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , ne peuvent pas être évaluées à partir de cette hypothèse, parce que de nombreuses sorties différentes peuvent être correctes (see also the Evaluating machine translation chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de la traduction automatique, dans le module L'évaluation des technologies langagières). Un grand modèle de langue produit du texte quelle que soit la tâche, de sorte que son évaluation pose la même difficulté.
Quatre façons d’évaluer
La sortie d’un système peut être évaluée de plusieurs façons. Le premier tableau ci-dessous en présente quatre, avec les types de systèmes pour lesquels chacune est habituellement utilisée. La première façon compare la sortie avec des réponses préparées à l’avance, tandis que dans les trois autres, des personnes jugent la sortie elle-même.
La Figure 2figure 2 applique les quatre façons à une même traduction automatique.
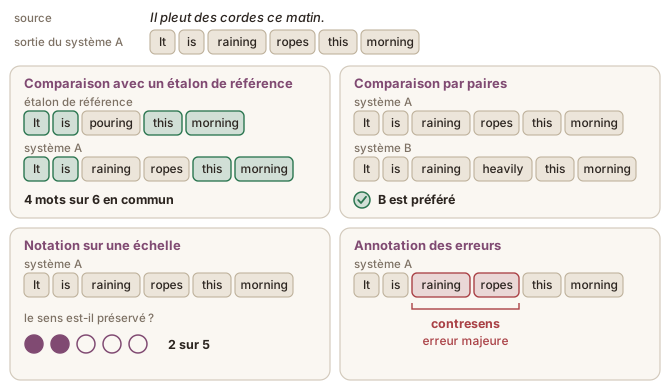
Chaque façon a ses avantages et ses coûts, que présente le deuxième tableau.
| Façon d’évaluer | Avantages | Coûts et risques |
|---|---|---|
| Comparaison avec un étalon de référence | la même évaluation peut être répétée, et réutilisée pour chaque nouveau système sans coût supplémentaire | le résultat dépend d’un seul étalon de référence, alors que d’autres réponses pourraient être correctes (Basile et al., 2021) ; un étalon de référence public peut se retrouver dans les données d’entraînement des systèmes qu’il sert à tester (Sainz et al., 2023) |
| Comparaison par paires | un jugement facile à poser, qui montre directement lequel de deux systèmes est préféré | elle dit quelle sortie est la meilleure, mais pas à quel point chacune est bonne, ni pourquoi ; chaque nouveau système demande de nouveaux jugements |
| Notation sur une échelle | un niveau de qualité pour chaque sortie, pour chaque critère | les personnes n’appliquent pas une échelle de la même façon, de sorte que les évaluateurs ont besoin de critères clairs et d’une formation (Jurafsky & Martin, 2026) |
| Annotation des erreurs | elle montre quelles erreurs un système commet et à quel endroit | lente et coûteuse, parce qu’elle demande des spécialistes (Kocmi et al., 2024a) |
La comparaison par paires est la méthode derrière les classements publics d’agents conversationnels (see also the Human preference rankings page, in the Using LLMs module) (voir aussi la page Les classements fondés sur les préférences humaines, dans le module Utiliser les GML). La notation et l’annotation des erreurs sont les principales façons d’évaluer des traductions à la main, avec des grilles comme Multidimensional Quality Metrics (MQM) et Error Span Annotation (ESA) (see also the Evaluating machine translation chapter, in the Evaluating language technology module) (voir aussi le chapitre Évaluation de la traduction automatique, dans le module L'évaluation des technologies langagières).
Les personnes et les mesures automatiques
Un jugement peut venir d’une personne ou d’une mesure automatique. Le tableau ci-dessous compare trois cas.
| Juge | Avantages | Coûts et risques |
|---|---|---|
| Des personnes | la forme d’évaluation qui inspire le plus confiance pour les systèmes qui produisent du texte (Howcroft et al., 2020) | lent et coûteux (Jurafsky & Martin, 2026) ; le résultat dépend de qui juge et de la façon dont les critères sont définis |
| Une mesure automatique qui compare la sortie à un étalon de référence | rapide et peu coûteuse, de sorte qu’elle peut être répétée pour chaque système | utile seulement dans la mesure où elle concorde avec les jugements de personnes |
| Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. comme juge (Zheng et al., 2023) | rapide et peu coûteux ; il peut juger une sortie sans étalon de référence auquel la comparer | ses jugements ont leurs propres biais, de sorte qu’ils doivent eux aussi être vérifiés par rapport à ceux de personnes |
Deux constats montrent à quel point les jugements de personnes dépendent de la façon dont ils sont recueillis :
- Qui juge. Quand des traducteurs professionnels ont annoté les erreurs dans la sortie de systèmes de traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , le classement des systèmes a été très différent de celui qu’avaient produit des travailleurs recrutés sur une plateforme de production participative (Freitag et al., 2021).
- Comment les critères sont définis. Dans vingt ans d’articles sur la génération de texte, les critères de qualité avaient des noms et des définitions très différents d’un article à l’autre, et les comptes rendus omettaient souvent de dire comment l’évaluation avait été menée, de sorte que les résultats sont difficiles à comparer (Howcroft et al., 2020).
Une mesure automatique est vérifiée en comparant ses scores aux jugements de personnes sur les mêmes sorties (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
Évaluation intrinsèque et évaluation extrinsèque
Une évaluation peut juger la sortie d’un système, ou les effets de l’utilisation du système (Jurafsky & Martin, 2026) :
- L’évaluation intrinsèque juge la sortie elle-même. Les quatre façons ci-dessus sont intrinsèques.
- L’évaluation extrinsèque mesure l’effet du système sur une tâche, par
exemple :
- pour un système de traduction, ce qu’un traducteur doit modifier dans la sortie pour qu’elle soit correcte ;
- pour un extracteur de termes, le temps que la liste de candidats fait gagner à la personne qui construit une base terminologique termbasebase terminologique terminologyterminologie A database of terminological entries organized by concept, grouping the terms of several languages with metadata such as definitions, domains and usage status.Base de données d'entrées terminologiques organisée par concept, contenant les termes de plusieurs langues et des métadonnées comme des définitions, des domaines et des marques d'usage. .
Une évaluation extrinsèque est la seule façon de savoir si un système aide à accomplir la tâche visée, mais elle est souvent très coûteuse (Jurafsky & Martin, 2026).
Choisir une façon d’évaluer
La façon d’évaluer dépend de la question et des ressources disponibles.
La question, par exemple :
- pour savoir lequel de deux agents conversationnels ou de deux systèmes de traduction les gens préfèrent, une comparaison par paires ;
- pour savoir si une traduction est assez bonne pour être utilisée, et ce qui ne va pas, une notation ou une annotation des erreurs ;
- pour comparer de nombreux systèmes, ou pour suivre un système d’une version à la suivante, une comparaison avec un étalon de référence (see also the gold standard page, in the Evaluating language technology module) (voir aussi la page L'étalon de référence, dans le module L'évaluation des technologies langagières).
Les ressources, par exemple :
- Le temps et l’argent. Les jugements de personnes coûtent plus cher qu’une mesure automatique, et il faut les payer de nouveau pour chaque nouveau système (Jurafsky & Martin, 2026).
- L’expertise. L’annotation des erreurs demande des spécialistes, qui ne sont pas disponibles pour toutes les langues (Kocmi et al., 2024a).
- Un étalon de référence existant. Lorsqu’il n’en existe aucun pour la tâche, le domaine et la langue, en créer un est le premier coût de l’évaluation.
Une évaluation combine souvent plusieurs façons, par exemple un score par rapport à un étalon de référence pour chaque système et une annotation des erreurs pour les meilleurs.
La sortie et l’étalon de référence
La façon la plus courante d’évaluer un système de TAL est de comparer sa sortie avec un étalon de référence (angl. gold standard) (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières). L’étalon de référence indique quelle aurait dû être la sortie, et il est le plus souvent constitué des réponses que des personnes ont données pour la même entrée (Jurafsky & Martin, 2026).
Par exemple, en reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , un système trouve les noms de personnes, de lieux et d’organisations dans un texte. Si un tel système renvoyait trois noms pour une phrase, vous ne pourriez dire s’il a bien fonctionné qu’en sachant quels noms des personnes trouvent dans cette phrase. La Figure 3figure 3 construit cet exemple en trois étapes.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Un étalon de référence doit être créé pour chaque tâche. Pour attribuer un score à un extracteur de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. , un outil qui dresse la liste des termes spécialisés d’un texte, il faut la liste des termes qui se trouvent dans le texte, et cette liste doit être établie à la main : une ou plusieurs personnes lisent le texte et marquent les termes, en suivant des consignes écrites.
Étalon de référence, référence et réalité de terrain
Le mot général pour les réponses auxquelles une sortie est comparée est la référence. Un étalon de référence est une référence que des personnes ont produite. Pour un système de traduction, c’est une traduction faite par une personne, appelée traduction de référence.
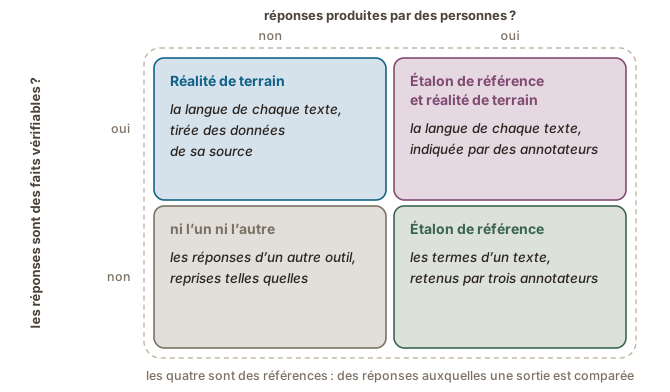
Le terme réalité de terrain (angl. ground truth) est souvent employé comme synonyme d’étalon de référence, mais les deux répondent à des questions différentes sur une référence (Figure 4figure 4) : un étalon de référence est produit par des personnes, et une réalité de terrain est constituée de faits vérifiables. Lorsque les réponses dépendent d’un jugement, les personnes peuvent être en désaccord et plusieurs réponses peuvent être correctes (Basile et al., 2021) : un étalon de référence n’est alors pas une réalité de terrain.
Les limites d’un étalon de référence
Chaque score calculé par rapport à un étalon de référence est une comparaison avec un ensemble de réponses particulier, et cet ensemble a ses propres limites :
- Il dépend des consignes. Les personnes qui l’ont établi ont suivi des consignes écrites et ont tranché les cas flous, par exemple si les noms propres comptent comme des termes, ou quelle longueur un terme peut avoir. Si elles avaient décidé autrement, le même système obtiendrait un autre score sur le même texte (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique). Pour beaucoup de tâches langagières, une partie de ces décisions relève du jugement (Basile et al., 2021).
- Il dépend des annotateurs. D’autres personnes, avec une autre expertise, marqueraient certains éléments autrement, et tout annotateur fait des erreurs (Artstein & Poesio, 2008). Comparer les annotateurs entre eux montre à quel point on peut se fier à un étalon de référence (see also the Agreement between annotators page, in the Evaluating language technology module) (voir aussi la page L'accord entre annotateurs, dans le module L'évaluation des technologies langagières).
- Il porte sur un ensemble limité de textes. Un score dit ce que donne un système sur des textes semblables à ceux de l’étalon de référence, d’un domaine, d’une langue et d’un type de document, et il en dit moins sur d’autres textes (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières).
- Il coûte cher à étendre. Un nouveau domaine ou une nouvelle langue demande un nouvel étalon de référence, annoté de nouveau à la main.
- Il peut se retrouver dans les données d’entraînement. Une fois publié, un étalon de référence peut avoir servi à entraîner les systèmes qu’il doit évaluer (Sainz et al., 2023) (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
- Il énumère un nombre limité de réponses. Pour un système qui produit du texte, comme un système de traduction ou un agent conversationnel, une sortie peut être bonne sans ressembler à aucune d’elles, et c’est l’une des raisons pour lesquelles des personnes jugent aussi de telles sorties directement (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
La sortie et l’étalon de référence
La façon la plus courante d’évaluer un système de TAL est de comparer sa sortie avec un étalon de référence (angl. gold standard) (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières). L’étalon de référence indique quelle aurait dû être la sortie, et il est le plus souvent constitué des réponses que des personnes ont données pour la même entrée (Jurafsky & Martin, 2026).
Par exemple, en reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , un système trouve les noms de personnes, de lieux et d’organisations dans un texte. Si un tel système renvoyait trois noms pour une phrase, vous ne pourriez dire s’il a bien fonctionné qu’en sachant quels noms des personnes trouvent dans cette phrase. La Figure 3figure 3 construit cet exemple en trois étapes.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Un étalon de référence doit être créé pour chaque tâche. Pour attribuer un score à un extracteur de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. , un outil qui dresse la liste des termes spécialisés d’un texte, il faut la liste des termes qui se trouvent dans le texte, et cette liste doit être établie à la main : une ou plusieurs personnes lisent le texte et marquent les termes, en suivant des consignes écrites.
Étalon de référence, référence et réalité de terrain
Le mot général pour les réponses auxquelles une sortie est comparée est la référence. Un étalon de référence est une référence que des personnes ont produite. Pour un système de traduction, c’est une traduction faite par une personne, appelée traduction de référence.
Le terme réalité de terrain (angl. ground truth) est souvent employé comme synonyme d’étalon de référence, mais les deux répondent à des questions différentes sur une référence (Figure 4figure 4) : un étalon de référence est produit par des personnes, et une réalité de terrain est constituée de faits vérifiables. Lorsque les réponses dépendent d’un jugement, les personnes peuvent être en désaccord et plusieurs réponses peuvent être correctes (Basile et al., 2021) : un étalon de référence n’est alors pas une réalité de terrain.
Les limites d’un étalon de référence
Chaque score calculé par rapport à un étalon de référence est une comparaison avec un ensemble de réponses particulier, et cet ensemble a ses propres limites :
- Il dépend des consignes. Les personnes qui l’ont établi ont suivi des consignes écrites et ont tranché les cas flous, par exemple si les noms propres comptent comme des termes, ou quelle longueur un terme peut avoir. Si elles avaient décidé autrement, le même système obtiendrait un autre score sur le même texte (see also the Where people disagree about terms page, in the Classical NLP module) (voir aussi la page Les points de désaccord sur les termes, dans le module TAL classique). Pour beaucoup de tâches langagières, une partie de ces décisions relève du jugement (Basile et al., 2021).
- Il dépend des annotateurs. D’autres personnes, avec une autre expertise, marqueraient certains éléments autrement, et tout annotateur fait des erreurs (Artstein & Poesio, 2008). Comparer les annotateurs entre eux montre à quel point on peut se fier à un étalon de référence (see also the Agreement between annotators page, in the Evaluating language technology module) (voir aussi la page L'accord entre annotateurs, dans le module L'évaluation des technologies langagières).
- Il porte sur un ensemble limité de textes. Un score dit ce que donne un système sur des textes semblables à ceux de l’étalon de référence, d’un domaine, d’une langue et d’un type de document, et il en dit moins sur d’autres textes (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières).
- Il coûte cher à étendre. Un nouveau domaine ou une nouvelle langue demande un nouvel étalon de référence, annoté de nouveau à la main.
- Il peut se retrouver dans les données d’entraînement. Une fois publié, un étalon de référence peut avoir servi à entraîner les systèmes qu’il doit évaluer (Sainz et al., 2023) (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières).
- Il énumère un nombre limité de réponses. Pour un système qui produit du texte, comme un système de traduction ou un agent conversationnel, une sortie peut être bonne sans ressembler à aucune d’elles, et c’est l’une des raisons pour lesquelles des personnes jugent aussi de telles sorties directement (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
Ce que mesure l’accord
Pour beaucoup de tâches langagières, il n’existe pas de réponse unique qui soit objectivement vraie (see also the Systematic evaluation page, in the Evaluating language technology module) (voir aussi la page L'évaluation systématique, dans le module L'évaluation des technologies langagières) : des personnes qui annotent les mêmes données séparément ne produisent donc pas le même étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. . La mesure dans laquelle elles sont d’accord s’appelle l’accord inter-annotateurs.
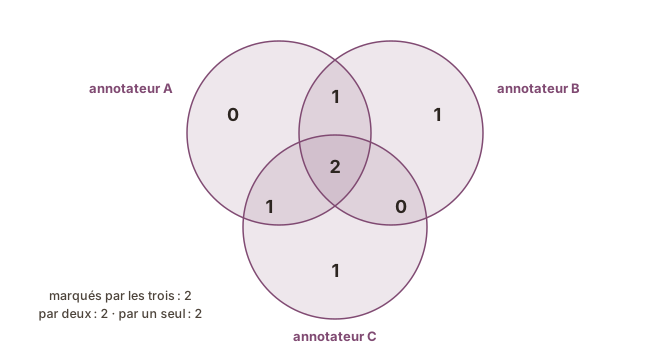
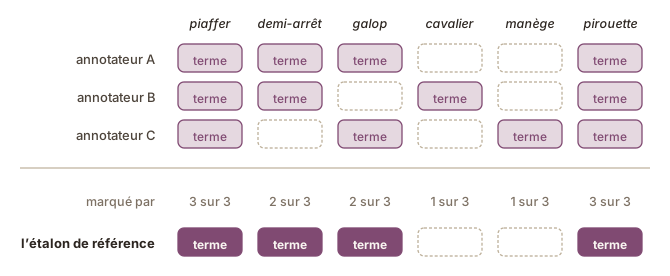
L’accord inter-annotateurs est une mesure de la fiabilité d’un étalon de référence : un accord élevé suggère que les annotateurs ont compris les consignes de la même façon (Artstein & Poesio, 2008). Dans Figure 5figure 5, trois annotateurs ont marqué six unités à eux trois, et seules deux des six ont été marquées par les trois.
L’accord se mesure aussi lorsque des personnes jugent directement la sortie d’un système (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières). Pour les traductions, par exemple, la notation sur une échelle et l’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. des erreurs donnent toutes deux, en général, un accord faible entre les personnes qui jugent (Kocmi et al., 2024a).
Les mesures de l’accord
La mesure la plus simple est la proportion d’éléments pour lesquels les annotateurs ont donné la même réponse. Une partie de tout accord est due au hasard, et certaines mesures en tiennent compte (Artstein & Poesio, 2008). Lorsque les annotateurs marquent des éléments dans un texte suivi, comme des termes, leur accord peut être mesuré avec les mêmes scores qu’un système (Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
Accord faible et accord élevé
- Un accord faible est un constat sur la tâche. Soit certains annotateurs se trompent, soit les consignes ne conviennent pas aux données (Artstein & Poesio, 2008). Pour beaucoup de tâches langagières, il existe une troisième possibilité : plusieurs réponses sont correctes (Basile et al., 2021).
- Une tâche où l’accord est faible est plus difficile à évaluer, et souvent plus difficile à automatiser. L’étalon de référence auquel un système est comparé est lui-même incertain, et lorsque les personnes ne s’entendent pas sur la réponse, un système n’a pas de réponse constante à apprendre ou à reproduire. Dans une analyse de résultats publiés en TAL biomédical, Boguslav et Cohen (2017) ont constaté que les tâches où l’accord entre annotateurs était plus élevé obtenaient aussi des scores de systèmes plus élevés.
- Un accord élevé n’est pas une preuve. La fiabilité est une condition préalable pour qu’un étalon de référence soit juste, mais deux personnes peuvent partager la même idée fausse et être entièrement d’accord (Artstein & Poesio, 2008).
Combiner plusieurs annotateurs
La plupart des évaluations comparent un système à un seul étalon de référence : les différences entre annotateurs doivent donc être tranchées. Cette étape s’appelle l’arbitrage, et elle peut se faire de plusieurs façons, par exemple :
- La discussion : les annotateurs comparent leurs résultats et tranchent chaque différence ensemble.
- Le vote majoritaire : une unité entre dans l’étalon de référence lorsque la majorité des annotateurs l’ont marquée. La Figure 6figure 6 l’applique aux trois annotateurs de Figure 5figure 5.
- La vérification par une seule personne : un seul annotateur expérimenté prend ou révise chaque décision, ce qui garde l’étalon de référence cohérent, mais en fait le point de vue d’une seule personne.
Combiner les annotations n’est pas la seule possibilité. Une évaluation peut aussi conserver les annotations de chaque personne et comparer un système à toutes, de sorte que les éléments sur lesquels les personnes sont en désaccord sont comptés eux aussi (Basile et al., 2021).
L’accord et le score d’un système
Un score par rapport à un étalon de référence ne peut pas être interprété sans l’accord entre les personnes qui l’ont établi. Lorsque deux personnes soigneuses atteignent 0,6 l’une par rapport à l’autre, un système qui atteint 0,6 par rapport à l’une d’elles fait à peu près aussi bien que le ferait une deuxième personne (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
L’accord est souvent considéré comme la limite supérieure de ce qu’un système peut atteindre, mais des systèmes obtiennent bel et bien des scores supérieurs (Boguslav & Cohen, 2017). Un score plus élevé n’est pas toujours réalisable, et il n’est pas toujours souhaitable : un score beaucoup plus élevé peut signifier que le système reproduit les choix des personnes qui ont établi l’étalon de référence.
Ce que mesure l’accord
Pour beaucoup de tâches langagières, il n’existe pas de réponse unique qui soit objectivement vraie (see also the Systematic evaluation page, in the Evaluating language technology module) (voir aussi la page L'évaluation systématique, dans le module L'évaluation des technologies langagières) : des personnes qui annotent les mêmes données séparément ne produisent donc pas le même étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. . La mesure dans laquelle elles sont d’accord s’appelle l’accord inter-annotateurs.
L’accord inter-annotateurs est une mesure de la fiabilité d’un étalon de référence : un accord élevé suggère que les annotateurs ont compris les consignes de la même façon (Artstein & Poesio, 2008). Dans Figure 5figure 5, trois annotateurs ont marqué six unités à eux trois, et seules deux des six ont été marquées par les trois.
L’accord se mesure aussi lorsque des personnes jugent directement la sortie d’un système (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières). Pour les traductions, par exemple, la notation sur une échelle et l’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. des erreurs donnent toutes deux, en général, un accord faible entre les personnes qui jugent (Kocmi et al., 2024a).
Les mesures de l’accord
La mesure la plus simple est la proportion d’éléments pour lesquels les annotateurs ont donné la même réponse. Une partie de tout accord est due au hasard, et certaines mesures en tiennent compte (Artstein & Poesio, 2008). Lorsque les annotateurs marquent des éléments dans un texte suivi, comme des termes, leur accord peut être mesuré avec les mêmes scores qu’un système (Hripcsak & Rothschild, 2005) (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
Accord faible et accord élevé
- Un accord faible est un constat sur la tâche. Soit certains annotateurs se trompent, soit les consignes ne conviennent pas aux données (Artstein & Poesio, 2008). Pour beaucoup de tâches langagières, il existe une troisième possibilité : plusieurs réponses sont correctes (Basile et al., 2021).
- Une tâche où l’accord est faible est plus difficile à évaluer, et souvent plus difficile à automatiser. L’étalon de référence auquel un système est comparé est lui-même incertain, et lorsque les personnes ne s’entendent pas sur la réponse, un système n’a pas de réponse constante à apprendre ou à reproduire. Dans une analyse de résultats publiés en TAL biomédical, Boguslav et Cohen (2017) ont constaté que les tâches où l’accord entre annotateurs était plus élevé obtenaient aussi des scores de systèmes plus élevés.
- Un accord élevé n’est pas une preuve. La fiabilité est une condition préalable pour qu’un étalon de référence soit juste, mais deux personnes peuvent partager la même idée fausse et être entièrement d’accord (Artstein & Poesio, 2008).
Combiner plusieurs annotateurs
La plupart des évaluations comparent un système à un seul étalon de référence : les différences entre annotateurs doivent donc être tranchées. Cette étape s’appelle l’arbitrage, et elle peut se faire de plusieurs façons, par exemple :
- La discussion : les annotateurs comparent leurs résultats et tranchent chaque différence ensemble.
- Le vote majoritaire : une unité entre dans l’étalon de référence lorsque la majorité des annotateurs l’ont marquée. La Figure 6figure 6 l’applique aux trois annotateurs de Figure 5figure 5.
- La vérification par une seule personne : un seul annotateur expérimenté prend ou révise chaque décision, ce qui garde l’étalon de référence cohérent, mais en fait le point de vue d’une seule personne.
Combiner les annotations n’est pas la seule possibilité. Une évaluation peut aussi conserver les annotations de chaque personne et comparer un système à toutes, de sorte que les éléments sur lesquels les personnes sont en désaccord sont comptés eux aussi (Basile et al., 2021).
L’accord et le score d’un système
Un score par rapport à un étalon de référence ne peut pas être interprété sans l’accord entre les personnes qui l’ont établi. Lorsque deux personnes soigneuses atteignent 0,6 l’une par rapport à l’autre, un système qui atteint 0,6 par rapport à l’une d’elles fait à peu près aussi bien que le ferait une deuxième personne (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières).
L’accord est souvent considéré comme la limite supérieure de ce qu’un système peut atteindre, mais des systèmes obtiennent bel et bien des scores supérieurs (Boguslav & Cohen, 2017). Un score plus élevé n’est pas toujours réalisable, et il n’est pas toujours souhaitable : un score beaucoup plus élevé peut signifier que le système reproduit les choix des personnes qui ont établi l’étalon de référence.
Étalon de référence, jeu de test et test de performances
Un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. est une partie d’une évaluation : les réponses auxquelles une sortie est comparée. Un test de performances est une évaluation complète, préparée une fois et partagée, de sorte que toutes les personnes qui testent un système pour la même tâche utilisent la même (Raji et al., 2021).
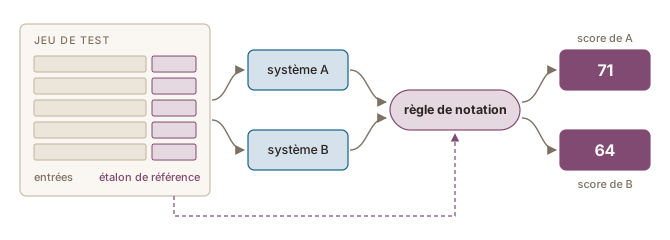
Un test de performances fixe les trois parties d’une évaluation (see also the Systematic evaluation page, in the Evaluating language technology module) (voir aussi la page L'évaluation systématique, dans le module L'évaluation des technologies langagières), comme le montrent le tableau ci-dessous et Figure 7figure 7.
| Partie d’une évaluation | Dans un test de performances |
|---|---|
| Données d’évaluation | un ensemble fixe d’entrées qui n’ont pas servi à entraîner les systèmes |
| Jugement | une réponse pour chaque entrée : le plus souvent un étalon de référence pour les réponses qui ne sont pas vérifiables ; une réalité de terrain ground truthréalité de terrain evaluationévaluation The values, labels or observations treated as the correct description of the cases in a dataset.Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. lorsqu’elles le sont |
| Mesure | une règle de notation, la même pour tous les systèmes |
Les entrées d’un test de performances, avec leurs réponses, constituent son jeu de test.
Un étalon de référence que vous créez pour votre propre projet n’est donc pas un test de performances. Il en devient une partie lorsqu’il est publié avec ses entrées et une règle de notation, et que d’autres personnes l’utilisent pour comparer leurs systèmes.
Un test réutilisable
Un test de performances peut être réutilisé : une fois qu’il existe, autant de systèmes qu’on le souhaite, y compris des systèmes publiés plus tard, peuvent y obtenir un score exactement de la même façon. Les comparaisons par paires et les notations par des personnes demandent un nouvel effort pour chaque système, et elles ne peuvent pas être répétées à l’identique (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
Utiliser le même test pour tous les systèmes ne suffit pas à rendre la comparaison équitable : un système peut avoir été entraîné sur le jeu de test, ou le jeu de test peut convenir mieux à un système qu’à un autre.
La contamination des données
Un système qui a appris à partir de son jeu de test n’a pas été testé, pas plus qu’un étudiant qui a vu le questionnaire de l’examen la veille. Pour un modèle entraîné sur du texte recueilli sur le web, un tel apprentissage est difficile à exclure. Un test de performances public est du texte sur le web, tout comme les articles qui en discutent, les corrigés et les fils de discussion.
La contamination rend un score trop élevé sans rendre le système meilleur. Comme les données d’entraînement ne sont pas divulguées, elle est difficile à mesurer de l’extérieur, et Sainz et al. (2023) soutiennent qu’elle doit être mesurée pour chaque test de performances et qu’on ne peut pas la supposer absente (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML).
La contamination peut aussi se produire à la main : coller les questions d’un test de performances dans un agent conversationnel dont les conversations servent à l’entraînement transmet le jeu de test au fournisseur. Balloccu et al. (2024) ont passé en revue des études qui évaluaient de tels produits et ont constaté qu’à elles toutes, elles avaient ainsi exposé les éléments de test de centaines de tests de performances.
Deux autres facteurs peuvent fausser une comparaison sur le même jeu de test :
- L’ajustement sur le jeu de test. Un système qui a été ajusté encore et encore jusqu’à ce que son score au jeu de test augmente a lui aussi appris à partir de ce jeu, et c’est pourquoi un jeu de développement validation setjeu de données de validation machine learningapprentissage automatique A portion of a dataset kept separate from the data used to fit a model's parameters and used during development to guide choices about the model.Portion d'un jeu de données tenue à l'écart des données servant à ajuster les paramètres d'un modèle et utilisée pendant le développement pour guider les choix concernant le modèle. distinct sert à l’ajustement (see also the From rules to machine learning chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des règles à l'apprentissage automatique, dans le module Fondements de l'IA et du TAL).
- Un jeu de test plus proche d’un système. Un jeu de test dont les textes ressemblent davantage aux données d’entraînement d’un système qu’à celles d’un autre favorise ce système.
Les limites d’un score à un test de performances
Chacune des trois parties d’un test de performances peut avoir des défauts : un score ne peut donc être interprété qu’en examinant les trois. Deux parties peuvent être excellentes, mais un défaut dans la troisième affecte tout de même tous les scores.
- Le jeu de test : est-il pertinent pour votre tâche et vos textes ? Un test de performances mesure les tâches particulières qu’il contient, et non une capacité « générale » (Raji et al., 2021). Un score élevé en culture générale ou en programmation en dit peu sur ce qu’un système fera d’un texte juridique en français (see also the LLM leaderboards chapter, in the Using LLMs module) (voir aussi le chapitre Les classements de GML, dans le module Utiliser les GML).
- L’étalon de référence : est-il fiable ? Les réponses ne sont pas plus fiables que l’accord entre les personnes qui les ont produites (see also the Agreement between annotators page, in the Evaluating language technology module) (voir aussi la page L'accord entre annotateurs, dans le module L'évaluation des technologies langagières).
- La règle de notation : que peut-elle mesurer ? Un score automatique peut augmenter sans que les sorties s’améliorent : en traduction, se fier uniquement à BLEU a mené à de mauvaises décisions sur le système à déployer (Kocmi et al., 2021) (see also the Ways of evaluating page, in the Evaluating language technology module) (voir aussi la page Les façons d'évaluer, dans le module L'évaluation des technologies langagières).
Un score comparé à une méthode simple
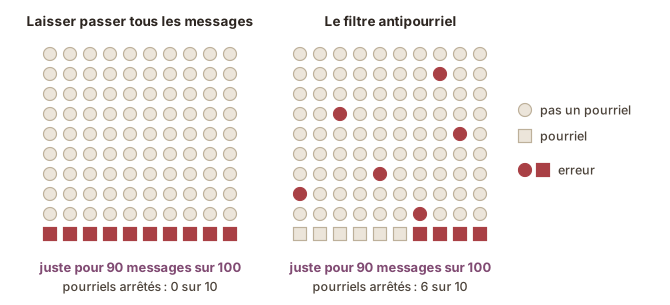
Un score ne dit pas, à lui seul, si un système est bon. Si l’on vous dit qu’un filtre antipourriel a raison pour 90 messages sur 100, il vous reste à savoir quel score une méthode très simple obtiendrait sur les mêmes messages. Si 90 des 100 messages ne sont pas des pourriels, un filtre qui laisse passer tous les messages a lui aussi raison 90 fois sur 100, et il n’a arrêté aucun pourriel (Figure 8figure 8).
Le score d’une telle méthode simple s’appelle un étalon.
Un étalon est évalué exactement comme le système, sur les mêmes données d’évaluation et, lorsqu’il y en a un, par rapport au même étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. et avec la même mesure, afin que les deux scores puissent être comparés (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières). Un système qui n’obtient pas un score nettement supérieur à son étalon n’a pas montré qu’il accomplit la tâche.
Les étalons pour la classification
Pour une tâche où un système répartit des éléments en classes (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), le tableau ci-dessous présente trois étalons simples.
| Étalon | Ce qu’il fait | Ce qu’il obtient |
|---|---|---|
| Réponse au hasard | choisit une classe au hasard pour chaque élément | avec deux classes, a raison environ une fois sur deux |
| Classe majoritaire | répond toujours la classe la plus fréquente | a raison aussi souvent que cette classe apparaît : 90 % lorsque neuf éléments sur dix lui appartiennent |
| Réponse la plus fréquente pour chaque élément | donne à chaque élément la réponse qu’il a reçue le plus souvent dans un ensemble d’exemples étiquetés ; possible seulement lorsque les mêmes éléments reviennent, comme le font les mots | dépend de la tâche, et peut être élevé : environ 92 % des mots pour l’étiquetage morphosyntaxique de l’anglais, l’exemple ci-dessous |
Un étalon peut aussi être un outil existant : on attend alors d’un nouveau système qu’il fasse mieux que celui qu’il remplace.Le troisième étalon n’est pas toujours possible : il lui faut des exemples étiquetés, et les éléments du test doivent revenir dans ces exemples, comme le font les mots dans un texte suivi. Jurafsky et Martin (2026) le donnent pour l’étiquetage morphosyntaxique. Il n’y a pas deux courriels identiques, de sorte qu’un filtre antipourriel n’a pas d’étalon de ce type.
Dans les exemples ci-dessus, les étalons ont été mesurés avec l’exactitude accuracyexactitude evaluationévaluation The share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. , la proportion d’éléments qui reçoivent la bonne réponse. Quand la classe à trouver est rare, comme les pourriels, une autre mesure, par exemple le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. , risque moins de donner un score élevé à un étalon naïf (see also the Precision, recall and F1 page, in the Evaluating language technology module) (voir aussi la page Précision, rappel et score F1, dans le module L'évaluation des technologies langagières).
L’étalon et la performance humaine
Un score s’interprète entre deux points de comparaison : l’étalon, et le niveau que des personnes atteignent pour la même tâche (see also the Agreement between annotators page, in the Evaluating language technology module) (voir aussi la page L'accord entre annotateurs, dans le module L'évaluation des technologies langagières).
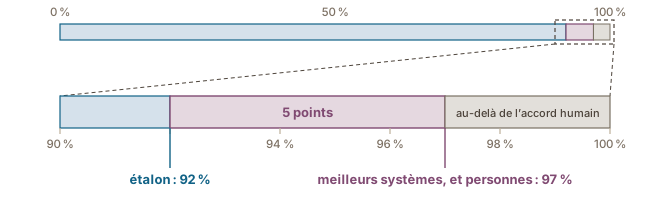
En étiquetage morphosyntaxique part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. , chaque mot d’un texte reçoit une étiquette : nom, verbe, adjectif, etc. Pour l’anglais, Jurafsky et Martin (2026) rapportent qu’un étalon qui donne à chaque mot son étiquette la plus fréquente a raison pour environ 92 % des mots, et que les meilleurs systèmes atteignent environ 97 %, ce qui est aussi à peu près le niveau que des personnes atteignent (Figure 9figure 9). Les systèmes diffèrent donc de l’étalon de cinq points, et un score de 93 % pour l’anglais est proche de l’étalon. Ces chiffres ne valent que pour l’anglais : pour une autre langue, les deux points de comparaison doivent être mesurés de nouveau.
Un score comparé à une méthode simple
Un score ne dit pas, à lui seul, si un système est bon. Si l’on vous dit qu’un filtre antipourriel a raison pour 90 messages sur 100, il vous reste à savoir quel score une méthode très simple obtiendrait sur les mêmes messages. Si 90 des 100 messages ne sont pas des pourriels, un filtre qui laisse passer tous les messages a lui aussi raison 90 fois sur 100, et il n’a arrêté aucun pourriel (Figure 8figure 8).
Le score d’une telle méthode simple s’appelle un étalon.
Un étalon est évalué exactement comme le système, sur les mêmes données d’évaluation et, lorsqu’il y en a un, par rapport au même étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. et avec la même mesure, afin que les deux scores puissent être comparés (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières). Un système qui n’obtient pas un score nettement supérieur à son étalon n’a pas montré qu’il accomplit la tâche.
Les étalons pour la classification
Pour une tâche où un système répartit des éléments en classes (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), le tableau ci-dessous présente trois étalons simples.
| Étalon | Ce qu’il fait | Ce qu’il obtient |
|---|---|---|
| Réponse au hasard | choisit une classe au hasard pour chaque élément | avec deux classes, a raison environ une fois sur deux |
| Classe majoritaire | répond toujours la classe la plus fréquente | a raison aussi souvent que cette classe apparaît : 90 % lorsque neuf éléments sur dix lui appartiennent |
| Réponse la plus fréquente pour chaque élément | donne à chaque élément la réponse qu’il a reçue le plus souvent dans un ensemble d’exemples étiquetés ; possible seulement lorsque les mêmes éléments reviennent, comme le font les mots | dépend de la tâche, et peut être élevé : environ 92 % des mots pour l’étiquetage morphosyntaxique de l’anglais, l’exemple ci-dessous |
Un étalon peut aussi être un outil existant : on attend alors d’un nouveau système qu’il fasse mieux que celui qu’il remplace.Le troisième étalon n’est pas toujours possible : il lui faut des exemples étiquetés, et les éléments du test doivent revenir dans ces exemples, comme le font les mots dans un texte suivi. Jurafsky et Martin (2026) le donnent pour l’étiquetage morphosyntaxique. Il n’y a pas deux courriels identiques, de sorte qu’un filtre antipourriel n’a pas d’étalon de ce type.
Dans les exemples ci-dessus, les étalons ont été mesurés avec l’exactitude accuracyexactitude evaluationévaluation The share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. , la proportion d’éléments qui reçoivent la bonne réponse. Quand la classe à trouver est rare, comme les pourriels, une autre mesure, par exemple le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. , risque moins de donner un score élevé à un étalon naïf (see also the Precision, recall and F1 page, in the Evaluating language technology module) (voir aussi la page Précision, rappel et score F1, dans le module L'évaluation des technologies langagières).
L’étalon et la performance humaine
Un score s’interprète entre deux points de comparaison : l’étalon, et le niveau que des personnes atteignent pour la même tâche (see also the Agreement between annotators page, in the Evaluating language technology module) (voir aussi la page L'accord entre annotateurs, dans le module L'évaluation des technologies langagières).
En étiquetage morphosyntaxique part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. , chaque mot d’un texte reçoit une étiquette : nom, verbe, adjectif, etc. Pour l’anglais, Jurafsky et Martin (2026) rapportent qu’un étalon qui donne à chaque mot son étiquette la plus fréquente a raison pour environ 92 % des mots, et que les meilleurs systèmes atteignent environ 97 %, ce qui est aussi à peu près le niveau que des personnes atteignent (Figure 9figure 9). Les systèmes diffèrent donc de l’étalon de cinq points, et un score de 93 % pour l’anglais est proche de l’étalon. Ces chiffres ne valent que pour l’anglais : pour une autre langue, les deux points de comparaison doivent être mesurés de nouveau.
This teaching view only exists in French.
Extraction et classification
Ce chapitre porte sur deux types de système (Figure 1figure 1) :
- les systèmes qui repèrent des éléments dans un texte, comme un extracteur de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. ou un système de reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. ;
- les systèmes qui classent des éléments (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), comme un filtre antipourriel, ou un système qui étiquette une critique comme positive ou négative.
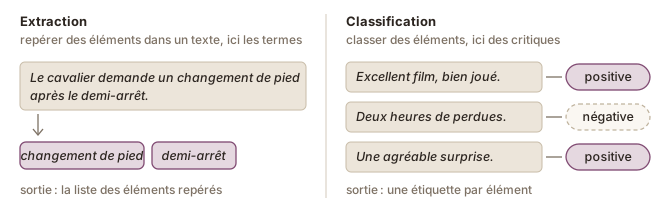
De tels systèmes sont le plus souvent évalués en comparant leur sortie à un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , les réponses que des personnes ont données pour les mêmes données (see also the gold standard page, in the Evaluating language technology module) (voir aussi la page L'étalon de référence, dans le module L'évaluation des technologies langagières). Plusieurs mesures permettent de transformer cette comparaison en score. Ce chapitre se concentre sur trois mesures couramment utilisées ensemble : la précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. , le rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. et le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. .
Un exemple de chaque erreur
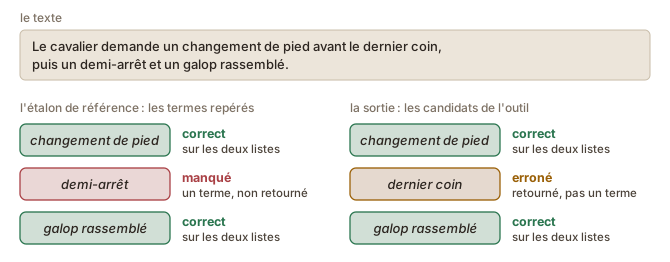
Par exemple, un extracteur de termes, un outil qui dresse la liste des termes spécialisés d’un texte, traite une phrase sur le dressage, un sport équestre (Figure 2figure 2) :
- l’outil propose une liste de trois candidats : changement de pied, dernier coin et galop rassemblé ;
- l’étalon de référence est une liste de trois termes : changement de pied, demi-arrêt et galop rassemblé.
Deux candidats figurent sur les deux listes : ils sont donc corrects. L’outil a aussi fait deux erreurs, de types différents :
- dernier coin a été proposé, mais ce n’est pas un terme ;
- demi-arrêt est un terme, mais il n’a pas été trouvé.
Les quatre cas
Quand la sortie d’un système est comparée à un étalon de référence, chaque décision correspond à l’un de quatre cas, définis dans les encadrés ci-dessous et souvent abrégés VP, FP, FN et VN.
Dans l’exemple ci-dessus, changement de pied et galop rassemblé sont des vrais positifs, dernier coin est un faux positif et demi-arrêt est un faux négatif. Les vrais négatifs sont tout le reste du texte. La Figure 3figure 3 construit les quatre cas pour un extracteur de termes.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Jurafsky et Martin (2026) présentent les mêmes quatre cas sous forme de tableau, appelé matrice de confusion, pour un système qui classe des éléments en deux classes, comme un filtre antipourriel : un message arrêté par erreur est un faux positif, et un pourriel qui arrive dans la boîte de réception est un faux négatif.
| Dans l’étalon de référence | Absent de l’étalon de référence | |
|---|---|---|
| Trouvé par le système | vrai positif | faux positif |
| Non trouvé par le système | faux négatif | vrai négatif |
Le bruit et le silence
L’ensemble des faux positifs s’appelle aussi le bruit, et l’ensemble des faux négatifs, le silence. Les deux mots peuvent se comprendre littéralement : le bruit est ce qui ne devrait pas se trouver dans la sortie, et le silence, ce qui y manque.
Les vrais négatifs
Le quatrième cas n’est pas le même pour les deux types de système (Figure 4figure 4) :
- Pour un filtre antipourriel, chaque message est un élément : les vrais négatifs, les messages qui ne sont pas des pourriels et que le filtre a laissés passer, peuvent donc être comptés.
- Pour un système qui repère des éléments dans un texte, comme un extracteur de termes, les vrais négatifs seraient chaque mot et chaque suite de mots qui n’est pas un terme et n’a pas été trouvée. Ces unités varient en longueur et se chevauchent : leur nombre n’est donc pas bien défini (Hripcsak & Rothschild, 2005).
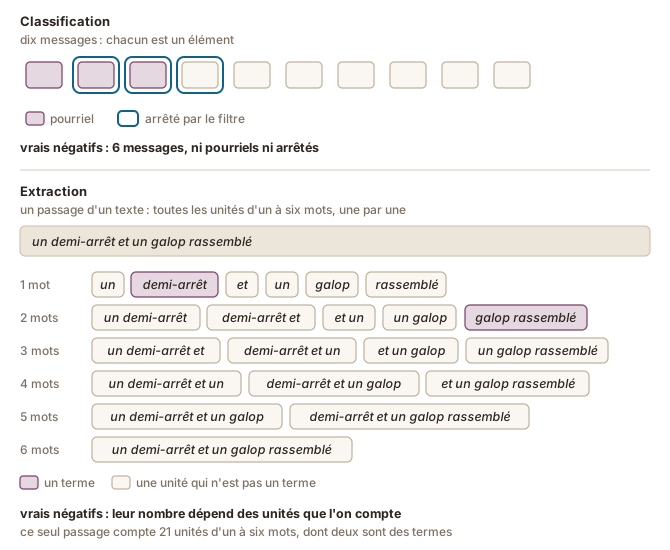
Les scores les plus utilisés pour les deux types de système, la précision et le rappel, se calculent à partir des trois autres cas seulement (Jurafsky & Martin, 2026) (see also the Precision, recall and F1 page, in the Evaluating language technology module) (voir aussi la page Précision, rappel et score F1, dans le module L'évaluation des technologies langagières).
Le compromis entre les deux erreurs
Les deux erreurs s’opposent. Un outil réglé pour proposer plus de candidats manque moins de termes, mais il propose aussi plus d’unités qui ne sont pas des termes. Un outil réglé pour proposer moins de candidats fait l’inverse.
Dans Figure 5figure 5, un outil a classé douze candidats, et la liste est coupée à trois endroits. Plus la coupure se fait bas dans la liste, moins il manque de termes, et plus il y a de bruit. Une évaluation indique donc chacune des deux erreurs, en plus d’un score qui les combine.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Extraction et classification
Ce chapitre porte sur deux types de système (Figure 1figure 1) :
- les systèmes qui repèrent des éléments dans un texte, comme un extracteur de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. ou un système de reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. ;
- les systèmes qui classent des éléments (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), comme un filtre antipourriel, ou un système qui étiquette une critique comme positive ou négative.
De tels systèmes sont le plus souvent évalués en comparant leur sortie à un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , les réponses que des personnes ont données pour les mêmes données (see also the gold standard page, in the Evaluating language technology module) (voir aussi la page L'étalon de référence, dans le module L'évaluation des technologies langagières). Plusieurs mesures permettent de transformer cette comparaison en score. Ce chapitre se concentre sur trois mesures couramment utilisées ensemble : la précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. , le rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. et le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. .
Un exemple de chaque erreur
Par exemple, un extracteur de termes, un outil qui dresse la liste des termes spécialisés d’un texte, traite une phrase sur le dressage, un sport équestre (Figure 2figure 2) :
- l’outil propose une liste de trois candidats : changement de pied, dernier coin et galop rassemblé ;
- l’étalon de référence est une liste de trois termes : changement de pied, demi-arrêt et galop rassemblé.
Deux candidats figurent sur les deux listes : ils sont donc corrects. L’outil a aussi fait deux erreurs, de types différents :
- dernier coin a été proposé, mais ce n’est pas un terme ;
- demi-arrêt est un terme, mais il n’a pas été trouvé.
Les quatre cas
Quand la sortie d’un système est comparée à un étalon de référence, chaque décision correspond à l’un de quatre cas, définis dans les encadrés ci-dessous et souvent abrégés VP, FP, FN et VN.
Dans l’exemple ci-dessus, changement de pied et galop rassemblé sont des vrais positifs, dernier coin est un faux positif et demi-arrêt est un faux négatif. Les vrais négatifs sont tout le reste du texte. La Figure 3figure 3 construit les quatre cas pour un extracteur de termes.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Jurafsky et Martin (2026) présentent les mêmes quatre cas sous forme de tableau, appelé matrice de confusion, pour un système qui classe des éléments en deux classes, comme un filtre antipourriel : un message arrêté par erreur est un faux positif, et un pourriel qui arrive dans la boîte de réception est un faux négatif.
| Dans l’étalon de référence | Absent de l’étalon de référence | |
|---|---|---|
| Trouvé par le système | vrai positif | faux positif |
| Non trouvé par le système | faux négatif | vrai négatif |
Le bruit et le silence
L’ensemble des faux positifs s’appelle aussi le bruit, et l’ensemble des faux négatifs, le silence. Les deux mots peuvent se comprendre littéralement : le bruit est ce qui ne devrait pas se trouver dans la sortie, et le silence, ce qui y manque.
Les vrais négatifs
Le quatrième cas n’est pas le même pour les deux types de système (Figure 4figure 4) :
- Pour un filtre antipourriel, chaque message est un élément : les vrais négatifs, les messages qui ne sont pas des pourriels et que le filtre a laissés passer, peuvent donc être comptés.
- Pour un système qui repère des éléments dans un texte, comme un extracteur de termes, les vrais négatifs seraient chaque mot et chaque suite de mots qui n’est pas un terme et n’a pas été trouvée. Ces unités varient en longueur et se chevauchent : leur nombre n’est donc pas bien défini (Hripcsak & Rothschild, 2005).
Les scores les plus utilisés pour les deux types de système, la précision et le rappel, se calculent à partir des trois autres cas seulement (Jurafsky & Martin, 2026) (see also the Precision, recall and F1 page, in the Evaluating language technology module) (voir aussi la page Précision, rappel et score F1, dans le module L'évaluation des technologies langagières).
Le compromis entre les deux erreurs
Les deux erreurs s’opposent. Un outil réglé pour proposer plus de candidats manque moins de termes, mais il propose aussi plus d’unités qui ne sont pas des termes. Un outil réglé pour proposer moins de candidats fait l’inverse.
Dans Figure 5figure 5, un outil a classé douze candidats, et la liste est coupée à trois endroits. Plus la coupure se fait bas dans la liste, moins il manque de termes, et plus il y a de bruit. Une évaluation indique donc chacune des deux erreurs, en plus d’un score qui les combine.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
La précision et le rappel
Pour un système qui repère des éléments dans un texte, ou qui classe des éléments en deux classes, la comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. donne deux scores (Jurafsky & Martin, 2026). La Figure 6figure 6 montre les parties à partir desquelles ils se calculent, pour un extracteur de termes.
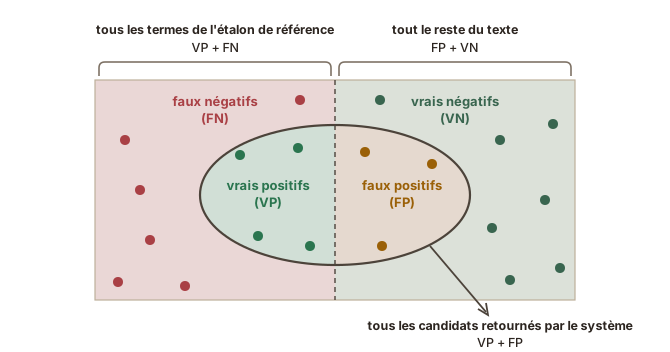
Chaque score peut s’expliquer de plusieurs façons, et l’une d’elles vous paraîtra peut-être plus claire que les autres :
- Précision
- sous forme de formule : précision = VP / (VP + FP) ;
- sous forme de part : les vrais positifs true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. divisés par tout ce que le système a trouvé, pour un extracteur de termes tous ses candidats ;
- sous forme de question : de tout ce que le système a trouvé, quelle part est correcte ?
- les faux positifs false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. , la font baisser.
- Rappel
- sous forme de formule : rappel = VP / (VP + FN) ;
- sous forme de part : les vrais positifs divisés par tout ce que contient l’étalon de référence, pour un extracteur de termes tous ses termes ;
- sous forme de question : de tout ce que contient l’étalon de référence, quelle part le système a-t-il trouvée ?
- les faux négatifs false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. , le font baisser.
Un exemple détaillé
Dans cet exemple, un extracteur de termes propose dix candidats pour un court texte sur le dressage, et l’étalon de référence de ce texte compte neuf termes (Figure 7figure 7).
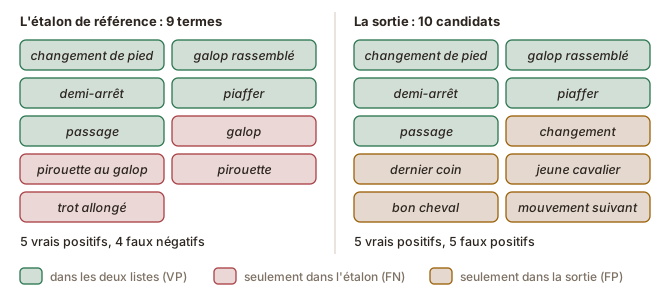
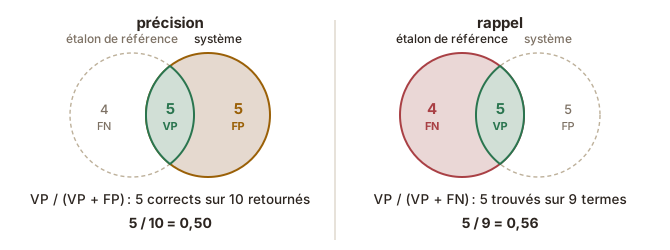
Cinq candidats figurent sur les deux listes : il y a donc 5 vrais positifs, 5 faux positifs et 4 faux négatifs (Figure 8figure 8) :
- précision = 5 / (5 + 5) = 0,50 ;
- rappel = 5 / (5 + 4) = 0,56.
Le score F1
Le score F1 combine la précision et le rappel en un seul nombre.
Il vaut deux fois leur produit, divisé par leur somme : F1 = 2 × précision × rappel / (précision + rappel), ici 2 × 0,50 × 0,56 / (0,50 + 0,56) = 0,53. Comme moyenne harmonique, il est plus proche de la plus basse des deux valeurs que ne le serait une moyenne ordinaire (Jurafsky & Martin, 2026) : un outil ne peut donc pas obtenir un bon score en ne faisant qu’une seule chose. Par exemple, si un outil proposait chaque mot et chaque suite de mots d’un texte, il aurait un rappel parfait, une précision proche de zéro et un score F1 proche de zéro (Figure 9figure 9).
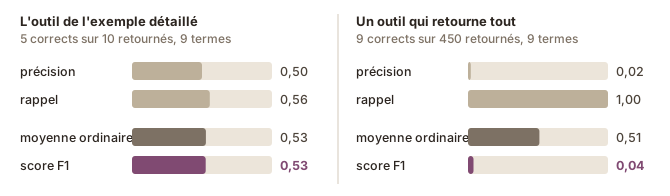
Les scores changent avec le nombre de candidats qu’un outil propose. La Figure 10figure 10 donne les trois scores après chaque candidat de la liste classée de Figure 5figure 5 : à mesure qu’on garde plus de candidats, la précision baisse et le rappel augmente, et le score F1 est le plus élevé après sept candidats.
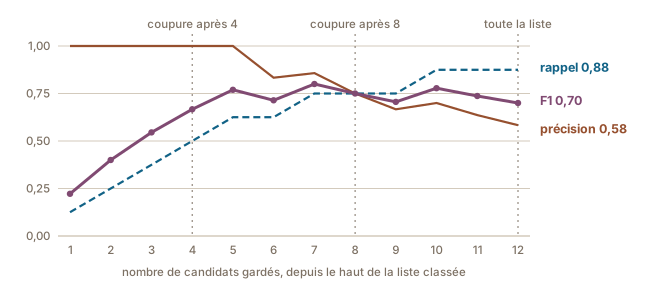
Plus de deux classes
Quand un système classe des éléments en plus de deux classes, par exemple des courriels en urgents, normaux et pourriels, la précision et le rappel se calculent pour chaque classe. On fait ensuite la moyenne des scores des classes (macromoyenne), ou on regroupe les décisions de toutes les classes avant le calcul (micromoyenne) ; dans ce cas, la classe la plus fréquente pèse le plus sur le résultat (Jurafsky & Martin, 2026).
L’exactitude
Le score le plus évident est l’exactitude.
Contrairement à la précision et au rappel, l’exactitude compte aussi les vrais négatifs true negative (TN)vrai négatif (VN) evaluationévaluation An item that the gold standard does not contain and that a system did not return, or did not assign to the class it looks for: for example, a legitimate message that a spam filter lets through.Élément que la référence ne contient pas et qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un message légitime qu'un filtre antipourriel laisse passer. : exactitude = (VP + VN) / (VP + FP + FN + VN). Autrement dit, l’exactitude est le nombre de décisions correctes, positives ou négatives, divisé par le nombre total de décisions. Elle peut se calculer pour un système qui classe des éléments, où les vrais négatifs peuvent être comptés, mais pas pour un système qui repère des éléments dans un texte (see also the False positives and false negatives page, in the Evaluating language technology module) (voir aussi la page Faux positifs et faux négatifs, dans le module L'évaluation des technologies langagières).
La Figure 11figure 11 la calcule pour un filtre antipourriel et 100 messages : 10 de ces messages sont des pourriels, et le filtre en arrête 6, ainsi que 6 messages qui ne sont pas des pourriels.
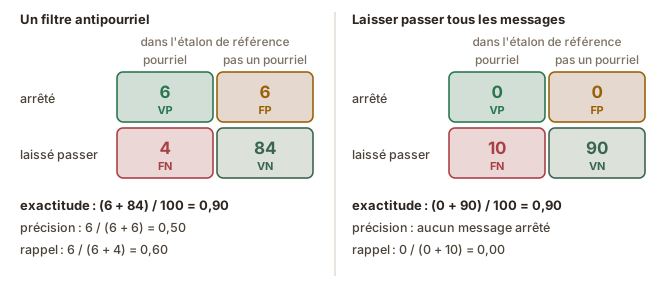
L’exactitude est trompeuse quand la classe à trouver est rare, comme le montre la deuxième matrice. Jurafsky et Martin (2026) donnent un exemple plus extrême : un million de publications sur les réseaux sociaux, dont une centaine portent sur le produit qu’une entreprise veut suivre. Un système qui étiquette chaque publication comme ne portant pas sur le produit a raison pour 99,99 % des publications, mais il n’a trouvé aucune des cent. La précision et le rappel ne comptent pas les vrais négatifs : le même système a donc un rappel de zéro (see also the Baselines page, in the Evaluating language technology module) (voir aussi la page Les étalons, dans le module L'évaluation des technologies langagières).
La précision et le rappel
Pour un système qui repère des éléments dans un texte, ou qui classe des éléments en deux classes, la comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. donne deux scores (Jurafsky & Martin, 2026). La Figure 6figure 6 montre les parties à partir desquelles ils se calculent, pour un extracteur de termes.
Chaque score peut s’expliquer de plusieurs façons, et l’une d’elles vous paraîtra peut-être plus claire que les autres :
- Précision
- sous forme de formule : précision = VP / (VP + FP) ;
- sous forme de part : les vrais positifs true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. divisés par tout ce que le système a trouvé, pour un extracteur de termes tous ses candidats ;
- sous forme de question : de tout ce que le système a trouvé, quelle part est correcte ?
- les faux positifs false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. , la font baisser.
- Rappel
- sous forme de formule : rappel = VP / (VP + FN) ;
- sous forme de part : les vrais positifs divisés par tout ce que contient l’étalon de référence, pour un extracteur de termes tous ses termes ;
- sous forme de question : de tout ce que contient l’étalon de référence, quelle part le système a-t-il trouvée ?
- les faux négatifs false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. , le font baisser.
Un exemple détaillé
Dans cet exemple, un extracteur de termes propose dix candidats pour un court texte sur le dressage, et l’étalon de référence de ce texte compte neuf termes (Figure 7figure 7).
Cinq candidats figurent sur les deux listes : il y a donc 5 vrais positifs, 5 faux positifs et 4 faux négatifs (Figure 8figure 8) :
- précision = 5 / (5 + 5) = 0,50 ;
- rappel = 5 / (5 + 4) = 0,56.
Le score F1
Le score F1 combine la précision et le rappel en un seul nombre.
Il vaut deux fois leur produit, divisé par leur somme : F1 = 2 × précision × rappel / (précision + rappel), ici 2 × 0,50 × 0,56 / (0,50 + 0,56) = 0,53. Comme moyenne harmonique, il est plus proche de la plus basse des deux valeurs que ne le serait une moyenne ordinaire (Jurafsky & Martin, 2026) : un outil ne peut donc pas obtenir un bon score en ne faisant qu’une seule chose. Par exemple, si un outil proposait chaque mot et chaque suite de mots d’un texte, il aurait un rappel parfait, une précision proche de zéro et un score F1 proche de zéro (Figure 9figure 9).
Les scores changent avec le nombre de candidats qu’un outil propose. La Figure 10figure 10 donne les trois scores après chaque candidat de la liste classée de Figure 5figure 5 : à mesure qu’on garde plus de candidats, la précision baisse et le rappel augmente, et le score F1 est le plus élevé après sept candidats.
Plus de deux classes
Quand un système classe des éléments en plus de deux classes, par exemple des courriels en urgents, normaux et pourriels, la précision et le rappel se calculent pour chaque classe. On fait ensuite la moyenne des scores des classes (macromoyenne), ou on regroupe les décisions de toutes les classes avant le calcul (micromoyenne) ; dans ce cas, la classe la plus fréquente pèse le plus sur le résultat (Jurafsky & Martin, 2026).
L’exactitude
Le score le plus évident est l’exactitude.
Contrairement à la précision et au rappel, l’exactitude compte aussi les vrais négatifs true negative (TN)vrai négatif (VN) evaluationévaluation An item that the gold standard does not contain and that a system did not return, or did not assign to the class it looks for: for example, a legitimate message that a spam filter lets through.Élément que la référence ne contient pas et qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un message légitime qu'un filtre antipourriel laisse passer. : exactitude = (VP + VN) / (VP + FP + FN + VN). Autrement dit, l’exactitude est le nombre de décisions correctes, positives ou négatives, divisé par le nombre total de décisions. Elle peut se calculer pour un système qui classe des éléments, où les vrais négatifs peuvent être comptés, mais pas pour un système qui repère des éléments dans un texte (see also the False positives and false negatives page, in the Evaluating language technology module) (voir aussi la page Faux positifs et faux négatifs, dans le module L'évaluation des technologies langagières).
La Figure 11figure 11 la calcule pour un filtre antipourriel et 100 messages : 10 de ces messages sont des pourriels, et le filtre en arrête 6, ainsi que 6 messages qui ne sont pas des pourriels.
L’exactitude est trompeuse quand la classe à trouver est rare, comme le montre la deuxième matrice. Jurafsky et Martin (2026) donnent un exemple plus extrême : un million de publications sur les réseaux sociaux, dont une centaine portent sur le produit qu’une entreprise veut suivre. Un système qui étiquette chaque publication comme ne portant pas sur le produit a raison pour 99,99 % des publications, mais il n’a trouvé aucune des cent. La précision et le rappel ne comptent pas les vrais négatifs : le même système a donc un rappel de zéro (see also the Baselines page, in the Evaluating language technology module) (voir aussi la page Les étalons, dans le module L'évaluation des technologies langagières).
Les deux listes
Les exercices ci-dessous portent sur un extracteur de termes qui propose six candidats pour un court texte sur le dressage. L’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. de ce texte compte huit termes. Le tableau ci-dessous donne les deux listes.
| Liste | Unités |
|---|---|
| Dans l’étalon de référence (8 termes) | épaule en dedans, appuyer, reculer, trot allongé, pas rassemblé, contre-galop, cession à la jambe, travers |
| Proposés par l’outil (6 candidats) | épaule en dedans, appuyer, trot allongé, contre-galop, grand côté, bon rythme |
Exercices
What is the precision of the tool? Round the answer to two decimals.
Quelle est la précision de l'outil ? Arrondissez la réponse à deux décimales.
Show the explanationVoir l'explication
Four of the six candidates are in the gold standard. Precision is the share of the candidates that are correct: 4 / 6 = 0.67.
Quatre des six candidats figurent dans la référence. La précision est la part des candidats qui sont corrects : 4 / 6 = 0,67.
What is the recall of the tool?
Quel est le rappel de l'outil ?
Show the explanationVoir l'explication
The gold standard has eight terms and the tool found four of them. Recall is the share of the terms of the gold standard that the tool found: 4 / 8 = 0.50.
La référence compte huit termes et l'outil en a trouvé quatre. Le rappel est la part des termes de la référence que l'outil a trouvés : 4 / 8 = 0,50.
What is the F1 score of the tool? Round the answer to two decimals.
Quel est le score F1 de l'outil ? Arrondissez la réponse à deux décimales.
Show the explanationVoir l'explication
The F1 score is twice the product of precision and recall, divided by their sum: 2 × 0.67 × 0.50 / (0.67 + 0.50) = 0.57. It lies between the two values, closer to the lower one.
Le score F1 vaut deux fois le produit de la précision et du rappel, divisé par leur somme : 2 × 0,67 × 0,50 / (0,67 + 0,50) = 0,57. Il se situe entre les deux valeurs, plus près de la plus basse.
A second tool returns twenty candidates for the same text, and all eight terms of the gold standard are among them. Which of the following statements is true?
Un deuxième outil propose vingt candidats pour le même texte, et les huit termes de la référence en font partie. Lequel des énoncés suivants est exact ?
Show the solutionVoir la solution
The second tool has a recall of 8 / 8 = 1.00 and a precision of 8 / 20 = 0.40. Its F1 score is therefore 2 × 0.40 × 1.00 / (0.40 + 1.00) = 0.57, the same as the first tool's.
Two tools can reach the same F1 score with opposite errors: the first misses half of the terms, and most of the second tool's candidates are not terms. That is why an evaluation reports precision and recall as well as the F1 score.
Le deuxième outil a un rappel de 8 / 8 = 1,00 et une précision de 8 / 20 = 0,40. Son score F1 est donc de 2 × 0,40 × 1,00 / (0,40 + 1,00) = 0,57, comme celui du premier outil.
Deux outils peuvent obtenir le même score F1 avec des erreurs opposées : le premier manque la moitié des termes, et la plupart des candidats du second ne sont pas des termes. C'est pourquoi une évaluation indique la précision et le rappel en plus du score F1.
Les réponses : 4 vrais positifs, 2 faux positifs, 4 faux négatifs ; précision 4 / 6 = 0,67, rappel 4 / 8 = 0,50, F1 0,57. Les exercices eux-mêmes sont sur la page, avec la vérification automatique.
Les décisions de correspondance
Les scores d’un système qui repère des éléments dans un texte dépendent de la rigueur avec laquelle une réponse doit correspondre à l’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. pour compter comme correcte (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières). Les mêmes décisions se posent pour toute tâche de ce genre. Le tableau ci-dessous les donne pour l’extraction de termes (see also the Automatic term extraction (from rules to large language models) chapter, in the Classical NLP module) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue), dans le module TAL classique) et pour la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , qui repère les noms de personnes, de lieux et d’organisations dans un texte.
| Décision | Extraction de termes | Reconnaissance d’entités nommées |
|---|---|---|
| Éléments uniques ou occurrences | chaque terme une seule fois, ou chacune de ses occurrences dans le texte | chaque nom une seule fois, ou chacune de ses mentions dans le texte |
| Correspondances partielles | si galop est faux, à moitié juste ou juste quand l’étalon de référence contient galop rassemblé | si Curie est faux, à moitié juste ou juste quand l’étalon de référence contient Marie Curie |
| Unités imbriquées | seulement les termes les plus longs, ou aussi les termes plus courts qu’ils contiennent, comme galop dans galop rassemblé | seulement les noms les plus longs, ou aussi les noms qu’ils contiennent, comme Paris dans Université de Paris |
| Forme | si les majuscules, les pluriels et les variantes orthographiques donnent la même réponse | si les majuscules et les variantes orthographiques, comme Tchaïkovski et Tchaïkovsky, donnent la même réponse |
| Étiquettes | si un terme doit aussi avoir la bonne étiquette, quand l’étalon de référence étiquette ses termes | si un nom doit aussi avoir le bon type, comme personne ou lieu |
| Seuil | toute la liste classée, ou son haut | un seuil sur la confiance du système, quand il en indique une |
Pour la classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. , la plupart de ces décisions ne se posent pas : chaque élément, comme un message, est une unité aux limites fixes, et le système lui attribue une classe. Jurafsky et Martin (2026) font remarquer que la reconnaissance d’entités nommées comporte une étape de segmentation, qui décide où chaque nom commence et finit, que la classification de textes n’a pas, et que cette étape complique son évaluation.
Dans Figure 12figure 12, par exemple, les mêmes quatre candidats obtiennent un score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. de 0,25, de 0,50 ou de 0,75, selon la décision sur la forme.
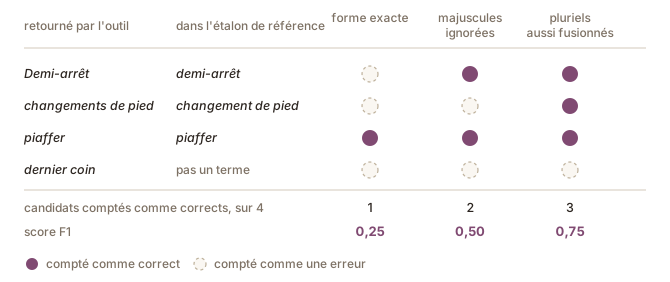
Quatre constats montrent à quel point ces décisions peuvent changer les scores :
- Correspondances partielles en reconnaissance d’entités nommées. Quand l’unité comptée est le nom, un système qui propose Jane là où l’étalon de référence contient Jane Villanueva fait deux erreurs à la fois : un faux positif false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. pour Jane et un faux négatif false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. pour Jane Villanueva (Jurafsky & Martin, 2026).
- Correspondances partielles et seuil en extraction de termes. Les scores publiés varient beaucoup selon la rigueur de l’évaluation, par exemple selon que les correspondances partielles sont acceptées ou non, et ils changent avec l’endroit où une liste classée est coupée (Rigouts Terryn et al., 2019).
- Termes uniques ou occurrences. Les scores calculés sur chaque occurrence dans le texte et les scores calculés sur une liste de termes uniques peuvent mener à des conclusions différentes, par exemple sur la langue ou le domaine où un système réussit le mieux (Rigouts Terryn et al., 2022b).
- Forme. Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. donne parfois une forme qui ne figure pas telle quelle dans le texte, comme follow-up là où le texte a follow up (Rigouts Terryn, 2026).
Les candidats entre le juste et le faux
Une comparaison stricte n’a que deux issues, correct ou non, mais beaucoup de candidats d’un extracteur de termes se situent entre les deux (Figure 13figure 13) :
- le candidat est une partie d’un terme de l’étalon de référence ;
- le candidat est un terme de l’étalon de référence auquel s’ajoute un autre mot ;
- le candidat serait un terme pour certains usages, mais pas pour d’autres.
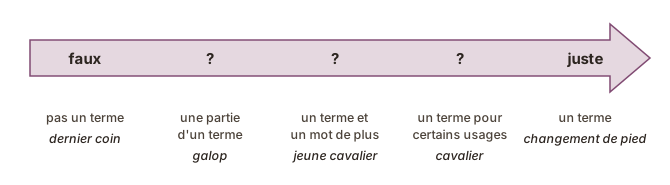
Les mêmes cas se présentent en reconnaissance d’entités nommées, par exemple Curie pour Marie Curie, ou l’Université de Paris avec un mot de trop. Une évaluation stricte les compte tous comme des erreurs. Une évaluation plus souple en accepte certains et donne des scores plus élevés : des scores obtenus avec des règles différentes ne peuvent donc pas être comparés.
Les décisions de correspondance
Les scores d’un système qui repère des éléments dans un texte dépendent de la rigueur avec laquelle une réponse doit correspondre à l’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. pour compter comme correcte (see also the Interpreting a score page, in the Evaluating language technology module) (voir aussi la page Interpréter un score, dans le module L'évaluation des technologies langagières). Les mêmes décisions se posent pour toute tâche de ce genre. Le tableau ci-dessous les donne pour l’extraction de termes (see also the Automatic term extraction (from rules to large language models) chapter, in the Classical NLP module) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue), dans le module TAL classique) et pour la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , qui repère les noms de personnes, de lieux et d’organisations dans un texte.
| Décision | Extraction de termes | Reconnaissance d’entités nommées |
|---|---|---|
| Éléments uniques ou occurrences | chaque terme une seule fois, ou chacune de ses occurrences dans le texte | chaque nom une seule fois, ou chacune de ses mentions dans le texte |
| Correspondances partielles | si galop est faux, à moitié juste ou juste quand l’étalon de référence contient galop rassemblé | si Curie est faux, à moitié juste ou juste quand l’étalon de référence contient Marie Curie |
| Unités imbriquées | seulement les termes les plus longs, ou aussi les termes plus courts qu’ils contiennent, comme galop dans galop rassemblé | seulement les noms les plus longs, ou aussi les noms qu’ils contiennent, comme Paris dans Université de Paris |
| Forme | si les majuscules, les pluriels et les variantes orthographiques donnent la même réponse | si les majuscules et les variantes orthographiques, comme Tchaïkovski et Tchaïkovsky, donnent la même réponse |
| Étiquettes | si un terme doit aussi avoir la bonne étiquette, quand l’étalon de référence étiquette ses termes | si un nom doit aussi avoir le bon type, comme personne ou lieu |
| Seuil | toute la liste classée, ou son haut | un seuil sur la confiance du système, quand il en indique une |
Pour la classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. , la plupart de ces décisions ne se posent pas : chaque élément, comme un message, est une unité aux limites fixes, et le système lui attribue une classe. Jurafsky et Martin (2026) font remarquer que la reconnaissance d’entités nommées comporte une étape de segmentation, qui décide où chaque nom commence et finit, que la classification de textes n’a pas, et que cette étape complique son évaluation.
Dans Figure 12figure 12, par exemple, les mêmes quatre candidats obtiennent un score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. de 0,25, de 0,50 ou de 0,75, selon la décision sur la forme.
Quatre constats montrent à quel point ces décisions peuvent changer les scores :
- Correspondances partielles en reconnaissance d’entités nommées. Quand l’unité comptée est le nom, un système qui propose Jane là où l’étalon de référence contient Jane Villanueva fait deux erreurs à la fois : un faux positif false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. pour Jane et un faux négatif false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. pour Jane Villanueva (Jurafsky & Martin, 2026).
- Correspondances partielles et seuil en extraction de termes. Les scores publiés varient beaucoup selon la rigueur de l’évaluation, par exemple selon que les correspondances partielles sont acceptées ou non, et ils changent avec l’endroit où une liste classée est coupée (Rigouts Terryn et al., 2019).
- Termes uniques ou occurrences. Les scores calculés sur chaque occurrence dans le texte et les scores calculés sur une liste de termes uniques peuvent mener à des conclusions différentes, par exemple sur la langue ou le domaine où un système réussit le mieux (Rigouts Terryn et al., 2022b).
- Forme. Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. donne parfois une forme qui ne figure pas telle quelle dans le texte, comme follow-up là où le texte a follow up (Rigouts Terryn, 2026).
Les candidats entre le juste et le faux
Une comparaison stricte n’a que deux issues, correct ou non, mais beaucoup de candidats d’un extracteur de termes se situent entre les deux (Figure 13figure 13) :
- le candidat est une partie d’un terme de l’étalon de référence ;
- le candidat est un terme de l’étalon de référence auquel s’ajoute un autre mot ;
- le candidat serait un terme pour certains usages, mais pas pour d’autres.
Les mêmes cas se présentent en reconnaissance d’entités nommées, par exemple Curie pour Marie Curie, ou l’Université de Paris avec un mot de trop. Une évaluation stricte les compte tous comme des erreurs. Une évaluation plus souple en accepte certains et donne des scores plus élevés : des scores obtenus avec des règles différentes ne peuvent donc pas être comparés.
Un annotateur comme étalon de référence
L’accord inter-annotateurs inter-annotator agreement (IAA)accord inter-annotateurs evaluationévaluation How far two or more people who annotate the same data independently give the same answers.Mesure dans laquelle deux personnes ou plus qui annotent les mêmes données séparément donnent les mêmes réponses. mesure à quel point des personnes qui annotent les mêmes données séparément sont d’accord, et donc à quel point un étalon de référence est fiable (see also the Agreement between annotators page, in the Evaluating language technology module) (voir aussi la page L'accord entre annotateurs, dans le module L'évaluation des technologies langagières). Il existe plusieurs mesures de cet accord. Quand deux personnes ont chacune dressé la liste des termes d’un même texte, leur accord peut se mesurer avec les scores de ce chapitre, en prenant une des listes comme étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. et en évaluant l’autre comme la sortie d’un système :
- les termes qui figurent sur les deux listes sont des vrais positifs true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. ;
- les termes qui ne figurent que sur la deuxième liste sont des faux positifs false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. ;
- les termes qui ne figurent que sur la première liste sont des faux négatifs false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. .
Dans Figure 14figure 14, la liste de l’annotateur A compte cinq termes et celle de l’annotateur B, six, et quatre termes figurent sur les deux listes. Avec A comme étalon de référence, B a une précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. de 4 / 6 et un rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. de 4 / 5. Avec B comme étalon de référence, les deux valeurs s’inversent. Le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. vaut 0,73 dans les deux cas : l’accord inter-annotateurs entre deux personnes est donc un seul nombre, quelle que soit celle qui sert d’étalon de référence. Avec trois annotateurs ou plus, on compare chaque paire à tour de rôle et on fait la moyenne des scores.
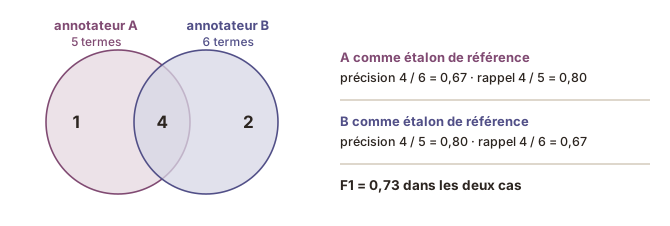
Cette mesure convient à l’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. de termes et d’autres éléments repérés dans un texte, où il n’y a pas de liste fixe d’éléments et où l’on ne peut pas compter ce que personne n’a repéré (Hripcsak & Rothschild, 2005) (see also the False positives and false negatives page, in the Evaluating language technology module) (voir aussi la page Faux positifs et faux négatifs, dans le module L'évaluation des technologies langagières).
Mesuré ainsi, l’accord inter-annotateurs est sur la même échelle que le score d’un système, et les deux peuvent être comparés directement.
This teaching view only exists in French.
De l’export au score
INCEpTION exporte un fichier par texte et par personne, avec une ligne par mot. Voici le début d’une phrase de en_02 dans l’annotation data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. d’une personne, l’annotateur A :
#FORMAT=WebAnno TSV 3.3
#T_SP=webanno.custom.Terme|Commentaire

#Text=Among the various cardiovascular diseases, heart failure (HF) is projected to have the largest increases in incidence over the coming decades; therefore, improving HF prediction is of significant value.
2-6	187-201	cardiovascular	*[8]
2-7	202-210	diseases	*[8]
2-8	210-211	,	_
2-9	212-217	heart	*[9]
2-10	218-225	failure	*[9]
2-11	226-227	(	_
2-12	227-229	HF	*
2-13	229-230	)	_
2-14	231-233	is	_
…
2-20	264-273	increases	_
2-21	274-276	in	_
2-22 277-286 incidence * Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Le calcul est le même pour les 36 paires du groupe, une fois par langue et par règle de correspondance exact matchcorrespondance exacte CAT toolsTAO A translation-memory match in which the stored source segment is identical to the segment being translated, character for character, so the tool can insert the stored translation as it is.Correspondance de mémoire de traduction dans laquelle le segment source stocké est identique, caractère pour caractère, au segment à traduire, de sorte que l'outil peut insérer la traduction stockée telle quelle. .
Le tableau
| AB | FD | GH | JD | JC | JP | LA | MI | VL | meanmoyenne | termstermes | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AB | · | 0.560,56 | 140 | ||||||||
| FD | · | 0.460,46 | 157 | ||||||||
| GH | · | 0.520,52 | 317 | ||||||||
| JD | · | 0.510,51 | 163 | ||||||||
| JC | · | 0.580,58 | 219 | ||||||||
| JP | · | 0.530,53 | 158 | ||||||||
| LA | · | 0.430,43 | 83 | ||||||||
| MI | · | 0.560,56 | 156 | ||||||||
| VL | · | 0.510,51 | 110 |
| AB | FD | GH | JD | JC | JP | LA | MI | VL | meanmoyenne | termstermes | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AB | · | 0.570,57 | 135 | ||||||||
| FD | · | 0.470,47 | 156 | ||||||||
| GH | · | 0.530,53 | 297 | ||||||||
| JD | · | 0.530,53 | 157 | ||||||||
| JC | · | 0.580,58 | 205 | ||||||||
| JP | · | 0.530,53 | 154 | ||||||||
| LA | · | 0.430,43 | 79 | ||||||||
| MI | · | 0.570,57 | 149 | ||||||||
| VL | · | 0.520,52 | 104 |
| AB | FD | GH | JD | JC | JP | LA | MI | VL | meanmoyenne | termstermes | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AB | · | 0.570,57 | 128 | ||||||||
| FD | · | 0.490,49 | 154 | ||||||||
| GH | · | 0.530,53 | 281 | ||||||||
| JD | · | 0.530,53 | 150 | ||||||||
| JC | · | 0.590,59 | 194 | ||||||||
| JP | · | 0.540,54 | 147 | ||||||||
| LA | · | 0.440,44 | 75 | ||||||||
| MI | · | 0.580,58 | 140 | ||||||||
| VL | · | 0.530,53 | 101 |
| AB | FD | GH | JD | JC | JP | LA | MI | VL | meanmoyenne | termstermes | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AB | · | 0.660,66 | 185 | ||||||||
| FD | · | 0.530,53 | 121 | ||||||||
| GH | · | 0.620,62 | 250 | ||||||||
| JD | · | 0.600,60 | 212 | ||||||||
| JC | · | 0.610,61 | 232 | ||||||||
| JP | · | 0.630,63 | 176 | ||||||||
| LA | · | 0.490,49 | 108 | ||||||||
| MI | · | 0.580,58 | 162 | ||||||||
| VL | · | 0.600,60 | 120 |
| AB | FD | GH | JD | JC | JP | LA | MI | VL | meanmoyenne | termstermes | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AB | · | 0.650,65 | 169 | ||||||||
| FD | · | 0.560,56 | 120 | ||||||||
| GH | · | 0.620,62 | 229 | ||||||||
| JD | · | 0.600,60 | 196 | ||||||||
| JC | · | 0.610,61 | 212 | ||||||||
| JP | · | 0.640,64 | 162 | ||||||||
| LA | · | 0.490,49 | 97 | ||||||||
| MI | · | 0.580,58 | 147 | ||||||||
| VL | · | 0.600,60 | 108 |
| AB | FD | GH | JD | JC | JP | LA | MI | VL | meanmoyenne | termstermes | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AB | · | 0.660,66 | 163 | ||||||||
| FD | · | 0.580,58 | 118 | ||||||||
| GH | · | 0.630,63 | 216 | ||||||||
| JD | · | 0.610,61 | 186 | ||||||||
| JC | · | 0.610,61 | 203 | ||||||||
| JP | · | 0.650,65 | 152 | ||||||||
| LA | · | 0.500,50 | 94 | ||||||||
| MI | · | 0.590,59 | 135 | ||||||||
| VL | · | 0.610,61 | 106 |
Click a cell to see the two lists of that pair.Cliquez sur une case pour voir les deux listes de cette paire.
Compare these two lists term by termComparer ces deux listes terme par terme
Scores computed on 5 October 2026 from the INCEpTION export; initials instead of names.Scores calculés le 5 octobre 2026 à partir de l'export INCEpTION ; des initiales plutôt que des noms.
Lire le tableau
- Chaque case est l’accord inter-annotator agreement (IAA)accord inter-annotateurs evaluationévaluation How far two or more people who annotate the same data independently give the same answers.Mesure dans laquelle deux personnes ou plus qui annotent les mêmes données séparément donnent les mêmes réponses. entre deux personnes, leur score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. .
- La colonne « moyenne », au bout de votre ligne, est votre accord moyen avec les huit autres personnes, pour la langue et la règle choisies au-dessus du tableau : c’est le chiffre que demande le rapport individuel (section 3.1, règle 3).
- Les couleurs vont du score le plus bas de ce tableau au plus haut ; la légende donne les deux valeurs.
- Cliquer sur une case affiche les deux listes en cercles, proportionnels à leur taille, avec la précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. et le rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. quand l’une sert de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. (see also the Agreement as an F1 score page, in the Evaluating language technology module) (voir aussi la page L'accord mesuré par le score F1, dans le module L'évaluation des technologies langagières), et un lien vers la comparaison des deux listes, terme par terme.
- Les causes de désaccord : la frontière du terme, les sigles, les mots courants au sens spécialisé, le degré de spécialisation. Vos propres cas sont sur la page de comparaison (see also the Comparing two lists, term by term page, in the Course materials module) (voir aussi la page Comparer deux listes, terme par terme, dans le module Matériel de cours).
L’accord moyen du groupe
L’accord moyen du groupe est la moyenne des 36 scores F1 du tableau, une fois par langue et par règle de correspondance.
| Rule 1: exactRègle 1 : exacte | Rule 2: formRègle 2 : forme | Rule 3: pluralRègle 3 : pluriel | |
|---|---|---|---|
| English textsTextes en anglais | |||
| Mean agreement (F1)Accord moyen (F1) | 0.520,52 | 0.530,53 | 0.530,53 |
| Terms marked by at least one personTermes marqués par au moins une personne | 434 | 407 | 389 |
| Mean size of a listTaille moyenne d'une liste | 167 | 160 | 152 |
| Shortest and longest listListe la plus courte et la plus longue | 83 and 31783 et 317 | 79 and 29779 et 297 | 75 and 28175 et 281 |
| Majority listListe majoritaire | 133 | 127 | 118 |
| French textsTextes en français | |||
| Mean agreement (F1)Accord moyen (F1) | 0.590,59 | 0.590,59 | 0.600,60 |
| Terms marked by at least one personTermes marqués par au moins une personne | 414 | 379 | 357 |
| Mean size of a listTaille moyenne d'une liste | 174 | 160 | 153 |
| Shortest and longest listListe la plus courte et la plus longue | 108 and 250108 et 250 | 97 and 22997 et 229 | 94 and 21694 et 216 |
| Majority listListe majoritaire | 146 | 131 | 125 |
Les règles de correspondance
Les règles 2 et 3 réunissent des formes que la règle 1 sépare, par exemple « disease » et « diseases » (see also the Project 1 · Step by step page, in the Course materials module) (voir aussi la page Projet 1 · Pas à pas, dans le module Matériel de cours). Le tableau montre ce que cela change pour ce groupe : de la règle 1 à la règle 3, les termes différents, les listes et la liste majoritaire raccourcissent d’environ un dixième en anglais et un peu plus en français, mais l’accord monte à peine. Les désaccords portent donc rarement sur la forme d’un terme : ils portent sur ce qui compte comme terme et sur ses frontières, que les règles ne touchent pas.
L’anglais et le français
Le groupe s’accorde mieux sur les textes français, selon les trois règles. Les textes français et anglais sont des résumés différents : l’écart peut donc venir des textes autant que de la langue.
Le nombre de termes
Ensemble, les neuf personnes ont marqué bien plus de termes différents qu’une seule liste n’en contient : selon la règle 3, 389 en anglais et 357 en français, contre 152 et 153 dans une liste moyenne.
Les listes diffèrent par les termes retenus, et aussi par leur nombre : en anglais, la plus longue compte près de quatre fois plus de termes que la plus courte. Deux listes de tailles très différentes ne peuvent pas avoir un F1 élevé, même si la plus courte est entièrement comprise dans la plus longue : pour ces deux listes extrêmes, le F1 ne peut pas dépasser 0,42.
Par rapport à la recherche
Les scores d’accord du groupe sont du même ordre que ceux d’études publiées. Dans une étude sur des résumés scientifiques en anglais sur l’insuffisance cardiaque, huit personnes aux profils variés obtenaient un F1 moyen de 0,48 avec de simples définitions du terme, et de 0,59 avec des consignes complètes, calculé comme ici entre chaque paire de personnes et sur les formes distinctes (Rigouts Terryn et al., 2020a, tableau 2). Un accord entre 0,5 et 0,6 reflète la difficulté de la tâche.
Du vote à la référence
Pour évaluer un outil, il faut une seule liste. L’étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. du projet garde les termes qu’au moins cinq personnes sur neuf ont marqués.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Le groupe et la référence
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 1.001,00 | 0.320,32 | 0.490,49 |
| FD | 1.001,00 | 0.360,36 | 0.530,53 |
| GH | 1.001,00 | 0.730,73 | 0.840,84 |
| JD | 1.001,00 | 0.380,38 | 0.550,55 |
| JC | 1.001,00 | 0.510,51 | 0.670,67 |
| JP | 1.001,00 | 0.360,36 | 0.530,53 |
| LA | 1.001,00 | 0.190,19 | 0.320,32 |
| MI | 1.001,00 | 0.360,36 | 0.530,53 |
| VL | 1.001,00 | 0.250,25 | 0.400,40 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.970,97 | 0.450,45 | 0.610,61 |
| FD | 0.910,91 | 0.470,47 | 0.620,62 |
| GH | 0.800,80 | 0.830,83 | 0.810,81 |
| JD | 0.930,93 | 0.500,50 | 0.650,65 |
| JC | 0.940,94 | 0.680,68 | 0.790,79 |
| JP | 0.920,92 | 0.480,48 | 0.630,63 |
| LA | 0.930,93 | 0.250,25 | 0.400,40 |
| MI | 0.990,99 | 0.510,51 | 0.670,67 |
| VL | 0.970,97 | 0.350,35 | 0.520,52 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.890,89 | 0.530,53 | 0.670,67 |
| FD | 0.760,76 | 0.510,51 | 0.610,61 |
| GH | 0.650,65 | 0.880,88 | 0.750,75 |
| JD | 0.850,85 | 0.580,58 | 0.690,69 |
| JC | 0.840,84 | 0.780,78 | 0.810,81 |
| JP | 0.860,86 | 0.580,58 | 0.690,69 |
| LA | 0.900,90 | 0.320,32 | 0.470,47 |
| MI | 0.940,94 | 0.620,62 | 0.740,74 |
| VL | 0.960,96 | 0.450,45 | 0.610,61 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.820,82 | 0.660,66 | 0.730,73 |
| FD | 0.620,62 | 0.560,56 | 0.590,59 |
| GH | 0.520,52 | 0.940,94 | 0.670,67 |
| JD | 0.690,69 | 0.640,64 | 0.670,67 |
| JC | 0.700,70 | 0.880,88 | 0.780,78 |
| JP | 0.730,73 | 0.660,66 | 0.690,69 |
| LA | 0.810,81 | 0.390,39 | 0.520,52 |
| MI | 0.810,81 | 0.730,73 | 0.770,77 |
| VL | 0.920,92 | 0.580,58 | 0.710,71 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.760,76 | 0.800,80 | 0.780,78 |
| FD | 0.500,50 | 0.590,59 | 0.550,55 |
| GH | 0.410,41 | 0.980,98 | 0.580,58 |
| JD | 0.560,56 | 0.680,68 | 0.610,61 |
| JC | 0.570,57 | 0.950,95 | 0.720,72 |
| JP | 0.610,61 | 0.730,73 | 0.670,67 |
| LA | 0.770,77 | 0.480,48 | 0.590,59 |
| MI | 0.690,69 | 0.810,81 | 0.740,74 |
| VL | 0.790,79 | 0.650,65 | 0.720,72 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.620,62 | 0.890,89 | 0.730,73 |
| FD | 0.420,42 | 0.670,67 | 0.520,52 |
| GH | 0.310,31 | 1.001,00 | 0.470,47 |
| JD | 0.470,47 | 0.790,79 | 0.590,59 |
| JC | 0.430,43 | 0.960,96 | 0.590,59 |
| JP | 0.490,49 | 0.790,79 | 0.600,60 |
| LA | 0.690,69 | 0.580,58 | 0.630,63 |
| MI | 0.550,55 | 0.870,87 | 0.670,67 |
| VL | 0.650,65 | 0.720,72 | 0.680,68 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.440,44 | 1.001,00 | 0.610,61 |
| FD | 0.280,28 | 0.720,72 | 0.400,40 |
| GH | 0.190,19 | 1.001,00 | 0.320,32 |
| JD | 0.340,34 | 0.900,90 | 0.490,49 |
| JC | 0.270,27 | 0.980,98 | 0.430,43 |
| JP | 0.370,37 | 0.950,95 | 0.530,53 |
| LA | 0.540,54 | 0.740,74 | 0.630,63 |
| MI | 0.360,36 | 0.920,92 | 0.520,52 |
| VL | 0.460,46 | 0.820,82 | 0.580,58 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.310,31 | 1.001,00 | 0.470,47 |
| FD | 0.240,24 | 0.860,86 | 0.370,37 |
| GH | 0.140,14 | 1.001,00 | 0.240,24 |
| JD | 0.250,25 | 0.950,95 | 0.400,40 |
| JC | 0.200,20 | 1.001,00 | 0.330,33 |
| JP | 0.270,27 | 0.980,98 | 0.420,42 |
| LA | 0.430,43 | 0.840,84 | 0.570,57 |
| MI | 0.280,28 | 1.001,00 | 0.430,43 |
| VL | 0.330,33 | 0.840,84 | 0.470,47 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.140,14 | 1.001,00 | 0.250,25 |
| FD | 0.130,13 | 1.001,00 | 0.230,23 |
| GH | 0.060,06 | 1.001,00 | 0.120,12 |
| JD | 0.120,12 | 1.001,00 | 0.220,22 |
| JC | 0.090,09 | 1.001,00 | 0.170,17 |
| JP | 0.130,13 | 1.001,00 | 0.230,23 |
| LA | 0.240,24 | 1.001,00 | 0.390,39 |
| MI | 0.130,13 | 1.001,00 | 0.230,23 |
| VL | 0.180,18 | 1.001,00 | 0.310,31 |
The 133 terms at least 5 of the 9 annotators markedLes 133 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 20 terms9 sur 9 · 20 termes
- body mass index
- cardiac resynchronization therapy
- cardiovascular diseases
- case-control analysis
- CHF
- clinical practice
- congestive heart failure
- cTnT
- diabetes mellitus
- ejection fraction
- heart failure
- heart rate
- hyperkalemia
- intubations
- left ventricular ejection fraction
- morbidity
- mortality
- spironolactone
- systolic heart failure
- Troponin T
8 of 9 · 23 terms8 sur 9 · 23 termes
- biomarker
- biomarkers
- clinical trials
- confidence intervals
- CRT
- diabetes
- dialysis
- dialysis-dependent patients
- echocardiograms
- emergency department
- HF
- high-sensitivity assay
- hospitalization
- implantation
- International Classification of Diseases
- intubated
- laboratory report
- NT-proBNP
- periprocedural
- reverse remodeling
- Spironolactone
- systolic blood pressure
- β-blocker
7 of 9 · 18 terms7 sur 9 · 18 termes
- acute kidney injury
- AUCs
- bundle branch morphology
- CIs
- confidence interval
- Congestive heart failure
- echocardiographic
- ED
- hazard ratio
- heart failure patients
- HF prediction model
- implant
- implantable cardioverter-defibrillator
- N-terminal pro-B-type natriuretic peptide
- NRIs
- randomized trials
- regression analyses
- symptomatic systolic heart failure
6 of 9 · 37 terms6 sur 9 · 37 termes
- Aldosterone receptor antagonists
- all-cause hospitalization
- angiotensin II receptor blocker
- angiotensin-converting enzyme inhibitor
- ARIC HF model
- atherosclerosis
- AUC
- cardiac troponin T
- cardiomyopathy
- CHF patients
- clinical characteristics
- clinical status
- Cox regression
- CRT implantation
- Crude rates
- device implantation
- diagnosed
- dialysis patients
- dialysis-dependent
- ED physicians
- ED visits
- end-of-life treatment
- heart failure risk
- incident HF
- incident systolic heart failure
- integrated discrimination improvement
- Intubation
- laboratory report model
- medications
- net reclassification improvement
- NRI
- patients
- physicians
- prevalent coronary heart disease
- severe hyperkalemia
- sex-specific models
- treatment
5 of 9 · 35 terms5 sur 9 · 35 termes
- adverse events
- Aldosterone
- all-cause hospitalizations
- antagonists
- antihypertensive medication
- ARIC
- atherosclerosis risk
- Atherosclerosis Risk in Communities
- Cardiac resynchronization therapy
- cardiomyopathy origin
- cardioverter-defibrillator
- CHF treatments
- class I recommendation
- coronary heart disease
- deactivation
- deterioration
- Dialysis
- Dialysis patients
- HF hospitalizations
- hospitalizations
- implantable
- intubation
- Intubation rates
- intubation rates
- model fit
- natriuretic peptide
- Patient
- Patients
- receptor
- Retrospective cohort
- risk of hospitalization
- serum potassium level
- sex-specific model
- Student t test
- time-varying covariates
The 130 terms found in only one of the 9 listsLes 130 termes présents dans une seule des 9 listes
- "laboratory report" model
- -fold
- 6-month echocardiograms
- advances
- AIM
- analysis
- analyze
- area under the receiver operating characteristic curve (AUC)
- ARIC)
- assay
- assessed
- assessment
- associated
- association
- atherosclerosis risk in communities
- average
- baseline serum creatinine
- benefit
- body mass
- Cardiac resynchronization
- cardiac troponin
- characteristic curve (AUC)
- coefficient
- collect
- communicate
- compelling improvement
- CONCLUSION
- conclusion
- CONCLUSIONS
- confidence
- confidence intervals (CIs)
- congestive heart failure (CHF)
- consecutive patients
- coronary
- correlation
- correlation coefficient R
- Cox
- Cox regression with time-varying covariates
- creatinine level
- Crude
- cTnT and NT-proBNP
- current/former smoking
- deactivation discussions
- declined
- decrease
- decreases
- described
- developed
- device
- dialysis-dependent patients with heart failure
- dialysis-dependent patients with HF
- discrimination
- discrimination improvement
- discussed
- echocardiographic outcomes.
- emergency department (ED)
- evaluate
- excluded
- failure
- heart
- Heart Function
- HF risk
- hypothesize
- identified
- improvement
- improvements
- incident
- increased
- increased risk of hyperkalemia
- increases
- increases in incidence
- initiated
- interval
- interview data
- left ventricular ejection
- life
- male
- mean
- mean follow-up
- median
- medication use
- mellitus
- men
- mEq
- month
- n =
- N-terminal pro-B-type
- N-terminal pro-B-type natriuretic peptide:
- observed
- operating characteristic curve
- operating characteristic curve (AUC)
- PARTICIPANTS
- participants
- patient awareness
- patient's
- perspective
- prediction model.
- preferences
- process
- qualitative
- Rates
- rates of annual ED visits
- receptor antagonists
- reclassification
- reduce
- regression
- report model
- RESULTS
- resynchronization
- resynchronization therapy
- Retrospective
- serious complications
- simple sex-specific model
- simpler laboratory report model
- smoking
- statistically
- Student t test,
- studies
- systolic heart failure,
- theory
- timing
- total ED visits
- trials
- Troponin T and N-terminal pro-B-type natriuretic peptide
- use
- use of spironolactone
- value
- ventricular
- visits
- women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 1.001,00 | 0.330,33 | 0.500,50 |
| FD | 1.001,00 | 0.380,38 | 0.550,55 |
| GH | 1.001,00 | 0.730,73 | 0.840,84 |
| JD | 1.001,00 | 0.390,39 | 0.560,56 |
| JC | 1.001,00 | 0.500,50 | 0.670,67 |
| JP | 1.001,00 | 0.380,38 | 0.550,55 |
| LA | 1.001,00 | 0.190,19 | 0.330,33 |
| MI | 1.001,00 | 0.370,37 | 0.540,54 |
| VL | 1.001,00 | 0.260,26 | 0.410,41 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.980,98 | 0.460,46 | 0.620,62 |
| FD | 0.910,91 | 0.490,49 | 0.640,64 |
| GH | 0.810,81 | 0.830,83 | 0.820,82 |
| JD | 0.940,94 | 0.510,51 | 0.660,66 |
| JC | 0.940,94 | 0.670,67 | 0.780,78 |
| JP | 0.920,92 | 0.490,49 | 0.640,64 |
| LA | 0.920,92 | 0.250,25 | 0.400,40 |
| MI | 0.990,99 | 0.510,51 | 0.680,68 |
| VL | 0.980,98 | 0.350,35 | 0.520,52 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.900,90 | 0.540,54 | 0.670,67 |
| FD | 0.760,76 | 0.520,52 | 0.620,62 |
| GH | 0.670,67 | 0.880,88 | 0.760,76 |
| JD | 0.860,86 | 0.590,59 | 0.700,70 |
| JC | 0.850,85 | 0.770,77 | 0.810,81 |
| JP | 0.860,86 | 0.590,59 | 0.700,70 |
| LA | 0.910,91 | 0.320,32 | 0.470,47 |
| MI | 0.930,93 | 0.610,61 | 0.740,74 |
| VL | 0.970,97 | 0.450,45 | 0.610,61 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.820,82 | 0.670,67 | 0.740,74 |
| FD | 0.620,62 | 0.590,59 | 0.600,60 |
| GH | 0.530,53 | 0.950,95 | 0.680,68 |
| JD | 0.700,70 | 0.670,67 | 0.680,68 |
| JC | 0.710,71 | 0.880,88 | 0.780,78 |
| JP | 0.720,72 | 0.670,67 | 0.700,70 |
| LA | 0.800,80 | 0.380,38 | 0.520,52 |
| MI | 0.810,81 | 0.730,73 | 0.760,76 |
| VL | 0.910,91 | 0.580,58 | 0.710,71 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.760,76 | 0.800,80 | 0.780,78 |
| FD | 0.520,52 | 0.640,64 | 0.570,57 |
| GH | 0.420,42 | 0.980,98 | 0.590,59 |
| JD | 0.570,57 | 0.710,71 | 0.630,63 |
| JC | 0.580,58 | 0.940,94 | 0.720,72 |
| JP | 0.610,61 | 0.740,74 | 0.670,67 |
| LA | 0.760,76 | 0.470,47 | 0.580,58 |
| MI | 0.690,69 | 0.800,80 | 0.740,74 |
| VL | 0.800,80 | 0.650,65 | 0.720,72 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.650,65 | 0.870,87 | 0.750,75 |
| FD | 0.440,44 | 0.680,68 | 0.540,54 |
| GH | 0.340,34 | 1.001,00 | 0.510,51 |
| JD | 0.500,50 | 0.780,78 | 0.610,61 |
| JC | 0.470,47 | 0.960,96 | 0.630,63 |
| JP | 0.500,50 | 0.760,76 | 0.600,60 |
| LA | 0.700,70 | 0.550,55 | 0.610,61 |
| MI | 0.580,58 | 0.860,86 | 0.700,70 |
| VL | 0.710,71 | 0.730,73 | 0.720,72 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.440,44 | 1.001,00 | 0.610,61 |
| FD | 0.280,28 | 0.750,75 | 0.410,41 |
| GH | 0.200,20 | 1.001,00 | 0.330,33 |
| JD | 0.340,34 | 0.920,92 | 0.500,50 |
| JC | 0.280,28 | 0.980,98 | 0.440,44 |
| JP | 0.360,36 | 0.950,95 | 0.530,53 |
| LA | 0.540,54 | 0.730,73 | 0.620,62 |
| MI | 0.360,36 | 0.920,92 | 0.520,52 |
| VL | 0.460,46 | 0.810,81 | 0.590,59 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.310,31 | 1.001,00 | 0.470,47 |
| FD | 0.240,24 | 0.880,88 | 0.370,37 |
| GH | 0.140,14 | 1.001,00 | 0.250,25 |
| JD | 0.260,26 | 0.950,95 | 0.400,40 |
| JC | 0.200,20 | 1.001,00 | 0.340,34 |
| JP | 0.270,27 | 0.980,98 | 0.420,42 |
| LA | 0.440,44 | 0.830,83 | 0.580,58 |
| MI | 0.280,28 | 1.001,00 | 0.440,44 |
| VL | 0.340,34 | 0.830,83 | 0.480,48 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.150,15 | 1.001,00 | 0.260,26 |
| FD | 0.130,13 | 1.001,00 | 0.230,23 |
| GH | 0.070,07 | 1.001,00 | 0.130,13 |
| JD | 0.130,13 | 1.001,00 | 0.230,23 |
| JC | 0.100,10 | 1.001,00 | 0.180,18 |
| JP | 0.130,13 | 1.001,00 | 0.230,23 |
| LA | 0.250,25 | 1.001,00 | 0.400,40 |
| MI | 0.130,13 | 1.001,00 | 0.240,24 |
| VL | 0.190,19 | 1.001,00 | 0.320,32 |
The 127 terms at least 5 of the 9 annotators markedLes 127 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 20 terms9 sur 9 · 20 termes
- body mass index
- cardiac resynchronization therapy
- cardiovascular diseases
- case-control analysis
- CHF
- clinical practice
- congestive heart failure
- cTnT
- diabetes mellitus
- ejection fraction
- heart failure
- heart rate
- hyperkalemia
- intubations
- left ventricular ejection fraction
- morbidity
- mortality
- spironolactone
- systolic heart failure
- Troponin T
8 of 9 · 22 terms8 sur 9 · 22 termes
- biomarker
- biomarkers
- clinical trials
- confidence intervals
- CRT
- diabetes
- dialysis
- dialysis-dependent patients
- echocardiograms
- emergency department
- HF
- high-sensitivity assay
- hospitalization
- implantation
- International Classification of Diseases
- intubated
- laboratory report
- NT-proBNP
- periprocedural
- reverse remodeling
- systolic blood pressure
- β-blocker
7 of 9 · 17 terms7 sur 9 · 17 termes
- acute kidney injury
- AUCs
- bundle branch morphology
- CIs
- confidence interval
- echocardiographic
- ED
- hazard ratio
- heart failure patients
- HF prediction model
- implant
- implantable cardioverter-defibrillator
- N-terminal pro-B-type natriuretic peptide
- NRIs
- randomized trials
- regression analyses
- symptomatic systolic heart failure
6 of 9 · 42 terms6 sur 9 · 42 termes
- Aldosterone receptor antagonists
- all-cause hospitalization
- angiotensin II receptor blocker
- angiotensin-converting enzyme inhibitor
- ARIC
- ARIC HF model
- atherosclerosis
- Atherosclerosis Risk in Communities
- AUC
- baseline
- cardiac troponin T
- cardiomyopathy
- CHF patients
- clinical characteristics
- clinical status
- Cox regression
- CRT implantation
- Crude rates
- device implantation
- diagnosed
- dialysis patients
- dialysis-dependent
- ED physicians
- ED visits
- end-of-life treatment
- heart failure risk
- incident HF
- incident systolic heart failure
- integrated discrimination improvement
- Intubation
- Intubation rates
- laboratory report model
- medications
- net reclassification improvement
- NRI
- patients
- physicians
- prevalent coronary heart disease
- severe hyperkalemia
- sex-specific models
- Student t test
- treatment
5 of 9 · 26 terms5 sur 9 · 26 termes
- adverse events
- Aldosterone
- all-cause hospitalizations
- antagonists
- antihypertensive medication
- atherosclerosis risk
- cardiomyopathy origin
- cardioverter-defibrillator
- CHF treatments
- class I recommendation
- coronary heart disease
- deactivation
- deterioration
- end of life
- HF hospitalizations
- hospitalizations
- implantable
- model fit
- natriuretic peptide
- Patient
- receptor
- Retrospective cohort
- risk of hospitalization
- serum potassium level
- sex-specific model
- time-varying covariates
The 119 terms found in only one of the 9 listsLes 119 termes présents dans une seule des 9 listes
- -fold
- 6-month echocardiograms
- advances
- AIM
- analysis
- analyze
- area under the receiver operating characteristic curve (AUC
- assay
- assessed
- assessment
- associated
- association
- average
- baseline serum creatinine
- benefit
- body mass
- cardiac troponin
- characteristic curve (AUC
- coefficient
- collect
- communicate
- compelling improvement
- CONCLUSION
- CONCLUSIONS
- confidence
- confidence intervals (CIs
- congestive heart failure (CHF
- consecutive patients
- coronary
- correlation
- correlation coefficient R
- Cox
- Cox regression with time-varying covariates
- creatinine level
- Crude
- cTnT and NT-proBNP
- current/former smoking
- deactivation discussions
- declined
- decrease
- decreases
- described
- developed
- device
- dialysis-dependent patients with heart failure
- dialysis-dependent patients with HF
- discrimination
- discrimination improvement
- discussed
- emergency department (ED
- evaluate
- excluded
- failure
- heart
- Heart Function
- HF risk
- hypothesize
- identified
- improvement
- improvements
- incident
- increased
- increased risk of hyperkalemia
- increases
- increases in incidence
- initiated
- interval
- interview data
- left ventricular ejection
- life
- male
- mean
- mean follow-up
- median
- medication use
- mellitus
- men
- mEq
- month
- n =
- N-terminal pro-B-type
- observed
- operating characteristic curve
- operating characteristic curve (AUC
- participants
- patient awareness
- patient's
- perspective
- prediction model
- preferences
- process
- qualitative
- rates of annual ED visits
- receptor antagonists
- reclassification
- reduce
- regression
- report model
- RESULTS
- resynchronization
- resynchronization therapy
- Retrospective
- serious complications
- simple sex-specific model
- simpler laboratory report model
- smoking
- statistically
- studies
- theory
- timing
- total ED visits
- trials
- Troponin T and N-terminal pro-B-type natriuretic peptide
- use
- use of spironolactone
- value
- ventricular
- visits
- women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 1.001,00 | 0.330,33 | 0.490,49 |
| FD | 1.001,00 | 0.400,40 | 0.570,57 |
| GH | 1.001,00 | 0.720,72 | 0.840,84 |
| JD | 1.001,00 | 0.390,39 | 0.560,56 |
| JC | 1.001,00 | 0.500,50 | 0.670,67 |
| JP | 1.001,00 | 0.380,38 | 0.550,55 |
| LA | 1.001,00 | 0.190,19 | 0.320,32 |
| MI | 1.001,00 | 0.360,36 | 0.530,53 |
| VL | 1.001,00 | 0.260,26 | 0.410,41 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.980,98 | 0.460,46 | 0.620,62 |
| FD | 0.910,91 | 0.510,51 | 0.650,65 |
| GH | 0.810,81 | 0.830,83 | 0.820,82 |
| JD | 0.930,93 | 0.510,51 | 0.660,66 |
| JC | 0.930,93 | 0.660,66 | 0.770,77 |
| JP | 0.920,92 | 0.490,49 | 0.640,64 |
| LA | 0.920,92 | 0.250,25 | 0.400,40 |
| MI | 0.990,99 | 0.510,51 | 0.670,67 |
| VL | 0.980,98 | 0.360,36 | 0.530,53 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.900,90 | 0.540,54 | 0.670,67 |
| FD | 0.760,76 | 0.550,55 | 0.640,64 |
| GH | 0.670,67 | 0.880,88 | 0.760,76 |
| JD | 0.850,85 | 0.600,60 | 0.700,70 |
| JC | 0.840,84 | 0.770,77 | 0.800,80 |
| JP | 0.860,86 | 0.600,60 | 0.710,71 |
| LA | 0.910,91 | 0.320,32 | 0.470,47 |
| MI | 0.930,93 | 0.610,61 | 0.740,74 |
| VL | 0.970,97 | 0.460,46 | 0.620,62 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.810,81 | 0.670,67 | 0.730,73 |
| FD | 0.620,62 | 0.620,62 | 0.620,62 |
| GH | 0.520,52 | 0.950,95 | 0.670,67 |
| JD | 0.700,70 | 0.680,68 | 0.690,69 |
| JC | 0.700,70 | 0.880,88 | 0.780,78 |
| JP | 0.730,73 | 0.690,69 | 0.710,71 |
| LA | 0.790,79 | 0.380,38 | 0.510,51 |
| MI | 0.810,81 | 0.730,73 | 0.770,77 |
| VL | 0.910,91 | 0.590,59 | 0.720,72 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.740,74 | 0.810,81 | 0.770,77 |
| FD | 0.520,52 | 0.680,68 | 0.590,59 |
| GH | 0.410,41 | 0.980,98 | 0.580,58 |
| JD | 0.570,57 | 0.730,73 | 0.640,64 |
| JC | 0.580,58 | 0.950,95 | 0.720,72 |
| JP | 0.610,61 | 0.760,76 | 0.680,68 |
| LA | 0.750,75 | 0.470,47 | 0.580,58 |
| MI | 0.680,68 | 0.810,81 | 0.740,74 |
| VL | 0.800,80 | 0.690,69 | 0.740,74 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.650,65 | 0.860,86 | 0.740,74 |
| FD | 0.440,44 | 0.710,71 | 0.540,54 |
| GH | 0.340,34 | 1.001,00 | 0.510,51 |
| JD | 0.510,51 | 0.800,80 | 0.630,63 |
| JC | 0.480,48 | 0.970,97 | 0.640,64 |
| JP | 0.520,52 | 0.790,79 | 0.630,63 |
| LA | 0.690,69 | 0.540,54 | 0.610,61 |
| MI | 0.600,60 | 0.880,88 | 0.710,71 |
| VL | 0.710,71 | 0.750,75 | 0.730,73 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.460,46 | 0.980,98 | 0.630,63 |
| FD | 0.300,30 | 0.780,78 | 0.440,44 |
| GH | 0.210,21 | 1.001,00 | 0.350,35 |
| JD | 0.370,37 | 0.920,92 | 0.520,52 |
| JC | 0.300,30 | 0.980,98 | 0.470,47 |
| JP | 0.390,39 | 0.950,95 | 0.550,55 |
| LA | 0.560,56 | 0.700,70 | 0.620,62 |
| MI | 0.410,41 | 0.950,95 | 0.570,57 |
| VL | 0.480,48 | 0.820,82 | 0.610,61 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.340,34 | 1.001,00 | 0.500,50 |
| FD | 0.250,25 | 0.880,88 | 0.390,39 |
| GH | 0.150,15 | 1.001,00 | 0.270,27 |
| JD | 0.270,27 | 0.950,95 | 0.420,42 |
| JC | 0.220,22 | 1.001,00 | 0.360,36 |
| JP | 0.290,29 | 0.980,98 | 0.440,44 |
| LA | 0.480,48 | 0.840,84 | 0.610,61 |
| MI | 0.310,31 | 1.001,00 | 0.470,47 |
| VL | 0.370,37 | 0.860,86 | 0.510,51 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.170,17 | 1.001,00 | 0.290,29 |
| FD | 0.140,14 | 1.001,00 | 0.250,25 |
| GH | 0.080,08 | 1.001,00 | 0.140,14 |
| JD | 0.150,15 | 1.001,00 | 0.260,26 |
| JC | 0.110,11 | 1.001,00 | 0.200,20 |
| JP | 0.150,15 | 1.001,00 | 0.260,26 |
| LA | 0.290,29 | 1.001,00 | 0.450,45 |
| MI | 0.160,16 | 1.001,00 | 0.270,27 |
| VL | 0.220,22 | 1.001,00 | 0.360,36 |
The 118 terms at least 5 of the 9 annotators markedLes 118 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 22 terms9 sur 9 · 22 termes
- biomarker
- body mass index
- cardiac resynchronization therapy
- cardiovascular diseases
- case-control analysis
- CHF
- clinical practice
- congestive heart failure
- cTnT
- diabetes mellitus
- ejection fraction
- heart failure
- heart rate
- hyperkalemia
- intubations
- left ventricular ejection fraction
- morbidity
- mortality
- NRI
- spironolactone
- systolic heart failure
- Troponin T
8 of 9 · 21 terms8 sur 9 · 21 termes
- AUC
- clinical trials
- confidence interval
- CRT
- diabetes
- dialysis
- dialysis-dependent patients
- echocardiograms
- emergency department
- HF
- high-sensitivity assay
- hospitalization
- implantation
- International Classification of Diseases
- intubated
- laboratory report
- NT-proBNP
- periprocedural
- reverse remodeling
- systolic blood pressure
- β-blocker
7 of 9 · 17 terms7 sur 9 · 17 termes
- acute kidney injury
- all-cause hospitalization
- bundle branch morphology
- CIs
- echocardiographic
- ED
- hazard ratio
- heart failure patients
- HF prediction model
- implant
- implantable cardioverter-defibrillator
- N-terminal pro-B-type natriuretic peptide
- randomized trials
- regression analyses
- sex-specific models
- symptomatic systolic heart failure
- treatment
6 of 9 · 36 terms6 sur 9 · 36 termes
- Aldosterone receptor antagonists
- angiotensin II receptor blocker
- angiotensin-converting enzyme inhibitor
- ARIC
- ARIC HF model
- atherosclerosis
- Atherosclerosis Risk in Communities
- baseline
- cardiac troponin T
- cardiomyopathy
- CHF patients
- clinical characteristics
- clinical status
- Cox regression
- CRT implantation
- Crude rates
- device implantation
- diagnosed
- dialysis patients
- dialysis-dependent
- ED physicians
- ED visits
- end-of-life treatment
- heart failure risk
- incident HF
- incident systolic heart failure
- integrated discrimination improvement
- Intubation rates
- laboratory report model
- medication
- net reclassification improvement
- patients
- physicians
- prevalent coronary heart disease
- severe hyperkalemia
- Student t test
5 of 9 · 22 terms5 sur 9 · 22 termes
- adverse events
- Aldosterone
- antagonists
- antihypertensive medication
- atherosclerosis risk
- cardiomyopathy origin
- cardioverter-defibrillator
- CHF treatments
- class I recommendation
- coronary heart disease
- deactivation
- deterioration
- end of life
- HF hospitalization
- implantable
- model fit
- natriuretic peptide
- receptor
- Retrospective cohort
- risk of hospitalization
- serum potassium level
- time-varying covariates
The 115 terms found in only one of the 9 listsLes 115 termes présents dans une seule des 9 listes
- -fold
- 6-month echocardiograms
- advances
- AIM
- analysis
- analyze
- area under the receiver operating characteristic curve (AUC
- assay
- assessed
- assessment
- associated
- association
- average
- baseline serum creatinine
- body mass
- cardiac troponin
- characteristic curve (AUC
- coefficient
- collect
- communicate
- compelling improvement
- CONCLUSION
- confidence
- confidence intervals (CIs
- congestive heart failure (CHF
- consecutive patients
- coronary
- correlation
- correlation coefficient R
- Cox
- Cox regression with time-varying covariates
- creatinine level
- Crude
- cTnT and NT-proBNP
- current/former smoking
- deactivation discussions
- declined
- decrease
- described
- developed
- device
- dialysis-dependent patients with heart failure
- dialysis-dependent patients with HF
- discrimination
- discrimination improvement
- discussed
- emergency department (ED
- evaluate
- excluded
- failure
- heart
- Heart Function
- HF risk
- hypothesize
- identified
- improvements
- incident
- increased
- increased risk of hyperkalemia
- increases
- increases in incidence
- initiated
- interval
- interview data
- left ventricular ejection
- life
- male
- mean
- mean follow-up
- median
- medication use
- mellitus
- men
- mEq
- month
- n =
- N-terminal pro-B-type
- observed
- operating characteristic curve
- operating characteristic curve (AUC
- participants
- patient awareness
- patient's
- perspective
- prediction model
- preferences
- process
- qualitative
- rates of annual ED visits
- receptor antagonists
- reclassification
- reduce
- regression
- report model
- RESULTS
- resynchronization
- resynchronization therapy
- Retrospective
- serious complications
- simple sex-specific model
- simpler laboratory report model
- smoking
- statistically
- studies
- theory
- timing
- total ED visits
- trials
- Troponin T and N-terminal pro-B-type natriuretic peptide
- use
- use of spironolactone
- value
- ventricular
- visits
- women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 1.001,00 | 0.450,45 | 0.620,62 |
| FD | 1.001,00 | 0.290,29 | 0.450,45 |
| GH | 1.001,00 | 0.600,60 | 0.750,75 |
| JD | 1.001,00 | 0.510,51 | 0.680,68 |
| JC | 1.001,00 | 0.560,56 | 0.720,72 |
| JP | 1.001,00 | 0.420,42 | 0.600,60 |
| LA | 1.001,00 | 0.260,26 | 0.410,41 |
| MI | 1.001,00 | 0.390,39 | 0.560,56 |
| VL | 1.001,00 | 0.290,29 | 0.450,45 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.980,98 | 0.630,63 | 0.770,77 |
| FD | 0.960,96 | 0.400,40 | 0.570,57 |
| GH | 0.880,88 | 0.770,77 | 0.820,82 |
| JD | 0.880,88 | 0.650,65 | 0.750,75 |
| JC | 0.870,87 | 0.700,70 | 0.780,78 |
| JP | 0.950,95 | 0.580,58 | 0.730,73 |
| LA | 0.840,84 | 0.320,32 | 0.460,46 |
| MI | 0.960,96 | 0.540,54 | 0.690,69 |
| VL | 0.980,98 | 0.410,41 | 0.580,58 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.940,94 | 0.770,77 | 0.850,85 |
| FD | 0.900,90 | 0.480,48 | 0.630,63 |
| GH | 0.770,77 | 0.850,85 | 0.810,81 |
| JD | 0.760,76 | 0.720,72 | 0.740,74 |
| JC | 0.790,79 | 0.820,82 | 0.810,81 |
| JP | 0.880,88 | 0.690,69 | 0.770,77 |
| LA | 0.820,82 | 0.400,40 | 0.540,54 |
| MI | 0.850,85 | 0.610,61 | 0.710,71 |
| VL | 0.950,95 | 0.510,51 | 0.660,66 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.830,83 | 0.860,86 | 0.840,84 |
| FD | 0.790,79 | 0.540,54 | 0.640,64 |
| GH | 0.660,66 | 0.930,93 | 0.770,77 |
| JD | 0.680,68 | 0.810,81 | 0.740,74 |
| JC | 0.690,69 | 0.900,90 | 0.780,78 |
| JP | 0.810,81 | 0.800,80 | 0.810,81 |
| LA | 0.780,78 | 0.470,47 | 0.590,59 |
| MI | 0.750,75 | 0.690,69 | 0.720,72 |
| VL | 0.900,90 | 0.610,61 | 0.730,73 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.730,73 | 0.930,93 | 0.820,82 |
| FD | 0.720,72 | 0.600,60 | 0.650,65 |
| GH | 0.580,58 | 0.990,99 | 0.730,73 |
| JD | 0.590,59 | 0.860,86 | 0.700,70 |
| JC | 0.590,59 | 0.940,94 | 0.720,72 |
| JP | 0.720,72 | 0.870,87 | 0.790,79 |
| LA | 0.760,76 | 0.560,56 | 0.650,65 |
| MI | 0.660,66 | 0.730,73 | 0.690,69 |
| VL | 0.860,86 | 0.700,70 | 0.770,77 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.630,63 | 0.950,95 | 0.760,76 |
| FD | 0.650,65 | 0.630,63 | 0.640,64 |
| GH | 0.490,49 | 0.990,99 | 0.650,65 |
| JD | 0.540,54 | 0.930,93 | 0.680,68 |
| JC | 0.510,51 | 0.960,96 | 0.670,67 |
| JP | 0.640,64 | 0.920,92 | 0.760,76 |
| LA | 0.670,67 | 0.580,58 | 0.620,62 |
| MI | 0.600,60 | 0.800,80 | 0.690,69 |
| VL | 0.830,83 | 0.810,81 | 0.820,82 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.510,51 | 0.970,97 | 0.670,67 |
| FD | 0.560,56 | 0.700,70 | 0.620,62 |
| GH | 0.380,38 | 0.990,99 | 0.550,55 |
| JD | 0.450,45 | 0.980,98 | 0.610,61 |
| JC | 0.410,41 | 0.970,97 | 0.570,57 |
| JP | 0.530,53 | 0.960,96 | 0.680,68 |
| LA | 0.610,61 | 0.680,68 | 0.640,64 |
| MI | 0.510,51 | 0.840,84 | 0.630,63 |
| VL | 0.730,73 | 0.910,91 | 0.810,81 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.370,37 | 0.970,97 | 0.530,53 |
| FD | 0.470,47 | 0.810,81 | 0.600,60 |
| GH | 0.280,28 | 0.990,99 | 0.430,43 |
| JD | 0.330,33 | 0.990,99 | 0.490,49 |
| JC | 0.300,30 | 1.001,00 | 0.460,46 |
| JP | 0.380,38 | 0.960,96 | 0.550,55 |
| LA | 0.520,52 | 0.800,80 | 0.630,63 |
| MI | 0.400,40 | 0.910,91 | 0.550,55 |
| VL | 0.560,56 | 0.960,96 | 0.700,70 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.150,15 | 1.001,00 | 0.260,26 |
| FD | 0.220,22 | 1.001,00 | 0.360,36 |
| GH | 0.110,11 | 1.001,00 | 0.200,20 |
| JD | 0.130,13 | 1.001,00 | 0.230,23 |
| JC | 0.120,12 | 1.001,00 | 0.210,21 |
| JP | 0.150,15 | 1.001,00 | 0.270,27 |
| LA | 0.250,25 | 1.001,00 | 0.400,40 |
| MI | 0.170,17 | 1.001,00 | 0.290,29 |
| VL | 0.230,23 | 1.001,00 | 0.370,37 |
The 146 terms at least 5 of the 9 annotators markedLes 146 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 27 terms9 sur 9 · 27 termes
- arythmies ventriculaires
- auto-soins
- bêta-bloquants
- cardiopathies congénitales
- d'insuffisance rénale
- DNP
- endopeptidase
- l'ANP
- L'asynchronisme
- l'enzyme de conversion
- l'hypertension artérielle
- l'Incidence hospitalière
- l'insuffisance cardiaque
- l'urodilatine
- maladie chronique
- marqueurs pronostiques
- molécules
- mortalité hospitalière
- NPR-C
- NT-proBNP
- post chirurgie
- profil épidémiologique
- Resynchronisation cardiaque
- système rénine-angiotensine
- Système Rénine-Angiotensine-Aldostérone
- vasodilatatrice
- Épidémiologie
8 of 9 · 43 terms8 sur 9 · 43 termes
- Antagonistes
- BNP
- brain natriuretic peptide
- cardiomyocyte
- cardiopathie
- cardiopathie congénitale
- circulation sanguine
- CNP
- concentration plasmatique
- d'IC
- d'insuffisance cardiaque
- diurétique
- dysfonction ventriculaire
- dysfonction ventriculaire gauche
- développement clinique
- fonction ventriculaire
- hypertensive
- inhibiteurs
- ischémique
- l'angiotensine II
- l'asynchronisme
- l'autodétermination
- l'expansion volémique
- l'IC
- l'incidence hospitalière
- natriurétique
- néphropathie diabètique
- pathologies cardiaques congénitales
- peptides
- peptides natriurétiques
- plan de traitement
- pratique clinique
- proBNP
- pré-proBNP
- resynchronisation
- récepteur de clairance
- rénales
- symptômes
- thérapeutique
- ventricule droit systémique
- ventricule unique
- échographique
- équimolaire
7 of 9 · 27 terms7 sur 9 · 27 termes
- activité biologique
- antagonistes
- B-type natriuretic peptide
- centrales
- clivé
- d'inhiber
- diagnostic
- dosage
- fonction rénale
- fraction d'éjection ventriculaire gauche
- hospitalisations
- IC
- intervention infirmière de soutien
- interventions
- L'autodétermination
- l'hospitalisation
- l'Ic
- L'incidence hospitalière standardisée
- l'Insuffisance cardiaque
- L'épidémiologie
- marqueurs
- mort subite
- NPR-A
- peptide
- récepteurs AT1
- syndromes coronariens aigus
- traitement
6 of 9 · 26 terms6 sur 9 · 26 termes
- biologiques
- calcium
- cardiopathies
- cliniques
- clivage
- congénitales
- d'hospitalisation
- diète
- GI
- groupe d'intervention
- intervention infirmière
- L'IC
- L'insuffisance cardiaque
- l'insuffisance rénale chronique
- l'élimination
- non-peptidiques
- patients
- prise en charge
- récepteur
- stimulation cardiaque de resynchronisation
- synthétisé
- TAD
- techniques d'immunodosage automatisées
- ventriculaire
- voie orale
- études cliniques
5 of 9 · 23 terms5 sur 9 · 23 termes
- amélioration clinique
- arythmies
- concentration
- congénitaux
- d'affiliation
- d'autonomie
- d'immunodosage
- dysfonction ventriculaire avec bloc de branche droit
- groupe anatomique
- hospitalisés
- l'angiotensine
- L'incidence hospitalière
- l'insuffisance cardiaque gauche
- l'insuffisance cardiaque gauche avec bloc de branche gauche
- l'intervention
- multicentriques
- pathologies
- physiologiquement
- Resynchronisation
- rénale
- théorie de l'autodétermination
- vasculaires
- étude pilote
The 127 terms found in only one of the 9 listsLes 127 termes présents dans une seule des 9 listes
- adultes
- amélioration clinique et échographique
- analytique
- Antagonistes des récepteurs AT1 de l'angiotensine II
- antagonistes non-peptidiques des récepteurs de l'angiotensine
- appel téléphonique
- aspects
- AT1
- besoin d'affiliation,
- biologique
- bloc
- blocage du système
- branche gauche
- bénéfices à long terme
- cas
- challenges
- chirurgie
- CNP,
- Conclusion
- congénitale
- critique
- d'inhiber le système
- de façon équimolaire
- diurétique et natriurétique
- dysfonction
- dysfonction ventriculaire avec bloc de branche
- développement
- développement de l'insuffisance cardiaque
- Effet
- effets
- famille
- fonction ventriculaire de l'insuffisance cardiaque
- fraction d'éjection
- fréquence de l'insuffisance cardiaque
- fréquence de l'insuffisance cardiaque à fonction systolique préservée
- groupe anatomique et fonctionnel
- groupe d'intervention (GI)
- groupes de patients
- hospitalisations répétées
- hospitalière
- implications
- infirmière
- inhibiteurs de l'enzyme
- interpréter
- intervention
- l'angiotensine II.
- l'effet
- l'expansion volémique.
- l'incidence
- l'incidence hospitalière de l'IC
- l'installation progressive
- l'installation progressive de l'insuffisance cardiaque
- l'Insuffisance cardiaque (IC)
- l'âge moyen
- l'étude ETICS
- l'étude prospective ETICS
- la circulation sanguine
- La concentration plasmatique
- la fonction rénale
- la néphropathie diabètique
- la resynchronisation
- La stimulation cardiaque
- La stimulation cardiaque de resynchronisation
- Le dosage
- le système rénine-angiotensine
- les antagonistes du calcium
- les inhibiteurs de l'enzyme de conversion de l'angiotensine
- les récepteurs AT1 de l'angiotensine II
- les syndromes coronariens aigus
- Les études cliniques
- limitée
- long terme
- modèle
- modèle de l'insuffisance cardiaque
- modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
- mono
- mono- ou multicentriques
- mort
- natriuretic
- natriuretic peptide
- par liaison
- parent
- patients atteints d'IC
- patients atteints d'IC.
- patients jeunes
- pistes
- population de patients
- post chirurgie de cardiopathie congénitale
- poussée d'IC
- pratique des auto-soins
- première poussée
- première poussée d'IC
- problèmes
- pronostiques
- prospective
- précocement
- prévention de l'insuffisance rénale
- prévention de l'insuffisance rénale chronique
- randomisée à deux groupes
- rapport homme/femme
- recherches
- rendu de résultat
- restrictions
- resynchronisation en post chirurgie de cardiopathie congénitale
- récepteurs AT1 de l'angiotensine II
- Rénine-Angiotensine-Aldostérone
- résultat
- Résultats
- résultats
- Résultats de l'étude ETICS
- soins
- Somme
- soutien
- standardisée
- systémique
- sévères
- traitement de l'hypertension artérielle
- voie orale,
- à deux groupes
- à fonction systolique
- à long terme
- âge
- équivalentes
- étude
- études mono
- études mono-
- évaluée
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 1.001,00 | 0.450,45 | 0.620,62 |
| FD | 1.001,00 | 0.320,32 | 0.480,48 |
| GH | 1.001,00 | 0.600,60 | 0.750,75 |
| JD | 1.001,00 | 0.520,52 | 0.680,68 |
| JC | 1.001,00 | 0.560,56 | 0.720,72 |
| JP | 1.001,00 | 0.430,43 | 0.600,60 |
| LA | 1.001,00 | 0.260,26 | 0.410,41 |
| MI | 1.001,00 | 0.390,39 | 0.560,56 |
| VL | 1.001,00 | 0.280,28 | 0.440,44 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.980,98 | 0.620,62 | 0.760,76 |
| FD | 0.960,96 | 0.430,43 | 0.590,59 |
| GH | 0.900,90 | 0.770,77 | 0.830,83 |
| JD | 0.890,89 | 0.650,65 | 0.750,75 |
| JC | 0.870,87 | 0.690,69 | 0.770,77 |
| JP | 0.960,96 | 0.580,58 | 0.730,73 |
| LA | 0.830,83 | 0.300,30 | 0.440,44 |
| MI | 0.950,95 | 0.520,52 | 0.680,68 |
| VL | 0.980,98 | 0.400,40 | 0.560,56 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.940,94 | 0.760,76 | 0.840,84 |
| FD | 0.910,91 | 0.520,52 | 0.670,67 |
| GH | 0.780,78 | 0.860,86 | 0.810,81 |
| JD | 0.760,76 | 0.720,72 | 0.740,74 |
| JC | 0.780,78 | 0.800,80 | 0.790,79 |
| JP | 0.880,88 | 0.690,69 | 0.770,77 |
| LA | 0.820,82 | 0.390,39 | 0.530,53 |
| MI | 0.840,84 | 0.600,60 | 0.700,70 |
| VL | 0.940,94 | 0.490,49 | 0.650,65 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.820,82 | 0.860,86 | 0.840,84 |
| FD | 0.780,78 | 0.590,59 | 0.670,67 |
| GH | 0.650,65 | 0.930,93 | 0.770,77 |
| JD | 0.670,67 | 0.820,82 | 0.740,74 |
| JC | 0.670,67 | 0.890,89 | 0.760,76 |
| JP | 0.800,80 | 0.810,81 | 0.810,81 |
| LA | 0.770,77 | 0.470,47 | 0.580,58 |
| MI | 0.750,75 | 0.690,69 | 0.720,72 |
| VL | 0.890,89 | 0.600,60 | 0.720,72 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.720,72 | 0.920,92 | 0.810,81 |
| FD | 0.720,72 | 0.660,66 | 0.690,69 |
| GH | 0.570,57 | 0.990,99 | 0.720,72 |
| JD | 0.580,58 | 0.870,87 | 0.700,70 |
| JC | 0.570,57 | 0.930,93 | 0.710,71 |
| JP | 0.720,72 | 0.890,89 | 0.790,79 |
| LA | 0.750,75 | 0.560,56 | 0.640,64 |
| MI | 0.650,65 | 0.720,72 | 0.680,68 |
| VL | 0.850,85 | 0.700,70 | 0.770,77 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.610,61 | 0.940,94 | 0.750,75 |
| FD | 0.650,65 | 0.710,71 | 0.680,68 |
| GH | 0.480,48 | 1.001,00 | 0.650,65 |
| JD | 0.530,53 | 0.940,94 | 0.670,67 |
| JC | 0.490,49 | 0.950,95 | 0.650,65 |
| JP | 0.640,64 | 0.940,94 | 0.760,76 |
| LA | 0.660,66 | 0.580,58 | 0.620,62 |
| MI | 0.600,60 | 0.800,80 | 0.690,69 |
| VL | 0.820,82 | 0.810,81 | 0.820,82 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.500,50 | 0.970,97 | 0.660,66 |
| FD | 0.570,57 | 0.770,77 | 0.650,65 |
| GH | 0.380,38 | 1.001,00 | 0.560,56 |
| JD | 0.440,44 | 0.980,98 | 0.610,61 |
| JC | 0.400,40 | 0.970,97 | 0.570,57 |
| JP | 0.530,53 | 0.970,97 | 0.680,68 |
| LA | 0.620,62 | 0.680,68 | 0.650,65 |
| MI | 0.510,51 | 0.850,85 | 0.640,64 |
| VL | 0.740,74 | 0.910,91 | 0.820,82 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.380,38 | 0.970,97 | 0.550,55 |
| FD | 0.480,48 | 0.880,88 | 0.620,62 |
| GH | 0.290,29 | 1.001,00 | 0.450,45 |
| JD | 0.330,33 | 0.980,98 | 0.500,50 |
| JC | 0.310,31 | 1.001,00 | 0.470,47 |
| JP | 0.400,40 | 0.970,97 | 0.560,56 |
| LA | 0.540,54 | 0.790,79 | 0.640,64 |
| MI | 0.410,41 | 0.910,91 | 0.560,56 |
| VL | 0.580,58 | 0.950,95 | 0.720,72 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.180,18 | 1.001,00 | 0.300,30 |
| FD | 0.250,25 | 1.001,00 | 0.400,40 |
| GH | 0.130,13 | 1.001,00 | 0.230,23 |
| JD | 0.150,15 | 1.001,00 | 0.270,27 |
| JC | 0.140,14 | 1.001,00 | 0.250,25 |
| JP | 0.180,18 | 1.001,00 | 0.310,31 |
| LA | 0.310,31 | 1.001,00 | 0.470,47 |
| MI | 0.200,20 | 1.001,00 | 0.340,34 |
| VL | 0.280,28 | 1.001,00 | 0.430,43 |
The 131 terms at least 5 of the 9 annotators markedLes 131 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 30 terms9 sur 9 · 30 termes
- ANP
- arythmies ventriculaires
- asynchronisme
- auto-soins
- bêta-bloquants
- cardiopathies congénitales
- CNP
- DNP
- endopeptidase
- enzyme de conversion
- expansion volémique
- hypertension artérielle
- Incidence hospitalière
- insuffisance cardiaque
- insuffisance rénale
- maladie chronique
- marqueurs pronostiques
- molécules
- mortalité hospitalière
- NPR-C
- NT-proBNP
- post chirurgie
- profil épidémiologique
- resynchronisation
- Resynchronisation cardiaque
- système rénine-angiotensine
- Système Rénine-Angiotensine-Aldostérone
- urodilatine
- vasodilatatrice
- Épidémiologie
8 of 9 · 36 terms8 sur 9 · 36 termes
- angiotensine II
- antagonistes
- autodétermination
- BNP
- brain natriuretic peptide
- cardiomyocyte
- cardiopathie
- cardiopathie congénitale
- circulation sanguine
- concentration plasmatique
- diurétique
- dysfonction ventriculaire
- dysfonction ventriculaire gauche
- développement clinique
- fonction ventriculaire
- hypertensive
- IC
- inhibiteurs
- ischémique
- natriurétique
- néphropathie diabètique
- pathologies cardiaques congénitales
- peptides
- peptides natriurétiques
- plan de traitement
- pratique clinique
- proBNP
- pré-proBNP
- récepteur de clairance
- rénales
- symptômes
- thérapeutique
- ventricule droit systémique
- ventricule unique
- échographique
- équimolaire
7 of 9 · 22 terms7 sur 9 · 22 termes
- activité biologique
- B-type natriuretic peptide
- centrales
- clivé
- diagnostic
- dosage
- fonction rénale
- fraction d'éjection ventriculaire gauche
- hospitalisation
- hospitalisations
- incidence hospitalière standardisée
- inhiber
- intervention infirmière de soutien
- interventions
- marqueurs
- mort subite
- NPR-A
- peptide
- récepteurs AT1
- syndromes coronariens aigus
- traitement
- voie orale
6 of 9 · 22 terms6 sur 9 · 22 termes
- biologiques
- calcium
- cardiopathies
- cliniques
- clivage
- congénitales
- diète
- GI
- groupe d'intervention
- insuffisance rénale chronique
- intervention infirmière
- non-peptidiques
- patients
- prise en charge
- récepteur
- stimulation cardiaque de resynchronisation
- synthétisé
- TAD
- techniques d'immunodosage automatisées
- ventriculaire
- élimination
- études cliniques
5 of 9 · 21 terms5 sur 9 · 21 termes
- affiliation
- amélioration clinique
- angiotensine
- arythmies
- autonomie
- concentration
- congénitaux
- dysfonction ventriculaire avec bloc de branche droit
- groupe anatomique
- hospitalisés
- immunodosage
- insuffisance cardiaque gauche
- insuffisance cardiaque gauche avec bloc de branche gauche
- intervention
- multicentriques
- pathologies
- physiologiquement
- rénale
- théorie de l'autodétermination
- vasculaires
- étude pilote
The 111 terms found in only one of the 9 listsLes 111 termes présents dans une seule des 9 listes
- adultes
- amélioration clinique et échographique
- analytique
- Antagonistes des récepteurs AT1 de l'angiotensine II
- antagonistes non-peptidiques des récepteurs de l'angiotensine
- appel téléphonique
- aspects
- AT1
- biologique
- bloc
- blocage du système
- branche gauche
- bénéfices à long terme
- cas
- challenges
- chirurgie
- Conclusion
- congénitale
- critique
- de façon équimolaire
- diurétique et natriurétique
- dysfonction
- dysfonction ventriculaire avec bloc de branche
- développement
- développement de l'insuffisance cardiaque
- Effet
- effets
- famille
- fonction ventriculaire de l'insuffisance cardiaque
- fraction d'éjection
- fréquence de l'insuffisance cardiaque
- fréquence de l'insuffisance cardiaque à fonction systolique préservée
- groupe anatomique et fonctionnel
- groupe d'intervention (GI
- groupes de patients
- hospitalisations répétées
- hospitalière
- implications
- incidence
- incidence hospitalière de l'IC
- infirmière
- inhiber le système
- inhibiteurs de l'enzyme
- installation progressive
- installation progressive de l'insuffisance cardiaque
- interpréter
- la circulation sanguine
- La concentration plasmatique
- la fonction rénale
- la néphropathie diabètique
- la resynchronisation
- La stimulation cardiaque
- La stimulation cardiaque de resynchronisation
- Le dosage
- le système rénine-angiotensine
- les antagonistes du calcium
- les inhibiteurs de l'enzyme de conversion de l'angiotensine
- les récepteurs AT1 de l'angiotensine II
- les syndromes coronariens aigus
- Les études cliniques
- limitée
- long terme
- modèle
- modèle de l'insuffisance cardiaque
- modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
- mono
- mono- ou multicentriques
- mort
- natriuretic
- natriuretic peptide
- par liaison
- parent
- patients jeunes
- pistes
- population de patients
- post chirurgie de cardiopathie congénitale
- poussée d'IC
- pratique des auto-soins
- première poussée
- première poussée d'IC
- problèmes
- pronostiques
- prospective
- précocement
- prévention de l'insuffisance rénale
- prévention de l'insuffisance rénale chronique
- randomisée à deux groupes
- rapport homme/femme
- recherches
- rendu de résultat
- restrictions
- resynchronisation en post chirurgie de cardiopathie congénitale
- récepteurs AT1 de l'angiotensine II
- Rénine-Angiotensine-Aldostérone
- résultat
- Résultats de l'étude ETICS
- soins
- Somme
- soutien
- standardisée
- systémique
- sévères
- traitement de l'hypertension artérielle
- à deux groupes
- à fonction systolique
- à long terme
- âge moyen
- équivalentes
- étude ETICS
- étude prospective ETICS
- évaluée
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 1.001,00 | 0.460,46 | 0.630,63 |
| FD | 1.001,00 | 0.330,33 | 0.500,50 |
| GH | 1.001,00 | 0.600,60 | 0.750,75 |
| JD | 1.001,00 | 0.520,52 | 0.690,69 |
| JC | 1.001,00 | 0.570,57 | 0.720,72 |
| JP | 1.001,00 | 0.430,43 | 0.600,60 |
| LA | 1.001,00 | 0.260,26 | 0.420,42 |
| MI | 1.001,00 | 0.380,38 | 0.550,55 |
| VL | 1.001,00 | 0.300,30 | 0.460,46 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.970,97 | 0.630,63 | 0.770,77 |
| FD | 0.960,96 | 0.450,45 | 0.610,61 |
| GH | 0.910,91 | 0.780,78 | 0.840,84 |
| JD | 0.890,89 | 0.660,66 | 0.760,76 |
| JC | 0.860,86 | 0.700,70 | 0.770,77 |
| JP | 0.960,96 | 0.580,58 | 0.720,72 |
| LA | 0.830,83 | 0.310,31 | 0.450,45 |
| MI | 0.960,96 | 0.520,52 | 0.670,67 |
| VL | 0.980,98 | 0.410,41 | 0.580,58 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.930,93 | 0.760,76 | 0.840,84 |
| FD | 0.920,92 | 0.550,55 | 0.690,69 |
| GH | 0.790,79 | 0.860,86 | 0.820,82 |
| JD | 0.770,77 | 0.720,72 | 0.740,74 |
| JC | 0.780,78 | 0.790,79 | 0.790,79 |
| JP | 0.900,90 | 0.680,68 | 0.780,78 |
| LA | 0.820,82 | 0.390,39 | 0.530,53 |
| MI | 0.870,87 | 0.590,59 | 0.700,70 |
| VL | 0.940,94 | 0.500,50 | 0.660,66 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.810,81 | 0.860,86 | 0.830,83 |
| FD | 0.810,81 | 0.620,62 | 0.700,70 |
| GH | 0.670,67 | 0.940,94 | 0.780,78 |
| JD | 0.670,67 | 0.820,82 | 0.740,74 |
| JC | 0.670,67 | 0.890,89 | 0.760,76 |
| JP | 0.810,81 | 0.800,80 | 0.810,81 |
| LA | 0.770,77 | 0.470,47 | 0.580,58 |
| MI | 0.770,77 | 0.680,68 | 0.720,72 |
| VL | 0.890,89 | 0.610,61 | 0.730,73 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.710,71 | 0.930,93 | 0.810,81 |
| FD | 0.730,73 | 0.690,69 | 0.710,71 |
| GH | 0.580,58 | 1.001,00 | 0.730,73 |
| JD | 0.590,59 | 0.870,87 | 0.700,70 |
| JC | 0.570,57 | 0.930,93 | 0.710,71 |
| JP | 0.720,72 | 0.880,88 | 0.790,79 |
| LA | 0.740,74 | 0.560,56 | 0.640,64 |
| MI | 0.670,67 | 0.730,73 | 0.700,70 |
| VL | 0.850,85 | 0.720,72 | 0.780,78 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.620,62 | 0.950,95 | 0.750,75 |
| FD | 0.660,66 | 0.740,74 | 0.700,70 |
| GH | 0.490,49 | 1.001,00 | 0.660,66 |
| JD | 0.540,54 | 0.940,94 | 0.690,69 |
| JC | 0.500,50 | 0.950,95 | 0.650,65 |
| JP | 0.650,65 | 0.930,93 | 0.770,77 |
| LA | 0.660,66 | 0.580,58 | 0.620,62 |
| MI | 0.620,62 | 0.790,79 | 0.700,70 |
| VL | 0.820,82 | 0.820,82 | 0.820,82 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.510,51 | 0.960,96 | 0.670,67 |
| FD | 0.590,59 | 0.810,81 | 0.690,69 |
| GH | 0.400,40 | 1.001,00 | 0.570,57 |
| JD | 0.450,45 | 0.980,98 | 0.620,62 |
| JC | 0.400,40 | 0.950,95 | 0.570,57 |
| JP | 0.550,55 | 0.960,96 | 0.700,70 |
| LA | 0.620,62 | 0.670,67 | 0.640,64 |
| MI | 0.540,54 | 0.850,85 | 0.660,66 |
| VL | 0.740,74 | 0.920,92 | 0.820,82 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.390,39 | 0.970,97 | 0.550,55 |
| FD | 0.500,50 | 0.910,91 | 0.650,65 |
| GH | 0.300,30 | 1.001,00 | 0.460,46 |
| JD | 0.340,34 | 0.980,98 | 0.510,51 |
| JC | 0.320,32 | 1.001,00 | 0.480,48 |
| JP | 0.410,41 | 0.970,97 | 0.580,58 |
| LA | 0.540,54 | 0.790,79 | 0.640,64 |
| MI | 0.440,44 | 0.910,91 | 0.590,59 |
| VL | 0.580,58 | 0.950,95 | 0.720,72 |
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
| precisionprécision | recallrappel | F1 | |
|---|---|---|---|
| AB | 0.190,19 | 1.001,00 | 0.320,32 |
| FD | 0.260,26 | 1.001,00 | 0.420,42 |
| GH | 0.140,14 | 1.001,00 | 0.250,25 |
| JD | 0.170,17 | 1.001,00 | 0.290,29 |
| JC | 0.150,15 | 1.001,00 | 0.270,27 |
| JP | 0.200,20 | 1.001,00 | 0.340,34 |
| LA | 0.330,33 | 1.001,00 | 0.500,50 |
| MI | 0.230,23 | 1.001,00 | 0.370,37 |
| VL | 0.290,29 | 1.001,00 | 0.450,45 |
The 125 terms at least 5 of the 9 annotators markedLes 125 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 31 terms9 sur 9 · 31 termes
- ANP
- arythmies ventriculaires
- asynchronisme
- auto-soins
- bêta-bloquants
- cardiopathie
- cardiopathies congénitales
- CNP
- DNP
- endopeptidase
- enzyme de conversion
- expansion volémique
- hypertension artérielle
- Incidence hospitalière
- insuffisance cardiaque
- insuffisance rénale
- maladie chronique
- marqueurs pronostiques
- molécules
- mortalité hospitalière
- NPR-C
- NT-proBNP
- post chirurgie
- profil épidémiologique
- resynchronisation
- Resynchronisation cardiaque
- système rénine-angiotensine
- Système Rénine-Angiotensine-Aldostérone
- urodilatine
- vasodilatatrice
- Épidémiologie
8 of 9 · 34 terms8 sur 9 · 34 termes
- angiotensine II
- antagonistes
- autodétermination
- BNP
- brain natriuretic peptide
- cardiomyocyte
- circulation sanguine
- concentration plasmatique
- diurétique
- dysfonction ventriculaire
- dysfonction ventriculaire gauche
- développement clinique
- fonction ventriculaire
- hypertensive
- IC
- inhibiteurs
- ischémique
- natriurétique
- néphropathie diabètique
- pathologies cardiaques congénitales
- peptides
- peptides natriurétiques
- plan de traitement
- pratique clinique
- proBNP
- pré-proBNP
- récepteur de clairance
- rénales
- symptômes
- thérapeutique
- ventricule droit systémique
- ventricule unique
- échographique
- équimolaire
7 of 9 · 21 terms7 sur 9 · 21 termes
- activité biologique
- B-type natriuretic peptide
- centrales
- clivé
- diagnostic
- dosage
- fonction rénale
- fraction d'éjection ventriculaire gauche
- hospitalisation
- incidence hospitalière standardisée
- inhiber
- intervention
- intervention infirmière de soutien
- marqueurs
- mort subite
- NPR-A
- récepteur
- récepteurs AT1
- syndromes coronariens aigus
- traitement
- voie orale
6 of 9 · 20 terms6 sur 9 · 20 termes
- biologiques
- calcium
- cliniques
- clivage
- congénitales
- diète
- GI
- groupe d'intervention
- insuffisance rénale chronique
- intervention infirmière
- non-peptidiques
- patients
- prise en charge
- stimulation cardiaque de resynchronisation
- synthétisé
- TAD
- techniques d'immunodosage automatisées
- ventriculaire
- élimination
- études cliniques
5 of 9 · 19 terms5 sur 9 · 19 termes
- affiliation
- amélioration clinique
- angiotensine
- arythmies
- autonomie
- concentration
- congénitaux
- dysfonction ventriculaire avec bloc de branche droit
- groupe anatomique
- hospitalisés
- immunodosage
- insuffisance cardiaque gauche
- insuffisance cardiaque gauche avec bloc de branche gauche
- multicentriques
- pathologies
- physiologiquement
- théorie de l'autodétermination
- vasculaires
- étude pilote
The 106 terms found in only one of the 9 listsLes 106 termes présents dans une seule des 9 listes
- amélioration clinique et échographique
- analytique
- Antagonistes des récepteurs AT1 de l'angiotensine II
- antagonistes non-peptidiques des récepteurs de l'angiotensine
- appel téléphonique
- aspects
- AT1
- bloc
- blocage du système
- branche gauche
- bénéfices à long terme
- cas
- challenges
- chirurgie
- Conclusion
- critique
- de façon équimolaire
- diurétique et natriurétique
- dysfonction
- dysfonction ventriculaire avec bloc de branche
- développement
- développement de l'insuffisance cardiaque
- effets
- famille
- fonction ventriculaire de l'insuffisance cardiaque
- fraction d'éjection
- fréquence de l'insuffisance cardiaque
- fréquence de l'insuffisance cardiaque à fonction systolique préservée
- groupe anatomique et fonctionnel
- groupe d'intervention (GI
- groupes de patients
- hospitalisations répétées
- hospitalière
- implications
- incidence
- incidence hospitalière de l'IC
- infirmière
- inhiber le système
- inhibiteurs de l'enzyme
- installation progressive
- installation progressive de l'insuffisance cardiaque
- interpréter
- la circulation sanguine
- La concentration plasmatique
- la fonction rénale
- la néphropathie diabètique
- la resynchronisation
- La stimulation cardiaque
- La stimulation cardiaque de resynchronisation
- Le dosage
- le système rénine-angiotensine
- les antagonistes du calcium
- les inhibiteurs de l'enzyme de conversion de l'angiotensine
- les récepteurs AT1 de l'angiotensine II
- les syndromes coronariens aigus
- Les études cliniques
- limitée
- long terme
- modèle
- modèle de l'insuffisance cardiaque
- modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
- mono
- mono- ou multicentriques
- mort
- natriuretic
- natriuretic peptide
- par liaison
- parent
- patients jeunes
- pistes
- population de patients
- post chirurgie de cardiopathie congénitale
- poussée d'IC
- pratique des auto-soins
- première poussée
- première poussée d'IC
- problèmes
- pronostiques
- prospective
- précocement
- prévention de l'insuffisance rénale
- prévention de l'insuffisance rénale chronique
- randomisée à deux groupes
- rapport homme/femme
- recherches
- rendu de résultat
- restrictions
- resynchronisation en post chirurgie de cardiopathie congénitale
- récepteurs AT1 de l'angiotensine II
- Rénine-Angiotensine-Aldostérone
- Résultats de l'étude ETICS
- soins
- Somme
- soutien
- standardisée
- systémique
- sévères
- traitement de l'hypertension artérielle
- à deux groupes
- à fonction systolique
- à long terme
- âge moyen
- équivalentes
- étude ETICS
- étude prospective ETICS
- évaluée
Scores computed on 5 October 2026 from the INCEpTION export; initials instead of names.Scores calculés le 5 octobre 2026 à partir de l'export INCEpTION ; des initiales plutôt que des noms.
Lire les graphiques
- Le seuil se change dans le menu : plus il est bas, plus la référence est longue.
- Les barres comptent les termes selon le nombre de personnes qui les ont marqués. Une longue barre à gauche : beaucoup de termes présents dans une seule liste.
- Le nuage de points place chacun selon sa précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. et son rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. . Au-dessus de la diagonale : une liste plus longue que la référence ; en dessous : plus courte.
- Les termes listés sont ceux qu’au moins cinq personnes ont marqués, puis, à part, ceux qui ne figurent que dans une des neuf listes.