Reading the scoresLire les scores
TRA6008 To read for S8À lire pour la S8
Comparing like with like
Scores from different metrics, test sets, references or tools cannot be compared directly (Figure 13figure 13).
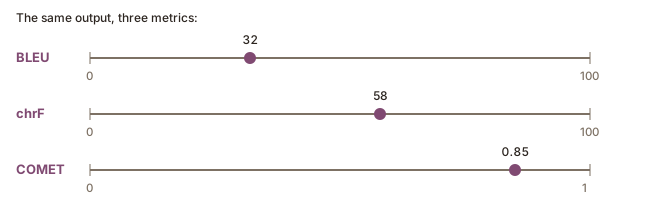
When all of these are the same, the difference between two scores can be read, with caution. A small difference may be noise: a BLEU difference of one or two points corresponded to a real difference in human judgement only about half the time on the WMT 2019 data Mathur et al. (2020) re-examined. Resampling the test set shows whether a difference is significant (Kocmi et al., 2021; Jurafsky & Martin, 2026) (see also the Interpreting a score page) (voir aussi la page Interpréter un score).
Eight translations of one sentence
The demonstration below scores eight translations of one French sentence, collected in 2026: Google Translate, DeepL, and ChatGPT, Claude and Gemini each with a simple and an elaborate prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. . The simple prompt said only to translate into English; the elaborate one asked for natural, fluent American English with consistent terminology. The two reference translations are my own. The ranking changes with the reference and with the metric as well as with the systems. Every text can be edited, and translations can be added, so the same comparison can be made on other sentences.
TranslationsTraductions
| TranslationTraduction | BLEU | chrF |
|---|
Rank 1 is the highest score; equal scores share a rank. Hover over a translation to follow it.Le rang 1 est le meilleur score ; des scores égaux partagent un rang. Survolez une traduction pour la suivre.
The demonstration uses only the simplest metrics, BLEU and chrF, because the others need a trained model that is much harder to run on a web page. The lesson is the same for them: a score depends on the reference, for every metric that compares the output with one, and on the method, since different metrics can rank the same translations differently (see also the Ways of evaluating a translation page) (voir aussi la page Les façons d'évaluer une traduction).
From the score to the sentences
A score for a whole test set ranks the systems; the scores per segment segmentsegment CAT toolsTAO A portion of translatable content that a CAT tool treats as a discrete unit for translation, alignment, storage and match retrieval.Portion de contenu à traduire qu'un outil de TAO traite comme une unité distincte aux fins de traduction, d'alignement, de stockage et de recherche de correspondances. show where they differ. Two kinds of sentence are worth reading:
- where two systems are far apart, which shows the kind of error each system makes;
- where two metrics disagree about the same output, which shows the kind of error each metric misses.
A segment score points to a sentence worth reading, and the sentence still has to be read. MATEO gives the scores per sentence for metrics such as COMET (see also the Computing scores with MATEO page) (voir aussi la page Calculer des scores avec MATEO).
Combining methods
No single metric is enough: in one company, relying on BLEU alone held back improved models and led to bad deployment decisions (Kocmi et al., 2021). At WMT, an automatic ranking decides which systems people evaluate, and human evaluation is the final arbiter (Kocmi et al., 2025) (see also the WMT general translation task page, in the Machine translation module) (voir aussi la page La tâche générale de traduction de WMT, dans le module Traduction automatique). The same division works on a smaller scale: an automatic score for every system, then a human reading of the leading systems and of the sentences on which the scores disagree.
Comparer ce qui est comparable
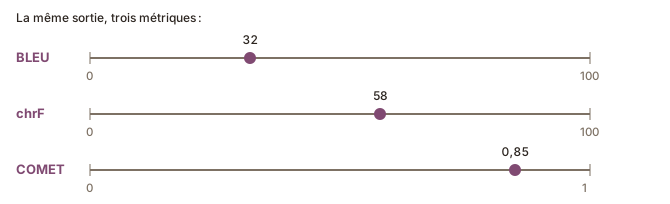
Les scores de métriques, de jeux de test, de références ou d’outils différents ne peuvent pas être comparés directement (Figure 13figure 13).
| Un score dépend de | Conséquence |
|---|---|
| la métrique | un BLEU de 32 et un chrF de 58 pour la même sortie ne sont pas deux mesures d’une même chose, et aucun n’est un pourcentage de quoi que ce soit |
| la paire de langues | certaines métriques entraînées, comme COMET et BLEURT, ont des plages de valeurs différentes selon les paires de langues, si bien qu’on ne peut pas supposer que leurs scores partagent une même échelle (Kocmi et al., 2021) |
| le jeu de test test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. | un jeu de test plus difficile donne des scores plus bas pour un même système ; WMT a rendu ses jeux de test de 2025 plus difficiles à dessein (Kocmi et al., 2025) |
| la référence | une deuxième traduction de référence donne un autre score (see also the Many correct translations page) (voir aussi la page De nombreuses traductions correctes) |
| la segmentation en unités lexicales tokenization¹segmentation en unités lexicales linguisticslinguistique The process of dividing running text into individual units that can be counted, annotated or analyzed.Processus de découpage d'un texte suivi en unités individuelles pouvant être comptées, annotées ou analysées. , pour BLEU | deux scores BLEU calculés avec des outils différents peuvent présenter un écart allant jusqu’à 1,8 point sur la même sortie (Post, 2018) |
Quand tous ces éléments sont identiques, la différence entre deux scores peut être lue, avec prudence. Une petite différence peut n’être que du bruit : une différence BLEU d’un ou deux points ne correspondait à une différence réelle dans le jugement humain qu’environ une fois sur deux, sur les données de WMT 2019 que Mathur et al. (2020) ont réexaminées. Un rééchantillonnage du jeu de test montre si une différence est significative (Kocmi et al., 2021 ; Jurafsky & Martin, 2026) (see also the Interpreting a score page) (voir aussi la page Interpréter un score).
Huit traductions d’une même phrase
La démonstration ci-dessous note huit traductions d’une phrase française, recueillies en 2026 : Google Translate, DeepL, ainsi que ChatGPT, Claude et Gemini, chacun avec une requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. simple et une requête élaborée. La requête simple demandait seulement de traduire vers l’anglais ; la requête élaborée demandait un anglais américain naturel et fluide, avec une terminologie cohérente. Les deux traductions de référence sont les miennes. Le classement change avec la référence et avec la métrique autant qu’avec les systèmes. Chaque texte peut être modifié, et des traductions peuvent être ajoutées, si bien que la même comparaison peut être faite sur d’autres phrases.
TranslationsTraductions
| TranslationTraduction | BLEU | chrF |
|---|
Rank 1 is the highest score; equal scores share a rank. Hover over a translation to follow it.Le rang 1 est le meilleur score ; des scores égaux partagent un rang. Survolez une traduction pour la suivre.
La démonstration n’emploie que les métriques les plus simples, BLEU et chrF, parce que les autres demandent un modèle entraîné, beaucoup plus difficile à faire tourner dans une page Web. La leçon vaut aussi pour elles : un score dépend de la référence, pour toute métrique qui compare la sortie avec une référence, et de la méthode, puisque des métriques différentes peuvent classer les mêmes traductions différemment (see also the Ways of evaluating a translation page) (voir aussi la page Les façons d'évaluer une traduction).
Du score aux phrases
Un score pour tout un jeu de test classe les systèmes ; les scores par segment segmentsegment CAT toolsTAO A portion of translatable content that a CAT tool treats as a discrete unit for translation, alignment, storage and match retrieval.Portion de contenu à traduire qu'un outil de TAO traite comme une unité distincte aux fins de traduction, d'alignement, de stockage et de recherche de correspondances. montrent où ils diffèrent. Deux types de phrases valent la peine d’être lues :
- celles où deux systèmes sont très éloignés, qui montrent le type d’erreur que fait chaque système ;
- celles où deux métriques sont en désaccord sur une même sortie, qui montrent le type d’erreur qui échappe à chaque métrique.
Un score de segment désigne une phrase à lire, et la phrase doit encore être lue. MATEO donne les scores par phrase pour des métriques comme COMET (see also the Computing scores with MATEO page) (voir aussi la page Calculer des scores avec MATEO).
Combiner les méthodes
Aucune métrique ne suffit à elle seule : dans une entreprise, s’en remettre à BLEU seul a freiné l’adoption de modèles améliorés et conduit à de mauvaises décisions de déploiement (Kocmi et al., 2021). À WMT, un classement automatique décide des systèmes que des personnes évaluent, et l’évaluation humaine est l’arbitre final (Kocmi et al., 2025) (see also the WMT general translation task page, in the Machine translation module) (voir aussi la page La tâche générale de traduction de WMT, dans le module Traduction automatique). La même répartition fonctionne à plus petite échelle : un score automatique pour chaque système, puis une lecture humaine des systèmes de tête et des phrases sur lesquelles les scores ne concordent pas.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
- Kocmi, T., Federmann, C., Grundkiewicz, R., Junczys-Dowmunt, M., Matsushita, H., & Menezes, A. (2021). To Ship or Not to Ship: An Extensive Evaluation of Automatic Metrics for Machine Translation. Proceedings of the Sixth Conference on Machine Translation (WMT 2021), 478–494. https://aclanthology.org/2021.wmt-1.57/
- Mathur, N., Baldwin, T., & Cohn, T. (2020). Tangled up in BLEU: Reevaluating the Evaluation of Automatic Machine Translation Evaluation Metrics. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, 4984–4997. https://doi.org/10.18653/v1/2020.acl-main.448
- Post, M. (2018). A Call for Clarity in Reporting BLEU Scores. Proceedings of the Third Conference on Machine Translation: Research Papers (WMT 2018), 186–191. https://doi.org/10.18653/v1/W18-6319