Ways of evaluating a translationLes façons d'évaluer une traduction
TRA6008 To read for S8À lire pour la S8
Methods of evaluating a translation
The four ways of evaluating any system (comparison with a gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , pairwise comparison, rating and error annotation) are explained in the foundations chapter (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer). In translation the gold standard is a reference translation, and both a comparison with it and a rating give a score, so Figure 3figure 3 groups the two. Its colours show that many methods can work with or without a reference.
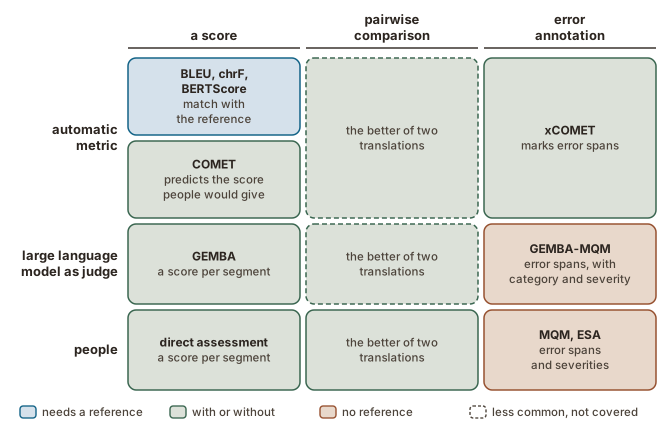
The rows of the figure are the three families of methods:
- Automatic metrics: a program computes the score, and the same input always gets the same score.
- A large language model large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. as judge: a general model is instructed to judge the translation.
- People: raters judge the translation themselves.
Automatic metrics
Automatic metrics differ in what they compare. There are three main kinds:
- surface metrics count the words or characters that the output shares with the reference, for instance BLEU (Papineni et al., 2002) and chrF (Popović, 2015);
- semantic metrics compare the meaning of the output and the reference through contextual embeddings contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. , for instance BERTScore (Zhang et al., 2020);
- learned metrics are trained on human judgements to predict the score a person would give, for instance COMET (Rei et al., 2020); some work without a reference, which is called quality estimation.
A metric is a system too, and it is evaluated against people: its scores are compared with human judgements of the same translations, both when it ranks whole systems and when it scores single sentences. WMT, the Conference on Machine Translation, runs a shared task shared tasktâche partagée evaluationévaluation A public evaluation exercise in which every participating team is given the same task, the same data and the same scoring, so that their systems can be compared directly.Exercice d'évaluation public où toutes les équipes participantes reçoivent la même tâche, les mêmes données et la même notation, de sorte que leurs systèmes se comparent directement. of this kind every year. Two studies show how the results have changed:
- In 2021, on the largest collection of human judgements then available, learned metrics ranked pairs of systems more like people than surface metrics did (Kocmi et al., 2021).
- In 2025, large language models used as judges were the best at ranking whole systems. On single sentences, simple metrics that compare the output with a reference, surface ones such as chrF and embedding-based ones such as BERTScore, were among the best, ahead of most learned metrics and model judges; only one model judge and one learned metric equalled or exceeded them. The organizers call this result surprising (Lavie et al., 2025).
Large language models as judges
A large language model used as a judge receives the source, the output, the reference if there is one, and an instruction saying what to judge and in what form to answer (Kocmi & Federmann, 2023a). It can give a score, a list of errors with their category and severity, or both.
- Model judges rank whole systems well, but most score single sentences less reliably, as the 2025 results above show.
- The judgement changes with the wording of the prompt and with the model, and the same model asked twice can answer differently (see also the A large language model as judge page) (voir aussi la page Un grand modèle de langue comme juge).
People
People give a score, choose the better of two translations (Jurafsky & Martin, 2026), or annotate data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. the errors with a scheme, for instance MQM (Freitag et al., 2021) or ESA (Kocmi et al., 2024a). Their judgement is the standard the other methods are measured against, with two limits:
- Raters disagree, since a source can be ambiguous and raters know different things and use scales differently; evaluations remove outlier raters and normalize their scores (Jurafsky & Martin, 2026).
- Who judges changes the result: professional translators and crowd workers ranked the same systems differently (Freitag et al., 2021) (see also the Human evaluation: DA, MQM and ESA page) (voir aussi la page L'évaluation humaine : DA, MQM et ESA).
Comparing the methods
The table below compares the three families on eight criteria, with the automatic metrics split in two. A reference translation for every test sentence is expensive, and for some language pairs and domains there is none, so the need for a reference often decides which methods can be used at all.
| Surface metrics | Semantic and learned metrics | Large language model as judge | People | |
|---|---|---|---|---|
| Reference needed | yes | yes for most; quality estimation works without | optional | no for error annotation; optional for scores and comparisons |
| Basis of the judgement | shared words or characters | closeness in meaning, or a predicted human score | whatever the prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. asks for | adequacy, fluency, errors |
| Detail of the result | one score per sentence or test set test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. | one score; some metrics also mark error spans | a score, a list of errors, or both | errors with type and severity, or a score |
| Agreement with people | below learned metrics in 2021 (Kocmi et al., 2021); among the best on single sentences in 2025 (Lavie et al., 2025) | above surface metrics in 2021; on single sentences in 2025, BERTScore among the best, most learned metrics behind | the best at ranking systems in 2025, less reliable per sentence | the standard the others are measured against, with disagreement between people |
| Explainability | yes: the count can be redone by hand | no: a model’s output | partly: the model gives reasons, but they are generated too | yes |
| Reuse on new output | yes, at no cost, once the reference exists | yes, at the cost of running the model | yes, but another model or prompt gives other scores | no: every new output needs new judgements |
| Cost | negligible | a model to run | a model to call, per sentence | high: time and expertise |
| Robustness across languages, domains and paraphrases | sensitive to tokenization tokenization¹segmentation en unités lexicales linguisticslinguistique The process of dividing running text into individual units that can be counted, annotated or analyzed.Processus de découpage d'un texte suivi en unités individuelles pouvant être comptées, annotées ou analysées. and morphology | depends on the languages the model was trained on | sensitive to the prompt, with known biases | depends on the raters and the instructions |
Scores are not comparable across test sets or language pairs, even from the same metric: a score depends on the texts and the language pair as well as on the translation (Kocmi et al., 2021, 2025) (see also the Reading the scores page) (voir aussi la page Lire les scores).
Purposes of an evaluation
Which method fits depends partly on what the evaluation is for. Machine translation is evaluated for several purposes:
- to compare systems, as WMT does every year, and as a company does before choosing a system;
- to guide development, where a fast automatic score shows whether a change helped;
- to find errors, which needs more than a score: where the errors are, of what kind, and how serious;
- to decide what the output can be used for: good enough to understand a web page is not always good enough to publish, and the question is answered mainly by reading the output.
Les méthodes d’évaluation d’une traduction
Les quatre façons d’évaluer un système, quel qu’il soit (comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , comparaison par paires, notation et annotation des erreurs), sont expliquées dans le chapitre sur les fondements (see also the Ways of evaluating page) (voir aussi la page Les façons d'évaluer). En traduction, l’étalon de référence est une traduction de référence, et la comparaison avec celle-ci comme la notation donnent un score : la
Figure 3figure 3réunit donc les deux. Ses couleurs montrent que de nombreuses méthodes peuvent fonctionner avec ou sans référence.
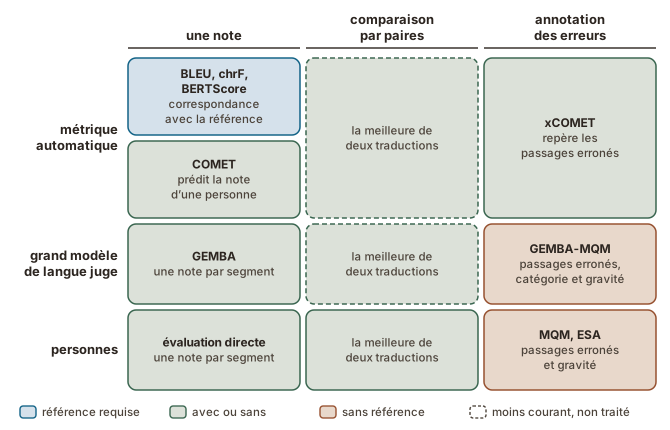
Les lignes de la figure correspondent aux trois familles de méthodes :
- Les métriques automatiques : un programme calcule le score, et une même entrée reçoit toujours le même score.
- Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. comme juge : un modèle généraliste reçoit la consigne de juger la traduction.
- Des personnes : des évaluateurs jugent eux-mêmes la traduction.
Les métriques automatiques
Les métriques automatiques diffèrent par ce qu’elles comparent. On en distingue trois grands types :
- les métriques de surface comptent les mots ou les caractères que la sortie partage avec la référence, par exemple BLEU (Papineni et al., 2002) et chrF (Popović, 2015) ;
- les métriques sémantiques comparent le sens de la sortie et de la référence au moyen de plongements contextuels contextual embeddingplongement contextuel embeddingsplongements A numerical representation generated for a particular occurrence of a token by taking account of the other tokens available to the model.Représentation numérique générée pour une occurrence particulière d'un jeton en tenant compte des autres jetons accessibles au modèle. , par exemple BERTScore (Zhang et al., 2020) ;
- les métriques apprises sont entraînées sur des jugements humains pour prédire le score qu’une personne donnerait, par exemple COMET (Rei et al., 2020) ; certaines fonctionnent sans référence, ce qu’on appelle l’estimation de la qualité.
Une métrique est elle aussi un système, et elle est évaluée par rapport à des personnes : ses scores sont comparés avec des jugements humains portant sur les mêmes traductions, à la fois quand elle classe des systèmes entiers et quand elle note des phrases isolées. WMT, la Conference on Machine Translation, organise chaque année une tâche partagée shared tasktâche partagée evaluationévaluation A public evaluation exercise in which every participating team is given the same task, the same data and the same scoring, so that their systems can be compared directly.Exercice d'évaluation public où toutes les équipes participantes reçoivent la même tâche, les mêmes données et la même notation, de sorte que leurs systèmes se comparent directement. de ce type. Deux études montrent comment les résultats ont évolué :
- En 2021, sur la plus grande collection de jugements humains alors disponible, les métriques apprises classaient des paires de systèmes plus comme les personnes que les métriques de surface (Kocmi et al., 2021).
- En 2025, les grands modèles de langue employés comme juges étaient les meilleurs pour classer des systèmes entiers. Sur des phrases isolées, des métriques simples qui comparent la sortie avec une référence, de surface comme chrF ou fondées sur des plongements comme BERTScore, comptaient parmi les meilleures, devant la plupart des métriques apprises et des modèles juges ; seuls un modèle juge et une métrique apprise les égalaient ou les dépassaient. Les organisateurs qualifient ce résultat de surprenant (Lavie et al., 2025).
Les grands modèles de langue comme juges
Un grand modèle de langue employé comme juge reçoit la source, la sortie, la référence s’il y en a une, et une consigne qui dit quoi juger et sous quelle forme répondre (Kocmi & Federmann, 2023a). Il peut donner un score, une liste d’erreurs avec leur catégorie et leur gravité, ou les deux.
- Les modèles juges classent bien des systèmes entiers, mais la plupart notent les phrases isolées de façon moins fiable, comme le montrent les résultats de 2025 ci-dessus.
- Le jugement change avec la formulation de la requête et avec le modèle, et un même modèle interrogé deux fois peut répondre différemment (see also the A large language model as judge page) (voir aussi la page Un grand modèle de langue comme juge).
Les personnes
Les personnes donnent un score, choisissent la meilleure de deux traductions (Jurafsky & Martin, 2026) ou annotent data annotationannotation des données datadonnées The process of adding labels or other structured information, such as categories, tags, transcriptions, or marked regions, to data so that it can be used to train or evaluate a machine learning system.Processus consistant à ajouter aux données des étiquettes ou d'autres informations structurées, comme des catégories, des balises, des transcriptions ou des zones marquées, pour qu'elles puissent servir à entraîner ou à évaluer un système d'apprentissage automatique. les erreurs selon un système de classement, par exemple MQM (Freitag et al., 2021) ou ESA (Kocmi et al., 2024a). Leur jugement est la norme à laquelle les autres méthodes sont mesurées, avec deux limites :
- Les évaluateurs ne sont pas toujours d’accord, parce qu’une source peut être ambiguë et que les évaluateurs n’ont pas les mêmes connaissances ni la même façon d’utiliser une échelle ; les évaluations écartent les évaluateurs aberrants et normalisent leurs scores (Jurafsky & Martin, 2026).
- Le choix des évaluateurs change le résultat : des traducteurs professionnels et des travailleurs de la production participative ont classé les mêmes systèmes différemment (Freitag et al., 2021) (see also the Human evaluation: DA, MQM and ESA page) (voir aussi la page L'évaluation humaine : DA, MQM et ESA).
Les méthodes comparées
Le tableau ci-dessous compare les trois familles selon huit critères, en séparant les métriques automatiques en deux. Une traduction de référence pour chaque phrase de test coûte cher, et pour certaines paires de langues et certains domaines il n’en existe pas : la nécessité d’une référence décide donc souvent des méthodes qui peuvent être employées.
| Métriques de surface | Métriques sémantiques et apprises | Grand modèle de langue comme juge | Personnes | |
|---|---|---|---|---|
| Référence nécessaire | oui | oui pour la plupart ; l’estimation de la qualité s’en passe | facultative | non pour l’annotation des erreurs ; facultative pour les scores et les comparaisons |
| Fondement du jugement | mots ou caractères partagés | proximité de sens, ou score humain prédit | ce que demande la requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. | adéquation, fluidité, erreurs |
| Précision du résultat | un score par phrase ou par jeu de test test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. | un score ; certaines métriques marquent aussi des passages erronés | un score, une liste d’erreurs, ou les deux | des erreurs avec type et gravité, ou un score |
| Accord avec les personnes | inférieur aux métriques apprises en 2021 (Kocmi et al., 2021) ; parmi les meilleurs sur des phrases isolées en 2025 (Lavie et al., 2025) | supérieur aux métriques de surface en 2021 ; sur des phrases isolées en 2025, BERTScore parmi les meilleures, la plupart des métriques apprises derrière | le meilleur pour classer des systèmes en 2025, moins fiable par phrase | la norme à laquelle les autres sont mesurées, avec des désaccords entre personnes |
| Explicabilité | oui : le comptage peut être refait à la main | non : c’est la sortie d’un modèle | en partie : le modèle donne des raisons, mais elles sont générées elles aussi | oui |
| Réemploi sur une nouvelle sortie | oui, sans frais, une fois la référence disponible | oui, au prix de l’exécution du modèle | oui, mais un autre modèle ou une autre requête donne d’autres scores | non : chaque nouvelle sortie demande de nouveaux jugements |
| Coût | négligeable | un modèle à exécuter | un modèle à interroger, phrase par phrase | élevé : du temps et de l’expertise |
| Robustesse selon les langues, les domaines et les paraphrases | sensibles à la segmentation en unités lexicales tokenization¹segmentation en unités lexicales linguisticslinguistique The process of dividing running text into individual units that can be counted, annotated or analyzed.Processus de découpage d'un texte suivi en unités individuelles pouvant être comptées, annotées ou analysées. et à la morphologie | dépend des langues sur lesquelles le modèle a été entraîné | sensible à la requête, avec des biais connus | dépend des évaluateurs et des consignes |
Les scores ne sont pas comparables d’un jeu de test ou d’une paire de langues à l’autre, même pour une même métrique : un score dépend des textes et de la paire de langues autant que de la traduction (Kocmi et al., 2021, 2025) (see also the Reading the scores page) (voir aussi la page Lire les scores).
Les buts d’une évaluation
La méthode qui convient dépend en partie de ce à quoi sert l’évaluation. La traduction automatique est évaluée à plusieurs fins :
- pour comparer des systèmes, comme le fait WMT chaque année, et comme le fait une entreprise avant de choisir un système ;
- pour guider le développement, où un score automatique rapide montre si une modification a aidé ;
- pour trouver les erreurs, ce qui demande plus qu’un score : où sont les erreurs, de quel type, et quelle est leur gravité ;
- pour décider de l’usage possible de la sortie : assez bonne pour comprendre une page Web ne veut pas toujours dire assez bonne pour être publiée, et la question se tranche surtout en lisant la sortie.
Sources
- Freitag, M., Foster, G., Grangier, D., Ratnakar, V., Tan, Q., & Macherey, W. (2021). Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation. Transactions of the Association for Computational Linguistics, 9, 1460–1474. https://doi.org/10.1162/tacl_a_00437
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., & Federmann, C. (2023a). GEMBA-MQM: Detecting Translation Quality Error Spans with GPT-4. Proceedings of the Eighth Conference on Machine Translation (WMT 2023), 768–775. https://doi.org/10.18653/v1/2023.wmt-1.64
- Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
- Kocmi, T., Federmann, C., Grundkiewicz, R., Junczys-Dowmunt, M., Matsushita, H., & Menezes, A. (2021). To Ship or Not to Ship: An Extensive Evaluation of Automatic Metrics for Machine Translation. Proceedings of the Sixth Conference on Machine Translation (WMT 2021), 478–494. https://aclanthology.org/2021.wmt-1.57/
- Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131
- Lavie, A., Hanneman, G., Agrawal, S., Kanojia, D., Lo, C., Zouhar, V., et al. (2025). Findings of the WMT25 Shared Task on Automated Translation Evaluation Systems: Linguistic Diversity is Challenging and References Still Help. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 436–483. https://doi.org/10.18653/v1/2025.wmt-1.24
- Papineni, K., Roukos, S., Ward, T., & Zhu, W.-J. (2002). BLEU: a method for automatic evaluation of machine translation. Proceedings of the 40th Annual Meeting of the Association for Computational Linguistics (ACL 2002), Philadelphia, 311–318. https://doi.org/10.3115/1073083.1073135
- Popović, M. (2015). chrF: character n-gram F-score for automatic MT evaluation. Proceedings of the Tenth Workshop on Statistical Machine Translation (WMT 2015), Lisbon, 392–395. https://doi.org/10.18653/v1/W15-3049
- Rei, R., Stewart, C., Farinha, A. C., & Lavie, A. (2020). COMET: A Neural Framework for MT Evaluation. Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP 2020), 2685–2702. https://doi.org/10.18653/v1/2020.emnlp-main.213
- Zhang, T., Kishore, V., Wu, F., Weinberger, K. Q., & Artzi, Y. (2020). BERTScore: Evaluating Text Generation with BERT. Eighth International Conference on Learning Representations (ICLR 2020). http://arxiv.org/abs/1904.09675