Fine-tuning: from generator to assistant
machine learning apprentissage automatique Definition Définition · fine-tuning affinage · fr: affinage · en : fine-tuning
Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. (Jurafsky & Martin, 2026, p. 210 )
Notes Remarques Fine-tuning may adjust all the model's parameters or only a selected subset and generally requires much less data and computation than pretraining. L'affinage peut ajuster tous les paramètres du modèle ou seulement une partie, et demande généralement beaucoup moins de données et de calcul que le préentraînement.
Other attested French terms: réglage fin, peaufinage Autres termes français attestés : réglage fin, peaufinage
Fine-tuning: from generator to assistant
What pretraining and fine-tuning cost
pretraining : an immense amount of text, collected in bulk; most of the cost is computation fine-tuning : far less data, each example chosen or written with care ; little computationit changes how the model behaves far more than what it knows
The numbers, if asked: 60 petaflop/s-days for the largest InstructGPT model
against 3,640 for pretraining GPT-3.
Fine-tuning: from generator to assistant
Fine-tuning against size
a model of 1.3 billion parameters, fine-tuned
preferred by people to GPT-3 at 175 billion , not fine-tuned, on the requests users sent
more than a hundred times smaller
Key points L'essentiel
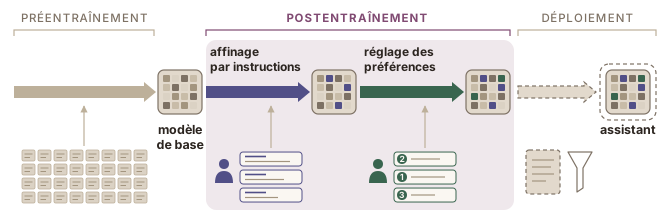
LLM chatbots typically go through four stages: pretraining produces a base model, two stages of fine-tuning make it answer and shape how it answers, and deployment adds instructions and filters around it without changing it.
The fine-tuning stages after pretraining are together called post-training.
From pretraining to deployment
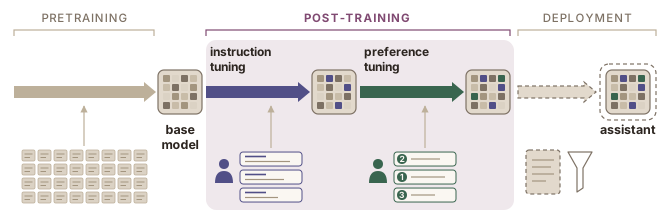
Figure 1. From pretraining to the assistant you type into.
Pretraining pre-training préentraînement language models modèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses. Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. .base model base model modèle de base language models modèles de langue A language model that has completed pretraining but has not yet undergone post-training. Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. : it continues text and does not reliably follow instructions.Instruction tuning instruction tuning affinage par instructions language models modèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. .Preference tuning preference tuning réglage des préférences language models modèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. .Deployment. System prompts system prompt requête générative système prompting requêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction. Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. , safety filters and other machinery around the model, changing nothing in its parameters (see also the Alignment page) (voir aussi la page L'alignement ) .
computing informatique Definition Définition · deployment déploiement · fr: déploiement · en : deployment
Putting a system into operation where it will be used: installing it with what it needs to run and making it available to its users. For an AI system, it means making a trained model available to people, for instance behind an application or a chat interface. Mise en service d'un système là où il sera utilisé : son installation, avec ce dont il a besoin pour fonctionner, et sa mise à la disposition de ses utilisateurs. Pour un système d'IA, il s'agit de rendre un modèle entraîné accessible aux personnes, par exemple derrière une application ou une interface conversationnelle. (Jackson & Gallagher, 2026 ; Tabassi, 2023, Appendix A )
Notes Remarques For a language model, deployment changes nothing in its parameters: system prompts, output filters and access rules are set around the model, and they can be changed far more often than the model itself. Deployment tasks include piloting the system, checking compatibility with existing systems and ensuring regulatory compliance (Tabassi, 2023). Pour un modèle de langue, le déploiement ne change rien à ses paramètres : les requêtes génératives système, les filtres de sortie et les règles d'accès sont placés autour du modèle, et on peut les changer bien plus souvent que le modèle lui-même. Les tâches de déploiement comprennent la mise à l'essai du système, la vérification de sa compatibilité avec les systèmes existants et le respect de la réglementation (Tabassi, 2023).
Post-training
Stages 2 and 3 are both forms of fine-tuning fine-tuning affinage machine learning apprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. , and
together the field calls them post-training. Many current models add a third
post-training stage,
reinforcement learning with verifiable rewards reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) language models modèles de langue A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement.
(Jurafsky & Martin, 2026) (see also the RLVR: learning from answers that can be checked page) (voir aussi la page L'ARV : apprendre à partir de réponses vérifiables ) .
The two terms are not synonyms: fine-tuning is the technique, and it is also
used outside post-training, for instance to adapt an existing model to one
organization’s texts.
language models modèles de langue Definition Définition · post-training postentraînement · fr: postentraînement · en : post-training
Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. (Jurafsky & Martin, 2026, pp. 209–223 )
Notes Remarques For modern language models, post-training may include instruction tuning, preference tuning and reinforcement learning with verifiable rewards. These stages can make a base model better at following instructions, producing preferred responses or solving particular kinds of problems. Post-training is an umbrella term, and organizations do not necessarily use the same stages or sequence. In-context learning and ordinary prompting are not post-training, because they do not update the model's parameters. In some engineering contexts, post-training is used more broadly for processes applied after training, such as quantization; this entry concerns post-training as a stage in developing language models. Pour les modèles de langue modernes, il peut comprendre l'affinage par instructions, le réglage des préférences et l'apprentissage par renforcement avec récompenses vérifiables. Ces étapes peuvent rendre un modèle de base plus apte à suivre des instructions, à produire des réponses préférées ou à résoudre certains types de problèmes. Postentraînement est un terme générique, et les organisations n'utilisent pas nécessairement les mêmes étapes ni le même ordre. L'apprentissage en contexte et la requête ordinaire ne relèvent pas du postentraînement, car ils ne modifient pas les paramètres du modèle. Dans certains contextes techniques, le terme s'emploie plus largement pour des traitements postérieurs à l'entraînement, comme la quantification ; la présente entrée vise le postentraînement comme étape du développement des modèles de langue.
The four stages from pretraining to assistant
computing informatique Definition Définition · deployment déploiement · fr: déploiement · en : deployment
Putting a system into operation where it will be used: installing it with what it needs to run and making it available to its users. For an AI system, it means making a trained model available to people, for instance behind an application or a chat interface. Mise en service d'un système là où il sera utilisé : son installation, avec ce dont il a besoin pour fonctionner, et sa mise à la disposition de ses utilisateurs. Pour un système d'IA, il s'agit de rendre un modèle entraîné accessible aux personnes, par exemple derrière une application ou une interface conversationnelle. (Jackson & Gallagher, 2026 ; Tabassi, 2023, Appendix A )
Notes Remarques For a language model, deployment changes nothing in its parameters: system prompts, output filters and access rules are set around the model, and they can be changed far more often than the model itself. Deployment tasks include piloting the system, checking compatibility with existing systems and ensuring regulatory compliance (Tabassi, 2023). Pour un modèle de langue, le déploiement ne change rien à ses paramètres : les requêtes génératives système, les filtres de sortie et les règles d'accès sont placés autour du modèle, et on peut les changer bien plus souvent que le modèle lui-même. Les tâches de déploiement comprennent la mise à l'essai du système, la vérification de sa compatibilité avec les systèmes existants et le respect de la réglementation (Tabassi, 2023).
The four stages from pretraining to assistant
language models modèles de langue Definition Définition · post-training postentraînement · fr: postentraînement · en : post-training
Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. (Jurafsky & Martin, 2026, pp. 209–223 )
Notes Remarques For modern language models, post-training may include instruction tuning, preference tuning and reinforcement learning with verifiable rewards. These stages can make a base model better at following instructions, producing preferred responses or solving particular kinds of problems. Post-training is an umbrella term, and organizations do not necessarily use the same stages or sequence. In-context learning and ordinary prompting are not post-training, because they do not update the model's parameters. In some engineering contexts, post-training is used more broadly for processes applied after training, such as quantization; this entry concerns post-training as a stage in developing language models. Pour les modèles de langue modernes, il peut comprendre l'affinage par instructions, le réglage des préférences et l'apprentissage par renforcement avec récompenses vérifiables. Ces étapes peuvent rendre un modèle de base plus apte à suivre des instructions, à produire des réponses préférées ou à résoudre certains types de problèmes. Postentraînement est un terme générique, et les organisations n'utilisent pas nécessairement les mêmes étapes ni le même ordre. L'apprentissage en contexte et la requête ordinaire ne relèvent pas du postentraînement, car ils ne modifient pas les paramètres du modèle. Dans certains contextes techniques, le terme s'emploie plus largement pour des traitements postérieurs à l'entraînement, comme la quantification ; la présente entrée vise le postentraînement comme étape du développement des modèles de langue.
Instruction tuning: learning from examples
One pair
Prompt: Explain photosynthesis to a 10-year-old.
Response: Photosynthesis is how plants make their own food using
sunlight. Think of leaves as tiny factories that take in sunlight, water
and air…
Instruction tuning: learning from examples
language models modèles de langue Definition Définition · supervised fine-tuning (SFT) affinage supervisé · fr: affinage supervisé · en : supervised fine-tuning
Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. (Jurafsky & Martin, 2026, pp. 209–211 )
Notes Remarques For LLMs, SFT often uses instruction-and-response examples, in which case it is also called instruction tuning. Instruction tuning is a common subtype of SFT, but SFT can also be used for classification, domain adaptation, and other labelled tasks. Pour les GML, il s'appuie souvent sur des exemples d'instructions et de réponses, auquel cas on parle aussi d'affinage par instructions. Ce dernier en est un sous-type courant, mais l'affinage supervisé sert aussi à la classification, à l'adaptation à un domaine et à d'autres tâches étiquetées.
Other attested French terms: affinage par apprentissage supervisé, peaufinage par apprentissage supervisé Autres termes français attestés : affinage par apprentissage supervisé, peaufinage par apprentissage supervisé
Instruction tuning: learning from examples
language models modèles de langue Definition Définition · instruction tuning affinage par instructions · fr: affinage par instructions · en : instruction tuning
A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. (Jurafsky & Martin, 2026, p. 210 )
Notes Remarques This makes the model better able to follow instructions across a range of tasks, including tasks not represented exactly in the training examples. Le modèle devient ainsi plus apte à suivre des instructions dans un éventail de tâches, y compris des tâches qui ne figurent pas exactement dans les exemples d'entraînement.
Other attested English terms: instruction fine-tuning Autres termes anglais attestés : instruction fine-tuning
Key points L'essentiel
The model is trained on pairs of an instruction and a good answer, until it treats a request as something to answer rather than something to continue.
There are far fewer of these pairs than there are documents in pretraining, so each one matters: a sloppy example teaches a sloppy manner.
Showing the model what a good answer looks like
Instruction tuning is done by giving pairs of examples: instructions and
responses. One half is an instruction, the kind of thing a user would actually
type, which in this context is called a
prompt prompt requête prompting requêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output. Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. . The other half is a response worth imitating.
Prompt: Explain photosynthesis to a 10-year-old.
Response: Photosynthesis is how plants make their own food using sunlight.
Think of leaves as tiny factories that take in sunlight, water and air…
language models modèles de langue Definition Définition · supervised fine-tuning (SFT) affinage supervisé · fr: affinage supervisé · en : supervised fine-tuning
Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. (Jurafsky & Martin, 2026, pp. 209–211 )
Notes Remarques For LLMs, SFT often uses instruction-and-response examples, in which case it is also called instruction tuning. Instruction tuning is a common subtype of SFT, but SFT can also be used for classification, domain adaptation, and other labelled tasks. Pour les GML, il s'appuie souvent sur des exemples d'instructions et de réponses, auquel cas on parle aussi d'affinage par instructions. Ce dernier en est un sous-type courant, mais l'affinage supervisé sert aussi à la classification, à l'adaptation à un domaine et à d'autres tâches étiquetées.
Other attested French terms: affinage par apprentissage supervisé, peaufinage par apprentissage supervisé Autres termes français attestés : affinage par apprentissage supervisé, peaufinage par apprentissage supervisé
Training on enough of these teaches a pattern that pretraining rarely presented
so consistently:
an instruction is followed by a response to it. Thus, the text completion system becomes a question answering system.
language models modèles de langue Definition Définition · instruction tuning affinage par instructions · fr: affinage par instructions · en : instruction tuning
A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. (Jurafsky & Martin, 2026, p. 210 )
Notes Remarques This makes the model better able to follow instructions across a range of tasks, including tasks not represented exactly in the training examples. Le modèle devient ainsi plus apte à suivre des instructions dans un éventail de tâches, y compris des tâches qui ne figurent pas exactement dans les exemples d'entraînement.
Other attested English terms: instruction fine-tuning Autres termes anglais attestés : instruction fine-tuning
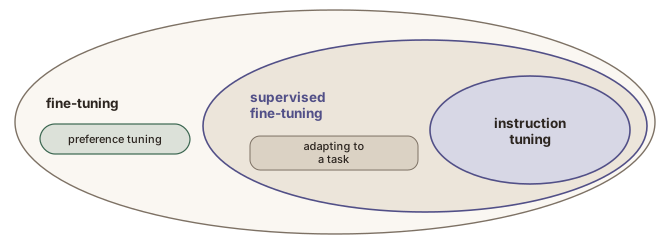
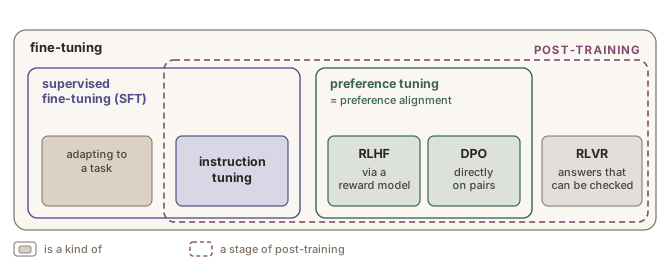
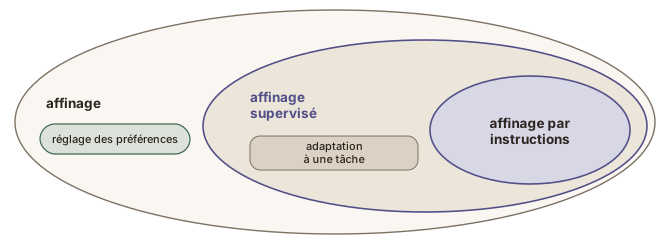
Instruction tuning is one kind of supervised fine-tuning, which is itself one
kind of fine-tuning. Supervised fine-tuning is also used outside assistants, to
adapt a model to a task, such as translating with one organization’s terminology
from its translation memory translation memory (TM) mémoire de traduction (MT) CAT tools TAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text. Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. .
Figure 2. How the three names nest.
The term instruction tuning was introduced by Wei et al. (2022), who fine-tuned a pretrained model on
more than 60 datasets phrased as instructions and found that it could then follow
instructions for tasks it had not seen.
Small data, chosen carefully
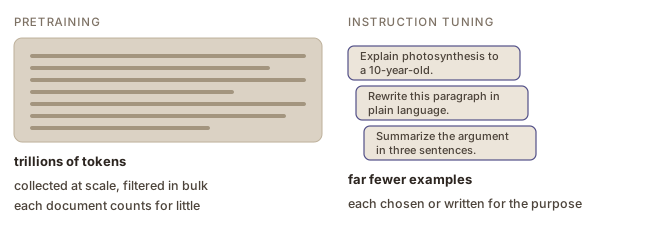
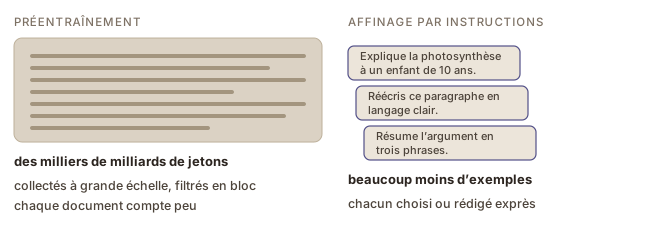
Figure 3. Where the two kinds of training data come from, and what each is judged on.
Pretraining text was written by people too, but not for this purpose, and it is
filtered in bulk. Instruction-tuning examples are chosen or written for the
behaviour wanted. For InstructGPT, that meant about 13 000 prompts
with answers written by hired labellers (Ouyang et al., 2022). Later sets also
reuse questions and answers from community sites (Zhou et al., 2023) and
instructions and answers generated by a model, then filtered (Wang et al., 2023).
Quality counts for more than quantity here: a thousand carefully chosen examples
can be enough: doubling their number did not improve the answers, and filtering
them for quality did (Zhou et al., 2023). The authors take this as a sign that
the model learns a manner rather than a subject.
Where the examples are written for the purpose, the work is often paid: Ouyang et al.
(2022) recruited and screened about 40 labellers for it.
Not quite the helpful assistant chatbot yet
After this stage the model answers questions and can keep up a
conversation. Its finer judgement goes only as far as its examples showed it: how long an
answer should be, when to say it is unsure, when a request should be declined. Those
qualities are easy to recognize in a response and hard to specify in advance.
The data, if asked: for InstructGPT, about 13,000 prompts with answers written
by hired labellers, about 40 of them, recruited and screened. Later sets also
reuse questions and answers from community sites, and answers generated by a
model and then filtered. The term was introduced by Wei et al. (2022): a pretrained model fine-tuned on
more than 60 datasets phrased as instructions could then
follow instructions for tasks it had not seen.
Instruction tuning: learning from examples
Not quite the helpful assistant chatbot yet The model answers; its judgement goes only as far as its examples:
how long an answer should bewhen to say it is unsurewhen to decline a request Easy to recognize, hard to specify in advance.
Ranking instead of writing
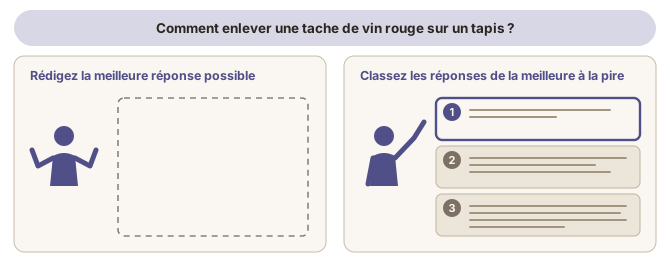
Some things about a good answer are easy to judge and hard to state. Asked
whether this response or that one is better, an annotator can answer quickly;
asked to write down the rule they applied, they would find it far harder.
Preference tuning uses that asymmetry. Rather than asking people to produce
the ideal answer, it asks them to put several of the model’s own answers in
order. The rankings are not perfectly consistent: the labellers of Ouyang et al.
(2022) agreed with each other on about 73% of comparisons. Each ranking is then
split into pairs: four answers in order give six pairs, each made of a better and
a worse answer.
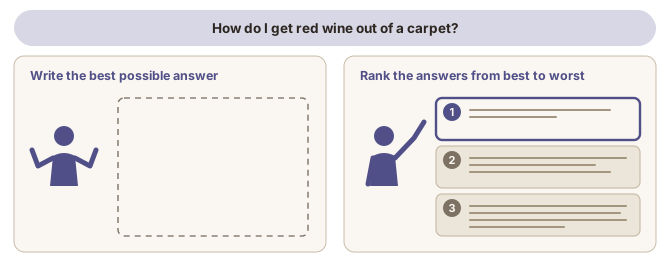
Figure 4. It is often much easier to put concrete options in order, from best to worst, than to write the best possible answer yourself.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
The two best-known methods are reinforcement learning from human feedback (RLHF)
and direct preference optimization (DPO) (Jurafsky & Martin, 2026).
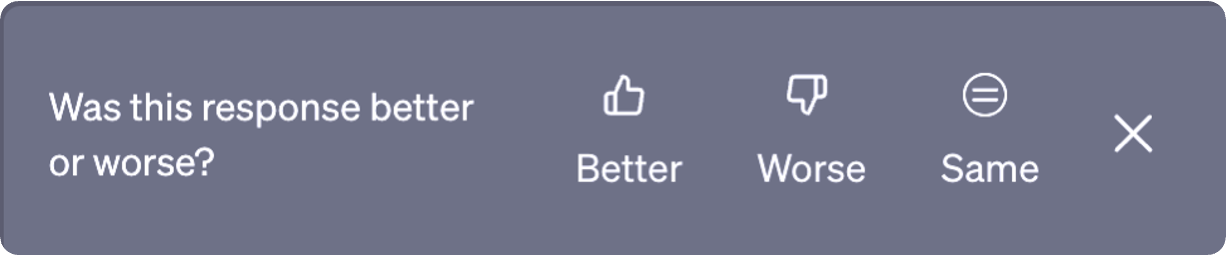
Figure 5. ChatGPT asking whether a response was better or worse (screenshot, 10 September 2026 ).
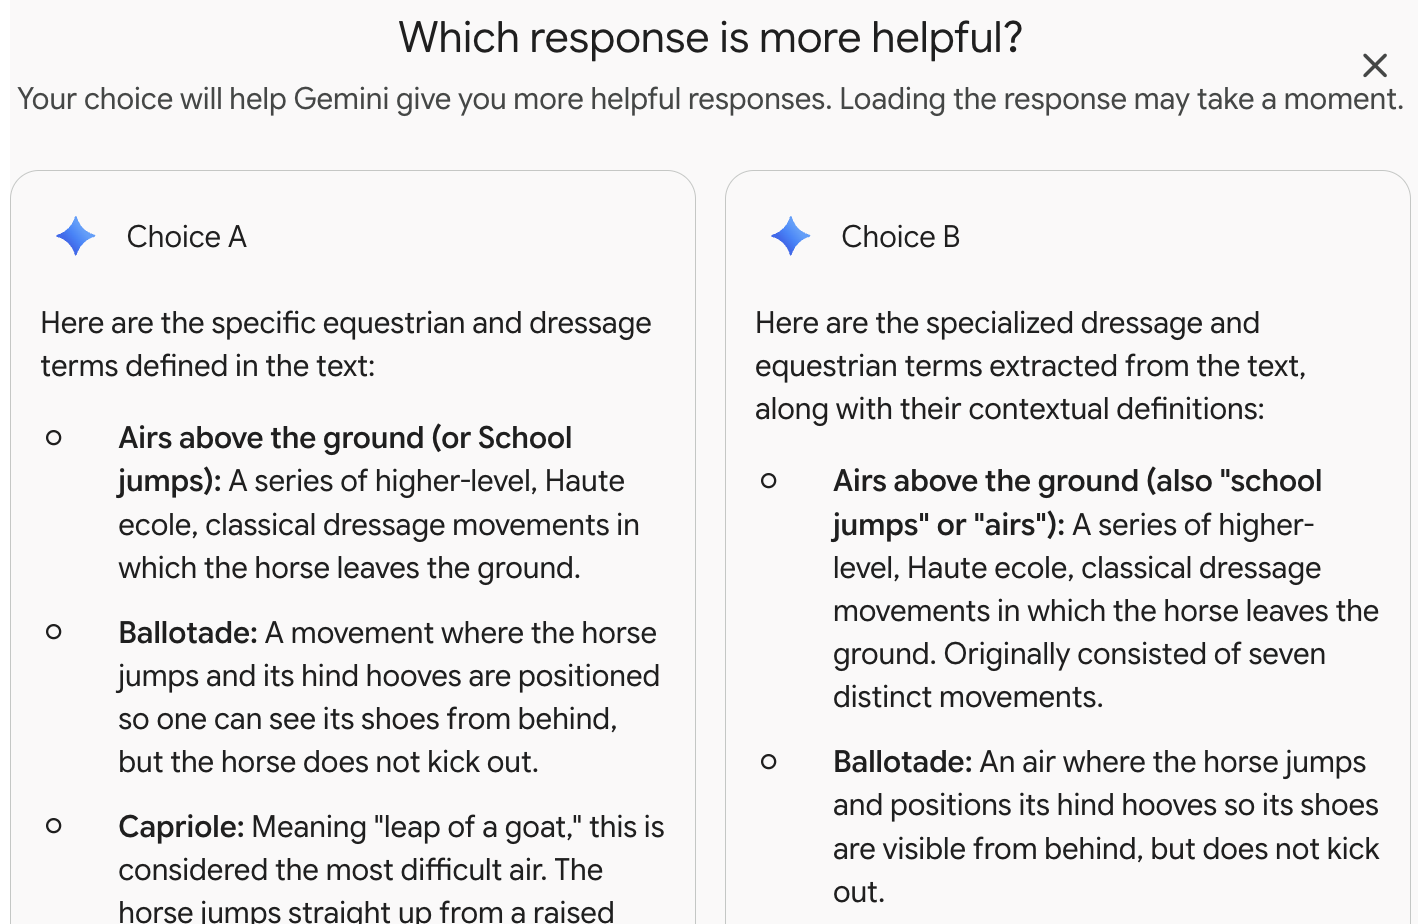
Figure 6. Gemini showing two answers to one request and asking which is more helpful (screenshot, 1 October 2026 ).
RLHF: a reward model stands in for the people
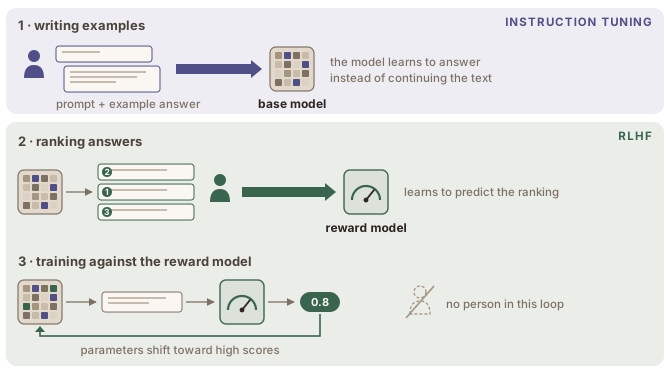
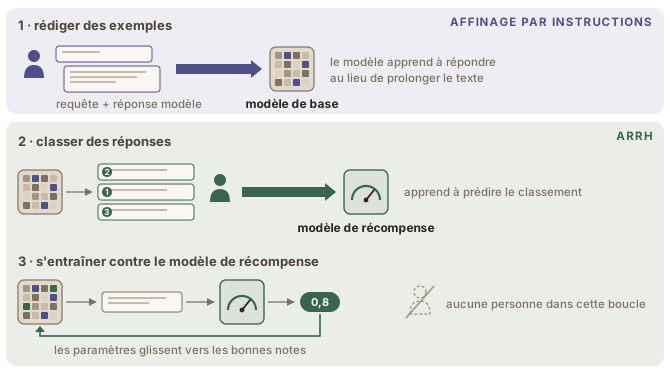
Figure 7. Post-training an LLM: instruction tuning, then RLHF.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
The reward model is the piece that makes the scale possible. Human rankings are
slow and expensive to collect, so a separate network is trained to imitate them,
and the language model is then trained against that imitation, round after round. In each round, the model writes a new answer, the reward
model gives that answer a score, and the model’s parameters parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. shift toward answers
that score higher. A penalty keeps the model close to where it started: pushed
too far, it learns to please the reward model rather than the people behind it
(Ouyang et al., 2022).
The comparisons do not have to come from people: in a method its authors call
Constitutional AI, a model compares answers for harmfulness against a written list of principles,
and those comparisons, with human ones for helpfulness, train the reward model
(Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
The method predates large language models large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) trained systems
from human comparisons of short behaviour clips, in a method designed for goals that are hard to write down.
DPO: learning from the ranked pairs directly
Direct preference optimization direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées.
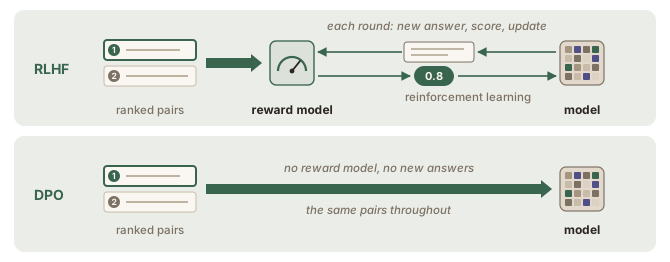
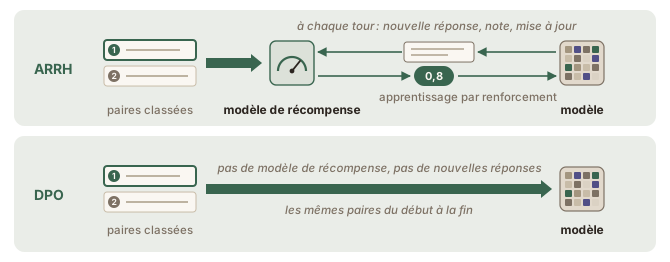
(DPO) starts from the same ranked pairs but uses no reward model (Rafailov et
al., 2023). The pairs are collected before training and stay the same
throughout: the model writes no new answers while it learns. For each pair, its
parameters are adjusted so that the preferred answer becomes more probable and
the rejected one less probable.
DPO is therefore closer to supervised
learning supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. than to reinforcement learning (Jurafsky & Martin, 2026), but it
is not supervised fine-tuning supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : the model
learns from a comparison between two answers, not from an answer to imitate.
Figure 8. The same ranked pairs, used in two ways.
Preference tuning: learning from rankings
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
Ranking instead of writing
Some things about a good answer are easy to judge and hard to state. Asked
whether this response or that one is better, an annotator can answer quickly;
asked to write down the rule they applied, they would find it far harder.
Preference tuning uses that asymmetry. Rather than asking people to produce
the ideal answer, it asks them to put several of the model’s own answers in
order. The rankings are not perfectly consistent: the labellers of Ouyang et al.
(2022) agreed with each other on about 73% of comparisons. Each ranking is then
split into pairs: four answers in order give six pairs, each made of a better and
a worse answer.
Figure 4. It is often much easier to put concrete options in order, from best to worst, than to write the best possible answer yourself.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
The two best-known methods are reinforcement learning from human feedback (RLHF)
and direct preference optimization (DPO) (Jurafsky & Martin, 2026).
Figure 5. ChatGPT asking whether a response was better or worse (screenshot, 10 September 2026 ).
Figure 6. Gemini showing two answers to one request and asking which is more helpful (screenshot, 1 October 2026 ).
RLHF: a reward model stands in for the people
Figure 7. Post-training an LLM: instruction tuning, then RLHF.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
The reward model is the piece that makes the scale possible. Human rankings are
slow and expensive to collect, so a separate network is trained to imitate them,
and the language model is then trained against that imitation, round after round. In each round, the model writes a new answer, the reward
model gives that answer a score, and the model’s parameters parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. shift toward answers
that score higher. A penalty keeps the model close to where it started: pushed
too far, it learns to please the reward model rather than the people behind it
(Ouyang et al., 2022).
The comparisons do not have to come from people: in a method its authors call
Constitutional AI, a model compares answers for harmfulness against a written list of principles,
and those comparisons, with human ones for helpfulness, train the reward model
(Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
The method predates large language models large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) trained systems
from human comparisons of short behaviour clips, in a method designed for goals that are hard to write down.
DPO: learning from the ranked pairs directly
Direct preference optimization direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées.
(DPO) starts from the same ranked pairs but uses no reward model (Rafailov et
al., 2023). The pairs are collected before training and stay the same
throughout: the model writes no new answers while it learns. For each pair, its
parameters are adjusted so that the preferred answer becomes more probable and
the rejected one less probable.
DPO is therefore closer to supervised
learning supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. than to reinforcement learning (Jurafsky & Martin, 2026), but it
is not supervised fine-tuning supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : the model
learns from a comparison between two answers, not from an answer to imitate.
Figure 8. The same ranked pairs, used in two ways.
The asymmetry the method relies on: asked which of two answers is better, an
annotator can answer quickly; asked to write down the rule they applied, they
would find it far harder. They do not always agree: about 73% of comparisons
in Ouyang et al. (2022). Each ranking is split into pairs: four ranked answers
give six. The better-or-worse question collects a comparison from users; the thumbs
collect a judgement of one answer.
Ranking instead of writing
Some things about a good answer are easy to judge and hard to state. Asked
whether this response or that one is better, an annotator can answer quickly;
asked to write down the rule they applied, they would find it far harder.
Preference tuning uses that asymmetry. Rather than asking people to produce
the ideal answer, it asks them to put several of the model’s own answers in
order. The rankings are not perfectly consistent: the labellers of Ouyang et al.
(2022) agreed with each other on about 73% of comparisons. Each ranking is then
split into pairs: four answers in order give six pairs, each made of a better and
a worse answer.
Figure 4. It is often much easier to put concrete options in order, from best to worst, than to write the best possible answer yourself.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
The two best-known methods are reinforcement learning from human feedback (RLHF)
and direct preference optimization (DPO) (Jurafsky & Martin, 2026).
Figure 5. ChatGPT asking whether a response was better or worse (screenshot, 10 September 2026 ).
Figure 6. Gemini showing two answers to one request and asking which is more helpful (screenshot, 1 October 2026 ).
RLHF: a reward model stands in for the people
Figure 7. Post-training an LLM: instruction tuning, then RLHF.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
The reward model is the piece that makes the scale possible. Human rankings are
slow and expensive to collect, so a separate network is trained to imitate them,
and the language model is then trained against that imitation, round after round. In each round, the model writes a new answer, the reward
model gives that answer a score, and the model’s parameters parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. shift toward answers
that score higher. A penalty keeps the model close to where it started: pushed
too far, it learns to please the reward model rather than the people behind it
(Ouyang et al., 2022).
The comparisons do not have to come from people: in a method its authors call
Constitutional AI, a model compares answers for harmfulness against a written list of principles,
and those comparisons, with human ones for helpfulness, train the reward model
(Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
The method predates large language models large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) trained systems
from human comparisons of short behaviour clips, in a method designed for goals that are hard to write down.
DPO: learning from the ranked pairs directly
Direct preference optimization direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées.
(DPO) starts from the same ranked pairs but uses no reward model (Rafailov et
al., 2023). The pairs are collected before training and stay the same
throughout: the model writes no new answers while it learns. For each pair, its
parameters are adjusted so that the preferred answer becomes more probable and
the rejected one less probable.
DPO is therefore closer to supervised
learning supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. than to reinforcement learning (Jurafsky & Martin, 2026), but it
is not supervised fine-tuning supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : the model
learns from a comparison between two answers, not from an answer to imitate.
Figure 8. The same ranked pairs, used in two ways.
Preference tuning: learning from rankings
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
Preference tuning: learning from rankings
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
Each round of RLHF: the model writes a new answer, the reward model scores it,
and the parameters shift toward higher scores; the answers always come from the
model as it is at that moment. The comparisons need not come from people: in Constitutional AI a model compares answers for harmfulness against written
principles, and those comparisons, with human ones for helpfulness, train the
reward model (Bai et al., 2022a).
Ranking instead of writing
Some things about a good answer are easy to judge and hard to state. Asked
whether this response or that one is better, an annotator can answer quickly;
asked to write down the rule they applied, they would find it far harder.
Preference tuning uses that asymmetry. Rather than asking people to produce
the ideal answer, it asks them to put several of the model’s own answers in
order. The rankings are not perfectly consistent: the labellers of Ouyang et al.
(2022) agreed with each other on about 73% of comparisons. Each ranking is then
split into pairs: four answers in order give six pairs, each made of a better and
a worse answer.
Figure 4. It is often much easier to put concrete options in order, from best to worst, than to write the best possible answer yourself.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
The two best-known methods are reinforcement learning from human feedback (RLHF)
and direct preference optimization (DPO) (Jurafsky & Martin, 2026).
Figure 5. ChatGPT asking whether a response was better or worse (screenshot, 10 September 2026 ).
Figure 6. Gemini showing two answers to one request and asking which is more helpful (screenshot, 1 October 2026 ).
RLHF: a reward model stands in for the people
Figure 7. Post-training an LLM: instruction tuning, then RLHF.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
The reward model is the piece that makes the scale possible. Human rankings are
slow and expensive to collect, so a separate network is trained to imitate them,
and the language model is then trained against that imitation, round after round. In each round, the model writes a new answer, the reward
model gives that answer a score, and the model’s parameters parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. shift toward answers
that score higher. A penalty keeps the model close to where it started: pushed
too far, it learns to please the reward model rather than the people behind it
(Ouyang et al., 2022).
The comparisons do not have to come from people: in a method its authors call
Constitutional AI, a model compares answers for harmfulness against a written list of principles,
and those comparisons, with human ones for helpfulness, train the reward model
(Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
The method predates large language models large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) trained systems
from human comparisons of short behaviour clips, in a method designed for goals that are hard to write down.
DPO: learning from the ranked pairs directly
Direct preference optimization direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées.
(DPO) starts from the same ranked pairs but uses no reward model (Rafailov et
al., 2023). The pairs are collected before training and stay the same
throughout: the model writes no new answers while it learns. For each pair, its
parameters are adjusted so that the preferred answer becomes more probable and
the rejected one less probable.
DPO is therefore closer to supervised
learning supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. than to reinforcement learning (Jurafsky & Martin, 2026), but it
is not supervised fine-tuning supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : the model
learns from a comparison between two answers, not from an answer to imitate.
Figure 8. The same ranked pairs, used in two ways.
Preference tuning: learning from rankings
DPO: closer to supervised learning
it learns from a comparison between two answers
not from an answer to imitate , as supervised fine-tuning does
Go as a challenge for AI
Games have long been test cases for AI, chess being the best
known (see also the What counts as AI? page, in the Foundations of AI & NLP module) (voir aussi la page Ce qu'on appelle « IA » , dans le module Fondements de l'IA et du TAL ) , and Go had long
been seen as the most challenging of the classic games (Silver et al., 2016). It
offers far more possible moves at each turn than chess, about 250 against about
35, and its games run longer (Silver et al., 2016). No program can work through
every possible continuation of a game of Go and pick the best one: it cannot
brute-force its way to a good move.
Between 2015 and 2017, Google DeepMind nonetheless built systems that played Go
well, and tested them in well-publicized matches against human champions.
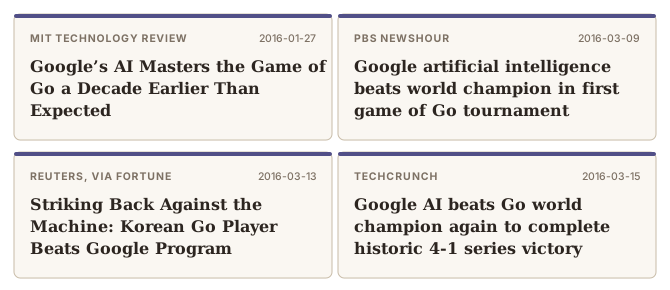
Figure 9. Headlines from January to March 2016, from the announcement of the Fan Hui result to the end of the Lee Sedol match (Knight, 2016; Akpan, 2016; Reuters, 2016; Russell, 2016).
Learning from humans, then from itself
AlphaGo, the Go program, was trained in two stages much like a language model’s.
It began by learning from about 30 million positions from games between strong
amateur players on an online Go server, predicting the move such a player would
make (Silver et al., 2016). Imitation tends to cap a program near the level of the players it copies
(Silver et al., 2017).
Then it played against itself, millions of times, and learned from which side
won. Self-play, combined with a search through possible moves, took it past
them: the program beat a professional player, Fan Hui, five games
to nothing (Silver et al., 2016). Learning from a score rather than from examples
is called reinforcement
learning reinforcement learning (RL) apprentissage par renforcement (AR) machine learning apprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (see also the Three kinds of learning page, in the Foundations of AI & NLP module) (voir aussi la page Trois types d'apprentissage , dans le module Fondements de l'IA et du TAL ) .
The Lee Sedol match and move 37
In March 2016 AlphaGo played Lee Sedol, one of the strongest players in the
world, and won four games of five (Metz, 2016).
AI IA Definition Définition · Move 37 coup 37 · fr: coup 37 · en : Move 37
The 37th move played by the Go program AlphaGo in the second game of its 2016 match against Lee Sedol, one of the strongest players in the world: a move so far outside human playing convention that one of the match's two commentators first took it for a mistake, and that proved central to winning the game. Le 37e coup joué par le programme de go AlphaGo dans la deuxième partie de son match de 2016 contre Lee Sedol, l'un des plus forts joueurs du monde : un coup si éloigné des conventions humaines que l'un des deux commentateurs du match l'a d'abord pris pour une erreur, et qui s'est révélé décisif dans la victoire. (Metz, 2016 )
Notes Remarques The name has become shorthand for two related ideas: a system trained by reinforcement learning discovering a valuable action no human would have chosen, and the moment an observer realizes that an ability they had considered inherently human is not exclusively human. Le nom est devenu un raccourci pour deux idées liées : un système entraîné par apprentissage par renforcement qui découvre une action réellement utile qu'aucun humain n'aurait choisie, et le moment où l'on réalise qu'une capacité que l'on croyait proprement humaine ne l'est pas exclusivement.
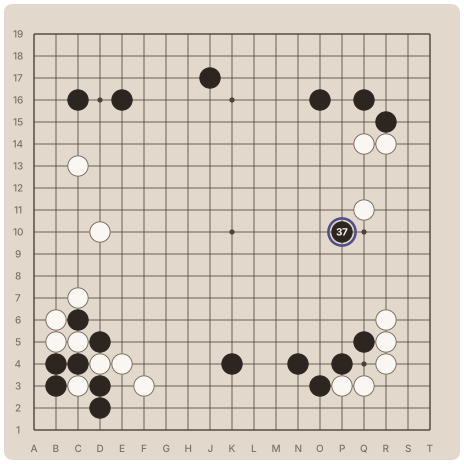
Figure 10. The position after move 37 of the second game, 10 March 2016 . AlphaGo, playing black, has just played at P10. It is the first move that is four steps away from the border.
Of the match’s two commentators, one called it a very strange move and the other
thought it was a mistake. It proved central to winning the game, and AlphaGo won
the match about a decade before experts had expected such a win (Metz, 2016).
Learning from the rules alone
A later system, AlphaZero, was given no human games at all. It started from
the rules of the game and its own play, and it ended up stronger still
(Silver et al., 2018).
Reinforcement learning: AlphaGo and move 37
AI IA Definition Définition · Move 37 coup 37 · fr: coup 37 · en : Move 37
The 37th move played by the Go program AlphaGo in the second game of its 2016 match against Lee Sedol, one of the strongest players in the world: a move so far outside human playing convention that one of the match's two commentators first took it for a mistake, and that proved central to winning the game. Le 37e coup joué par le programme de go AlphaGo dans la deuxième partie de son match de 2016 contre Lee Sedol, l'un des plus forts joueurs du monde : un coup si éloigné des conventions humaines que l'un des deux commentateurs du match l'a d'abord pris pour une erreur, et qui s'est révélé décisif dans la victoire. (Metz, 2016 )
Notes Remarques The name has become shorthand for two related ideas: a system trained by reinforcement learning discovering a valuable action no human would have chosen, and the moment an observer realizes that an ability they had considered inherently human is not exclusively human. Le nom est devenu un raccourci pour deux idées liées : un système entraîné par apprentissage par renforcement qui découvre une action réellement utile qu'aucun humain n'aurait choisie, et le moment où l'on réalise qu'une capacité que l'on croyait proprement humaine ne l'est pas exclusivement.
Go as a challenge for AI
Games have long been test cases for AI, chess being the best
known (see also the What counts as AI? page, in the Foundations of AI & NLP module) (voir aussi la page Ce qu'on appelle « IA » , dans le module Fondements de l'IA et du TAL ) , and Go had long
been seen as the most challenging of the classic games (Silver et al., 2016). It
offers far more possible moves at each turn than chess, about 250 against about
35, and its games run longer (Silver et al., 2016). No program can work through
every possible continuation of a game of Go and pick the best one: it cannot
brute-force its way to a good move.
Between 2015 and 2017, Google DeepMind nonetheless built systems that played Go
well, and tested them in well-publicized matches against human champions.
Figure 9. Headlines from January to March 2016, from the announcement of the Fan Hui result to the end of the Lee Sedol match (Knight, 2016; Akpan, 2016; Reuters, 2016; Russell, 2016).
Learning from humans, then from itself
AlphaGo, the Go program, was trained in two stages much like a language model’s.
It began by learning from about 30 million positions from games between strong
amateur players on an online Go server, predicting the move such a player would
make (Silver et al., 2016). Imitation tends to cap a program near the level of the players it copies
(Silver et al., 2017).
Then it played against itself, millions of times, and learned from which side
won. Self-play, combined with a search through possible moves, took it past
them: the program beat a professional player, Fan Hui, five games
to nothing (Silver et al., 2016). Learning from a score rather than from examples
is called reinforcement
learning reinforcement learning (RL) apprentissage par renforcement (AR) machine learning apprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (see also the Three kinds of learning page, in the Foundations of AI & NLP module) (voir aussi la page Trois types d'apprentissage , dans le module Fondements de l'IA et du TAL ) .
The Lee Sedol match and move 37
In March 2016 AlphaGo played Lee Sedol, one of the strongest players in the
world, and won four games of five (Metz, 2016).
AI IA Definition Définition · Move 37 coup 37 · fr: coup 37 · en : Move 37
The 37th move played by the Go program AlphaGo in the second game of its 2016 match against Lee Sedol, one of the strongest players in the world: a move so far outside human playing convention that one of the match's two commentators first took it for a mistake, and that proved central to winning the game. Le 37e coup joué par le programme de go AlphaGo dans la deuxième partie de son match de 2016 contre Lee Sedol, l'un des plus forts joueurs du monde : un coup si éloigné des conventions humaines que l'un des deux commentateurs du match l'a d'abord pris pour une erreur, et qui s'est révélé décisif dans la victoire. (Metz, 2016 )
Notes Remarques The name has become shorthand for two related ideas: a system trained by reinforcement learning discovering a valuable action no human would have chosen, and the moment an observer realizes that an ability they had considered inherently human is not exclusively human. Le nom est devenu un raccourci pour deux idées liées : un système entraîné par apprentissage par renforcement qui découvre une action réellement utile qu'aucun humain n'aurait choisie, et le moment où l'on réalise qu'une capacité que l'on croyait proprement humaine ne l'est pas exclusivement.
Figure 10. The position after move 37 of the second game, 10 March 2016 . AlphaGo, playing black, has just played at P10. It is the first move that is four steps away from the border.
Of the match’s two commentators, one called it a very strange move and the other
thought it was a mistake. It proved central to winning the game, and AlphaGo won
the match about a decade before experts had expected such a win (Metz, 2016).
Learning from the rules alone
A later system, AlphaZero, was given no human games at all. It started from
the rules of the game and its own play, and it ended up stronger still
(Silver et al., 2018).
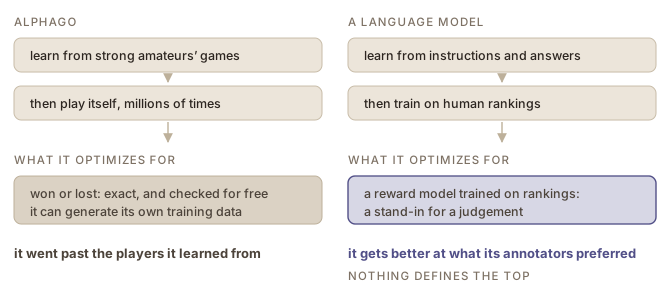
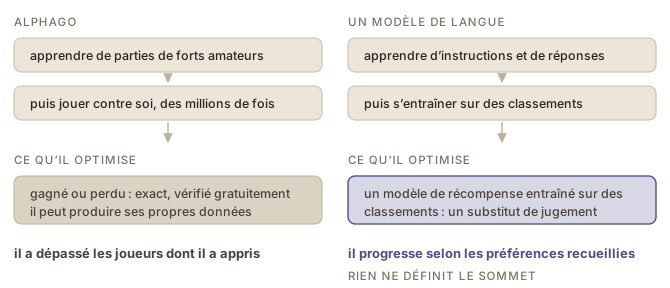
AlphaGo training versus LLM training
AlphaGo was trained in two stages, on human games and then against
itself (see also the Reinforcement learning: AlphaGo and move 37 page) (voir aussi la page L'apprentissage par renforcement : AlphaGo et le coup 37 ) . They line up
with instruction tuning instruction tuning affinage par instructions language models modèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. and
preference tuning preference tuning réglage des préférences language models modèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , and the resemblance ends at
the thing being optimized.
Figure 11. The two pipelines line up stage for stage and part company at what is being optimized.
At the end of every game of Go, the rules say who won. That result is exact, it
costs nothing to check, and a program can play millions of games against itself
to collect more of it.
A translation, a summary or an explanation has nothing like that. No rule says whether a text is right, so preference tuning learns from people’s
rankings, through a reward model or directly, and those rankings are a stand-in
for a judgement and not a ground truth ground truth réalité de terrain evaluation évaluation The values, labels or observations treated as the correct description of the cases in a dataset. Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. (Guo et al.,
2025). A language model can therefore get
better at producing what its annotators preferred, but it has no clear route to
becoming superhuman at writing the way AlphaGo and its successors became
superhuman at Go,
because nothing defines the top.
This is a crucial difference. Having a result you can check automatically
means you can keep optimizing without people, and each check costs almost
nothing. Whereas
being reliant on subjective references that require human involvement to create
is a considerable limitation in terms of how much you can optimize and what you
should consider good performance (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières ) .
RLVR: verifiable answers are the answer
Some tasks done in language do end in a result that can be checked: a
mathematical answer is right or wrong, and code passes its tests or does not.
There, training can again score the model’s answers automatically, as often as
the budget allows. This is reinforcement learning with verifiable rewards
(RLVR), the method behind reasoning models reasoning model modèle de raisonnement language models modèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference. Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. such as
DeepSeek-R1, which improved most in mathematics and code (Guo et al., 2025). The name was introduced for
the post-training of the open Tülu 3 models (Lambert et al., 2025).
language models modèles de langue Definition Définition · reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) · fr: apprentissage par renforcement vérifiable · en : reinforcement learning with verifiable rewards
A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky & Martin, 2026, p. 21 ; Lambert et al., 2025 )
Notes Remarques For example, a mathematical answer may be compared with a known solution, or generated code may be tested to determine whether it runs correctly. Reinforcement learning adjusts the model to make responses receiving higher rewards more likely. Par exemple, une réponse mathématique peut être comparée à une solution connue, ou du code généré peut être exécuté pour vérifier son bon fonctionnement. L'apprentissage par renforcement ajuste le modèle pour rendre plus probables les réponses les mieux récompensées.
Other attested French terms: apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables Autres termes français attestés : apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables
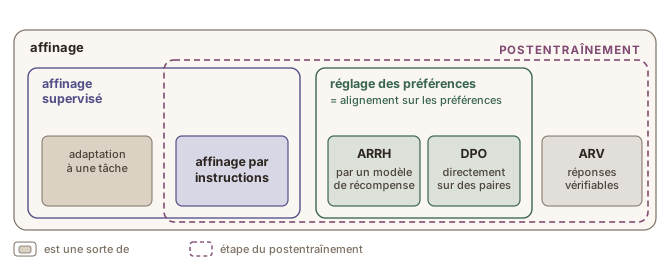
How the kinds of fine-tuning fit together
Instruction tuning, preference tuning and RLVR are all
fine-tuning fine-tuning affinage machine learning apprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. : each trains a model that already
exists on further data. Post-training post-training postentraînement language models modèles de langue Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. names the
stages a developer runs to turn a base model base model modèle de base language models modèles de langue A language model that has completed pretraining but has not yet undergone post-training. Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. into an
assistant (Jurafsky & Martin, 2026). Adapting a model to a domain or a task is fine-tuning as well, but it
happens outside post-training.
Figure 12. The kinds of fine-tuning this chapter names, and which of them make up post-training.
This is the screen that sets up the projects. A translation, a summary or an
explanation has no result a rule can check, so preference tuning optimizes a
stand-in for a judgement. A model can get better at what its annotators
preferred; it has no clear route to becoming superhuman at writing, because nothing
defines the top. The absence of a single correct answer is the central problem
of every project in this course.
RLVR: learning from answers that can be checked
RLVR: verifiable answers are the answer
a maths answer is right or wrong ; code passes its tests or not
there, training can score answers automatically , as often as the budget allows
the method behind reasoning models such as DeepSeek-R1, which improved most in mathematics and code
RLVR: learning from answers that can be checked
language models modèles de langue Definition Définition · reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) · fr: apprentissage par renforcement vérifiable · en : reinforcement learning with verifiable rewards
A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky & Martin, 2026, p. 21 ; Lambert et al., 2025 )
Notes Remarques For example, a mathematical answer may be compared with a known solution, or generated code may be tested to determine whether it runs correctly. Reinforcement learning adjusts the model to make responses receiving higher rewards more likely. Par exemple, une réponse mathématique peut être comparée à une solution connue, ou du code généré peut être exécuté pour vérifier son bon fonctionnement. L'apprentissage par renforcement ajuste le modèle pour rendre plus probables les réponses les mieux récompensées.
Other attested French terms: apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables Autres termes français attestés : apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables
AlphaGo training versus LLM training
AlphaGo was trained in two stages, on human games and then against
itself (see also the Reinforcement learning: AlphaGo and move 37 page) (voir aussi la page L'apprentissage par renforcement : AlphaGo et le coup 37 ) . They line up
with instruction tuning instruction tuning affinage par instructions language models modèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. and
preference tuning preference tuning réglage des préférences language models modèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , and the resemblance ends at
the thing being optimized.
Figure 11. The two pipelines line up stage for stage and part company at what is being optimized.
At the end of every game of Go, the rules say who won. That result is exact, it
costs nothing to check, and a program can play millions of games against itself
to collect more of it.
A translation, a summary or an explanation has nothing like that. No rule says whether a text is right, so preference tuning learns from people’s
rankings, through a reward model or directly, and those rankings are a stand-in
for a judgement and not a ground truth ground truth réalité de terrain evaluation évaluation The values, labels or observations treated as the correct description of the cases in a dataset. Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. (Guo et al.,
2025). A language model can therefore get
better at producing what its annotators preferred, but it has no clear route to
becoming superhuman at writing the way AlphaGo and its successors became
superhuman at Go,
because nothing defines the top.
This is a crucial difference. Having a result you can check automatically
means you can keep optimizing without people, and each check costs almost
nothing. Whereas
being reliant on subjective references that require human involvement to create
is a considerable limitation in terms of how much you can optimize and what you
should consider good performance (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières ) .
RLVR: verifiable answers are the answer
Some tasks done in language do end in a result that can be checked: a
mathematical answer is right or wrong, and code passes its tests or does not.
There, training can again score the model’s answers automatically, as often as
the budget allows. This is reinforcement learning with verifiable rewards
(RLVR), the method behind reasoning models reasoning model modèle de raisonnement language models modèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference. Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. such as
DeepSeek-R1, which improved most in mathematics and code (Guo et al., 2025). The name was introduced for
the post-training of the open Tülu 3 models (Lambert et al., 2025).
language models modèles de langue Definition Définition · reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) · fr: apprentissage par renforcement vérifiable · en : reinforcement learning with verifiable rewards
A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky & Martin, 2026, p. 21 ; Lambert et al., 2025 )
Notes Remarques For example, a mathematical answer may be compared with a known solution, or generated code may be tested to determine whether it runs correctly. Reinforcement learning adjusts the model to make responses receiving higher rewards more likely. Par exemple, une réponse mathématique peut être comparée à une solution connue, ou du code généré peut être exécuté pour vérifier son bon fonctionnement. L'apprentissage par renforcement ajuste le modèle pour rendre plus probables les réponses les mieux récompensées.
Other attested French terms: apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables Autres termes français attestés : apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables
How the kinds of fine-tuning fit together
Instruction tuning, preference tuning and RLVR are all
fine-tuning fine-tuning affinage machine learning apprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. : each trains a model that already
exists on further data. Post-training post-training postentraînement language models modèles de langue Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. names the
stages a developer runs to turn a base model base model modèle de base language models modèles de langue A language model that has completed pretraining but has not yet undergone post-training. Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. into an
assistant (Jurafsky & Martin, 2026). Adapting a model to a domain or a task is fine-tuning as well, but it
happens outside post-training.
Figure 12. The kinds of fine-tuning this chapter names, and which of them make up post-training.
The map closes the chapter: every kind of fine-tuning it shows has now been
explained.
L'affinage : du générateur à l'assistant
machine learning apprentissage automatique Definition Définition · fine-tuning affinage · fr: affinage · en : fine-tuning
Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. (Jurafsky & Martin, 2026, p. 210 )
Notes Remarques Fine-tuning may adjust all the model's parameters or only a selected subset and generally requires much less data and computation than pretraining. L'affinage peut ajuster tous les paramètres du modèle ou seulement une partie, et demande généralement beaucoup moins de données et de calcul que le préentraînement.
Other attested French terms: réglage fin, peaufinage Autres termes français attestés : réglage fin, peaufinage
L'affinage : du générateur à l'assistant
Ce que coûtent le préentraînement et l’affinage
préentraînement : une immense quantité de texte, recueilli en masse ; l’essentiel du coût est le calcul affinage : beaucoup moins de données, chaque exemple choisi ou rédigé avec soin ; peu de calculil change bien plus la façon dont le modèle se comporte que ce qu’il sait
Les chiffres, si on vous les demande : 60 pétaflop/s-jours pour le plus gros
modèle d’InstructGPT, contre 3 640 pour le préentraînement de GPT-3.
L'affinage : du générateur à l'assistant
L’affinage face à la taille
un modèle de 1,3 milliard de paramètres, affiné
préféré par des personnes à GPT-3 et ses 175 milliards , non affiné, sur les requêtes des utilisateurs
plus de cent fois plus petit
Key points L'essentiel
Les agents conversationnels fondés sur un GML passent en général par quatre étapes : le préentraînement produit un modèle de base, deux étapes d’affinage le font répondre et façonnent sa manière de répondre, et le déploiement ajoute autour de lui des instructions et des filtres sans le modifier.
Les étapes d’affinage qui suivent le préentraînement forment ensemble le postentraînement.
Du préentraînement au déploiement
Figure 1. Du préentraînement à l'assistant auquel vous écrivez.
Préentraînement pre-training préentraînement language models modèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses. Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. .modèle de base base model modèle de base language models modèles de langue A language model that has completed pretraining but has not yet undergone post-training. Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. : il prolonge du texte et ne suit pas les instructions de façon fiable.Affinage par instructions instruction tuning affinage par instructions language models modèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. .Réglage des préférences preference tuning réglage des préférences language models modèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. .Déploiement. Requêtes génératives système system prompt requête générative système prompting requêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction. Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. , filtres de sécurité et autres dispositifs autour du modèle, qui ne changent rien à ses paramètres (see also the Alignment page) (voir aussi la page L'alignement ) .
computing informatique Definition Définition · deployment déploiement · fr: déploiement · en : deployment
Putting a system into operation where it will be used: installing it with what it needs to run and making it available to its users. For an AI system, it means making a trained model available to people, for instance behind an application or a chat interface. Mise en service d'un système là où il sera utilisé : son installation, avec ce dont il a besoin pour fonctionner, et sa mise à la disposition de ses utilisateurs. Pour un système d'IA, il s'agit de rendre un modèle entraîné accessible aux personnes, par exemple derrière une application ou une interface conversationnelle. (Jackson & Gallagher, 2026 ; Tabassi, 2023, Appendix A )
Notes Remarques For a language model, deployment changes nothing in its parameters: system prompts, output filters and access rules are set around the model, and they can be changed far more often than the model itself. Deployment tasks include piloting the system, checking compatibility with existing systems and ensuring regulatory compliance (Tabassi, 2023). Pour un modèle de langue, le déploiement ne change rien à ses paramètres : les requêtes génératives système, les filtres de sortie et les règles d'accès sont placés autour du modèle, et on peut les changer bien plus souvent que le modèle lui-même. Les tâches de déploiement comprennent la mise à l'essai du système, la vérification de sa compatibilité avec les systèmes existants et le respect de la réglementation (Tabassi, 2023).
Le postentraînement
Les étapes 2 et 3 sont deux formes d’affinage fine-tuning affinage machine learning apprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. , que
le domaine regroupe sous le nom de postentraînement. Beaucoup de modèles actuels
y ajoutent une troisième étape,
l’apprentissage par renforcement vérifiable reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) language models modèles de langue A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement.
(Jurafsky et Martin, 2026) (see also the RLVR: learning from answers that can be checked page) (voir aussi la page L'ARV : apprendre à partir de réponses vérifiables ) . Les deux termes ne sont
pas synonymes : l’affinage est la technique, et il sert aussi en dehors du
postentraînement, par exemple pour adapter un modèle existant aux textes d’une
organisation.
language models modèles de langue Definition Définition · post-training postentraînement · fr: postentraînement · en : post-training
Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. (Jurafsky & Martin, 2026, pp. 209–223 )
Notes Remarques For modern language models, post-training may include instruction tuning, preference tuning and reinforcement learning with verifiable rewards. These stages can make a base model better at following instructions, producing preferred responses or solving particular kinds of problems. Post-training is an umbrella term, and organizations do not necessarily use the same stages or sequence. In-context learning and ordinary prompting are not post-training, because they do not update the model's parameters. In some engineering contexts, post-training is used more broadly for processes applied after training, such as quantization; this entry concerns post-training as a stage in developing language models. Pour les modèles de langue modernes, il peut comprendre l'affinage par instructions, le réglage des préférences et l'apprentissage par renforcement avec récompenses vérifiables. Ces étapes peuvent rendre un modèle de base plus apte à suivre des instructions, à produire des réponses préférées ou à résoudre certains types de problèmes. Postentraînement est un terme générique, et les organisations n'utilisent pas nécessairement les mêmes étapes ni le même ordre. L'apprentissage en contexte et la requête ordinaire ne relèvent pas du postentraînement, car ils ne modifient pas les paramètres du modèle. Dans certains contextes techniques, le terme s'emploie plus largement pour des traitements postérieurs à l'entraînement, comme la quantification ; la présente entrée vise le postentraînement comme étape du développement des modèles de langue.
Les quatre étapes du préentraînement à l'assistant
computing informatique Definition Définition · deployment déploiement · fr: déploiement · en : deployment
Putting a system into operation where it will be used: installing it with what it needs to run and making it available to its users. For an AI system, it means making a trained model available to people, for instance behind an application or a chat interface. Mise en service d'un système là où il sera utilisé : son installation, avec ce dont il a besoin pour fonctionner, et sa mise à la disposition de ses utilisateurs. Pour un système d'IA, il s'agit de rendre un modèle entraîné accessible aux personnes, par exemple derrière une application ou une interface conversationnelle. (Jackson & Gallagher, 2026 ; Tabassi, 2023, Appendix A )
Notes Remarques For a language model, deployment changes nothing in its parameters: system prompts, output filters and access rules are set around the model, and they can be changed far more often than the model itself. Deployment tasks include piloting the system, checking compatibility with existing systems and ensuring regulatory compliance (Tabassi, 2023). Pour un modèle de langue, le déploiement ne change rien à ses paramètres : les requêtes génératives système, les filtres de sortie et les règles d'accès sont placés autour du modèle, et on peut les changer bien plus souvent que le modèle lui-même. Les tâches de déploiement comprennent la mise à l'essai du système, la vérification de sa compatibilité avec les systèmes existants et le respect de la réglementation (Tabassi, 2023).
Les quatre étapes du préentraînement à l'assistant
language models modèles de langue Definition Définition · post-training postentraînement · fr: postentraînement · en : post-training
Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. (Jurafsky & Martin, 2026, pp. 209–223 )
Notes Remarques For modern language models, post-training may include instruction tuning, preference tuning and reinforcement learning with verifiable rewards. These stages can make a base model better at following instructions, producing preferred responses or solving particular kinds of problems. Post-training is an umbrella term, and organizations do not necessarily use the same stages or sequence. In-context learning and ordinary prompting are not post-training, because they do not update the model's parameters. In some engineering contexts, post-training is used more broadly for processes applied after training, such as quantization; this entry concerns post-training as a stage in developing language models. Pour les modèles de langue modernes, il peut comprendre l'affinage par instructions, le réglage des préférences et l'apprentissage par renforcement avec récompenses vérifiables. Ces étapes peuvent rendre un modèle de base plus apte à suivre des instructions, à produire des réponses préférées ou à résoudre certains types de problèmes. Postentraînement est un terme générique, et les organisations n'utilisent pas nécessairement les mêmes étapes ni le même ordre. L'apprentissage en contexte et la requête ordinaire ne relèvent pas du postentraînement, car ils ne modifient pas les paramètres du modèle. Dans certains contextes techniques, le terme s'emploie plus largement pour des traitements postérieurs à l'entraînement, comme la quantification ; la présente entrée vise le postentraînement comme étape du développement des modèles de langue.
L'affinage par instructions : apprendre à partir d'exemples
Une paire
Requête : Explique la photosynthèse à un enfant de 10 ans.
Réponse : La photosynthèse, c’est la façon dont les plantes fabriquent
leur propre nourriture avec la lumière du soleil. Imagine les feuilles
comme de petites usines qui captent la lumière, l’eau et l’air…
L'affinage par instructions : apprendre à partir d'exemples
language models modèles de langue Definition Définition · supervised fine-tuning (SFT) affinage supervisé · fr: affinage supervisé · en : supervised fine-tuning
Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. (Jurafsky & Martin, 2026, pp. 209–211 )
Notes Remarques For LLMs, SFT often uses instruction-and-response examples, in which case it is also called instruction tuning. Instruction tuning is a common subtype of SFT, but SFT can also be used for classification, domain adaptation, and other labelled tasks. Pour les GML, il s'appuie souvent sur des exemples d'instructions et de réponses, auquel cas on parle aussi d'affinage par instructions. Ce dernier en est un sous-type courant, mais l'affinage supervisé sert aussi à la classification, à l'adaptation à un domaine et à d'autres tâches étiquetées.
Other attested French terms: affinage par apprentissage supervisé, peaufinage par apprentissage supervisé Autres termes français attestés : affinage par apprentissage supervisé, peaufinage par apprentissage supervisé
L'affinage par instructions : apprendre à partir d'exemples
language models modèles de langue Definition Définition · instruction tuning affinage par instructions · fr: affinage par instructions · en : instruction tuning
A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. (Jurafsky & Martin, 2026, p. 210 )
Notes Remarques This makes the model better able to follow instructions across a range of tasks, including tasks not represented exactly in the training examples. Le modèle devient ainsi plus apte à suivre des instructions dans un éventail de tâches, y compris des tâches qui ne figurent pas exactement dans les exemples d'entraînement.
Other attested English terms: instruction fine-tuning Autres termes anglais attestés : instruction fine-tuning
Key points L'essentiel
Le modèle est entraîné sur des paires formées d’une instruction et d’une bonne réponse, jusqu’à ce qu’il traite une demande comme quelque chose à quoi répondre plutôt que comme un texte à prolonger.
Ces paires sont bien moins nombreuses que les documents du préentraînement, si bien que chacune compte : un exemple bâclé enseigne une manière bâclée.
Montrer au modèle à quoi ressemble une bonne réponse
L’affinage par instructions se fait en fournissant des paires d’exemples :
des instructions et des réponses. Une moitié est une instruction,
le genre de chose qu’un utilisateur taperait réellement, ce qu’on appelle dans
ce contexte une requête prompt requête prompting requêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output. Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. . L’autre moitié est une réponse
digne d’être imitée.
Requête : Explique la photosynthèse à un enfant de 10 ans.
Réponse : La photosynthèse, c’est la façon dont les plantes fabriquent
leur propre nourriture avec la lumière du soleil. Imagine les feuilles comme
de petites usines qui captent la lumière, l’eau et l’air…
language models modèles de langue Definition Définition · supervised fine-tuning (SFT) affinage supervisé · fr: affinage supervisé · en : supervised fine-tuning
Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. (Jurafsky & Martin, 2026, pp. 209–211 )
Notes Remarques For LLMs, SFT often uses instruction-and-response examples, in which case it is also called instruction tuning. Instruction tuning is a common subtype of SFT, but SFT can also be used for classification, domain adaptation, and other labelled tasks. Pour les GML, il s'appuie souvent sur des exemples d'instructions et de réponses, auquel cas on parle aussi d'affinage par instructions. Ce dernier en est un sous-type courant, mais l'affinage supervisé sert aussi à la classification, à l'adaptation à un domaine et à d'autres tâches étiquetées.
Other attested French terms: affinage par apprentissage supervisé, peaufinage par apprentissage supervisé Autres termes français attestés : affinage par apprentissage supervisé, peaufinage par apprentissage supervisé
S’entraîner sur assez de ces paires enseigne une régularité que le
préentraînement présentait rarement de façon aussi constante : une instruction est suivie d’une réponse.
Le système qui complète du texte devient ainsi un système qui répond aux questions.
language models modèles de langue Definition Définition · instruction tuning affinage par instructions · fr: affinage par instructions · en : instruction tuning
A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. (Jurafsky & Martin, 2026, p. 210 )
Notes Remarques This makes the model better able to follow instructions across a range of tasks, including tasks not represented exactly in the training examples. Le modèle devient ainsi plus apte à suivre des instructions dans un éventail de tâches, y compris des tâches qui ne figurent pas exactement dans les exemples d'entraînement.
Other attested English terms: instruction fine-tuning Autres termes anglais attestés : instruction fine-tuning
L’affinage par instructions est une sorte d’affinage supervisé, qui est
lui-même une sorte d’affinage. L’affinage supervisé sert aussi en dehors des
assistants, pour adapter un modèle à une tâche, comme traduire avec la
terminologie d’une organisation à partir de sa
mémoire de traduction translation memory (TM) mémoire de traduction (MT) CAT tools TAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text. Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. .
Figure 2. Comment les trois noms s'emboîtent.
Le terme anglais instruction tuning a été introduit par Wei et al. (2022), qui ont affiné un modèle préentraîné sur
plus de 60 jeux de données formulés comme des instructions et constaté qu’il pouvait
ensuite suivre des instructions pour des tâches qu’il n’avait pas vues.
Peu de données, choisies avec soin
Figure 3. D'où viennent les deux sortes de données d'entraînement, et sur quoi chacune est jugée.
Le texte du préentraînement a lui aussi été écrit par des personnes, mais pas
dans ce but, et il est filtré en bloc. Les exemples de l’affinage par
instructions sont choisis ou rédigés selon le comportement recherché. Pour
InstructGPT, il s’agissait d’environ 13 000 requêtes accompagnées de
réponses rédigées par des étiqueteurs recrutés à cette fin (Ouyang et al.,
2022). Les ensembles plus récents reprennent aussi des questions et des réponses
de sites communautaires (Zhou et al., 2023) et des instructions et des réponses
générées par un modèle, puis filtrées (Wang et al., 2023).
Ici, la qualité compte plus que la quantité : un millier d’exemples
soigneusement choisis peut suffire. En doubler le nombre n’a pas amélioré les
réponses, alors que les filtrer selon leur qualité les a améliorées (Zhou et al., 2023). Les
auteurs y voient le signe que le modèle apprend une manière plutôt qu’un sujet.
Là où les exemples sont rédigés exprès, le travail est souvent rémunéré : Ouyang et
coll. (2022) ont recruté et sélectionné une quarantaine d’étiqueteurs pour cette
tâche.
Pas encore tout à fait l’agent conversationnel serviable
Après cette étape, le modèle répond aux questions et peut soutenir une
conversation. Son jugement plus fin ne va pas plus loin que ce que ses exemples lui ont
montré : quelle longueur donner à une réponse, quand dire qu’il n’est pas sûr, quand une demande devrait être
refusée. Ces qualités sont faciles à reconnaître dans une réponse et difficiles
à préciser d’avance.
Les données, si on vous les demande : pour InstructGPT, environ 13 000 requêtes
avec des réponses rédigées par une quarantaine d’étiqueteurs recrutés et
sélectionnés pour cela. Les ensembles plus récents reprennent aussi des
questions et des réponses de sites communautaires, et des réponses générées
par un modèle puis filtrées. Le terme anglais a été introduit par Wei et al. (2022) : un modèle préentraîné,
affiné sur plus de 60 jeux de données formulés comme des instructions, pouvait ensuite suivre des instructions pour des tâches qu’il
n’avait pas vues.
L'affinage par instructions : apprendre à partir d'exemples
Pas encore tout à fait l’agent conversationnel serviable Le modèle répond ; son jugement ne va pas plus loin que ses exemples :
quelle longueur donner à une réponsequand dire qu’il n’est pas sûrquand refuser une demande Facile à reconnaître, difficile à préciser d’avance.
Classer au lieu d’écrire
Certaines choses, dans une bonne réponse, sont faciles à juger et difficiles à
énoncer. Si on lui demande si cette réponse-ci ou celle-là est meilleure, un
annotateur peut répondre vite ; si on lui demande d’écrire la règle qu’il a
appliquée, la tâche est bien plus difficile.
Le réglage des préférences exploite cette asymétrie. Plutôt que de demander aux
gens de produire la réponse idéale, il leur demande de mettre en ordre plusieurs
des réponses du modèle lui-même. Les classements ne sont pas parfaitement
cohérents : les étiqueteurs d’Ouyang et al. (2022) concordaient sur environ
73 % des comparaisons. Chaque classement est ensuite découpé en paires : quatre
réponses classées donnent six paires, chacune formée d’une meilleure et d’une
moins bonne réponse.
Figure 4. Il est souvent bien plus facile de classer des options concrètes, de la meilleure à la pire, que de rédiger soi-même la meilleure réponse possible.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
Les deux méthodes les plus connues sont l’apprentissage par renforcement avec
rétroaction humaine (ARRH) et l’optimisation directe des préférences (DPO)
(Jurafsky et Martin, 2026).
Vos évaluations comme données de préférence
Les agents conversationnels demandent parfois ce genre de jugement
directement à leurs utilisateurs : ChatGPT, par exemple, demande à l’occasion
si une réponse était meilleure ou moins bonne, et Gemini affiche parfois deux
réponses côte à côte en demandant laquelle est la plus utile. Les boutons pouce levé et pouce
baissé sous une réponse recueillent un jugement plus simple, sur une seule
réponse à la fois, et OpenAI (2025) s’est servi de ces évaluations comme signal
de récompense à l’entraînement (see also the Model specifications: deciding how a chatbot behaves page) (voir aussi la page Les spécifications de modèle : décider du comportement d'un agent conversationnel ) .
Figure 5. ChatGPT demande si une réponse était meilleure ou moins bonne (capture d'écran, 10 septembre 2026 ).
Figure 6. Gemini affiche deux réponses à une même requête et demande laquelle est la plus utile (capture d'écran, 1er octobre 2026 ).
L’ARRH : un modèle de récompense remplace les personnes
Figure 7. Le postentraînement d'un GML : l'affinage par instructions, puis l'ARRH.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
Le modèle de récompense est la pièce qui rend l’échelle possible. Les
classements humains sont lents et coûteux à recueillir ; on entraîne donc un
réseau distinct à les imiter, et le modèle de langue est ensuite entraîné contre
cette imitation, tour après tour. À chaque tour,
le modèle écrit une nouvelle réponse, le modèle de récompense attribue une note
à cette réponse, et les paramètres parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle sont ajustés en faveur des
réponses les mieux notées. Une pénalité maintient le modèle près de son point de
départ : poussé trop loin, il apprend à plaire au modèle de récompense plutôt
qu’aux personnes derrière lui (Ouyang et al., 2022).
Les comparaisons ne viennent pas forcément de personnes : dans une méthode que
ses auteurs appellent l’IA constitutionnelle, un modèle compare des réponses
sur leur caractère nuisible d’après une liste écrite de principes, et ces
comparaisons, avec des comparaisons humaines pour l’utilité, entraînent le
modèle de récompense (Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
La méthode est antérieure aux grands modèles de langue large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) ont
entraîné des systèmes à partir de comparaisons humaines de courts extraits de
comportement, par une méthode conçue pour des objectifs difficiles à formuler.
La DPO : apprendre directement des paires classées
L’optimisation directe des
préférences direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées. (DPO) part des mêmes paires classées, mais sans modèle de
récompense (Rafailov et al., 2023). Les paires sont recueillies avant
l’entraînement et restent les mêmes du début à la fin : le modèle n’écrit aucune
nouvelle réponse pendant qu’il apprend. Pour chaque paire, ses paramètres sont
ajustés de sorte que la réponse préférée devienne plus probable et la réponse
rejetée, moins probable.
La DPO est donc plus proche de l’apprentissage
supervisé supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. que de l’apprentissage par renforcement (Jurafsky et Martin,
2026), sans être pour autant un affinage
supervisé supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : le modèle apprend d’une comparaison entre deux réponses, et
non d’une réponse à imiter.
Figure 8. Les mêmes paires classées, utilisées de deux façons.
Le réglage des préférences : apprendre à partir de classements
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
Classer au lieu d’écrire
Certaines choses, dans une bonne réponse, sont faciles à juger et difficiles à
énoncer. Si on lui demande si cette réponse-ci ou celle-là est meilleure, un
annotateur peut répondre vite ; si on lui demande d’écrire la règle qu’il a
appliquée, la tâche est bien plus difficile.
Le réglage des préférences exploite cette asymétrie. Plutôt que de demander aux
gens de produire la réponse idéale, il leur demande de mettre en ordre plusieurs
des réponses du modèle lui-même. Les classements ne sont pas parfaitement
cohérents : les étiqueteurs d’Ouyang et al. (2022) concordaient sur environ
73 % des comparaisons. Chaque classement est ensuite découpé en paires : quatre
réponses classées donnent six paires, chacune formée d’une meilleure et d’une
moins bonne réponse.
Figure 4. Il est souvent bien plus facile de classer des options concrètes, de la meilleure à la pire, que de rédiger soi-même la meilleure réponse possible.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
Les deux méthodes les plus connues sont l’apprentissage par renforcement avec
rétroaction humaine (ARRH) et l’optimisation directe des préférences (DPO)
(Jurafsky et Martin, 2026).
Vos évaluations comme données de préférence
Les agents conversationnels demandent parfois ce genre de jugement
directement à leurs utilisateurs : ChatGPT, par exemple, demande à l’occasion
si une réponse était meilleure ou moins bonne, et Gemini affiche parfois deux
réponses côte à côte en demandant laquelle est la plus utile. Les boutons pouce levé et pouce
baissé sous une réponse recueillent un jugement plus simple, sur une seule
réponse à la fois, et OpenAI (2025) s’est servi de ces évaluations comme signal
de récompense à l’entraînement (see also the Model specifications: deciding how a chatbot behaves page) (voir aussi la page Les spécifications de modèle : décider du comportement d'un agent conversationnel ) .
Figure 5. ChatGPT demande si une réponse était meilleure ou moins bonne (capture d'écran, 10 septembre 2026 ).
Figure 6. Gemini affiche deux réponses à une même requête et demande laquelle est la plus utile (capture d'écran, 1er octobre 2026 ).
L’ARRH : un modèle de récompense remplace les personnes
Figure 7. Le postentraînement d'un GML : l'affinage par instructions, puis l'ARRH.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
Le modèle de récompense est la pièce qui rend l’échelle possible. Les
classements humains sont lents et coûteux à recueillir ; on entraîne donc un
réseau distinct à les imiter, et le modèle de langue est ensuite entraîné contre
cette imitation, tour après tour. À chaque tour,
le modèle écrit une nouvelle réponse, le modèle de récompense attribue une note
à cette réponse, et les paramètres parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle sont ajustés en faveur des
réponses les mieux notées. Une pénalité maintient le modèle près de son point de
départ : poussé trop loin, il apprend à plaire au modèle de récompense plutôt
qu’aux personnes derrière lui (Ouyang et al., 2022).
Les comparaisons ne viennent pas forcément de personnes : dans une méthode que
ses auteurs appellent l’IA constitutionnelle, un modèle compare des réponses
sur leur caractère nuisible d’après une liste écrite de principes, et ces
comparaisons, avec des comparaisons humaines pour l’utilité, entraînent le
modèle de récompense (Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
La méthode est antérieure aux grands modèles de langue large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) ont
entraîné des systèmes à partir de comparaisons humaines de courts extraits de
comportement, par une méthode conçue pour des objectifs difficiles à formuler.
La DPO : apprendre directement des paires classées
L’optimisation directe des
préférences direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées. (DPO) part des mêmes paires classées, mais sans modèle de
récompense (Rafailov et al., 2023). Les paires sont recueillies avant
l’entraînement et restent les mêmes du début à la fin : le modèle n’écrit aucune
nouvelle réponse pendant qu’il apprend. Pour chaque paire, ses paramètres sont
ajustés de sorte que la réponse préférée devienne plus probable et la réponse
rejetée, moins probable.
La DPO est donc plus proche de l’apprentissage
supervisé supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. que de l’apprentissage par renforcement (Jurafsky et Martin,
2026), sans être pour autant un affinage
supervisé supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : le modèle apprend d’une comparaison entre deux réponses, et
non d’une réponse à imiter.
Figure 8. Les mêmes paires classées, utilisées de deux façons.
L’asymétrie sur laquelle repose la méthode : à qui on demande laquelle de deux
réponses est la meilleure, un annotateur peut répondre vite ; à qui on demande
d’écrire la règle appliquée, la tâche est bien plus difficile. Ils ne sont pas
toujours d’accord : environ 73 % des comparaisons chez Ouyang et al. (2022).
Chaque classement est découpé en paires : quatre réponses classées en donnent
six. La question « meilleure ou moins bonne » recueille une comparaison auprès des
utilisateurs ; les pouces, un jugement sur une seule réponse.
Classer au lieu d’écrire
Certaines choses, dans une bonne réponse, sont faciles à juger et difficiles à
énoncer. Si on lui demande si cette réponse-ci ou celle-là est meilleure, un
annotateur peut répondre vite ; si on lui demande d’écrire la règle qu’il a
appliquée, la tâche est bien plus difficile.
Le réglage des préférences exploite cette asymétrie. Plutôt que de demander aux
gens de produire la réponse idéale, il leur demande de mettre en ordre plusieurs
des réponses du modèle lui-même. Les classements ne sont pas parfaitement
cohérents : les étiqueteurs d’Ouyang et al. (2022) concordaient sur environ
73 % des comparaisons. Chaque classement est ensuite découpé en paires : quatre
réponses classées donnent six paires, chacune formée d’une meilleure et d’une
moins bonne réponse.
Figure 4. Il est souvent bien plus facile de classer des options concrètes, de la meilleure à la pire, que de rédiger soi-même la meilleure réponse possible.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
Les deux méthodes les plus connues sont l’apprentissage par renforcement avec
rétroaction humaine (ARRH) et l’optimisation directe des préférences (DPO)
(Jurafsky et Martin, 2026).
Vos évaluations comme données de préférence
Les agents conversationnels demandent parfois ce genre de jugement
directement à leurs utilisateurs : ChatGPT, par exemple, demande à l’occasion
si une réponse était meilleure ou moins bonne, et Gemini affiche parfois deux
réponses côte à côte en demandant laquelle est la plus utile. Les boutons pouce levé et pouce
baissé sous une réponse recueillent un jugement plus simple, sur une seule
réponse à la fois, et OpenAI (2025) s’est servi de ces évaluations comme signal
de récompense à l’entraînement (see also the Model specifications: deciding how a chatbot behaves page) (voir aussi la page Les spécifications de modèle : décider du comportement d'un agent conversationnel ) .
Figure 5. ChatGPT demande si une réponse était meilleure ou moins bonne (capture d'écran, 10 septembre 2026 ).
Figure 6. Gemini affiche deux réponses à une même requête et demande laquelle est la plus utile (capture d'écran, 1er octobre 2026 ).
L’ARRH : un modèle de récompense remplace les personnes
Figure 7. Le postentraînement d'un GML : l'affinage par instructions, puis l'ARRH.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
Le modèle de récompense est la pièce qui rend l’échelle possible. Les
classements humains sont lents et coûteux à recueillir ; on entraîne donc un
réseau distinct à les imiter, et le modèle de langue est ensuite entraîné contre
cette imitation, tour après tour. À chaque tour,
le modèle écrit une nouvelle réponse, le modèle de récompense attribue une note
à cette réponse, et les paramètres parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle sont ajustés en faveur des
réponses les mieux notées. Une pénalité maintient le modèle près de son point de
départ : poussé trop loin, il apprend à plaire au modèle de récompense plutôt
qu’aux personnes derrière lui (Ouyang et al., 2022).
Les comparaisons ne viennent pas forcément de personnes : dans une méthode que
ses auteurs appellent l’IA constitutionnelle, un modèle compare des réponses
sur leur caractère nuisible d’après une liste écrite de principes, et ces
comparaisons, avec des comparaisons humaines pour l’utilité, entraînent le
modèle de récompense (Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
La méthode est antérieure aux grands modèles de langue large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) ont
entraîné des systèmes à partir de comparaisons humaines de courts extraits de
comportement, par une méthode conçue pour des objectifs difficiles à formuler.
La DPO : apprendre directement des paires classées
L’optimisation directe des
préférences direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées. (DPO) part des mêmes paires classées, mais sans modèle de
récompense (Rafailov et al., 2023). Les paires sont recueillies avant
l’entraînement et restent les mêmes du début à la fin : le modèle n’écrit aucune
nouvelle réponse pendant qu’il apprend. Pour chaque paire, ses paramètres sont
ajustés de sorte que la réponse préférée devienne plus probable et la réponse
rejetée, moins probable.
La DPO est donc plus proche de l’apprentissage
supervisé supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. que de l’apprentissage par renforcement (Jurafsky et Martin,
2026), sans être pour autant un affinage
supervisé supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : le modèle apprend d’une comparaison entre deux réponses, et
non d’une réponse à imiter.
Figure 8. Les mêmes paires classées, utilisées de deux façons.
Le réglage des préférences : apprendre à partir de classements
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
Le réglage des préférences : apprendre à partir de classements
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
À chaque tour d’ARRH, le modèle écrit une nouvelle réponse, le modèle de
récompense la note, et les paramètres sont ajustés en faveur des meilleures
notes ; les réponses viennent toujours du modèle tel qu’il est à ce moment-là.
Les comparaisons ne viennent pas forcément de personnes : dans l’IA constitutionnelle, un modèle compare des réponses sur leur caractère
nuisible d’après des principes écrits, et ces comparaisons, avec des
comparaisons humaines pour l’utilité, entraînent le modèle de récompense (Bai et al., 2022a).
Classer au lieu d’écrire
Certaines choses, dans une bonne réponse, sont faciles à juger et difficiles à
énoncer. Si on lui demande si cette réponse-ci ou celle-là est meilleure, un
annotateur peut répondre vite ; si on lui demande d’écrire la règle qu’il a
appliquée, la tâche est bien plus difficile.
Le réglage des préférences exploite cette asymétrie. Plutôt que de demander aux
gens de produire la réponse idéale, il leur demande de mettre en ordre plusieurs
des réponses du modèle lui-même. Les classements ne sont pas parfaitement
cohérents : les étiqueteurs d’Ouyang et al. (2022) concordaient sur environ
73 % des comparaisons. Chaque classement est ensuite découpé en paires : quatre
réponses classées donnent six paires, chacune formée d’une meilleure et d’une
moins bonne réponse.
Figure 4. Il est souvent bien plus facile de classer des options concrètes, de la meilleure à la pire, que de rédiger soi-même la meilleure réponse possible.
language models modèles de langue Definition Définition · preference tuning réglage des préférences · fr: réglage des préférences · en : preference tuning
A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. (Jurafsky & Martin, 2026, pp. 215–223 ; Ouyang et al., 2022 ; Rafailov et al., 2023 )
Notes Remarques The preferences usually come as rankings of candidate responses, made by people or by another model. Reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) are its two most common methods. The result reflects the preferences of whoever did the ranking; the stage is also called preference alignment or preference fine-tuning. Les préférences prennent généralement la forme de classements de réponses candidates, faits par des personnes ou par un autre modèle. L'apprentissage par renforcement avec rétroaction humaine (ARRH) et l'optimisation directe des préférences (DPO) en sont les deux méthodes les plus courantes. Le résultat reflète les préférences de ceux qui ont établi le classement ; on parle aussi d'alignement sur les préférences.
Other attested English terms: preference alignment, preference fine-tuning Autres termes anglais attestés : preference alignment, preference fine-tuning
Other attested French terms: alignement sur les préférences Autres termes français attestés : alignement sur les préférences
Les deux méthodes les plus connues sont l’apprentissage par renforcement avec
rétroaction humaine (ARRH) et l’optimisation directe des préférences (DPO)
(Jurafsky et Martin, 2026).
Vos évaluations comme données de préférence
Les agents conversationnels demandent parfois ce genre de jugement
directement à leurs utilisateurs : ChatGPT, par exemple, demande à l’occasion
si une réponse était meilleure ou moins bonne, et Gemini affiche parfois deux
réponses côte à côte en demandant laquelle est la plus utile. Les boutons pouce levé et pouce
baissé sous une réponse recueillent un jugement plus simple, sur une seule
réponse à la fois, et OpenAI (2025) s’est servi de ces évaluations comme signal
de récompense à l’entraînement (see also the Model specifications: deciding how a chatbot behaves page) (voir aussi la page Les spécifications de modèle : décider du comportement d'un agent conversationnel ) .
Figure 5. ChatGPT demande si une réponse était meilleure ou moins bonne (capture d'écran, 10 septembre 2026 ).
Figure 6. Gemini affiche deux réponses à une même requête et demande laquelle est la plus utile (capture d'écran, 1er octobre 2026 ).
L’ARRH : un modèle de récompense remplace les personnes
Figure 7. Le postentraînement d'un GML : l'affinage par instructions, puis l'ARRH.
language models modèles de langue Definition Définition · reward model modèle de récompense · fr: modèle de récompense · en : reward model
A model trained to assign a numerical score to a candidate output, usually by learning from human judgements of which outputs are better. Modèle entraîné à attribuer une note numérique à une sortie candidate, généralement à partir de jugements humains indiquant quelles sorties sont meilleures. (Jurafsky & Martin, 2026, pp. 219–220 ; Bai et al., 2022a )
Notes Remarques The judgements can also come from another model applying written principles, as in Constitutional AI (Bai et al., 2022a). The scores can then guide reinforcement learning or help select among several candidate responses. Les jugements peuvent aussi venir d'un autre modèle qui applique des principes écrits, comme dans l'IA constitutionnelle (Bai et al., 2022a). Les notes peuvent ensuite guider l'apprentissage par renforcement ou aider à choisir parmi plusieurs réponses candidates.
Le modèle de récompense est la pièce qui rend l’échelle possible. Les
classements humains sont lents et coûteux à recueillir ; on entraîne donc un
réseau distinct à les imiter, et le modèle de langue est ensuite entraîné contre
cette imitation, tour après tour. À chaque tour,
le modèle écrit une nouvelle réponse, le modèle de récompense attribue une note
à cette réponse, et les paramètres parameter paramètre de modèle machine learning apprentissage automatique A numerical value learned during a model's training and used in its computations. Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle sont ajustés en faveur des
réponses les mieux notées. Une pénalité maintient le modèle près de son point de
départ : poussé trop loin, il apprend à plaire au modèle de récompense plutôt
qu’aux personnes derrière lui (Ouyang et al., 2022).
Les comparaisons ne viennent pas forcément de personnes : dans une méthode que
ses auteurs appellent l’IA constitutionnelle, un modèle compare des réponses
sur leur caractère nuisible d’après une liste écrite de principes, et ces
comparaisons, avec des comparaisons humaines pour l’utilité, entraînent le
modèle de récompense (Bai et al., 2022a).
language models modèles de langue Definition Définition · reinforcement learning from human feedback (RLHF) apprentissage par renforcement avec rétroaction humaine (ARRH) · fr: apprentissage par renforcement avec rétroaction humaine · en : reinforcement learning from human feedback
A method for post-training a language model in which human evaluations of possible responses are used to create a reward signal, often by training a separate reward model. Méthode de postentraînement d'un modèle de langue dans laquelle des évaluations humaines de réponses possibles servent à créer un signal de récompense, souvent en entraînant un modèle de récompense distinct. (Jurafsky & Martin, 2026, pp. 209, 219–220 )
Notes Remarques Reinforcement learning then adjusts the language model to make responses receiving higher predicted rewards more likely. L'apprentissage par renforcement ajuste ensuite le modèle de langue pour rendre plus probables les réponses dont la récompense prédite est plus élevée.
La méthode est antérieure aux grands modèles de langue large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) ont
entraîné des systèmes à partir de comparaisons humaines de courts extraits de
comportement, par une méthode conçue pour des objectifs difficiles à formuler.
La DPO : apprendre directement des paires classées
L’optimisation directe des
préférences direct preference optimization (DPO) optimisation directe des préférences (DPO) language models modèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses. Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées. (DPO) part des mêmes paires classées, mais sans modèle de
récompense (Rafailov et al., 2023). Les paires sont recueillies avant
l’entraînement et restent les mêmes du début à la fin : le modèle n’écrit aucune
nouvelle réponse pendant qu’il apprend. Pour chaque paire, ses paramètres sont
ajustés de sorte que la réponse préférée devienne plus probable et la réponse
rejetée, moins probable.
La DPO est donc plus proche de l’apprentissage
supervisé supervised (machine) learning apprentissage supervisé machine learning apprentissage automatique A form of machine learning in which a model learns from labelled examples. Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. que de l’apprentissage par renforcement (Jurafsky et Martin,
2026), sans être pour autant un affinage
supervisé supervised fine-tuning (SFT) affinage supervisé language models modèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely. Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : le modèle apprend d’une comparaison entre deux réponses, et
non d’une réponse à imiter.
Figure 8. Les mêmes paires classées, utilisées de deux façons.
Le réglage des préférences : apprendre à partir de classements
La DPO : plus proche de l’apprentissage supervisé
elle apprend d’une comparaison entre deux réponses
et non d’une réponse à imiter , comme l’affinage supervisé
Le go, un défi pour l’IA
Les jeux, dont les échecs sont l’exemple le plus connu, servent depuis longtemps
de terrain d’essai à l’IA (see also the What counts as AI? page, in the Foundations of AI & NLP module) (voir aussi la page Ce qu'on appelle « IA » , dans le module Fondements de l'IA et du TAL ) ,
et le go était vu depuis longtemps comme le plus difficile des jeux classiques
(Silver et al., 2016). Il offre bien plus de coups possibles à chaque tour que
les échecs, environ 250 contre environ 35, et ses parties sont plus longues
(Silver et al., 2016). Aucun programme ne peut examiner toutes les suites
possibles d’une partie de go pour choisir la meilleure : il ne peut pas trouver
un bon coup par la force brute.
Entre 2015 et 2017, Google DeepMind a néanmoins construit des systèmes qui
jouaient bien au go, et les a mis à l’épreuve lors de matchs très médiatisés
contre des champions humains.
Figure 9. Des titres de presse de janvier à mars 2016, de l'annonce du résultat contre Fan Hui à la fin du match contre Lee Sedol, reproduits en anglais (Knight, 2016 ; Akpan, 2016 ; Reuters, 2016 ; Russell, 2016).
Apprendre des humains, puis de soi-même
AlphaGo, le programme de go, a été entraîné en deux étapes, tout comme un modèle de langue.
Il a commencé par apprendre à partir d’environ 30 millions de positions tirées
de parties entre de forts joueurs amateurs sur un serveur de go en ligne, en
prédisant le coup qu’un tel joueur jouerait (Silver et al., 2016). L’imitation tend à plafonner un programme près du niveau des joueurs qu’il copie
(Silver et al., 2017).
Puis il a joué contre lui-même, des millions de fois, et a appris de l’issue des
parties. Le jeu contre lui-même, allié à une recherche parmi les coups possibles, l’a
mené au-delà d’eux : le programme a battu un joueur professionnel,
Fan Hui, cinq parties à zéro (Silver et al., 2016). Apprendre à partir d’un
score plutôt que d’exemples, c’est l’apprentissage
par renforcement reinforcement learning (RL) apprentissage par renforcement (AR) machine learning apprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (see also the Three kinds of learning page, in the Foundations of AI & NLP module) (voir aussi la page Trois types d'apprentissage , dans le module Fondements de l'IA et du TAL ) .
Le match contre Lee Sedol et le coup 37
En mars 2016, AlphaGo a affronté Lee Sedol, l’un des plus forts joueurs du
monde, et a gagné quatre parties sur cinq (Metz, 2016).
AI IA Definition Définition · Move 37 coup 37 · fr: coup 37 · en : Move 37
The 37th move played by the Go program AlphaGo in the second game of its 2016 match against Lee Sedol, one of the strongest players in the world: a move so far outside human playing convention that one of the match's two commentators first took it for a mistake, and that proved central to winning the game. Le 37e coup joué par le programme de go AlphaGo dans la deuxième partie de son match de 2016 contre Lee Sedol, l'un des plus forts joueurs du monde : un coup si éloigné des conventions humaines que l'un des deux commentateurs du match l'a d'abord pris pour une erreur, et qui s'est révélé décisif dans la victoire. (Metz, 2016 )
Notes Remarques The name has become shorthand for two related ideas: a system trained by reinforcement learning discovering a valuable action no human would have chosen, and the moment an observer realizes that an ability they had considered inherently human is not exclusively human. Le nom est devenu un raccourci pour deux idées liées : un système entraîné par apprentissage par renforcement qui découvre une action réellement utile qu'aucun humain n'aurait choisie, et le moment où l'on réalise qu'une capacité que l'on croyait proprement humaine ne l'est pas exclusivement.
Figure 10. La position après le coup 37 de la deuxième partie, 10 mars 2016 . AlphaGo, qui joue les noirs, vient de jouer en P10. C'est le premier coup joué à quatre intersections du bord.
Des deux commentateurs du match, l’un a trouvé le coup très étrange et l’autre
l’a pris pour une erreur. Le coup s’est révélé décisif pour gagner la partie, et
AlphaGo a remporté le match une dizaine d’années avant ce qu’attendaient les
experts (Metz, 2016).
Apprendre à partir des seules règles
Un système ultérieur, AlphaZero, n’a reçu aucune partie humaine. Il est parti
des règles du jeu et de son propre jeu, et il a fini plus fort encore (Silver et
coll., 2018).
L'apprentissage par renforcement : AlphaGo et le coup 37
AI IA Definition Définition · Move 37 coup 37 · fr: coup 37 · en : Move 37
The 37th move played by the Go program AlphaGo in the second game of its 2016 match against Lee Sedol, one of the strongest players in the world: a move so far outside human playing convention that one of the match's two commentators first took it for a mistake, and that proved central to winning the game. Le 37e coup joué par le programme de go AlphaGo dans la deuxième partie de son match de 2016 contre Lee Sedol, l'un des plus forts joueurs du monde : un coup si éloigné des conventions humaines que l'un des deux commentateurs du match l'a d'abord pris pour une erreur, et qui s'est révélé décisif dans la victoire. (Metz, 2016 )
Notes Remarques The name has become shorthand for two related ideas: a system trained by reinforcement learning discovering a valuable action no human would have chosen, and the moment an observer realizes that an ability they had considered inherently human is not exclusively human. Le nom est devenu un raccourci pour deux idées liées : un système entraîné par apprentissage par renforcement qui découvre une action réellement utile qu'aucun humain n'aurait choisie, et le moment où l'on réalise qu'une capacité que l'on croyait proprement humaine ne l'est pas exclusivement.
Le go, un défi pour l’IA
Les jeux, dont les échecs sont l’exemple le plus connu, servent depuis longtemps
de terrain d’essai à l’IA (see also the What counts as AI? page, in the Foundations of AI & NLP module) (voir aussi la page Ce qu'on appelle « IA » , dans le module Fondements de l'IA et du TAL ) ,
et le go était vu depuis longtemps comme le plus difficile des jeux classiques
(Silver et al., 2016). Il offre bien plus de coups possibles à chaque tour que
les échecs, environ 250 contre environ 35, et ses parties sont plus longues
(Silver et al., 2016). Aucun programme ne peut examiner toutes les suites
possibles d’une partie de go pour choisir la meilleure : il ne peut pas trouver
un bon coup par la force brute.
Entre 2015 et 2017, Google DeepMind a néanmoins construit des systèmes qui
jouaient bien au go, et les a mis à l’épreuve lors de matchs très médiatisés
contre des champions humains.
Figure 9. Des titres de presse de janvier à mars 2016, de l'annonce du résultat contre Fan Hui à la fin du match contre Lee Sedol, reproduits en anglais (Knight, 2016 ; Akpan, 2016 ; Reuters, 2016 ; Russell, 2016).
Apprendre des humains, puis de soi-même
AlphaGo, le programme de go, a été entraîné en deux étapes, tout comme un modèle de langue.
Il a commencé par apprendre à partir d’environ 30 millions de positions tirées
de parties entre de forts joueurs amateurs sur un serveur de go en ligne, en
prédisant le coup qu’un tel joueur jouerait (Silver et al., 2016). L’imitation tend à plafonner un programme près du niveau des joueurs qu’il copie
(Silver et al., 2017).
Puis il a joué contre lui-même, des millions de fois, et a appris de l’issue des
parties. Le jeu contre lui-même, allié à une recherche parmi les coups possibles, l’a
mené au-delà d’eux : le programme a battu un joueur professionnel,
Fan Hui, cinq parties à zéro (Silver et al., 2016). Apprendre à partir d’un
score plutôt que d’exemples, c’est l’apprentissage
par renforcement reinforcement learning (RL) apprentissage par renforcement (AR) machine learning apprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (see also the Three kinds of learning page, in the Foundations of AI & NLP module) (voir aussi la page Trois types d'apprentissage , dans le module Fondements de l'IA et du TAL ) .
Le match contre Lee Sedol et le coup 37
En mars 2016, AlphaGo a affronté Lee Sedol, l’un des plus forts joueurs du
monde, et a gagné quatre parties sur cinq (Metz, 2016).
AI IA Definition Définition · Move 37 coup 37 · fr: coup 37 · en : Move 37
The 37th move played by the Go program AlphaGo in the second game of its 2016 match against Lee Sedol, one of the strongest players in the world: a move so far outside human playing convention that one of the match's two commentators first took it for a mistake, and that proved central to winning the game. Le 37e coup joué par le programme de go AlphaGo dans la deuxième partie de son match de 2016 contre Lee Sedol, l'un des plus forts joueurs du monde : un coup si éloigné des conventions humaines que l'un des deux commentateurs du match l'a d'abord pris pour une erreur, et qui s'est révélé décisif dans la victoire. (Metz, 2016 )
Notes Remarques The name has become shorthand for two related ideas: a system trained by reinforcement learning discovering a valuable action no human would have chosen, and the moment an observer realizes that an ability they had considered inherently human is not exclusively human. Le nom est devenu un raccourci pour deux idées liées : un système entraîné par apprentissage par renforcement qui découvre une action réellement utile qu'aucun humain n'aurait choisie, et le moment où l'on réalise qu'une capacité que l'on croyait proprement humaine ne l'est pas exclusivement.
Figure 10. La position après le coup 37 de la deuxième partie, 10 mars 2016 . AlphaGo, qui joue les noirs, vient de jouer en P10. C'est le premier coup joué à quatre intersections du bord.
Des deux commentateurs du match, l’un a trouvé le coup très étrange et l’autre
l’a pris pour une erreur. Le coup s’est révélé décisif pour gagner la partie, et
AlphaGo a remporté le match une dizaine d’années avant ce qu’attendaient les
experts (Metz, 2016).
Apprendre à partir des seules règles
Un système ultérieur, AlphaZero, n’a reçu aucune partie humaine. Il est parti
des règles du jeu et de son propre jeu, et il a fini plus fort encore (Silver et
coll., 2018).
L’entraînement d’AlphaGo face à celui des GML
AlphaGo a été entraîné en deux étapes, sur des parties humaines puis contre
lui-même (see also the Reinforcement learning: AlphaGo and move 37 page) (voir aussi la page L'apprentissage par renforcement : AlphaGo et le coup 37 ) . Elles
correspondent à l’affinage par instructions instruction tuning affinage par instructions language models modèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées.
et au réglage des préférences preference tuning réglage des préférences language models modèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , et la
ressemblance s’arrête à ce qui est optimisé.
Figure 11. Les deux chaînes se correspondent étape pour étape et se séparent sur ce qu'elles optimisent.
À la fin de chaque partie de go, les règles disent qui a gagné. Ce résultat est
exact, il ne coûte rien à vérifier, et un programme peut jouer des millions de
parties contre lui-même pour en recueillir davantage.
Une traduction, un résumé ou une explication n’ont rien de tel. Aucune règle ne
dit si un texte est juste ; le réglage des préférences apprend donc de
classements humains, par un modèle de récompense ou directement, et ces
classements tiennent lieu de jugement sans être une
réalité de terrain ground truth réalité de terrain evaluation évaluation The values, labels or observations treated as the correct description of the cases in a dataset. Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. (Guo et al., 2025). Un modèle de langue peut donc
produire de mieux en mieux ce que ses annotateurs préféraient, mais il n’a pas de voie
claire pour devenir surhumain en écriture comme AlphaGo et ses successeurs le
sont devenus au go,
parce que rien ne définit le sommet.
C’est une différence cruciale. Disposer d’un résultat vérifiable automatiquement
permet de continuer à optimiser sans intervention humaine, et chaque
vérification ne coûte presque rien. Dépendre de références subjectives, dont la création exige une intervention
humaine, limite au contraire considérablement ce qu’on peut optimiser et ce
qu’on doit considérer comme une bonne performance (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières ) .
L’ARV : les réponses vérifiables sont la réponse
Certaines tâches langagières aboutissent pourtant à un résultat vérifiable : une
réponse mathématique est juste ou fausse, et du code réussit ses tests ou non.
Là, l’entraînement peut de nouveau noter automatiquement les réponses du
modèle, aussi souvent que le budget le permet. C’est l’apprentissage par renforcement vérifiable (ARV),
la méthode derrière des modèles de raisonnement reasoning model modèle de raisonnement language models modèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference. Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence.
comme DeepSeek-R1, qui ont le plus progressé en mathématiques et en programmation
(Guo et al., 2025). Le nom a été introduit
pour le postentraînement des modèles ouverts Tülu 3 (Lambert et al., 2025).
language models modèles de langue Definition Définition · reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) · fr: apprentissage par renforcement vérifiable · en : reinforcement learning with verifiable rewards
A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky & Martin, 2026, p. 21 ; Lambert et al., 2025 )
Notes Remarques For example, a mathematical answer may be compared with a known solution, or generated code may be tested to determine whether it runs correctly. Reinforcement learning adjusts the model to make responses receiving higher rewards more likely. Par exemple, une réponse mathématique peut être comparée à une solution connue, ou du code généré peut être exécuté pour vérifier son bon fonctionnement. L'apprentissage par renforcement ajuste le modèle pour rendre plus probables les réponses les mieux récompensées.
Other attested French terms: apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables Autres termes français attestés : apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables
L’affinage par instructions, le réglage des préférences et l’ARV relèvent tous
de l’affinage fine-tuning affinage machine learning apprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. : chacun entraîne davantage un modèle
qui existe déjà. Le postentraînement post-training postentraînement language models modèles de langue Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. désigne les
étapes qu’un développeur mène pour faire d’un
modèle de base base model modèle de base language models modèles de langue A language model that has completed pretraining but has not yet undergone post-training. Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. un assistant (Jurafsky et Martin, 2026). Adapter un modèle à un
domaine ou à une tâche relève aussi de l’affinage, mais en dehors du
postentraînement.
Figure 12. Les sortes d'affinage que nomme ce chapitre, et celles qui forment le postentraînement.
C’est l’écran qui prépare les projets. Une traduction, un résumé ou une
explication n’aboutissent à aucun résultat qu’une règle puisse vérifier ; le
réglage des préférences optimise donc un substitut de jugement. Un modèle peut
produire de mieux en mieux ce que ses annotateurs préféraient ; il n’a pas de voie claire vers le surhumain en écriture, parce que rien ne définit le sommet.
L’absence de réponse correcte unique est le problème central de chaque projet
de ce cours.
L'ARV : apprendre à partir de réponses vérifiables
L’ARV : les réponses vérifiables sont la réponse
une réponse mathématique est juste ou fausse ; du code réussit ses tests ou non
là, l’entraînement peut noter les réponses automatiquement , aussi souvent que le budget le permet
la méthode derrière des modèles de raisonnement comme DeepSeek-R1, qui ont le plus progressé en mathématiques et en programmation
L'ARV : apprendre à partir de réponses vérifiables
language models modèles de langue Definition Définition · reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) · fr: apprentissage par renforcement vérifiable · en : reinforcement learning with verifiable rewards
A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky & Martin, 2026, p. 21 ; Lambert et al., 2025 )
Notes Remarques For example, a mathematical answer may be compared with a known solution, or generated code may be tested to determine whether it runs correctly. Reinforcement learning adjusts the model to make responses receiving higher rewards more likely. Par exemple, une réponse mathématique peut être comparée à une solution connue, ou du code généré peut être exécuté pour vérifier son bon fonctionnement. L'apprentissage par renforcement ajuste le modèle pour rendre plus probables les réponses les mieux récompensées.
Other attested French terms: apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables Autres termes français attestés : apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables
L’entraînement d’AlphaGo face à celui des GML
AlphaGo a été entraîné en deux étapes, sur des parties humaines puis contre
lui-même (see also the Reinforcement learning: AlphaGo and move 37 page) (voir aussi la page L'apprentissage par renforcement : AlphaGo et le coup 37 ) . Elles
correspondent à l’affinage par instructions instruction tuning affinage par instructions language models modèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses. Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées.
et au réglage des préférences preference tuning réglage des préférences language models modèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable. Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , et la
ressemblance s’arrête à ce qui est optimisé.
Figure 11. Les deux chaînes se correspondent étape pour étape et se séparent sur ce qu'elles optimisent.
À la fin de chaque partie de go, les règles disent qui a gagné. Ce résultat est
exact, il ne coûte rien à vérifier, et un programme peut jouer des millions de
parties contre lui-même pour en recueillir davantage.
Une traduction, un résumé ou une explication n’ont rien de tel. Aucune règle ne
dit si un texte est juste ; le réglage des préférences apprend donc de
classements humains, par un modèle de récompense ou directement, et ces
classements tiennent lieu de jugement sans être une
réalité de terrain ground truth réalité de terrain evaluation évaluation The values, labels or observations treated as the correct description of the cases in a dataset. Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. (Guo et al., 2025). Un modèle de langue peut donc
produire de mieux en mieux ce que ses annotateurs préféraient, mais il n’a pas de voie
claire pour devenir surhumain en écriture comme AlphaGo et ses successeurs le
sont devenus au go,
parce que rien ne définit le sommet.
C’est une différence cruciale. Disposer d’un résultat vérifiable automatiquement
permet de continuer à optimiser sans intervention humaine, et chaque
vérification ne coûte presque rien. Dépendre de références subjectives, dont la création exige une intervention
humaine, limite au contraire considérablement ce qu’on peut optimiser et ce
qu’on doit considérer comme une bonne performance (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières ) .
L’ARV : les réponses vérifiables sont la réponse
Certaines tâches langagières aboutissent pourtant à un résultat vérifiable : une
réponse mathématique est juste ou fausse, et du code réussit ses tests ou non.
Là, l’entraînement peut de nouveau noter automatiquement les réponses du
modèle, aussi souvent que le budget le permet. C’est l’apprentissage par renforcement vérifiable (ARV),
la méthode derrière des modèles de raisonnement reasoning model modèle de raisonnement language models modèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference. Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence.
comme DeepSeek-R1, qui ont le plus progressé en mathématiques et en programmation
(Guo et al., 2025). Le nom a été introduit
pour le postentraînement des modèles ouverts Tülu 3 (Lambert et al., 2025).
language models modèles de langue Definition Définition · reinforcement learning with verifiable rewards (RLVR) apprentissage par renforcement vérifiable (ARV) · fr: apprentissage par renforcement vérifiable · en : reinforcement learning with verifiable rewards
A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically. Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky & Martin, 2026, p. 21 ; Lambert et al., 2025 )
Notes Remarques For example, a mathematical answer may be compared with a known solution, or generated code may be tested to determine whether it runs correctly. Reinforcement learning adjusts the model to make responses receiving higher rewards more likely. Par exemple, une réponse mathématique peut être comparée à une solution connue, ou du code généré peut être exécuté pour vérifier son bon fonctionnement. L'apprentissage par renforcement ajuste le modèle pour rendre plus probables les réponses les mieux récompensées.
Other attested French terms: apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables Autres termes français attestés : apprentissage par renforcement avec récompenses vérifiables, apprentissage par renforcement à partir de résultats vérifiables
L’affinage par instructions, le réglage des préférences et l’ARV relèvent tous
de l’affinage fine-tuning affinage machine learning apprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour. Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. : chacun entraîne davantage un modèle
qui existe déjà. Le postentraînement post-training postentraînement language models modèles de langue Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses. Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. désigne les
étapes qu’un développeur mène pour faire d’un
modèle de base base model modèle de base language models modèles de langue A language model that has completed pretraining but has not yet undergone post-training. Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. un assistant (Jurafsky et Martin, 2026). Adapter un modèle à un
domaine ou à une tâche relève aussi de l’affinage, mais en dehors du
postentraînement.
Figure 12. Les sortes d'affinage que nomme ce chapitre, et celles qui forment le postentraînement.
La carte clôt le chapitre : chaque sorte d’affinage qu’elle montre a
maintenant été expliquée.