Projet 2 · Machine translationProjet 2 · Traduction automatique
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
🔒 Projet 2 · Machine translationProjet 2 · Traduction automatiqueis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Project 2 · OverviewProjet 2 · Aperçu
Le projet en bref
Le Projet 2 compare trois façons de faire traduire un même texte de l’anglais
vers le français :
avec l’agent : vous traduisez vous-même en travaillant avec un agent
conversationnel, de la préparation à la version finale ;
Les trois suivent le même mandat de traduction (public, français du Canada,
terminologie), mais ne le reçoivent pas de la même façon : DeepL ne le reçoit pas, la
requête unique le contient en entier, et avec l’agent, c’est vous qui veillez
à ce qu’il soit suivi. Un écart au mandat compte comme une erreur dans les
évaluations qui s’appuient sur lui, quelle que soit la traduction.
Ces traductions sont ensuite évaluées de quatre façons :
votre annotation de leurs erreurs, avec la grille MQM ;
le juge : un agent conversationnel à qui l’on demande de les juger ;
chrF, une métrique automatique de surface ;
COMET, une métrique automatique apprise à partir de jugements humains.
chrF et COMET comparent chaque traduction à une traduction humaine faite par
une autre équipe, la référence.
Le projet se fait en trois équipes de trois, chacune avec son agent :
Claude, ChatGPT ou Gemini.
La comparaison des quatre évaluations est le cœur du projet : un texte n’a
pas une seule bonne traduction, et les quatre évaluations ne classent pas
toujours les traductions de la même manière.
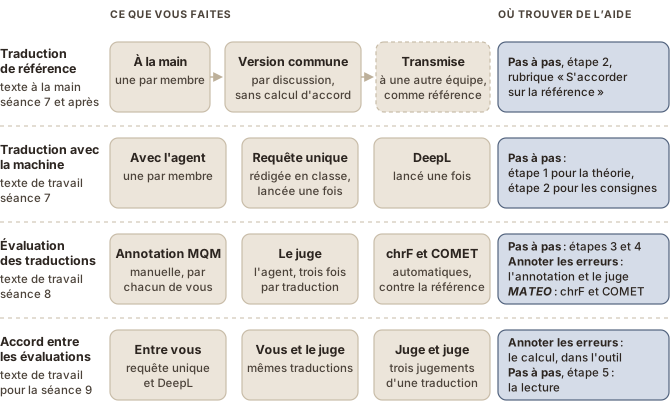
La Figure 1figure 1 résume le travail du projet et, pour chaque
partie, où trouver de l’aide.
Figure 1. Le travail du projet. La traduction de référence se fait sur le texte que vous traduisez à la main, tout le reste sur votre texte de travail.
Le Projet 2 vaut 30 % de la note du cours. Il est noté sur 100 points :
Ce qui est noté
Points
Qui
le processus : votre part dans le travail en classe (la rédaction des deux requêtes, la référence en équipe) et le travail fait (vos deux traductions, votre annotation, vos conversations avec le juge), notés sur l’engagement et non sur la qualité
10
chaque personne
la présentation
15
l’équipe
le rapport d’équipe
30
l’équipe
le rapport individuel
45
chaque personne
La note du Projet 2.
Les gabarits indiquent les points de chaque question.
Votre équipe et vos textes
Choisissez votre équipe : la page indique vos deux textes, et la page
d’annotation s’en souviendra.
You translate text 1 by hand. Your working text is text 2; its reference comes from the ChatGPT team.Vous traduisez à la main le texte 1. Votre texte de travail est le texte 2 ; sa référence vient de l'équipe ChatGPT.
You translate text 2 by hand. Your working text is text 3; its reference comes from the Gemini team.Vous traduisez à la main le texte 2. Votre texte de travail est le texte 3 ; sa référence vient de l'équipe Gemini.
You translate text 3 by hand. Your working text is text 1; its reference comes from the Claude team.Vous traduisez à la main le texte 3. Votre texte de travail est le texte 1 ; sa référence vient de l'équipe Claude.
TeamÉquipe
Translates by handTraduit à la main
Working textTexte de travail
Its reference comes fromSa référence vient de
Claude teaml'équipe Claude
text 1le texte 1
text 2le texte 2
the ChatGPT teaml'équipe ChatGPT
ChatGPT teaml'équipe ChatGPT
text 2le texte 2
text 3le texte 3
the Gemini teaml'équipe Gemini
Gemini teaml'équipe Gemini
text 3le texte 3
text 1le texte 1
the Claude teaml'équipe Claude
The rotation of the three teams over the three texts.La rotation des trois équipes sur les trois textes.
La composition des équipes et l’agent de chacune sont annoncés sur StudiUM ;
l’attribution des agents change d’un projet à l’autre.
Chaque équipe travaille sur deux textes, celui qu’elle traduit à la main
et son texte de travail, pour deux raisons :
Vos deux traductions restent indépendantes. Si vous traduisiez le même
texte à la main puis avec l’agent, la seconde traduction reprendrait vos
solutions de la première, et ne montrerait plus ce que donne le travail avec
l’agent.
La référence ne favorise aucune de vos traductions. chrF et COMET
mesurent la ressemblance avec la référence. Faite par une autre équipe, qui
n’a pas travaillé sur ce texte avec un agent, la référence ne ressemble pas
d’avance à vos traductions.
L’ordre est fixe. Sur le texte de travail, les trois traductions avec
l’agent viennent en premier, puis la requête unique, puis DeepL : une
traduction lue avant de traduire influence la vôtre.
Le projet semaine par semaine
Quand
Chaque personne
L’équipe
Toute la classe
entre les séances 6 et 7, pour le 29 octobre 2026
lire la théorie sur la traduction automatique (1)
séance 7, 29 octobre 2026
traduire à la main le texte indiqué pour votre équipe ; traduire le texte de travail avec l’agent (2)
rédiger la requête unique (2)
entre les séances 7 et 8, pour le 5 novembre 2026
finir les traductions ; vérifier vos fichiers ; lire la théorie sur l’évaluation (2, 3)
lancer la requête unique et DeepL ; s’accorder sur la référence et me l’envoyer au plus tard au début de la séance 8 (2)
séance 8, 5 novembre 2026
annoter votre traduction avec l’agent, la requête unique et DeepL ; premier jugement des deux traductions que vous faites juger (4)
chrF et COMET dans MATEO (4)
rédiger la requête du juge (4)
entre les séances 8 et 9, pour le 12 novembre 2026
finir l’annotation ; les quatre autres jugements (4)
comparer les annotations et les jugements ; rassembler les quatre classements ; préparer la présentation (5, 6)
séance 9, 12 novembre 2026
présenter (6)
20 novembre 2026, 23 h 59
le rapport individuel, avec vos deux traductions et le fichier exporté de votre annotation (7)
le rapport d’équipe (7)
Qui fait quoi, et quand. Les numéros renvoient aux étapes de la page Pas à pas.
Échéance · Listes de TermoStat et de l'agent, par équipe (par courriel, au plus tard à 23 h 59, avec les diapositives s'il y en a)
Pas de cours (période d'activités libres)
Évaluation · Rapports du Projet 1 (23 h 59, sur StudiUM)
Séance 7 · Projet 2 : vos questions sur les lectures, rédaction commune de la requête unique, traduction à la main, traduction avec l'agent
Échéance · Module sur la traduction automatique (à lire avant la séance)
Évaluation · Parcours sur Sketch Engine (23 h 59)
Séance 8 · Projet 2 : vos questions sur les lectures, annotation des erreurs, rédaction commune de la requête du juge, jugement par l'agent, chrF et COMET dans MATEO
Échéance · Lectures sur l'évaluation de la traduction automatique (avant la séance)
Échéance · Projet 2 : référence de l'équipe (par courriel, au plus tard au début de la séance)
Séance 9, évaluation · Présentations du Projet 2 ; lancement du Projet 3
Échéance · Projet 2 : diapositives de l'équipe (par courriel, au plus tard à 23 h 59 ; partagées avec toute la classe sur StudiUM)
Pas de cours (colloque à Ottawa). À faire cette semaine-là : choisir en équipe la question du Projet 3 et m'envoyer une proposition d'étude pour le dimanche 22 novembre 2026
Évaluation · Rapports du Projet 2 (23 h 59)
Échéance · Proposition d'étude du Projet 3 (23 h 59)
14 séance
28 évaluation
30 autre échéance
5 jeudi sans cours
Les traductions et leurs évaluations
Traduction
Annotation MQM
Juge, trois fois
chrF et COMET, contre la référence
les trois traductions avec l’agent, une par membre
par son auteur
oui
oui
la requête unique
par chaque membre
oui
oui
DeepL
par chaque membre
oui
oui
la référence
oui
elle sert de point de comparaison
Quelle traduction de votre texte de travail passe par quelle évaluation.
Ce que vous remettez
Les remises finales se font sur StudiUM ; les remises intermédiaires, par
courriel, à
ayla.rigouts.terryn@umontreal.ca.
Vos conversations avec l’agent et vos scores ne se remettent pas à part : ils vont dans les rapports. Un lien de partage qui ne fonctionne pas,
ou un agent qui ne permet pas le partage, se remplace par une copie de la
conversation, ajoutée à la remise du rapport où le lien figure.
Quoi
Qui
Où
Quand
la référence de l’équipe
l’équipe
courriel
au début de la séance 8, le 5 novembre 2026
les diapositives
l’équipe
courriel
12 novembre 2026, 23 h 59
le rapport individuel, avec vos deux traductions (.txt) et le fichier exporté de votre annotation (.json)
chaque personne
StudiUM
20 novembre 2026, 23 h 59
le rapport d’équipe
chaque membre, le même fichier
StudiUM
20 novembre 2026, 23 h 59
Ce que vous me remettez, par qui, où et quand.
This page is only available in French.
Project 2 · Step by stepProjet 2 · Pas à pas
1. Lire la théorie sur la traduction automatique, pour la séance 7
chaque personne traduit à la main le texte que
l’aperçu indique pour son
équipe (texte 1 pour l’équipe Claude, par exemple) ;
chaque personne traduit le texte de travail avec l’agent de l’équipe.
Puis, en équipe, en classe s’il reste du temps, sinon pour la séance 8 :
lancer la requête unique et DeepL sur le texte de travail, une fois les
trois traductions avec l’agent terminées ;
s’accorder sur une seule version du texte traduit à la main, la référence,
et me l’envoyer au plus tard au début de la séance 8.
L’ordre des traductions du texte de travail est fixe : d’abord les trois
traductions avec l’agent, puis la requête unique, puis DeepL, jamais
l’inverse. Une traduction lue avant de traduire influence la vôtre, et les
trois traductions avec l’agent doivent être terminées quand la requête unique
est lancée.
Le mandat de traduction
Toutes les traductions du projet suivent ce mandat, les traductions à la main
et la référence comprises. Il s’applique aussi à l’annotation : un terme qui
s’écarte de la liste imposée est un terme inadapté, un format de nombre qui
s’écarte des conventions une erreur de format, une espace ou un guillemet fautif une erreur
de ponctuation. Le texte ci-dessous se copie tel quel
dans la requête unique.
MANDAT DE TRADUCTIONTexte à traduire : le résumé d'un article scientifique sur la traductionautomatique, en anglais.Destination : la page « Recherche récente » du site d'un centre universitairede traduction au Québec. Lectorat : traducteurs, terminologues, réviseurs etétudiants en traduction, francophones, qui ne lisent pas la littératurespécialisée en anglais mais connaissent les outils de traduction.Langue : français du Canada. Registre neutre et soutenu, comme dansl'original ; la première personne du pluriel de l'original est conservée.Terminologie : les termes attestés, dans cet ordre de priorité : TERMIUM Plus,puis le Grand dictionnaire terminologique de l'OQLF, puis DataFranca.Termes imposés :- machine translation (MT) : traduction automatique (TA)- large language model (LLM) : grand modèle de langue (GML)- benchmark : test de performances- test set : jeu de données de test- prompt : requête- shared task : tâche partagéeUn terme technique dont l'équivalent français est peu répandu est donné enfrançais, suivi du terme anglais entre parenthèses à sa première occurrence,par exemple « apprentissage en contexte (in-context learning) ». Les noms desystèmes, de produits, de jeux de données et de conférences restent telsquels (Google Translate, WMT).Sigles : développés en français à la première occurrence, le sigle françaisentre parenthèses ; ensuite le sigle seul. Un sigle qui est un nom (WMT)reste tel quel.Format : virgule décimale ; les nombres restent en chiffres, comme dansl'original.Ponctuation : espace insécable entre un nombre et le signe % ; guillemetsfrançais « ».Fidélité : rien d'ajouté, rien d'omis ; une phrase par ligne, dans le mêmeordre que l'original.
Les trois textes et le texte d'essai
Quatre résumés d’articles sur la traduction automatique, publiés dans
l’ACL Anthology sous licence CC BY 4.0. Les trois textes ont été choisis
dans les mêmes actes, ceux de WMT 2025, pour leur longueur, leur sujet et
leur difficulté comparables : environ 160 mots en sept phrases chacun. Le
choix ne dit rien de la qualité des articles.
Texte d’essai : Stanovsky et al. (2019), Evaluating Gender Bias in Machine Translation, Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, p. 1679–1684.
Traduire avec l'agent
Des conseils, non des exigences : ce qui est noté est dit à la question 1.2
du rapport individuel.
Une conversation que vous menez. La requête unique montre ce que l’agent
produit seul ; ici, c’est vous qui menez la traduction, en allers-retours
jusqu’à une version qui vous satisfait. Il n’y a pas de nombre minimal de
tours : si la traduction vous satisfait vite, une conversation courte
suffit, et elle n’est pas pénalisée. Ce qui est noté est ce que vous avez
demandé et vérifié, pas le nombre de tours.
Ne demandez pas tout le texte traduit dès le premier message. Travaillez
par étapes : la préparation (lire le texte, repérer les difficultés,
chercher la terminologie avec des sources), un premier jet, puis la
révision.
Donnez le mandat dès le premier message, en entier : le public, le
français du Canada, les termes imposés, les conventions. Sans lui, l’agent
part dans une mauvaise direction et vous perdez des tours à le corriger.
Faites des demandes ciblées, un terme, une phrase, un passage :
« remplace partout ce terme par celui-ci », « cette phrase suit trop
l’anglais », « prends le terme de TERMIUM ».
Demandez les sources dès le début, jamais après coup : demandées après,
elles risquent d’être inventées.
Le mandat est le vôtre à faire respecter : vérifiez chaque terme
imposé et chaque convention dans la version finale, l’agent ne le fera pas
pour vous.
Si l’agent refuse, s’interrompt ou atteint une limite d’usage, reprenez
dans une nouvelle conversation et notez-le ; un refus qui persiste est un
résultat, à signaler dans le rapport.
La version finale n’a pas à venir de l’agent. Quand il devient plus
rapide de corriger vous-même, faites-le. Une fonction de document partagé,
comme le canevas de certains agents, peut aider.
La conversation est notée (rapport individuel, question 1.2), la qualité de
la traduction obtenue ne l’est pas.
La requête unique
Une seule requête pour tout le groupe, rédigée ensemble à partir d’une
requête de départ et du mandat de traduction, qu’elle contient en entier, et
essayée sur le texte d’essai : les traductions faites
avec elle ne diffèrent donc que par l’agent. Chaque équipe la lance une seule
fois sur son texte de travail, dans une nouvelle conversation, sans rien
ajouter ni corriger ensuite. Notez le modèle exact, la date et le niveau
de raisonnement.
Le point de départ, à améliorer ensemble en classe :
Traduis le texte ci-dessous de l'anglais vers le français du Canada. C'est le résumé d'un article scientifique sur la traduction automatique, destiné à la page « Recherche récente » du site d'un centre universitaire de traduction au Québec, lue par des traducteurs, des terminologues, des réviseurs et des étudiants en traduction francophones qui ne lisent pas la littérature spécialisée en anglais mais connaissent les outils de traduction, dans un registre neutre et soutenu comme l'original, en gardant la première personne du pluriel, avec les termes attestés par TERMIUM Plus, sinon par le Grand dictionnaire terminologique de l'OQLF, sinon par DataFranca, et en traduisant machine translation (MT) par traduction automatique (TA), large language model (LLM) par grand modèle de langue (GML), benchmark par test de performances, test set par jeu de données de test, prompt par requête et shared task par tâche partagée, un terme technique dont l'équivalent français est peu répandu étant donné en français suivi du terme anglais entre parenthèses à sa première occurrence, les noms de systèmes, de produits, de jeux de données et de conférences restant tels quels, les sigles étant développés en français à la première occurrence avec le sigle français entre parenthèses puis le sigle seul, avec la virgule décimale, une espace insécable entre un nombre et le signe %, les guillemets français et les nombres en chiffres comme dans l'original, sans rien ajouter ni omettre, une phrase par ligne dans le même ordre que l'original, et sans aucun commentaire, seulement la traduction.[le texte, une phrase par ligne]
S'accorder sur la référence
Comparez les trois traductions à la main phrase par phrase et décidez
d’une seule version. Gardez une trace de chaque désaccord : les solutions
proposées, celle que l’équipe retient, et pourquoi. Le rapport d’équipe
demande ce tableau.
Gardez la référence dans l’équipe. L’équipe qui l’utilise ne doit pas
la voir avant d’avoir terminé son annotation.
Envoyez-la-moi par courriel au plus tard au début de la séance 8, le
5 novembre 2026, en .txt, une phrase par ligne, avec le même découpage que le
texte source. Je l’ajoute à cette page, que seuls les étudiants du cours
peuvent ouvrir, pour qu’elle soit plus facile à manipuler sur le site, par
exemple à charger dans l’outil de la page « Annoter les erreurs » ;
si votre équipe n’est pas d’accord, dites-le-moi en me l’envoyant. Vous la
collerez aussi dans le rapport d’équipe. Si une
référence manque, l’équipe qui l’attend calcule chrF et COMET à la maison
dès qu’elle arrive ; le retard est celui de l’équipe qui la devait.
La traduction de DeepL
Un membre de l’équipe la fait, une seule fois. Pour que les traductions de
DeepL des trois équipes se comparent :
la version gratuite, sur deepl.com,
avec les réglages par défaut : le français comme langue d’arrivée, sans
glossaire ni choix de registre ;
le texte de travail collé en entier, une phrase par ligne : DeepL garde
en général les sauts de ligne ; vérifiez le nombre de lignes comme pour
les autres fichiers ;
sans le mandat de traduction, par choix : DeepL est le point de
comparaison sans consigne, et ses écarts au mandat comptent comme ceux des
autres traductions ;
une seule traduction, gardée telle quelle, sans retouche ;
Nommez chaque fichier par le texte, la façon de traduire et, pour une
traduction personnelle, vos initiales, sans espace ni accent.
Pour la personne AB de l’équipe Claude, qui traduit le texte 1 à la main et
travaille sur le texte 2 :
texte1_a-la-main_AB.txt et texte2_avec-agent_AB.txt ;
texte1_reference.txt pour la référence de l’équipe, qui porte sur le texte
traduit à la main ;
texte2_requete-unique.txt pour la requête unique ;
texte2_deepl.txt pour la traduction de DeepL.
Vérifiez vos fichiers dès qu’ils sont prêts en chargeant le texte source,
votre traduction avec l’agent, la requête unique et DeepL sur
Projet 2 · Annoter les erreurs :
la page dit lequel n’a pas le bon nombre de lignes ou contient une ligne vide.
Un fichier décalé d’une phrase qui a pourtant le bon nombre de lignes passe ces
vérifications, et celles de MATEO : relisez le début et la fin de chaque
fichier en face de la source.
3. Lire la théorie sur l’évaluation, pour la séance 8
Si vous le pouvez, faites une fois l’essai décrit sur la page
MATEO, avec un court texte que vous avez
traduit vous-même : à la séance 8, vous lancerez MATEO sur les fichiers du projet sans
avoir à découvrir l’outil.
4. Évaluer, à la séance 8
À la séance 8, après vos questions sur les lectures : chaque personne
annote les erreurs, toute la classe rédige la requête du juge (votre part
dans ce travail compte dans la note du processus), puis
chaque équipe fait juger ses traductions et calcule chrF et COMET dans
MATEO. Ce qui n’est pas fini en classe se termine pour la séance 9.
Trois traductions : la vôtre avec l’agent, celle de la requête unique
et celle de DeepL. Les deux dernières sont les mêmes pour toute l’équipe.
Annoter sa propre traduction n’est pas ce que prévoit MQM, où
l’annotateur n’a pas fait la traduction : signalez-le dans votre rapport.
La grille, les règles d’annotation et le fonctionnement de l’outil sont
sur la page.
Exportez votre travail à la fin de la séance, et gardez le fichier : il
sert à comparer en équipe (étape 5) et il se remet avec le rapport
individuel (étape 7).
La requête du juge
Rédigée ensemble à la séance 8, à partir de la grille d’annotation et du
mandat : les mêmes catégories, les mêmes règles, les mêmes gravités et le même
mandat, pour que le jugement de l’agent et le vôtre se comparent. La gravité neutre n’y figure pas : une
préférence ne compte pas dans le score. L’agent juge une traduction par
requête, sans référence et sans savoir qui l’a faite, et donne un résultat de
forme fixe : ses erreurs, puis leur nombre par gravité.
Le point de départ, à améliorer ensemble en classe :
You are an impartial evaluator of English-to-French (Canada) translations.You annotate errors with the MQM typology of Freitag et al. (2021).# Input- SOURCE: an English scientific abstract, one numbered sentence per line.- TRANSLATION: its French translation, with the same numbering.No reference translation is given.# TaskIdentify the errors in the translation, judged against the source andagainst the norms of Canadian French, reading the translation as a wholetext. Do not rewrite or correct the translation. A wording that is correctbut that you would phrase differently is not an error.# Translation brief (applies to every translation)Target: Canadian French, neutral formal register, for a web page read byfrancophone language professionals.Required terms: machine translation = traduction automatique (TA); largelanguage model = grand modèle de langue (GML); benchmark = test deperformances; test set = jeu de données de test; prompt = requête; sharedtask = tâche partagée. Any other term follows TERMIUM Plus, then the OQLF,then DataFranca.Format: decimal comma; numbers as digits, as in the source. Punctuation: ano-break space before %; French quotation marks « ». Acronyms expanded inFrench at first mention, except names such as WMT; names of systems,products, datasets and conferences unchanged.A term that departs from the required list is Terminology/Inappropriate. Anumber format that departs from the conventions is Locale convention/Format;a spacing or quotation-mark fault is Fluency/Punctuation. AFrench term followed by the English term in brackets at its firstoccurrence is not an error.# Categories (category/subcategory)- Accuracy/Addition: information not present in the source- Accuracy/Omission: content of the source missing from the translation- Accuracy/Mistranslation: the translation does not accurately represent the source- Accuracy/Untranslated: source text left in English- Fluency/Punctuation: incorrect punctuation, French spacing and quotation marks included- Fluency/Spelling: incorrect spelling or capitalization- Fluency/Grammar: problems with grammar, other than spelling- Fluency/Register: wrong grammatical register- Fluency/Inconsistency: internal inconsistency, not related to terminology- Terminology/Inappropriate: a term that is non-standard or does not fit the field- Terminology/Inconsistent: the same term translated in different ways- Style/Awkward: awkward or calqued phrasing- Locale convention/Format: wrong format for numbers, dates, units or names- Other: any other issue- Source error: an error in the English text itself; it does not count against the translation# Rules- Mark each error separately: two mistranslated words are two errors.- If one passage has several problems, mark only the most severe; if they are equally severe, the category listed first.- At most five errors per sentence: keep the five most severe.# Severities- major: seriously affects the understandability, reliability or usability of the text; the reader is misled or cannot follow- minor: a real imperfection that does not prevent the reader from understanding or relying on the text# OutputOne line per error, in this format:sentence number | category/subcategory | severity | words in error | explanation in French, one sentenceThen the totals, on three lines:major: nminor: nof which minor punctuation: nIf there is no error, write "No errors" and totals of 0.# Example of the expected output (for another text)2 | Accuracy/Omission | major | professional | Le mot « professional » n'est pas traduit.4 | Fluency/Punctuation | minor | modéré: | Il manque l'espace avant le deux-points.major: 1minor: 1of which minor punctuation: 1# SOURCE[the source text, one numbered sentence per line]# TRANSLATION[the translation, with the same numbering]
Faire juger les traductions par l'agent
Trois jugements par traduction, chacun dans une nouvelle conversation,
avec la requête du juge et l’agent de votre équipe. Six traductions sont
jugées : vos trois traductions avec l’agent, celle de la requête unique, celle
de DeepL et la référence.
Chacun fait juger sa traduction avec l’agent et une des trois traductions
communes :
répartissez la requête unique, DeepL et la référence entre vous. Cela fait
six conversations par personne.
Les premiers jugements à la séance 8, les deux autres pour la séance 9.
Le premier sert à comparer le juge à votre annotation ; les trois ensemble
montrent si le juge est constant.
La page Projet 2 · Annoter les erreurs,
partie « 3 · Le juge », prépare chaque requête et lit chaque réponse : un
bouton copie la source et la traduction numérotées, à coller dans la
requête, et la réponse du juge se colle telle quelle dans sa case. Pour la
référence, chargez-la d’abord sur la page, une fois votre annotation
terminée.
Si la réponse ne suit pas le format, demandez dans la même conversation
les mêmes erreurs dans le format demandé, sans redemander de jugement : une
nouvelle demande donnerait un autre jugement. Une réponse impossible à remettre
au format est elle aussi un résultat sur le juge : notez-la.
Si l’agent refuse ou s’interrompt, recommencez dans une nouvelle
conversation ; une limite d’usage atteinte se contourne en répartissant les
jugements autrement dans l’équipe, ou en attendant.
Gardez le lien de chaque conversation de jugement pour le rapport
d’équipe (tableau 3.1).
La référence de votre texte de travail : à ouvrir une fois votre annotation terminée
Les trois références sont ajoutées ici au début de la séance 8 ; seule celle
de votre texte de travail vous sert. N’ouvrez la référence de votre texte
de travail qu’une fois votre annotation terminée : avec la référence en
tête, on annote ce qui en diffère plutôt que ce qui est faux.
chrF et COMET dans MATEO
En équipe, une seule fois : les cinq traductions de votre texte de travail
(les trois traductions avec l’agent, la requête unique et DeepL), comparées à
la référence de ce texte, avec deux métriques :
chrF, une métrique de surface, qui compte les suites de caractères
communes ;
COMET, une métrique qui compare le sens, apprise à partir de jugements
humains.
La page MATEO décrit l’outil en détail.
Sur MATEO, page « Evaluate » :
Les métriques, sous « Metric selection » : gardez chrF et COMET,
décochez BLEU, et gardez les options proposées par défaut.
Les fichiers, sous « Input data » : indiquez d’abord le nombre de
traductions (« How many systems do you wish to compare? »), puis déposez
la référence dans « Reference file », le texte source dans « Source file »
(COMET en a besoin) et chaque traduction dans sa case « System ». MATEO
accepte au plus quatre traductions à la fois : faites un premier calcul
avec les trois traductions avec l’agent et la requête unique, puis un
second avec DeepL. Le score d’une traduction ne dépend pas des autres
traductions calculées avec elle.
Les scores du texte entier, sous « Evaluation results (corpus) » :
téléchargez le tableau. Les intervalles de confiance et les valeurs p ne
sont pas demandés.
Les scores phrase par phrase, sous « Evaluation results
(sentences) » : MATEO ne les donne que pour COMET. Téléchargez-les aussi :
ils servent à trouver les phrases où COMET et votre annotation ne sont pas
d’accord.
Comparez les traductions à l’intérieur d’une même métrique, jamais un
score de chrF à un score de COMET : leurs échelles sont différentes.
5. Comparer, pour la séance 9
En équipe, sur Projet 2 · Annoter les erreurs,
chacun ajoute les fichiers exportés des deux autres, échangés entre vous par
courriel ou autrement. La page donne alors :
les scores de chaque traduction : votre annotation, et les trois
jugements de l’agent avec leur moyenne ;
les erreurs par catégorie, pour chaque membre et chaque jugement ;
les phrases où vous divergez, vous et le juge compris.
Avec les scores de MATEO, vous avez alors les quatre classements des cinq
traductions avec et sans l’agent : l’annotation (celle de l’auteur pour une
traduction avec l’agent, la moyenne de l’équipe pour la requête unique et
DeepL), le juge (la moyenne de ses trois jugements), chrF et COMET. Ces quatre
classements nourrissent la présentation et sont au cœur des rapports.
Regardez les écarts autant que les rangs. Sur un texte de sept
phrases, une seule erreur peut faire passer une traduction de la première à la
dernière place : avant de conclure que deux évaluations divergent, regardez de
combien les traductions diffèrent dans chacune, et dans quelles phrases.
6. Présenter, à la séance 9
Le 12 novembre 2026, de 15 à 20 minutes par équipe, discussion comprise.
Les diapositives sont obligatoires, et je les partage avec toute la classe
sur StudiUM : c’est par elles que chaque équipe a les résultats des deux
autres pour son rapport. Elles contiennent au moins le tableau des quatre
évaluations des cinq traductions, avec les scores et les rangs (le tableau 5.1
du rapport d’équipe). Envoyez-les-moi par courriel au plus tard le 12 novembre 2026
à 23 h 59.
Une seule personne peut faire l’essentiel de la présentation : vous n’avez
pas à vous relayer. Chaque membre de l’équipe doit toutefois pouvoir répondre
aux questions et prendre part à la discussion. Je vous suggère aussi que
chacun présente brièvement ses propres annotations d’erreurs : c’est là que
vos jugements diffèrent le plus d’une personne à l’autre.
L’équipe qui a fait la référence de votre texte de travail est dans la salle :
vous pouvez lui demander pourquoi elle a fait ses choix, et elle peut les
défendre.
Ce qui est noté dans la présentation
La présentation sert à partager votre expérience avec les autres équipes et à
en discuter avant d’écrire les rapports. Ce qui compte, ce sont des exemples
concrets et ce que vous avez vécu, pas une analyse terminée : l’analyse est
notée dans les rapports.
Critère
Points
Ce qui vaut tous les points
Vos annotations d’erreurs
4
les erreurs que vous avez trouvées dans les traductions de votre texte de travail, avec des exemples, et où vos annotations divergent
Votre agent conversationnel
4
votre façon de traduire avec lui, ce qui a marché ou non, des exemples, ce qu’il fait autrement que la requête unique et DeepL, et son jugement comme juge comparé au vôtre
DeepL et les scores, brièvement
1
le tableau des quatre évaluations des cinq traductions, pour que les équipes puissent se comparer. Un seul point, parce que DeepL est le même outil pour toutes les équipes et que les scores sont calculés par l’outil d’annotation et MATEO
La discussion
4
des réponses claires aux questions, sur votre référence aussi, et de l’intérêt pour les résultats des autres équipes
Clarté et présentation
2
on comprend ce que vous avez fait, la présentation est structurée et tient dans le temps prévu
Les critères de la présentation, sur 15 points.
7. Rédiger les deux rapports, pour le 20 novembre 2026
Pour le 20 novembre 2026, 23 h 59, sur StudiUM, en PDF sur les gabarits, dans
deux remises : « Projet 2 · Rapport individuel », où vous joignez aussi vos
deux traductions (.txt) et votre dernier fichier exporté de l’annotation
(.json), avec tous vos jugements, et « Projet 2 · Rapport d’équipe », où chaque membre dépose le même rapport.
Chaque gabarit indique où trouver chaque chiffre, les repères de lecture des
scores et les points de chaque question.
Les agents conversationnels dans les rapports
Les agents conversationnels sont permis pour les rapports et la présentation,
comme toute autre ressource : un agent qui vous aide à structurer, à
reformuler ou à vérifier un calcul ne vous coûte rien, puisque ce qui est
noté, c’est votre raisonnement. Déclarez-le brièvement à la fin de chaque
rapport : quel agent, et pour quoi. Un usage non déclaré relève du règlement
sur l’intégrité.
This page is only available in French.
Project 2 · Annotating the errorsProjet 2 · Annoter les erreurs
La grille
La grille est celle de MQM dans la version de Freitag et al. (2021), que WMT
emploie encore pour ses annotations MQM, réduite à ce qu’un résumé
scientifique traduit de l’anglais vers le français peut contenir. Depuis 2024,
WMT évalue la plupart de ses paires de langues avec ESA, un protocole plus
rapide qui garde les erreurs et leur gravité mais pas leur catégorie ; MQM est
le cadre sur lequel ESA est construit (Kocmi et al., 2025) (see also the Human evaluation: DA, MQM and ESA page, in the Evaluating language technology module) (voir aussi la page L'évaluation humaine : DA, MQM et ESA, dans le module L'évaluation des technologies langagières).
Pour chaque erreur, vous choisissez une sous-catégorie, qui donne sa
catégorie, puis une gravité.
CategoryCatégorie
SubcategorySous-catégorie
What it coversCe qu'elle couvre
AccuracyExactitude
AdditionAjout
the translation includes information not present in the sourcela traduction contient une information absente de la source
OmissionOmission
the translation is missing content from the sourceil manque à la traduction une partie du contenu de la source
MistranslationErreur de sens
the translation does not accurately represent the sourcela traduction ne rend pas fidèlement la source : faux sens, contresens, non-sens
Untranslated textPassage non traduit
source text has been left untranslatedun passage de la source est resté en anglais
FluencyFluidité
PunctuationPonctuation
incorrect punctuation for the locale or the style, spacing and quotation marks includedponctuation incorrecte, y compris les espaces et les guillemets du français
SpellingOrthographe
incorrect spelling or capitalizationorthographe ou majuscules incorrectes
GrammarGrammaire
problems with grammar, other than spellingaccords, conjugaison, construction de la phrase
RegisterRegistre
wrong grammatical register, for instance inappropriately informal pronounsregistre grammatical inapproprié, par exemple un tutoiement
InconsistencyIncohérence
internal inconsistency, not related to terminologyincohérence interne qui ne porte pas sur un terme
TerminologyTerminologie
Inappropriate for contextTerme inadapté
terminology is non-standard or does not fit the contextterme non standard ou qui ne convient pas au domaine
Inconsistent useTerme incohérent
terminology is used inconsistentlyun même terme est traduit de plusieurs façons
StyleStyle
AwkwardMaladresse
the translation has stylistic problemstournure lourde, peu naturelle ou calquée sur l'anglais
Locale conventionConventions locales
FormatFormat
wrong format for numbers, dates, units or namesformat des nombres, des dates, des unités ou des noms
OtherAutre
OtherAutre
any other issue, explained in the notetout autre problème, expliqué dans la note
Source errorErreur dans la source
Source errorErreur dans la source
an error in the English text; it does not count against the translationune erreur du texte anglais ; elle ne compte pas contre la traduction
The error categories, after Freitag et al. (2021).Les catégories d'erreurs, d'après Freitag et al. (2021).
SeverityGravité
When to use itQuand l'employer
WeightPoids
majormajeure
seriously affects the understandability, reliability or usability of the text: the reader is misled or cannot follownuit sérieusement à la compréhension, à la fiabilité ou à l'utilité du texte : le lecteur est induit en erreur ou ne comprend pas
5
minormineure
a real imperfection that does not prevent the reader from understanding or relying on the textune imperfection réelle, qui n'empêche pas de comprendre ni de se fier au texte
1 (0.1 for punctuation)1 (0,1 pour la ponctuation)
neutralneutre
a preference: the translation is correct, but you would have phrased it differentlyune préférence : la traduction est correcte, mais vous l'auriez formulée autrement
0
The severities and their weights, after Freitag et al. (2021). A source error weighs nothing.Les gravités et leurs poids, d'après Freitag et al. (2021). Une erreur dans la source ne pèse rien.
La gravité neutre sert à noter une préférence sans la compter comme une
erreur : elle ne pèse rien dans le score, mais elle reste dans votre
annotation, et vous pouvez en parler dans vos rapports.
Les règles d’annotation
D’après les consignes d’annotation de Freitag et al. (2021) :
Le texte source, le mandat de traduction et la traduction. Ni la
référence, ni une autre traduction du même texte : MQM juge une traduction par rapport à
sa source, et une traduction sous les yeux fait relever ce qui en diffère
plutôt que ce qui est faux. L’outil montre donc une seule traduction à la
fois. Les dictionnaires et les banques de terminologie restent permis.
Le mandat compte comme la source. Un terme qui s’écarte de la liste
imposée est un terme inadapté (terminologie), un format de nombre qui
s’écarte des conventions une erreur de format (conventions locales), une
espace ou un guillemet fautif une erreur de ponctuation (fluidité) ; un terme anglais
gardé entre parenthèses après son équivalent français n’est pas une erreur.
Le mandat est sur Projet 2 · Pas à pas,
à l’étape 2.
Lisez la traduction comme un texte, phrase après phrase. Une formulation
qui convient dans ce texte n’est pas une erreur, même si elle serait douteuse
ailleurs ; une formulation correcte ailleurs mais fausse dans ce texte en est
une.
Une erreur par problème. Deux mots mal traduits dans une phrase font deux
erreurs. Un même passage qui pose plusieurs problèmes n’en compte qu’une, la
plus grave ; à gravité égale, la catégorie qui vient la première dans la
grille.
Une erreur répétée dans plusieurs phrases compte dans chacune.
Une préférence n’est pas une erreur : si la traduction est correcte mais
que vous l’auriez formulée autrement, la gravité est neutre.
Citez les mots en cause : ceux de la traduction, ou ceux de la source
pour une omission ou une erreur dans la source. Ajoutez une note quand la
catégorie ne suffit pas à comprendre le problème.
Cinq erreurs au plus par phrase. S’il y en a davantage, gardez les cinq
plus graves.
Annotez les trois traductions l’une après l’autre, et cochez la case du
bas quand vous avez relu toutes les phrases d’une traduction. Pour ajouter
une erreur, sélectionnez à la souris les mots en cause dans la traduction,
ou dans la source pour une omission : le formulaire s’ouvre avec ces mots,
et une fois l’erreur ajoutée, ils restent marqués dans la couleur de sa
catégorie. Le bouton « + erreur » ouvre le formulaire sans sélection.
Le juge : pour chaque traduction que vous faites juger, le bouton
« Copier la source et la traduction numérotées » prépare le texte de la
requête, et chaque réponse du juge se colle telle quelle dans sa case. La
page lit les erreurs ; une ligne signalée en rouge se corrige directement
dans la case. Pour la référence, chargez d’abord son fichier, une fois votre
annotation terminée.
Rien n’est envoyé : vos fichiers sont lus par votre navigateur et
restent sur votre ordinateur.
L’outil
4 · Results and comparison4 · Résultats et comparaison
Sources
Freitag, M., Foster, G., Grangier, D., Ratnakar, V., Tan, Q., & Macherey, W. (2021). Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation. Transactions of the Association for Computational Linguistics, 9, 1460–1474. https://doi.org/10.1162/tacl_a_00437
Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22