Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Rules written by people
A rule-based system automates a task by applying rules that people wrote down.
Two examples of simple rule-based systems are:
- a grammar checker:
a singular subject followed by a plural verb ⇒ flag the sentence - a date converter:
four digits, a hyphen, two digits, a hyphen, two digits ⇒ a date; reorder the parts
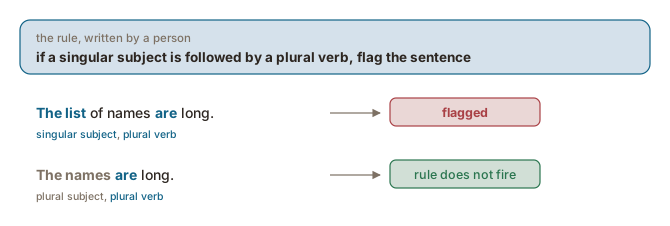
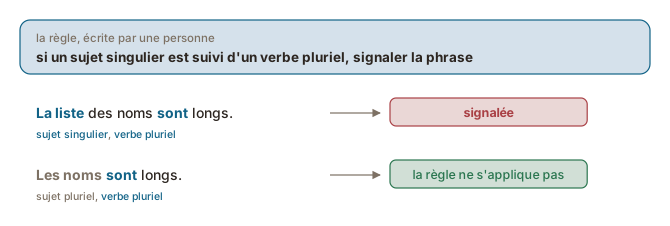
Every piece of the system’s behaviour was specified by a human, which is why this is called the deductive approach: general rules first, applied to each new case. Figure 1figure 1 shows one such rule applied to two sentences.
For language, the rule writers were often linguists. Early machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. systems, spelling and grammar checkers, and the first dialogue systems were built from thousands of grammatical rules, dictionary entries and transformation patterns, each written and maintained by hand.
The text a rule can see
A rule can only test what the program can observe in the text. The date converter’s rule is written in characters, digits and hyphens, which any program can read. The grammar checker’s rule assumes that the program already knows which words form the subject, whether it is singular and which word is the verb, and none of that is written in the text: it takes part-of-speech tagging part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. and parsing first, each a task of its own. Writing a rule therefore starts by translating what a person notices into something a program can measure.
Strengths and weaknesses
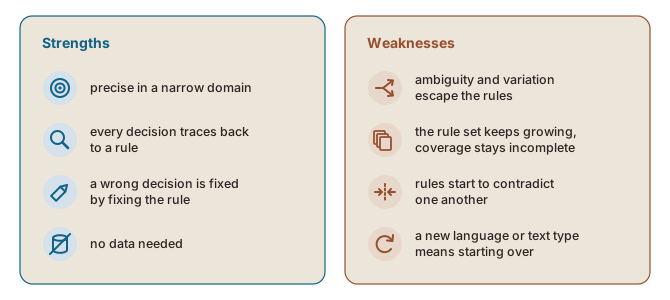
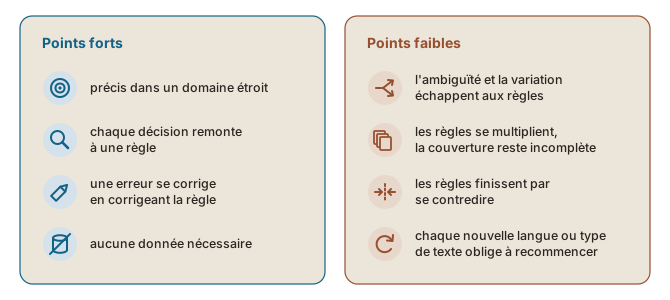
Rule-based systems are still in use, and Figure 2figure 2 sums up why, and why the field moved on. In a narrow, well-defined domain they are precise, every decision can be traced to a rule a person can read and fix, and they need no data. Against real language, which is ambiguous ambiguityambiguïté linguisticslinguistique The property of a stretch of language that allows more than one interpretation.Propriété d'un segment de langue qui autorise plus d'une interprétation. , variable and full of exceptions, the rule set keeps growing without ever covering everything, and every new language or text type means starting over (see also the Why language is hard chapter, in the Language as numbers module) (voir aussi le chapitre Pourquoi le langage est difficile, dans le module Le langage en nombres).
By the late 1980s, the weaknesses had pushed the field toward another way of building systems, in which the patterns are found in data instead of written as rules.
From cases to patterns
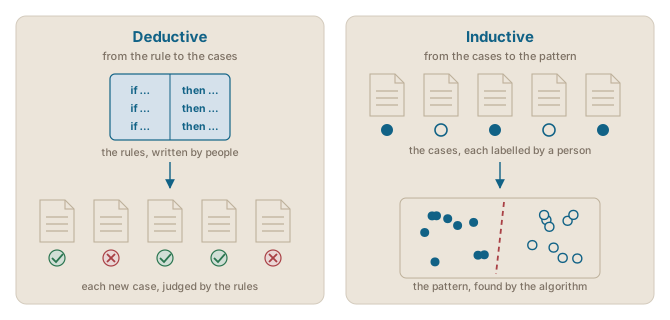
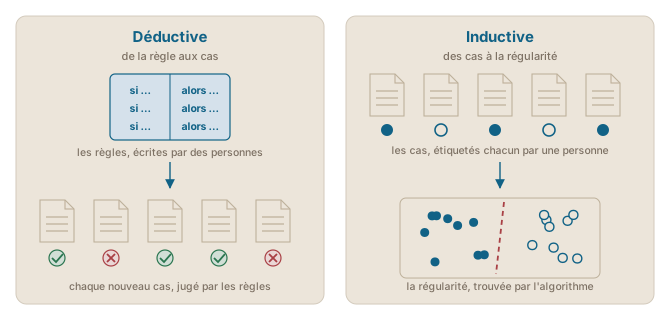
Instead of asking an expert to write the rules, you can collect examples that people have already labelled, and let an algorithm work out what separates them. Letting the algorithm find the pattern in the cases is the inductive approach; a rule-based system rule-based systemsystème à base de règles AIIA A system whose behaviour is fixed by rules that people wrote, most often of the form "if this condition, then this action", so that every output can be traced to the rule that produced it.Système dont le comportement est fixé par des règles écrites par des personnes, le plus souvent de la forme « si cette condition, alors cette action », de sorte que chaque résultat peut être rapporté à la règle qui l'a produit. works the other way round, from a general rule to each case, which is the deductive approach (Figure 3figure 3). The field made that turn to machine learning machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. in the late 1980s.
In this paradigm a person still chooses what the system measures, its features featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. , which is why it is also called statistical or feature-based machine learning. The algorithm adjusts a model one labelled example at a time (see also the Learning from labelled examples page) (voir aussi la page Apprendre à partir d'exemples étiquetés). Machine learning replaced rule writing for three reasons: a learned system can combine hundreds of weak signals that nobody would think to write down, labelling examples is cheaper and less specialized work than writing and maintaining rules, and a method transfers to a new language or domain once examples in it are collected. The table below sets the two paradigms side by side.
Rules against machine learning
| Aspect | Rule-based systems | Machine learning systems |
|---|---|---|
| What they depend on | Experts, who write and maintain the rules | A corpus, large and, for many tasks, annotated by people |
| Variation and ambiguity ambiguityambiguïté linguisticslinguistique The property of a stretch of language that allows more than one interpretation.Propriété d'un segment de langue qui autorise plus d'une interprétation. | A case nobody foresaw is a case nobody handled | Handled, provided enough cases like it are in the data and the features let the system find a systematic difference; an unusual case still gets an answer, as a degree of likelihood |
| Interpretability | Every decision traces back to a rule a person can read and change | Readable to a degree that depends on the algorithm; a decision is changed by changing the data |
| A new language or domain | Start again | Collect data, retrain |
| Where they fit | Narrow, well-defined tasks, and tasks with no data | Tasks with much variation and much data |
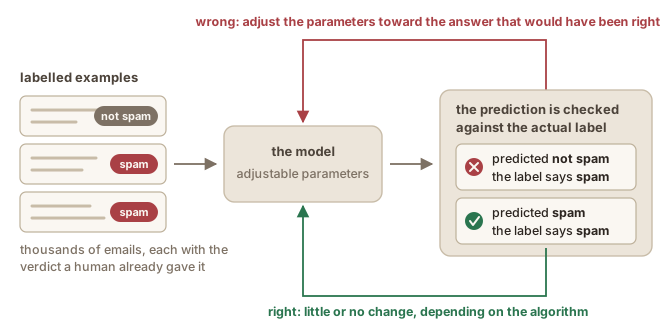
Suppose you want a system that sorts email into spam and not spam. The rule-based way is to describe spam: certain senders, certain words, too many links. The supervised way is to show the system ten thousand emails that a human already sorted, and let it work out the difference. Each email with its human verdict attached is a labelled example, and a collection of many labelled examples becomes training data.
Training then runs as a loop. The algorithm takes an example, predicts a label, and compares its prediction with the human label. A wrong prediction adjusts the model’s settings, a little, in the direction that would have made it right. A correct one changes little or nothing: some algorithms leave the settings exactly as they are, others nudge them toward answering the same way more confidently.The settings are the model’s parameters parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. . How they are stored and adjusted is not covered in this module; the loop is the point here, not the arithmetic inside it (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue). One pass through one email teaches almost nothing. Millions of passes through thousands of examples add up, and the predictions improve until they are good enough to use on email nobody has labelled.
Two consequences follow directly from this setup, and they will come back again and again in this collection:
- Everything is learned from the data, not from rules. The system reproduces the judgements in its training data, mistakes and blind spots included, and the data is the only way in: there is no rule to rewrite when it gets something wrong.
- The training data has to resemble the real job. A spam filter trained on English corporate email will stumble on French phishing. What the examples do not show, the model cannot learn.
Before anything can be learned, somebody has to decide what the algorithm looks at when it compares two emails.
First line: there is no rule to rewrite when the system gets something wrong, so the data is the only way in. Second: a spam filter trained on English corporate email stumbles on French phishing.
Algorithms cannot read emails the way humans do: they need numbers. So each example has to be described as a set of measurable properties: how long the message is, whether the sender is in your address book (typically encoded as 1 if yes, 0 if no), how many links it contains, whether the words win, free or miracle appear. Each such property is a feature.
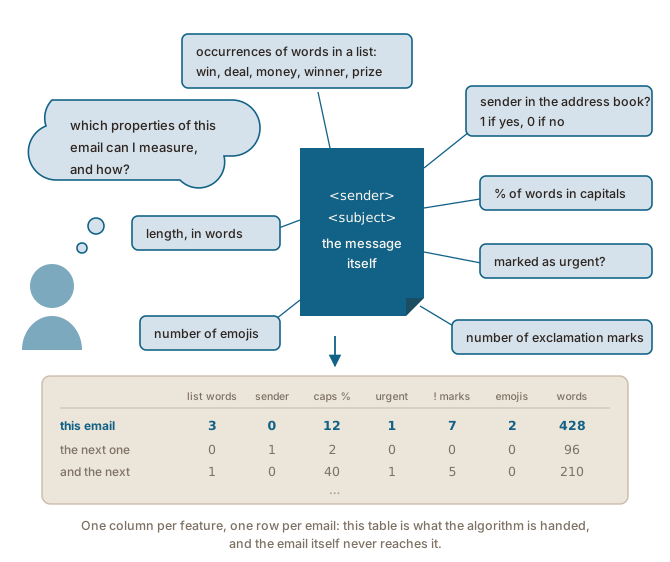
In traditional machine learning, choosing the features is human work, and it is where most of the craft goes. Someone has to guess which properties distinguish spam from ordinary mail, work out how to turn each one into a number, test the result, and go back for better features when the model disappoints. The guesses are hypotheses about the problem, and bad ones cap what any algorithm can achieve.
The strength of this recipe, features plus labels plus the loop, is that it can weigh hundreds of weak signals at once, which no hand-written rule set manages. Its ceiling is the features themselves: the model can only be as observant as the properties someone thought to measure. That ceiling is what neural networks later removed, by learning the features too (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue).
The same example, described by the same features, can be put to two different questions. Asked which of a fixed set of categories it belongs to, the task is classification: spam or not spam, positive or negative review, which part of speech a word is. Asked for a value on a scale, the task is regression: how many minutes a text takes to read, how long a translator will need to post-edit a segment segmentsegment CAT toolsTAO A portion of translatable content that a CAT tool treats as a discrete unit for translation, alignment, storage and match retrieval.Portion de contenu à traduire qu'un outil de TAO traite comme une unité distincte aux fins de traduction, d'alignement, de stockage et de recherche de correspondances. , what a house is worth.
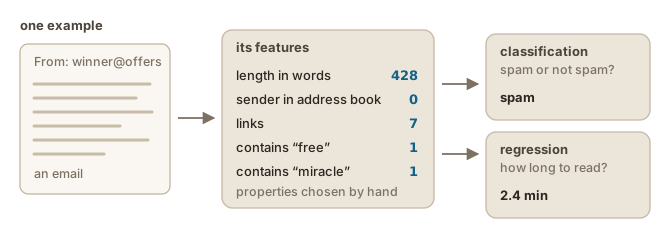
The distinction is about the answer, not about the data. A customer review supports both: a classifier decides whether it is positive or negative, and a regression predicts the rating the reviewer gave, 1 to 5 stars, from the same features. And the training loop does not change either way: predict, compare with the label, adjust.
Labelled examples are one way to learn, and the one this chapter follows, because it is the clearest and the most common. Two other families complete the standard picture.
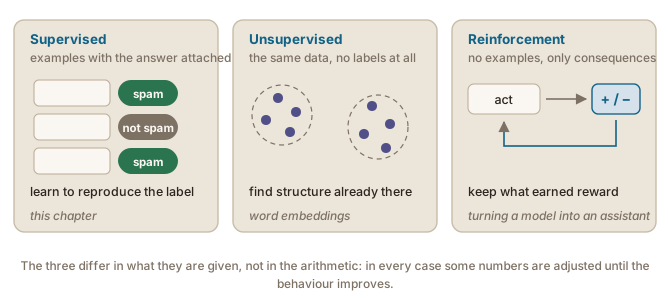
Unsupervised learning unsupervised learningapprentissage non supervisé machine learningapprentissage automatique A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example.Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. works on data with no labels at all. There is no right answer to compare against; instead the algorithm looks for structure that is already in the data, such as groups of similar items. Given thousands of translation-agency invoices, an unsupervised method might discover that they fall into clusters by client type, without anyone having defined the clusters beforehand. Where it matters most for language, word embeddings are learned from raw text, with no human labelling anything (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres).
Reinforcement learning reinforcement learning (RL)apprentissage par renforcement (AR) machine learningapprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward.Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. learns from trial and error. The system acts, receives a reward or a penalty, and adjusts toward what earned reward. No example shows it the right action; it has to find out. This family powers game-playing systems, and it is part of how a raw language model is turned into a usable assistant (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML).
What does a feature look like when the examples are words rather than emails? Take named entity recognition named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. as an example. This is an NLP task where the goal is to label named entities automatically: names of people, places, organizations, and so on (see also the Named entity recognition: one task up close page, in the Classical NLP module) (voir aussi la page La reconnaissance d'entités nommées : une tâche vue de près, dans le module TAL classique). Useful features for a word include: does it start with a capital letter, is it the first word of the sentence, does it appear in a list of known first names, what word comes just before it (Mr., in, at), and what suffix it ends with (-town, -land, -ville). With a training corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. where the entities have been labelled by hand, and those features calculated for every word, the algorithm can learn which patterns in the data go with a name.
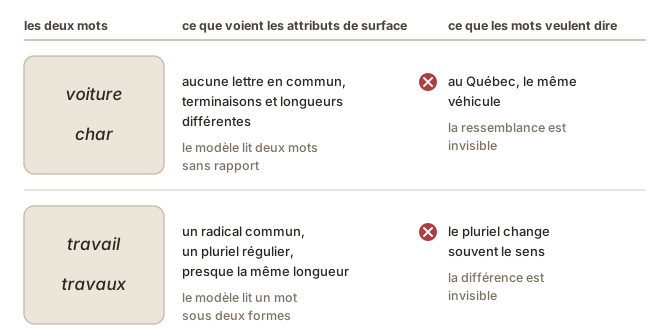
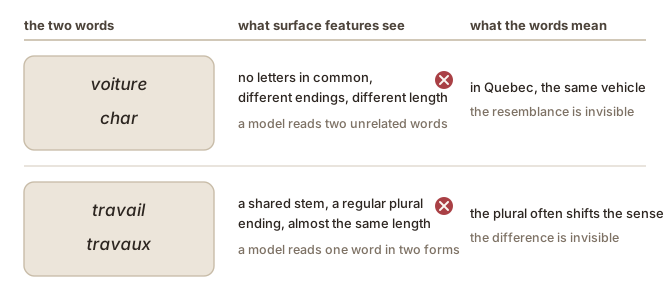
Though you can do some impressive things with feature engineering, these systems tend to all hit the same wall. Features like suffixes and capitalization describe the form of a word. They say nothing about what it means. To a feature-based model, voiture and char are simply two different sequences of letters, though in Quebec both can mean car; travail (work) and travaux (roadworks) look like the singular and plural of one word, though the plural often shifts the meaning. The way past the wall was to stop describing words by hand-picked properties and let a system learn, from how words are used, a numerical representation of the words themselves (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
Des règles écrites par des personnes
Un système à base de règles automatise une tâche en appliquant des règles que des personnes ont écrites.
Voici deux exemples de systèmes simples à base de règles :
- un correcteur grammatical :
un sujet singulier suivi d’un verbe pluriel ⇒ signaler la phrase - un convertisseur de dates :
quatre chiffres, un trait d’union, deux chiffres, un trait d’union, deux chiffres ⇒ une date ; réordonner les parties
Chaque élément du comportement du système a été spécifié par une personne, et c’est pourquoi on parle d’approche déductive : des règles générales d’abord, appliquées à chaque nouveau cas. La Figure 1figure 1 montre une telle règle appliquée à deux phrases.
Pour la langue, les auteurs de règles étaient souvent des linguistes. Les premiers systèmes de traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , les correcteurs orthographiques et grammaticaux et les premiers systèmes de dialogue étaient faits de milliers de règles grammaticales, d’entrées de dictionnaire et de schémas de transformation, chacun écrit et maintenu à la main.
Le texte vu par une règle
Une règle ne peut tester que ce que le programme observe dans le texte. La règle du convertisseur de dates est écrite en caractères, en chiffres et en traits d’union, que n’importe quel programme sait lire. Celle du correcteur grammatical suppose que le programme sait déjà quels mots forment le sujet, si celui-ci est singulier et quel mot est le verbe, et rien de tout cela n’est écrit dans le texte : il faut d’abord un étiquetage morphosyntaxique part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. et une analyse syntaxique, deux tâches à part entière. Écrire une règle commence donc par traduire ce qu’une personne remarque en quelque chose qu’un programme peut mesurer.
Points forts et points faibles
Les systèmes à base de règles servent encore, et la Figure 2figure 2 résume pourquoi, et pourquoi le domaine s’en est détourné. Dans un domaine étroit et bien défini, ils sont précis, chaque décision remonte à une règle qu’une personne peut lire et corriger, et ils n’ont besoin d’aucune donnée. Face à la langue réelle, ambiguë ambiguityambiguïté linguisticslinguistique The property of a stretch of language that allows more than one interpretation.Propriété d'un segment de langue qui autorise plus d'une interprétation. , variable et pleine d’exceptions, l’ensemble de règles ne cesse de grossir sans jamais tout couvrir, et chaque nouvelle langue ou chaque nouveau type de texte oblige à recommencer (see also the Why language is hard chapter, in the Language as numbers module) (voir aussi le chapitre Pourquoi le langage est difficile, dans le module Le langage en nombres).
À la fin des années 1980, ces faiblesses avaient poussé le domaine vers une autre façon de construire les systèmes, où les régularités sont trouvées dans des données au lieu d’être écrites sous forme de règles.
Des cas aux régularités
Au lieu de demander à un expert d’écrire les règles, vous pouvez réunir des exemples que des personnes ont déjà étiquetés, et laisser un algorithme trouver ce qui les distingue. Laisser l’algorithme trouver la régularité dans les cas, c’est l’approche inductive ; un système à base de règles rule-based systemsystème à base de règles AIIA A system whose behaviour is fixed by rules that people wrote, most often of the form "if this condition, then this action", so that every output can be traced to the rule that produced it.Système dont le comportement est fixé par des règles écrites par des personnes, le plus souvent de la forme « si cette condition, alors cette action », de sorte que chaque résultat peut être rapporté à la règle qui l'a produit. procède en sens inverse, d’une règle générale à chaque cas, et c’est l’approche déductive (Figure 3figure 3). Le domaine a pris ce virage vers l’apprentissage automatique machine learning (ML)apprentissage automatique machine learningapprentissage automatique An approach to artificial intelligence in which a model is trained on data or experience so that its adjustable parameters come to reflect patterns relevant to a task.Approche de l'intelligence artificielle dans laquelle un modèle est entraîné sur des données ou sur l'expérience, de sorte que ses paramètres ajustables en viennent à refléter des régularités pertinentes pour une tâche. à la fin des années 1980.
Dans ce paradigme, une personne choisit encore ce que le système mesure, ses attributs featureattribut machine learningapprentissage automatique A property or representation of an observation that a machine-learning model uses as input when making a prediction.Propriété ou représentation d'une observation qu'un modèle d'apprentissage automatique utilise en entrée pour produire une prédiction. , et c’est pourquoi on parle aussi d’apprentissage statistique ou fondé sur des attributs. L’algorithme ajuste un modèle un exemple étiqueté à la fois (see also the Learning from labelled examples page) (voir aussi la page Apprendre à partir d'exemples étiquetés). L’apprentissage automatique a remplacé l’écriture de règles pour trois raisons : un système appris peut combiner des centaines d’indices faibles que personne ne penserait à écrire, étiqueter des exemples est un travail moins coûteux et moins spécialisé qu’écrire et maintenir des règles, et une méthode se transpose à une nouvelle langue ou à un nouveau domaine dès qu’on y a réuni des exemples. Le tableau ci-dessous compare les deux paradigmes.
Règles et apprentissage automatique
| Aspect | Systèmes à base de règles | Systèmes d’apprentissage automatique |
|---|---|---|
| Ce dont ils dépendent | Des experts, qui écrivent et maintiennent les règles | Un corpus, volumineux et, pour bien des tâches, annoté par des personnes |
| Variation et ambiguïté ambiguityambiguïté linguisticslinguistique The property of a stretch of language that allows more than one interpretation.Propriété d'un segment de langue qui autorise plus d'une interprétation. | Un cas que personne n’a prévu est un cas que personne n’a traité | Traitées, à condition que les données contiennent assez de cas semblables et que les attributs permettent au système de trouver une différence systématique ; un cas inhabituel obtient tout de même une réponse, sous forme de degré de probabilité |
| Interprétabilité | Chaque décision remonte à une règle qu’une personne peut lire et modifier | Lisible à un degré qui dépend de l’algorithme ; une décision se modifie en modifiant les données |
| Une nouvelle langue ou un nouveau domaine | Tout recommencer | Réunir des données, réentraîner |
| Où ils conviennent | Les tâches étroites et bien définies, et les tâches sans données | Les tâches très variables, avec beaucoup de données |
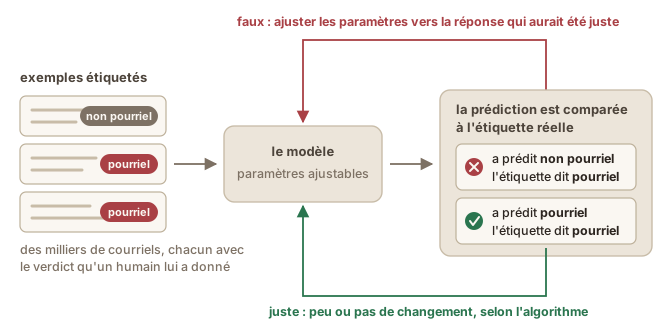
Supposons que vous vouliez un système qui trie les courriels entre pourriel et non pourriel. La façon à base de règles consiste à décrire le pourriel : certains expéditeurs, certains mots, trop de liens. La façon supervisée consiste à montrer au système dix mille courriels qu’un humain a déjà triés, et à le laisser dégager la différence. Chaque courriel accompagné du verdict humain est un exemple étiqueté, et un ensemble de nombreux exemples étiquetés devient des données d’entraînement.
L’entraînement se déroule alors en boucle. L’algorithme prend un exemple, prédit une étiquette et compare sa prédiction à celle de l’humain. Une prédiction fausse ajuste les réglages du modèle, un peu, dans la direction qui l’aurait rendue juste. Une prédiction juste ne change rien ou presque : certains algorithmes laissent les réglages exactement tels quels, d’autres les poussent à répondre pareil avec plus d’assurance.Ces réglages sont les paramètres parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle. La façon dont ils sont stockés et ajustés n’est pas traitée dans ce module ; ce qui compte ici, c’est la boucle, pas l’arithmétique qui s’y trouve (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue). Un passage sur un courriel n’apprend presque rien. Des millions de passages sur des milliers d’exemples s’accumulent, et les prédictions s’améliorent jusqu’à devenir assez bonnes pour des courriels que personne n’a étiquetés.
Deux conséquences découlent directement de ce fonctionnement, et elles reviendront sans cesse dans ce matériel :
- Tout s’apprend des données, pas de règles. Le système reproduit les jugements de ses données d’entraînement, erreurs et angles morts compris, et les données sont la seule porte d’entrée : il n’y a aucune règle à réécrire quand il se trompe.
- Les données d’entraînement doivent ressembler au travail réel. Un filtre antipourriel entraîné sur des courriels d’entreprise en anglais trébuchera sur de l’hameçonnage en français. Ce que les exemples ne montrent pas, le modèle ne peut pas l’apprendre.
Avant que quoi que ce soit puisse s’apprendre, quelqu’un doit décider ce que l’algorithme regarde quand il compare deux courriels.
Première ligne : il n’y a aucune règle à réécrire quand le système se trompe, donc les données sont la seule porte d’entrée. Deuxième : un filtre entraîné sur des courriels d’entreprise en anglais trébuche sur de l’hameçonnage en français.
Les algorithmes ne lisent pas les courriels comme les humains : il leur faut des nombres. Chaque exemple doit donc être décrit par un ensemble de propriétés mesurables : la longueur du message, la présence de l’expéditeur dans votre carnet d’adresses (encodée en général par 1 si oui, 0 si non), le nombre de liens, la présence des mots gagner, gratuit ou miracle. Chacune de ces propriétés est un attribut.
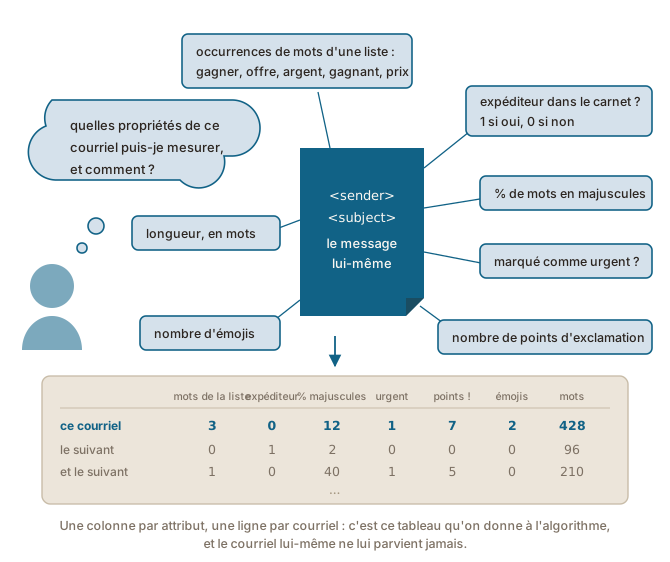
En apprentissage automatique traditionnel, le choix des attributs est un travail humain, et c’est là que passe l’essentiel du métier. Quelqu’un doit deviner quelles propriétés distinguent le pourriel du courrier ordinaire, trouver comment transformer chacune en nombre, tester le résultat et repartir en chercher de meilleures quand le modèle déçoit. Ces suppositions sont des hypothèses sur le problème, et les mauvaises plafonnent ce que n’importe quel algorithme peut atteindre.
La force de cette recette, des attributs plus des étiquettes plus la boucle, est de pouvoir peser des centaines de signaux faibles à la fois, ce qu’aucun ensemble de règles écrites à la main ne réussit. Son plafond, ce sont les attributs eux-mêmes : le modèle ne peut être plus observateur que les propriétés que quelqu’un a pensé à mesurer. Ce plafond, ce sont les réseaux de neurones qui l’ont levé plus tard, en apprenant aussi les attributs (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue).
Le même exemple, décrit par les mêmes attributs, peut être soumis à deux questions différentes. Si on demande à laquelle des catégories d’un ensemble fixe il appartient, la tâche est une classification : pourriel ou non pourriel, critique positive ou négative, catégorie grammaticale d’un mot. Si on demande une valeur sur une échelle, la tâche est une régression : combien de minutes un texte demande à lire, combien de temps une traductrice mettra à post-éditer un segment segmentsegment CAT toolsTAO A portion of translatable content that a CAT tool treats as a discrete unit for translation, alignment, storage and match retrieval.Portion de contenu à traduire qu'un outil de TAO traite comme une unité distincte aux fins de traduction, d'alignement, de stockage et de recherche de correspondances. , ce que vaut une maison.
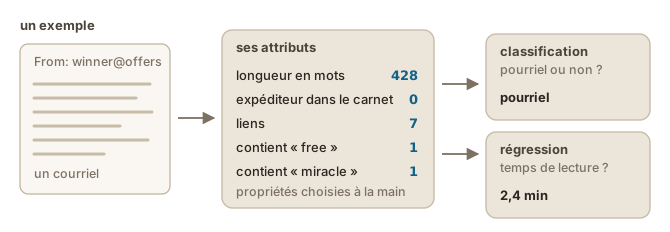
La distinction porte sur la réponse, pas sur les données. Une critique de client se prête aux deux : un classifieur décide si elle est positive ou négative, et une régression prédit la note que la personne a donnée, de 1 à 5 étoiles, à partir des mêmes attributs. Et la boucle d’entraînement ne change pas non plus : prédire, comparer à l’étiquette, ajuster.
Les exemples étiquetés sont une façon d’apprendre, celle que suit ce chapitre, parce qu’elle est la plus claire et la plus répandue. Deux autres familles complètent le tableau habituel.
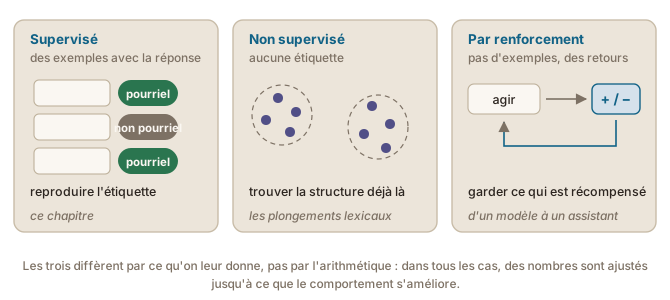
L’apprentissage non supervisé unsupervised learningapprentissage non supervisé machine learningapprentissage automatique A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example.Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. travaille sur des données sans aucune étiquette. Il n’y a pas de bonne réponse à laquelle se comparer ; l’algorithme cherche plutôt une structure déjà présente dans les données, par exemple des groupes d’éléments semblables. Devant des milliers de factures d’agences de traduction, une méthode non supervisée pourrait découvrir qu’elles se regroupent par type de client, sans que personne ait défini ces groupes à l’avance. Là où cela compte le plus pour la langue, les plongements lexicaux s’apprennent à partir de texte brut, sans que personne n’étiquette quoi que ce soit (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres).
L’apprentissage par renforcement reinforcement learning (RL)apprentissage par renforcement (AR) machine learningapprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward.Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. apprend par essais et erreurs. Le système agit, reçoit une récompense ou une pénalité, et s’ajuste vers ce qui a été récompensé. Aucun exemple ne lui montre la bonne action ; il doit la trouver. Cette famille fait fonctionner les systèmes qui jouent à des jeux, et elle fait partie de la façon dont un modèle de langue brut devient un assistant utilisable (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML).
À quoi ressemble un attribut quand les exemples sont des mots plutôt que des courriels ? Prenons la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. comme exemple. C’est une tâche de TAL dont le but est d’étiqueter automatiquement les entités nommées : noms de personnes, de lieux, d’organisations, et ainsi de suite (see also the Named entity recognition: one task up close page, in the Classical NLP module) (voir aussi la page La reconnaissance d'entités nommées : une tâche vue de près, dans le module TAL classique). Des attributs utiles pour un mot : commence-t-il par une majuscule, est-il le premier mot de la phrase, figure-t-il dans une liste de prénoms connus, quel mot le précède immédiatement (M., à, chez), et par quel suffixe se termine-t-il (-ville, -bourg, -ac). Avec un corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. d’entraînement où les entités ont été étiquetées à la main, et ces attributs calculés pour chaque mot, l’algorithme peut apprendre quels motifs des données vont avec un nom.
On peut faire des choses impressionnantes avec l’ingénierie des attributs, et pourtant ces systèmes butent tous sur le même mur. Des attributs comme les suffixes et les majuscules décrivent la forme d’un mot. Ils ne disent rien de ce qu’il veut dire. Pour un modèle fondé sur des attributs, voiture et char sont simplement deux suites de lettres différentes, alors qu’au Québec les deux peuvent désigner le même véhicule ; travail et travaux ont l’air du singulier et du pluriel d’un même mot, alors que le pluriel en change souvent le sens. Pour passer le mur, il a fallu cesser de décrire les mots par des propriétés choisies à la main et laisser un système apprendre, à partir de la façon dont les mots sont employés, une représentation numérique des mots eux-mêmes (see also the Language as numbers module) (voir aussi le module Le langage en nombres).