This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Corpus analysisL'analyse de corpus
Working with Sketch EngineTravailler avec Sketch Engine
Corpus analysisL'analyse de corpus
Working with Sketch EngineTravailler avec Sketch Engine
Getting started with Sketch EngineDécouvrir Sketch Engine
Exploring the existing corporaExplorer les corpus existants
Building a corpus from the webCréer un corpus à partir du web
Checking and tuning your web corpusVérifier et régler son corpus web
The practice corpusLe corpus des exercices
Wordlist: frequency listsWordlist : les listes de fréquences
Absolute and relative frequenciesFréquences absolues et relatives
ConcordancesLes concordances
Word Sketch and Word Sketch DifferenceWord Sketch et Word Sketch Difference
Going furtherPour aller plus loin
Key pointsL'essentiel
Working with Sketch EngineTravailler avec Sketch Engine
A corpus comes from one of two places: the collection Sketch Engine has already prepared, in more than 100 languages, or the web, gathered from your own keywords.
Un corpus vient de deux endroits : la collection déjà préparée par Sketch Engine, dans plus de 100 langues, ou le web, à partir de vos propres mots-clés.
Key pointsL'essentiel
Working with Sketch EngineTravailler avec Sketch Engine
Three functions cover most of the work: the word list (frequencies), the (a word in context) and the Word Sketch (a word's profile).
Trois fonctions couvrent l'essentiel : la liste de mots (fréquences), la (le mot en contexte) et le Word Sketch (le profil de s d'un mot).
concordance · fr: concordance concordance · en : concordance corporacorpus : A display of all occurrences of a word or expression in a corpus, each shown with its surrounding context, typically one occurrence per line with the search word aligned in the middle (the key word in context, or KWIC, format).Affichage de toutes les occurrences d'un mot ou d'une expression dans un corpus, chacune accompagnée de son contexte immédiat, généralement une occurrence par ligne avec le mot cherché aligné au centre (format KWIC, mot-clé en contexte).
collocation · fr: collocation collocation · en : collocation corporacorpus : A combination of words that co-occur more often than chance would predict and form a habitual, semi-fixed pairing, such as heavy rain or commit a crime (rather than strong rain or do a crime).Combinaison de mots qui apparaissent ensemble plus souvent que le hasard ne le laisserait prévoir et qui forment une association habituelle, semi-figée, comme soleil de plomb ou commettre un crime (plutôt que faire un crime).
Key pointsL'essentiel
Working with Sketch EngineTravailler avec Sketch Engine
Absolute frequencies do not compare across corpora: comparing needs relative frequencies, per million words.
Les fréquences absolues ne se comparent pas d'un corpus à l'autre : pour comparer, il faut des fréquences relatives, par million de mots.
Page 1Page 1
Getting started with Sketch EngineDécouvrir Sketch Engine
Sketch Engine builds, manages and analyzes corpora in more than 100 languages, in the browser, with nothing to install.
It is used here because my students, and those in many other language departments, have institutional access: the Université de Montréal subscribes on their behalf.
It is not the only option. AntConc (Anthony, 2026) is free, runs on your own machine, and does the same core analyses on your own files.
Sketch Engine crée, gère et analyse des corpus dans plus de 100 langues, dans le navigateur, sans rien installer.
Il sert ici parce que mes étudiantes et étudiants, comme ceux de bien d'autres départements de langues, y ont accès par leur établissement : l'Université de Montréal y est abonnée pour eux.
Ce n'est pas la seule option. AntConc (Anthony, 2026) est gratuit, s'installe sur votre machine et fait les mêmes analyses de base sur vos propres fichiers.
Page 1Page 1
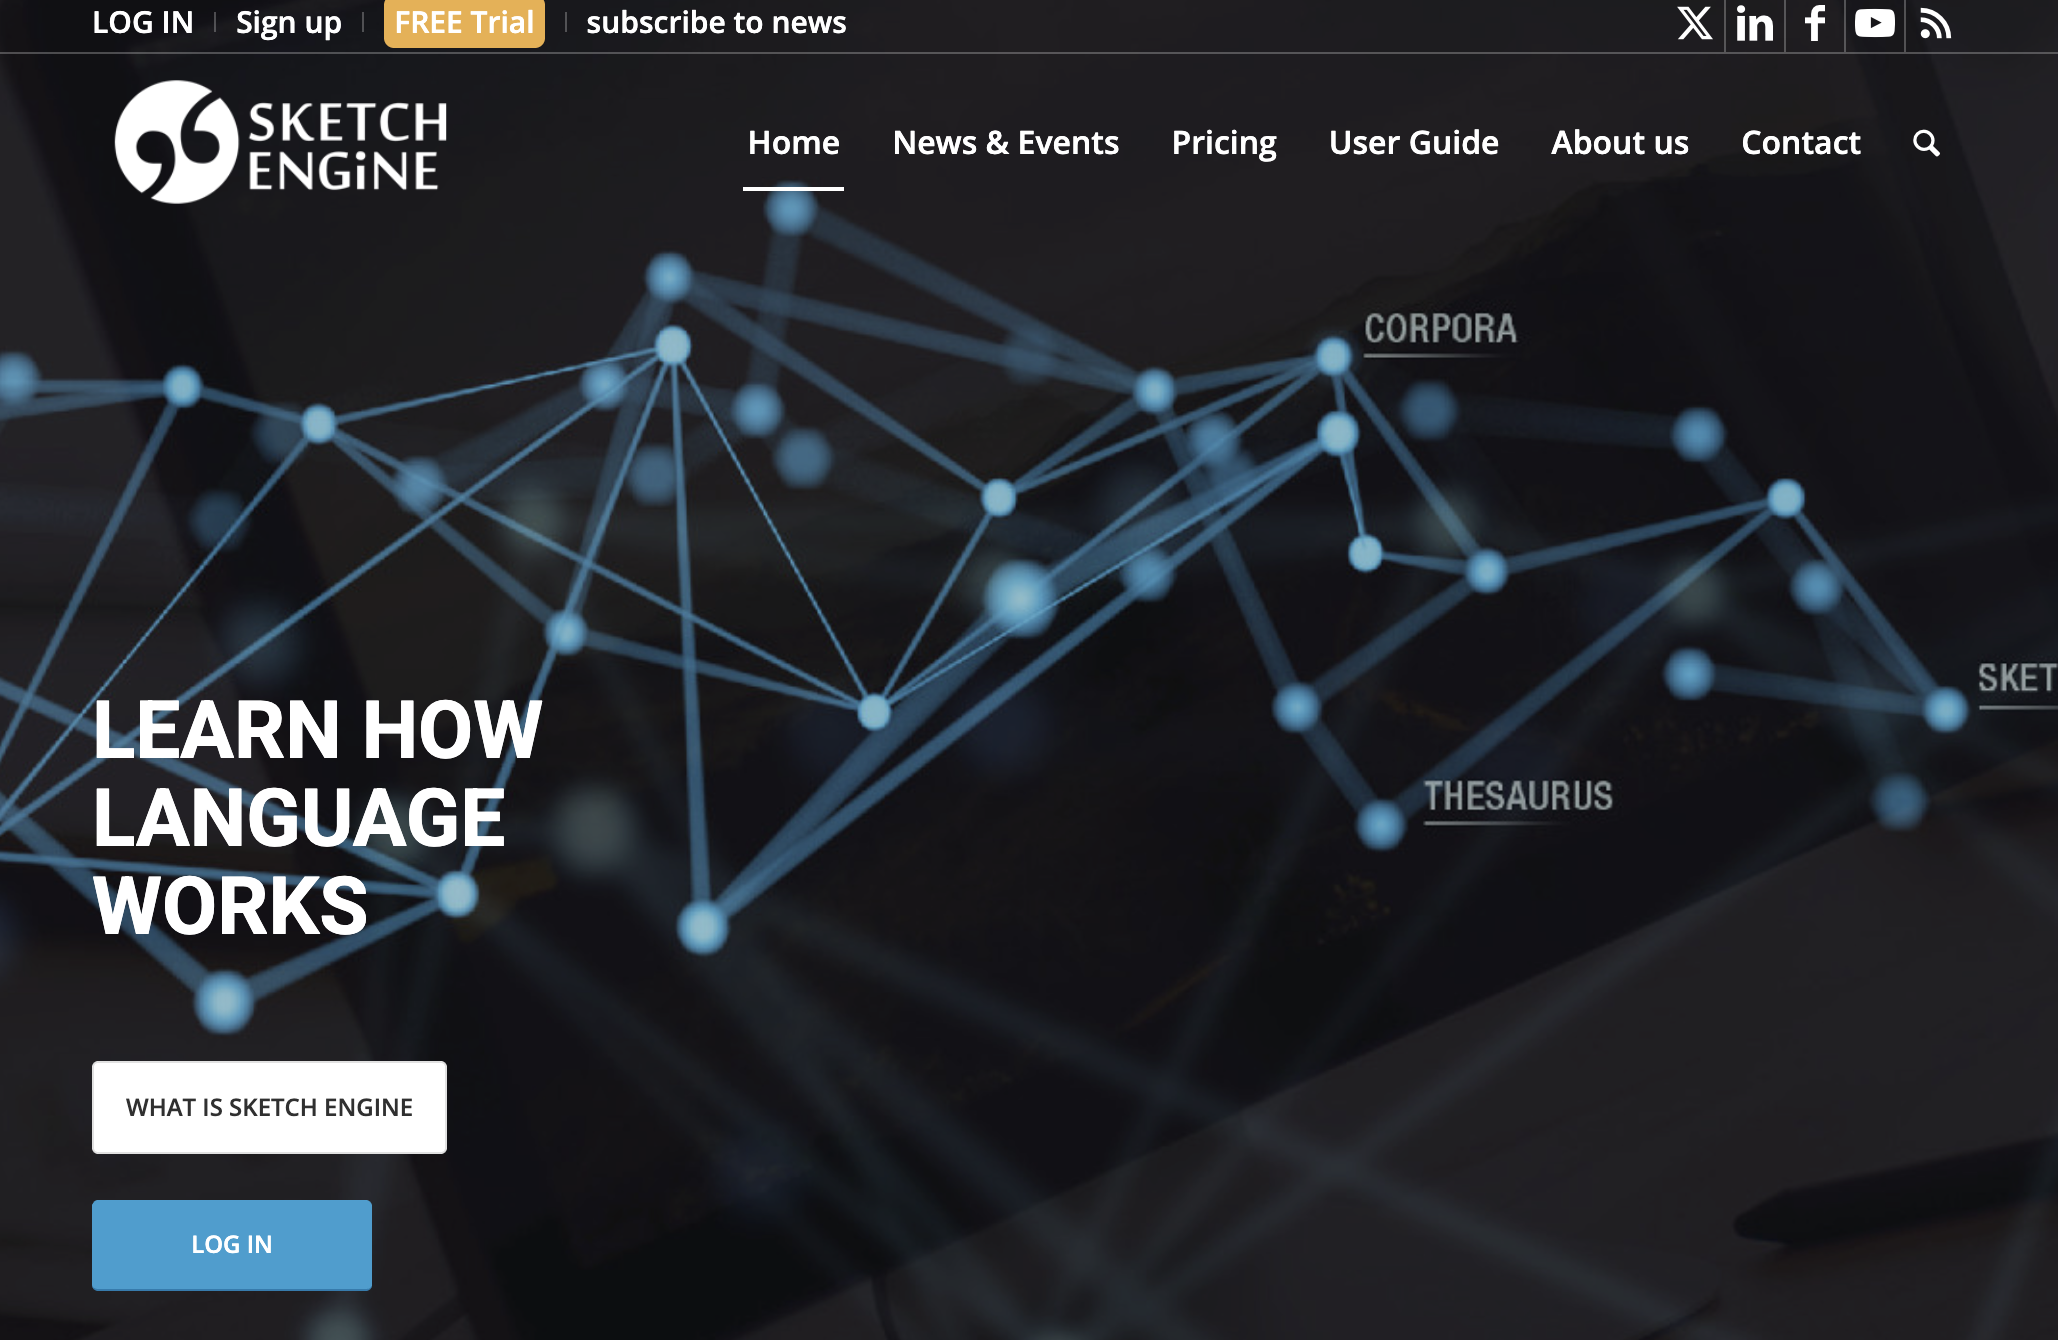
Figure 1. The Sketch Engine home page, with the Log In button in the top right. Figure 1. La page d'accueil de Sketch Engine, avec le bouton « Log In » en haut à droite.
Page 1Page 1
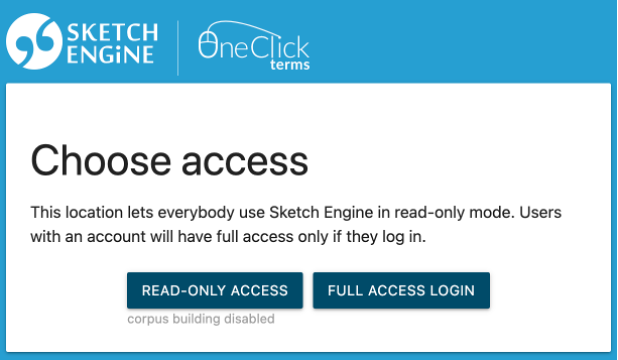
Figure 2. The login options, including Full Access Login. Figure 2. Les options de connexion, dont « Full Access Login ».
Page 1Page 1
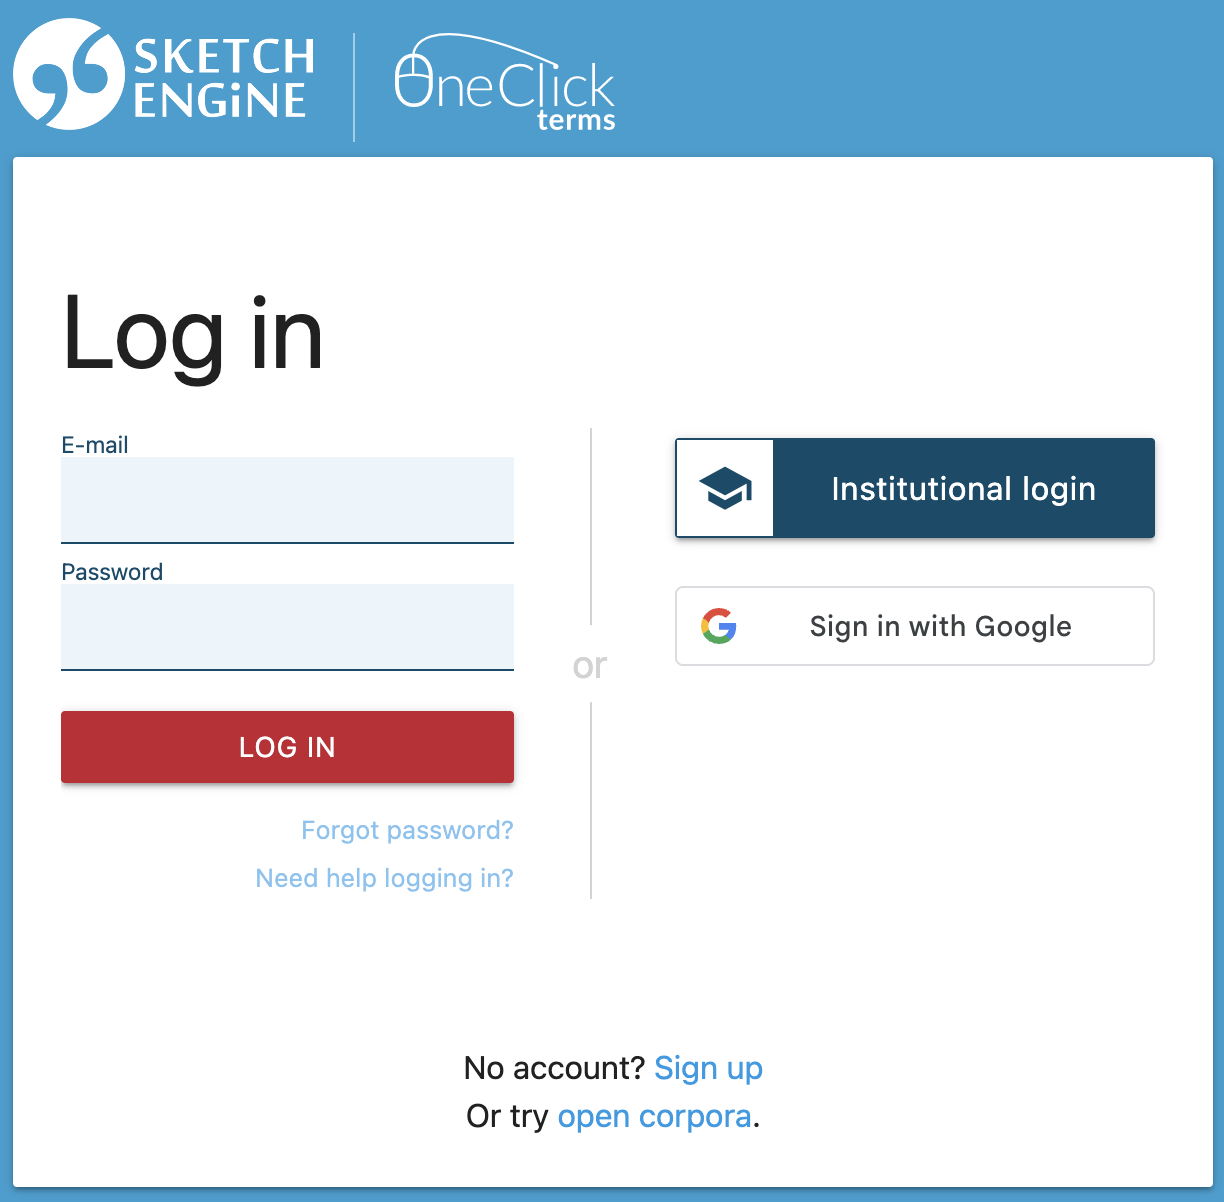
Figure 3. The login page, with the Institutional Login option for universities. Figure 3. La page de connexion, avec l'option « Institutional Login » pour les universités.
Page 1Page 1
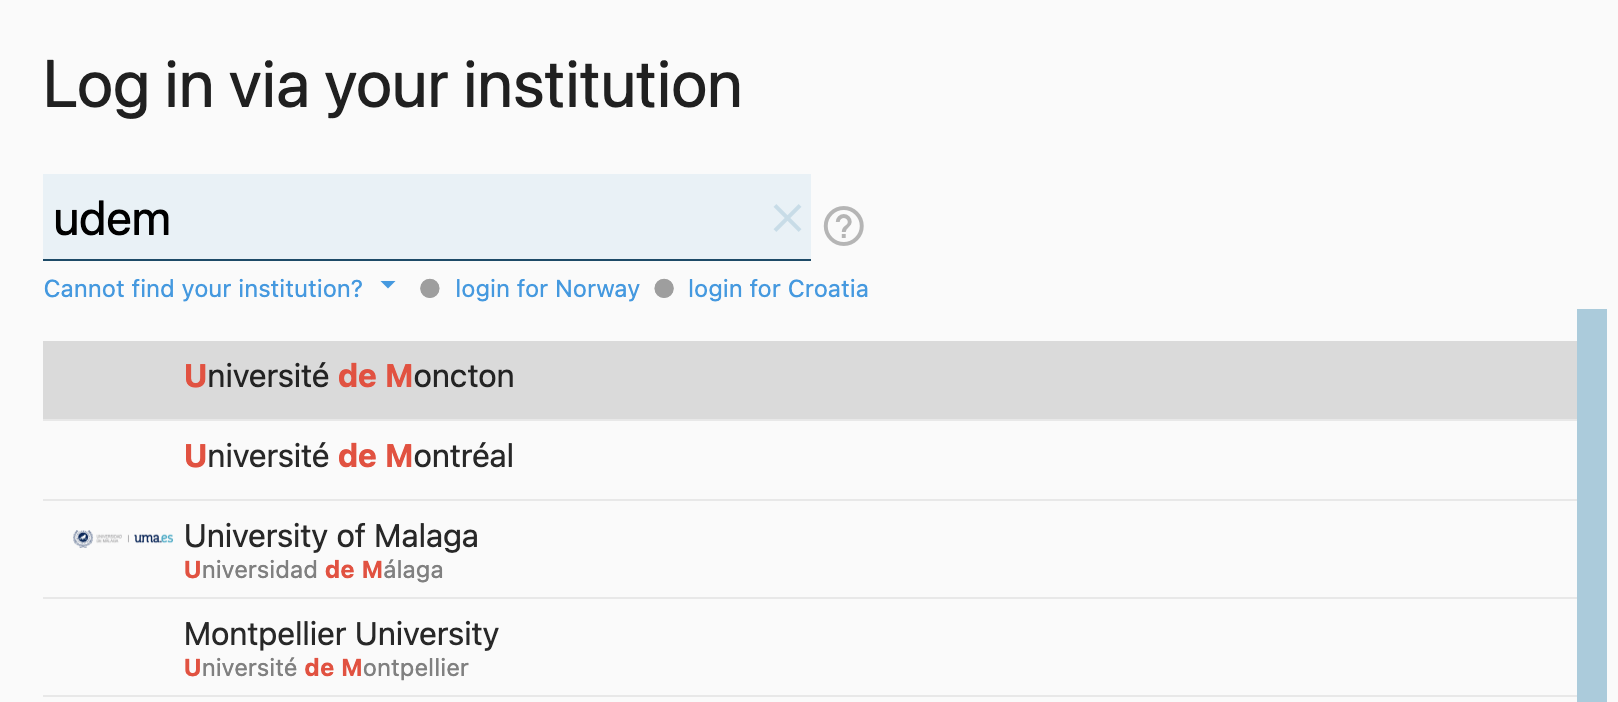
Figure 4. The list of partner institutions, including the Université de Montréal. Figure 4. La liste des institutions partenaires, dont l'Université de Montréal.
Page 2Page 2
Exploring the existing corporaExplorer les corpus existants
Sketch Engine gives access to a collection of prepared corpora in more than 100 languages: web, spoken language, parallel, specialized, diachronic.
These corpora already carry linguistic annotation (, ); how rich it is depends on the language.
Sketch Engine donne accès à une collection de corpus préparés dans plus de 100 langues : web, langue parlée, parallèles, spécialisés, diachroniques.
Ces corpus sont déjà enrichis (, ) ; la richesse des annotations dépend de la langue.
part-of-speech tagging (POS tagging) · fr: étiquetage morphosyntaxique étiquetage morphosyntaxique · en : part-of-speech tagging NLPTAL : The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe.
lemma · fr: lemme lemme · en : lemma linguisticslinguistique : The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller.
Page 2Page 2
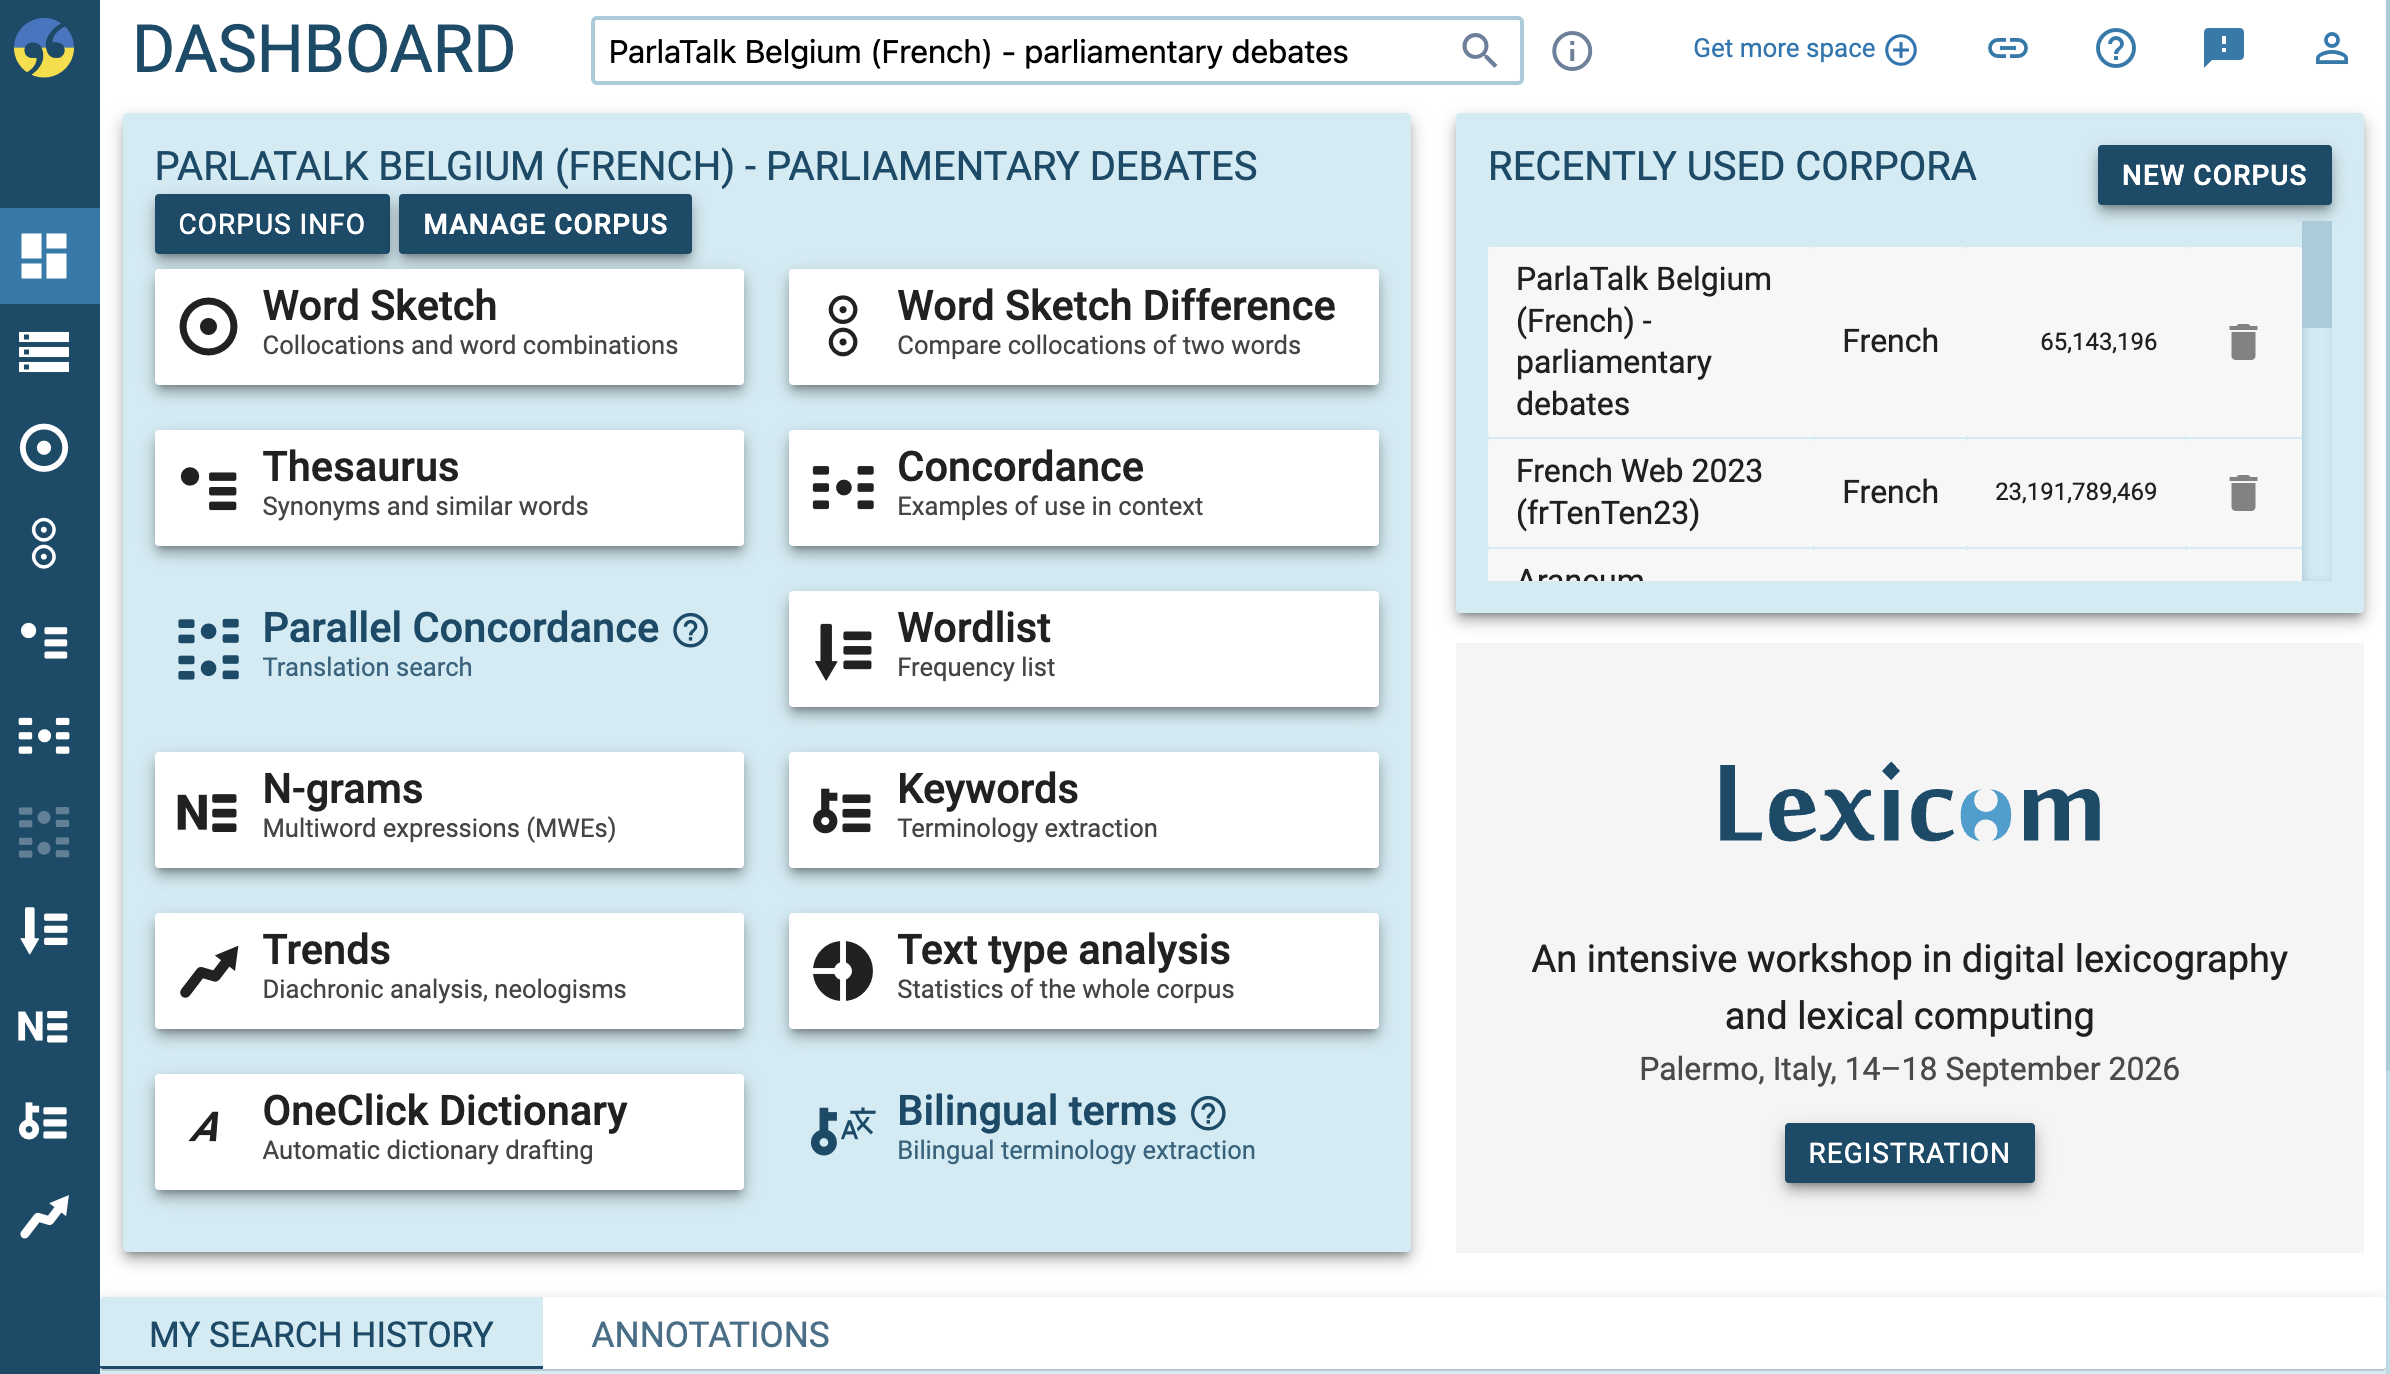
Figure 5. The home page after login: search box and recently used corpora. Figure 5. La page d'accueil après connexion : barre de recherche et corpus récemment utilisés.
Page 2Page 2
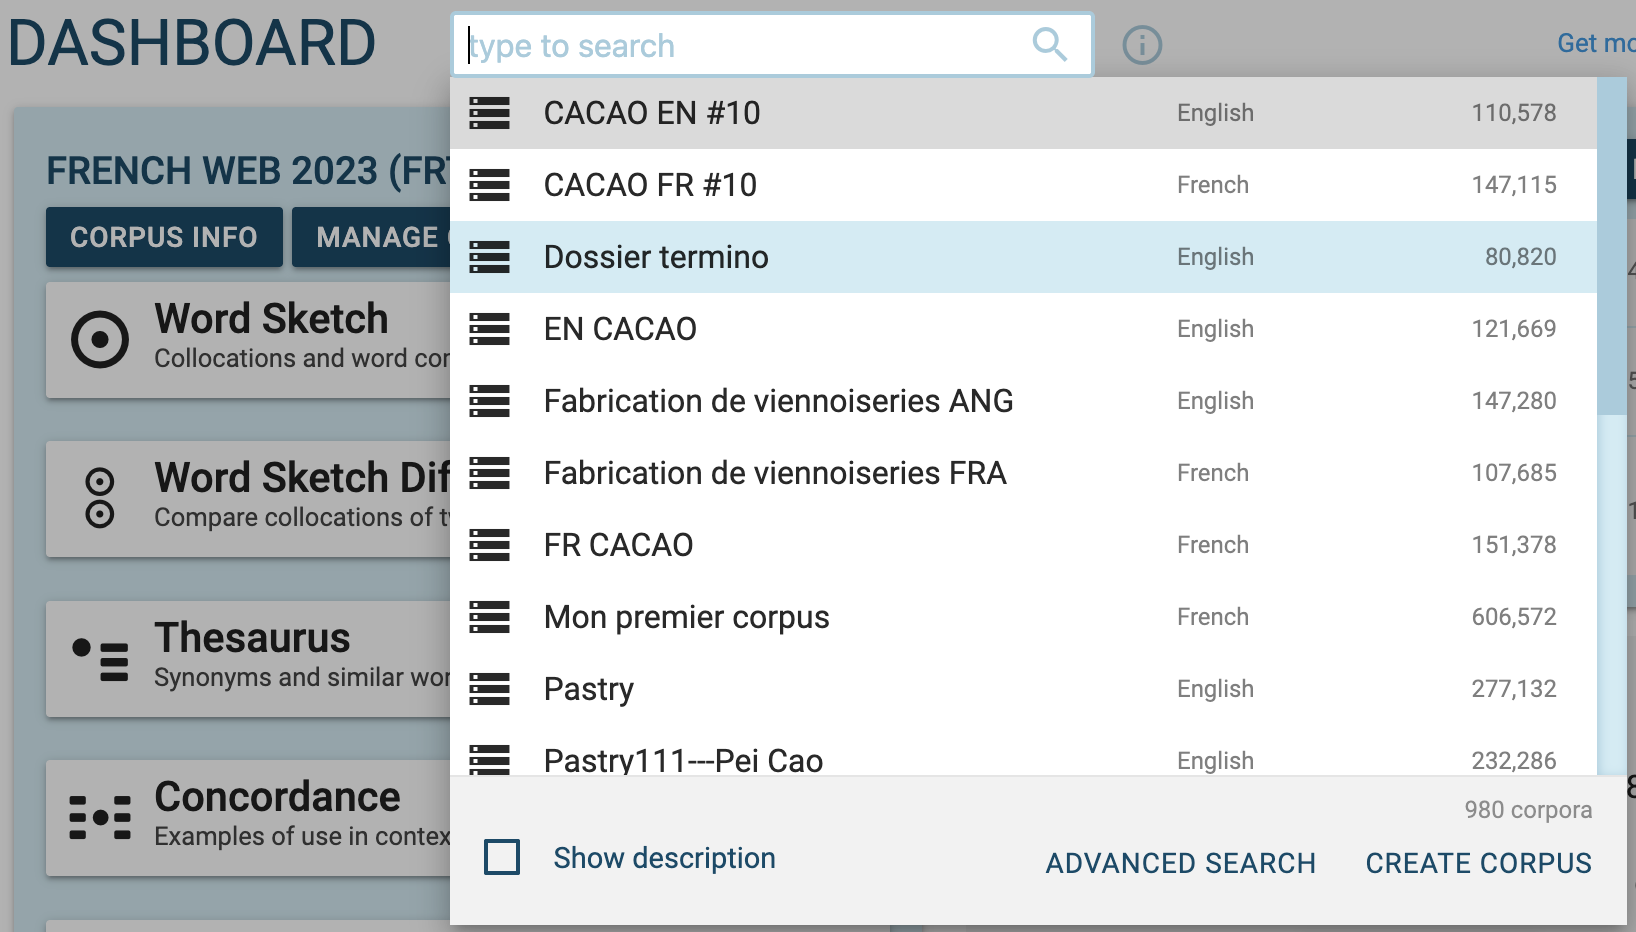
Figure 6. Corpus search, with the ADVANCED SEARCH option for browsing the whole collection. Figure 6. La recherche de corpus, avec l'option « ADVANCED SEARCH » pour explorer toute la collection.
Page 2Page 2
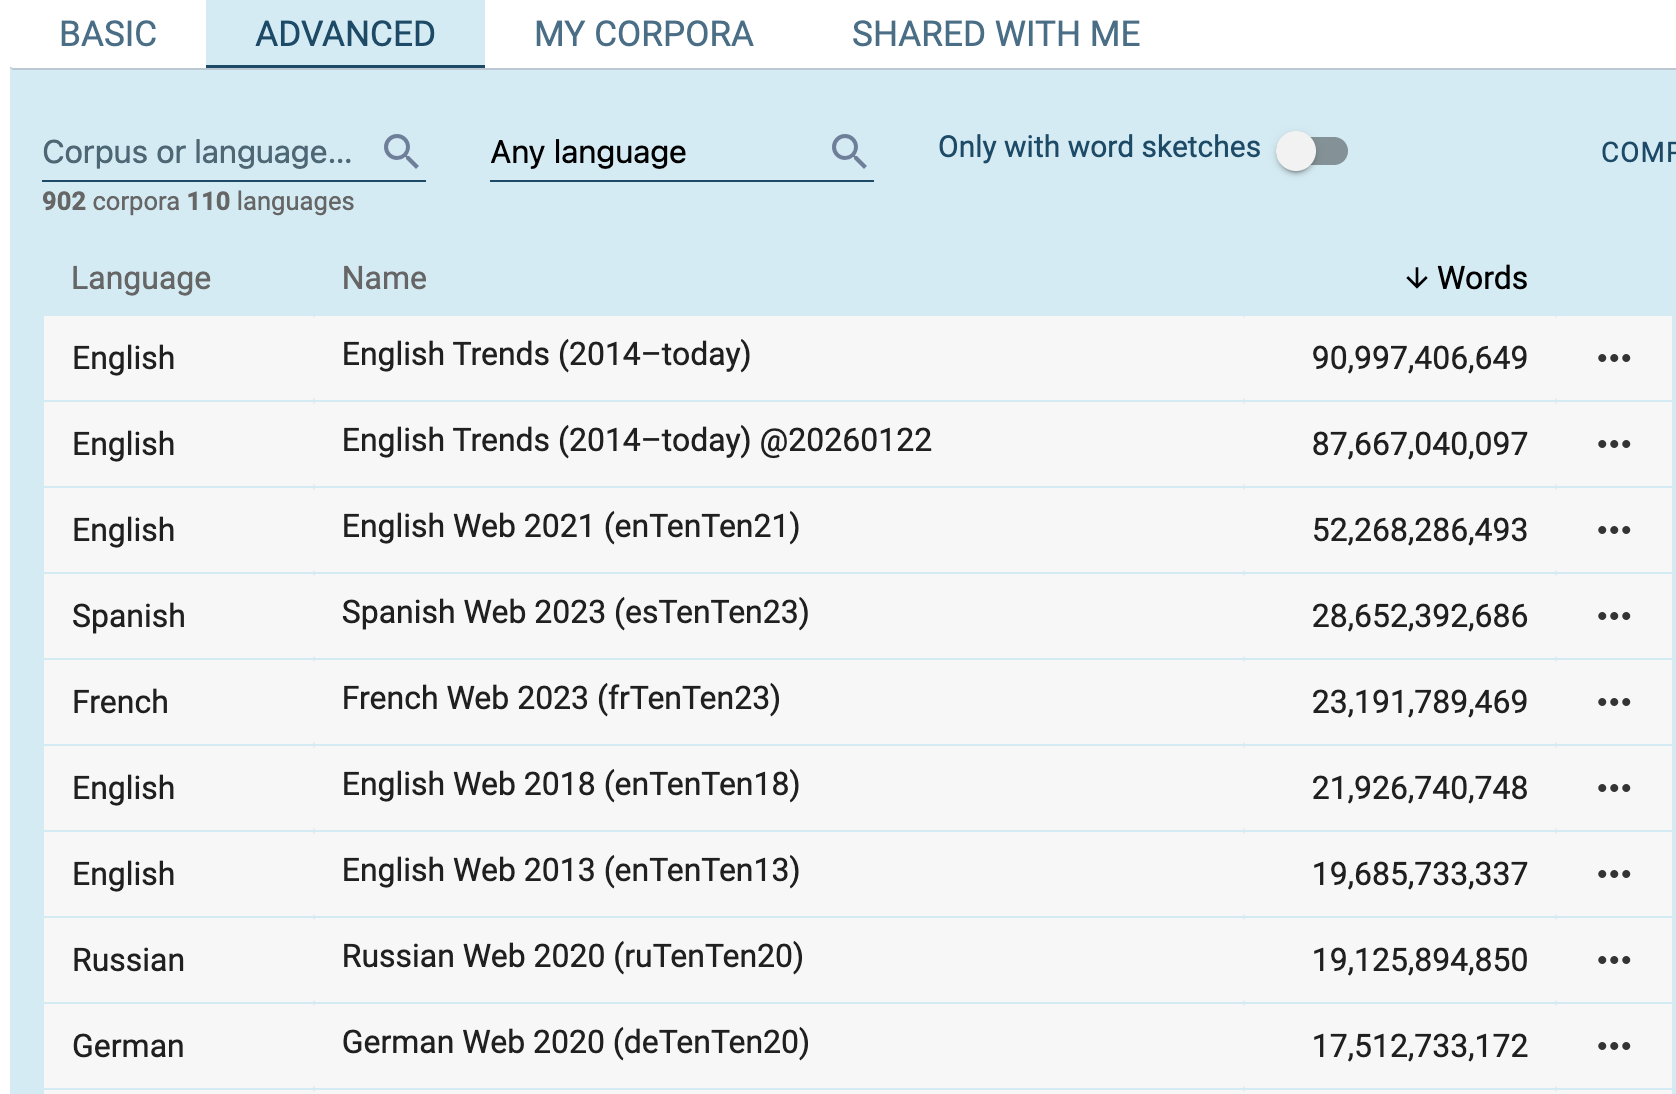
Figure 7. The list of available corpora: language, name, size. Figure 7. La liste des corpus disponibles : langue, nom, taille.
Page 2Page 2
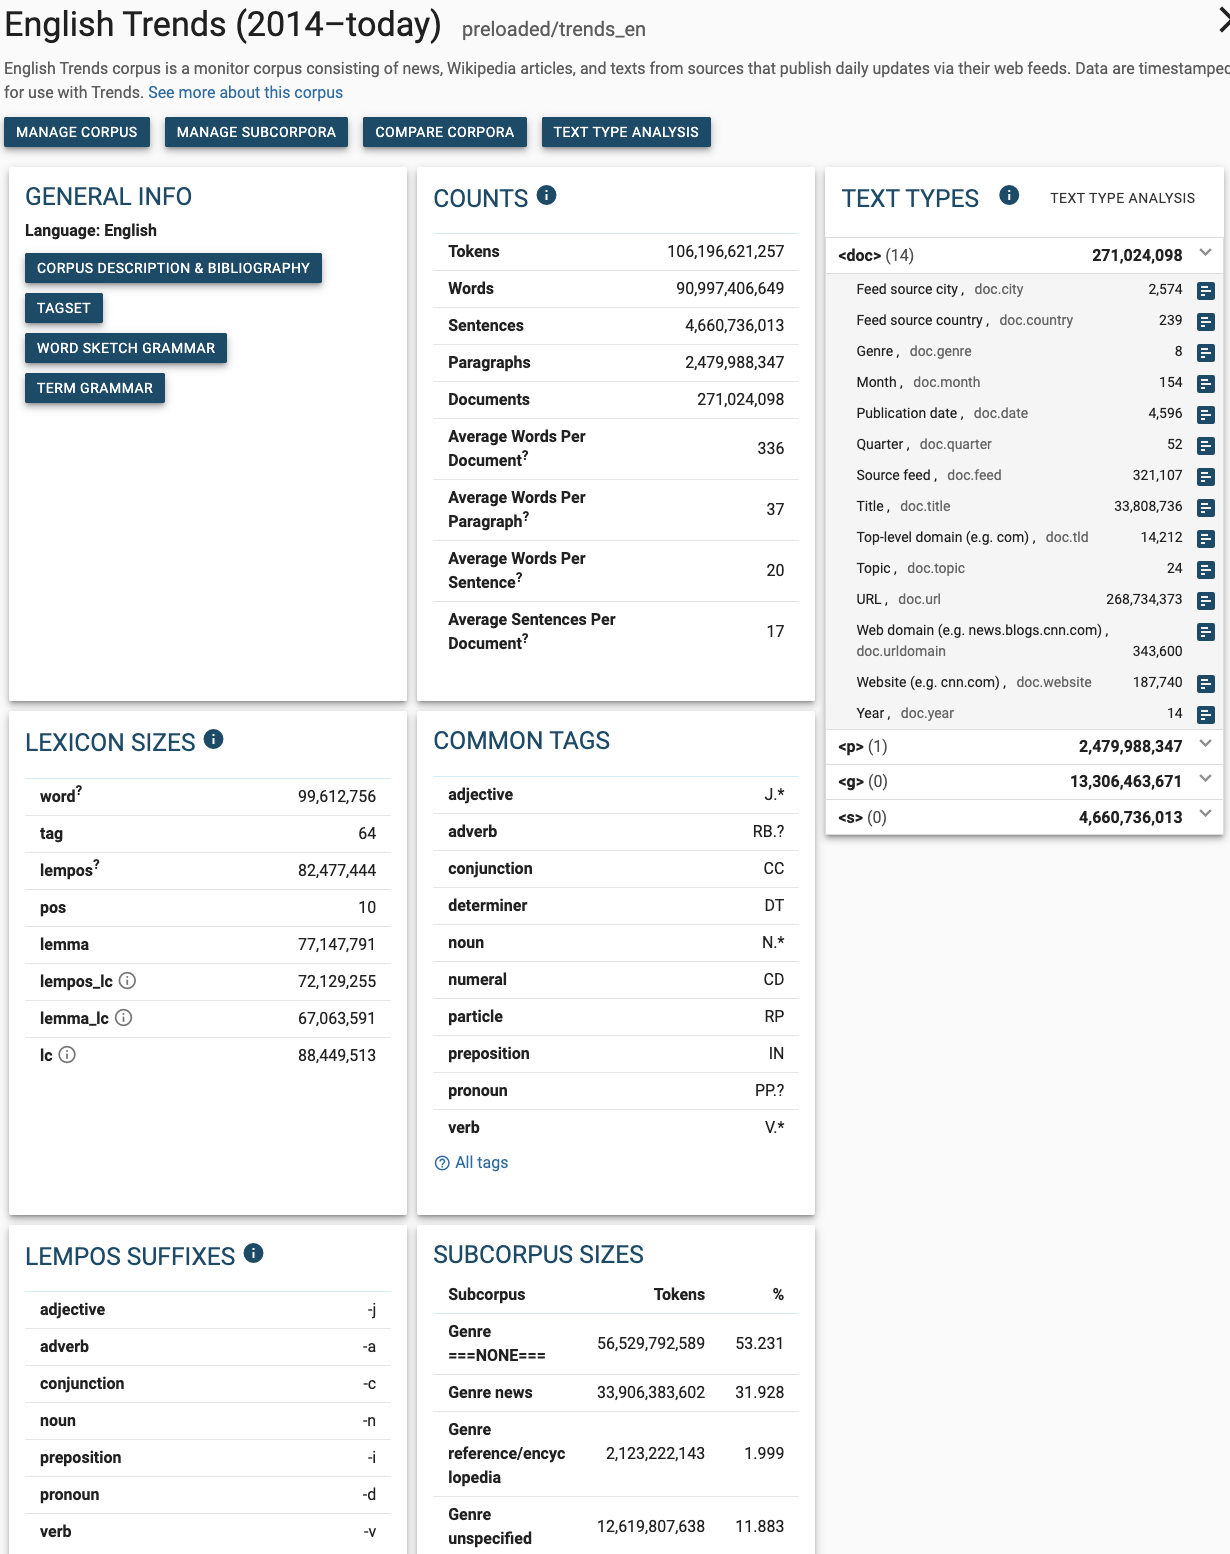
Figure 8. A corpus information record: metadata and available features. Figure 8. La fiche d'information d'un corpus : métadonnées et fonctionnalités disponibles.
Page 3Page 3
Building a corpus from the webCréer un corpus à partir du web
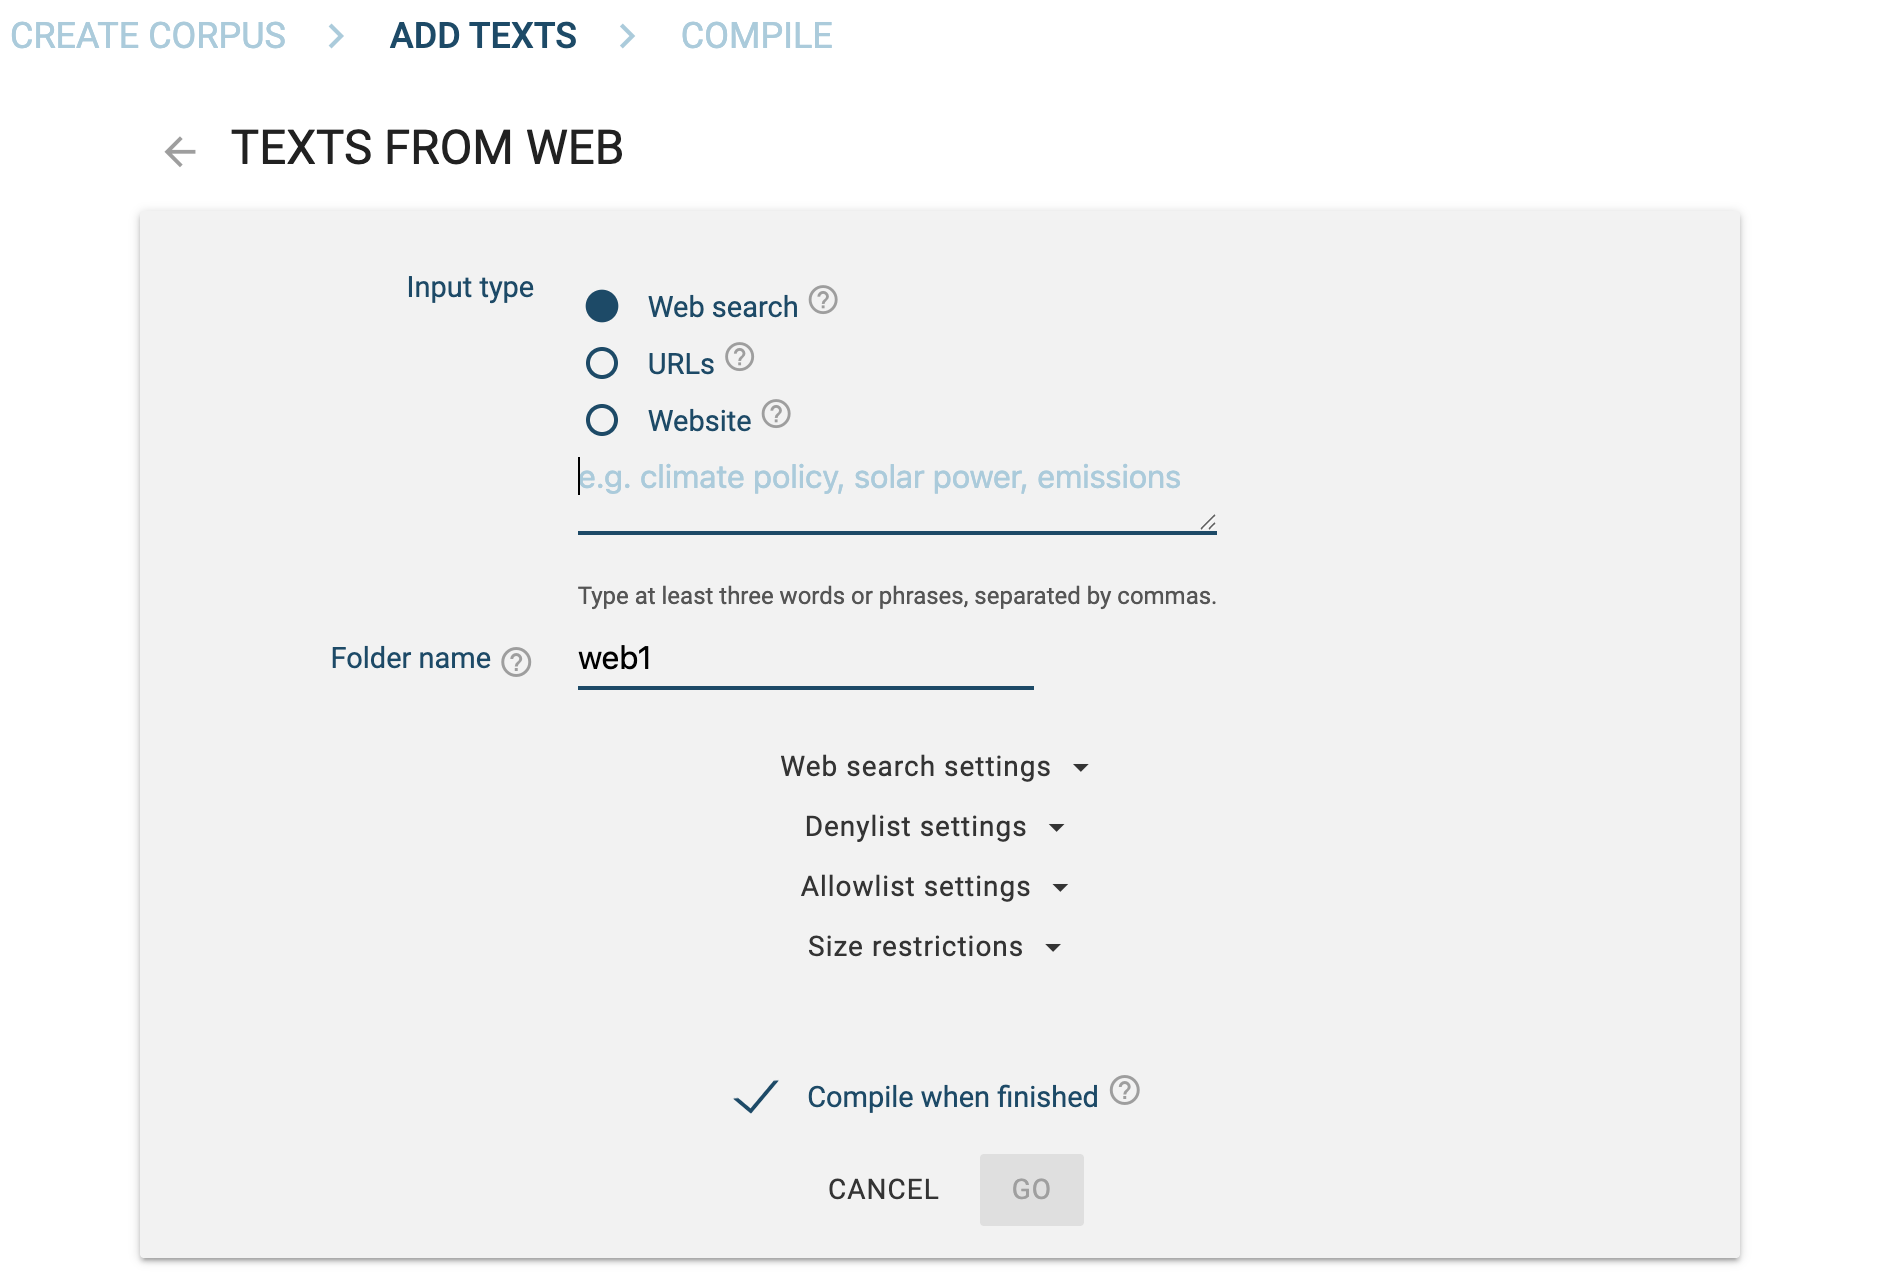
"NEW CORPUS" builds a corpus of your own, either from your own files or from texts found on the web by keyword.
For the exercise, keep the default settings: name, language, "web search", your keywords, GO.
Choose a subject you know well: you will judge far better whether the texts it finds are relevant.
« NEW CORPUS » construit un corpus personnalisé : à partir de vos propres fichiers, ou de textes trouvés sur le web par mots-clés.
Pour l'exercice, gardez les paramètres par défaut : nom, langue, « web search », vos mots-clés, GO.
Choisissez un sujet que vous connaissez bien : vous jugerez mieux la pertinence des textes récoltés.
Page 3Page 3
Figure 9. The NEW CORPUS button. Figure 9. Le bouton « NEW CORPUS ».
Page 3Page 3
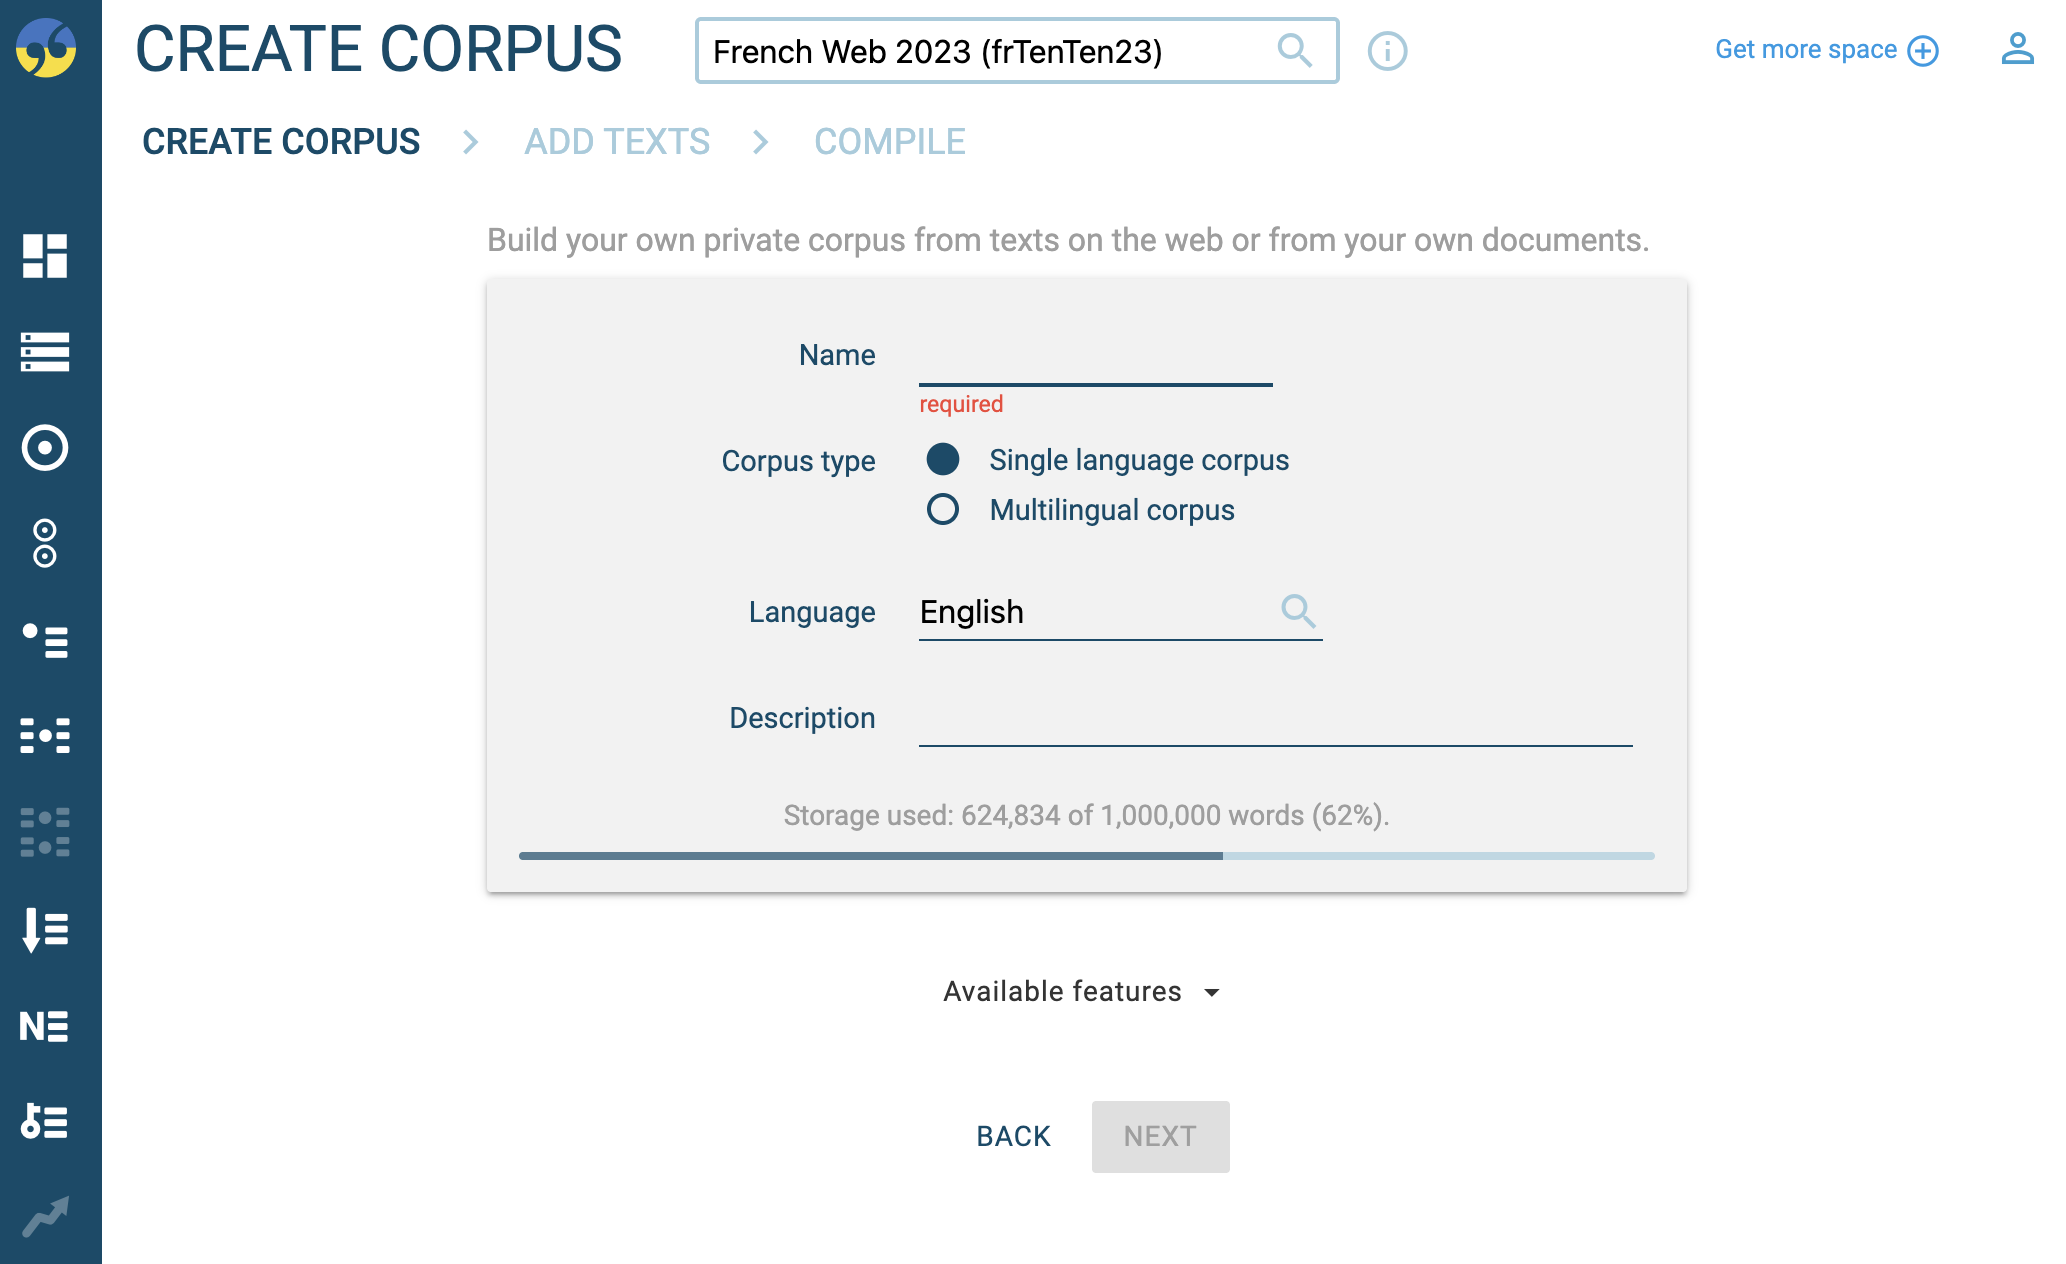
Figure 10. The initial configuration: name and language of the corpus. Figure 10. La configuration initiale : nom et langue du corpus.
Page 3Page 3
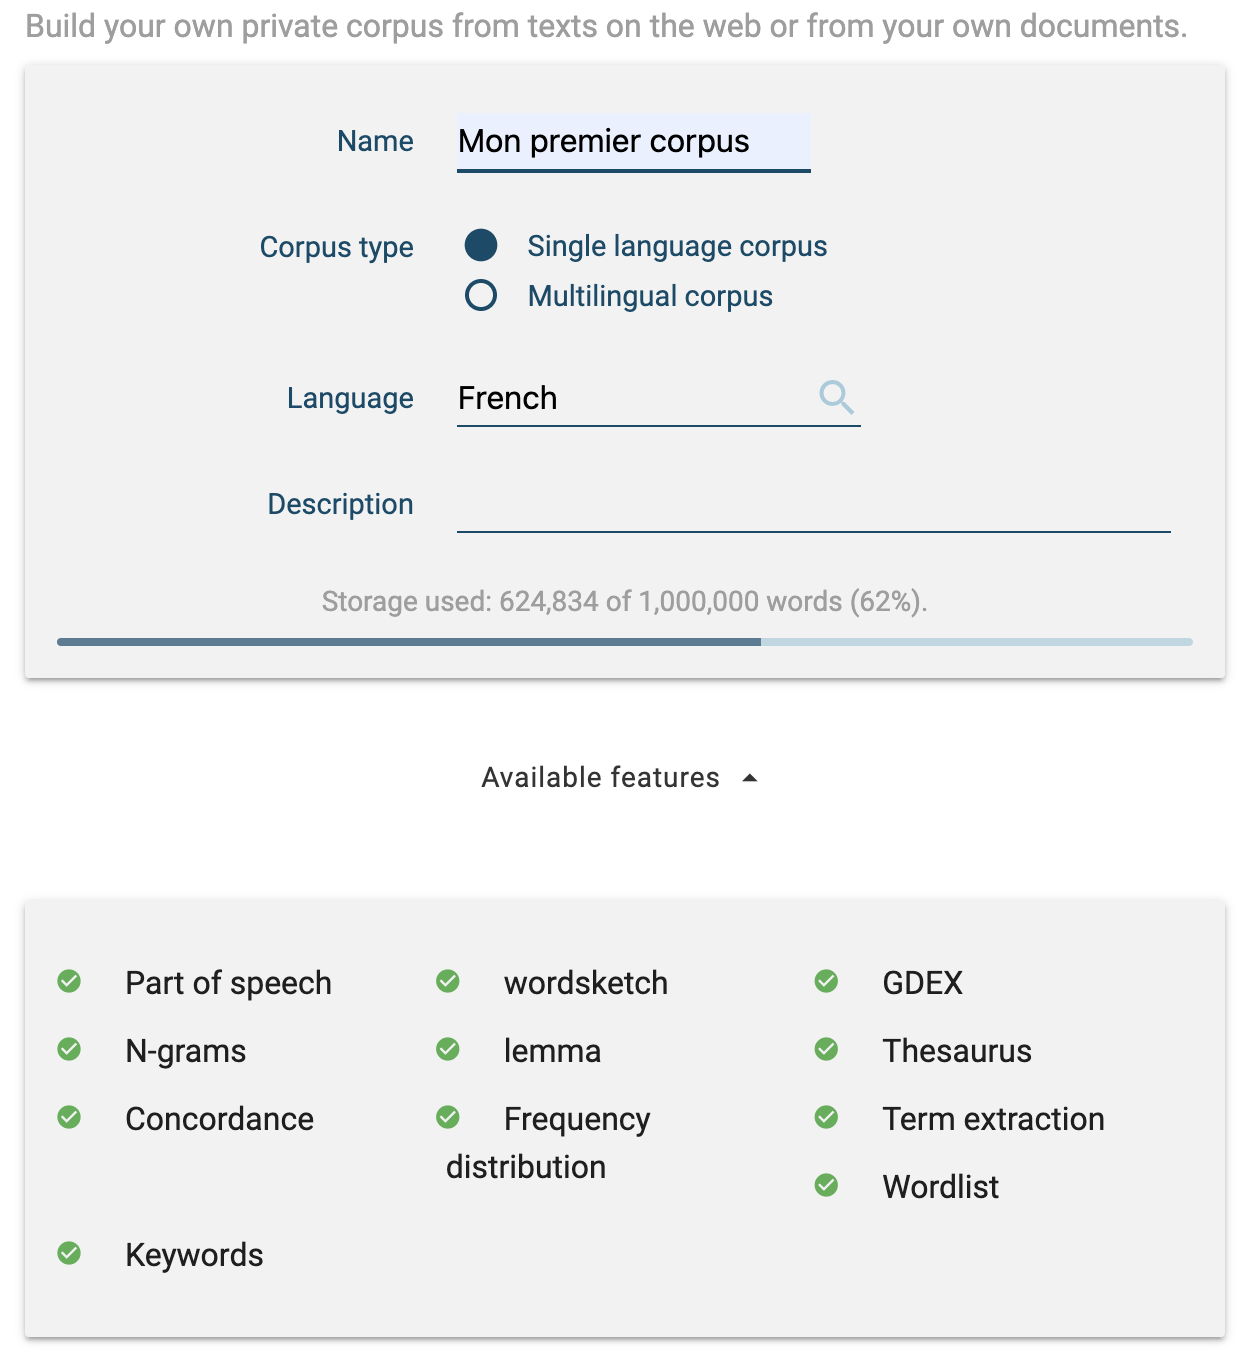
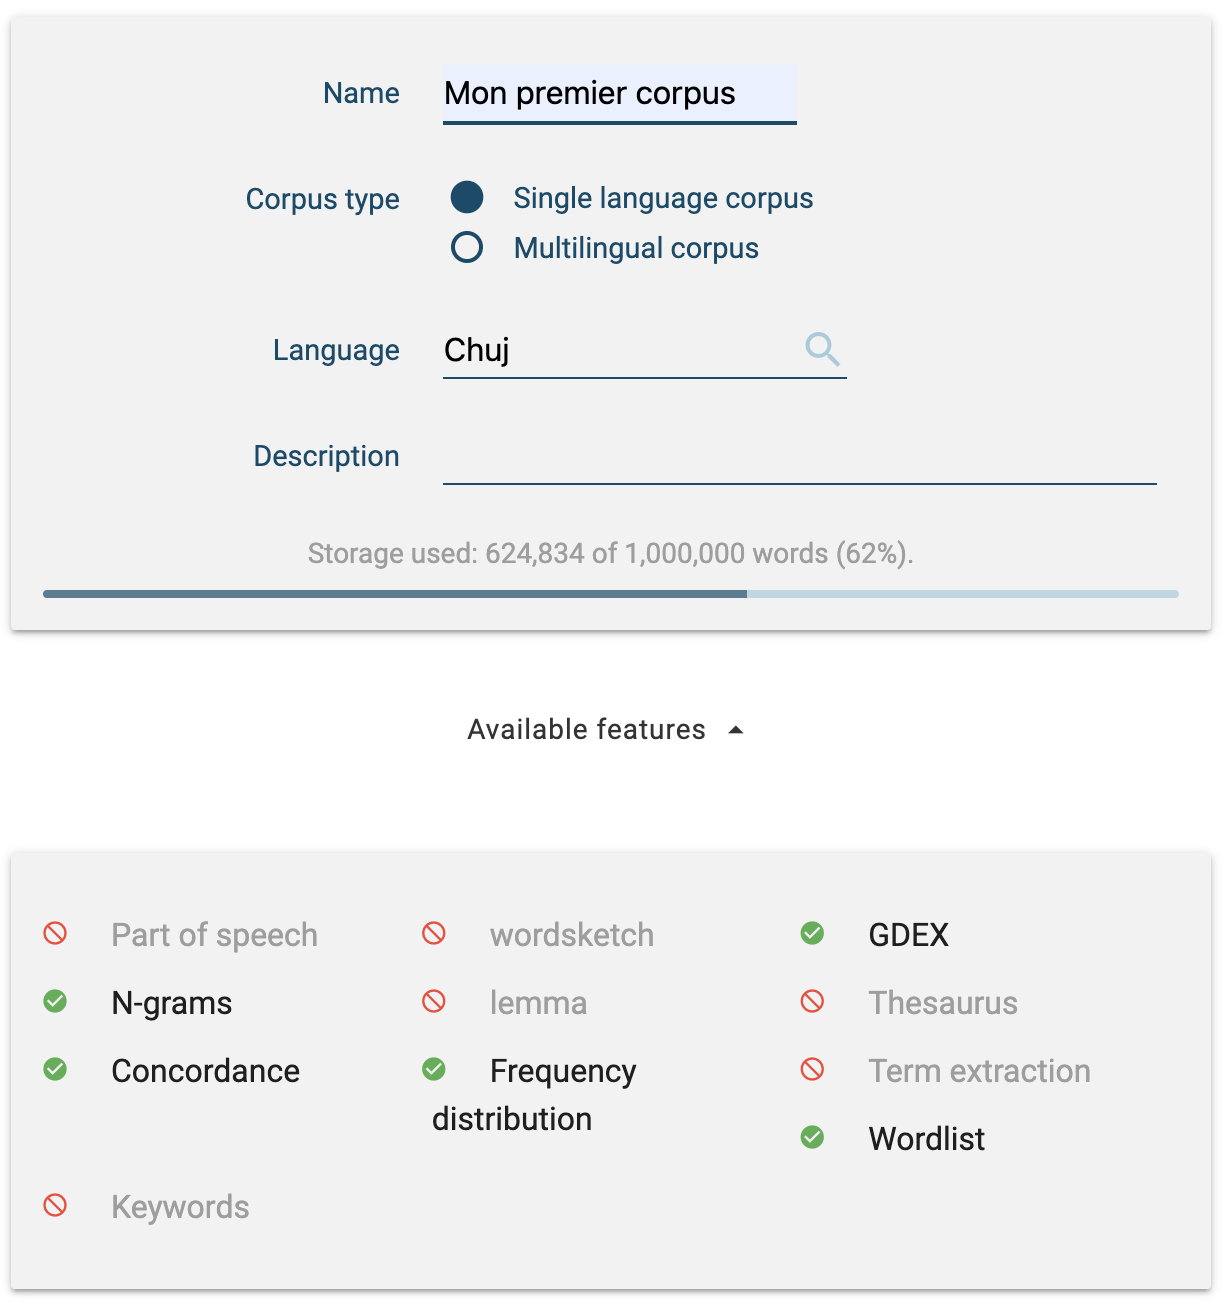
Figure 11. The features available for the chosen language. Figure 11. Les fonctionnalités disponibles selon la langue choisie.
Page 3Page 3
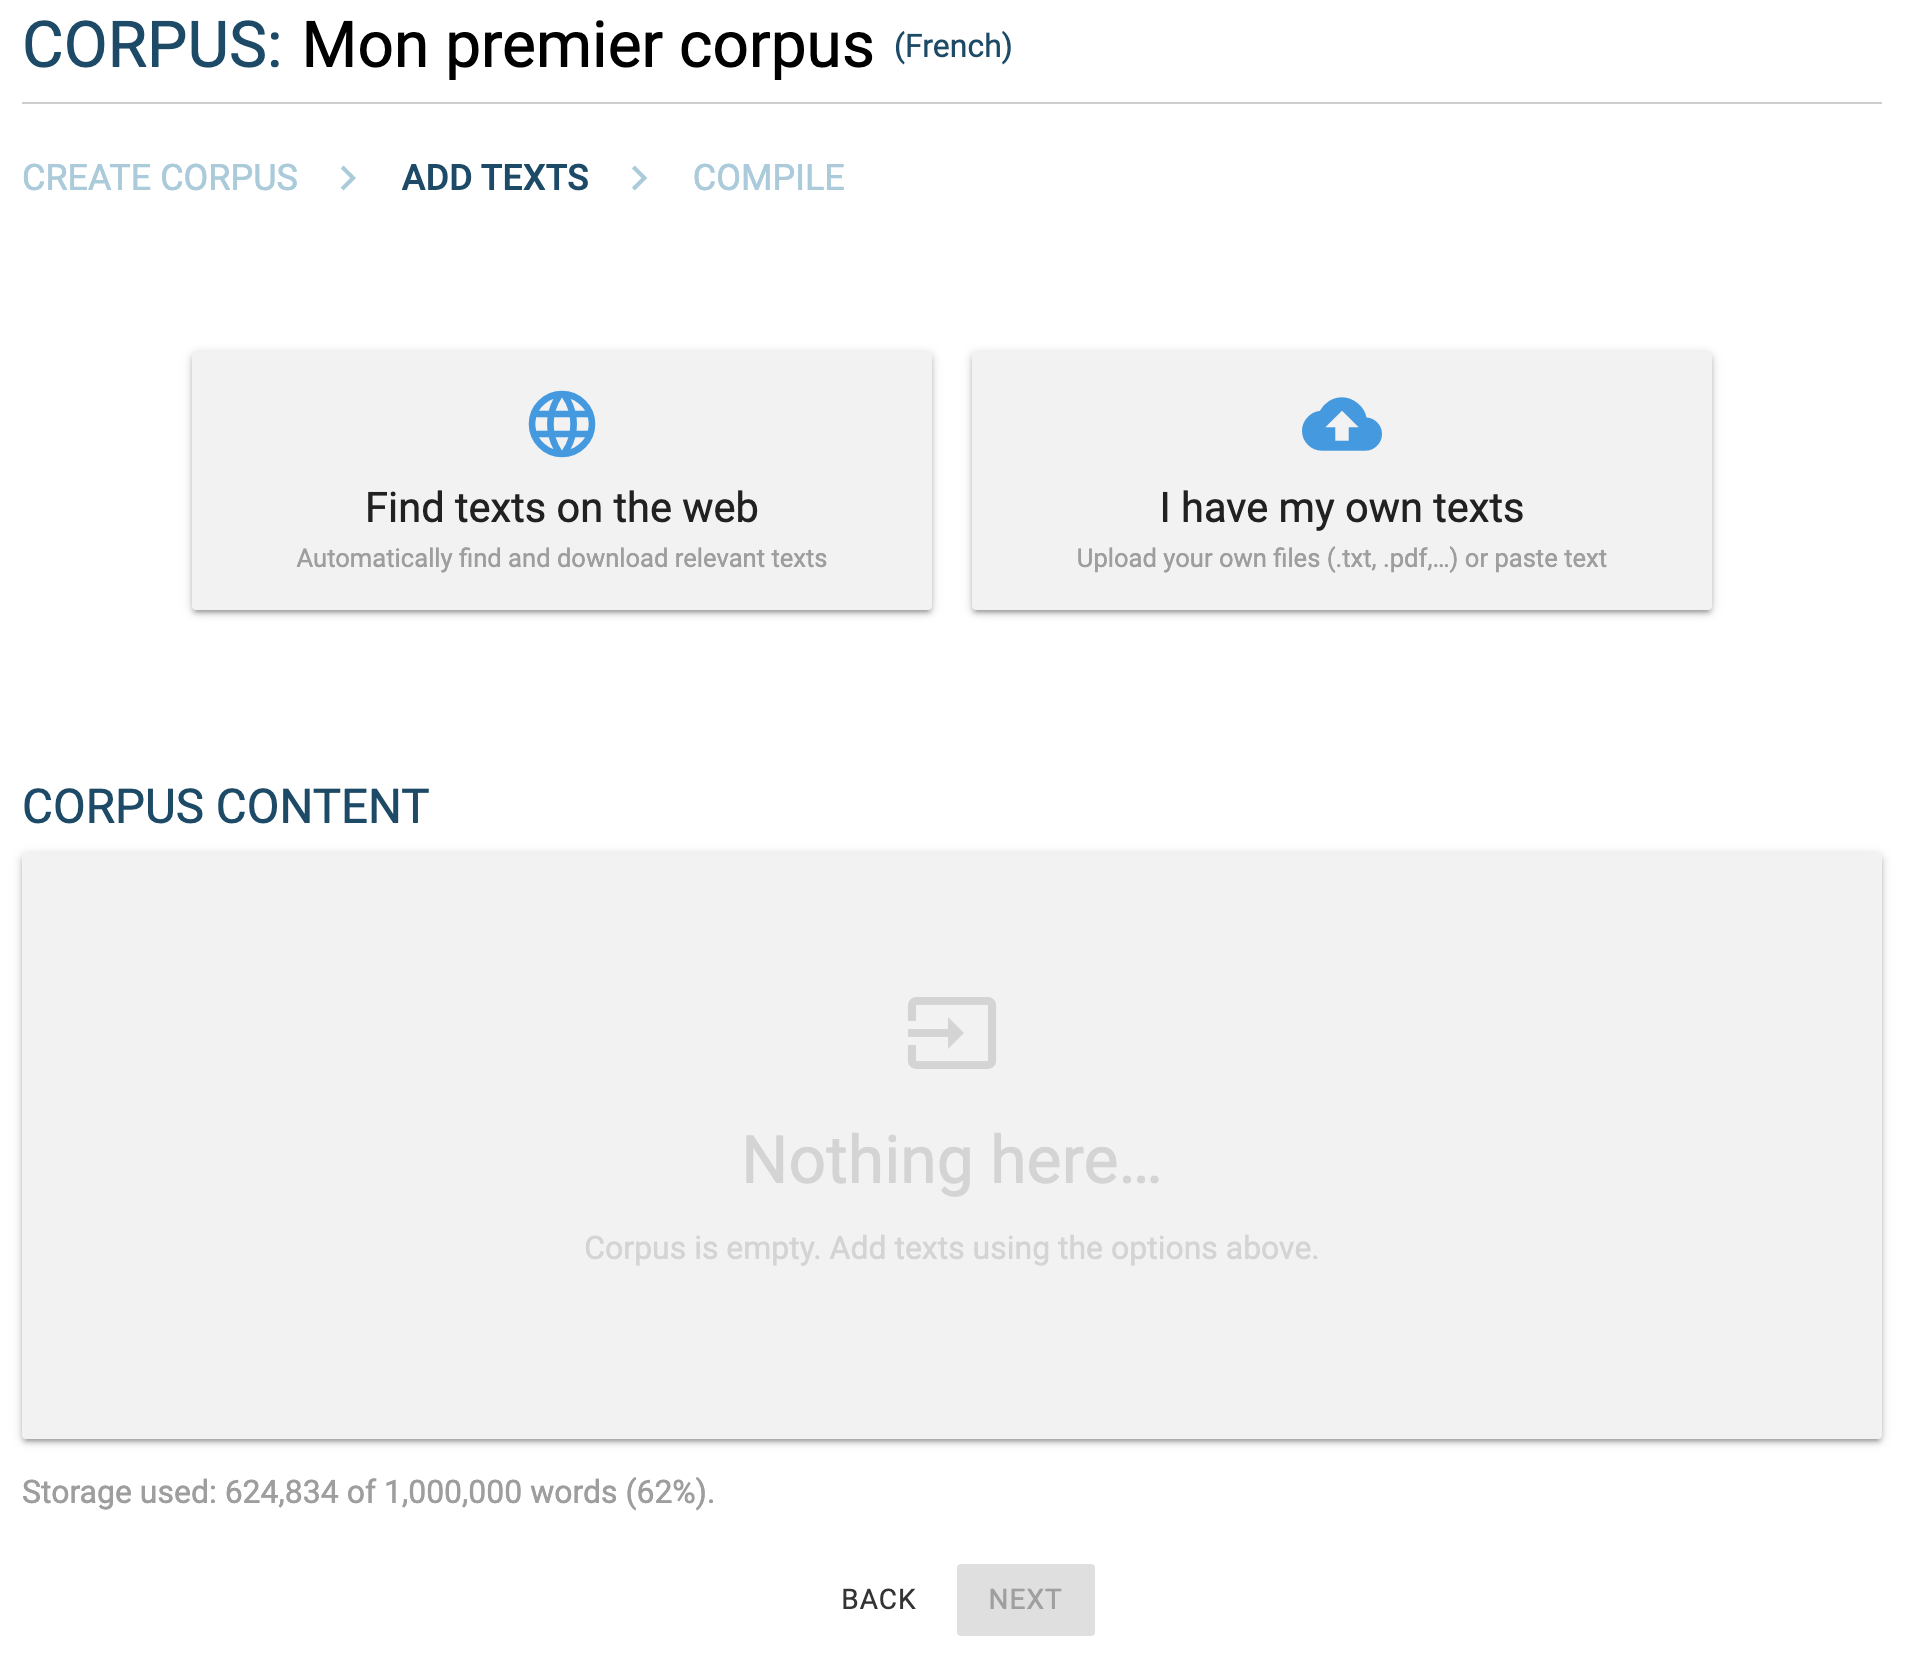
Figure 12. Choosing the source: your own files or texts from the web. Figure 12. Le choix de la source : fichiers personnels ou textes du web.
Page 3Page 3
Figure 13. Three ways of building a web corpus: keywords, a list of addresses or a whole site. Figure 13. Trois façons de construire un corpus web : mots-clés, liste d'adresses ou site complet.
Page 3Page 3
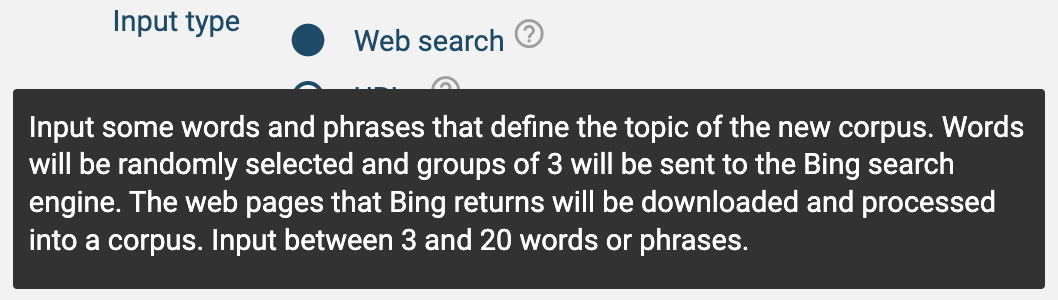
Figure 14. The question mark explains each option. Figure 14. Le « ? » explique chaque option.
Page 3Page 3
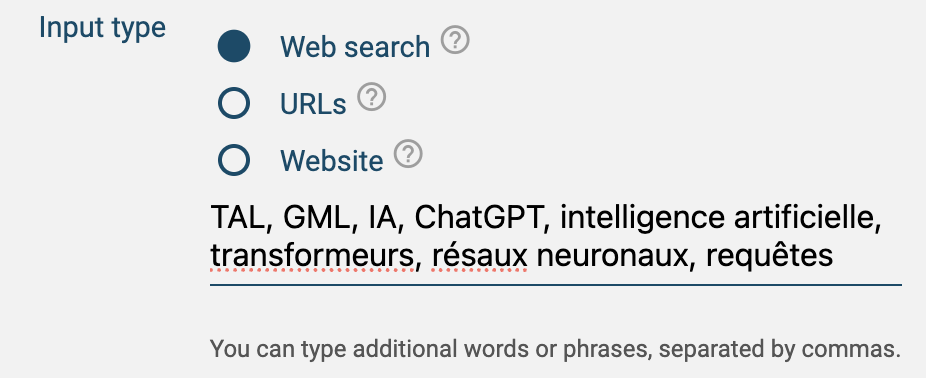
Figure 15. Entering the keywords that will guide the search for texts. Figure 15. La saisie des mots-clés qui guideront la recherche de textes.
Page 3Page 3
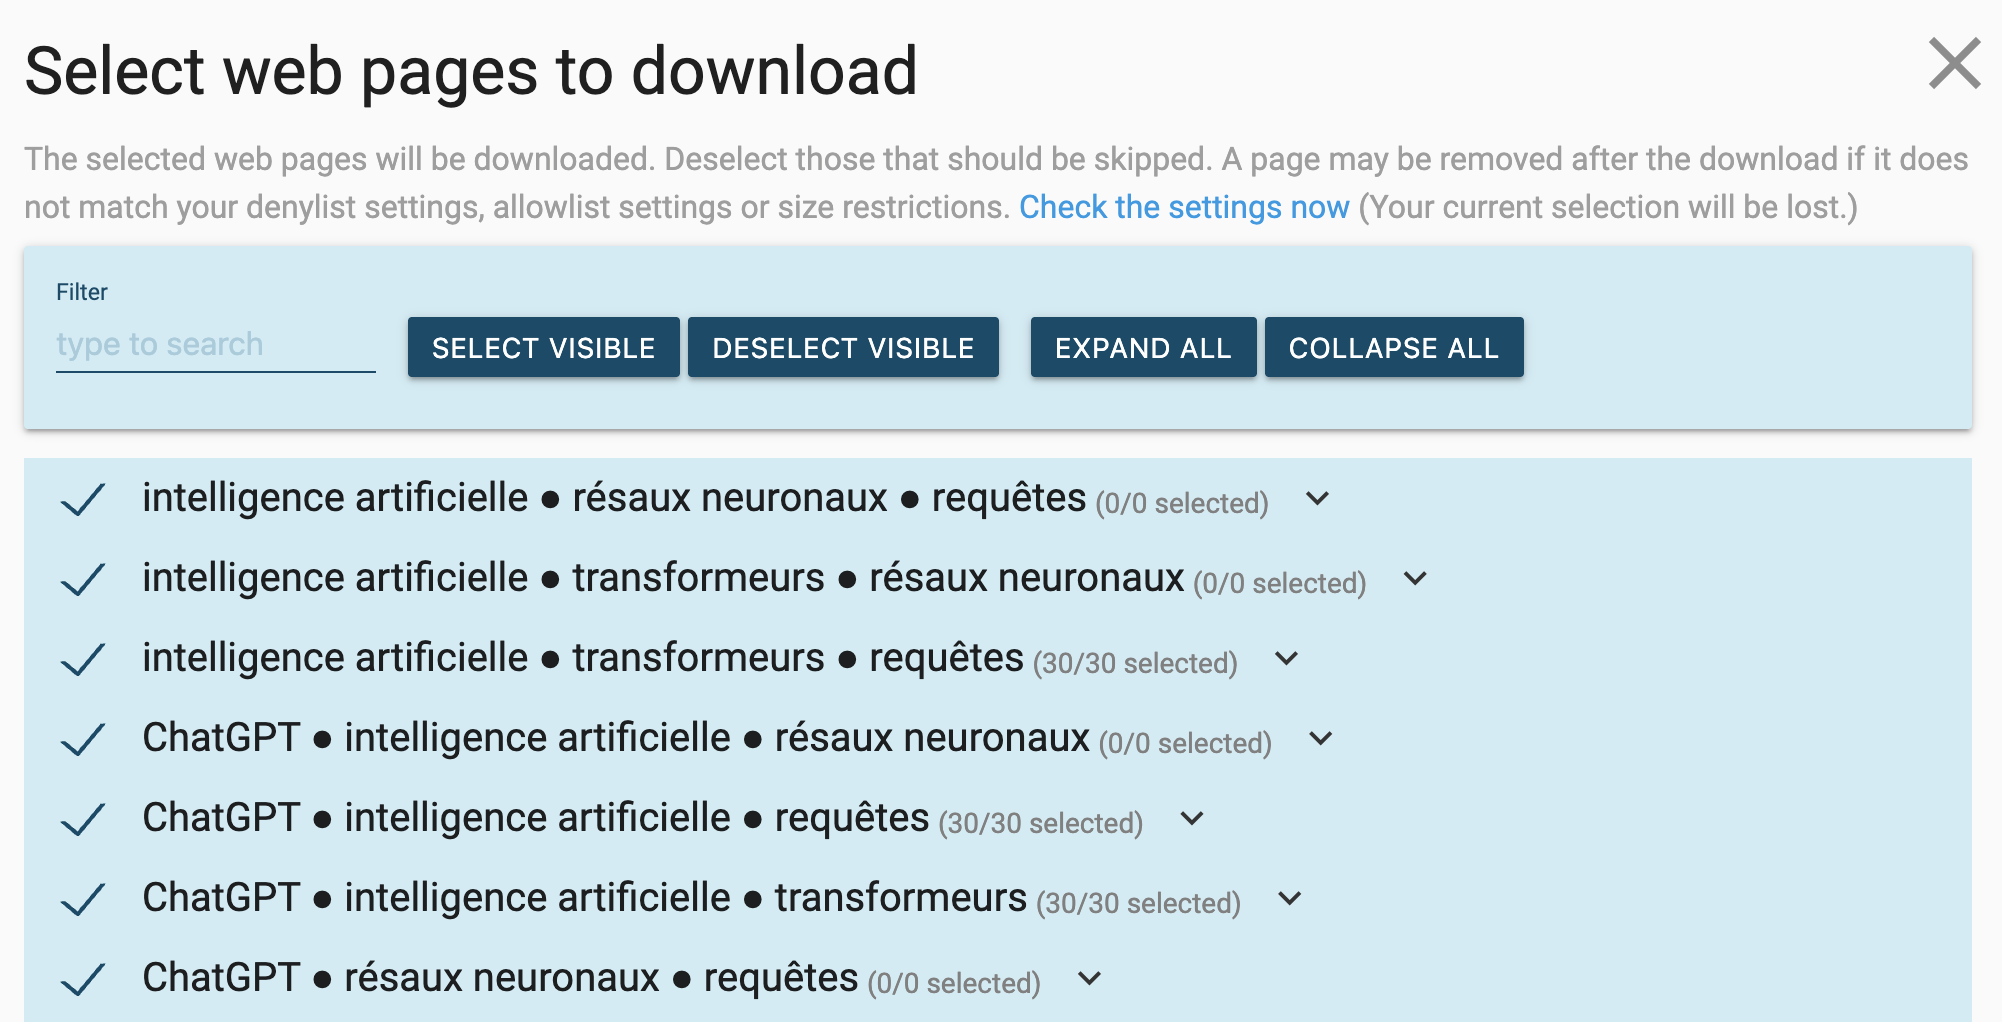
Figure 16. The progress of the search. Figure 16. La progression de la recherche.
Page 3Page 3
Figure 17. The pages found for each combination of keywords. Figure 17. Les pages trouvées pour chaque combinaison de mots-clés.
Page 3Page 3
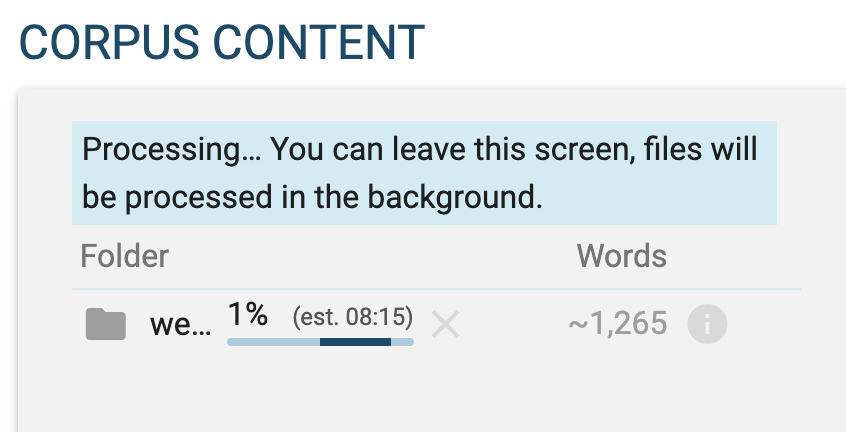
Figure 18. The texts being downloaded and processed. Figure 18. Le traitement des textes récoltés.
Page 3Page 3
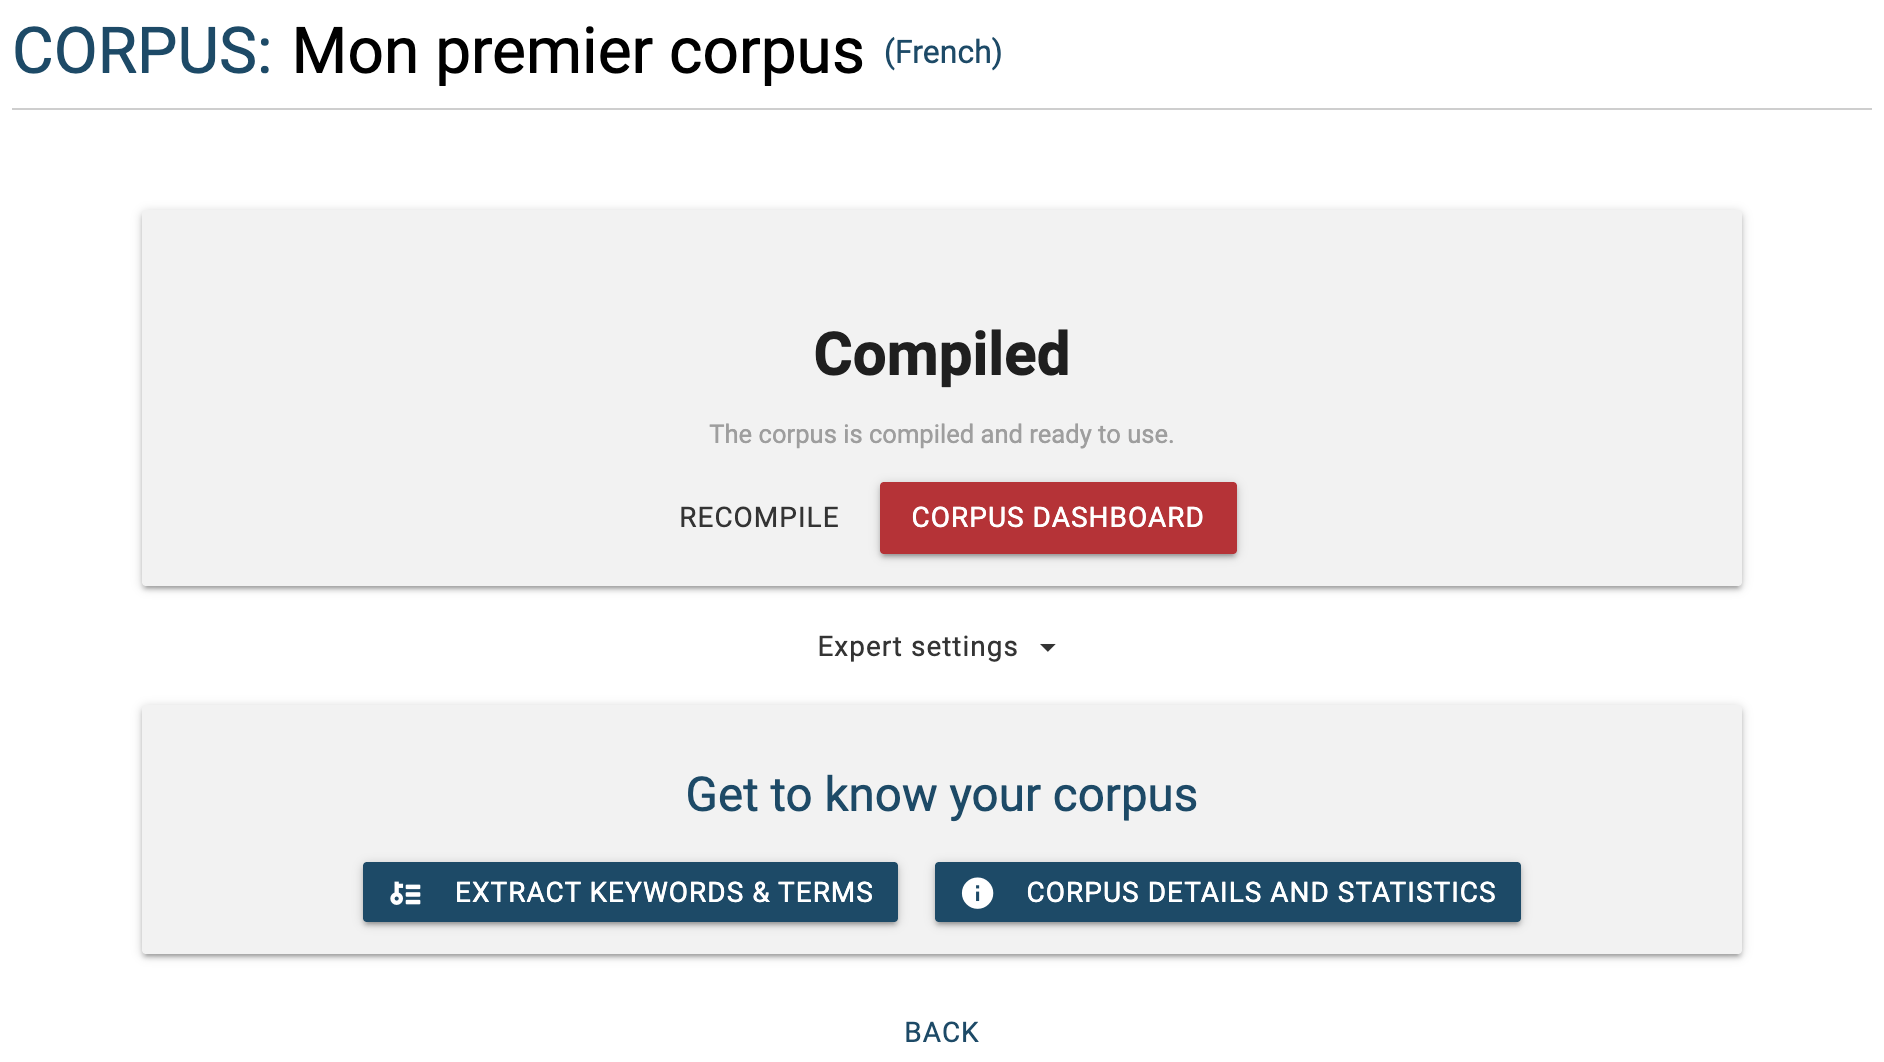
Figure 19. The corpus is ready. Figure 19. Le corpus est prêt.
Page 4Page 4
Checking and tuning your web corpusVérifier et régler son corpus web
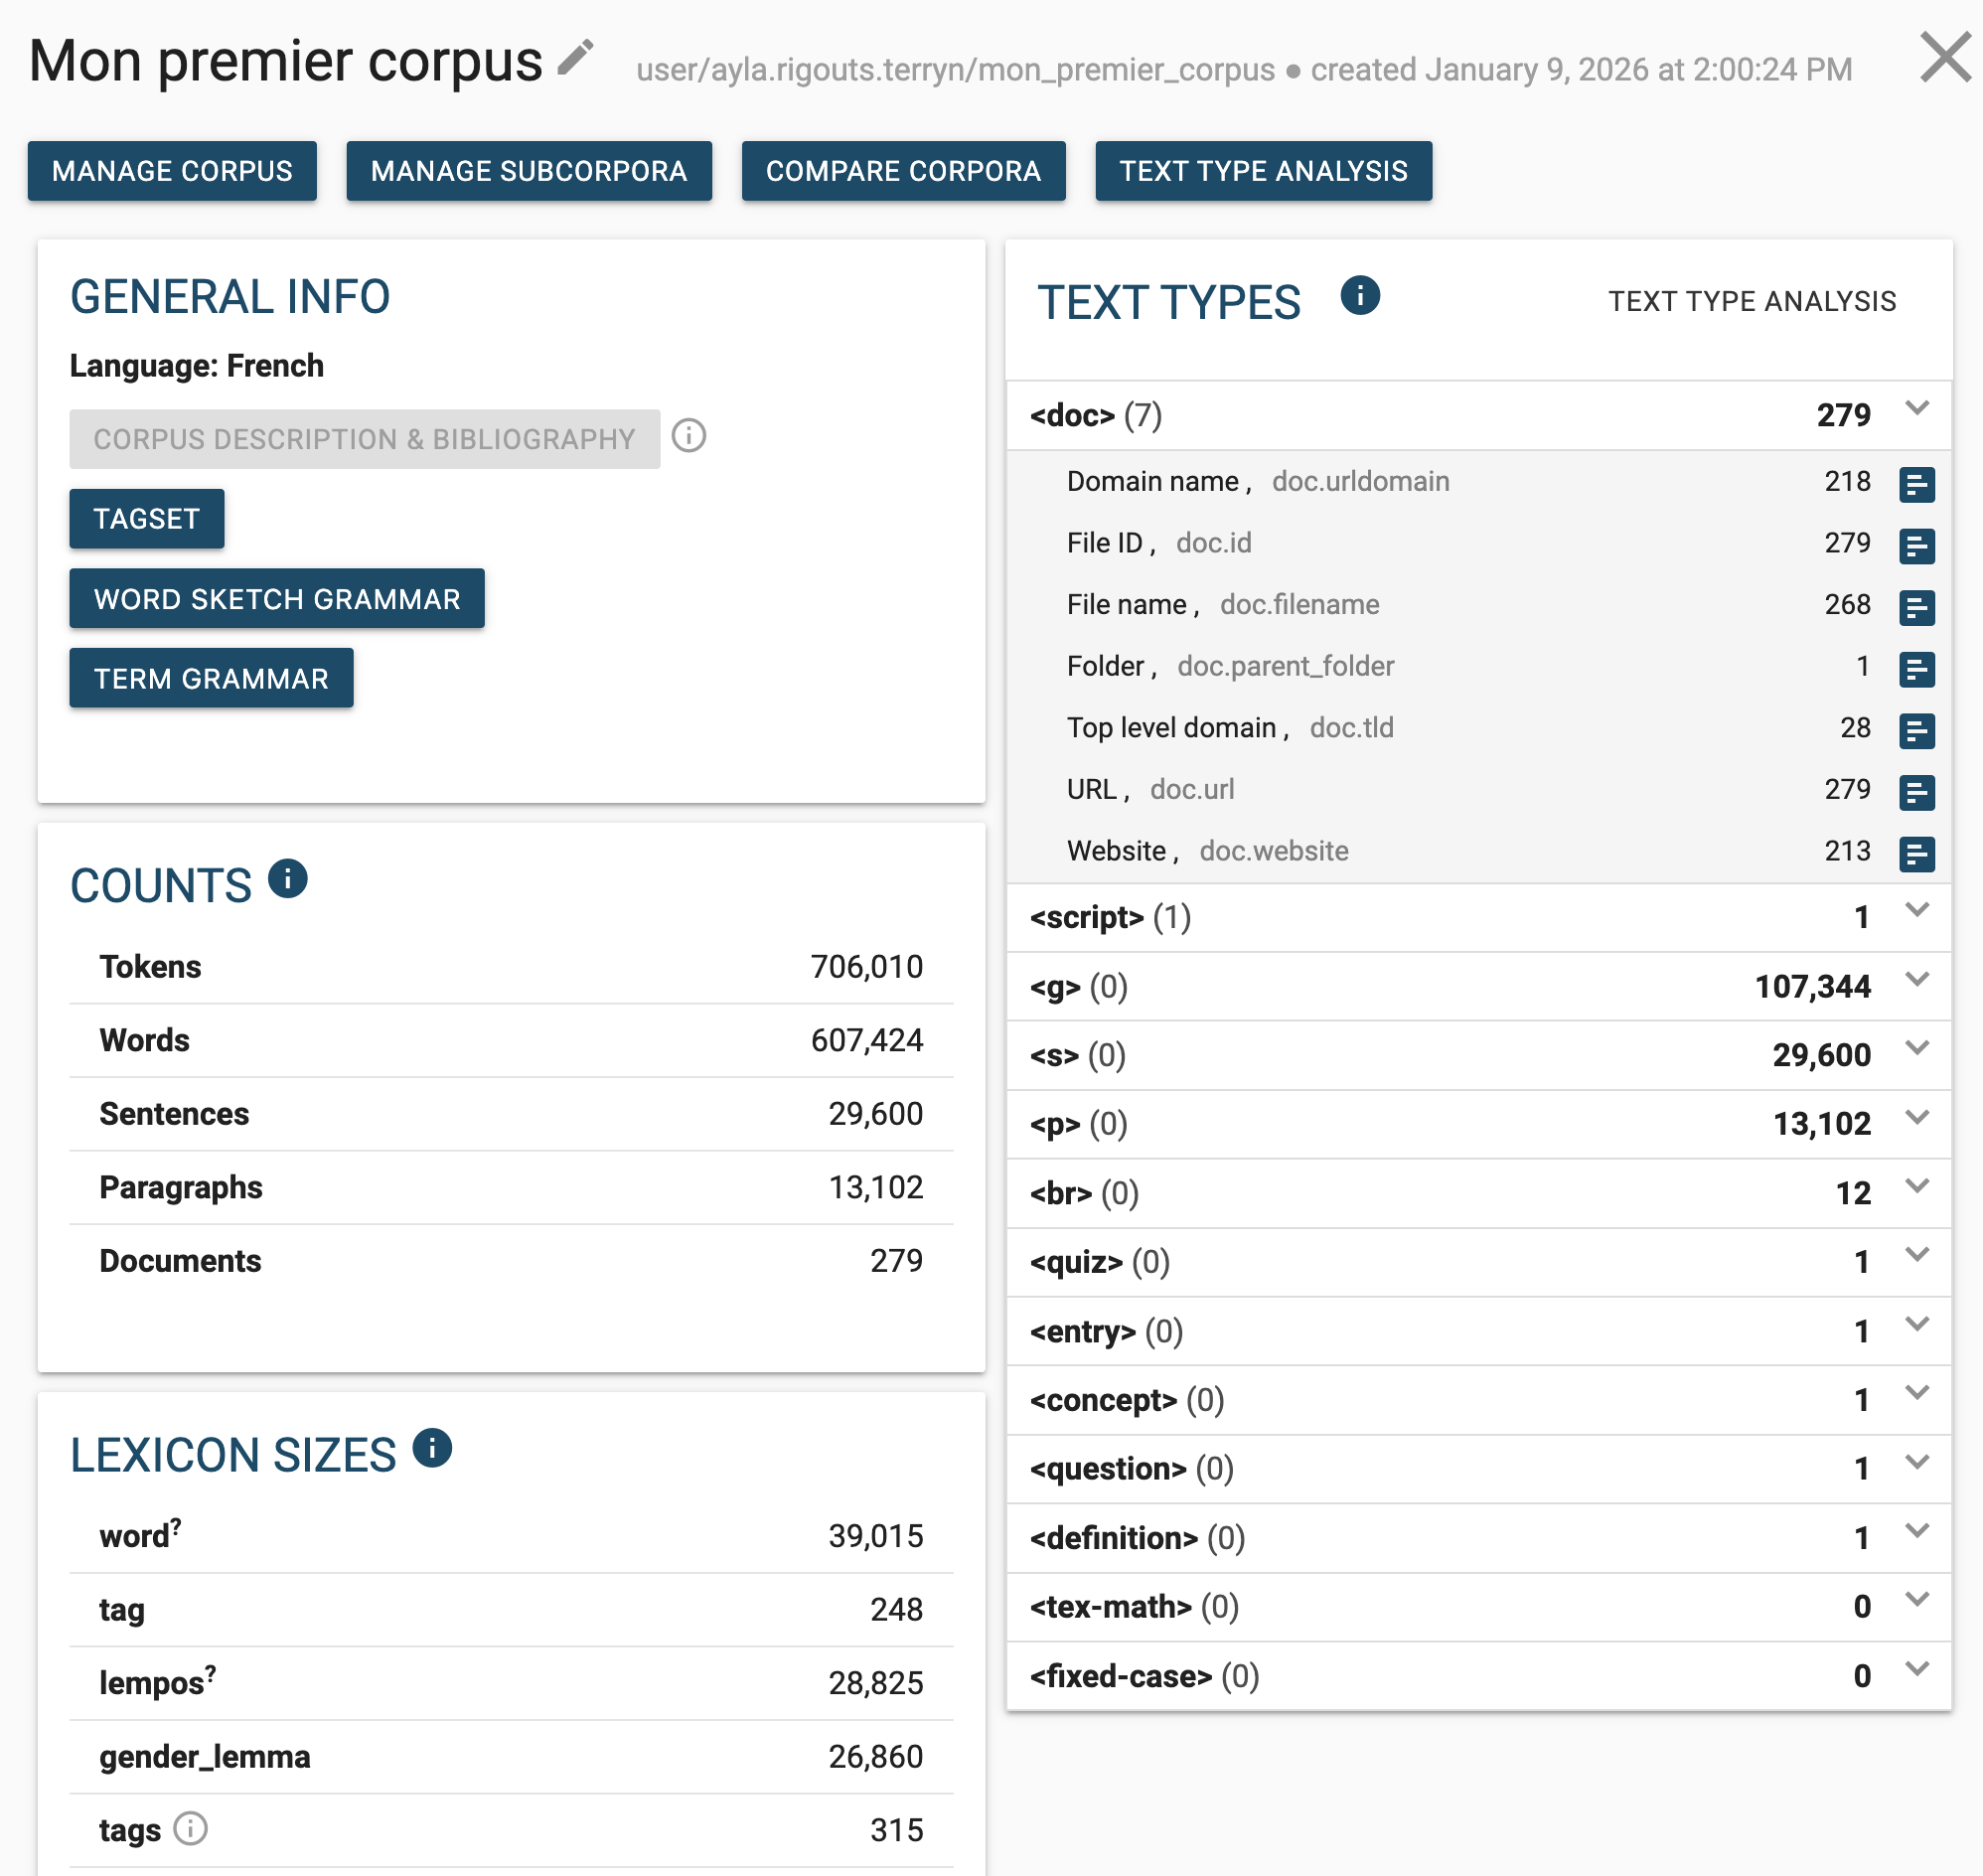
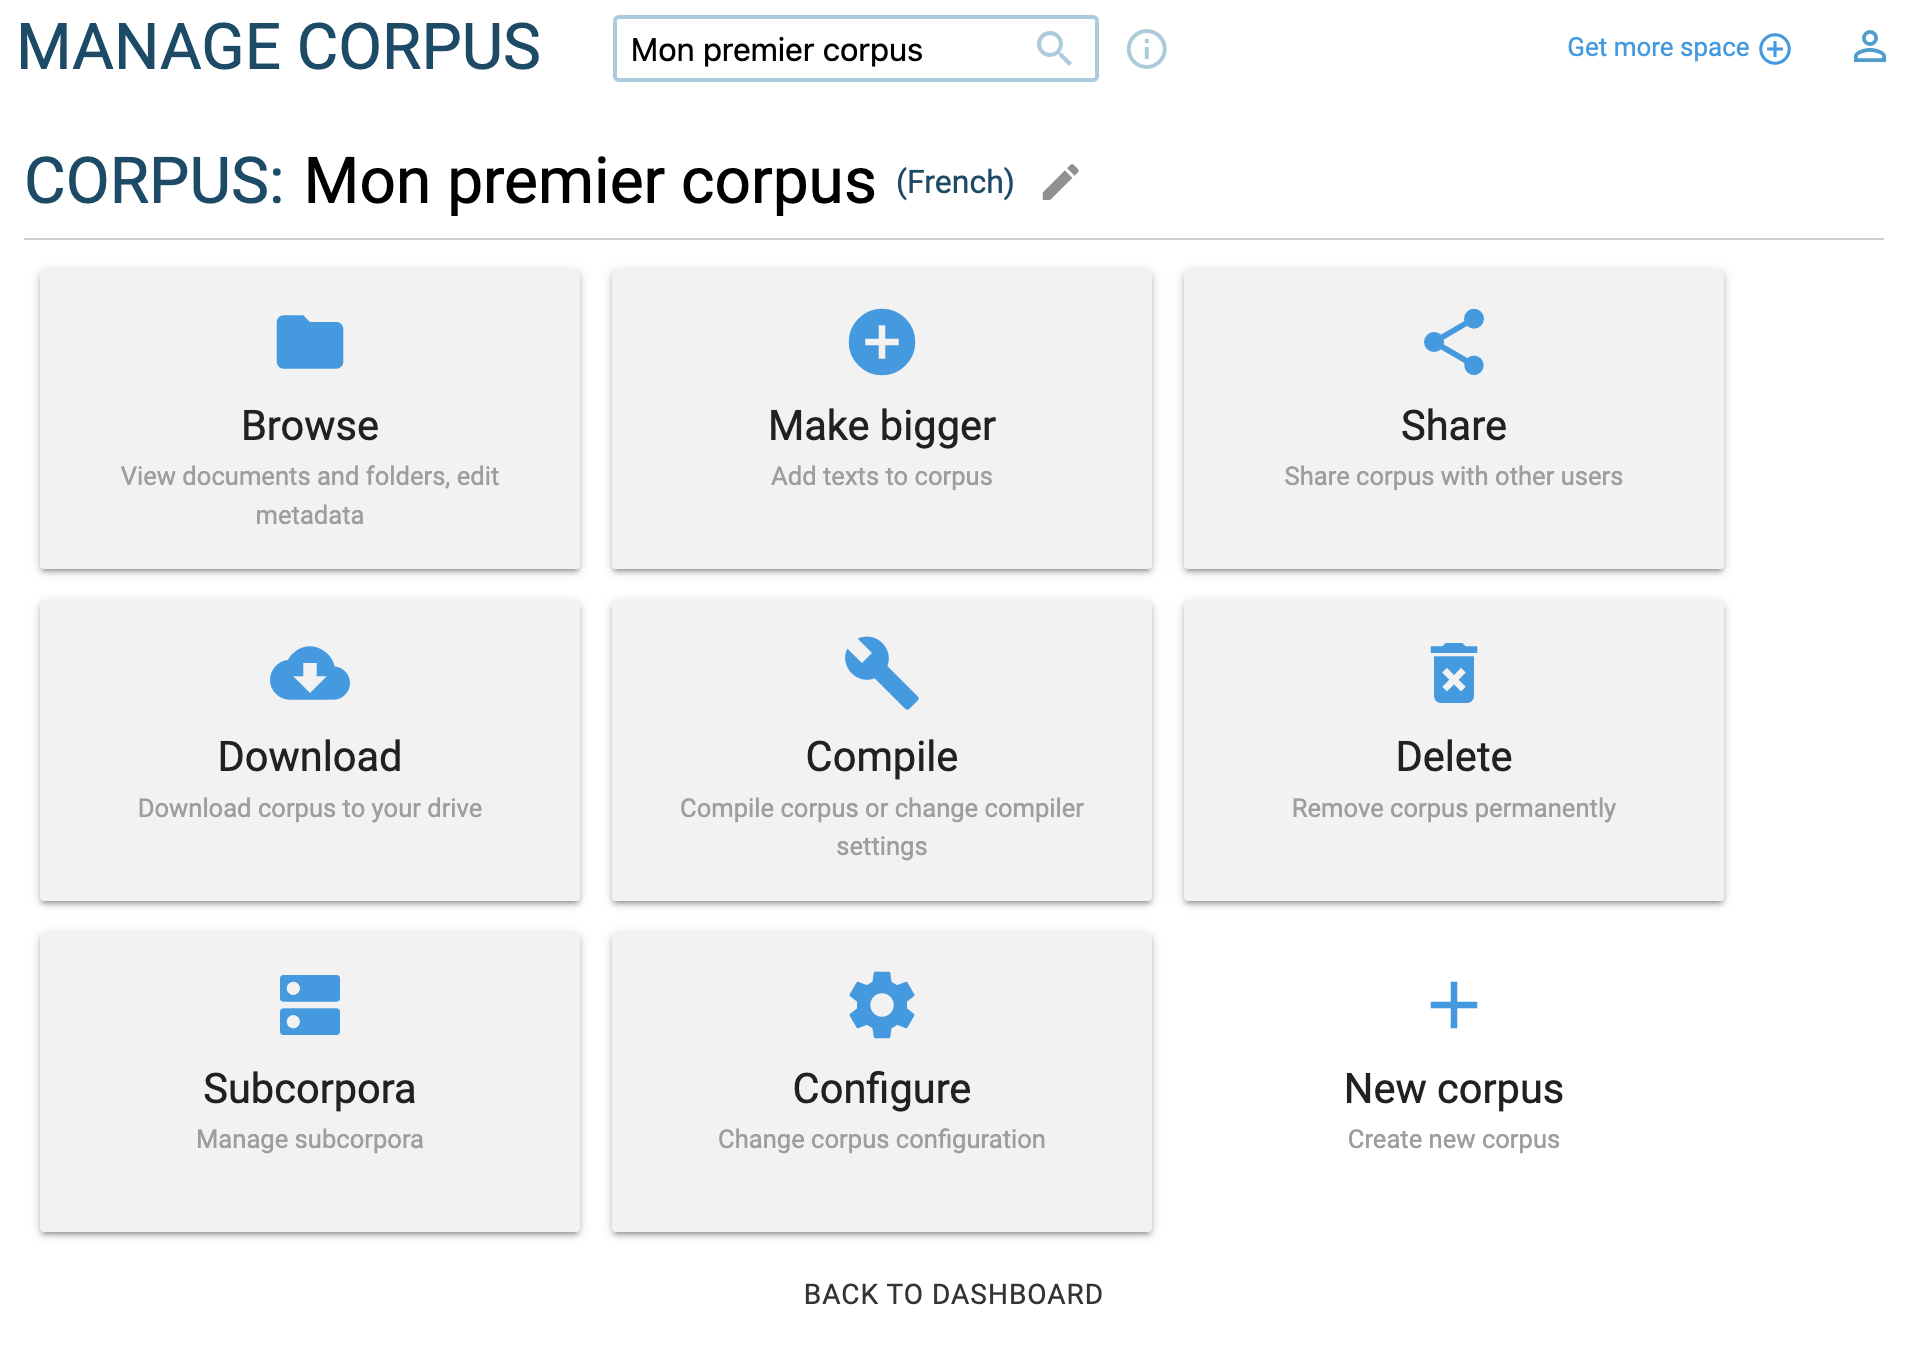
"Corpus details and statistics" says what the search actually collected: sizes, frequencies, composition, sources.
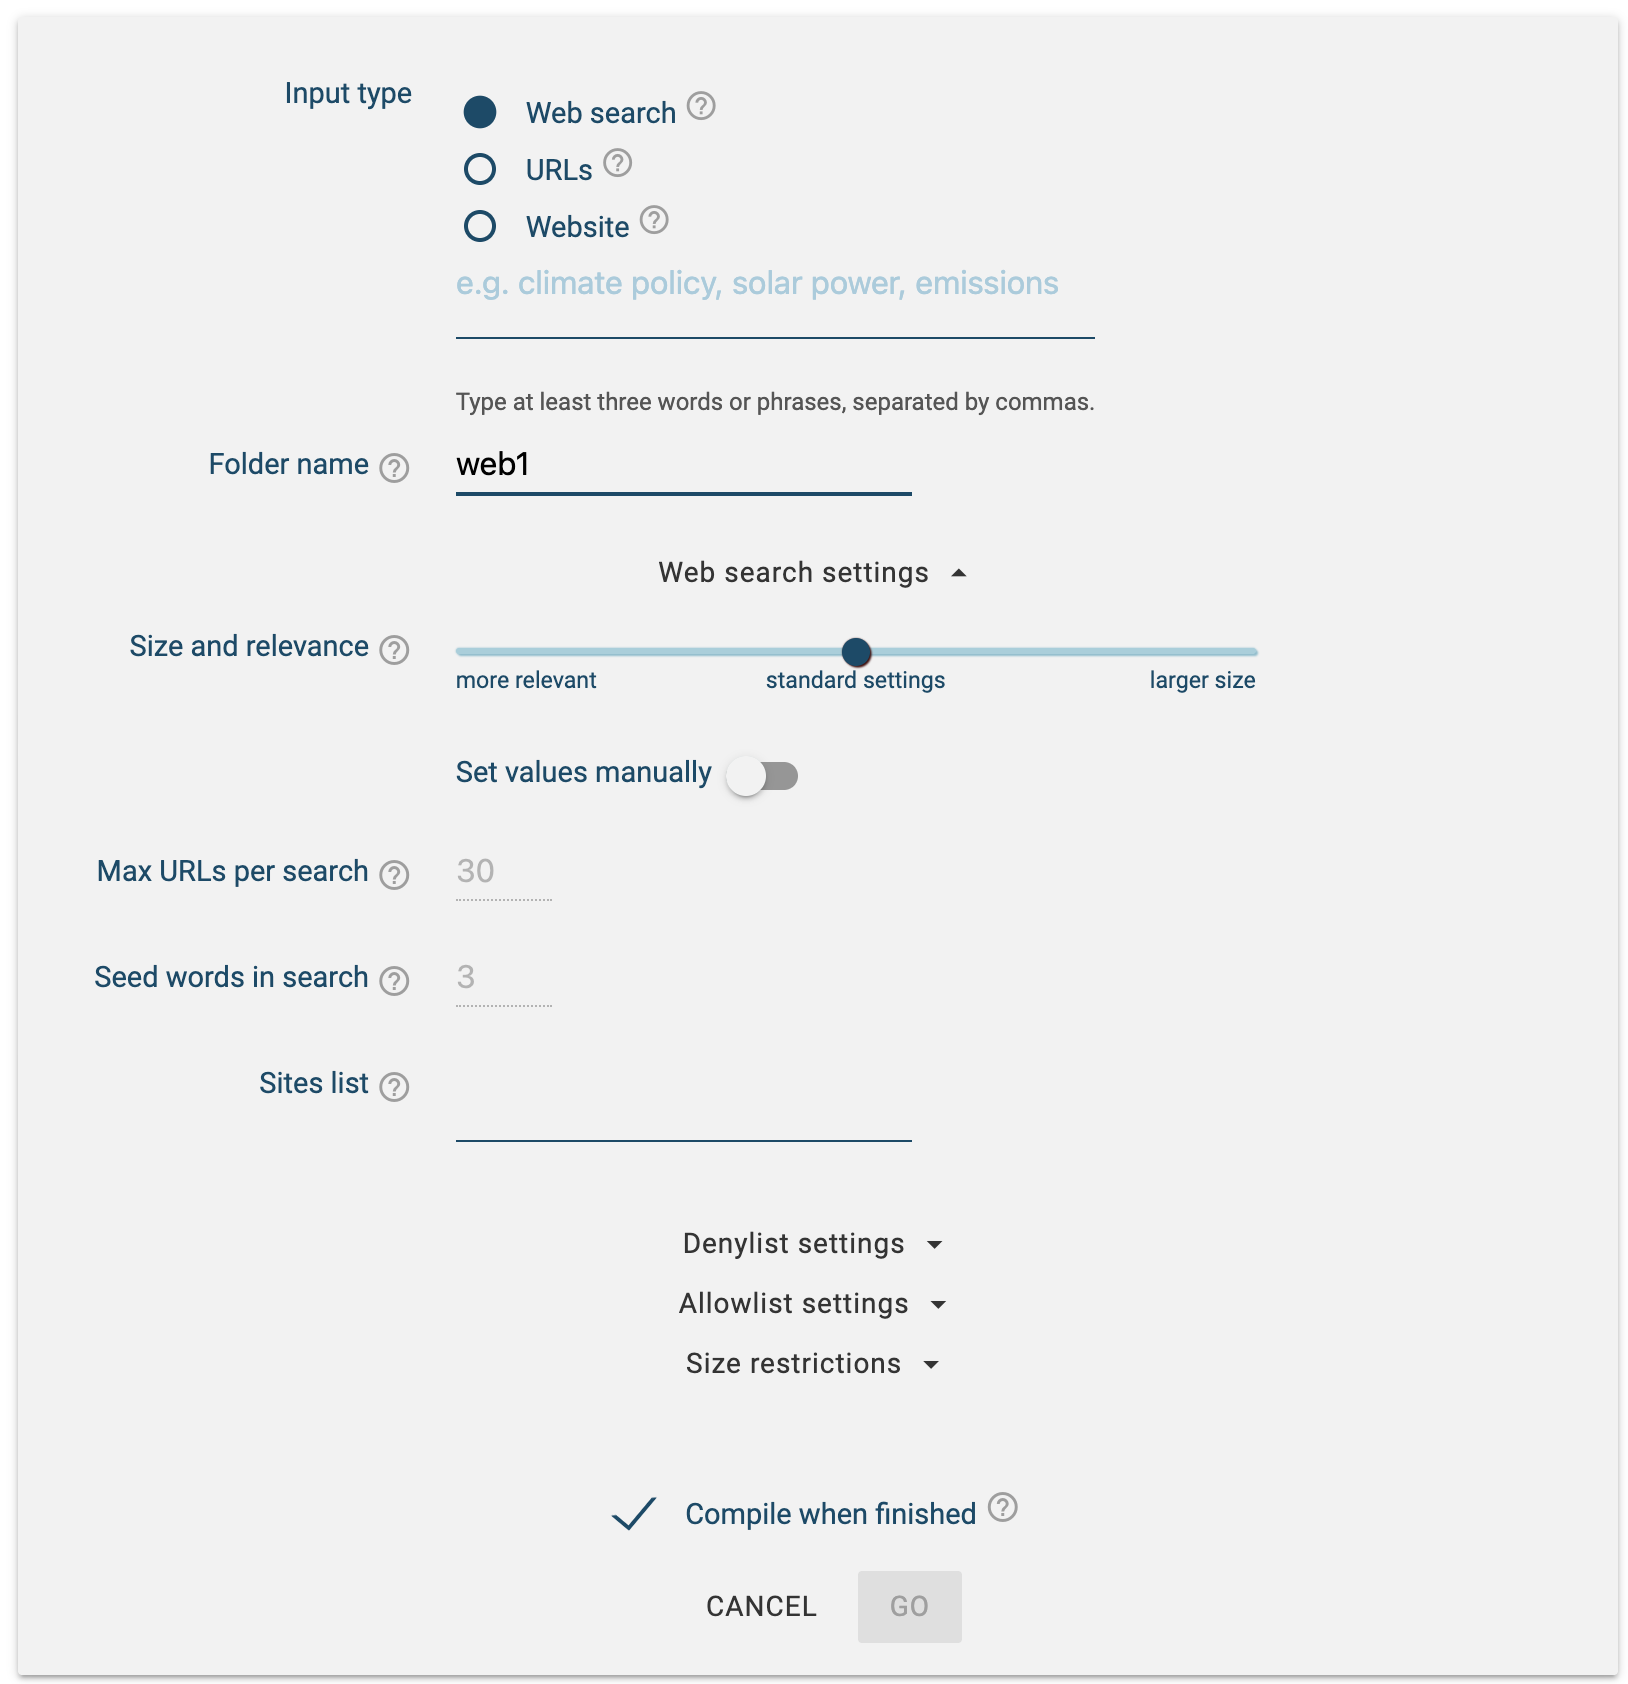
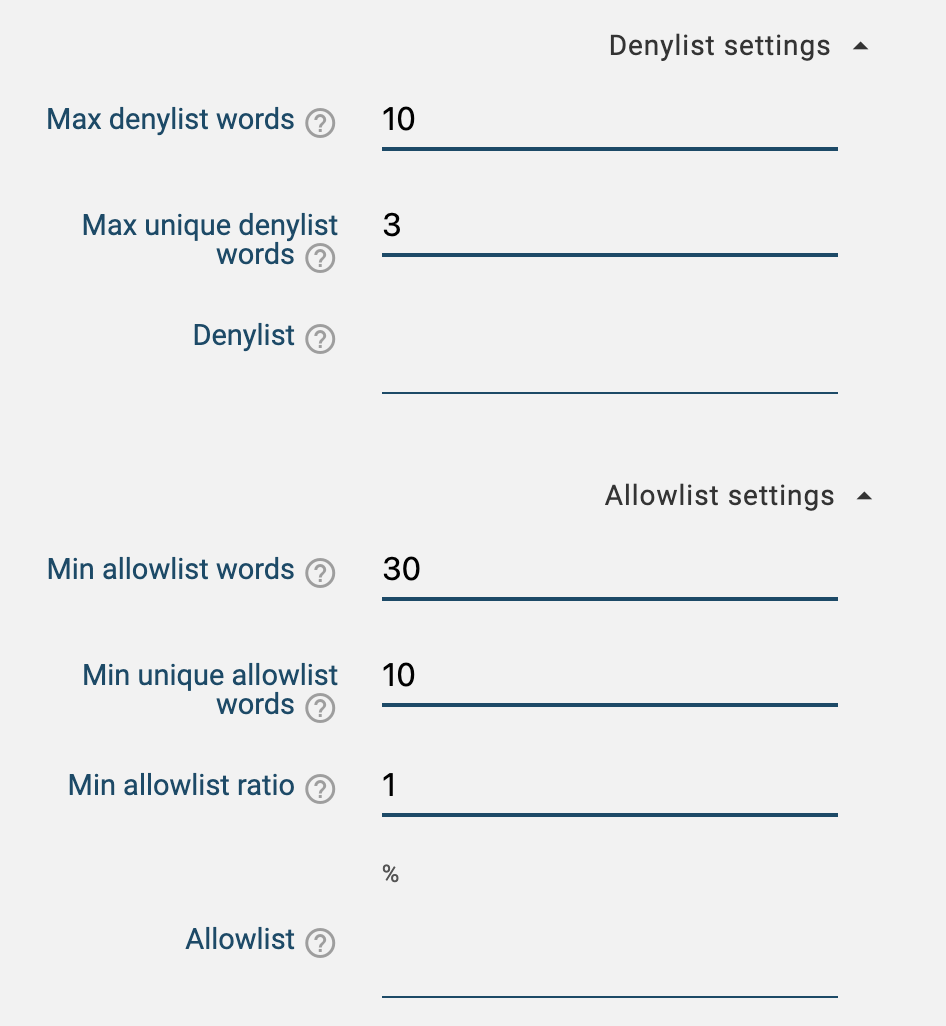
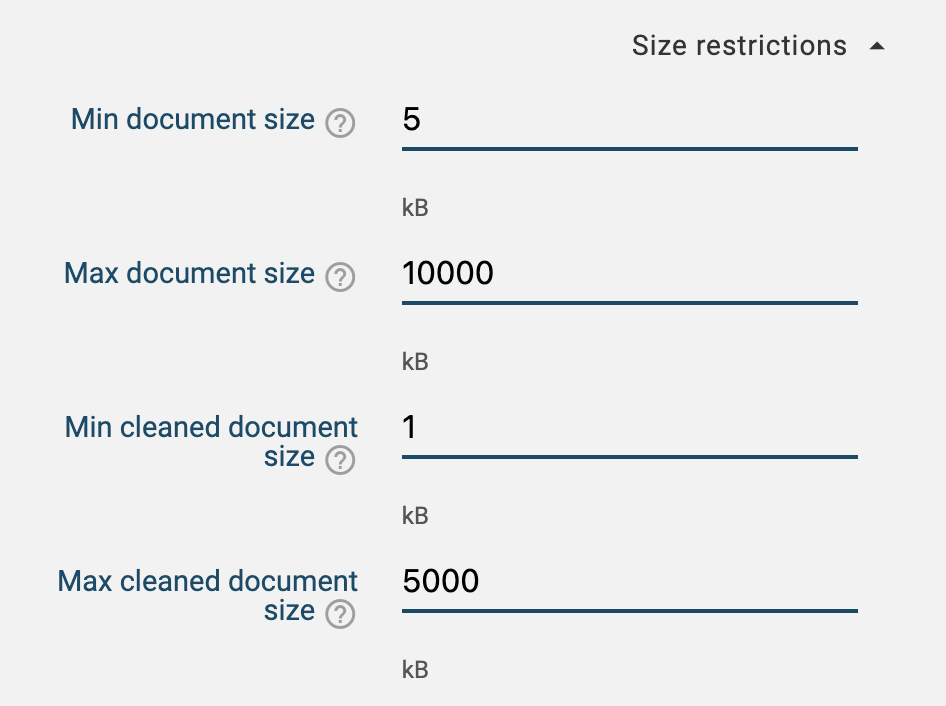
When the result is not what you wanted, four web search settings let you change it: the size-relevance slider, the allowlist, the denylist and the caps.
"Manage corpus" then serves to download, extend, share or delete the corpus, and to create subcorpora.
« Corpus details and statistics » décrit ce que la récolte a effectivement ramené : tailles, fréquences, composition, sources.
Si le résultat ne correspond pas à ce que vous vouliez, ce sont les paramètres de la recherche web qui le règlent : le curseur taille-pertinence, l'allowlist, la denylist, les plafonds.
« Manage corpus » sert ensuite à télécharger, élargir, partager ou supprimer le corpus, et à créer des sous-corpus.
Page 4Page 4
Figure 20. The statistics of a freshly built corpus: word counts, frequencies, composition. Figure 20. Les statistiques d'un corpus fraîchement créé : nombre de mots, fréquences, composition.
Page 4Page 4
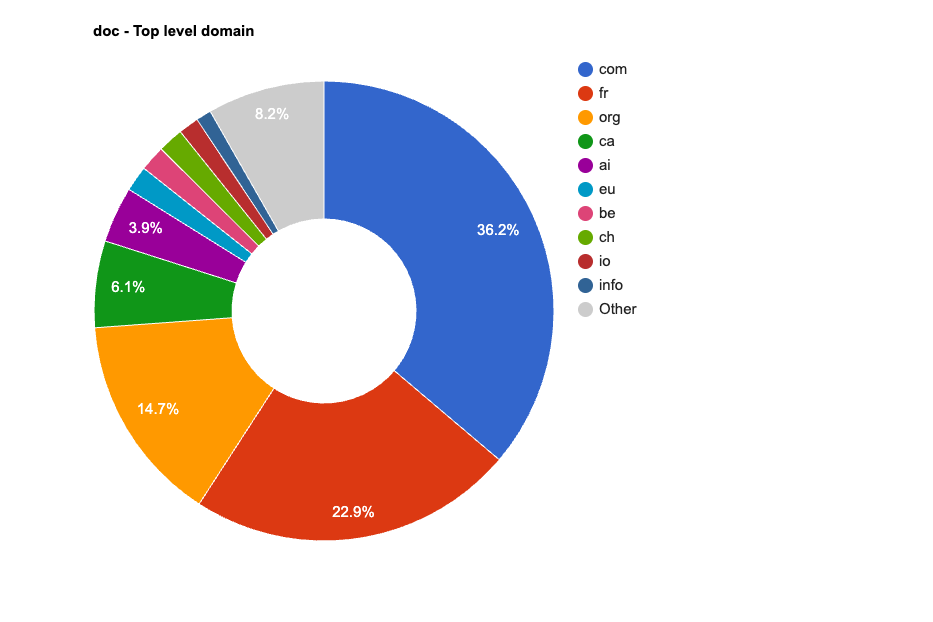
Figure 21. The analysis of the text types and sources of the corpus. Figure 21. L'analyse des types de textes et des sources du corpus.
Page 4Page 4
Figure 22. The settings of the web search. Figure 22. Les paramètres de la recherche web.
Page 4Page 4
Figure 23. The denylist and allowlist options. Figure 23. Les options « denylist » et « allowlist ».
Page 4Page 4
Figure 24. The size caps of the corpus. Figure 24. Les plafonds de taille du corpus.
Page 4Page 4
Figure 25. The management menu: download, extend, share, delete. Figure 25. Le menu de gestion : télécharger, élargir, partager, supprimer.
Page 5Page 5
The practice corpusLe corpus des exercices
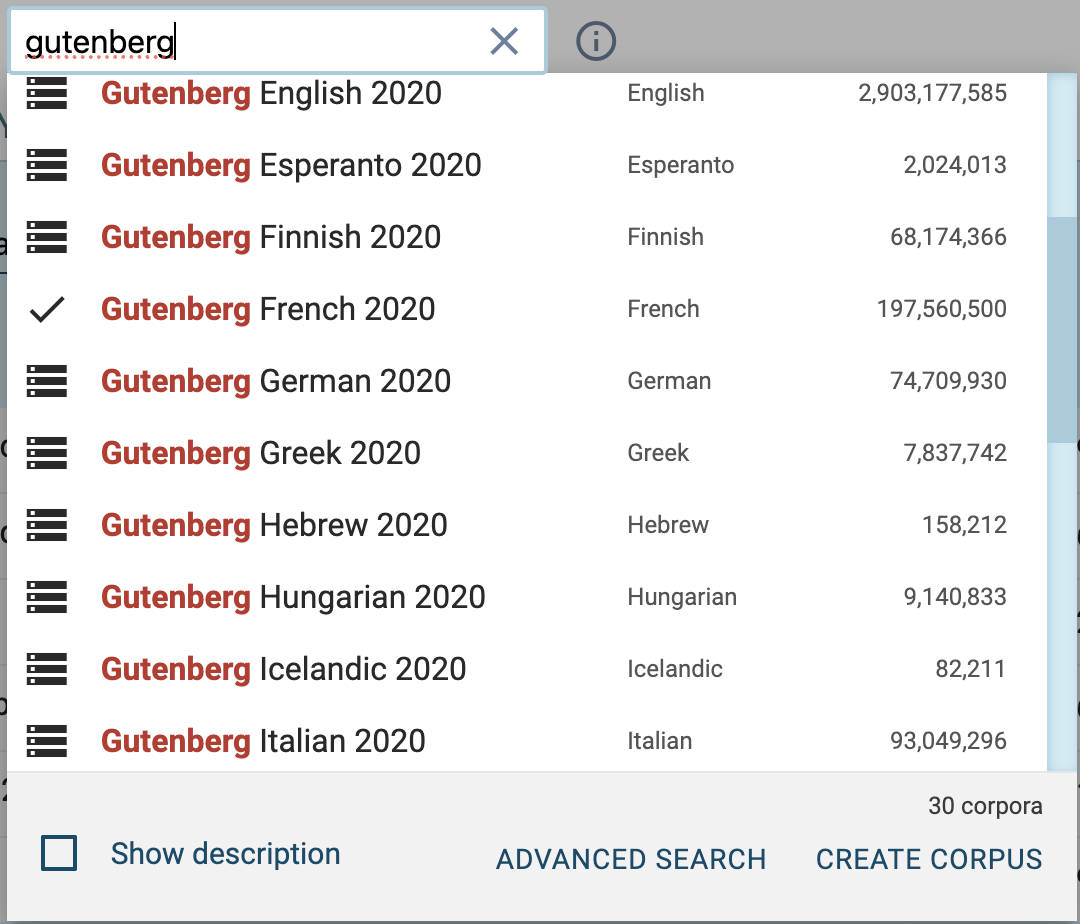
The exercises of this chapter use a fixed corpus, Gutenberg French 2020, so that everyone gets the same answers.
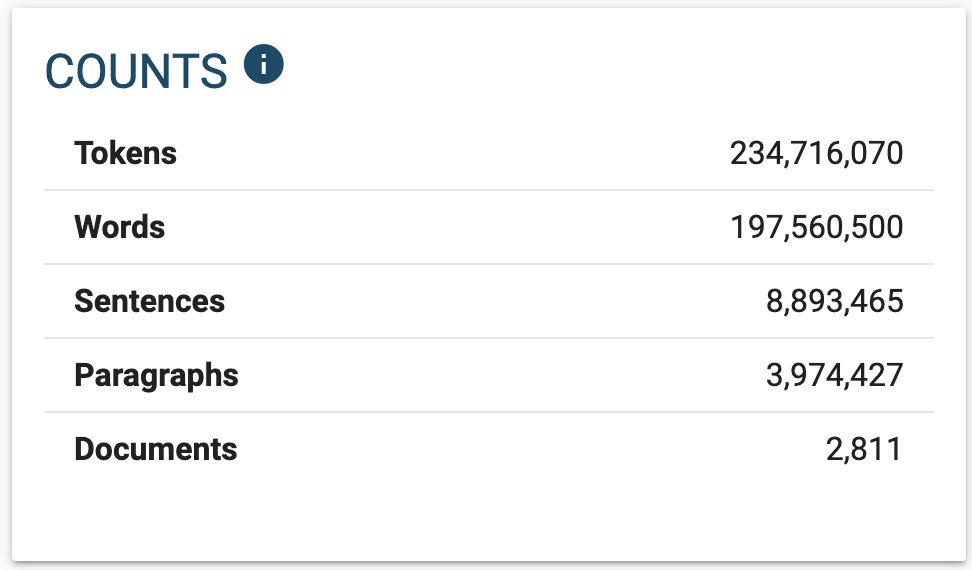
First skill: reading the statistics of a corpus, starting with the difference between "tokens" and "words".
Les exercices du chapitre utilisent un corpus fixe, Gutenberg French 2020, pour que tout le monde obtienne les mêmes réponses.
Première compétence : lire les statistiques d'un corpus, à commencer par la différence entre « tokens » et « words ».
Page 5Page 5
Figure 26. Selecting the Gutenberg French 2020 corpus in the list of corpora. Figure 26. La sélection du corpus Gutenberg French 2020 dans la liste des corpus.
Page 5Page 5
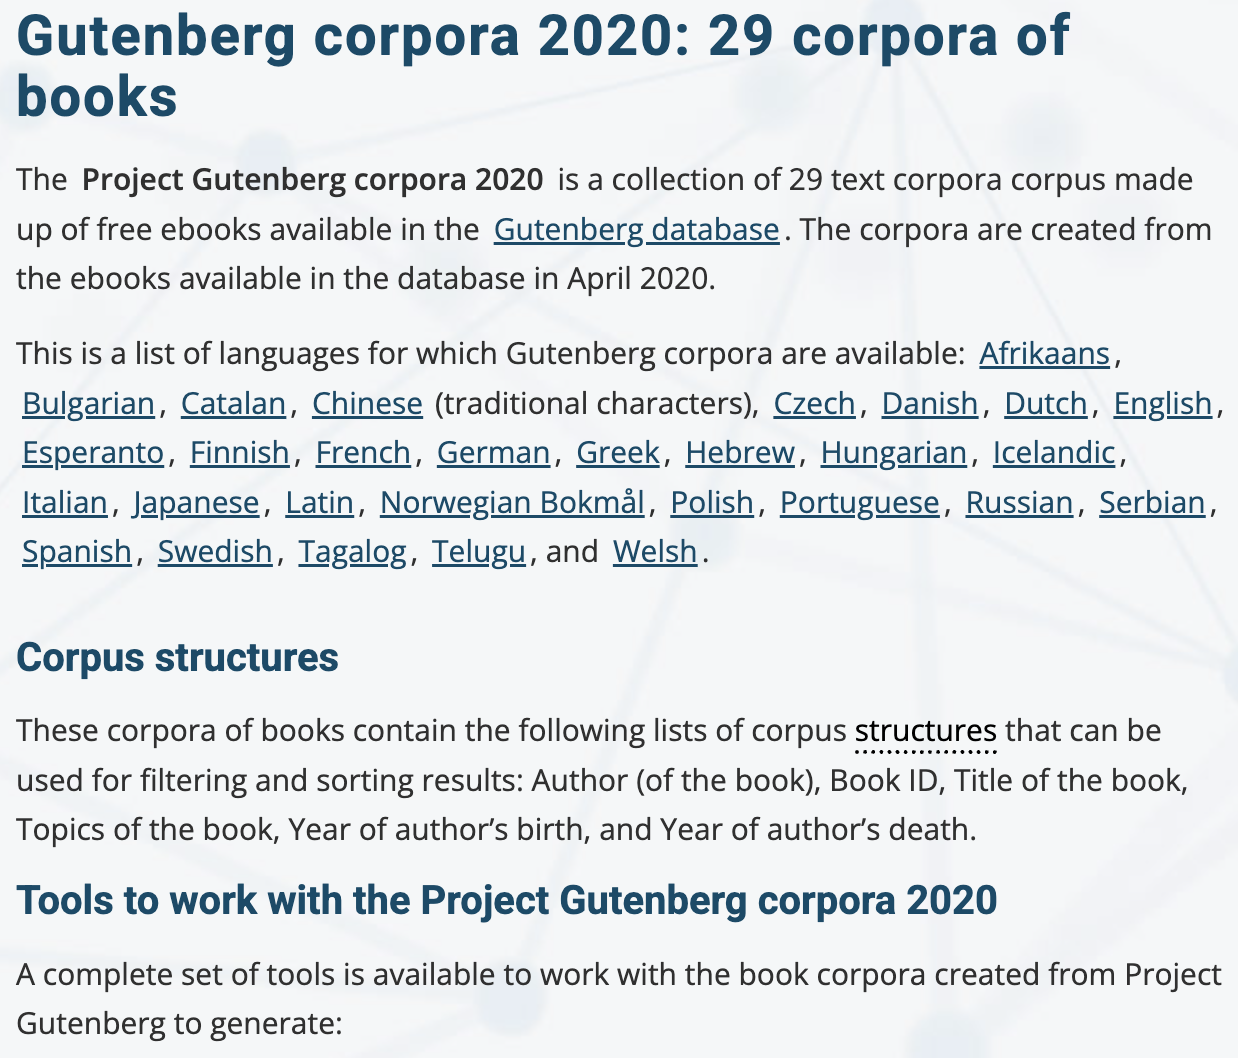
Figure 27. The corpus record as given on the Sketch Engine site. Figure 27. La fiche du corpus selon le site de Sketch Engine.
Page 5Page 5
Figure 28. The statistics of the corpus: 234,716,070 tokens and 197,560,500 words. Figure 28. Les statistiques du corpus : 234 716 070 « tokens » et 197 560 500 « words ».
Page 6Page 6
Wordlist: frequency listsWordlist : les listes de fréquences
Wordlist ranks the words of a corpus by frequency, with filtering by part of speech.
The list can count forms or : two different questions, two different results.
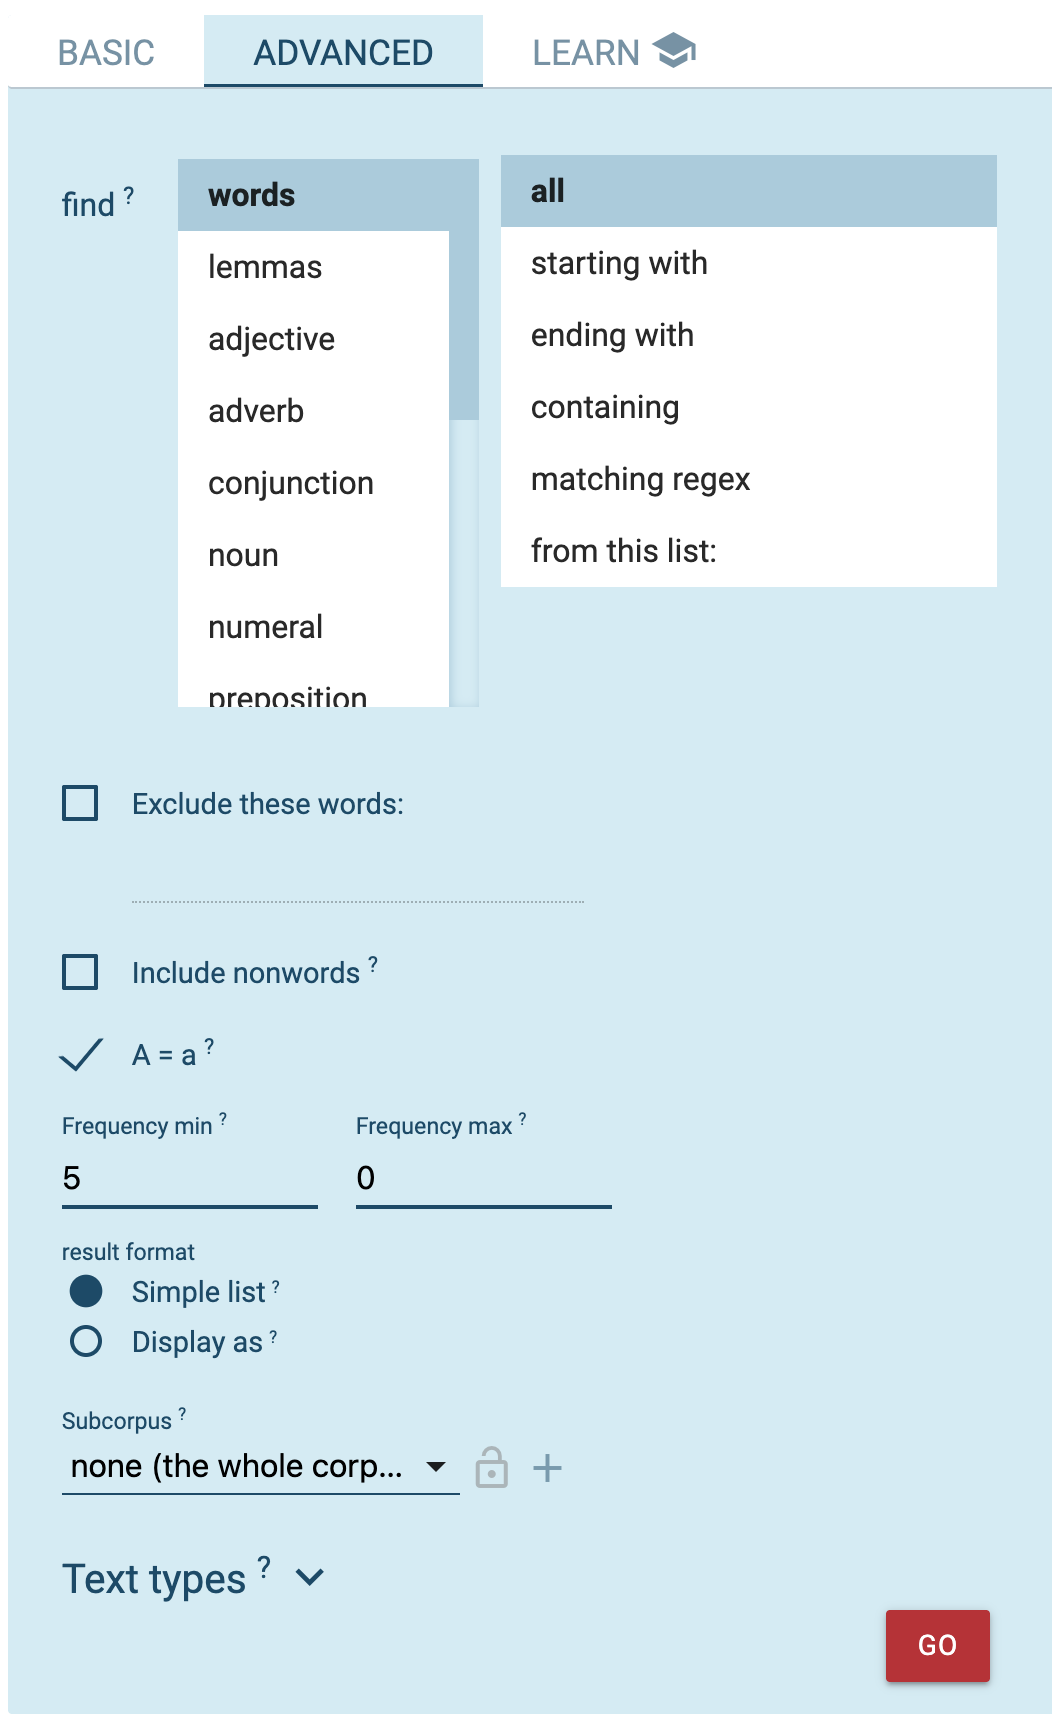
Advanced mode filters by pattern, minimum and maximum frequency, case, subcorpus.
Wordlist classe les mots d'un corpus par fréquence, avec filtrage par catégorie grammaticale.
La liste peut compter les formes ou les : deux questions différentes, deux résultats différents.
Le mode avancé filtre par motif, fréquence minimale et maximale, casse, sous-corpus.
lemma · fr: lemme lemme · en : lemma linguisticslinguistique : The base or dictionary form under which the inflected forms of a word are grouped: go, goes, went and gone share the lemma go.Forme de base, ou forme de dictionnaire, sous laquelle sont regroupées les formes fléchies d'un mot : va, allons, allait et allé partagent le lemme aller.
Page 6Page 6
Figure 29. Reaching Wordlist from the main menu. Figure 29. L'accès à Wordlist depuis le menu principal.
Page 6Page 6
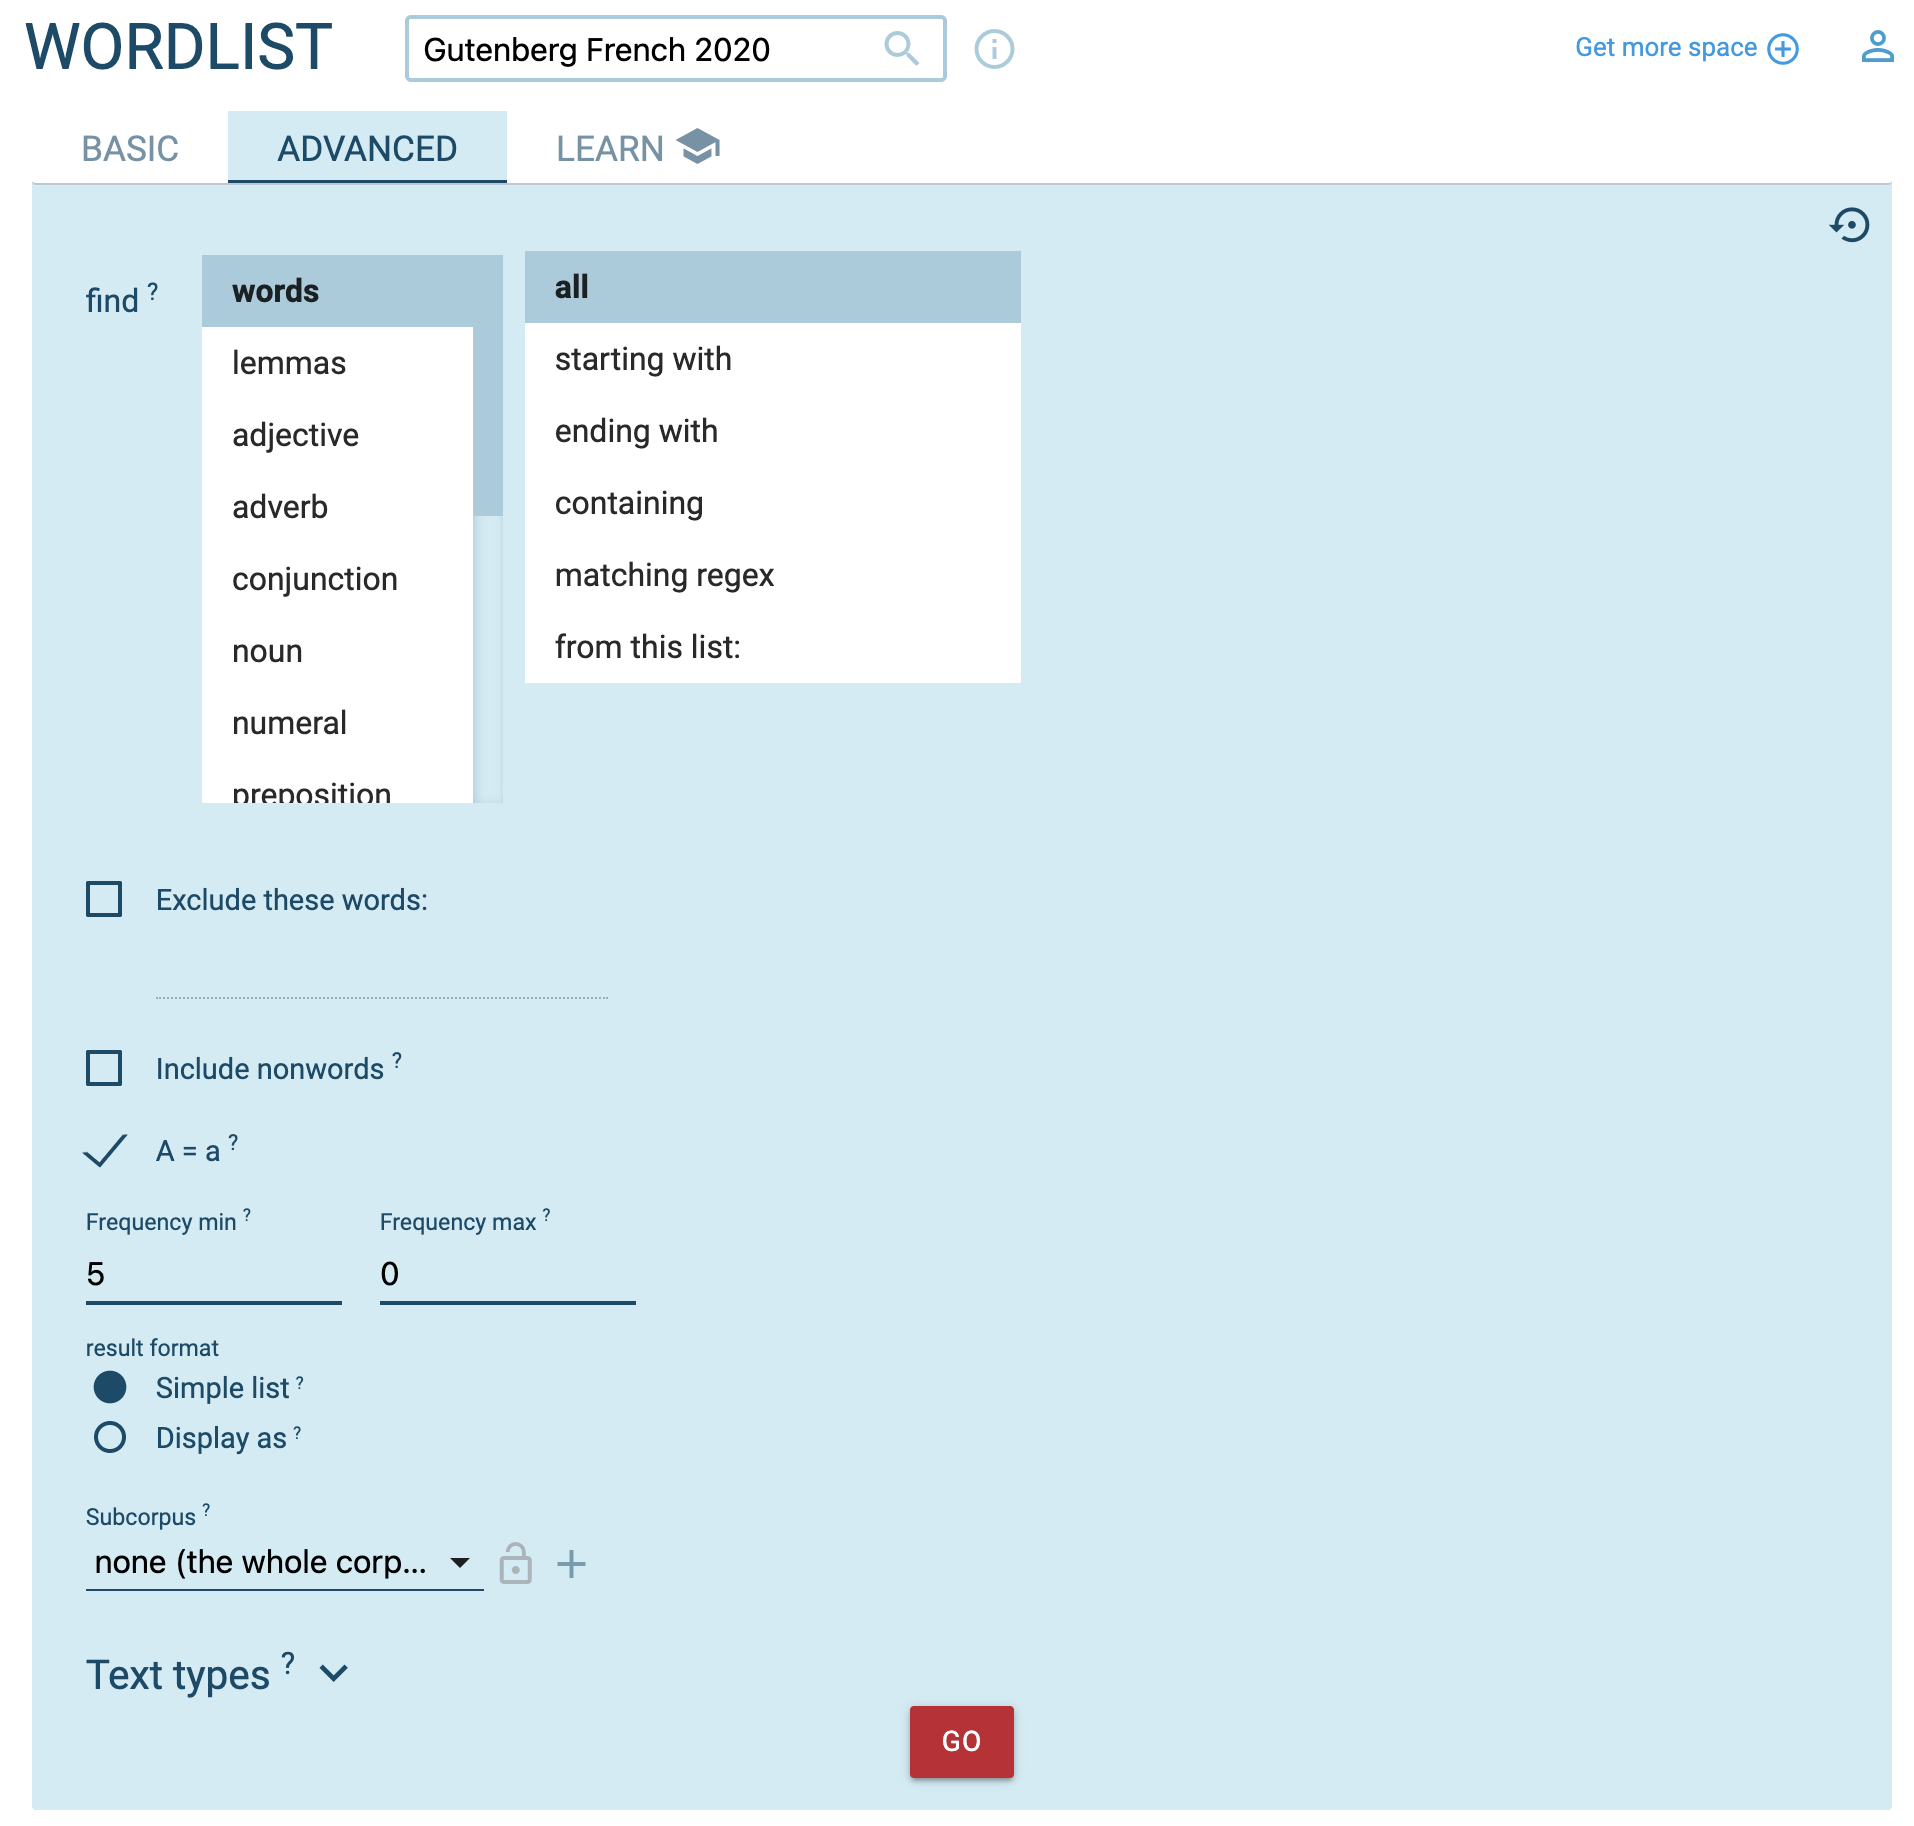
Figure 30. The Wordlist form. Figure 30. Le formulaire de Wordlist.
Page 6Page 6
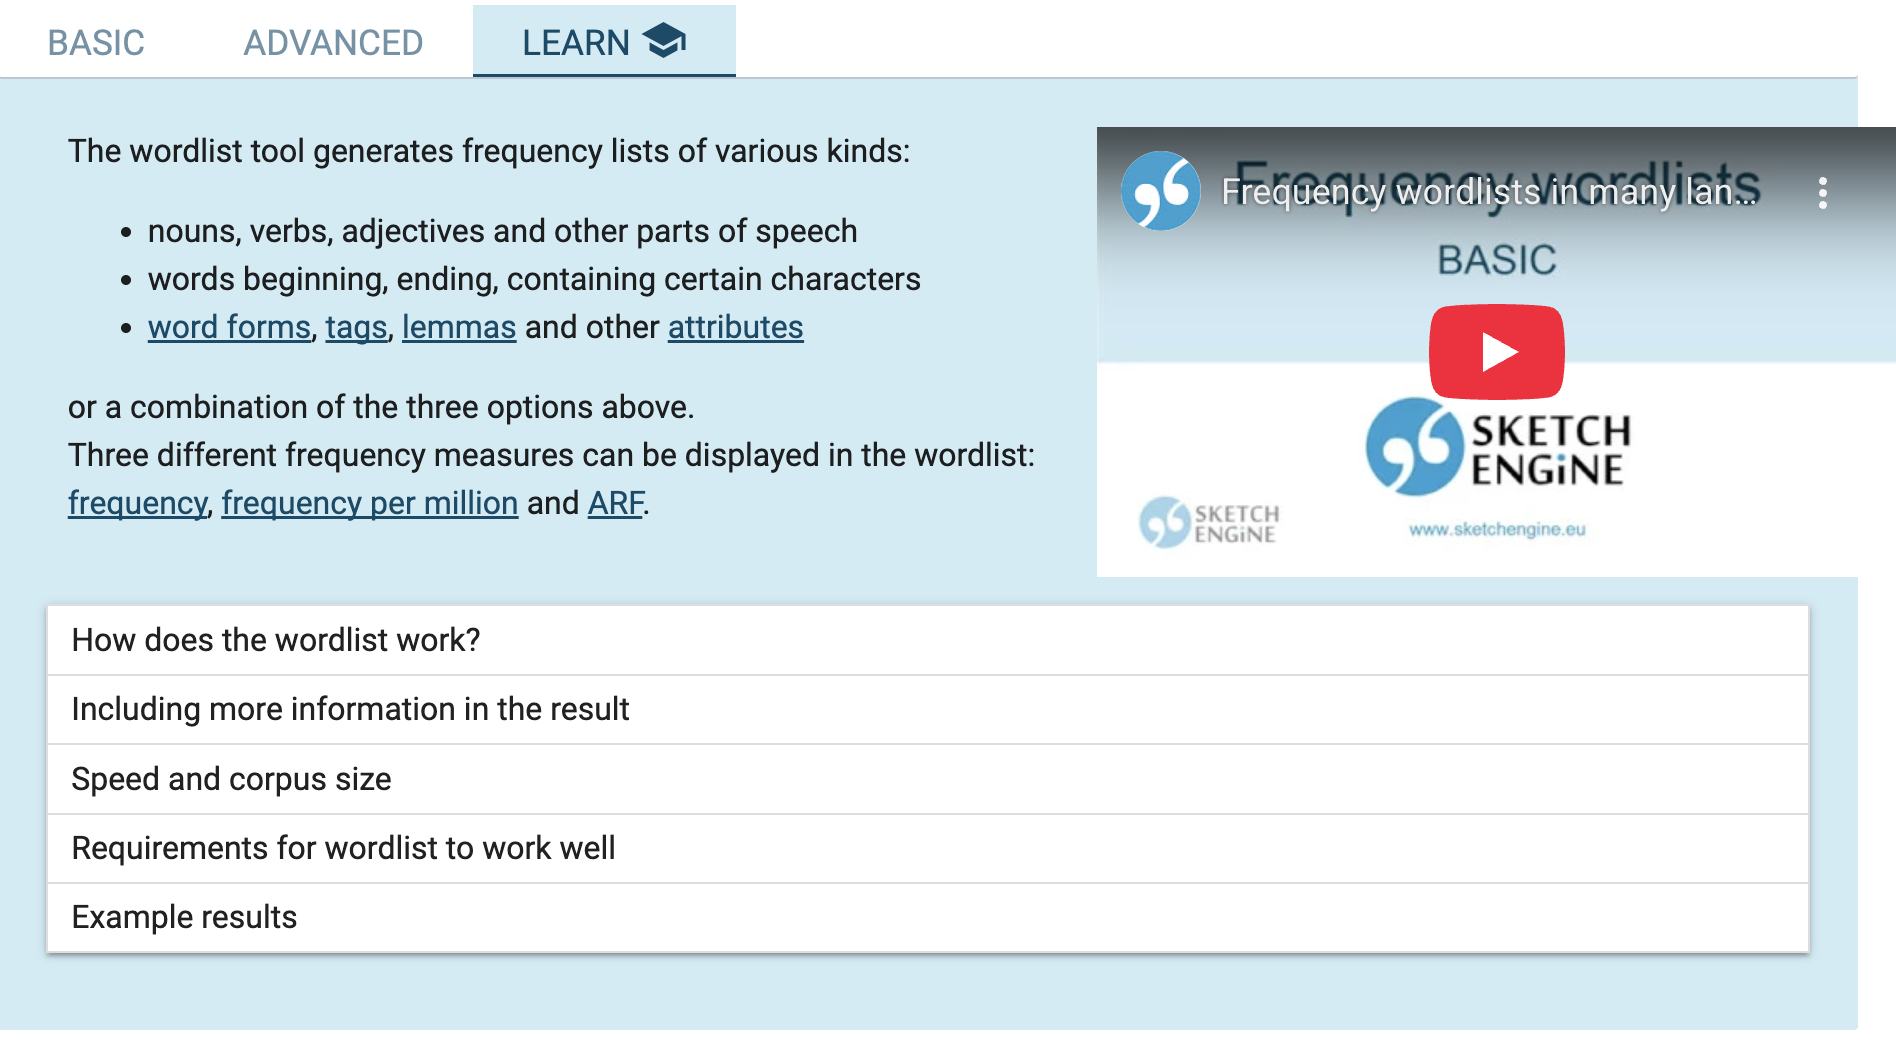
Figure 31. The LEARN tab: the built-in documentation of Wordlist. Figure 31. L'onglet LEARN : la documentation intégrée de Wordlist.
Page 6Page 6
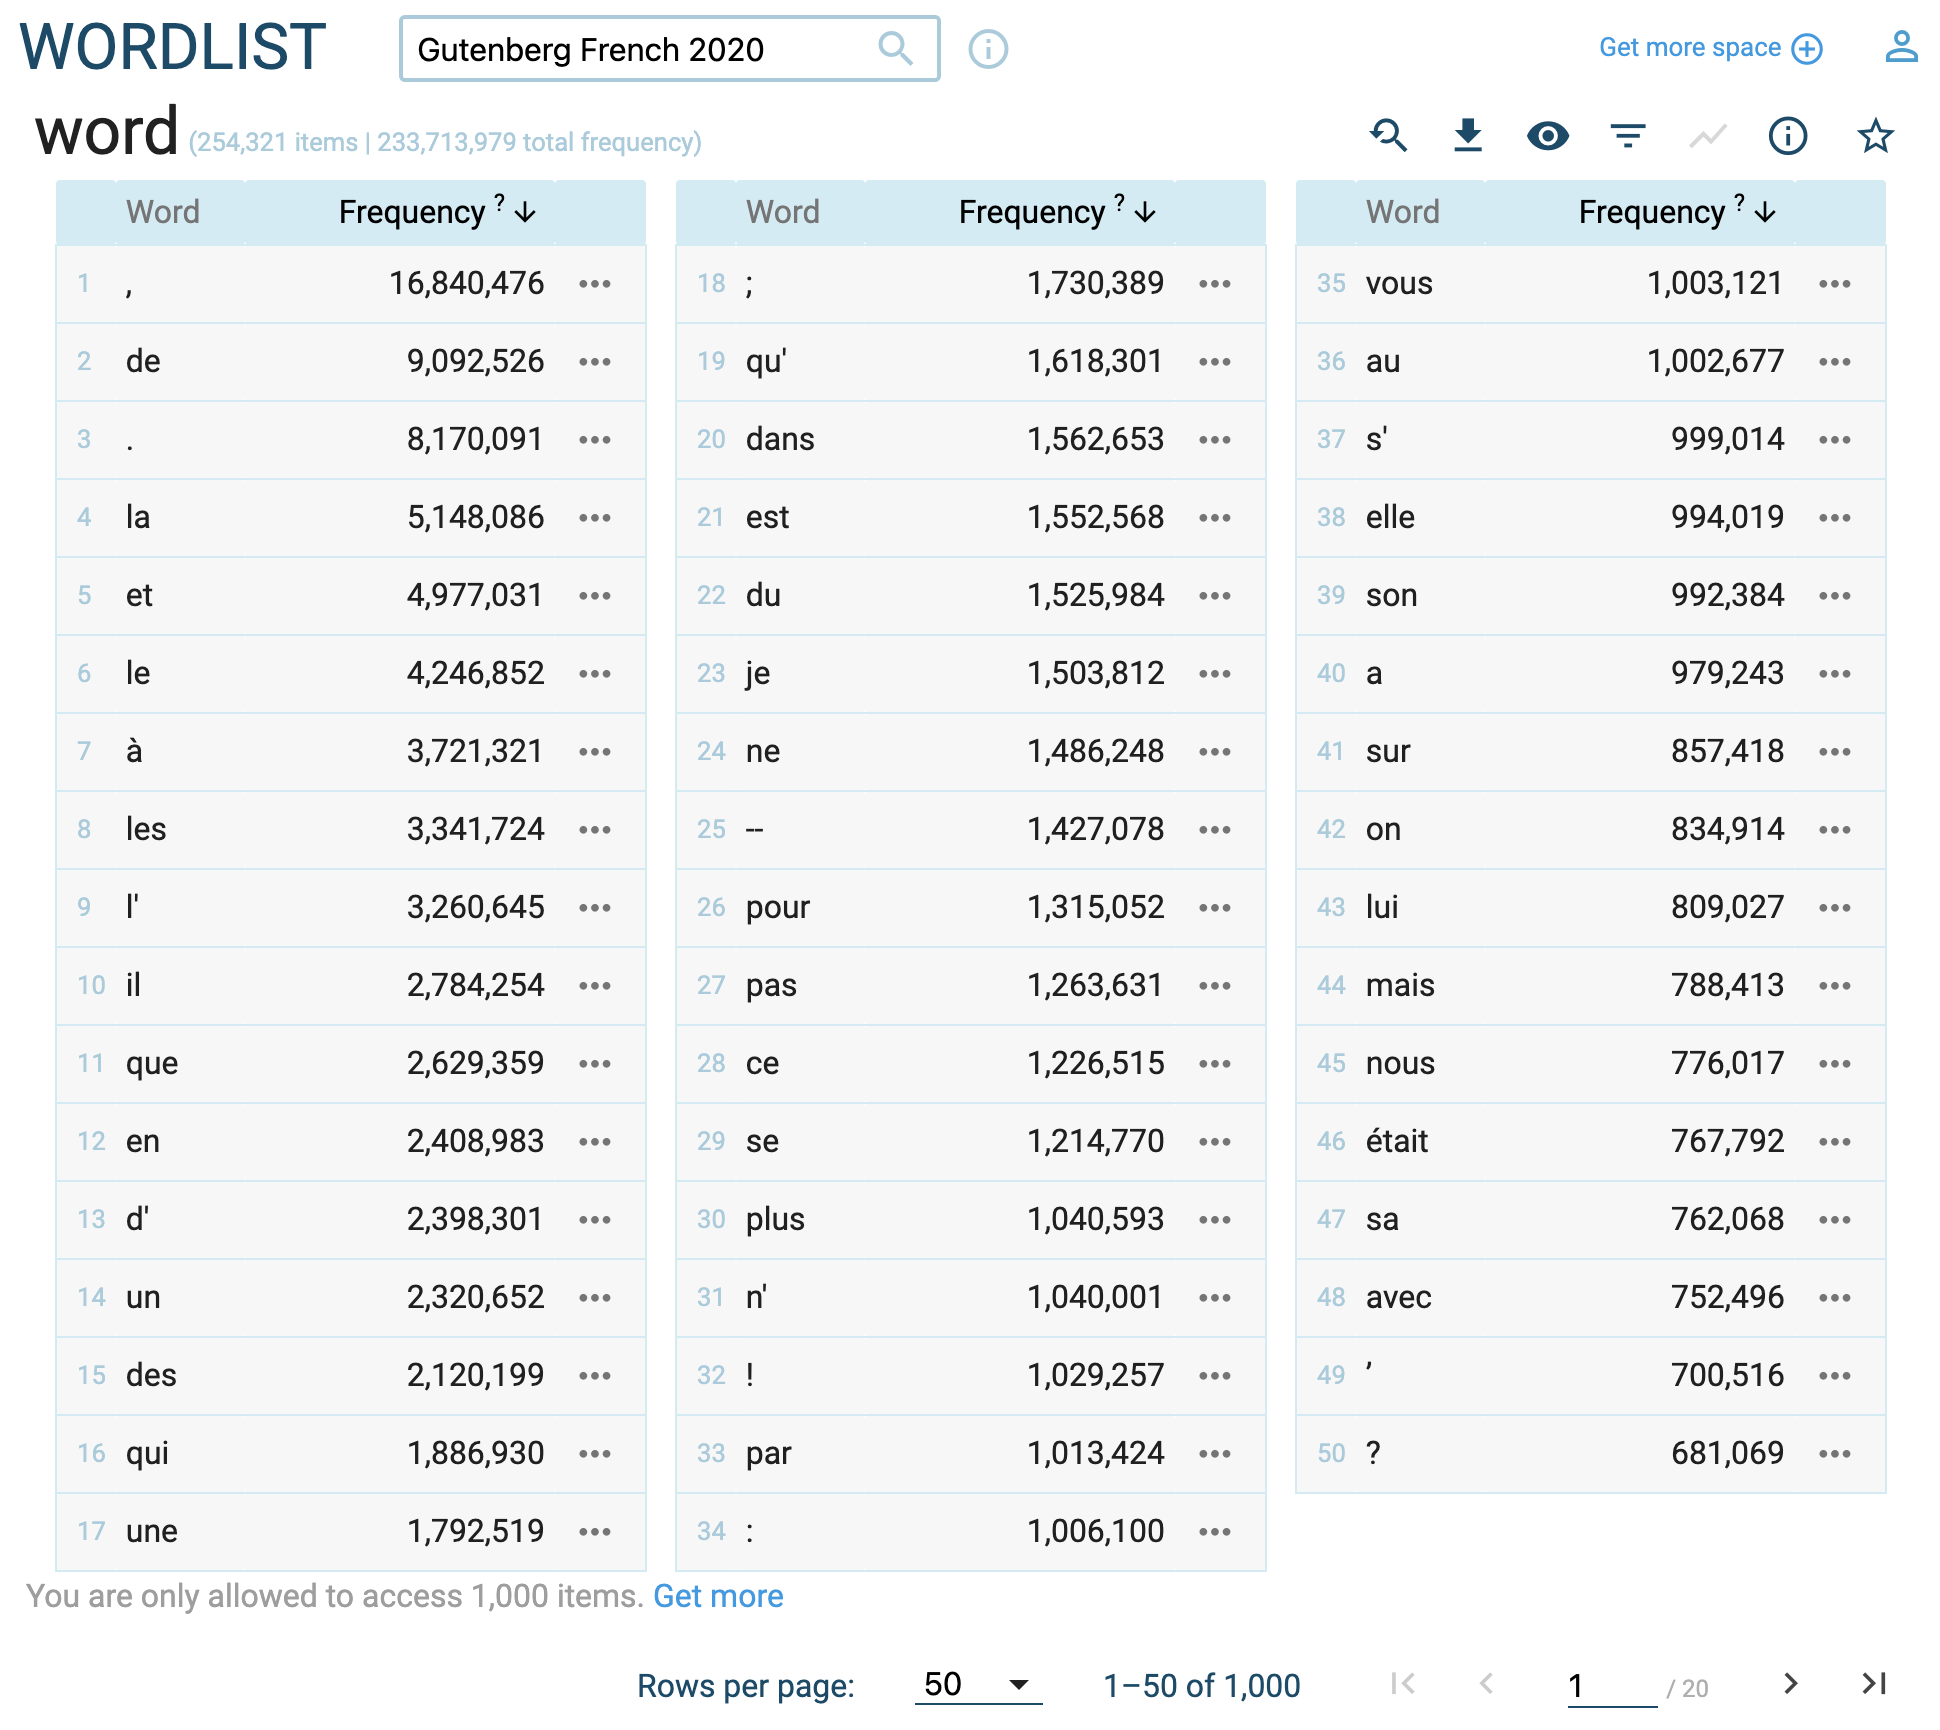
Figure 32. The results: every word of the corpus, sorted by frequency. Figure 32. Les résultats : tous les mots du corpus, triés par fréquence.
Page 6Page 6
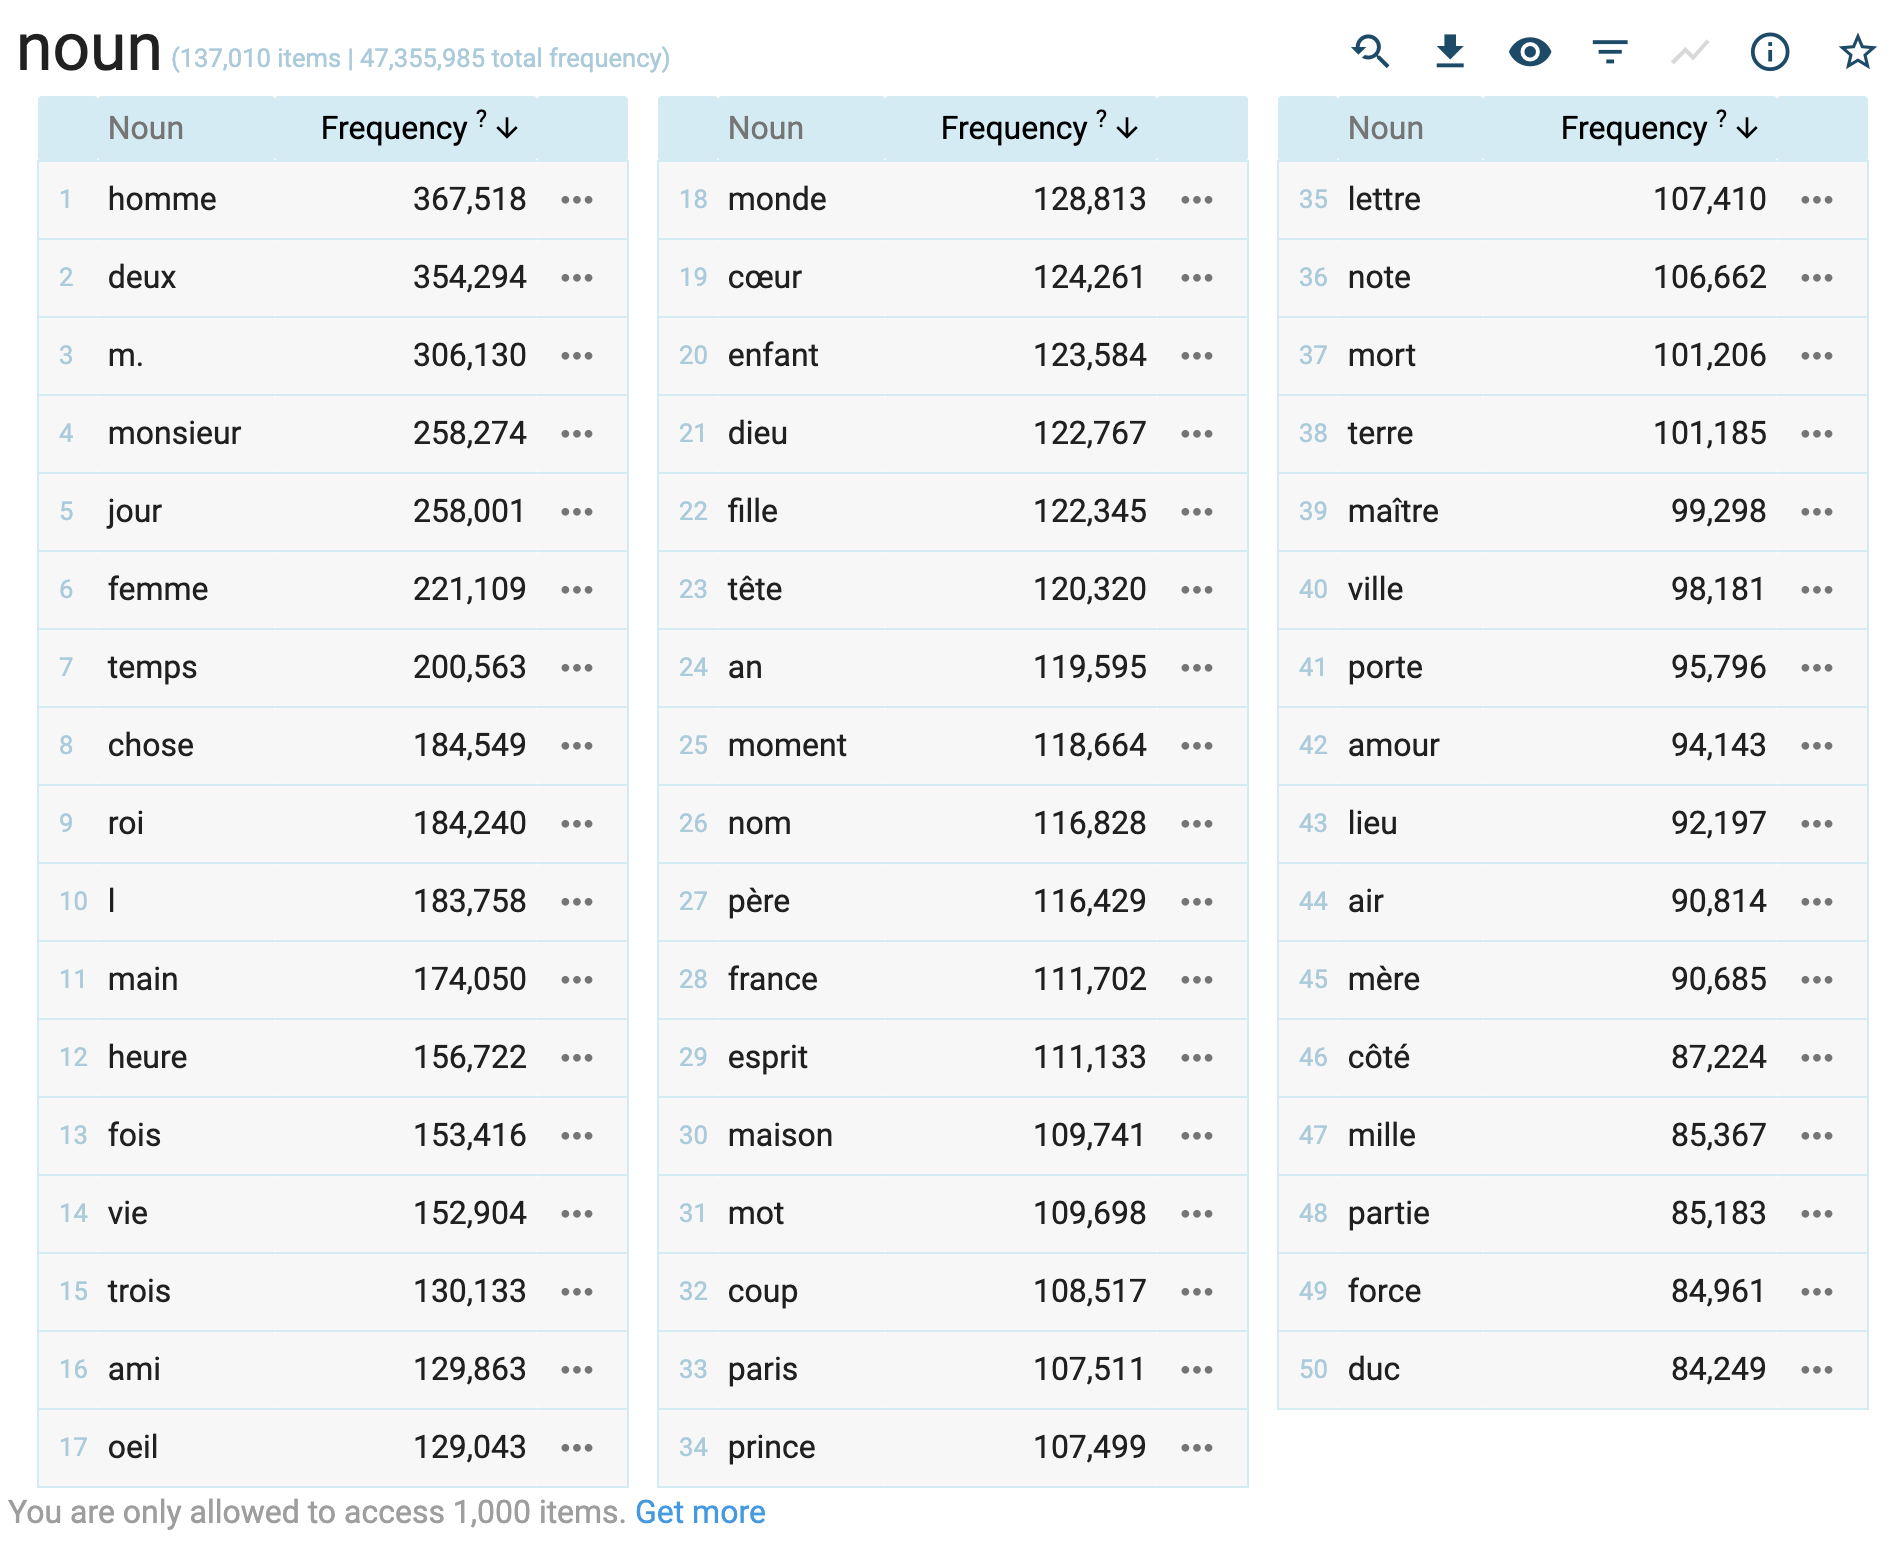
Figure 33. The most frequent nouns of the corpus. Figure 33. Les noms les plus fréquents du corpus.
Page 6Page 6
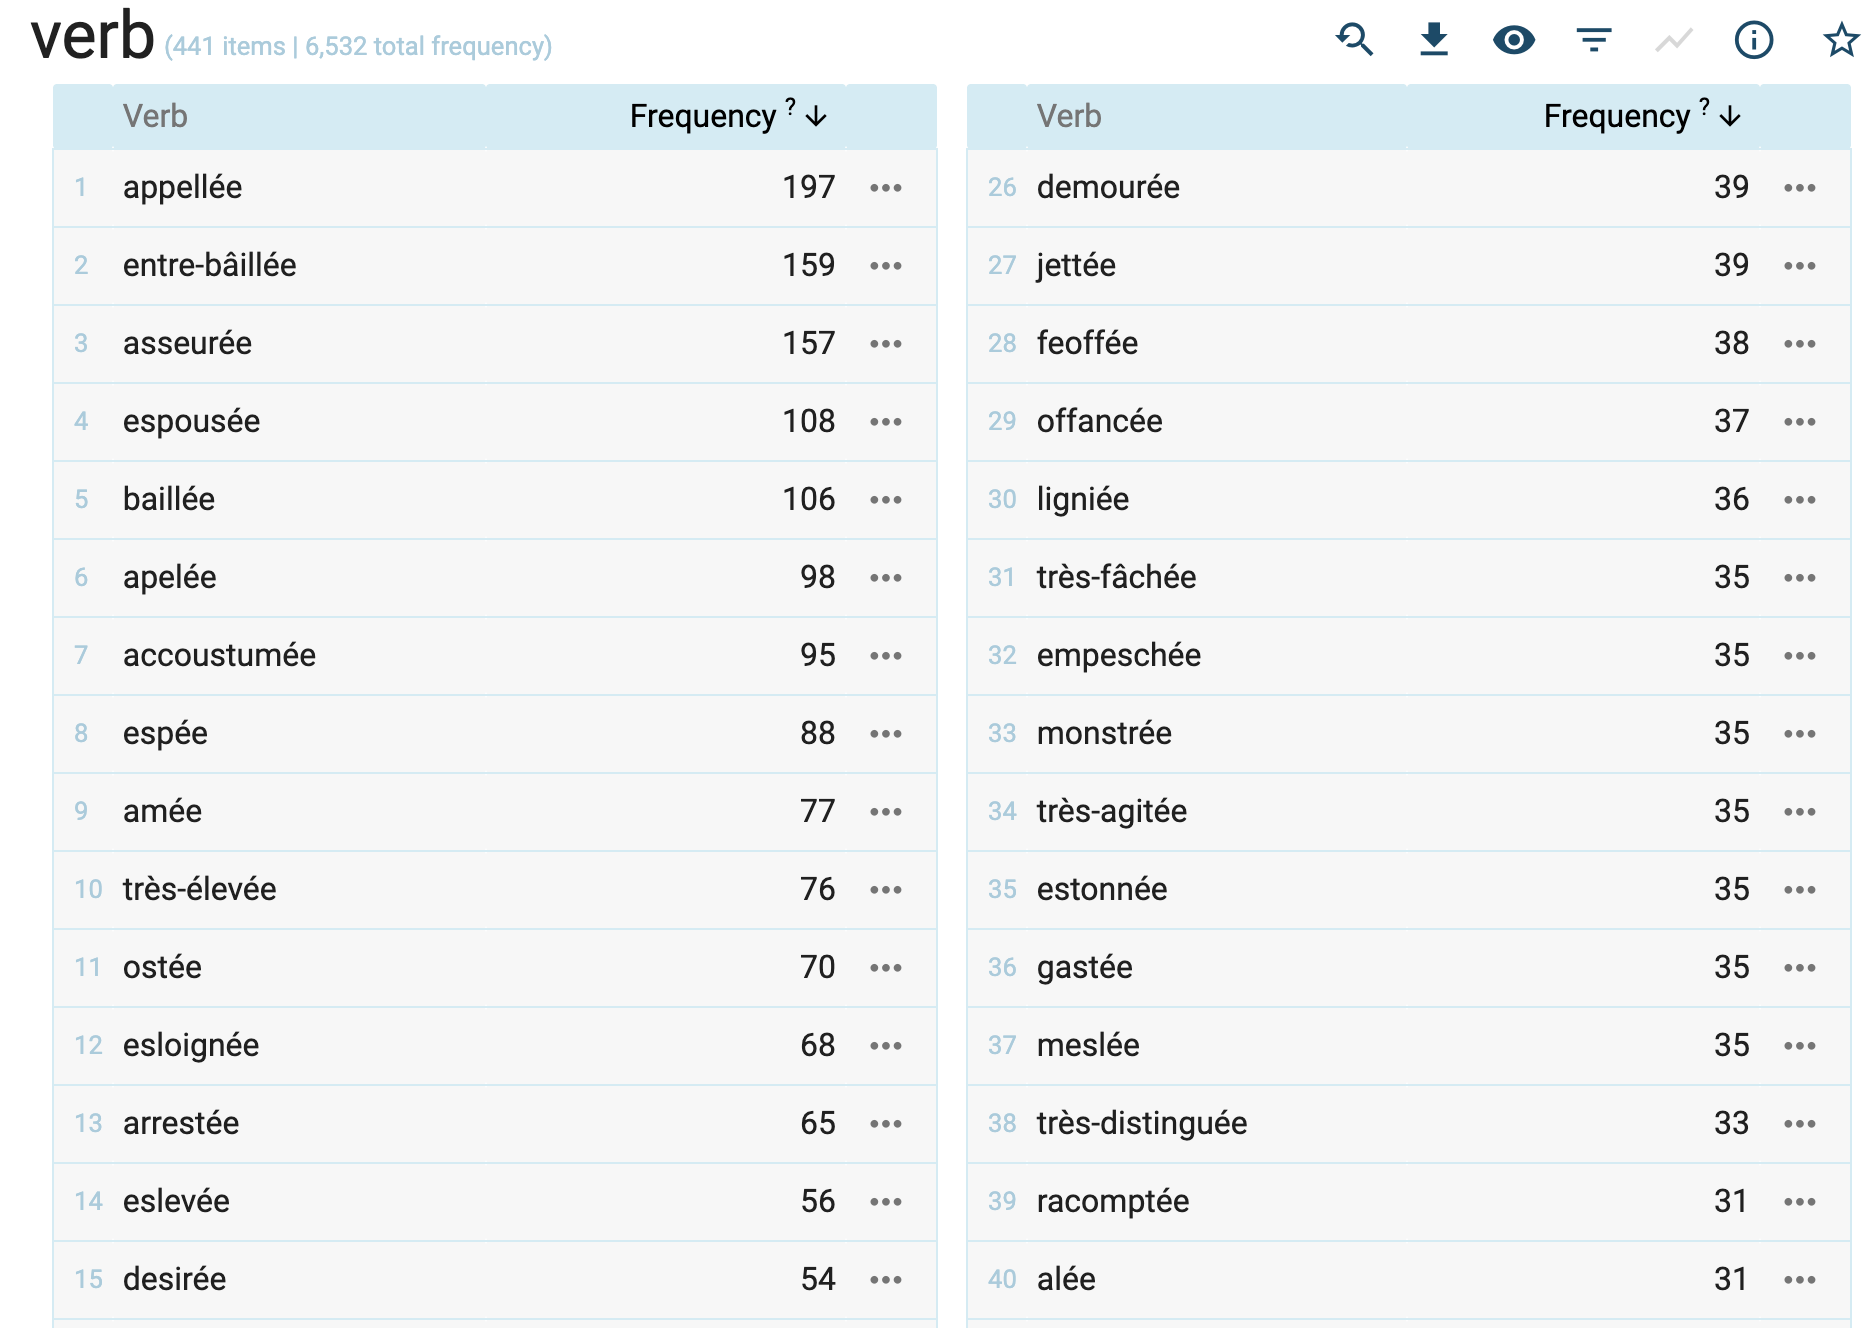
Figure 34. The most frequent verb forms in 'ée'. Figure 34. Les formes verbales en « ée » les plus fréquentes.
Page 6Page 6
Figure 35. The advanced options of Wordlist. Figure 35. Les options avancées de Wordlist.
Page 7Page 7
Absolute and relative frequenciesFréquences absolues et relatives
Absolute frequency counts occurrences; it depends on the size of the corpus and does not compare from one corpus to another.
Relative frequency normalizes it, usually per million words: that is the one that allows comparison.
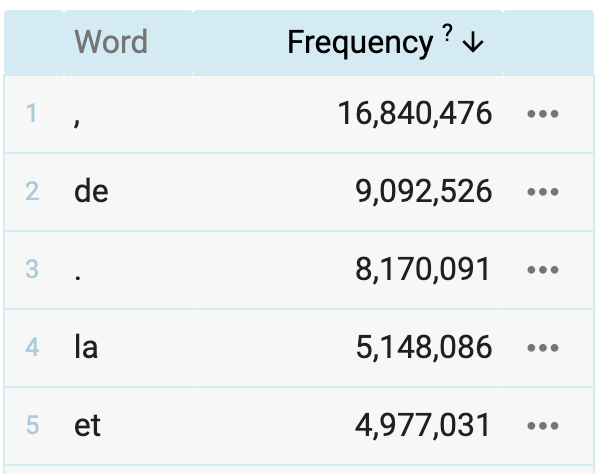
Sketch Engine shows both: "Frequency" and "per million".
La fréquence absolue compte les occurrences ; elle dépend de la taille du corpus et ne se compare pas d'un corpus à l'autre.
La fréquence relative la normalise, d'habitude par million de mots : c'est elle qui permet de comparer.
Sketch Engine affiche les deux : « Frequency » et « per million ».
Page 7Page 7
Figure 36. The top 5 of the Gutenberg French 2020 corpus. Figure 36. Le top 5 du corpus Gutenberg French 2020.
Page 8Page 8
ConcordancesLes concordances
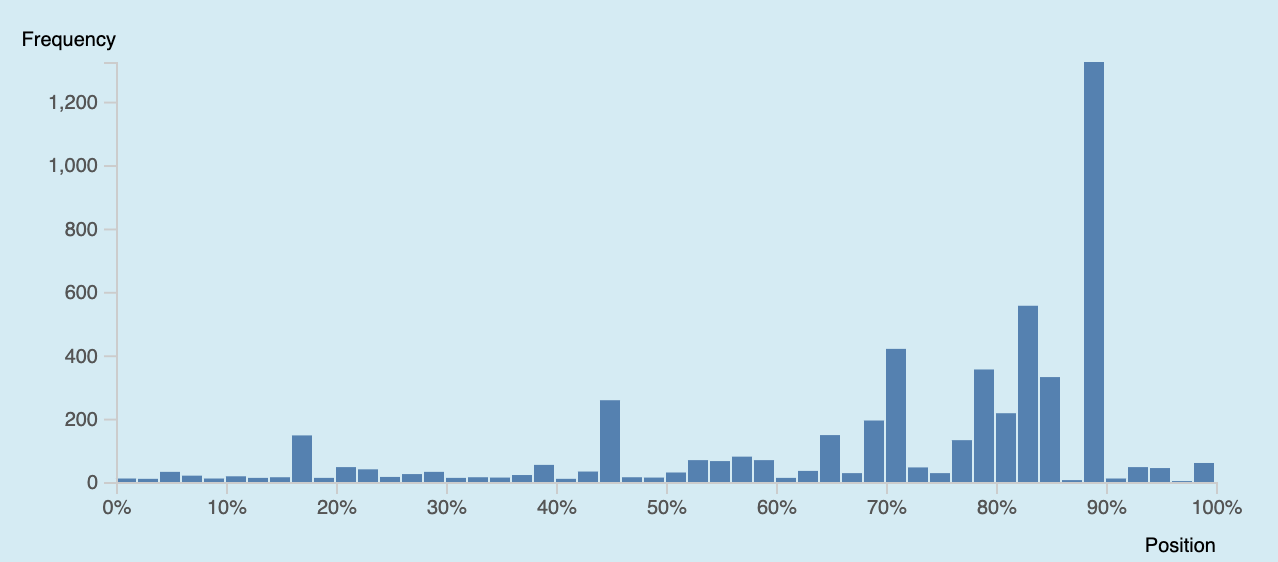
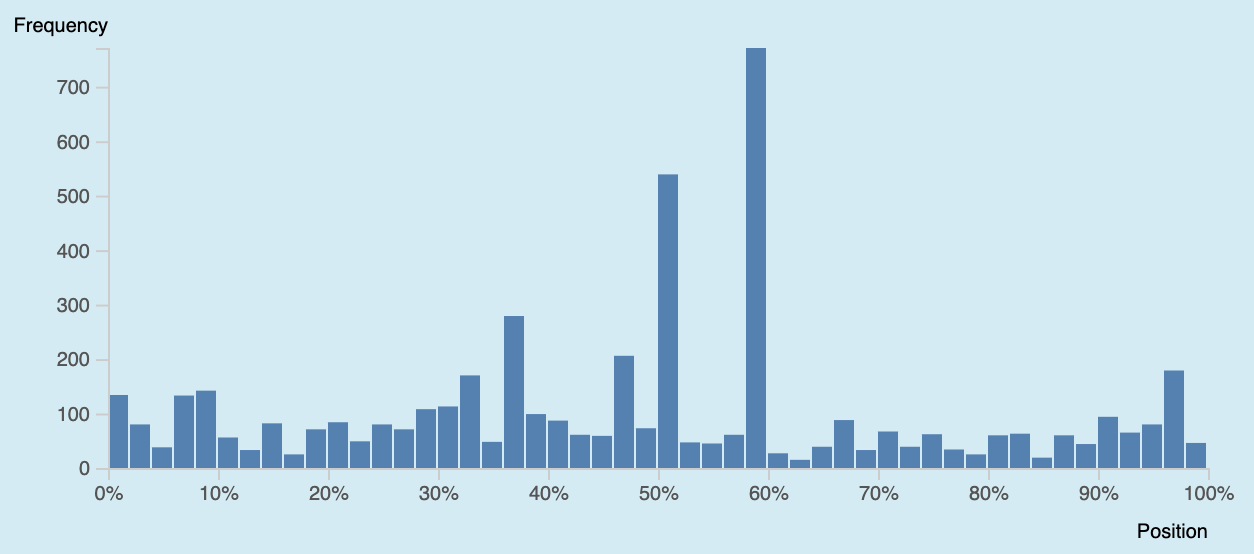
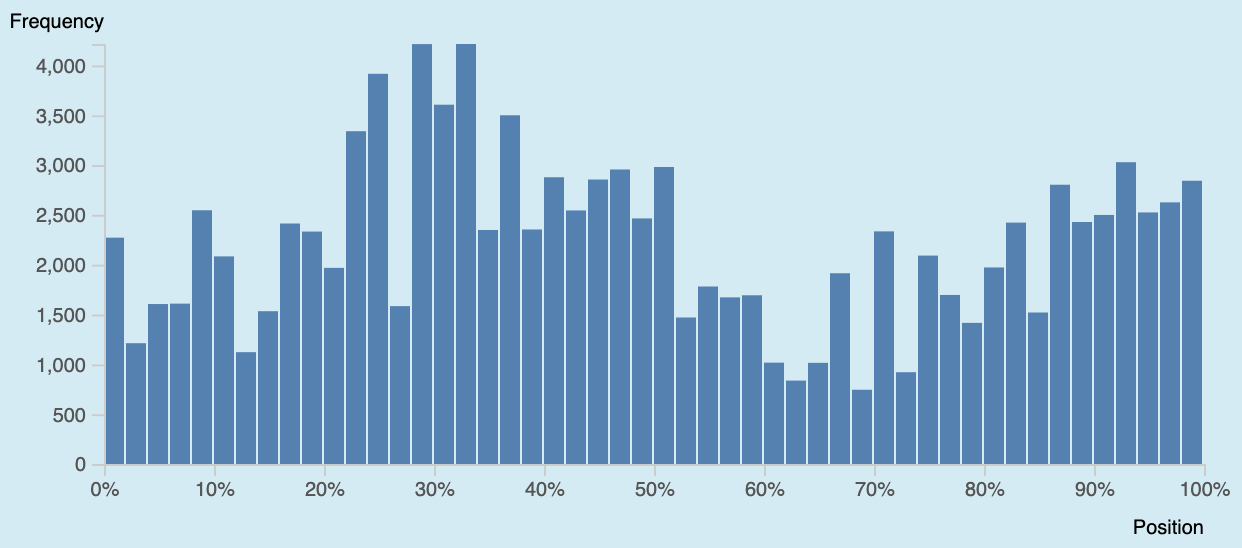
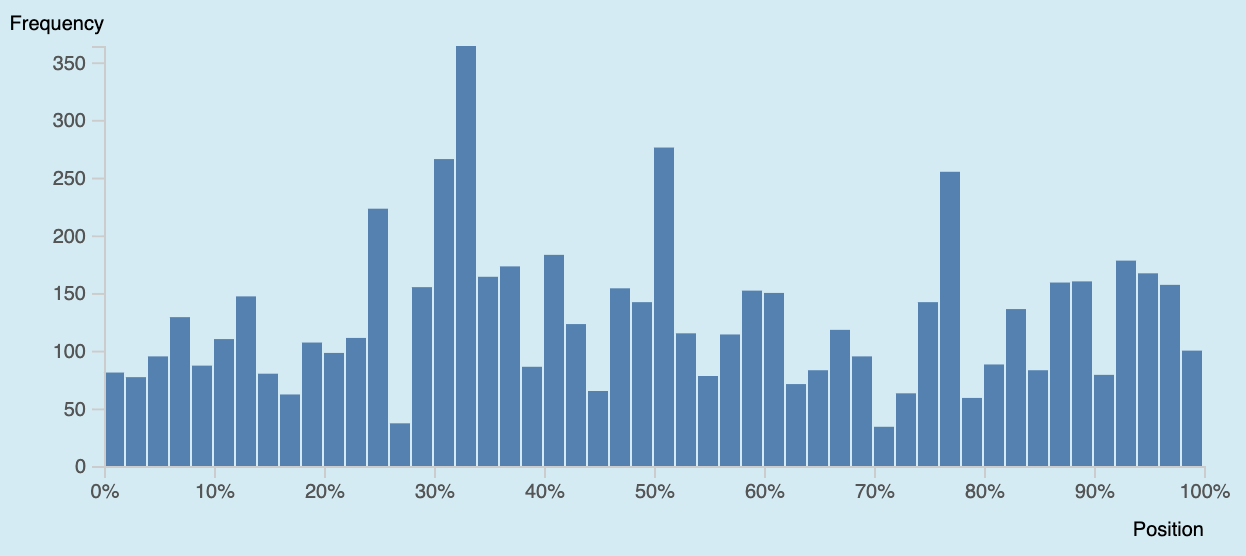
A shows every occurrence of a word with its immediate context (the KWIC format), so instead of counting how often a word appears you see how it is used.
From a concordance, Sketch Engine also computes , good example sentences (GDEX) and the distribution of the word across the corpus.
La affiche chaque occurrence d'un mot avec son contexte immédiat (format KWIC) : au lieu de compter combien de fois un mot apparaît, on voit comment il s'emploie.
Depuis une concordance, Sketch Engine calcule aussi les , de bonnes phrases d'exemple (GDEX) et la distribution du mot dans le corpus.
concordance · fr: concordance concordance · en : concordance corporacorpus : A display of all occurrences of a word or expression in a corpus, each shown with its surrounding context, typically one occurrence per line with the search word aligned in the middle (the key word in context, or KWIC, format).Affichage de toutes les occurrences d'un mot ou d'une expression dans un corpus, chacune accompagnée de son contexte immédiat, généralement une occurrence par ligne avec le mot cherché aligné au centre (format KWIC, mot-clé en contexte).
collocation · fr: collocation collocation · en : collocation corporacorpus : A combination of words that co-occur more often than chance would predict and form a habitual, semi-fixed pairing, such as heavy rain or commit a crime (rather than strong rain or do a crime).Combinaison de mots qui apparaissent ensemble plus souvent que le hasard ne le laisserait prévoir et qui forment une association habituelle, semi-figée, comme soleil de plomb ou commettre un crime (plutôt que faire un crime).
Page 8Page 8
Figure 37. Distribution A. Figure 37. Distribution A.
Page 8Page 8
Figure 38. Distribution B. Figure 38. Distribution B.
Page 8Page 8
Figure 39. Distribution C. Figure 39. Distribution C.
Page 8Page 8
Figure 40. Distribution D. Figure 40. Distribution D.
Page 9Page 9
Word Sketch and Word Sketch DifferenceWord Sketch et Word Sketch Difference
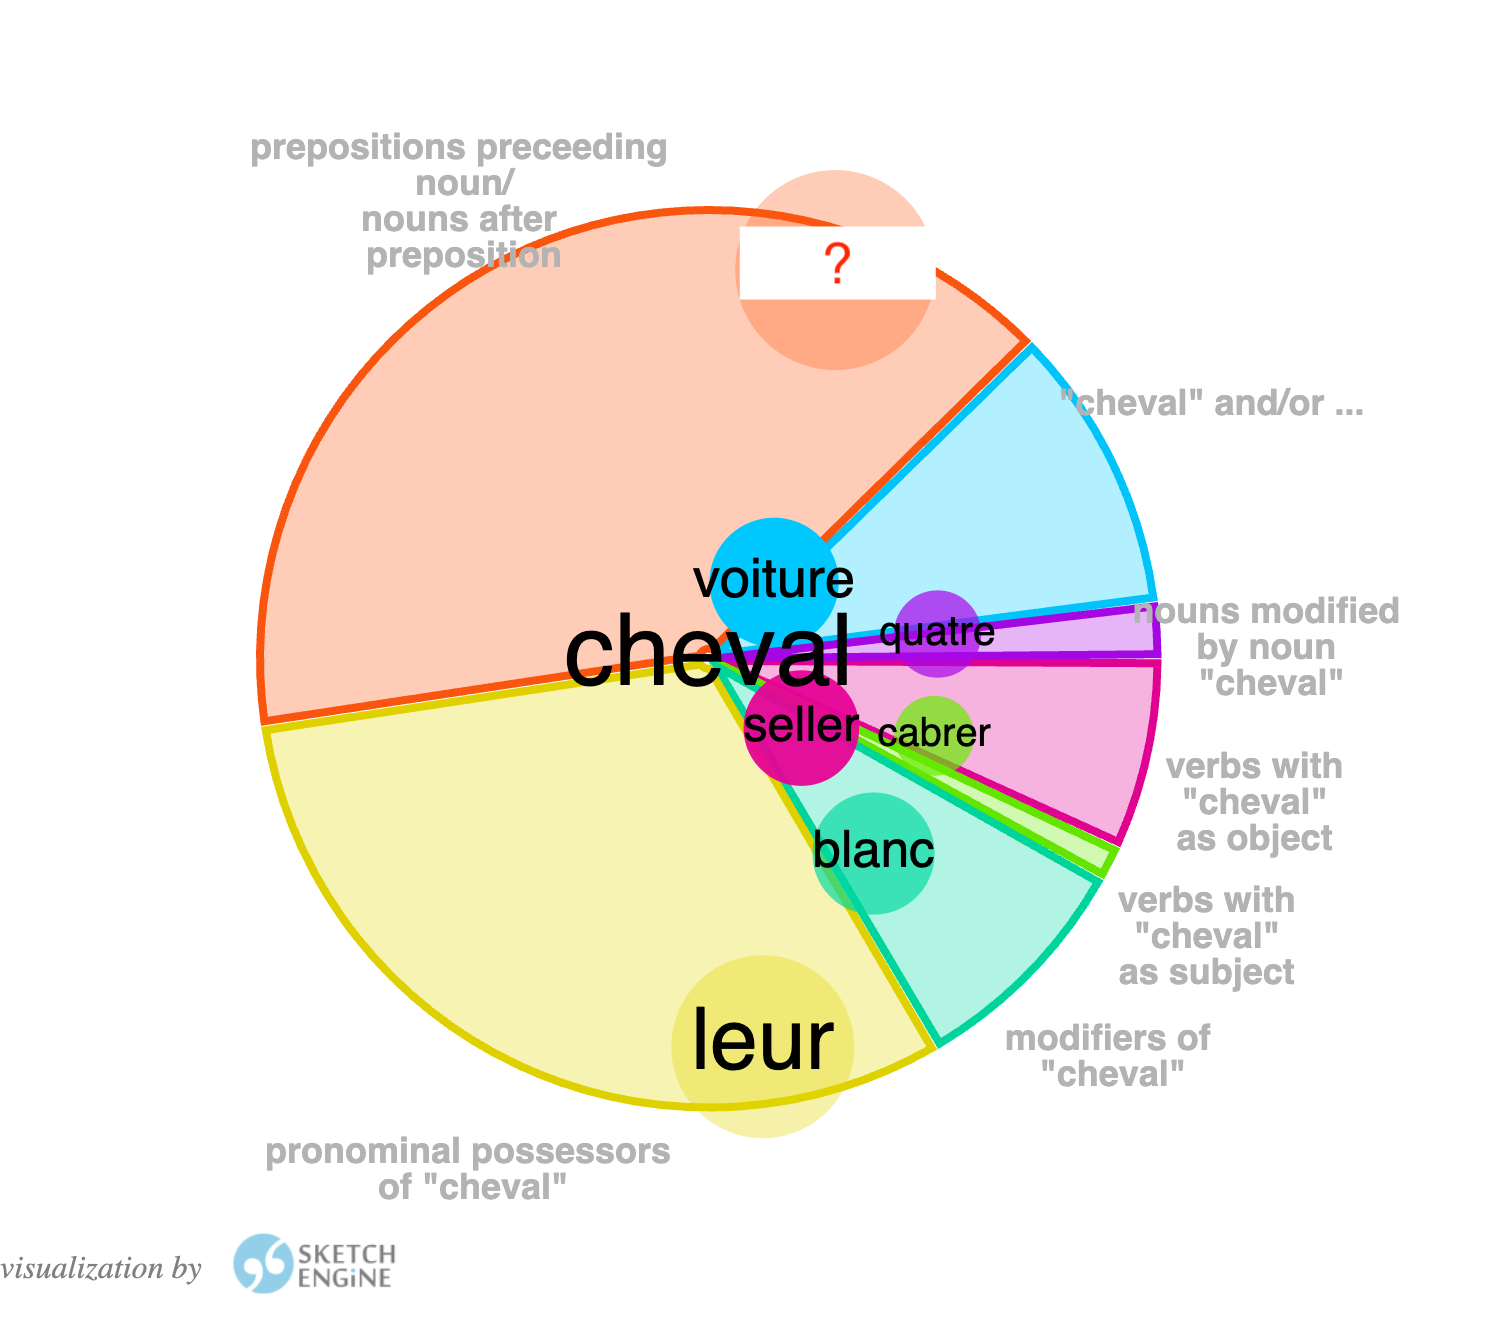
Word Sketch draws the profile of a word: its , grouped by grammatical relation.
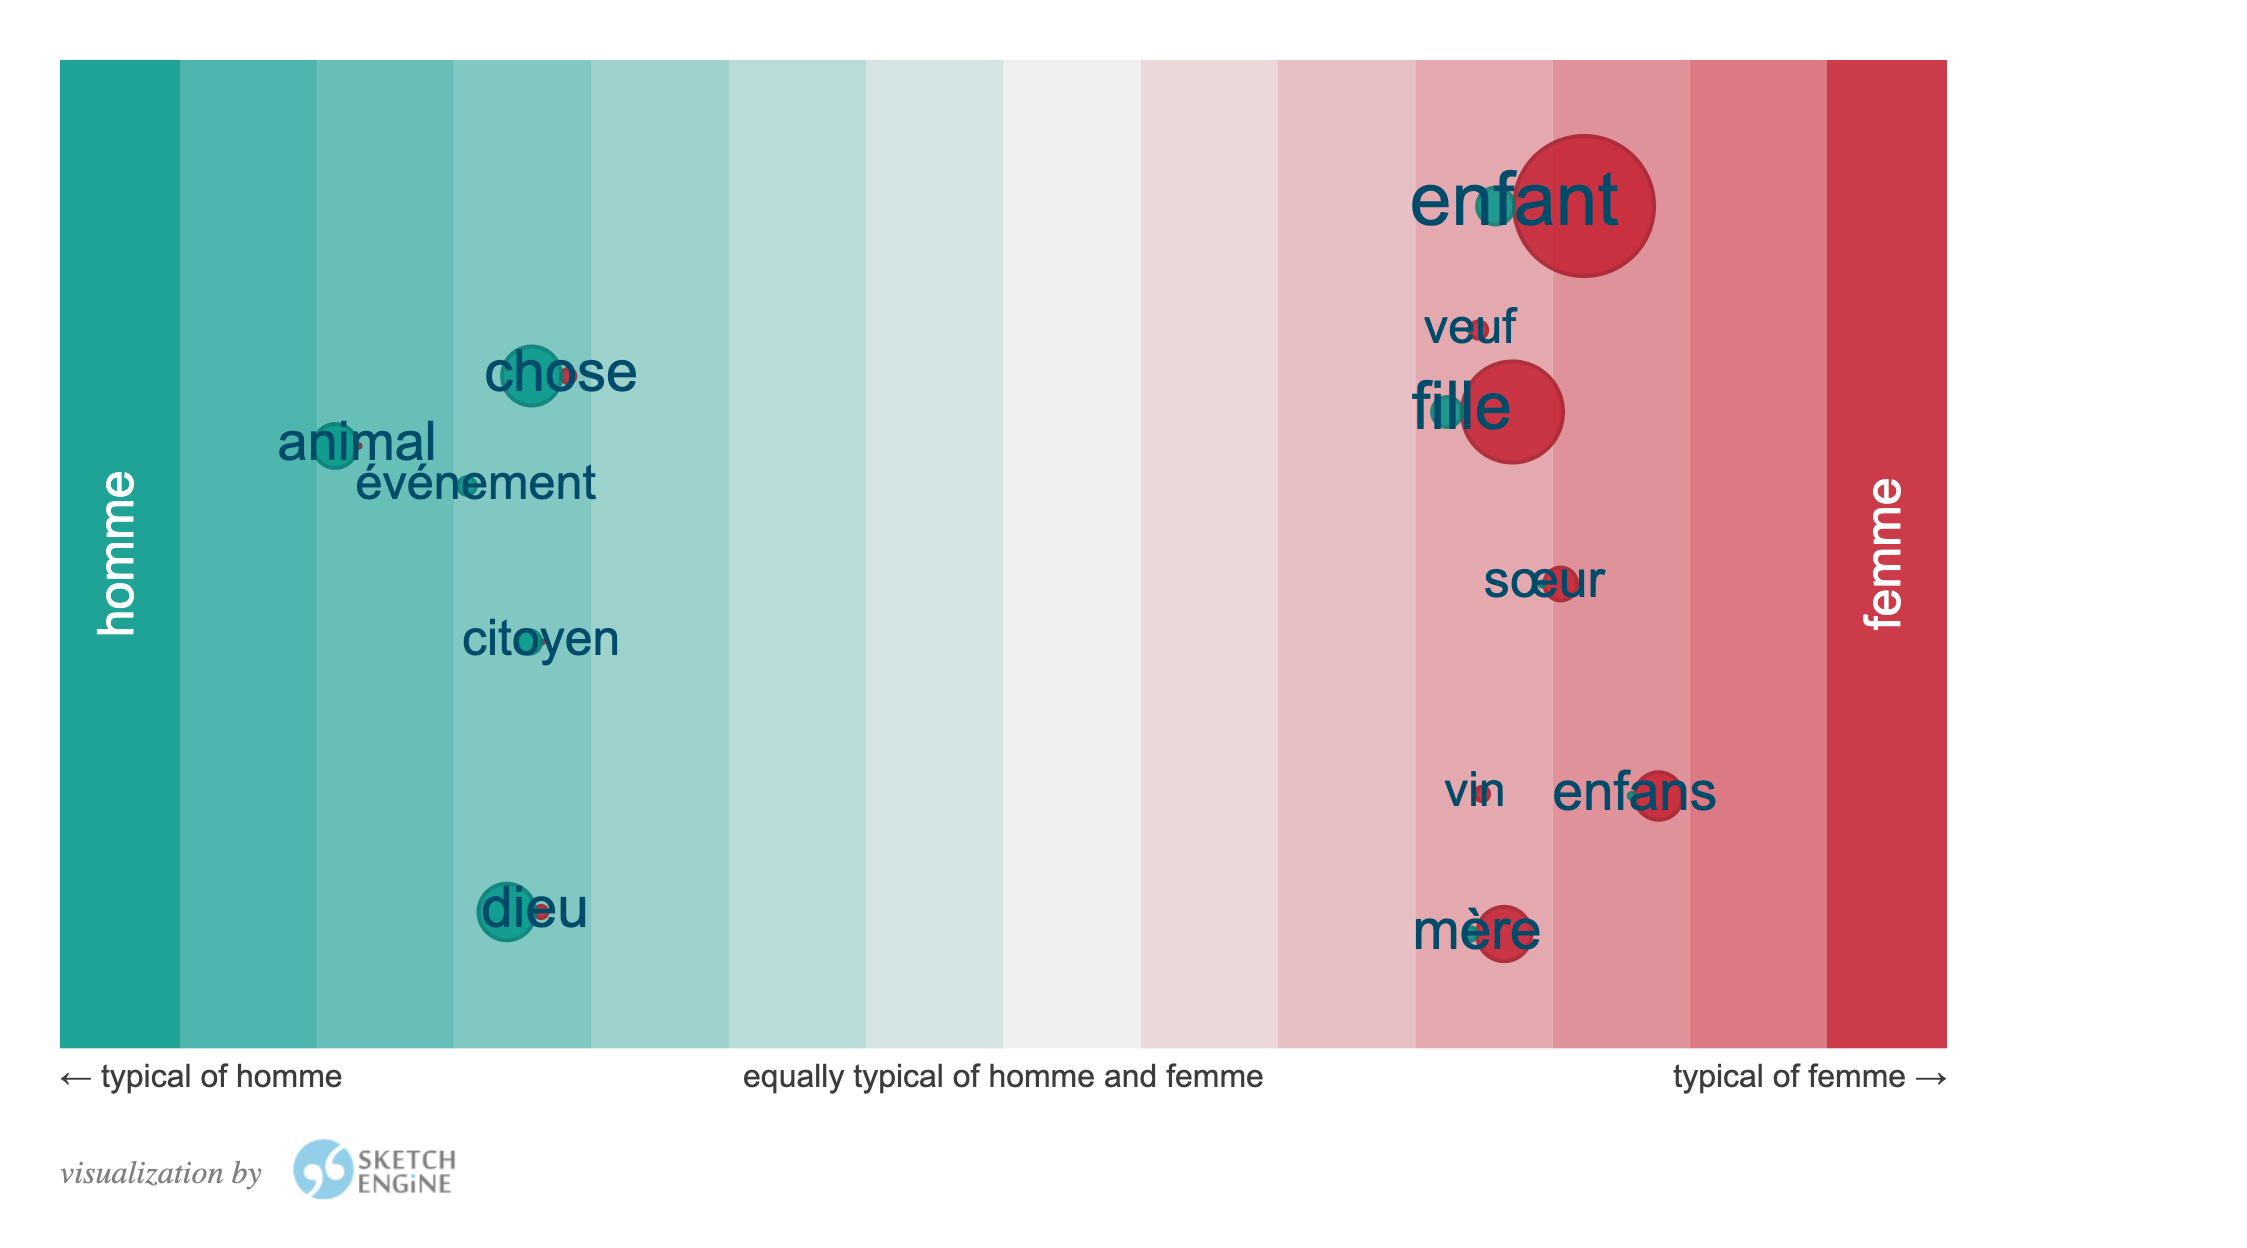
Word Sketch Difference compares two close words and shows the collocates specific to each.
In translation, they help you choose between near-synonyms and find the collocations a target-language reader expects.
Word Sketch dresse le portrait d'un mot : ses , regroupées par relation grammaticale.
Word Sketch Difference compare deux mots proches et montre les collocatifs propres à chacun.
En traduction, ils aident à choisir entre des quasi-synonymes et à trouver les collocations qu'attend un lecteur de la langue cible.
collocation · fr: collocation collocation · en : collocation corporacorpus : A combination of words that co-occur more often than chance would predict and form a habitual, semi-fixed pairing, such as heavy rain or commit a crime (rather than strong rain or do a crime).Combinaison de mots qui apparaissent ensemble plus souvent que le hasard ne le laisserait prévoir et qui forment une association habituelle, semi-figée, comme soleil de plomb ou commettre un crime (plutôt que faire un crime).
Page 9Page 9
Figure 41. Word Sketch Difference between 'homme' and 'femme'. The layout is partly random, so the same query does not draw the same picture twice. Figure 41. Word Sketch Difference entre « homme » et « femme ». La disposition est en partie aléatoire : la même requête ne dessine pas deux fois la même image.
Page 9Page 9
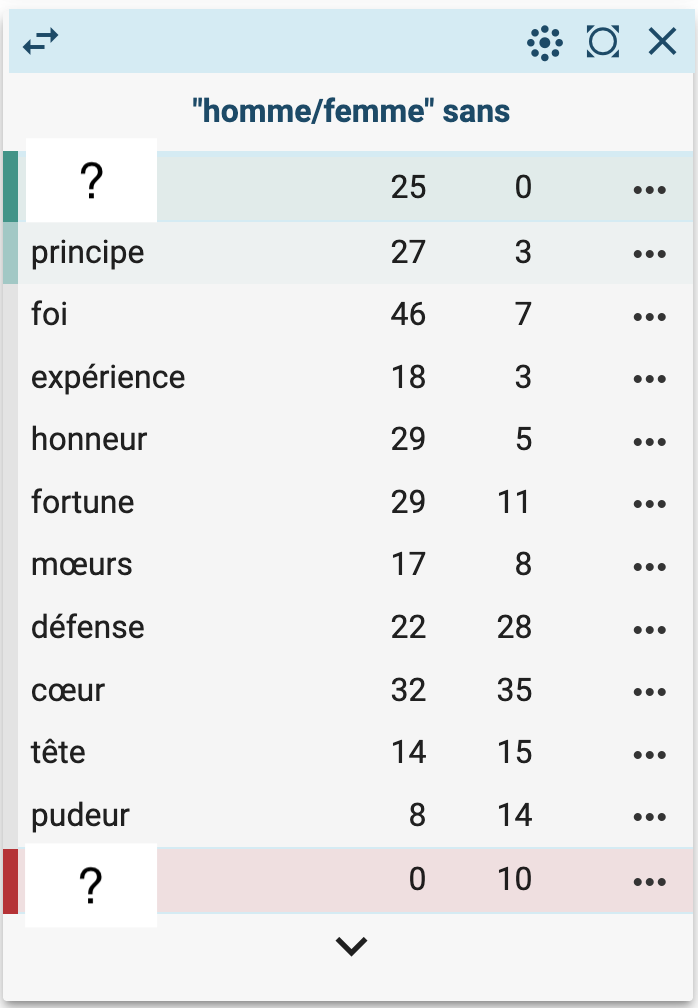
Figure 42. The 'sans' relation for 'homme' against 'femme': each row gives the count with 'homme', then with 'femme'. The row at each end is masked. Figure 42. La relation « sans » pour « homme » contre « femme » : chaque ligne donne le compte avec « homme », puis avec « femme ». La ligne située à chaque extrémité est masquée.
Page 9Page 9
Figure 43. The Word Sketch of 'cheval' drawn as a wheel, one sector per grammatical relation. The top preposition is masked. Figure 43. Le Word Sketch de « cheval » dessiné en roue, un secteur par relation grammaticale. La première préposition est masquée.
Page 10Page 10
Going furtherPour aller plus loin
You have used four functions: frequency lists, , collocations and Word Sketch.
Three more are worth knowing about: , the keywords of a corpus, and structured queries in CQL.
Vous avez utilisé quatre fonctions : listes de fréquences, , collocations et Word Sketch.
Trois autres valent la peine d'être connues : les , les mots-clés d'un corpus et les requêtes structurées en CQL.
concordance · fr: concordance concordance · en : concordance corporacorpus : A display of all occurrences of a word or expression in a corpus, each shown with its surrounding context, typically one occurrence per line with the search word aligned in the middle (the key word in context, or KWIC, format).Affichage de toutes les occurrences d'un mot ou d'une expression dans un corpus, chacune accompagnée de son contexte immédiat, généralement une occurrence par ligne avec le mot cherché aligné au centre (format KWIC, mot-clé en contexte).
n-gram · fr: n-gramme n-gramme · en : n-gram corporacorpus : A sequence of n consecutive items from a text, usually words: bigrams (n = 2), trigrams (n = 3), and so on.Suite de n éléments consécutifs d'un texte, généralement des mots : bigrammes (n = 2), trigrammes (n = 3), etc.
The page behind this slideLa page derrière cette diapositive
1 / 58The browser blocked the window. Allow pop-ups for this site, then try again.Le navigateur a bloqué la fenêtre. Autorisez les fenêtres surgissantes pour ce site, puis réessayez.ExitQuitter