TRA2600 · Bloc 1 · TAO (séances 1 à 4, examen à la séance 6)TRA2600 · Bloc 1 · TAO (séances 1 à 4, examen à la séance 6)
Semaine 1 · séance 1 · mercredi 2 September 2026Semaine 1 · séance 1 · mercredi 2 septembre 2026
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Translation memoriesLes mémoires de traduction
What a translation memory isQu'est-ce qu'une mémoire de traduction
Une phrase qui revient
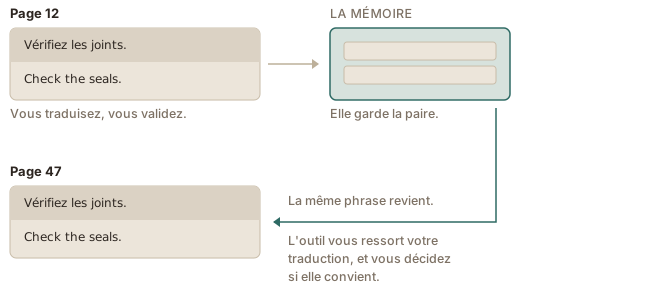
Vous traduisez un manuel d’entretien de pompes. À la page 12, vous traduisez
« Vérifiez les joints après le premier essai. » À la page 47, la même phrase
revient, mot pour mot. Sans outil, vous la retraduisez, probablement un peu
autrement, et le manuel dit deux choses là où il devrait en dire une.
Avec un outil de TAO, c’est vous qui travaillez autrement. Quand vous avez
validé votre traduction à la page 12, l’outil l’a gardée. À la page 47, il vous
la repropose, et vous décidez si elle convient.
Figure 1. Ce que vous validez à la page 12 revient à la page 47.
Ce qu’elle contient
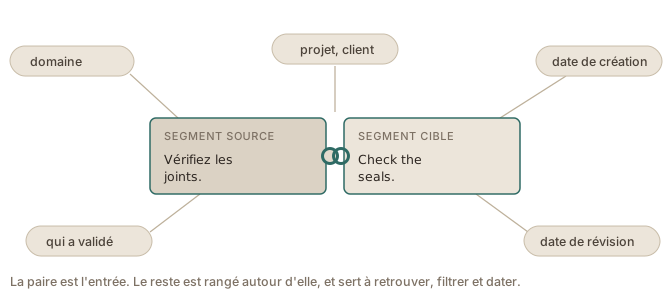
Une paire par entrée : une phrase dans la langue source, sa traduction dans la
langue cible. C’est tout. Autour de chaque paire, l’outil range des
informations de service : la date, la personne qui a validé, le projet ou le
client, parfois le domaine.
Figure 2. Une entrée de mémoire : la paire, et les informations de service rangées autour d'elle.
La mémoire compare des suites de caractères. Elle mesure à quel point deux
phrases se ressemblent, sans savoir ce qu’elles disent.
« Vérifiez les joints après le premier essai » et « Vérifiez les joints
après le deuxième essai » : un seul mot change, et c’est celui qui porte
l’information. L’outil annonce une ressemblance très élevée.
« Vérifiez les joints après le premier essai » et « Après le premier
essai, vérifiez les joints » : même sens, mots déplacés. L’outil les trouve
assez différentes.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
Memory or machine translationMémoire ou traduction automatique
D’où vient le texte proposé
Quand vous traduisez dans un outil de TAO, et selon la façon dont il est
configuré, l’outil vous propose une traduction pour chaque phrase. Elle peut
venir de la mémoire, d’un système de traduction automatique, ou des deux.
D’où elle vient change ce qu’il faut y vérifier.
Ce que cela change en pratique
Mémoire de traduction
Traduction automatique
D’où vient la proposition
d’une traduction écrite et validée par une personne dans un projet antérieur
d’un système qui la calcule au moment où vous ouvrez la phrase
Devant une phrase que personne n’a encore traduite
rien : la case reste vide
une proposition quand même
Ce que l’outil vous indique sur la proposition
un pourcentage de ressemblance avec la phrase stockée
rien sur sa fiabilité
Si la même phrase revient deux fois
la même proposition
pas nécessairement la même
Ce qu’il faut faire de la proposition
la vérifier ; si elle ne convient pas, se demander s’il faut aussi corriger la mémoire
La mémoire vous rend le plus souvent une traduction correcte ailleurs,
déplacée ici : elle a trouvé une phrase source qui ressemble à la vôtre sans
dire la même chose. Ce qui est stocké n’est pas garanti juste pour autant :
une traduction validée par une personne peut être fautive, et la mémoire la
ressort telle quelle.
La traduction automatique produit une phrase qui ne vient d’aucune
traduction existante. Avec les systèmes actuels, sur une paire de langues
aussi bien outillée que l’anglais et le français et sur des textes courants,
ce qui reste d’erreurs se lit bien : il faut comparer à la source pour le
voir. Des erreurs plus visibles arrivent encore, mais elles se sont raréfiées.
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
Rothwell, A., Moorkens, J., Fernández-Parra, M., Drugan, J., & Austermuehl, F. (2023). Translation Tools and Technologies. Routledge. https://doi.org/10.4324/9781003160793
This page is only available in French.
The full cycleLe cycle complet
Six choses, entre le texte et le fichier
Entre le texte que vous recevez et le fichier que vous livrez, l’outil de TAO et vous
faites six choses. Les deux premières ont lieu une seule fois, sur le fichier
entier ; les quatre autres se répètent pour chaque segment.
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 3. Le cycle d'une mémoire de traduction, du texte reçu au segment validé.
Le circuit se referme
Les deux flèches vers la mémoire vont dans des sens opposés et n’ont pas lieu
au même moment. La première part avant que vous ne voyiez le segment : l’outil
a déjà cherché quand la ligne s’affiche. Selon le réglage, il peut aussi avoir
rempli les propositions d’avance, pour tout le fichier, ce qu’on appelle la
prétraduction. La seconde flèche part quand vous validez, et elle écrit dans la
mémoire ce que vous venez d’accepter.
La mémoire dans laquelle l’outil cherche au segment 200 n’est donc plus celle
du segment 1 : elle contient entre-temps tout ce que vous y avez mis. Sur un
document où les phrases se ressemblent, le circuit devient utile bien avant la
fin du fichier. Des propositions remplies d’avance, elles, ne profitent pas de
ce que vous traduisez ensuite.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
Segments and translation unitsSegments et unités de traduction
Un tableau, pas un texte suivi
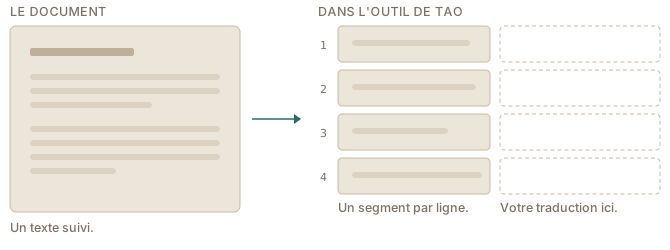
Un fichier ouvert dans un outil de TAO ne s’affiche pas comme un texte suivi.
Il s’affiche comme un tableau : une ligne par morceau de texte, la source à
gauche, la place de votre traduction à droite. Cette segmentation a eu lieu à
l’import, avant que vous n’écriviez quoi que ce soit.
Figure 4. Le même texte avant et après la segmentation : un segment par ligne, la place de la traduction en face.
Pourquoi le segment décide de tout
Le segment est l’unité de travail de l’outil : c’est par segment qu’il
enregistre, qu’il cherche, qu’il compte et qu’il vous propose une
correspondance. Le devis d’un projet se chiffre lui aussi en segments.
Pour qu’une mémoire serve à quelque chose, il faut beaucoup de
correspondances et des correspondances fiables. La taille des segments
décide des deux.
Trop grands, ils ne reviennent presque jamais. Si l’outil enregistrait des
paragraphes entiers, il serait rare d’en revoir un identique.
Trop petits, ils reviennent souvent mais ne portent plus assez de
contexte. Si l’outil enregistrait des mots isolés, ses propositions
varieraient tellement d’un contexte à l’autre qu’elles n’aideraient plus.
D’où le compromis : une phrase, un titre, ou un autre fragment de texte isolé.
Segment et unité de traduction sont donc deux choses différentes. Un segment
est un morceau d’un texte, dans une seule langue. Une unité de traduction
est le couple formé par un segment source et le segment cible que vous lui
avez donné. Le fichier que vous traduisez
contient des segments ; la mémoire, elle, contient des unités de traduction.
La segmentation n’est pas évidente
La règle de base est simple : une phrase, un segment. Les difficultés
commencent aux détails.
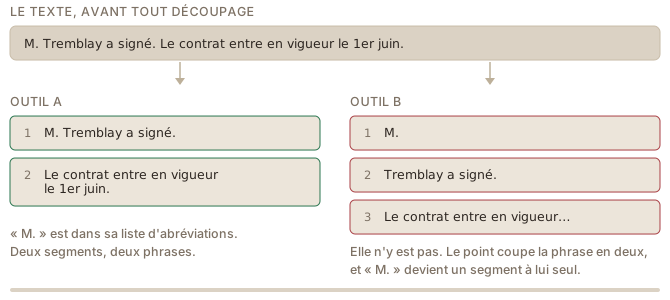
Un point ne termine pas toujours une phrase. « M. Tremblay a signé. »
contient deux points et une seule phrase. Les outils tiennent donc une liste
d’abréviations par langue, et cette liste se règle.
Certains segments ne sont pas des phrases du tout : un titre, une cellule
de tableau, un élément de menu, une légende. La structure du document
intervient donc autant que la ponctuation, et deux outils peuvent segmenter le
même texte un peu différemment.
La segmentation n’est pas toujours celle qu’il vous faut. Deux phrases
françaises rendues par une seule phrase anglaise se traduisent mieux dans un
seul segment, ce qui demande de fusionner deux segments dans l’éditeur, en
général à l’intérieur d’un même paragraphe.
Figure 5. Le même texte, segmenté par deux outils. Les règles appartiennent au logiciel, pas au texte.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
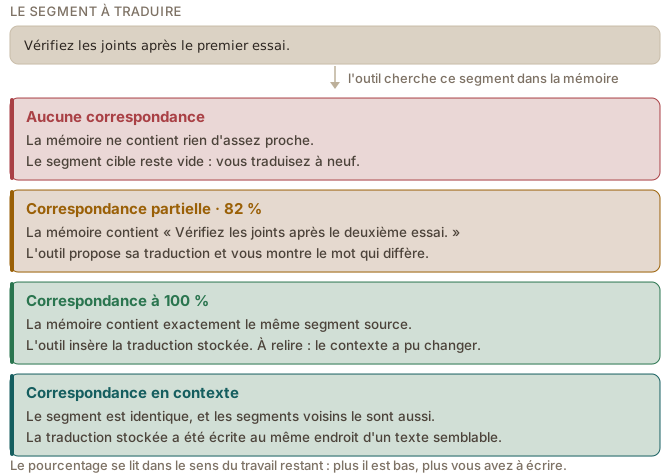
The four types of matchLes quatre types de correspondance
Quand vous traduisez dans un outil de TAO branché sur une mémoire de
traduction, la recherche dans la mémoire se fait de deux façons, selon le
réglage : l’outil remplit les propositions pour tout le fichier avant que vous
ne commenciez, ou il ne cherche qu’au moment où vous ouvrez un segment. Dans
les deux cas, cette recherche donne l’un de quatre résultats (voir la
Figure 6figure 6).
Figure 6. Ce que la mémoire renvoie pour un segment donné.
Ces quatre cas vont du moins utile au plus fiable. C’est aussi l’ordre dans
lequel vous les rencontrerez dans un projet neuf, où tout commence sans
correspondance et où les autres apparaissent à mesure que la mémoire se
remplit.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
No matchAucune correspondance
L’outil ne propose rien
Quand la mémoire ne contient aucun segment assez proche de celui que vous
ouvrez, elle ne propose rien : la case cible reste vide, et vous
traduisez comme vous le feriez sans outil. C’est le cas le plus simple, et le
seul qui ne demande rien de particulier.
Au début d’un projet, avec une mémoire neuve, c’est ce qui arrive à presque
tous les segments. Cela ne veut pas dire que l’outil ne sert à rien : chaque
segment que vous validez entre dans la mémoire, et les correspondances
commencent à apparaître dans le document même que vous êtes en train de
traduire.
Le seuil
« Assez proche » n’est pas une notion vague : c’est un nombre réglable, en
général autour de 70 %. Sous ce seuil, l’outil ne propose rien, pour la
raison suivante : corriger une proposition trop éloignée coûte plus de temps
que d’écrire la traduction directement. En dessous d’un certain degré de
ressemblance, une proposition n’est plus une aide, mais une lecture de plus.
Combien de correspondances espérer
Une mémoire à vous met du temps à devenir utile : elle ne contient que ce que
vous y avez mis. Ce que vous obtenez ensuite dépend de la ressemblance entre le
nouveau texte et ceux qui sont déjà dedans.
Vos premiers projets se traduisent presque entièrement à neuf.
Un texte d’un autre client, dans un autre domaine en donne peu, quel que
soit le volume accumulé.
La nouvelle version d’un document déjà traduit est le cas le plus
favorable : l’essentiel du texte n’a pas bougé, et la mémoire répond sur la
plus grande partie du fichier.
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
Tiedemann, J. (2012). Parallel Data, Tools and Interfaces in OPUS. Proceedings of the Eighth International Conference on Language Resources and Evaluation (LREC'12), Istanbul, 2214–2218. https://aclanthology.org/L12-1246/
This page is only available in French.
The fuzzy matchLa correspondance partielle
La réponse qui demande le plus d’attention
Des quatre réponses possibles, c’est celle qui demande le plus d’attention.
L’outil vous signale ce qui diffère entre les deux segments sources, et vous
reportez la différence dans la traduction.
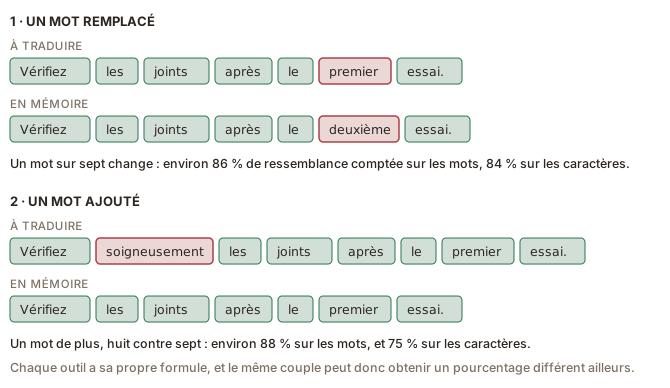
D’où vient le pourcentage
L’outil de TAO compare le segment source stocké à celui que vous traduisez, et
compte ce qu’il faudrait changer pour passer de l’un à l’autre : des mots
ajoutés, supprimés ou remplacés. Le pourcentage est ce compte rapporté à la
longueur du segment.
Figure 7. Le pourcentage vient d'un décompte de ce qui diffère entre les deux segments sources : un mot remplacé, ou un mot ajouté.
Ce que le pourcentage mesure, et ce qu’il ne mesure pas
Il mesure une ressemblance de forme, et rien d’autre. Il ne
dit pas si l’écart est important.
Une correspondance à 95 % dont le seul mot différent est « ne pas » demande une
correction essentielle : l’outil vous propose l’inverse de ce qu’il faut écrire.
Une correspondance à 80 % dont l’écart tient à un complément déplacé peut n’en
demander aucune. Le chiffre ne fait pas la différence entre les deux, et vous,
oui.
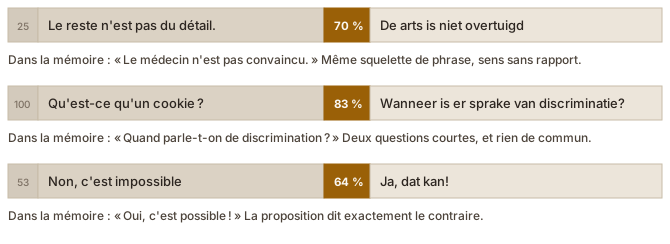
Trois exemples réels
Poussé à bout, ce calcul donne des propositions qui n’ont plus rien à voir avec
le segment à traduire. Les trois ci-dessous viennent de vrais projets, du
français vers le néerlandais, et ont circulé dans un groupe de traducteurs et
traductrices.
Figure 8. Trois correspondances partielles réelles. Le pourcentage compare des caractères, jamais des sens.
La troisième est la plus instructive : « Ja, dat kan! » veut dire « Oui, c’est
possible ! », soit le contraire exact du segment à traduire.
Aucune de ces propositions n’est un défaut de l’outil. Chacune est la bonne
réponse à la question qu’il se pose, qui est « quel segment stocké ressemble le
plus à celui-ci, lettre pour lettre ». La question du sens ne lui est jamais
posée, et il n’aurait pas les moyens d’y répondre.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
The 100% matchLa correspondance à 100 %
Rien à corriger, en apparence
L’outil de TAO insère la traduction stockée et passe au segment suivant. Il
n’y a rien à corriger en apparence, et une proposition qui ne demande rien est
une proposition qu’on relit peu.
Pourquoi relire quand même
Le segment est le même. Ce qui l’entoure ne l’est pas nécessairement, et une
phrase ne se traduit pas indépendamment de sa place.
La même phrase peut être un titre dans un document et une ligne de tableau
dans un autre, ce qui change la majuscule, la ponctuation finale et parfois
la tournure.
Elle peut reprendre un antécédent qui a changé : « Il est conforme à la
norme » ne se traduit pas de la même façon selon ce dont parlait la phrase
précédente.
Elle peut venir d’un document dont le registre ou le public n’est pas celui
du vôtre.
La mémoire ne sait rien de tout cela. Elle a comparé un segment à un segment, et
elle a trouvé qu’ils étaient identiques. C’est tout ce qu’annonce le 100 %.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
The context matchLa correspondance en contexte
Ce que le 100 % ignore
Une correspondance à 100 % ne dit rien de ce qui entoure le segment. La
correspondance en contexte tient compte de cet entourage : si le segment qui
précède et celui qui suit sont eux aussi les mêmes, la traduction stockée a été
écrite pour cette phrase à cet endroit-là, et le risque qu’elle ne convienne
pas ici devient faible.
Le cas demande un texte très proche de ce qui est en mémoire : une nouvelle
version d’un manuel, d’un contrat type ou d’un site dont la plupart des
passages n’ont pas bougé d’une version à l’autre.
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
How the memory fills upComment la mémoire se remplit
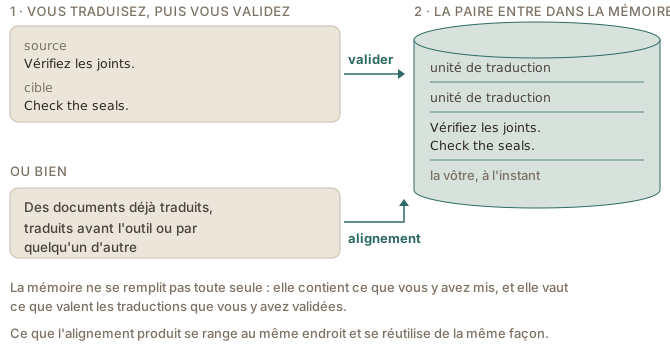
Au premier projet, elle est vide
Au premier projet, la mémoire est vide : elle ne peut rien proposer tant que
vous n’y avez rien mis. Elle se remplit à mesure que vous validez des segments,
et par alignement de documents déjà traduits.
Figure 9. Les deux façons de remplir une mémoire : segment par segment en traduisant, ou d'un coup par alignement.
En traduisant
Vous traduisez un segment, vous le validez, et la paire entre dans la mémoire
comme unité de traduction. Sur un document où les phrases se ressemblent, cela
se voit vite : quelques segments validés suffisent pour que l’outil
commence à en reproposer.
Valider un segment et passer au segment suivant sont deux actions
différentes : cliquer sur la ligne d’en dessous vous déplace sans rien
enregistrer, et seule la validation écrit dans la mémoire.
Ce qu’on aligne : vos traductions antérieures, celles d’un collègue, les
documents bilingues d’un client (see also the Wordfast: alignment chapter, in the CAT tools module) (voir aussi le chapitre Wordfast : alignement, dans le module Outils de TAO).
Une erreur validée coûte donc deux fois plutôt qu’une : au moment où elle
passe, puis chaque fois qu’elle revient et qu’on la reconfirme sans la relire.
Ce que devient la cohérence
Le désordre ne vient pas que des erreurs. Une mémoire perd aussi sa
cohérence à mesure qu’elle grossit. Sur quatre mémoires d’entreprise
réelles, de 22 000 à 300 000 unités de traduction (Moorkens, 2011) :
la différence la plus fréquente entre deux segments presque identiques était
une simple majuscule.
Chacune de ces traductions pouvait être juste dans son projet. C’est leur
coexistence dans une même mémoire qui pose problème, puisque l’outil les
propose ensuite indifféremment.
Deux conséquences, dès maintenant
Corrigez la mémoire, pas seulement le segment. Quand une proposition ne
convient pas parce que ce qui est enregistré est fautif, corrigez la mémoire
tout de suite si l’outil vous le permet, sinon notez-le très clairement.
Corriger seulement le segment du projet en cours laisse l’erreur en place pour
le projet suivant.
Gardez des mémoires séparées quand les projets n’ont rien à voir : les
phrases d’un client de machinerie n’ont aucune raison de ressortir dans une
traduction juridique.
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
Moorkens, J. (2011). Translation memories guarantee consistency: Truth or fiction?. Proceedings of Translating and the Computer 33 (Aslib). https://aclanthology.org/2011.tc-1.17/
This page is only available in French.
Choosing your memoriesChoisir ses mémoires
Deux mémoires, deux bonnes traductions
Un même segment source anglais peut avoir été traduit correctement de deux
façons, dans deux mémoires venues de domaines différents. Les deux répondent à
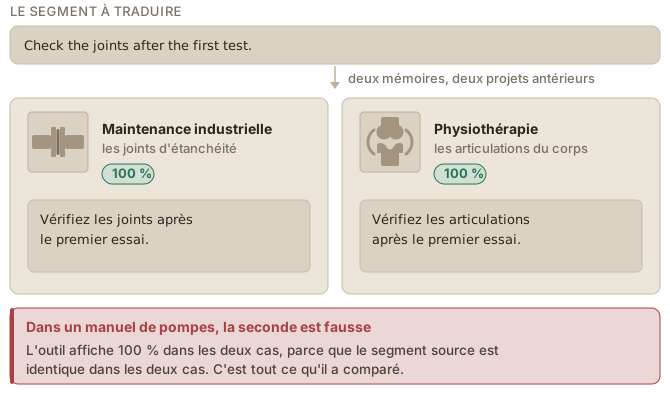
100 %, et la mémoire ne peut pas savoir laquelle convient à votre projet : elle
a comparé un segment à un segment.
Figure 10. Deux mémoires, un seul segment source, deux traductions justes chacune dans son domaine.
Une mémoire n’est donc pas un réglage à cocher au moment de créer le projet.
Avant de l’attacher, trois questions :
D’où viennent ses textes ? Un client, un domaine, un type de document, ou
un mélange dont personne ne se souvient.
Qui les a validés ? Une traduction stockée a été acceptée par quelqu’un,
dans des conditions que vous ne connaissez pas.
Est-ce qu’ils ressemblent au vôtre ? Un manuel technique et une brochure
du même client ne parlent pas de la même façon.
Une mémoire faite de textes proches du vôtre vous fait gagner du temps. Une
mémoire faite d’autre chose vous en fait perdre, surtout quand elle propose
quelque chose : une mémoire muette vous laisse traduire, une mémoire hors
domaine vous fait relire et corriger.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
This page is only available in French.
What you gain, what you loseCe qu'on y gagne, ce qu'on y perd
Ce que vous y gagnez
Trois choses.
De la cohérence : la même phrase ressort de la même façon d’un projet à
l’autre et d’un mois à l’autre.
De la vitesse sur les textes qui se ressemblent.
Moins de travail répétitif, ce qui est autre chose que de la vitesse.
Retraduire à la main la vingtième occurrence d’un avertissement de sécurité
n’apprend rien à personne.
Ce que vous y perdez
Une mémoire demande de l’entretien, et elle ne rend rien tant qu’elle ne
contient pas de textes proches du projet en cours. À cela s’ajoute une courbe
d’apprentissage : le temps passé à comprendre l’outil est du temps qui n’est
pas passé à traduire.
Ce que la mémoire change à ce que vous êtes payé
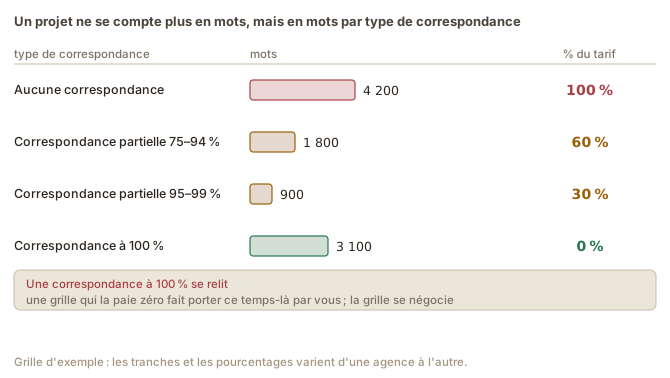
Un projet ne se compte plus seulement en mots : il se compte en mots par type
de correspondance, tant de segments sans correspondance, tant de correspondances
partielles par tranche, tant à 100 %. Les agences appliquent une grille
dégressive sur ce décompte, et ce que vous facturez dépend donc autant de la
mémoire branchée sur le projet que du texte à traduire.
Figure 11. Le même projet, compté par type de correspondance et payé à des taux différents. Grille d'exemple : les tranches et les pourcentages varient d'une agence à l'autre.
Le coût qu’on voit le moins : la segmentation
L’écran vous présente une phrase à la fois. C’est ce qui rend la réutilisation
possible, et c’est aussi ce qui éloigne du texte comme ensemble : le registre,
la progression thématique, la reprise d’un antécédent, le rythme d’un
paragraphe ne se lisent dans aucun segment isolé.
Le tableau ci-dessous rassemble des segments anglais dont la traduction
française n’est pas décidable telle quelle. Chaque fois, ce qui tranche se
trouve ailleurs.
Segment source
Traductions possibles
Ce qui tranche, et où cela se trouve
The client has signed.
Le client a signé. / La cliente a signé.
Le genre de la personne. Nulle part dans ce segment.
The doctor is not convinced.
Le médecin n’est pas convaincu. / La médecin n’est pas convaincue.
Le même problème, avec l’accord de l’attribut en plus.
Your order has been processed.
Votre commande a été traitée. / Votre ordre a été exécuté.
Le domaine du document : commerce ou finance.
Please confirm before Friday.
Veuillez confirmer avant vendredi. / Confirme avant vendredi.
Le registre, fixé pour le document entier.
They arrived late.
Ils sont arrivés en retard. / Elles sont arrivées en retard.
Le référent, souvent plusieurs segments plus haut.
Une mémoire qui vous propose une de ces traductions à 100 % la propose parce que
le segment source est identique, et pour aucune autre raison. Elle ne peut pas
savoir que le client de la page 3 est une cliente à la page 40.
Sources
Bowker, L. (2002). Computer-Aided Translation Technology: A Practical Introduction. University of Ottawa Press. https://doi.org/10.1353/book6554
Bowker, L., & Fisher, D. (2010). Computer-aided translation. Handbook of Translation Studies (John Benjamins Publishing Company). https://doi.org/10.1075/hts.1.comp2
Maruf, S., Saleh, F., & Haffari, G. (2021). A survey on document-level neural machine translation: Methods and evaluation. ACM Computing Surveys, 54(2), article 45. https://doi.org/10.1145/3441691
Rothwell, A., Moorkens, J., Fernández-Parra, M., Drugan, J., & Austermuehl, F. (2023). Translation Tools and Technologies. Routledge. https://doi.org/10.4324/9781003160793
Voita, E., Sennrich, R., & Titov, I. (2019). When a good translation is wrong in context: Context-aware machine translation improves on deixis, ellipsis, and lexical cohesion. Proceedings of the 57th Annual Meeting of the ACL, 1198–1212. https://aclanthology.org/P19-1116/
This page is only available in French.
🔒 TRA2600 · Installing WordfastTRA2600 · Installer Wordfastis course material (TRA2600). Open it on the site to include it here.est réservé au cours (TRA2600). Ouvrez-le sur le site pour l'inclure ici.
Une licence Wordfast Pro personnelle, d’un an et sans frais, obtenue pour ce
cours-ci. Elle est associée à votre adresse de l’UdeM et couvre tout le
trimestre, avec de la marge. Elle donne aussi accès à Wordfast Anywhere, la
version qui s’utilise dans un navigateur.
Elle est distincte des licences installées sur les postes du département, qui
viennent du département et servent aux cours qui en ont besoin. Les deux
existent en parallèle : la licence personnelle vous suit sur votre propre
ordinateur, celles du département restent sur les postes.
À l’échéance, Wordfast offre un rabais étudiant si vous voulez continuer. Rien
ne vous y oblige, et le cours ne suppose aucun achat.
Où l’installer
Vous avez le choix. Les postes du département ont Wordfast Pro installé, et
tout ce que le cours demande peut se faire là. Une installation sur votre propre
ordinateur reste plus commode pour les exercices à faire à la maison, entre deux
séances, et c’est ce que je vous recommande.
L’installation se fait en classe le 2 septembre 2026, avec de l’aide sur place. Ce
qui n’est pas terminé se finit chez vous, avec ces pages. C’est à vous de vous
assurer d’avoir un outil qui fonctionne avant la séance 2.
This page is only available in French.
Downloading Wordfast ProTélécharger Wordfast Pro
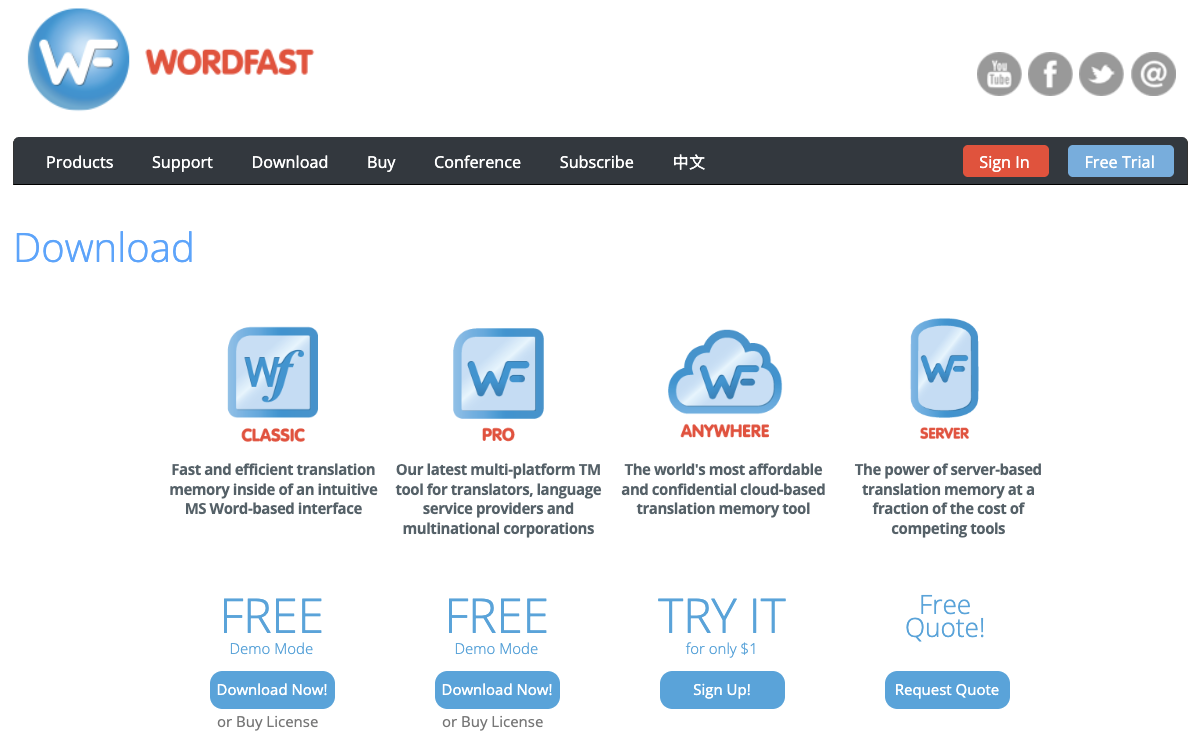
Rendez-vous sur wordfast.com et ouvrez la page
« Download ». Quatre produits y figurent côte à côte.
Figure 1. La page de téléchargement de wordfast.com. Le produit du cours est Wordfast Pro, la deuxième colonne.
Celui qui nous intéresse est le deuxième, Wordfast Pro. Les trois autres ne
servent pas dans ce cours :
Classic est l’ancienne version, qui fonctionne à l’intérieur de Microsoft
Word ;
Anywhere est la version qui s’exécute dans un navigateur, sans rien
installer. Votre licence y donne accès et elle peut dépanner, mais les
séances se donnent dans Pro ;
Server est un produit d’entreprise.
Sous Wordfast Pro, cliquez sur « Download Now! ». Le téléchargement démarre
sans achat : le mot « FREE » de cette colonne désigne le mode démonstration,
et c’est votre clé d’activation qui transformera cette installation en version
complète.
This page is only available in French.
Installing the softwareInstaller le logiciel
Télécharger le bon fichier
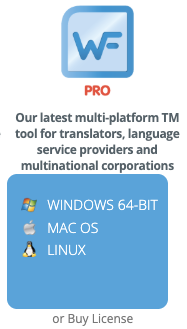
Le bouton « Download Now! » de la colonne Wordfast Pro ouvre la liste des
systèmes. Prenez celui de la machine sur laquelle vous installez.
Figure 2. Les trois systèmes proposés sous Wordfast Pro.
Une fois le fichier téléchargé, l’installation ne demande aucun choix
particulier : acceptez les valeurs proposées et laissez l’installateur se
terminer.
Sur Windows
Le fichier est un .exe. Ouvrez-le et suivez les écrans. Windows peut afficher
un avertissement SmartScreen pour un programme téléchargé sur le web : passez
par « Informations complémentaires », puis « Exécuter quand même ».
Gardez l’emplacement d’installation proposé, dans Program Files.
Sur macOS
Le fichier est un .dmg. Ouvrez-le, puis glissez l’icône de Wordfast Pro dans
le dossier Applications, comme pour n’importe quelle application Mac.
Au premier lancement, macOS bloque les applications qui ne viennent pas de
l’App Store. Le message dit que le développeur ne peut pas être vérifié. Passez
par Réglages Système, section Confidentialité et sécurité : un bouton
« Ouvrir quand même » y apparaît, sous le message qui vient de s’afficher. Le
blocage ne se produit qu’une fois.
Un mot sur l’emplacement
Installez le logiciel là où l’installateur le propose. La question de
l’emplacement se pose surtout pour vos projets, pas pour l’application, et elle
revient au premier chapitre du parcours Wordfast : vos dossiers de projets ne
doivent pas se trouver dans OneDrive, Dropbox ou Google Drive. La
synchronisation modifie les fichiers pendant que le logiciel les tient ouverts,
ce qui donne des mémoires abîmées et des projets qui refusent de s’ouvrir.
This page is only available in French.
Activating your licenceActiver votre licence
En deux temps
L’activation se déroule en deux temps. Vous récupérez d’abord une clé sur le
site de Wordfast, puis vous la donnez au logiciel. La clé est un texte à copier
et coller, alors gardez les deux fenêtres ouvertes.
Étape 1. Se connecter à son compte
Vous n’avez reçu aucun courriel, et c’est normal : votre compte existe déjà
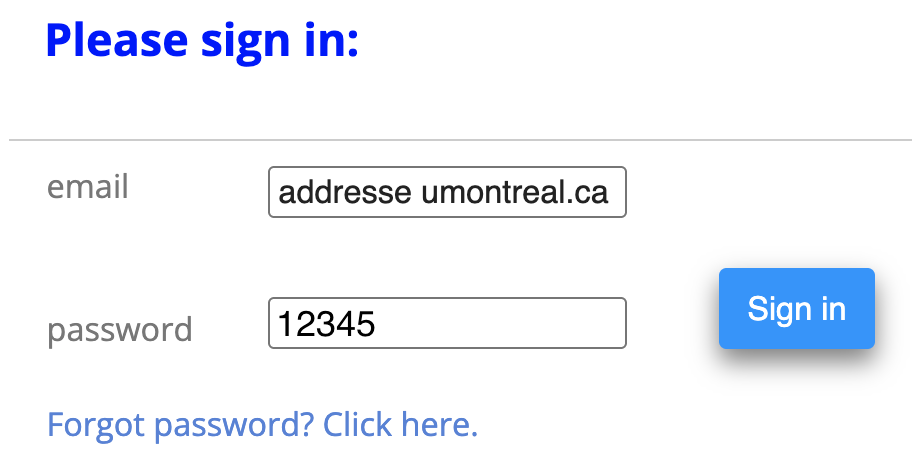
sur wordfast.com, créé avec votre adresse de l’UdeM et le mot de passe 12345.
Sur wordfast.com, cliquez sur « Sign In », en haut
à droite.
Figure 3. La connexion se fait avec votre adresse de l'UdeM et le mot de passe 12345, à changer une fois entré.
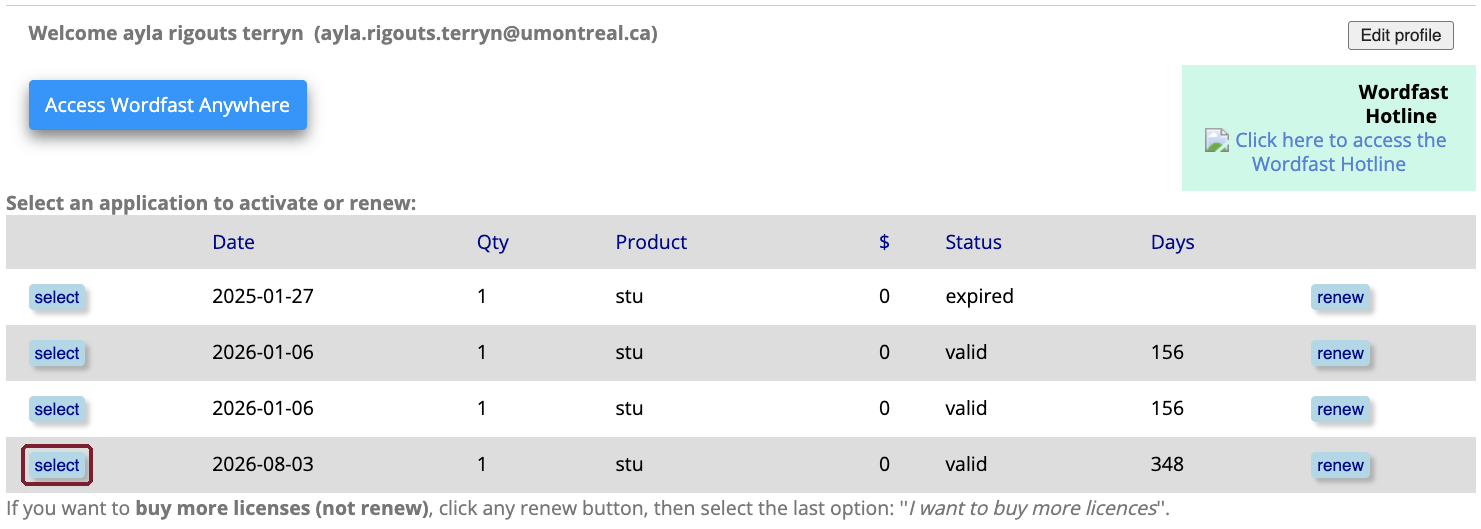
Figure 4. Ma page en montre plusieurs ; la vôtre n'en montre qu'une, sauf si vous avez déjà eu Wordfast Pro sur votre adresse de l'UdeM. Cliquez sur « select » à sa gauche.
Étape 3. Obtenir la clé
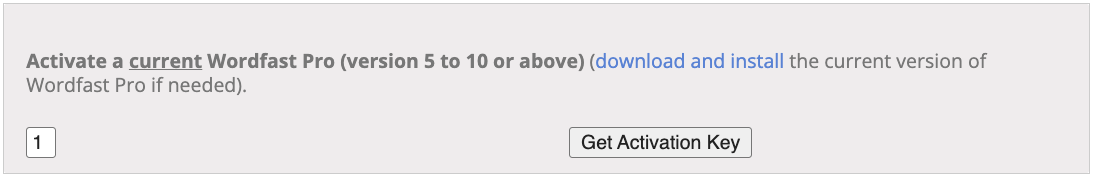
Laissez la quantité à 1 et cliquez sur « Get Activation Key ».
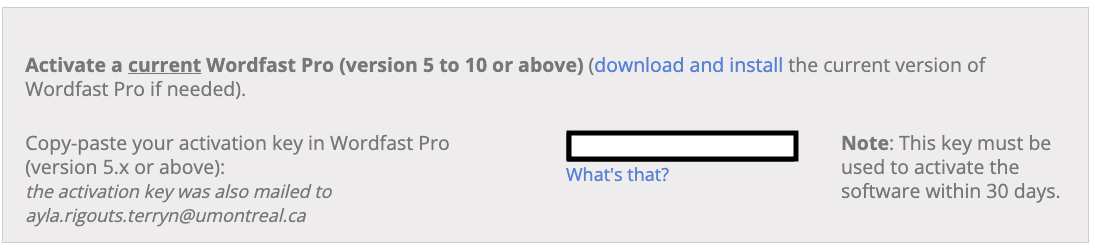
La clé s’affiche dans le même encadré. Elle vous est aussi envoyée par
courriel, à votre adresse de l’UdeM : si vous perdez la page, la clé est dans
votre boîte de réception.
Figure 6. La clé apparaît dans le champ. Elle est aussi envoyée par courriel.
Étape 4. Coller la clé dans Wordfast Pro
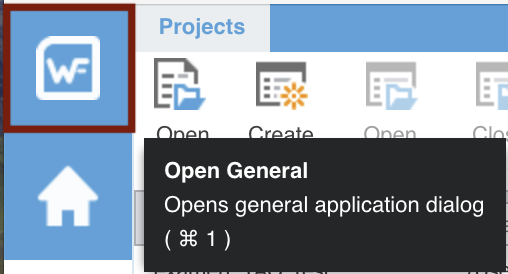
Ouvrez Wordfast Pro. Cliquez sur le logo Wordfast, en haut à gauche de la
fenêtre, et choisissez « Online Registration ».
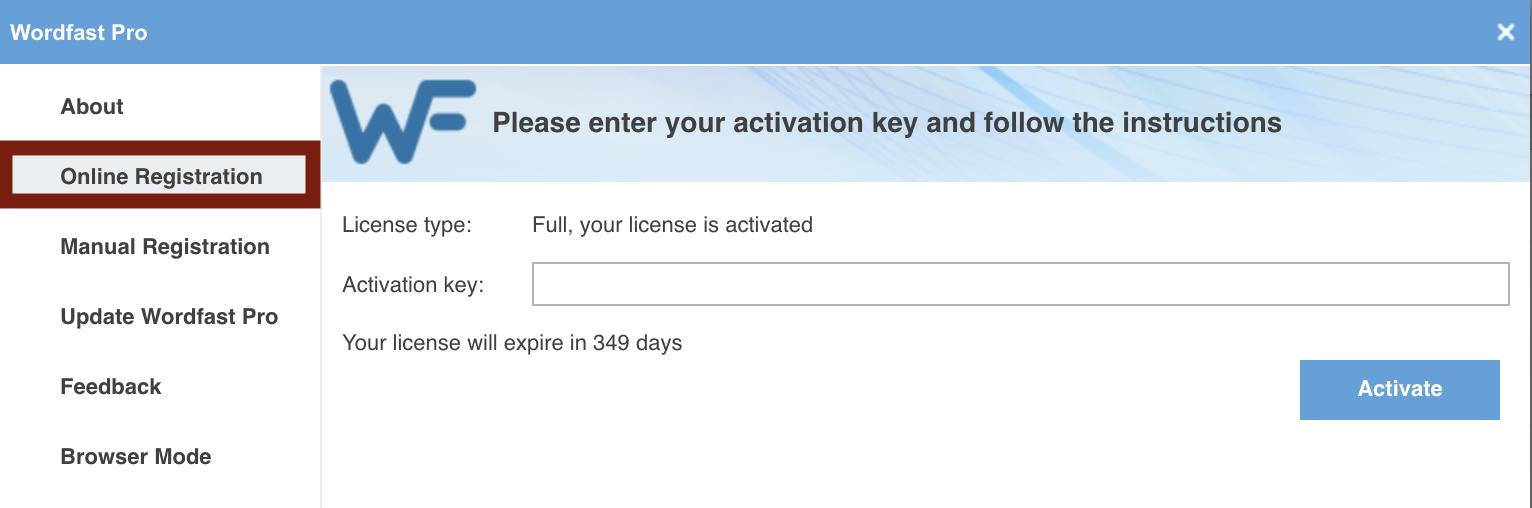
Figure 7. La fenêtre d'enregistrement. Après activation, « License type » indique une licence complète et le nombre de jours restants s'affiche sous le champ.
Collez la clé dans le champ « Activation key », puis cliquez sur « Activate ».
La confirmation est à lire dans cette même fenêtre : « License type » passe à
une licence complète, et une ligne indique combien de jours il reste. Si le
type de licence reste en mode démonstration, l’activation n’a pas fonctionné.
Étape 5. Redémarrer
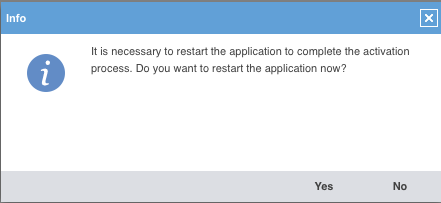
Wordfast demande de redémarrer pour terminer l’activation : répondez oui.
This page is only available in French.
First launchPremier lancement
Le premier démarrage est long
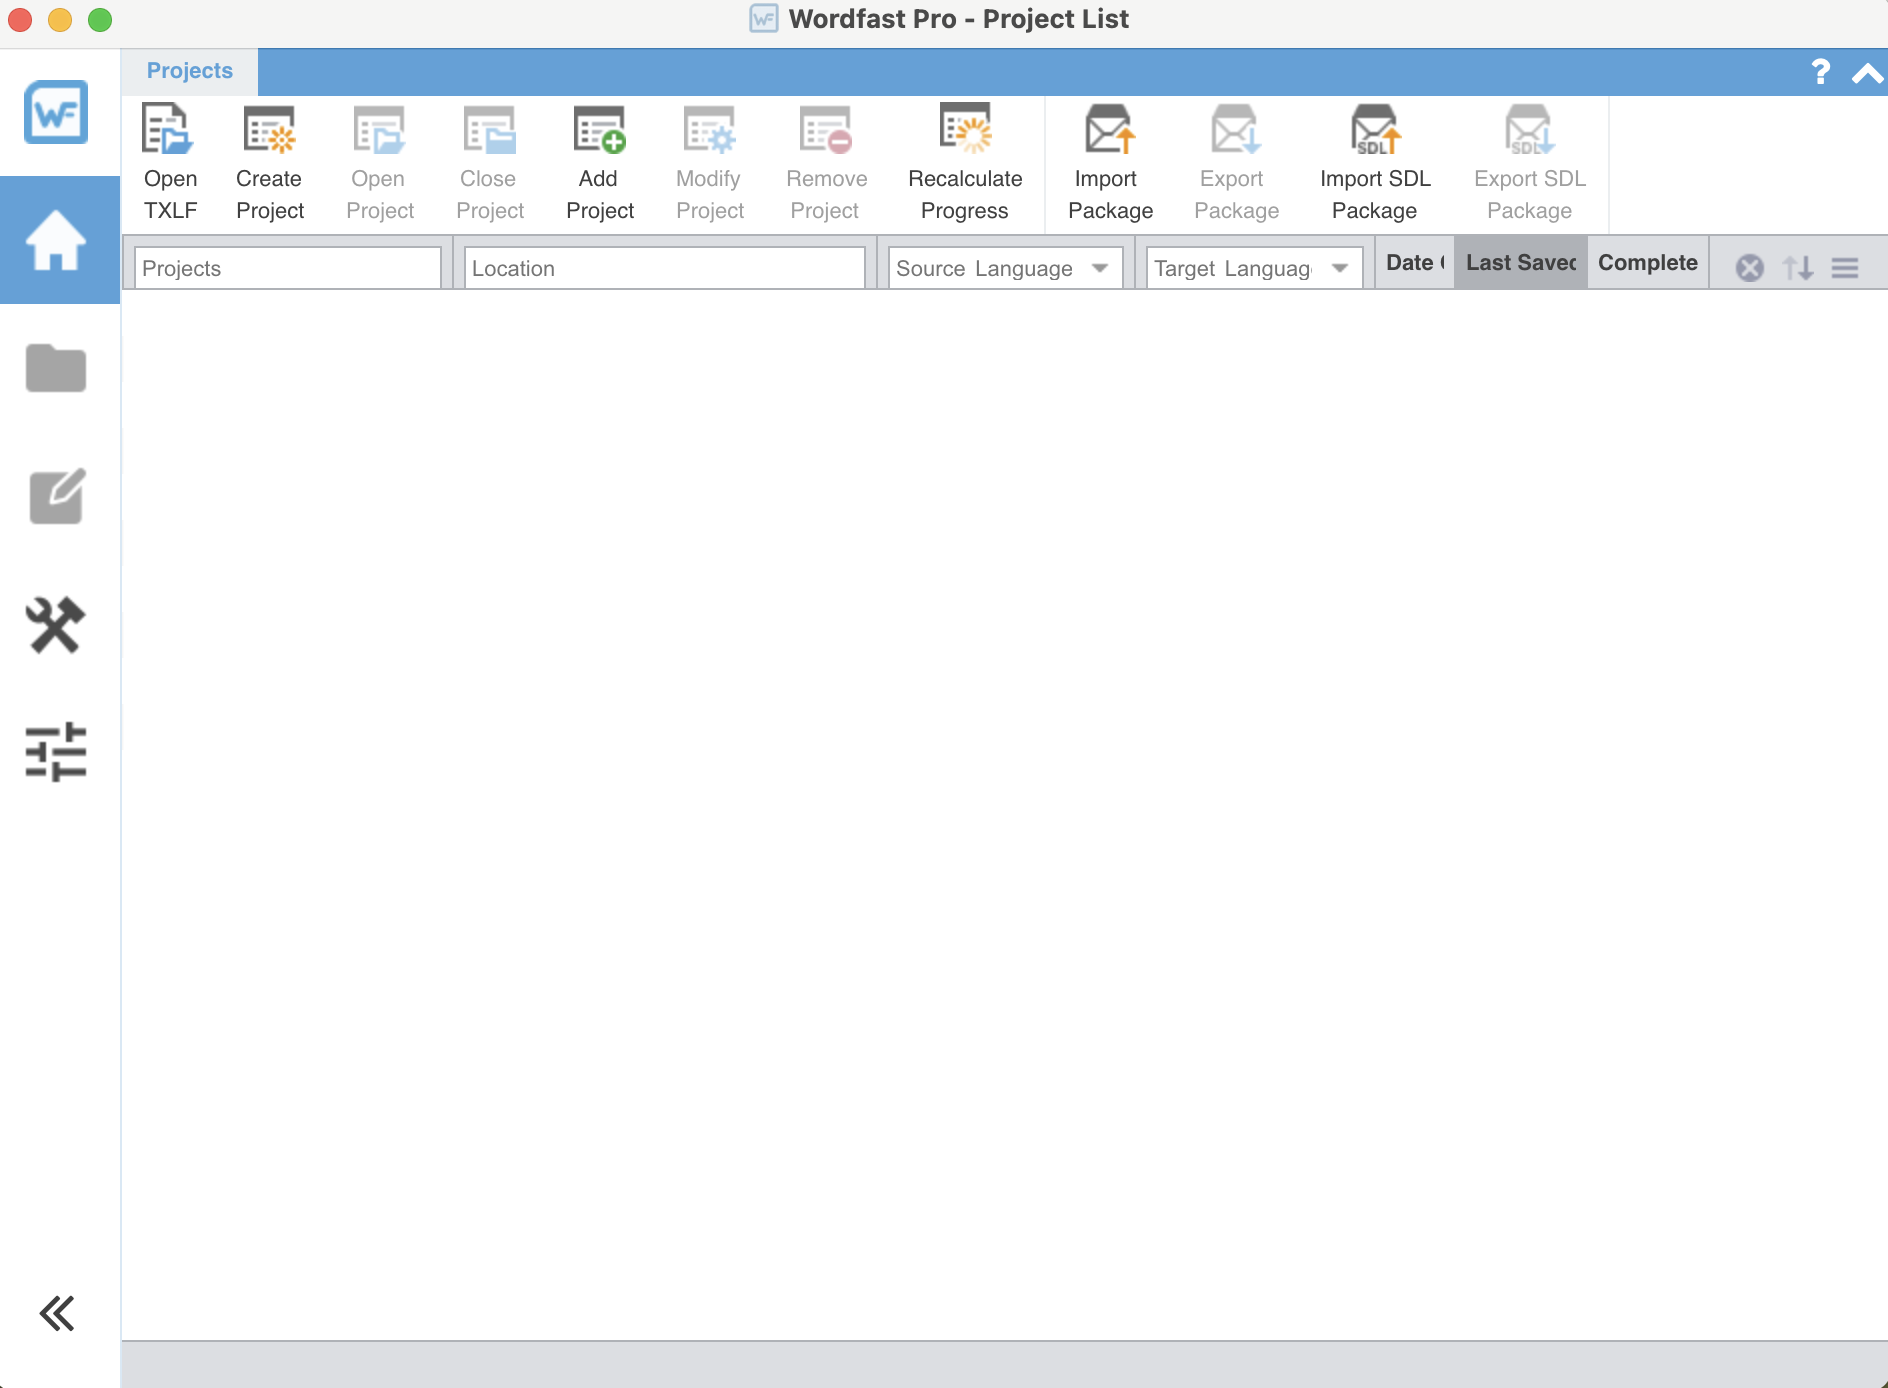
Ouvrez Wordfast Pro. Le démarrage est long, surtout la première fois : laissez
l’écran de chargement finir. Vous arrivez ensuite sur la liste des projets, et
elle est vide.
Figure 9. La liste des projets au premier lancement. Le tableau est vide, et c'est ce qu'il faut voir.
Il se remplira à partir de la séance 2 : un projet par ligne, avec sa paire de
langues et son pourcentage d’avancement.
Ce qu’il faut vérifier maintenant
Une seule chose : que la licence est active. Cliquez sur le logo Wordfast, en
haut à gauche, puis sur « Online Registration ». La ligne « License type » doit
annoncer une licence complète, et le nombre de jours restants doit s’afficher.
Si ce n’est pas le cas, reprenez la page
Activer votre licence.
Figure 10. Le logo Wordfast, en haut à gauche, ouvre la fenêtre générale.
C’est tout ce qui est attendu de vous avant la séance 2. Ne créez pas de projet
d’essai : la création d’un projet se fait ensemble, en classe, et le premier
chapitre du parcours Wordfast commence par l’organisation de vos dossiers, qui
est le genre de décision qu’il vaut mieux prendre avant d’avoir dix projets
éparpillés.
This page is only available in French.
When it does not workQuand ça ne fonctionne pas
Les postes du département sont une solution complète
Si Wordfast refuse de s’installer ou de démarrer sur votre machine, ce n’est pas
un problème pour votre réussite dans le cours. Les postes du département ont le
logiciel et permettent de faire les séances, les exercices et l’examen de
mi-session, qui se tient de toute façon en classe.
Ce que vous perdez, c’est la commodité de travailler chez vous entre deux
séances. Cela vaut la peine d’essayer de régler le problème, sans que ce soit
urgent au point d’y passer une soirée.
Wordfast est lent, surtout au démarrage
Le logiciel met du temps à s’ouvrir, et l’écran de chargement peut rester
affiché longtemps, surtout au premier lancement. Ce n’est pas un blocage.
Laissez-le finir avant de forcer la fermeture, et évitez de le relancer
plusieurs fois pendant qu’il démarre : vous n’obtiendrez que plusieurs
démarrages en même temps.
macOS refuse d’ouvrir l’application
Le message dit que le développeur ne peut pas être vérifié. Ouvrez Réglages
Système, puis Confidentialité et sécurité, et descendez jusqu’au message qui
vient d’apparaître : un bouton « Ouvrir quand même » s’y trouve. Il faut avoir
tenté d’ouvrir l’application juste avant pour que le bouton apparaisse.
Windows bloque l’installateur
L’écran bleu de SmartScreen annonce qu’il a protégé votre appareil. Cliquez sur
« Informations complémentaires », puis sur « Exécuter quand même ».
La licence refuse de s’activer
Trois causes, dans l’ordre de fréquence :
vous n’êtes pas connecté au bon compte. La licence est rattachée à votre
adresse de l’UdeM ;
la clé a été copiée avec une espace en trop, au début ou à la fin. Recollez-la
en vérifiant les extrémités ;
la clé a déjà servi sur une autre machine. Une licence n’autorise qu’UNE
activation, donc une clé déjà utilisée ne servira pas une deuxième fois.
Venez me voir : c’est le cas que je ne peux pas régler à distance.
Un fichier refuse d’être importé dans un projet
Si Wordfast annonce « Failed: 1 » à l’ajout d’un fichier, avec un message qui
parle de « Rules file » introuvable, ce n’est pas votre document : ce sont les
règles de filtrage de Wordfast, qu’il range dans un dossier temporaire du système et
que le système efface de temps à autre. Redémarrez Wordfast et ajoutez le fichier de
nouveau ; il les réinstalle en démarrant.
Cela s’est produit sur mon poste avec un fichier HTML, en septembre 2026, et le
redémarrage a suffi.
L’ordinateur est trop ancien, ou c’est un Chromebook
Wordfast Pro ne s’installe pas sur ChromeOS ni sur un iPad. Deux possibilités :
les postes du département, ou Wordfast Anywhere, la version qui s’exécute dans
un navigateur et à laquelle votre licence donne accès. Anywhere fait moins de
choses que Pro et les séances ne s’y donnent pas, mais il permet de suivre.
Ce que je vous demande
Signalez-moi un problème d’installation avant la séance 2 plutôt que le jour de
l’examen. Écrivez-moi ce que vous avez tenté et ce que dit le message d’erreur
exactement, ou venez me voir avant ou après une séance. Une installation qui ne
fonctionne pas est un problème banal, pas un aveu.