Administrator
This teaching view is for the instructor. Enter the administrator password.
Wrong password · Mot de passe incorrect
Key pointsL'essentiel
Evaluating machine translationÉvaluation de la traduction automatique
Systems that find or label things are usually evaluated against a gold standard, with each answer counted right or wrong, even though people do not always agree on the answers. Translation fits that approach even less well, because the system writes new text: the correct translations of a sentence cannot be listed, and one sentence can be partly right and partly wrong.
Les systèmes qui trouvent ou étiquettent des éléments sont habituellement évalués par rapport à un étalon de référence, chaque réponse étant comptée comme juste ou fausse, même si les personnes ne s'accordent pas toujours sur les réponses. La traduction se prête encore moins bien à cette approche, parce que le système rédige un texte nouveau : les traductions correctes d'une phrase ne peuvent pas être énumérées, et une même phrase peut être en partie juste et en partie fausse.
Key pointsL'essentiel
Evaluating machine translationÉvaluation de la traduction automatique
Surface metrics such as BLEU and chrF count the words or characters an output shares with a reference translation; semantic metrics compare meaning, and learned metrics predict the score a person would give; a large language model can be asked to judge; and people score translations or annotate their errors with schemes such as MQM and ESA.
Les métriques de surface comme BLEU et chrF comptent les mots ou les caractères qu'une sortie partage avec une traduction de référence ; les métriques sémantiques comparent le sens, et les métriques apprises prédisent le score qu'une personne donnerait ; un grand modèle de langue peut être chargé de juger ; et des personnes notent les traductions ou en annotent les erreurs selon des systèmes comme MQM et ESA.
Key pointsL'essentiel
Evaluating machine translationÉvaluation de la traduction automatique
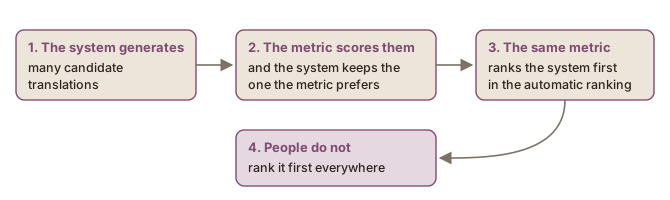
A metric is only as good as its agreement with the judgements of people, scores from different metrics or test sets cannot be compared, and automatic rankings and human rankings do not always agree.
Une métrique ne vaut que par son accord avec le jugement des personnes, les scores de métriques ou de jeux de test différents ne sont pas comparables, et les classements automatiques et humains ne concordent pas toujours.
Key pointsL'essentiel
Evaluating machine translationÉvaluation de la traduction automatique
A claim that machine translation equals human translation depends on the test behind it: which human translation, which raters, how much context and which texts.
Une affirmation selon laquelle la traduction automatique égale la traduction humaine dépend du test qui la fonde : quelle traduction humaine, quels évaluateurs, quelle part de contexte et quels textes.
Page 1Page 1
Many correct translationsDe nombreuses traductions correctes
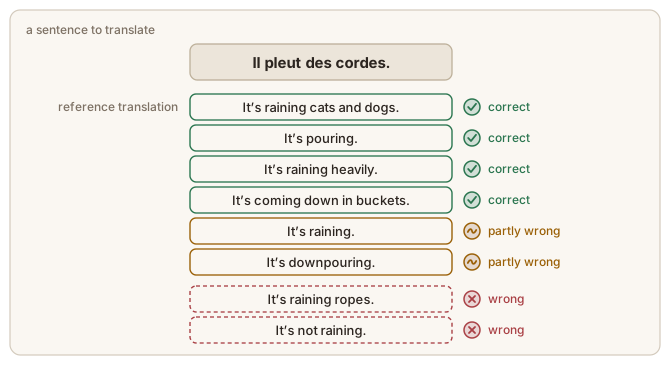
- Systems that find or label things are usually evaluated against a gold standard, with each answer counted right or wrong, even though people do not always agree on the answers. Translation fits that approach even less well, because the system writes new text: the correct translations of a sentence cannot be listed, and one sentence can be partly right and partly wrong.
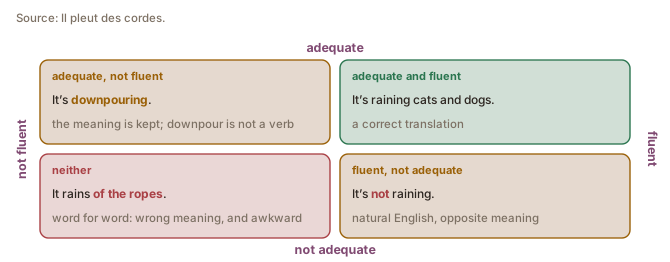
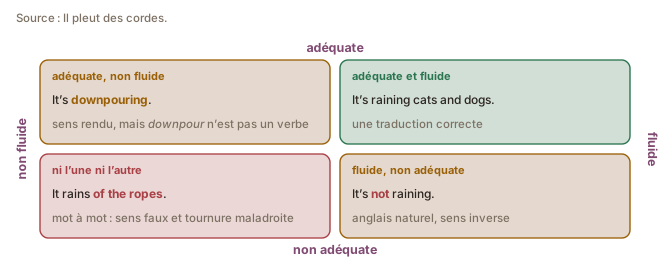
- A translation is judged for adequacy, whether the meaning of the source is kept, and for fluency, whether it reads as natural target language.
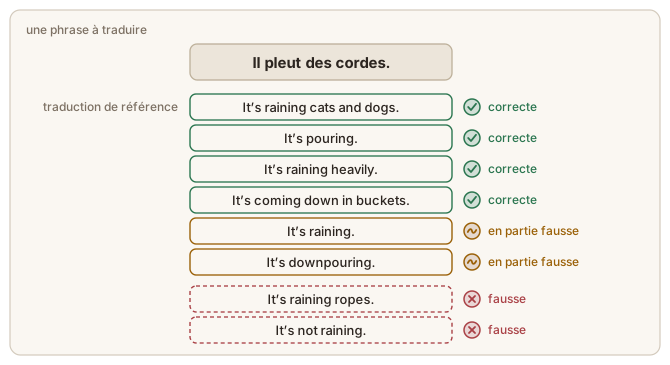
- Les systèmes qui trouvent ou étiquettent des éléments sont habituellement évalués par rapport à un étalon de référence, chaque réponse étant comptée comme juste ou fausse, même si les personnes ne s'accordent pas toujours sur les réponses. La traduction se prête encore moins bien à cette approche, parce que le système rédige un texte nouveau : les traductions correctes d'une phrase ne peuvent pas être énumérées, et une même phrase peut être en partie juste et en partie fausse.
- Une traduction est jugée sur son adéquation, c'est-à-dire si le sens de la source est conservé, et sur sa fluidité, c'est-à-dire si elle se lit comme un texte naturel dans la langue cible.
Page 1Page 1
Page 1Page 1
Page 2Page 2
Ways of evaluating a translationLes façons d'évaluer une traduction
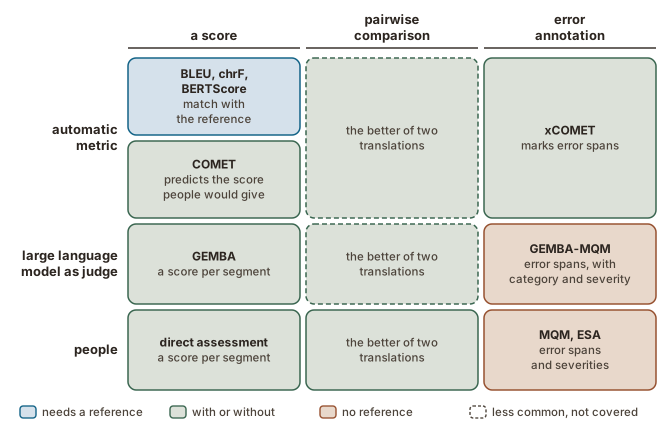
- A translation is evaluated by an automatic metric, by a large language model used as a judge, or by people, who give a score, compare two translations or annotate the errors.
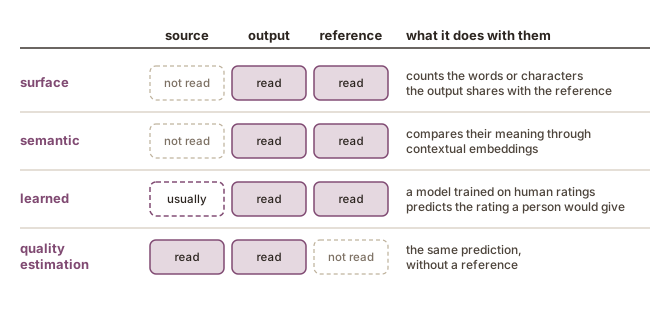
- Automatic metrics compare the output with a reference by the words or characters they share or by their meaning, or predict the score a person would give.
- The methods differ in what they need, what they measure, how closely they agree with people and what they cost; none is best on all of these, so the choice depends on what the evaluation is for.
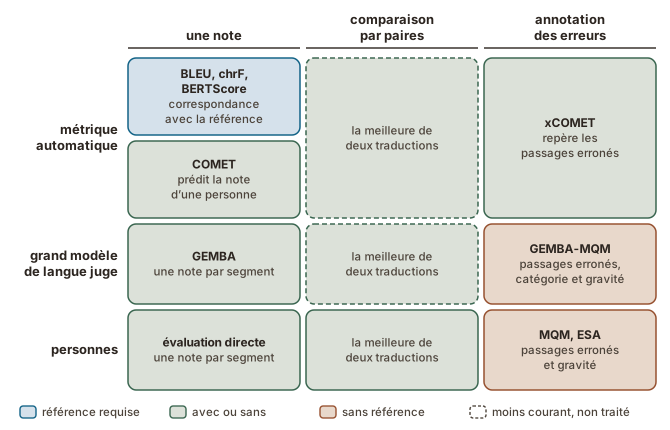
- Une traduction est évaluée par une métrique automatique, par un grand modèle de langue employé comme juge, ou par des personnes, qui lui attribuent un score, comparent deux traductions ou en annotent les erreurs.
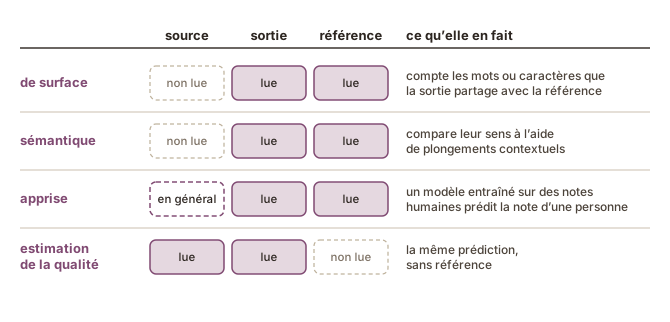
- Les métriques automatiques comparent la sortie avec une référence par les mots ou les caractères qu'elles ont en commun ou par leur sens, ou prédisent le score qu'une personne donnerait.
- Les méthodes diffèrent par ce qu'elles exigent, ce qu'elles mesurent, leur accord avec les personnes et leur coût ; aucune n'est la meilleure sur tous ces points, si bien que le choix dépend de ce à quoi sert l'évaluation.
Page 2Page 2
Page 3Page 3
BLEUBLEU
- BLEU scores a translation by its precision against a reference translation: for sequences of one to four words, the share that also occur in the reference. The four precisions are combined into one number, reduced when the translation is shorter than the reference.
- It rewards the exact words of the reference, so a correct synonym or a different word order is penalized like an error; it was designed to compare systems over a whole test set, and a single sentence often scores zero.
- BLEU note une traduction par sa précision par rapport à une traduction de référence : pour les suites d'un à quatre mots, la proportion qui figure aussi dans la référence. Les quatre précisions sont combinées en un seul nombre, réduit quand la traduction est plus courte que la référence.
- BLEU récompense les mots exacts de la référence, si bien qu'un synonyme correct ou un ordre des mots différent est pénalisé comme une erreur ; la métrique a été conçue pour comparer des systèmes sur tout un jeu de test, et une phrase isolée obtient souvent zéro.
Page 3Page 3
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Page 4Page 4
chrFchrF
- chrF scores a translation by the sequences of one to six characters it shares with the reference, counted as precision and recall and combined into an F-score, which in the usual setting gives recall twice the weight of precision.
- Counting characters instead of words makes it tolerant of inflections and independent of how the text is split into words. It is the surface metric to use where a trained metric cannot be, but it does not compare meaning.
- chrF note une traduction par les suites d'un à six caractères qu'elle partage avec la référence, comptées sous forme de précision et de rappel et combinées en un score F, qui, dans le réglage habituel, donne au rappel deux fois plus de poids qu'à la précision.
- Compter des caractères plutôt que des mots rend la métrique tolérante aux flexions et indépendante de la façon dont le texte est découpé en mots. C'est la métrique de surface à employer quand une métrique entraînée ne peut pas l'être, mais elle ne compare pas le sens.
Page 4Page 4
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Page 7Page 7
Semantic and learned metricsLes métriques sémantiques et apprises
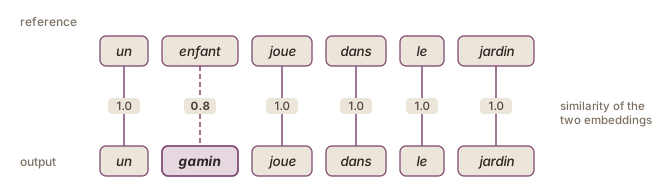
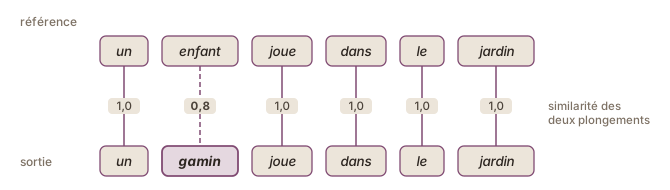
- Semantic metrics compare the meaning of the output and the reference through contextual embeddings, so that a synonym counts as a match; learned metrics are trained on human ratings of translations to predict the score a person would give.
- Learned metrics have often agreed with people better than surface metrics, though not consistently; a high score does not guarantee that the output means the same thing, the score cannot be checked by hand, and a system can be tuned to score well on the metric without being better.
- Les métriques sémantiques comparent le sens de la sortie et de la référence au moyen de plongements contextuels, si bien qu'un synonyme compte comme une correspondance ; les métriques apprises sont entraînées sur des notes que des personnes ont données à des traductions, pour prédire le score qu'une personne donnerait.
- Les métriques apprises se sont souvent mieux accordées avec les personnes que les métriques de surface, mais pas de façon constante ; un score élevé ne garantit pas que la sortie dise la même chose, le score ne peut pas être vérifié à la main, et un système peut être réglé pour bien réussir sur la métrique sans être meilleur.
Page 7Page 7
Page 7Page 7
Page 7Page 7
Page 8Page 8
A large language model as judgeUn grand modèle de langue comme juge
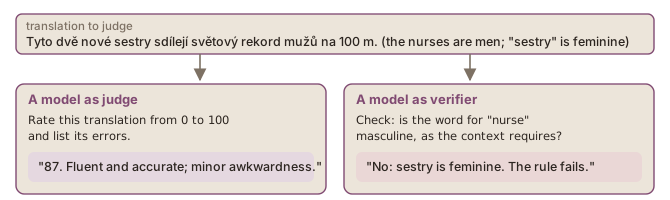
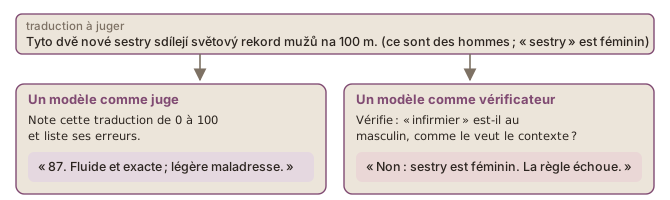
- A large language model can be asked to judge a translation: the prompt gives it the source, the output and, if there is one, the reference, with the criteria to apply and the form the answer should take.
- It can score a translation without a reference, it can list the errors it finds, and the criteria are set in the prompt. Its judgements vary with the prompt and the model, show biases, and are less reliable for one sentence than for a whole system.
- Un grand modèle de langue peut être chargé de juger une traduction : la requête lui fournit la source, la sortie et, s'il y en a une, la référence, avec les critères à appliquer et la forme que doit prendre la réponse.
- Il peut noter une traduction sans référence et dresser la liste des erreurs qu'il trouve, et les critères sont fixés dans la requête. Ses jugements varient avec la requête et le modèle, présentent des biais et sont moins fiables pour une phrase que pour un système entier.
Page 8Page 8
Page 9Page 9
Human evaluation: DA, MQM and ESAL'évaluation humaine : DA, MQM et ESA
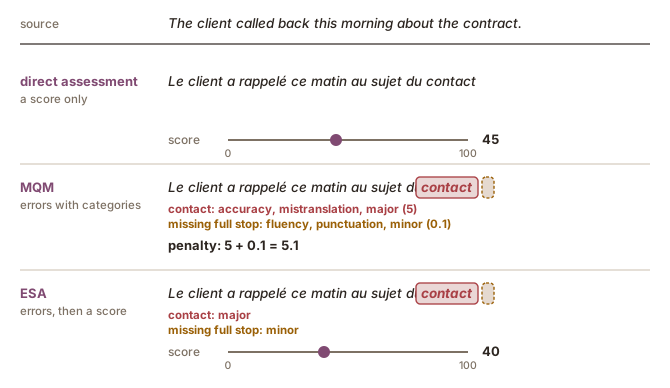
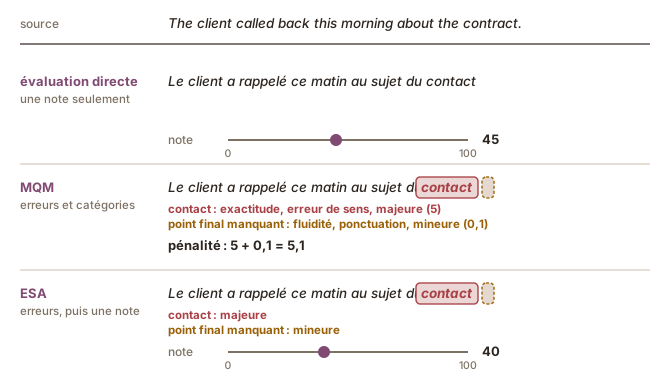
- Direct assessment gives each segment a score on a scale: fast and cheap, but noisy, and with no explanation of what is wrong.
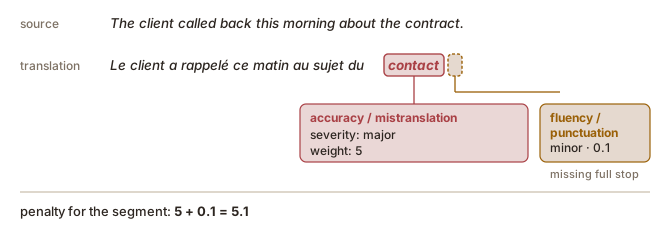
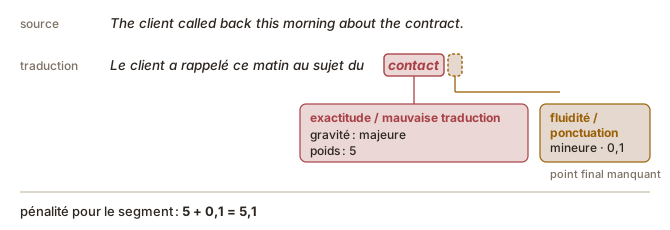
- MQM is an error annotation scheme: an annotator marks each error in a translation, gives it a category and a severity, and the errors are weighted into a score. It is the most detailed of the three and the most expensive, since it takes trained translators.
- ESA keeps the error spans and two severities, drops the categories and adds a score per segment. It is faster and cheaper than MQM at a quality close to it, and it is WMT's main protocol.
- L'évaluation directe donne à chaque segment un score sur une échelle : elle est rapide et peu coûteuse, mais bruitée, et elle n'explique pas ce qui ne va pas.
- MQM est un système d'annotation des erreurs : une annotatrice ou un annotateur marque chaque erreur d'une traduction, lui attribue une catégorie et une gravité, et les erreurs sont pondérées pour donner un score. C'est le plus détaillé des trois protocoles et le plus coûteux, puisqu'il demande des traducteurs formés.
- ESA garde les passages erronés et deux niveaux de gravité, abandonne les catégories et ajoute un score par segment. Il est plus rapide et moins coûteux que MQM pour une qualité proche, et c'est le principal protocole de WMT.
Page 9Page 9
Page 9Page 9
Page 10Page 10
Comparing machine and human translationComparer la traduction automatique et la traduction humaine
- A claim that machine translation equals human translation is true only for the test behind it: which human translation, which raters, which texts, and how much of each text the raters saw.
- Raters who see only the target text, or who lack translation expertise, are likely to judge mainly on fluency, and fluent machine output can hide errors that only a comparison with the source reveals.
- Une affirmation selon laquelle la traduction automatique égale la traduction humaine n'est vraie que pour le test qui la fonde : quelle traduction humaine, quels évaluateurs, quels textes, et quelle part de chaque texte les évaluateurs ont vue.
- Les évaluateurs qui ne voient que le texte cible, ou qui n'ont pas d'expertise en traduction, risquent de juger surtout sur la fluidité, et une sortie automatique fluide peut cacher des erreurs que seule une comparaison avec la source révèle.
Page 11Page 11
Reading the scoresLire les scores
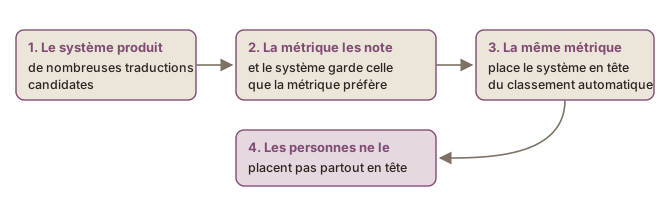
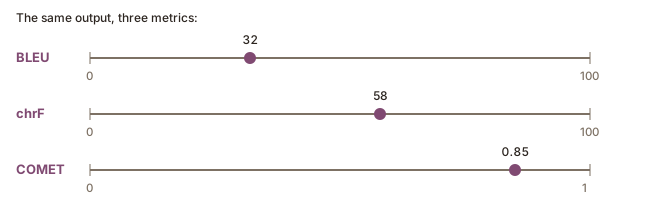
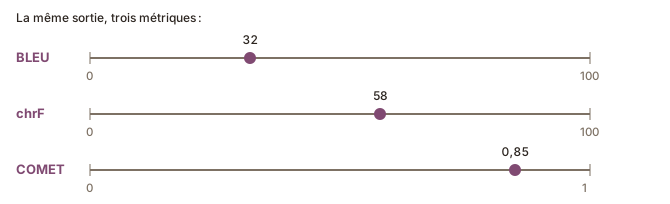
- A score from an automatic metric is comparable only with another score from the same metric, on the same test set, against the same reference, with the same tool; scores from different metrics cannot be compared, and none is a percentage.
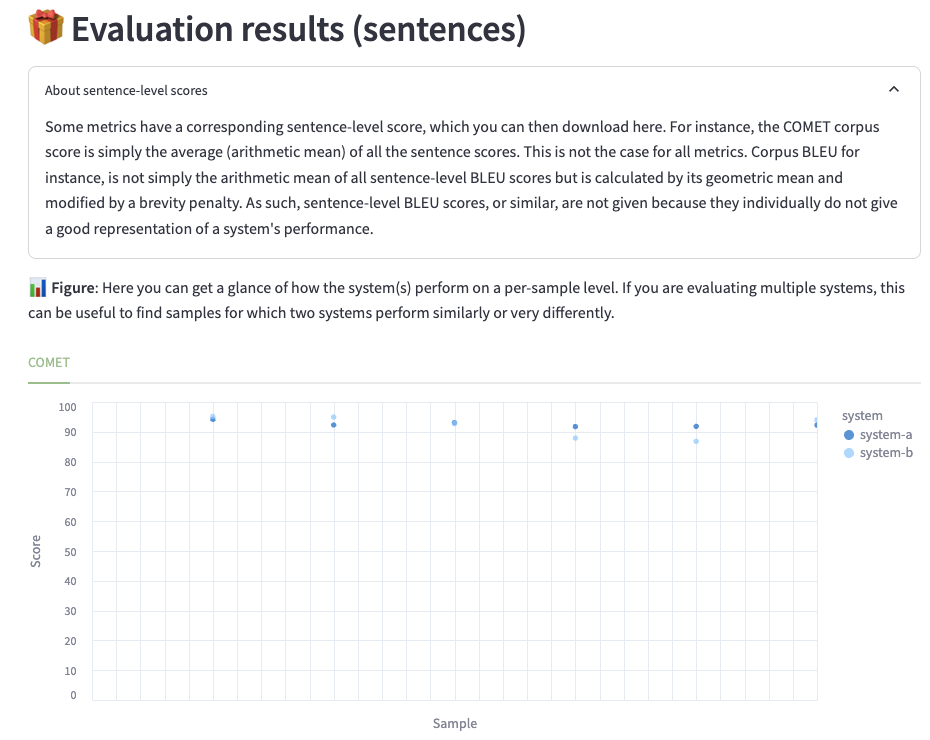
- Scores per sentence show where two systems differ and are the start of an error analysis.
- No single metric is enough: automatic scores show which systems and which sentences to read, and human judgement remains the final test.
- Le score d'une métrique automatique n'est comparable qu'à un autre score de la même métrique, sur le même jeu de test, par rapport à la même référence, avec le même outil ; les scores de métriques différentes ne peuvent pas être comparés, et aucun n'est un pourcentage.
- Les scores par phrase montrent où deux systèmes diffèrent et sont le point de départ d'une analyse des erreurs.
- Aucune métrique ne suffit à elle seule : les scores automatiques indiquent quels systèmes et quelles phrases lire, et le jugement humain reste l'épreuve finale.
Page 11Page 11
Page 12Page 12
Computing scores with MATEOCalculer des scores avec MATEO
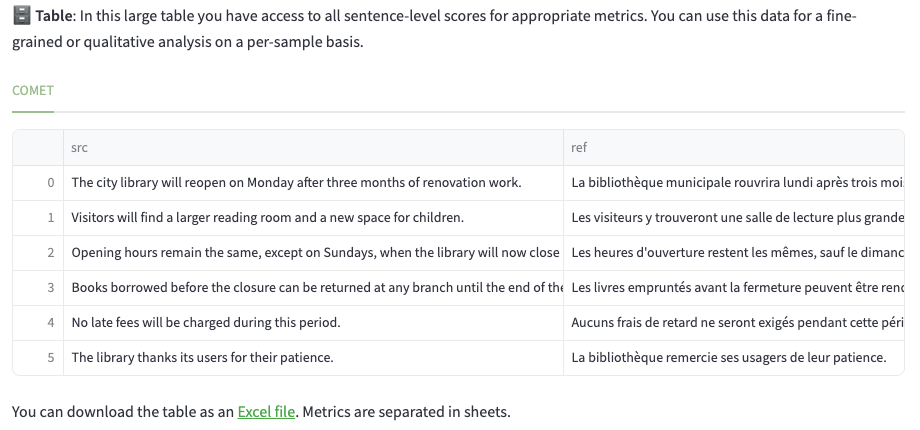
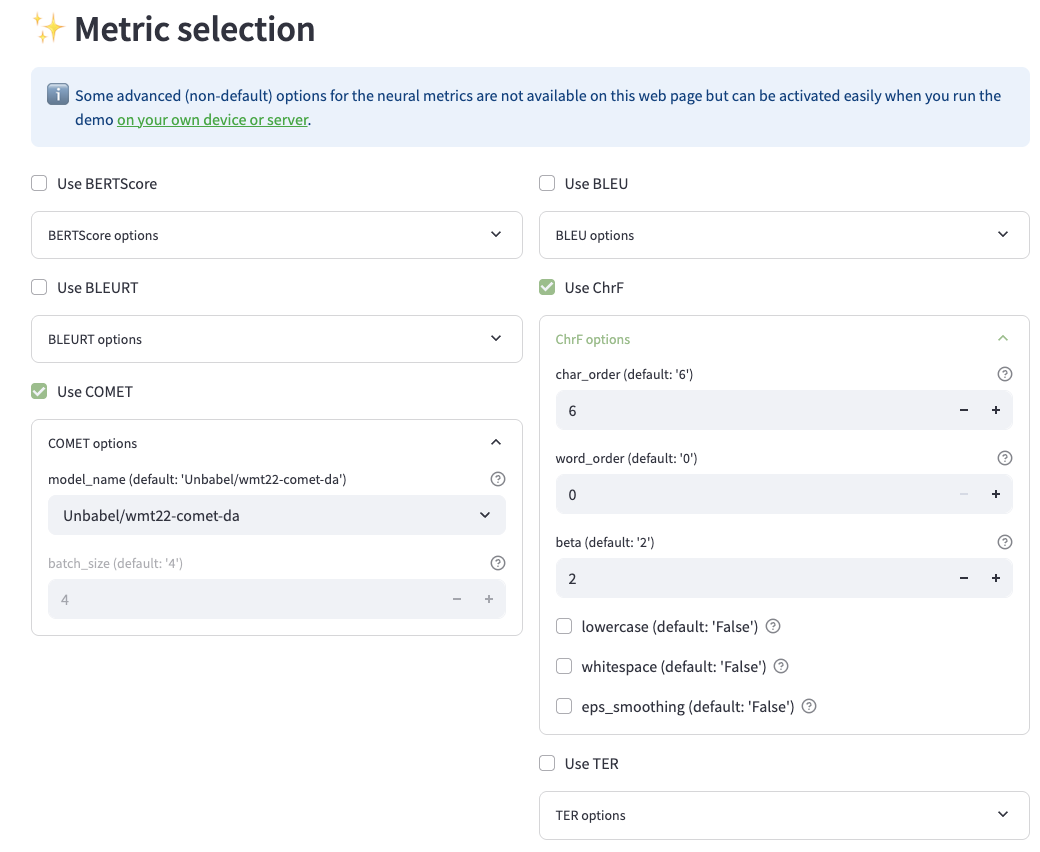
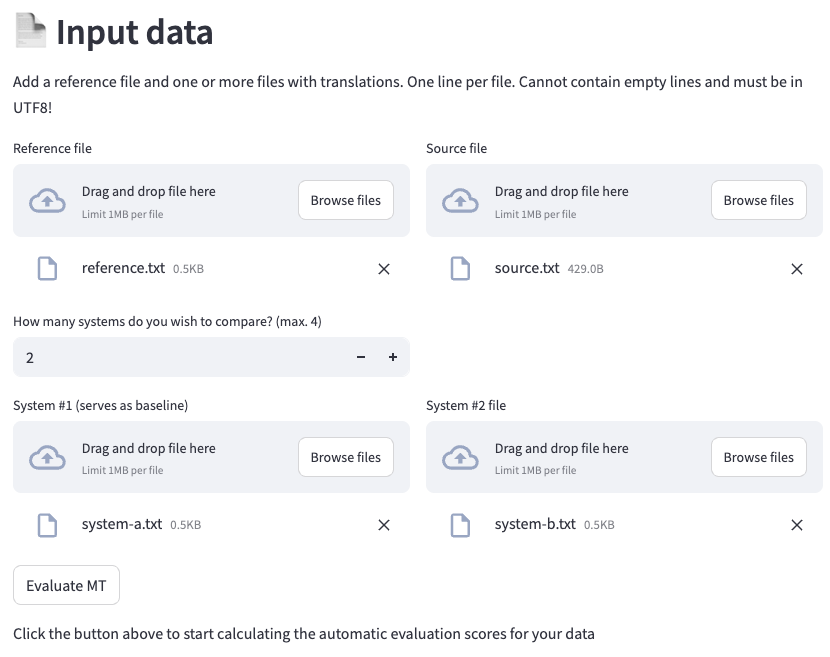
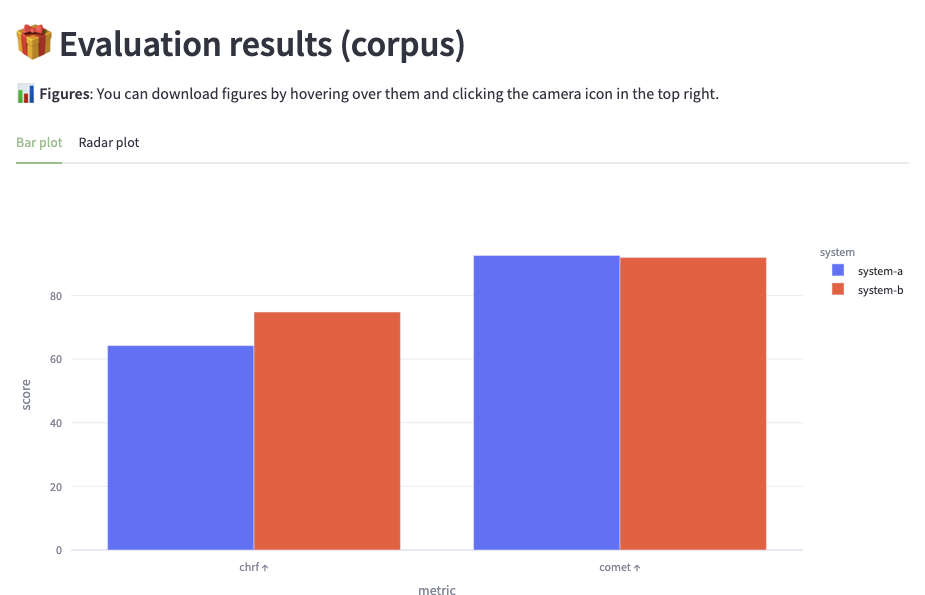
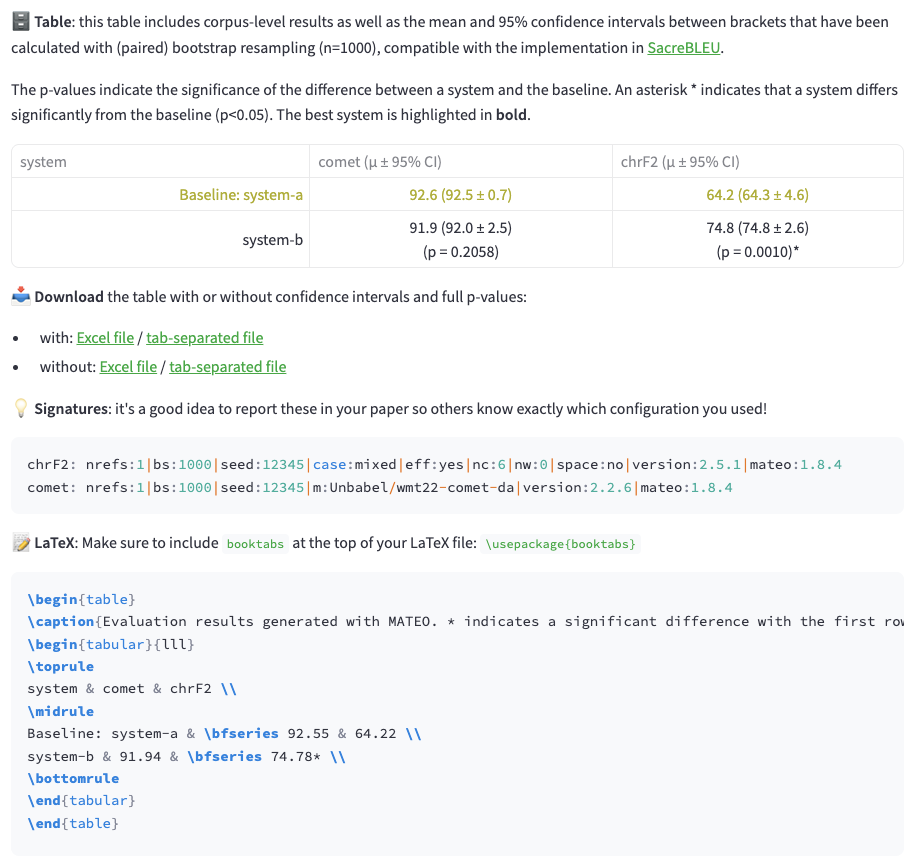
- MATEO is a web interface that computes the usual automatic metrics for machine translation, such as chrF and COMET, from files you upload, without any programming.
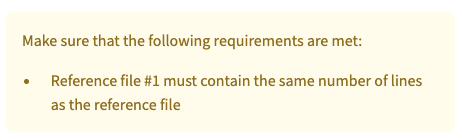
- The files must correspond line by line. MATEO checks that they have the same number of lines, but not that each line contains the right segment.
- MATEO gives the scores for the whole text and, for metrics such as COMET, the scores per sentence. The confidence intervals can be left aside for a first comparison, but a difference is significant only when MATEO's test says so.
- MATEO est une interface Web qui calcule les métriques automatiques usuelles de la traduction automatique, comme chrF et COMET, à partir de fichiers que vous téléversez, sans aucune programmation.
- Les fichiers doivent se correspondre ligne par ligne. MATEO vérifie qu'ils ont le même nombre de lignes, mais pas que chaque ligne contient le bon segment.
- MATEO donne les scores pour tout le texte et, pour des métriques comme COMET, les scores par phrase. Les intervalles de confiance peuvent être laissés de côté pour une première comparaison, mais une différence n'est significative que si le test de MATEO le dit.
Page 12Page 12
Page 12Page 12
Page 12Page 12
Page 12Page 12
Page 12Page 12
Page 12Page 12
Page 12Page 12