Extraction and classification
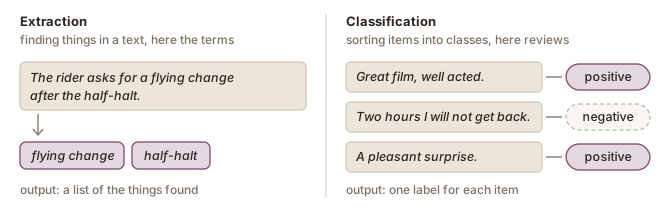
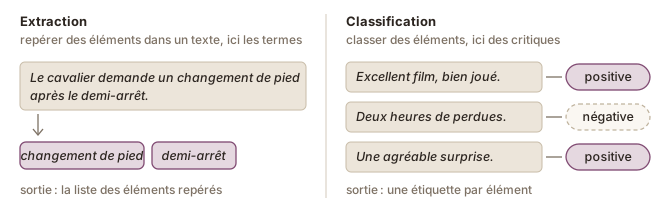
This chapter is about two kinds of system (Figure 1figure 1):
- systems that find things in a text, such as a term extractor automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. or a system for named entity recognition named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. ;
- systems that sort items into classes (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), such as a spam filter, or a system that labels a review as positive or negative.
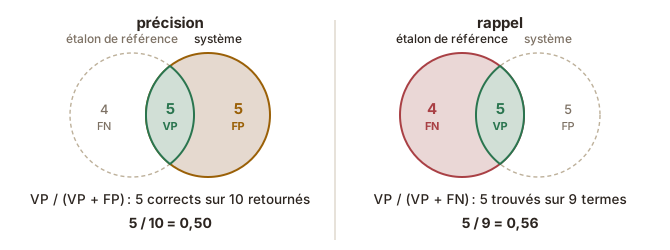
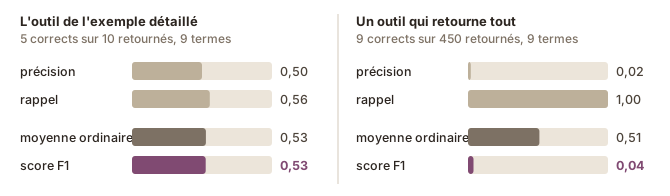
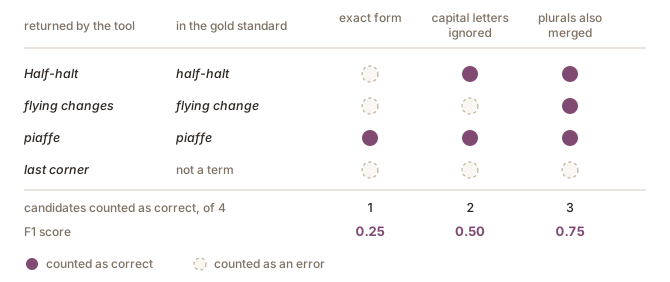
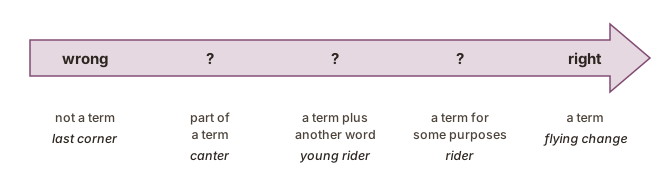
Such systems are most often evaluated by comparing their output with a gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , the answers that people gave for the same input (see also the gold standard page) (voir aussi la page L'étalon de référence). Several measures can turn that comparison into a score. The focus here is on three that are commonly used together: precision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. , recall recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. and the F1 score F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. .
An example of each error
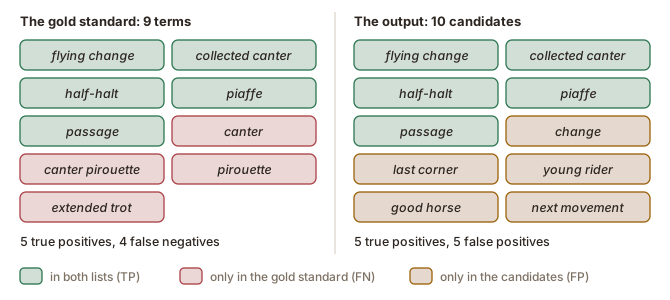
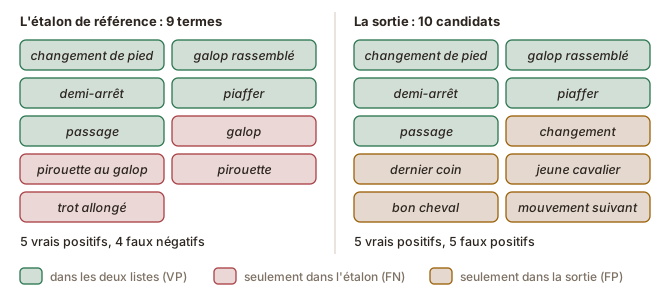
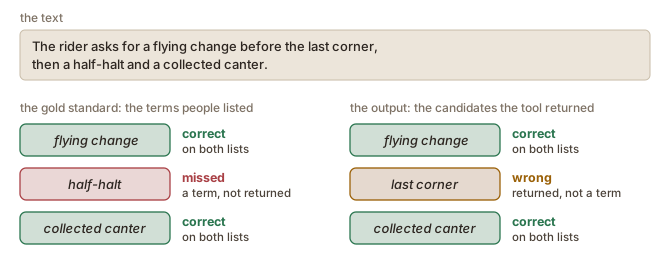
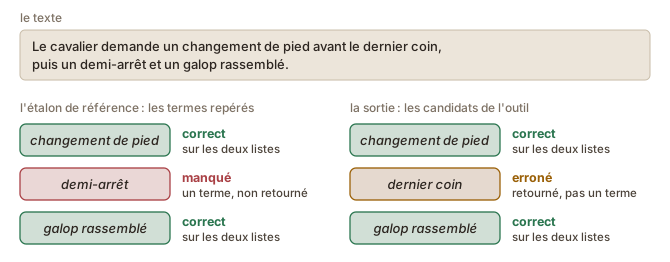
For example, a term extractor, a tool that lists the specialized terms of a text, is run on a sentence about dressage, an equestrian sport (Figure 2figure 2):
- the tool returns a list of three candidates: flying change, last corner and collected canter;
- the gold standard is a list of three terms: flying change, half-halt and collected canter.
Two candidates are on both lists, so they are correct. The tool has also made two errors, of different kinds:
- last corner was returned, but it is not a term;
- half-halt is a term, but it was not returned.
The four outcomes
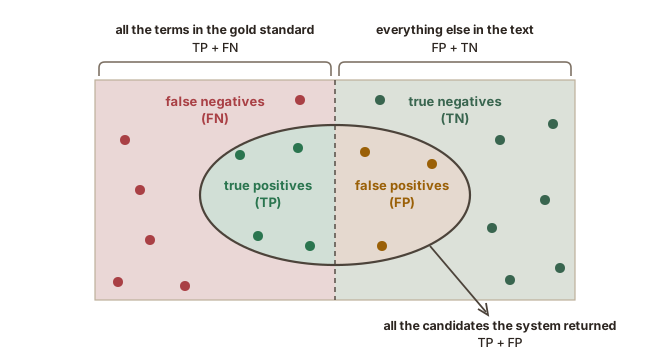
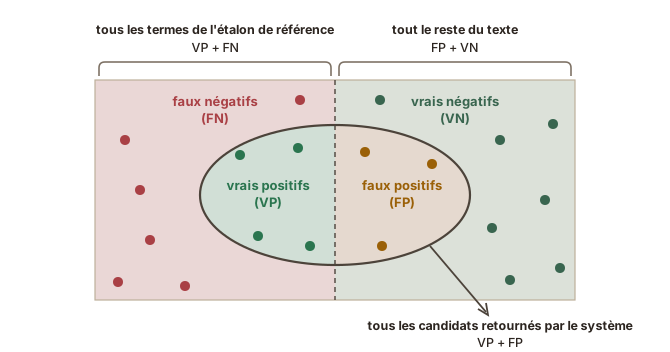
When the output of a system is compared with a gold standard, every decision is one of four cases, defined in the boxes below and often abbreviated TP, FP, FN and TN.
In the example above, flying change and collected canter are true positives, last corner is a false positive and half-halt is a false negative. The true negatives are everything else in the text. Figure 3figure 3 builds up the four cases for a term extractor.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Jurafsky and Martin (2026) present the same four cases as a table, called a confusion matrix, for a system that sorts items into two classes, such as a spam filter: a message stopped by mistake is a false positive, and spam that reaches the inbox is a false negative.
| In the gold standard | Not in the gold standard | |
|---|---|---|
| Returned by the system | true positive | false positive |
| Not returned by the system | false negative | true negative |
Noise and silence
The false positives are also called noise, and the false negatives silence. You can interpret the two words quite literally: noise is output that should not be there, and silence is output that is missing.
True negatives
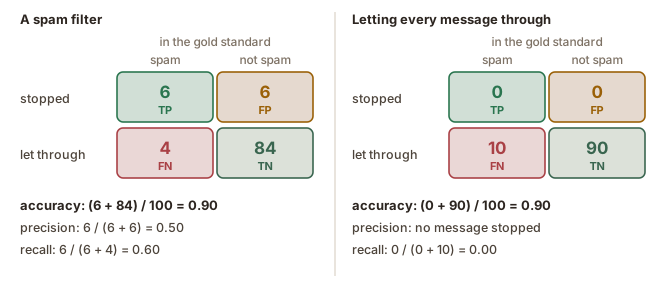
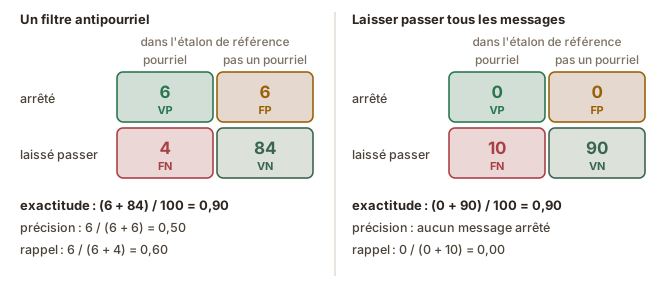
The fourth case differs between the two kinds of system (Figure 4figure 4):
- For a spam filter, each message is one item, so the true negatives, the messages that are not spam and were let through, can be counted.
- For a system that finds things in a text, such as a term extractor, the true negatives would be every word and every sequence of words that is not a term and was not returned. Such units vary in length and overlap, so their number is not well defined (Hripcsak & Rothschild, 2005).
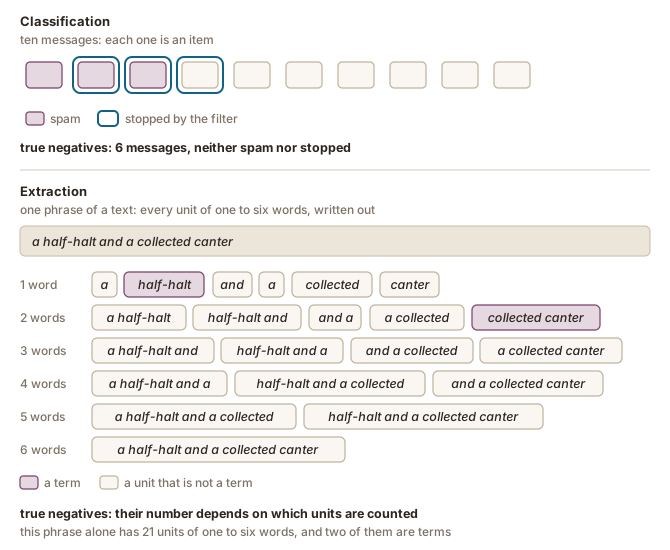
The scores most often used for both kinds of system, precision and recall, are calculated from the other three cases only (Jurafsky & Martin, 2026) (see also the Precision, recall and F1 page) (voir aussi la page Précision, rappel et score F1).
The trade-off between the two errors
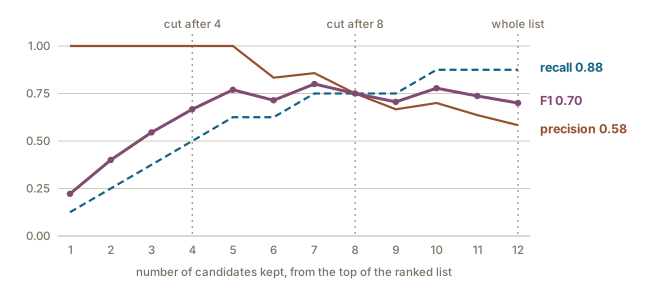
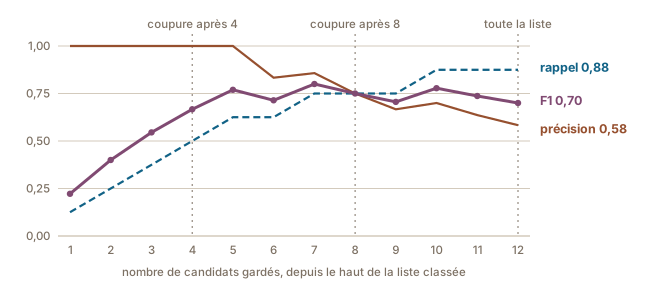
The two errors work against each other. A tool set to return more candidates misses fewer terms, but it also returns more units that are not terms. A tool set to return fewer candidates does the reverse.
In Figure 5figure 5, a tool has ranked twelve candidates, and the list is cut at three points. The further down the list the cut is made, the fewer terms are missed and the more noise comes with them. An evaluation therefore reports each of the two errors as well as a score that combines them.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Sources
- Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Extraction et classification
Ce chapitre porte sur deux types de système (Figure 1figure 1) :
- les systèmes qui repèrent des éléments dans un texte, comme un extracteur de termes automatic term extraction (ATE)extraction automatique de termes NLPTAL The identification, by a program, of candidate terms in a text or a corpus, for a person to validate.Repérage, par un programme, de candidats terminologiques dans un texte ou un corpus, en vue de leur validation par une personne. ou un système de reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. ;
- les systèmes qui classent des éléments (classification classificationclassification machine learningapprentissage automatique A task whose answer is one of a fixed set of categories: the system is asked which of k classes an input belongs to.Tâche dont la réponse est l'une des catégories d'un ensemble fixe : le système doit dire à laquelle des k classes appartient une entrée. ), comme un filtre antipourriel, ou un système qui étiquette une critique comme positive ou négative.
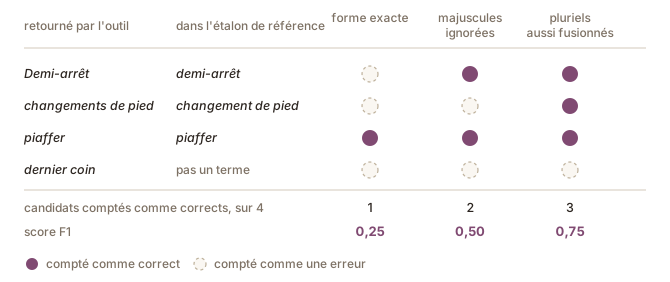
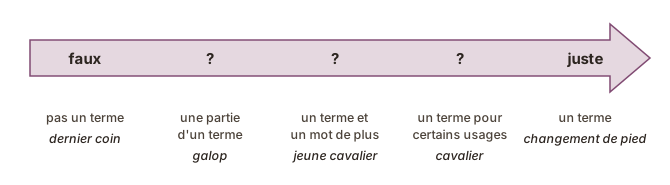
De tels systèmes sont le plus souvent évalués en comparant leur sortie à un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , les réponses que des personnes ont données pour les mêmes données (see also the gold standard page) (voir aussi la page L'étalon de référence). Plusieurs mesures permettent de transformer cette comparaison en score. Ce chapitre se concentre sur trois mesures couramment utilisées ensemble : la précision precisionprécision evaluationévaluation The share of the items a system returned that are correct according to the gold standard.Part des éléments trouvés par un système qui sont corrects selon la référence. , le rappel recallrappel evaluationévaluation The share of the items in the gold standard that a system returned.Part des éléments de la référence qu'un système a trouvés. et le score F1 F1 scorescore F1 evaluationévaluation The harmonic mean of precision and recall: a single number between 0 and 1 that is high only when both are high.Moyenne harmonique de la précision et du rappel : un seul nombre entre 0 et 1, qui n'est élevé que si les deux le sont. .
Un exemple de chaque erreur
Par exemple, un extracteur de termes, un outil qui dresse la liste des termes spécialisés d’un texte, traite une phrase sur le dressage, un sport équestre (Figure 2figure 2) :
- l’outil propose une liste de trois candidats : changement de pied, dernier coin et galop rassemblé ;
- l’étalon de référence est une liste de trois termes : changement de pied, demi-arrêt et galop rassemblé.
Deux candidats figurent sur les deux listes : ils sont donc corrects. L’outil a aussi fait deux erreurs, de types différents :
- dernier coin a été proposé, mais ce n’est pas un terme ;
- demi-arrêt est un terme, mais il n’a pas été trouvé.
Les quatre cas
Quand la sortie d’un système est comparée à un étalon de référence, chaque décision correspond à l’un de quatre cas, définis dans les encadrés ci-dessous et souvent abrégés VP, FP, FN et VN.
Dans l’exemple ci-dessus, changement de pied et galop rassemblé sont des vrais positifs, dernier coin est un faux positif et demi-arrêt est un faux négatif. Les vrais négatifs sont tout le reste du texte. La Figure 3figure 3 construit les quatre cas pour un extracteur de termes.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Jurafsky et Martin (2026) présentent les mêmes quatre cas sous forme de tableau, appelé matrice de confusion, pour un système qui classe des éléments en deux classes, comme un filtre antipourriel : un message arrêté par erreur est un faux positif, et un pourriel qui arrive dans la boîte de réception est un faux négatif.
| Dans l’étalon de référence | Absent de l’étalon de référence | |
|---|---|---|
| Trouvé par le système | vrai positif | faux positif |
| Non trouvé par le système | faux négatif | vrai négatif |
Le bruit et le silence
L’ensemble des faux positifs s’appelle aussi le bruit, et l’ensemble des faux négatifs, le silence. Les deux mots peuvent se comprendre littéralement : le bruit est ce qui ne devrait pas se trouver dans la sortie, et le silence, ce qui y manque.
Les vrais négatifs
Le quatrième cas n’est pas le même pour les deux types de système (Figure 4figure 4) :
- Pour un filtre antipourriel, chaque message est un élément : les vrais négatifs, les messages qui ne sont pas des pourriels et que le filtre a laissés passer, peuvent donc être comptés.
- Pour un système qui repère des éléments dans un texte, comme un extracteur de termes, les vrais négatifs seraient chaque mot et chaque suite de mots qui n’est pas un terme et n’a pas été trouvée. Ces unités varient en longueur et se chevauchent : leur nombre n’est donc pas bien défini (Hripcsak & Rothschild, 2005).
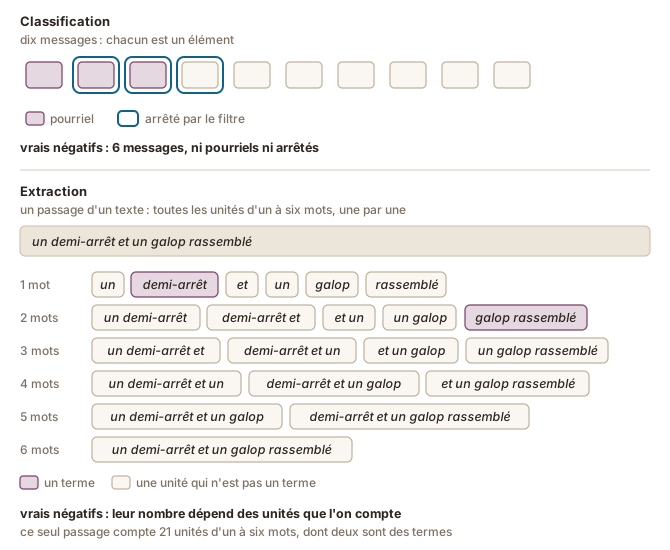
Les scores les plus utilisés pour les deux types de système, la précision et le rappel, se calculent à partir des trois autres cas seulement (Jurafsky & Martin, 2026) (see also the Precision, recall and F1 page) (voir aussi la page Précision, rappel et score F1).
Le compromis entre les deux erreurs
Les deux erreurs s’opposent. Un outil réglé pour proposer plus de candidats manque moins de termes, mais il propose aussi plus d’unités qui ne sont pas des termes. Un outil réglé pour proposer moins de candidats fait l’inverse.
Dans Figure 5figure 5, un outil a classé douze candidats, et la liste est coupée à trois endroits. Plus la coupure se fait bas dans la liste, moins il manque de termes, et plus il y a de bruit. Une évaluation indique donc chacune des deux erreurs, en plus d’un score qui les combine.
Click the drawing, or a line below, to build it up stage by stage. Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Sources
- Hripcsak, G., & Rothschild, A. S. (2005). Agreement, the F-measure, and reliability in information retrieval. Journal of the American Medical Informatics Association, 12(3), 296–298. https://doi.org/10.1197/jamia.M1733
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/